Cours
Introduction à Python pour la finance
4 h
106.7K
Octobre est historiquement le mois le plus volatil pour les actions, mais s'agit-il d'un signal durable ou juste de bruit dans les données ?
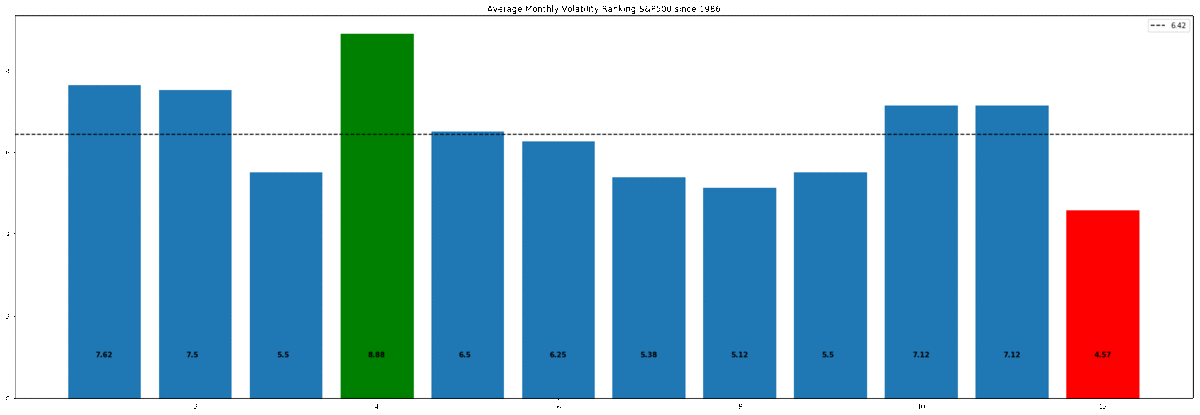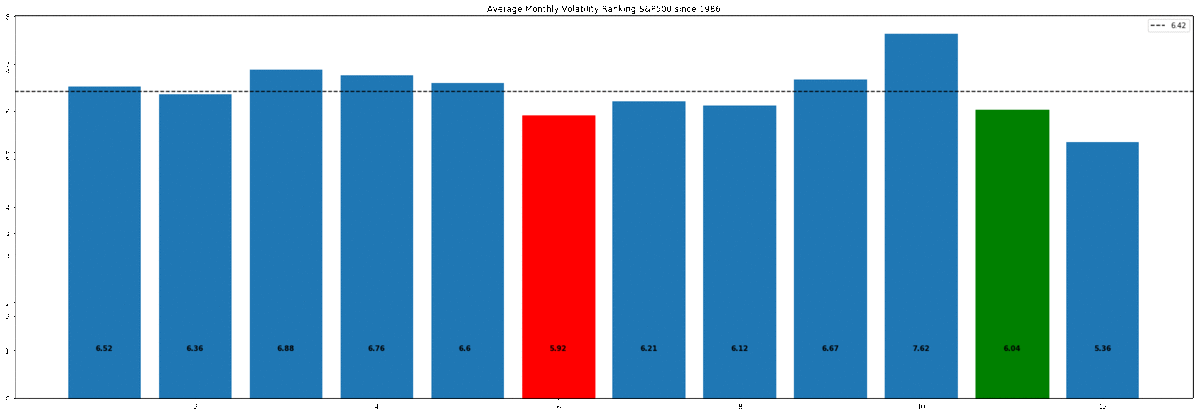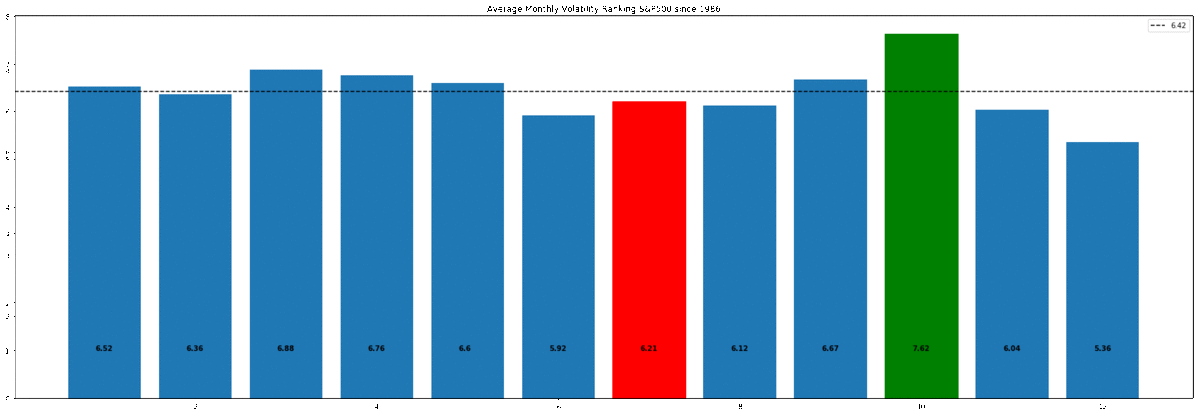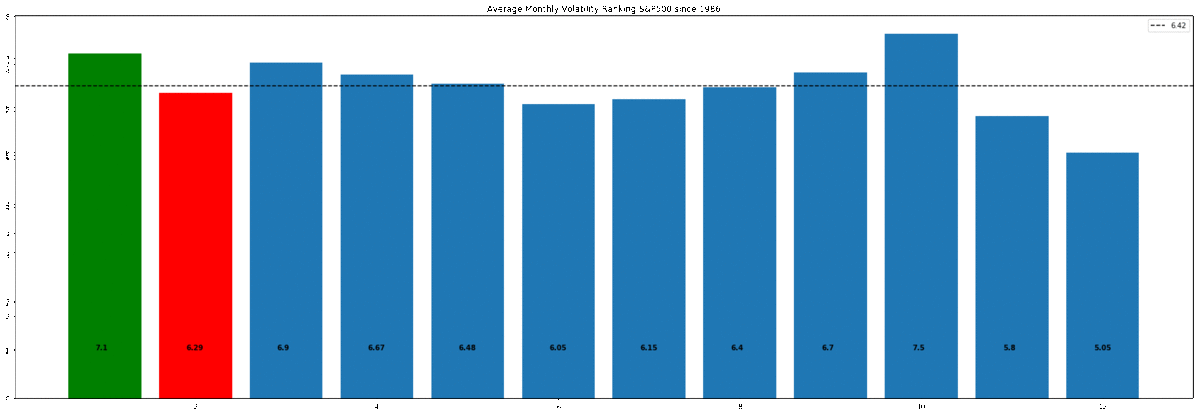
"Au cours des 32 dernières années, octobre a été en moyenne le mois le plus volatil pour le S&P 500 et décembre le moins volatil".
Dans ce tutoriel, nous allons utiliser Python pour mener une analyse complète et tester ce phénomène afin de déterminer s'il est statistiquement significatif ou non.
Nous exploiterons les fonctionnalités de séries temporelles de pandas, comme Resample, pour transformer des cours boursiers bruts en un format qui met en lumière les tendances.
Nous verrons ensuite comment réaliser des tests d'hypothèses par simulation en Python, plutôt qu'avec des formules lourdes.
Enfin, nous aborderons un problème majeur des analyses statistiques, le biais des comparaisons multiples, apprendrons à le traiter et visualiserons, via matplotlib, l'effet du « p-hacking ».
Nous utiliserons des données quotidiennes du S&P 500 pour cette analyse : plus précisément, les cours de clôture quotidiens bruts de 1986 à 2018 (difficiles à trouver, je les ai donc rendus disponibles publiquement).
Ce billet est inspiré par Winton, dont nous allons reproduire l'analyse ici, mais avec 32 années de données contre 87 chez eux.
Pour savoir si la volatilité extrême observée certains mois est réellement significative et donc susceptible de perdurer, nous devons transformer nos 32 ans de données de prix dans un format qui met en évidence le phénomène étudié.
Notre format de référence sera le classement moyen mensuel de volatilité (AMVR).
Le code suivant montre comment convertir nos prix bruts dans ce format. C'est parti !
D'abord, les imports standards (matplotlib.patches nous permet de styliser individuellement des barres dans un histogramme).
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
Une astuce pour afficher les graphiques en pleine largeur dans Jupyter :
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
Optionnel : essayez pour voir l'effet !
#plt.xkcd()
Importons les données avec read_csv, en lui passant le chemin (ici, l'URL) et en indiquant d'utiliser « date » comme index et de parser automatiquement les dates.
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
Nous obtenons ainsi les cours de clôture bruts et non ajustés du S&P 500 (SPX). Convertissons maintenant ces prix en rendements quotidiens en %. Deux options :
Pour notre usage, nous choisirons la méthode 2, car pandas gère instantanément un calcul de cette taille (plus de 8 000 valeurs). Nous nettoierons aussi la série en supprimant la première valeur (NaN, car pas de variation par rapport à la veille). pct_change() accepte un paramètre optionnel « periods » pour changer le décalage ; nous conservons la valeur par défaut (1).
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
Étape suivante : transformer ces variations quotidiennes en « volatilité mensuelle annualisée ». La 1re ligne ci-dessous montre que la transformation tient en une ligne. C'est toute la puissance de pandas. Détaillons les étapes.
1. Pour obtenir mnthly_annu, nous utilisons d'abord « resample » sur les rendements quotidiens. Resample permet de changer la fréquence des périodes. Il prend une « frequency offset string », c'est-à-dire une lettre correspondant à la nouvelle fréquence. Par exemple :
Comme nous voulons passer du quotidien au mensuel, nous passons « M ».
2. Il faut ensuite choisir comment agréger ces valeurs quotidiennes au mensuel (somme, produit, etc.). Pour notre analyse, nous cherchons une mesure de volatilité : l'écart-type convient bien. Nous ajoutons donc std() à nos données rééchantillonnées pour obtenir la volatilité mensuelle.
3. Enfin, nous annualisons cette valeur en multipliant par la racine carrée de 12 (mois dans l'année). Nous obtenons ainsi nos volatilités mensuelles annualisées.
Bonne pratique : visualiser au fil de l'analyse. Observons nos données de volatilité annualisée.
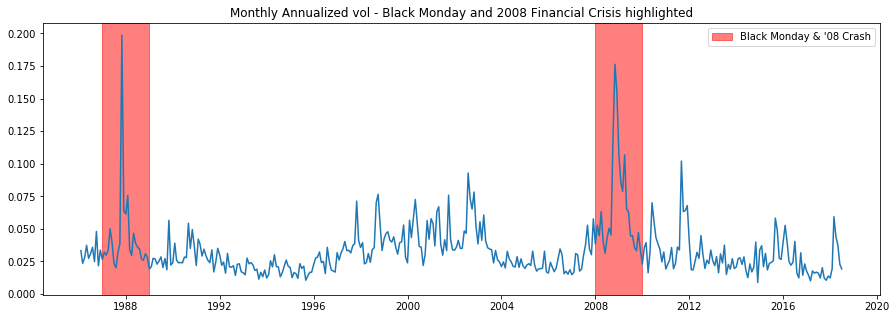
Le graphique ci-dessous met en évidence des événements majeurs comme le « lundi noir » et la crise financière de 2008. La méthode matplotlib « axvspan » ajoute des bandes verticales (axhspan pour l'horizontal). Elle prend « xmin » et « xmax » pour définir la largeur du rectangle ; notre axe des x étant un index datetime, nous pouvons simplement passer les années à surligner. Le paramètre alpha règle la transparence.
L'attribut mpatches permet de construire une légende personnalisée. On définit d'abord la variable « labs » avec la couleur, l'alpha et le texte, puis on la passe à « handles » dans plt.legend.
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
Nous avons vu l'une des méthodes puissantes de pandas, resample. Passons à une autre, groupby. Il nous faut passer de la volatilité mensuelle annualisée à notre métrique AMVR. Là encore, quelques lignes suffisent.
1. Nous appliquons « groupby » à mnthly_annu. Groupby nécessite un paramètre précisant comment regrouper. Cela peut être une fonction ou, comme ici, une série. Nous passons « mnthly_annu.index.year », c'est l'attribut année de l'index datetime. On regroupe ainsi la volatilité mensuelle pour chacune des 32 années.
2. Nous appliquons ensuite la méthode rank, qui ordonne les données par ordre croissant.
3. Enfin, nous répétons l'opération par mois et calculons la moyenne sur toutes les années. Nous obtenons nos valeurs AMVR finales !
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
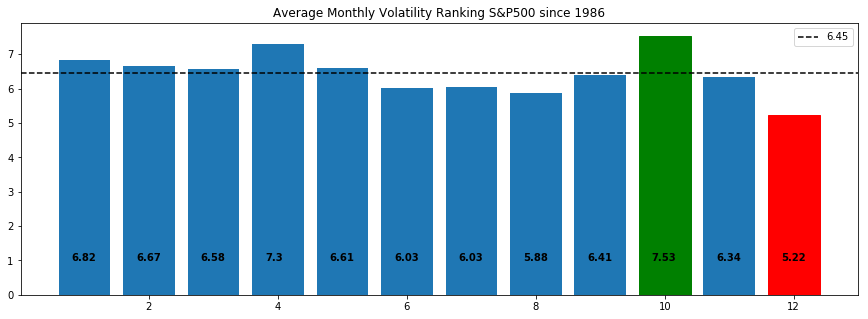
Voici nos classements moyens de volatilité mensuelle. Numériquement, on constate que le mois 10 (octobre) est le plus élevé et le 12 (décembre) le plus faible.
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
Choisir la bonne visualisation est clé pour raconter l'histoire des données. Ici, nous voulons montrer clairement la volatilité la plus forte et la plus faible. Nous utiliserons un diagramme en barres matplotlib, avec annotations et couleurs pour maximiser l'impact.
1. En indexant b_plot (b_plot[9]) sur la barre désirée, nous pouvons colorer pour surligner les valeurs extrêmes.
2. Pour ajouter les valeurs AMVR sur chaque barre, nous itérons (enumerate) sur « final » arrondi à 2 décimales. « i » et « v » désignent l'index et la valeur : i va de 1 à 12, value est l'AMVR arrondi. Nous utilisons ces variables dans plt.text(). Le 1er paramètre est la position x de l'étiquette : nous passons « i » décalé de 0,8 pour centrer. Le 2e est la chaîne de la valeur.
3. Pour afficher la moyenne, nous utilisons axhline et le paramètre « label » afin d'ajouter une légende en haut à droite. Il suffit de passer la valeur y (la moyenne), puis de styliser.
Ce visuel est le plus parlant pour notre phénomène : octobre est le plus volatil et décembre le moins. Surtout, décembre apparaît comme la valeur la plus « extrême » en valeur absolue, ce qui comptera pour la suite.
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
Voilà pour nos données. Passons au test d'hypothèse…
Le test d'hypothèse est un pilier de la data science, mais reste souvent intimidant et mal compris. En cause, la manière dont il est enseigné en Statistiques 101 :
"effectuez un test t, unilatéral ou bilatéral ? Choisissez une statistique de test adaptée comme le test t de Welch, calculez les degrés de liberté, la statistique t, cherchez la valeur critique dans une table, comparez…"
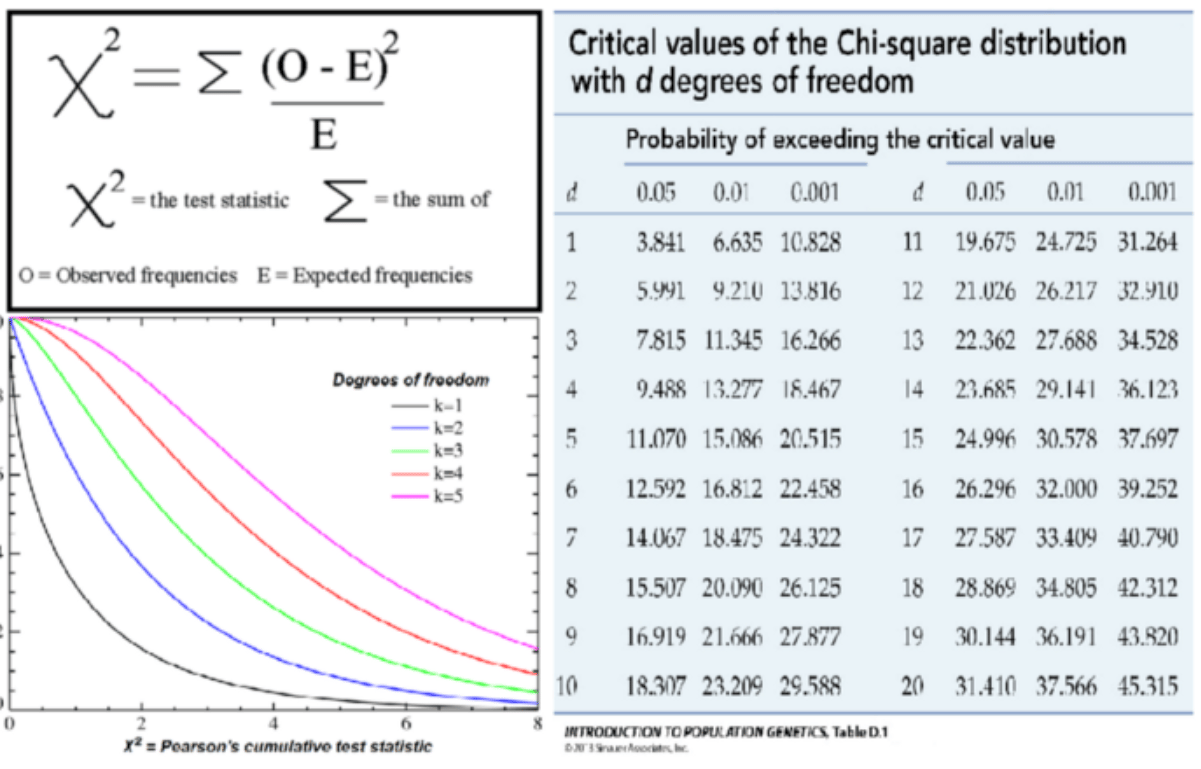
Sans surprise, cela brouille la compréhension du « quoi » et du « comment ». Or, ces techniques classiques ont été développées à une époque de faible puissance de calcul : ce ne sont que des solutions analytiques fermées pour obtenir une p-valeur, rien de plus, avec la contrainte de choisir la bonne formule selon des hypothèses parfois restrictives et opaques.
Mais réjouissez-vous !
Il existe une meilleure voie : la simulation.
Pour comprendre l'apport de la simulation, rappelons ce qu'est un test d'hypothèse :
Nous voulons tester « si l'effet observé dans nos données est réel ou s'il pourrait survenir par hasard » et, pour cela, nous procédons ainsi :
Voilà le test d'hypothèse en 3 étapes ! Quel que soit le phénomène, la question reste : « l'effet observé est-il réel, ou dû au hasard ?»
There is only one test ! Un excellent billet d'Allen Downey avec plus de détails
La vraie force de la simulation est d'expliciter nos hypothèses de modèle via le code, là où les techniques classiques font parfois « boîte noire ».
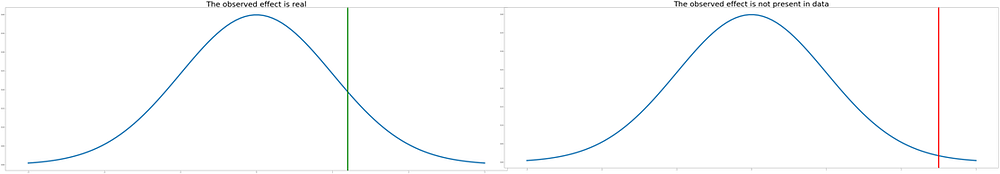
Exemple : le graphique de gauche montre les données réelles et l'effet observé avec une certaine probabilité (vert). À droite, nos données nulles simulées et l'enregistrement des fois où l'effet apparaît par hasard (rouge). Le cœur du test d'hypothèse est : quelle est la probabilité d'observer l'effet sur les données nulles ?
La partie la plus critique est de clarifier la question posée. Ici :
« L'observation la plus extrême pourrait-elle survenir par hasard ? »
Nous définissons la valeur la plus extrême comme la déviation absolue la plus grande de l'AMVR par rapport à la moyenne. Cette question forme notre hypothèse nulle.
Dans nos données, la valeur la plus extrême est celle de décembre (1,23) et non celle d'octobre (1,08), car nous considérons la déviation absolue par rapport à la moyenne, et pas simplement la volatilité la plus élevée.
1. Pour obtenir la déviation absolue, on soustrait la moyenne et on applique abs().
2. Avec sort_values(), on ordonne les résultats du plus petit au plus grand, puis on sélectionne les deux plus grands (octobre et décembre).
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
Maintenant que la question est posée, construisons notre « modèle nul ».
Plusieurs options :
Nous nous focalisons sur une technique : la permutation (mélange).
Pour obtenir le modèle nul, il nous faut un ensemble sans saisonnalité. Si la nulle est vraie (pas de saisonnalité et effet observé dû au hasard), alors les étiquettes mensuelles (janv., févr., etc.) sont dénuées de sens ; on peut donc mélanger les données pour construire ce que les statistiques classiques appellent la « distribution d'échantillonnage de la statistique de test sous l'hypothèse nulle ». L'effet (décembre extrême) devient alors également probable pour tous les mois, comme requis par la nulle.
Pour illustrer la puissance de la simulation sur du matériel moderne, notre code permutera les données quotidiennes (plus coûteux), mais s'exécute tout de même en quelques secondes sur un CPU récent.
Remarque : mélanger les étiquettes au niveau quotidien ou mensuel convient ici.
Shuffle 'date' label to create null dataset

Une excellente ressource sur l'échantillonnage : Julian Simon.
Remarque : la construction de notre test équivaut à un test bilatéral dans les méthodes « classiques » (Welch, ANOVA, etc.), car nous nous intéressons à la valeur la plus extrême, au-dessus comme au-dessous de la moyenne.
Ces décisions relèvent du design du modèle, et c'est normal : le modèle nul est un modèle ! Nous pouvons en fixer les paramètres, à condition d'être clairs sur la question posée.
Nous allons donc simuler beaucoup de données en Python pour créer l'ensemble nul. Nous simulerons 1 000 ensembles de 12 AMVR, en permutant les étiquettes « date » à chaque fois pour construire la distribution d'échantillonnage. La sortie est présentée plus bas dans la section p-hacking.
1. Définissons des conteneurs pour stocker les résultats : un pd.DataFrame() et un simple tableau [].
2. Puis un compteur à zéro et une boucle for de 1 000 itérations pour créer les données simulées.
3. La 1re ligne dans la boucle prend les rendements quotidiens d'origine et utilise la méthode pandas sample(), qui échantillonne aléatoirement un nombre donné d'observations. Nous avons 8 191 points (252 jours de bourse par an sur 32 ans). Nous supprimons l'index avec reset_index() pour pouvoir en ajouter un nouveau, car l'index date d'origine est mélangé avec les données, alors que nous voulons « mélanger » seulement les données.
4. La ligne suivante ajoute un nouvel index de dates en réaffectant l'index de daily_ret_shuffle avec un pd.bdate_range de même longueur que les données d'origine (jours ouvrés, lun.-ven.).
5. Maintenant que les données « mélangées » sont prêtes, nous répétons le même traitement que plus haut pour obtenir les AMVR.
6. Nous ajoutons ensuite chaque simulation à notre dataframe cumulatif via pd.concat (axis=1 pour empiler en colonnes).
7. Maximonth stocke la valeur la plus élevée de chaque simulation (utile plus tard pour le p-hacking).
8. Comme notre analyse requiert des AMVR en valeur absolue, les 3 lignes suivantes aplatissent les 1 000 séries AMVR, calculent la moyenne, soustraient cette moyenne et prennent la valeur absolue.
9. Nous faisons la même chose pour les « plus hauts uniquement ». Remarque : ici, une liste permet d'utiliser une compréhension de liste pour calculer abs(AMVR) sur chaque maximum.
Nous avons maintenant toutes les données nécessaires pour finaliser l'analyse : observations réelles et données simulées.
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
Passons au point intéressant. Nous avons formulé une hypothèse à tester, généré des données simulées en mélangeant les étiquettes « date » et nous devons maintenant réaliser le test pour estimer la probabilité d'observer un résultat aussi significatif que celui de décembre, sous l'hypothèse nulle (pas de saisonnalité).
Avant de tester, posons nos attentes.
Quelle est la probabilité d'observer au moins un résultat significatif avec un seuil de 5 % ?
= 1 - p(pas significatif)
= 1 - (1 – 0,05)¹²
= 0,46
il y a donc 46 % de chances d'observer au moins un mois significatif si la nulle est vraie.
Demandons-nous maintenant, pour chaque test individuel (comparaison de la déviation absolue de l'AMVR des 12 mois à la moyenne) combien de valeurs significatives devrions-nous attendre dans des données aléatoires, non saisonnières ?
12 x 0,05 = 0,6
Avec un seuil à 0,05, nous attendons un taux de faux positifs de 0,6. Autrement dit, pour chaque test (sur les données nulles) comparant les 12 AMVR mensuels à la moyenne, 0,6 mois ressortiront comme significatifs (bien sûr, on ne peut pas avoir moins d'un mois, mais sur des répétitions, la moyenne tendra vers ce nombre).
Nous avons souligné l'importance de formuler clairement la question. Le problème ici est que nous avons supposé tester la significativité contre les 12 mois ! D'où une probabilité de faux positif « au moins un » élevée, à 46 %.
C'est un exemple de biais des comparaisons multiples : élargir l'espace de recherche augmente la probabilité de trouver un résultat « significatif ». On peut en abuser pour sélectionner des paramètres aboutissant à une p-valeur « désirée ».
C'est l'essence du p-hacking
Pour illustrer l'effet du p-hacking et comment réduire la multiplicité, distinguons deux questions, proches mais différentes :
La beauté de la simulation, c'est sa simplicité. Le code suivant suffit pour calculer la p-valeur de la 1re question. Nous comptons combien de valeurs dans nos 12 000 déviations AMVR (12 mois x 1 000 essais) dépassent la valeur observée de décembre. Nous obtenons une p-valeur de 4,4 %, proche de notre seuil arbitraire de 5 %, mais significative malgré tout.
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
Pour répondre à la 2e question et éviter la multiplicité, au lieu de comparer notre résultat à la distribution de toutes les 12 000 déviations, nous ne considérons que la plus haute valeur de chacune des 1 000 séries AMVR absolues. Nous obtenons alors une p-valeur de 23 %, clairement non significative !
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
Maintenant que nous avons les résultats finaux, traçons ces distributions pour illustrer l'effet du p-hacking et nos conclusions :
1. Nous utilisons np.quantile() pour repérer le seuil de 5 % et l'affichons avec axvline sur les graphiques du bas.
2. Nous définissons ensuite 4 sous-graphiques (2x2). plt.subplots renvoie « fig » (la figure) et « ax1, ax2, ax3, ax4 » (les sous-graphiques).
3. Le graphique 1 présente un histogramme de « abs_all_months » (type='bar'). Pour les graphiques du bas, nous mettons cumulative='True' pour afficher une CDF. Bins=30 est raisonnable ici. Nous formatons, ajoutons les lignes verticales pour la significativité et l'observation, etc.
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
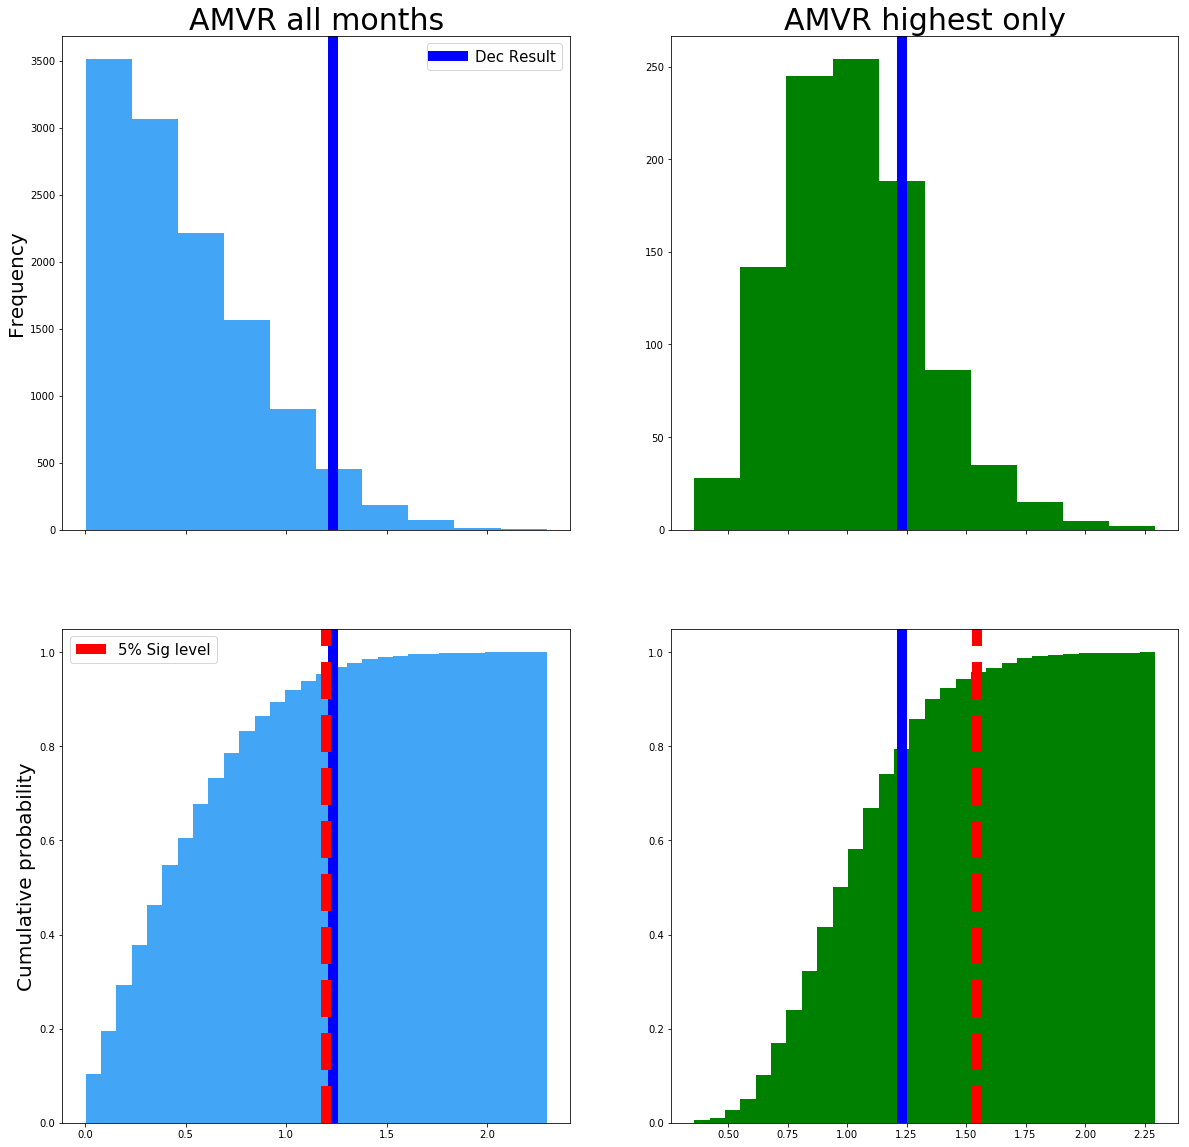
La colonne de gauche répond à la question 1 et celle de droite à la question 2. La ligne du haut montre les distributions de probabilité, celle du bas les CDF. La ligne rouge en pointillés est le seuil de 5 % que nous avons fixé. La ligne bleue est la valeur AMVR extrême de décembre (1,23).
À gauche, la valeur de décembre est significative à 5 %, de justesse. Mais en tenant compte du biais des comparaisons multiples, à droite, le seuil de significativité se déplace d'environ 1,2 (AMVR absolu) à près de 1,6 (voir la ligne rouge).
En corrigeant le biais des comparaisons multiples, notre valeur de décembre à 1,23 n'est plus significative !
En clarifiant la question posée et en évitant le biais des comparaisons multiples, nous évitons le p-hacking et la tentation d'afficher un résultat « significatif » qui ne l'est pas.
Pour approfondir le p-hacking et voir comment il peut orienter le récit que l'on fait de ses données, découvrez l'application interactive de FiveThirtyEight
Note des auteurs : Nos résultats diffèrent légèrement de la recherche Winton, en partie parce que le jeu de données n'est pas identique (32 ans vs 87 ans) et parce qu'ils retiennent octobre comme mois d'intérêt alors que nous avons décembre. Ils ont aussi utilisé une méthode non divulguée pour leurs « données simulées » tandis que nous avons explicité notre méthodologie par le code. Nous avons fait certains choix de modélisation tout au long de ce travail ; là encore, ils sont explicites dans le code. Ces choix relèvent du processus scientifique : tant qu'ils sont explicités, l'analyse a du sens.
Pour en savoir plus sur la finance avec Python, suivez le cours de DataCamp Intro to Python for Finance et consultez le Python For Finance Tutorial: Algorithmic Trading.
Suivez-moi sur twitter.com/pdquant pour la suite !
En savoir plus sur Python
Cours
Cours
Cours