Kurs
Einführung in Python für den Finanzbereich
4 Std.
106.6K
Oktober gilt historisch als der volatilste Börsenmonat. Aber ist das ein verlässliches Signal oder nur Rauschen in den Daten?
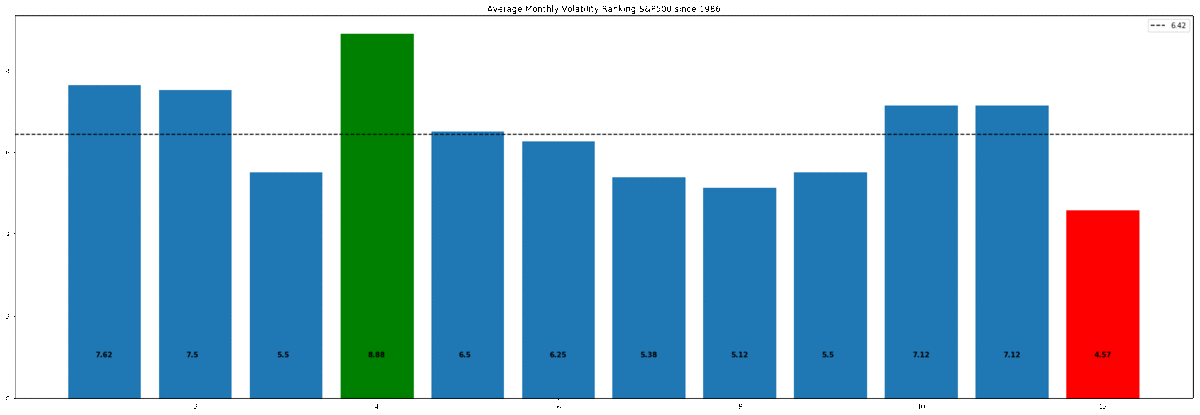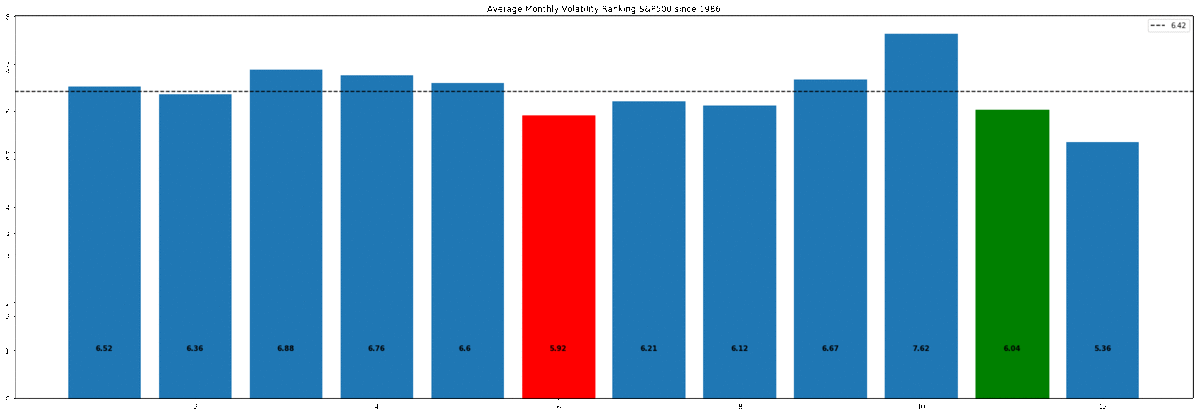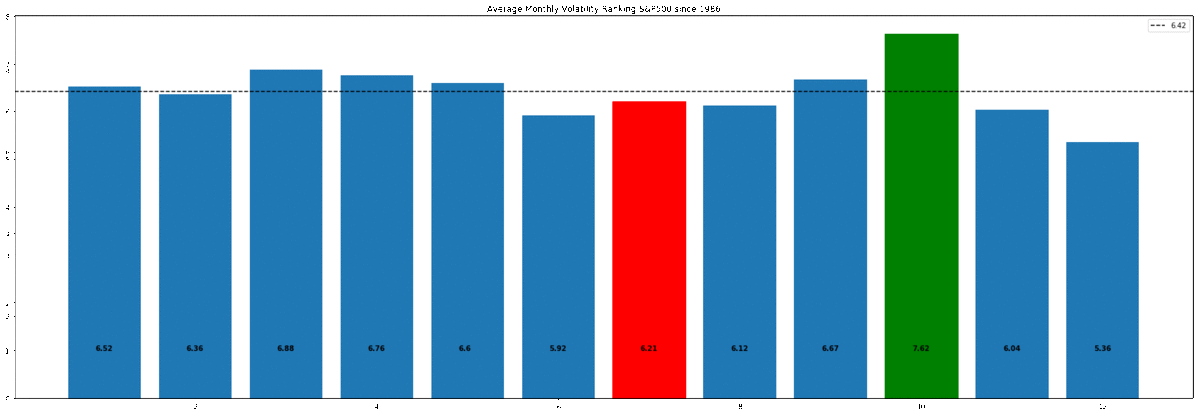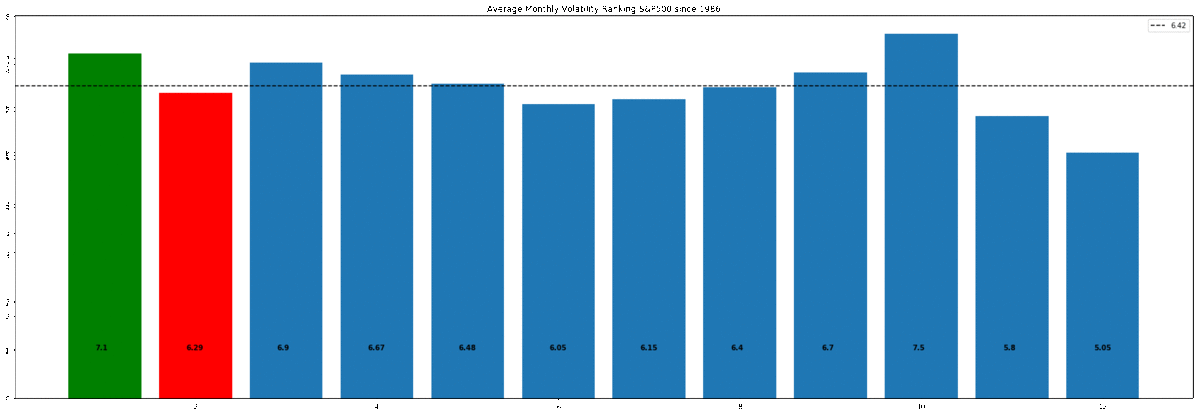
"In den letzten 32 Jahren war der Oktober im S&P500 im Schnitt der volatilste Monat, der Dezember der ruhigste".
In diesem Tutorial nutzen wir Python, um diese Beobachtung vollständig zu analysieren und zu testen – mit dem Ziel festzustellen, ob sie statistisch signifikant ist oder nicht.
Wir verwenden die Zeitreihenfunktionen von pandas, etwa Resample, um Rohdaten zu Aktienkursen so aufzubereiten, dass die zugrunde liegenden Muster sichtbar werden.
Anschließend zeigen wir, wie sich Hypothesentests in Python per Simulation statt mit umständlichen Formeln durchführen lassen.
Zum Schluss sprechen wir über ein zentrales Problem der Statistik, den Multiple-Comparison-Bias, lernen Gegenmaßnahmen kennen und visualisieren mit matplotlib den Effekt von "p-Hacking".
Für diese Analyse verwenden wir tägliche S&P500-Daten, konkret die täglichen Schlusskurse von 1986 bis 2018 (überraschend schwer zu finden, deshalb habe ich sie öffentlich bereitgestellt).
Die Inspiration für diesen Beitrag stammt von Winton, deren Analyse wir hier nachbauen – allerdings mit 32 statt 87 Jahren an Daten.
Um zu klären, ob die starke Volatilität in bestimmten Monaten wirklich signifikant und damit wahrscheinlich anhaltend ist, müssen wir unsere 32 Jahre Kursdaten in ein Format überführen, das das zu untersuchende Phänomen sichtbar macht.
Unser Zielformat sind die durchschnittlichen monatlichen Volatilitätsrankings (AMVR).
Der folgende Code zeigt, wie wir die Rohkurse in dieses Format bringen. Los geht’s!
Zuerst die Standard-Imports. (matplotlib.patches gibt uns Kontrolle über das Styling einzelner Balken in einem Histogramm)
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
Ein praktischer Trick, damit Charts in Jupyter-Notebooks über die volle Breite dargestellt werden:
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
Optional – probier es aus und schau, was passiert!
#plt.xkcd()
Wir importieren die Daten mit read_csv. Die Methode bekommt einen Pfad, in unserem Fall die URL zu den Daten. Außerdem setzen wir 'date' als Index und lassen die Datumsangaben automatisch parsen.
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
Das sind die ungeadjustierten Schlusskurse des S&P500 (SPX). Jetzt wandeln wir die Rohkurse in tägliche Prozentrenditen um. Dafür gibt es zwei Optionen:
Für unseren Zweck nehmen wir Methode 2, da pandas ein Dataset dieser Größe (über 8.000 Werte) mühelos verarbeitet. Außerdem bereinigen wir die Daten, indem wir den ersten Wert entfernen, der zu 'NaN' wird, weil es am ersten Tag keinen Vortagesvergleich gibt. pct_change() hat einen optionalen Parameter 'periods' für die Periodenverschiebung – wir lassen den Standardwert 1.
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
Als Nächstes transformieren wir diese täglichen Prozentveränderungen in „monatliche annualisierte Volatilität“. Die erste Codezeile unten zeigt, dass das in nur einer Zeile geht. Das ist die Stärke von pandas! Zerlegen wir die Schritte:
1. Für mnthly_annu nutzen wir zuerst die 'resample'-Methode auf den Tagesrenditen. Resample ändert die Frequenz der Datenperioden. Es nimmt eine "frequency offset string", also einen Buchstaben für die gewünschte neue Frequenz, z. B.:
Wir wollen von täglich auf monatlich resamplen, also übergeben wir 'M'.
2. Dann müssen wir festlegen, wie der neue Monatswert berechnet wird, z. B. Summe, Produkt etc. Für unsere Analyse brauchen wir ein Maß für Volatilität; die Standardabweichung eignet sich gut. Also hängen wir std() an die resample-Kette, um die monatliche Volatilität zu erhalten.
3. Zum Schluss annualisieren wir durch Multiplikation mit der Wurzel aus 12 (Monate pro Jahr). So erhalten wir die benötigten annualisierten Monatsvolatilitäten.
Best Practice in der Datenanalyse: Visualisiere die Daten fortlaufend. Schauen wir uns also die annualisierte Volatilität an.
Der folgende Plot zeigt große Marktphasen deutlich, etwa den Black Monday und die Finanzkrise 2008. Mit 'axvspan' in matplotlib fügen wir vertikale Bereiche hinzu (axhspan entsprechend horizontal). Die Parameter 'xmin' und 'xmax' setzen die Breite des Rechtecks; da unsere x-Achse ein Datetime-Index ist, können wir einfach die Jahre übergeben. Der Parameter alpha steuert die Transparenz, sodass die Kurve darunter sichtbar bleibt.
Mit mpatches erstellen wir eine individuelle Legende: Wir definieren 'labs' mit Farbe, Alpha und Text und übergeben sie als 'handles' an plt.legend.
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
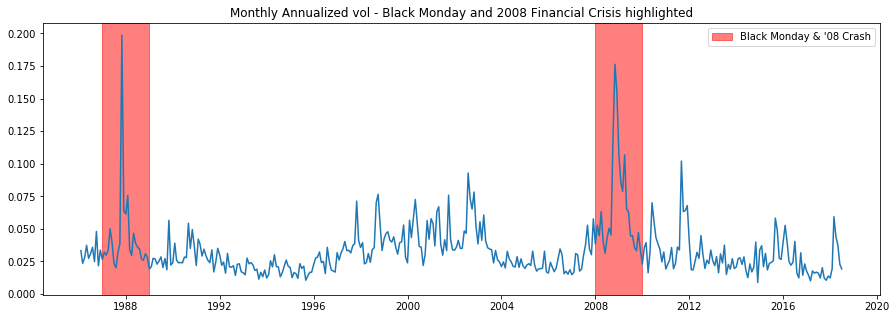
Wir haben also eine der starken pandas-Methoden gesehen: resample. Jetzt nutzen wir eine weitere, groupby. Wir wollen von den monatlichen annualisierten Volatilitäten zu unserem AMVR-Kennwert. Auch das gelingt in wenigen Zeilen.
1. Zuerst wenden wir 'groupby' auf mnthly_annu an. Groupby braucht einen Parameter, der angibt, wie gruppiert wird – Funktion oder, wie hier, eine Series. Wir übergeben 'mnthly_annu.index.year', also das Jahr aus dem Datetime-Index. Damit gruppieren wir die Monatsvolatilitäten für jedes der 32 Jahre.
2. Dann wenden wir die Methode rank an, die die Werte aufsteigend ordnet.
3. Schließlich wiederholen wir das nach Monaten und mitteln über alle Jahre. Das ergibt unsere finalen AMVR-Werte!
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
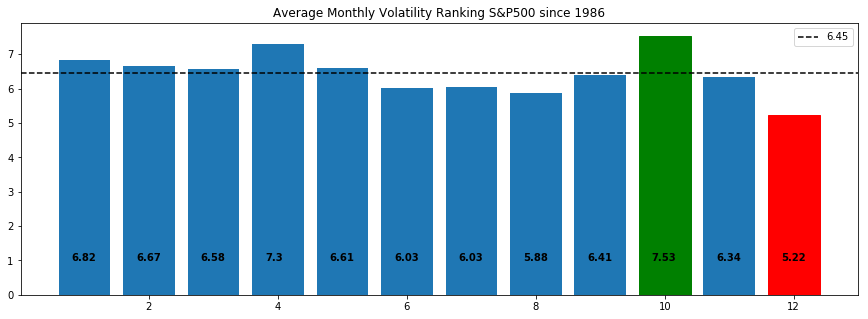
Damit haben wir die durchschnittlichen monatlichen Volatilitätsrankings. Numerisch sehen wir: Monat 10 (Oktober) ist am höchsten und 12 (Dezember) am niedrigsten.
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
Die passende Visualisierung ist entscheidend, um die Geschichte der Daten klar zu erzählen. Wir wollen die höchste und die niedrigste Volatilität deutlich hervorheben. Dafür nutzen wir das Balkendiagramm von matplotlib, annotieren die Werte und färben gezielt ein.
1. Indem wir b_plot mit dem gewünschten Balken indexieren (b_plot[9]), können wir Farbe setzen und so Höchst- und Tiefstwerte hervorheben.
2. Um die AMVR-Werte über ihren Balken anzuzeigen, iterieren wir per enumerate über 'final' und runden auf 2 Dezimalstellen. 'i' und 'v' sind dabei Index und Wert; 'i' läuft von 1–12. Diese Variablen übergeben wir an plt.text(). Der erste Parameter ist die x-Position (wir verschieben um 0,8 für die Zentrierung), der zweite die Zeichenkette des Werts.
3. Den Mittelwert zeigen wir mit axhline und fügen über 'label' eine Legende oben rechts hinzu.
Dieses Diagramm zeigt unser Phänomen am klarsten. Oktober ist am volatilsten, Dezember am ruhigsten. Wichtig: In absoluten Abweichungen vom Mittel ist Dezember extremer – das ist für die Analyse im nächsten Abschnitt relevant.
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
Das waren die Daten – weiter geht’s mit Hypothesentests …
Hypothesentests gehören zu den grundlegenden Techniken der Datenwissenschaft und wirken dennoch oft einschüchternd und missverständlich. Das liegt daran, wie sie in Statistik-Grundkursen vermittelt werden:
"Führe einen t-Test durch – einseitig oder zweiseitig? Wähle eine geeignete Teststatistik wie den Welch-t-Test, berechne Freiheitsgrade, den t-Wert, schlage den kritischen Wert in einer Tabelle nach, vergleiche ihn mit der Teststatistik …"
Kein Wunder, dass man unsicher ist, welchen Test man wie einsetzen soll. Viele klassische Verfahren entstanden in einer Zeit mit wenig Rechenleistung und liefern im Kern eine geschlossene Formel zur p-Wert-Berechnung – nicht mehr. Dazu kommt die Hürde, für jede Situation die richtige Formel mit oft restriktiven, teils undurchsichtigen Annahmen zu wählen.
Aber es gibt Grund zur Freude!
Es gibt einen besseren Weg: Simulation.
Um zu verstehen, wie Simulation hilft, rufen wir uns in Erinnerung, was ein Hypothesentest ist:
Wir wollen testen, „ob der beobachtete Effekt in unseren Daten real ist oder auch zufällig auftreten könnte“, und gehen dafür so vor:
So funktionieren Hypothesentests in drei Schritten! Egal welches Phänomen wir prüfen, die Frage ist immer: „Ist der beobachtete Effekt real oder Zufall?“
There is only one test! Dieser großartige Blog von Allen Downey geht tiefer auf Hypothesentests ein
Die eigentliche Stärke der Simulation ist, dass wir unsere Modellannahmen explizit im Code festhalten müssen. Klassische Verfahren wirken dagegen oft wie eine Blackbox, was ihre Annahmen angeht.
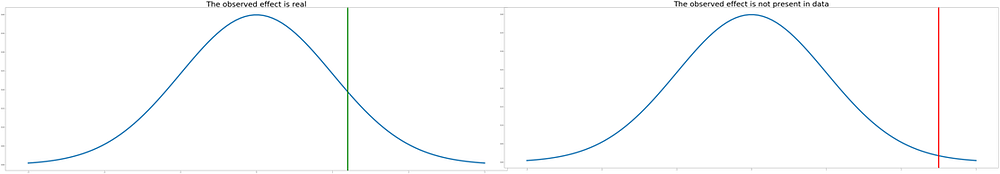
Beispiel unten: Links die echten Daten und der beobachtete Effekt mit einer gewissen Wahrscheinlichkeit (grün). Rechts unsere simulierten Null-Daten mit Markierung, wann der beobachtete Effekt zufällig auftauchte (rot). Darum geht es beim Hypothesentest: Wie wahrscheinlich ist der beobachtete Effekt unter der Null?
Der kritischste Teil eines Hypothesentests ist, die Frage glasklar zu formulieren. In unserem Fall fragen wir:
„Könnte der extremste Wert zufällig auftreten?“
Den extremsten Wert definieren wir als die größte absolute AMVR-Abweichung vom Mittelwert. Das ist unsere Nullhypothese.
In unseren Daten ist der extremste Wert der Dezember (1,23), nicht der Oktober (1,08), weil wir nach der größten absoluten Abweichung vom Mittel suchen, nicht nach der höchsten Volatilität.
1. Für die absolute Abweichung ziehen wir vom Mittelwert ab und wenden abs() an.
2. Mit sort_values() ordnen wir aufsteigend und wählen die zwei größten Werte, Okt und Dez, aus.
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
Jetzt, da wir die Frage definiert haben, brauchen wir unser „Nullmodell“.
Es gibt mehrere Ansätze:
Sampling ist ein großes Thema; wir fokussieren auf Permutation bzw. Shuffling.
Für das Nullmodell brauchen wir einen Datensatz ohne Saisonalität. Wenn die Null stimmt, dass es keine Saisonalität gibt und der beobachtete Effekt nur Zufall ist, sind die Monatslabels (Jan, Feb, …) bedeutungslos. Dann dürfen wir die Daten wiederholt durchmischen und so die Stichprobenverteilung der Teststatistik unter der Null aufbauen. Dadurch wird das beobachtete Phänomen (der extreme Dezemberwert) für alle Monate gleich wahrscheinlich – genau das verlangt unser Nullmodell.
Um die Power moderner Rechner zu demonstrieren, permutiert der Beispielcode sogar die täglichen Preisdaten – rechenintensiver, aber auf einem aktuellen CPU in Sekunden erledigt.
Hinweis: Das Mischen der täglichen oder der monatlichen Labels führt in unserem Fall zum gleichen Null-Datensatz.
Shuffle 'date' label to create null dataset

Ein hervorragender Einstieg ins Thema Sampling stammt von Julian Simon.
Hinweis: Unser Test ist durch die Konstruktion äquivalent zu einem zweiseitigen Test in der klassischen Methodik (z. B. Welch-t-Test oder ANOVA), da uns der extremste Wert in beide Richtungen (über oder unter dem Mittel) interessiert.
Diese Entscheidungen sind Designfragen – und das ist legitim, denn das Nullmodell ist eben ein Modell! Wichtig ist, die Fragestellung glasklar zu halten.
Wir wollen also viele Null-Datensätze in Python simulieren. Dazu erzeugen wir 1.000 Sätze mit je 12 AMVR, wobei wir jedes Mal die 'date'-Labels permutieren, um die Stichprobenverteilung zu erhalten. Die Ausgaben verwenden wir später im p-Hacking-Abschnitt.
1. Zuerst definieren wir Container für die Ergebnisse: ein pd.DataFrame() und ein einfaches Array [ ].
2. Dann einen Zähler auf null und eine For-Schleife über 1.000 Iterationen.
3. In der Schleife ziehen wir mit pandas sample() zufällig 8.191 Tageswerte (252 Handelstage × 32 Jahre). Mit reset_index() entfernen wir den alten Index, damit wir einen neuen setzen können. Der originale Datumsindex würde sonst mitgemischt – wir wollen aber nur die Daten „mischen“.
4. Danach vergeben wir einen neuen Datumsindex per pd.bdate_range in gleicher Länge. bdate_range statt date_range, weil wir nur Handelstage (Mo–Fr) wollen.
5. Auf den „gemischten“ Daten wenden wir die gleiche Aufbereitung wie zu Beginn an, um AMVR zu berechnen – das leisten die nächsten drei Zeilen.
6. Die simulierten AMVR-Werte hängen wir mit pd.concat spaltenweise (axis 1) an unser Sammel-DataFrame.
7. Maximonth speichert pro Simulation nur den höchsten AMVR-Wert (nutzen wir später für p-Hacking).
8. Da wir absolute AMVR-Abweichungen brauchen, flatten wir die 1.000 AMVR-Läufe zu einem Array, berechnen den Mittelwert, ziehen ihn ab und nehmen den Absolutbetrag.
9. Das Gleiche machen wir für die „nur höchste“-Werte. Hier nutzen wir eine Liste und berechnen per List Comprehension die abs(AMVR).
Damit haben wir alle Daten für die Analyse: die Originalbeobachtungen und den simulierten Datensatz.
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
Jetzt wird’s spannend. Wir haben eine Hypothese formuliert, die Null-Daten durch Mischen der 'date'-Labels erzeugt, und wollen nun testen, wie wahrscheinlich ein so signifikanter Dezember-Wert wäre, wenn die Null (keine Saisonalität) stimmt.
Bevor wir testen, justieren wir unsere Erwartungen.
Wie wahrscheinlich ist es, mindestens ein signifikantes Ergebnis zu sehen, bei einem Signifikanzniveau von 5%?
= 1 − p(nicht signifikant)
= 1 − (1 − 0,05)¹²
= 0,46
Es gibt also eine 46%-Chance, dass mindestens ein Monat signifikant erscheint, wenn die Null stimmt.
Und nun: Pro Einzeltst (Vergleich der absoluten AMVR jedes der 12 Monate mit dem Mittel) wieviele signifikante Werte erwarten wir in zufälligen, nicht-saisonalen Daten?
12 × 0,05 = 0,6
Bei 0,05 sollten wir also im Schnitt 0,6 Fehlalarme sehen. Anders gesagt: In jedem Test (unter der Null), der alle 12 Monate mit dem Mittel vergleicht, wird im Mittel 0,6 Monate „signifikant“ sein. (Klar, weniger als 1 Monat geht nicht, aber bei Wiederholung nähert sich der Erwartungswert 0,6 an).
Wir haben immer wieder betont, wie wichtig eine präzise Fragestellung ist. Das Problem an den obigen Erwartungen: Wir haben implizit getestet, ob einer von 12 Monaten signifikant ist! Deshalb ist die Wahrscheinlichkeit für mindestens einen Fehlalarm so hoch (46%).
Das ist ein Beispiel für den Multiple-Comparison-Bias. Wir erweitern den Suchraum und erhöhen damit die Chance, „signifikante“ Ergebnisse zu finden – was Missbrauch Tür und Tor öffnet, um p-Werte nach Wunsch zu „optimieren“.
Das ist der Kern von p-Hacking.
Um p-Hacking und die Reduktion von Multiplikität zu veranschaulichen, unterscheiden wir zwei subtil verschiedene Fragen:
Die Stärke der Simulation liegt in ihrer Einfachheit. Der folgende Code reicht, um den p-Wert für Frage 1 zu berechnen: Wir zählen, wie viele der insgesamt 12.000 AMVR-Abweichungen (12 Monate × 1.000 Versuche) größer sind als der beobachtete Dezemberwert. Ergebnis: p = 4,4%, nah an unserem etwas willkürlichen 5%-Cutoff, aber immer noch signifikant.
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
Für Frage 2 und zur Vermeidung von Multiplikität vergleichen wir nicht mit allen 12.000 Abweichungen, sondern betrachten nur den jeweils höchsten Wert aus jedem der 1.000 Läufe. Das ergibt einen p-Wert von 23% – klar nicht signifikant!
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
Nun visualisieren wir die Verteilungen, um den Effekt von p-Hacking und unsere Ergebnisse zu zeigen:
1. Mit np.quantile() bestimmen wir das 5%-Signifikanzniveau und zeichnen es in den unteren Plots per axvline ein.
2. Dann definieren wir vier Subplots. plt.subplots liefert 'fig' als Figure und 'ax1,ax2,ax3,ax4' als Achsenobjekte.
3. Plot 1 zeigt die erste Spalte: Ein Histogramm von 'abs_all_months' (oben) und darunter die kumulative Verteilung (cdf). Bins=30 ist hier sinnvoll. Mit axvline markieren wir Signifikanz- und Beobachtungswerte.
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
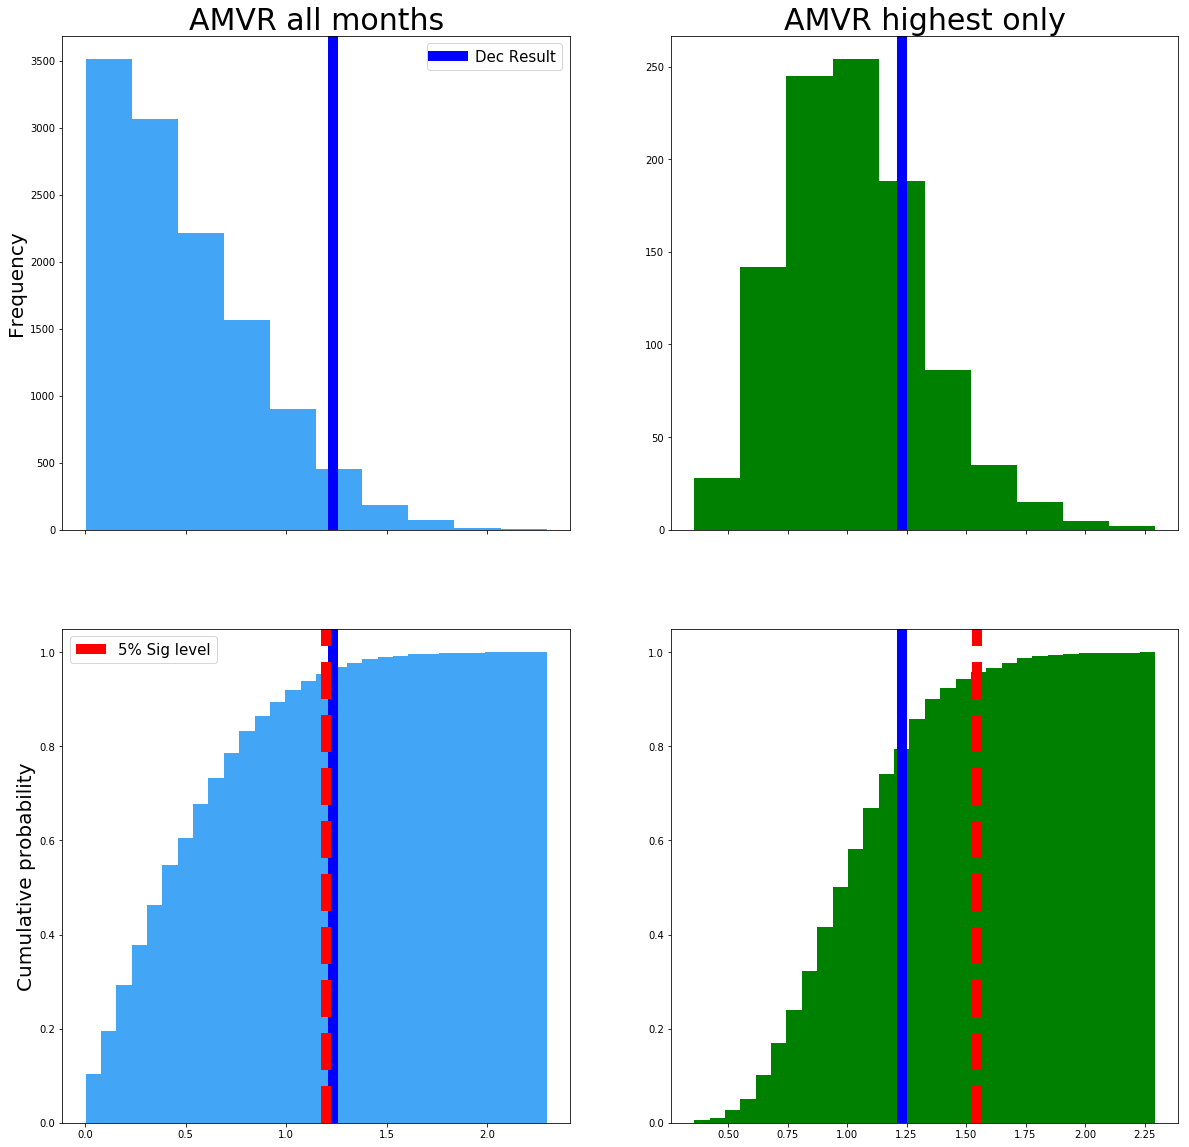
Die linke Spalte beantwortet Frage 1, die rechte Frage 2. Oben sind die Verteilungen, unten die CDFs. Die rote gestrichelte Linie markiert das willkürlich gewählte 5%-Niveau. Die blaue Linie ist der ursprüngliche extreme Dezemberwert von 1,23.
Links ist der Dezemberwert auf 5%-Niveau gerade so signifikant. Berücksichtigen wir jedoch den Multiple-Comparison-Bias, verschiebt sich rechts die Signifikanzschwelle von etwa 1,2 (abs AMVR) auf rund 1,6 (rote Linie).
Berücksichtigen wir den Multiple-Comparison-Bias, ist unser Dezemberwert von 1,23 nicht mehr signifikant!
Indem wir die genaue Fragestellung berücksichtigen und Multiple-Comparison-Bias vermeiden, umgehen wir p-Hacking und verhindern, dass wir fälschlich Signifikanz behaupten.
Mehr zu p-Hacking und wie es missbraucht werden kann, zeigt diese interaktive App von FiveThirtyEight.
Hinweis der Autor:innen: Unsere Ergebnisse weichen leicht von der Winton-Studie ab, teils wegen des anderen Datensatzes (32 vs. 87 Jahre) und weil dort der Oktober im Fokus steht, bei uns der Dezember. Außerdem nutzte Winton eine nicht offengelegte Methode für ihre „simulierten Daten“, während wir unsere Methodik im Code explizit machen. Wir haben im Verlauf Modellannahmen getroffen; auch diese sind offen gelegt. Solche Design- und Modellentscheidungen gehören zum wissenschaftlichen Prozess – solange sie transparent sind, ist die Analyse valide.
Wenn du mehr über Finance mit Python lernen willst, besuche DataCamps Kurs Intro to Python for Finance und sieh dir das Python For Finance Tutorial: Algorithmic Trading an.
Folge mir auf twitter.com/pdquant für mehr!
Erfahre mehr über Python
Kurs
Kurs
Kurs