कोर्स
Finance के लिए Python परिचय
4 घंटा
108.1K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंइतिहास में अक्टूबर को स्टॉक्स के लिए सबसे अधिक अस्थिर महीना माना जाता है, लेकिन क्या यह स्थायी सिग्नल है या सिर्फ डेटा में शोर?
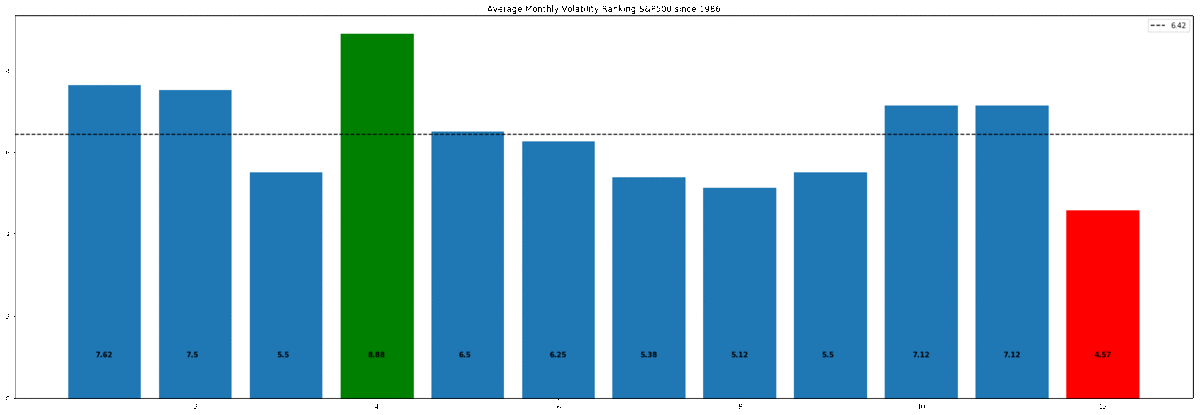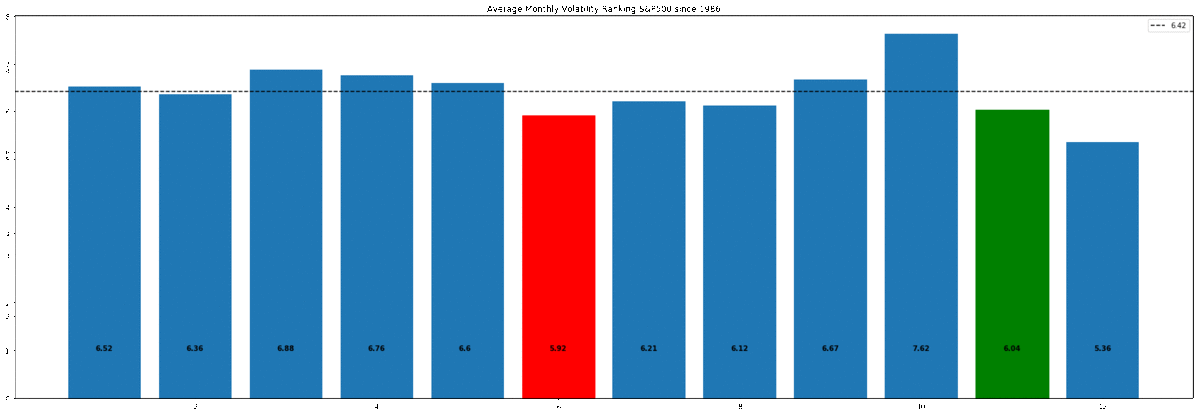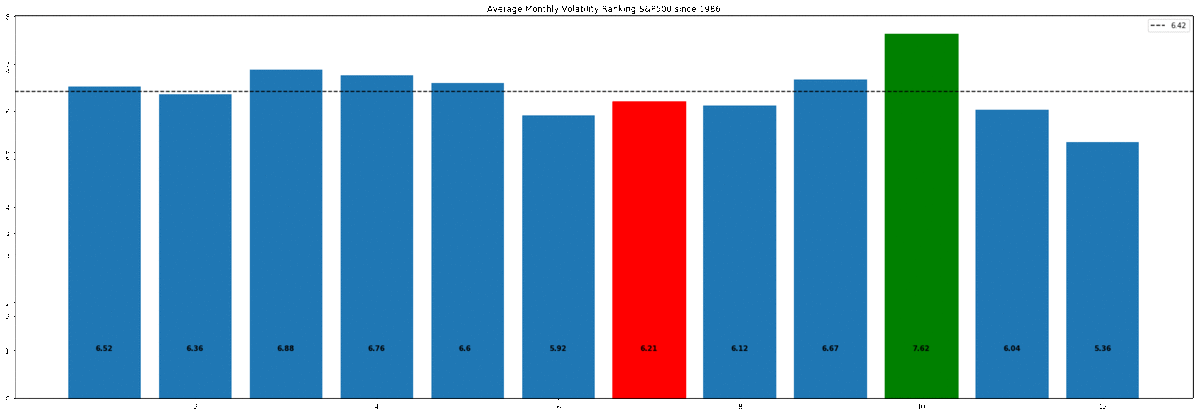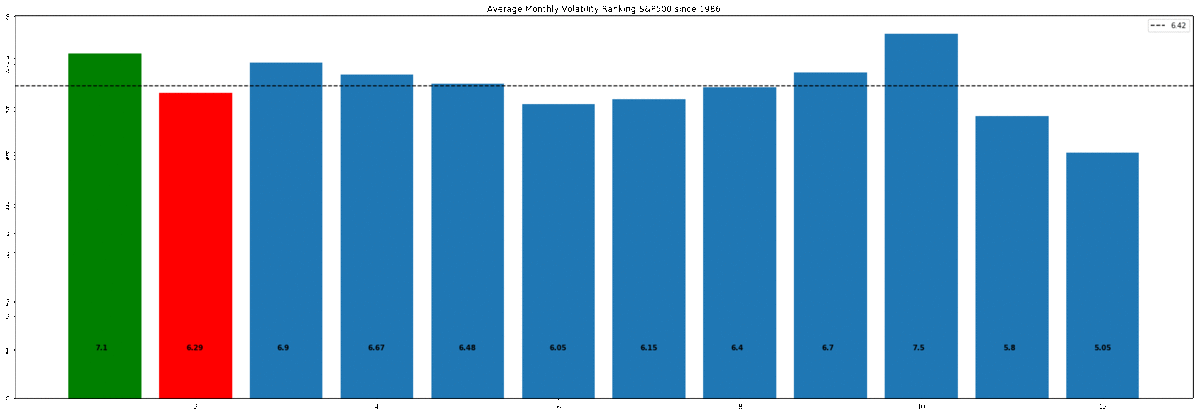
"पिछले 32 वर्षों में, औसतन S&P500 के लिए अक्टूबर सबसे अधिक अस्थिर महीना रहा है और दिसंबर सबसे कम अस्थिर".
इस ट्यूटोरियल में, हम Python का प्रयोग करके इस परिघटना का पूरा विश्लेषण और परीक्षण करेंगे, ताकि यह पता लगाया जा सके कि यह सांख्यिकीय रूप से महत्वपूर्ण है या नहीं।
हम pandas की टाइम सीरीज़ क्षमता, जैसे Resample, का उपयोग करके कच्चे स्टॉक प्राइस डेटा को ऐसे फ़ॉर्मेट में बदलेंगे जो डेटा को सजीव बना दे।
फिर हम जानेंगे कि कठिन सूत्रों के बजाय Python में सिमुलेशन के माध्यम से परिकल्पना परीक्षण कैसे किया जाए।
अंत में, हम सांख्यिकीय विश्लेषण की एक बड़ी समस्या, Multiple Comparison Bias, पर चर्चा करेंगे, उससे निपटने के तरीके सीखेंगे और matplotlib के जरिए दृश्य रूप से 'p‑हैकिंग' का प्रभाव दिखाएँगे।
हम इस विश्लेषण के लिए दैनिक S&P500 डेटा उपयोग करेंगे, विशेष रूप से 1986 से 2018 तक के कच्चे दैनिक क्लोज़िंग प्राइस (जो हैरानी की बात है कि ढूँढना मुश्किल है, इसलिए मैंने इसे सार्वजनिक रूप से उपलब्ध कराया है)।
इस पोस्ट की प्रेरणा Winton से आई, जिसे हम यहाँ पुनरुत्पादित करेंगे, भले ही हमारे पास उनके 87 वर्षों की तुलना में 32 वर्षों का डेटा हो।
यह जवाब देने के लिए कि क्या कुछ महीनों में देखी गई अत्यधिक अस्थिरता वास्तव में महत्वपूर्ण है और इसलिए जारी रहने की संभावना है, हमें अपने 32 वर्षों के प्राइस डेटा को ऐसे फ़ॉर्मेट में बदलना होगा जो उस परिघटना को दिखाए जिसकी हम जाँच कर रहे हैं।
हमारी पसंद का फ़ॉर्मेट होगा औसत मासिक वोलैटिलिटी रैंकिंग्स (AMVR)।
निम्नलिखित कोड दिखाता है कि हम अपने कच्चे प्राइस डेटा को इस फ़ॉर्मेट में कैसे लाएँ। आइए शुरू करें!
सबसे पहले मानक इम्पोर्ट्स। (matplotlib.patches हमें हिस्टोग्राम के भीतर व्यक्तिगत बार्स की स्टाइलिंग पर नियंत्रण देता है)
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
Jupyter नोटबुक्स में चार्ट्स को फुल-विड्थ दिखाने की एक अच्छी तरकीब:
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
यह वैकल्पिक है — आज़माएँ और देखें क्या होता है!
#plt.xkcd()
read_csv मेथड का उपयोग करके अपना डेटा इम्पोर्ट करें जो एक पाथ लेता है, हमारे मामले में डेटा का url। हम इसे यह भी बताते हैं कि 'date' को इंडेक्स के रूप में उपयोग करें और दिए गए टेक्स्ट से तारीखों को यथासंभव ऑटो-पार्स करें।
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
यह हमें S&P500 (SPX) के कच्चे, अनअजस्टेड क्लोज़िंग प्राइस देता है। अब हमें अपने कच्चे प्राइस को दैनिक % रिटर्न में बदलना है। इसके लिए हमारे पास दो विकल्प हैं:
हमारे उद्देश्य के लिए, हम मेथड 2 का उपयोग करेंगे, क्योंकि pandas इस आकार के डेटा सेट (8000 से अधिक वैल्यूज़) पर तुरंत गणना कर सकता है। हम डेटा को यह कहकर भी साफ करेंगे कि पहली वैल्यू हटा दें, जो 'NaN' बन जाती है क्योंकि पिछले दिन से कोई प्राइस परिवर्तन नहीं है। pct_change() एक वैकल्पिक पैरामीटर 'periods' लेता है जो पीरियड शिफ्ट बदलता है। हम इसे डिफॉल्ट एक पर ही छोड़ेंगे।
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
अगला कदम इन दैनिक % बदलाव वैल्यूज़ को 'मासिक वार्षिकीकृत वोलैटिलिटी' में बदलना है। नीचे की 1वीं कोड लाइन दिखाती है कि हम यह रूपांतरण केवल एक लाइन में कर सकते हैं। यही है Pandas की ताकत! लेकिन चलिए हर स्टेप को क्रमवार समझते हैं।
1. mnthly_annu पाने के लिए, हम पहले अपने दैनिक रिटर्न पर 'resample' मेथड का उपयोग करते हैं। Resample हमें डेटा पीरियड की फ़्रीक्वेंसी बदलने देता है। यह एक 'फ्रीक्वेंसी ऑफ़सेट स्ट्रिंग' लेता है या सरल शब्दों में, एक अक्षर जो वांछित नई फ्रीक्वेंसी से मेल खाता है। इनमें शामिल हैं:
क्योंकि हम दैनिक रिटर्न से मासिक पर रिसैंपल करना चाहते हैं, इसलिए हम पैरामीटर के रूप में 'M' पास करते हैं।
2. दूसरी चीज़ हमें यह तय करनी है कि इस नए मासिक आँकड़े तक कैसे पहुँचना है, जैसे कि हम दैनिक वैल्यूज़ को जोड़ सकते हैं, गुणा कर सकते हैं, आदि। हमारे विश्लेषण के लिए, हमें वोलैटिलिटी का कोई माप चाहिए और स्टैंडर्ड डिविएशन अच्छा काम करता है, इसलिए हम अपनी रिसैंपल्ड डेटा पर std() अपेंड करेंगे ताकि मासिक वोलैटिलिटी मिल सके।
3. अंतिम कदम है इस आँकड़े को वार्षिकीकृत करना। हम यह 12 के वर्गमूल से गुणा करके करते हैं, जहाँ 12 एक वर्ष में पीरियड (महीने) की संख्या है। इससे हमें हमारी आवश्यक वार्षिकीकृत मासिक वोलैटिलिटी वैल्यूज़ मिलती हैं।
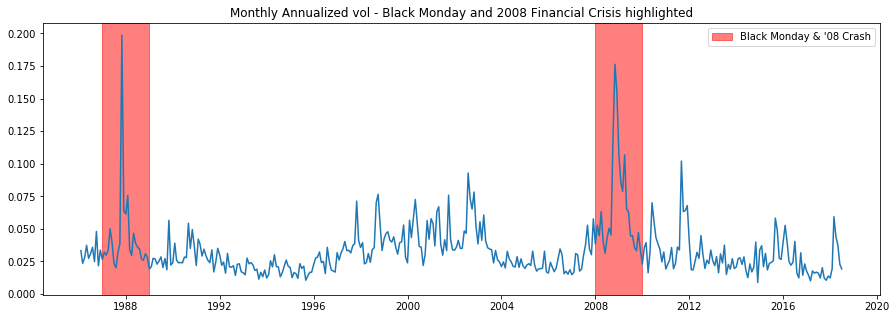
डेटा विश्लेषण में बेस्ट प्रैक्टिस है कि जैसे-जैसे आप विश्लेषण में आगे बढ़ें, डेटा को विज़ुअलाइज़ करते जाएँ। तो चलिए अपनी वार्षिकीकृत वोलैटिलिटी डेटा पर नज़र डालते हैं।
नीचे का प्लॉट प्रमुख बाज़ार घटनाओं को स्पष्ट रूप से दिखाता है, जैसे ब्लैक मंडे और 2008 की फाइनेंशियल क्राइसिस। matplotlib की 'axvspan' मेथड हमें वर्टिकल लाइन्स जोड़ने देती है (हॉरिज़ॉन्टल लाइन्स के लिए समकक्ष मेथड axhspan है), यह 'xmin' और 'xmax' पैरामीटर लेती है, जो बनाए गए रेक्टैंगल की चौड़ाई निर्दिष्ट करते हैं। क्योंकि हमारी x-एक्सिस डेटटाइम इंडेक्स है, हम आसानी से वे साल पास कर सकते हैं जिन्हें हाइलाइट करना है। alpha पैरामीटर ब्लॉक रंग की ट्रांसपेरेंसी को एडजस्ट करता है ताकि नीचे का ग्राफ़ दिखता रहे।
mpatches एट्रिब्यूट हमें एक कस्टम लीजेंड बॉक्स बनाने देता है। हम पहले 'labs' वेरिएबल को रंग, alpha और वांछित टेक्स्ट के साथ परिभाषित करते हैं, फिर 'handles' पैरामीटर के भीतर plt.legend को पास करके लीजेंड रेंडर करते हैं।
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
तो हमने pandas की एक शक्तिशाली मेथड, resample, देख ली। अब, एक और मेथड का उपयोग करते हैं, 'groupby'। हमें अपने मासिक वार्षिकीकृत वोलैटिलिटी वैल्यूज़ से वांछित AMVR मेट्रिक तक पहुँचना है। फिर से, हम इसे कुछ ही लाइनों में हासिल कर सकते हैं।
1. सबसे पहले, हम अपने mnthly_annu वैल्यूज़ पर 'groupby' मेथड लगाते हैं। Groupby को एक पैरामीटर चाहिए जो यह बताता है कि डेटा को कैसे ग्रुप करना है। यह कोई फंक्शन हो सकता है या हमारे मामले में, एक Series। हम 'mnthly_annu.index.year' पास करते हैं, जो बस mnthly_annu डेटा के डेटटाइम इंडेक्स का year एट्रिब्यूट है। यह हमारे डेटा सेट के 32 वर्षों में से प्रत्येक के लिए मासिक वोलैटिलिटी वैल्यूज़ को समूहित कर देगा।
2. अगला, हम 'rank' मेथड लगाते हैं, जो डेटा को आरोही क्रम में व्यवस्थित करती है।
3. अंत में, हम वही काम फिर करते हैं और प्रत्येक महीने के लिए सभी वर्षों पर औसत लेते हैं। इससे हमें अंतिम AMVR वैल्यूज़ मिलती हैं!
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
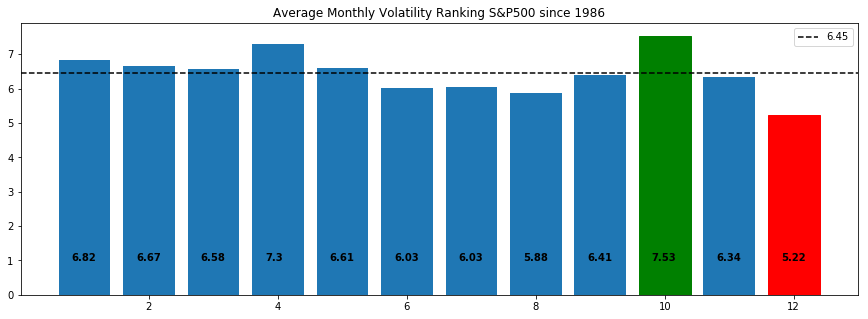
यह हमें अंतिम औसत मासिक वोलैटिलिटी रैंकिंग्स देता है। संख्यात्मक रूप से हम देखते हैं कि महीना 10 (अक्टूबर) सबसे ऊँचा और 12 (दिसंबर) सबसे नीचा है।
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
अपने डेटा के लिए सही विज़ुअलाइज़ेशन चुनना महत्वपूर्ण है क्योंकि हम सबसे प्रभावशाली चार्ट्स और प्लॉट्स के माध्यम से डेटा की कहानी बताना चाहते हैं। हमारे विश्लेषण के लिए, हम सबसे अधिक और सबसे कम वोलैटिलिटी को स्पष्ट रूप से दिखाना चाहते हैं। इसके लिए, हम matplotlib का बार चार्ट उपयोग करेंगे और अधिक प्रभाव के लिए एनोटेट और रंग देंगे।
1. इच्छित बार के साथ b_plot को इंडेक्स करके (b_plot[9]) हम सबसे अधिक और सबसे कम वैल्यूज़ को हाईलाइट करने के लिए रंग सेट कर सकते हैं।
2. उनके संबंधित बार पर AMVR वैल्यूज़ जोड़ने के लिए, हम प्रत्येक AMVR वैल्यू ('final' वेरिएबल) पर enumerate करते हैं और परिणाम को 2 दशमलव तक राउंड करते हैं। 'i' और 'v' 'final' वेरिएबल के 'index' और 'value' का प्रतिनिधित्व करते हैं, इसलिए 'i' 1–12 तक रहेगा, और 'value' AMVR वैल्यू देगा जिसे 2 दशमलव तक राउंड किया गया है। हम इन वेरिएबल्स को plt.text() में उपयोग करते हैं। plt.txt() का 1ला पैरामीटर लेबल के लिए x‑अक्ष लोकेशन है, इसलिए हम प्रत्येक बार के लिए 'i' पास करते हैं और 0.8 से ऑफ़सेट करते हैं ताकि यह सेंटर में आए। 2रा पैरामीटर 'final' वैल्यू का स्ट्रिंग संस्करण है।
3. औसत वैल्यू दिखाने के लिए, हम axhline का उपयोग करते हैं और 'label' वैल्यू का उपयोग करके ऊपर दाएँ कोने में लीजेंड जोड़ते हैं। बस y‑अक्ष वैल्यू पास करें, जो औसत है, फिर स्टाइलिंग जोड़ें।
यह अब तक का सबसे अच्छा दृश्य देता है उस परिघटना का जिसकी हम जाँच कर रहे हैं। हम स्पष्ट रूप से देख सकते हैं कि अक्टूबर सबसे अस्थिर महीना रहा है और दिसंबर सबसे कम। महत्वपूर्ण रूप से, हम यह भी देखते हैं कि एब्सोल्यूट टर्म्स में दिसंबर अधिक 'चरम' वैल्यू है। यह अगले सेक्शन के हमारे विश्लेषण के लिए महत्वपूर्ण होगा।
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
तो यह रहा हमारा डेटा, अब चलते हैं परिकल्पना परीक्षण पर…
परिकल्पना परीक्षण डेटा साइंस की सबसे बुनियादी तकनीकों में से एक है, फिर भी यह सबसे डरावनी और गलत समझी जाने वाली भी है। इस डर का आधार है Stats 101 में सिखाने का तरीका, जहाँ हमें बताया जाता है:
"t‑टेस्ट करें, क्या यह एक‑तरफ़ा है या दो‑तरफ़ा? Welch’s t‑टेस्ट जैसे उपयुक्त टेस्ट‑स्टैटिस्टिक चुनें, डिग्रीज़ ऑफ़ फ़्रीडम निकालें, t स्कोर निकालें, टेबल में क्रिटिकल वैल्यू देखें, क्रिटिकल वैल्यू की तुलना t स्टैटिस्टिक से करें ……"
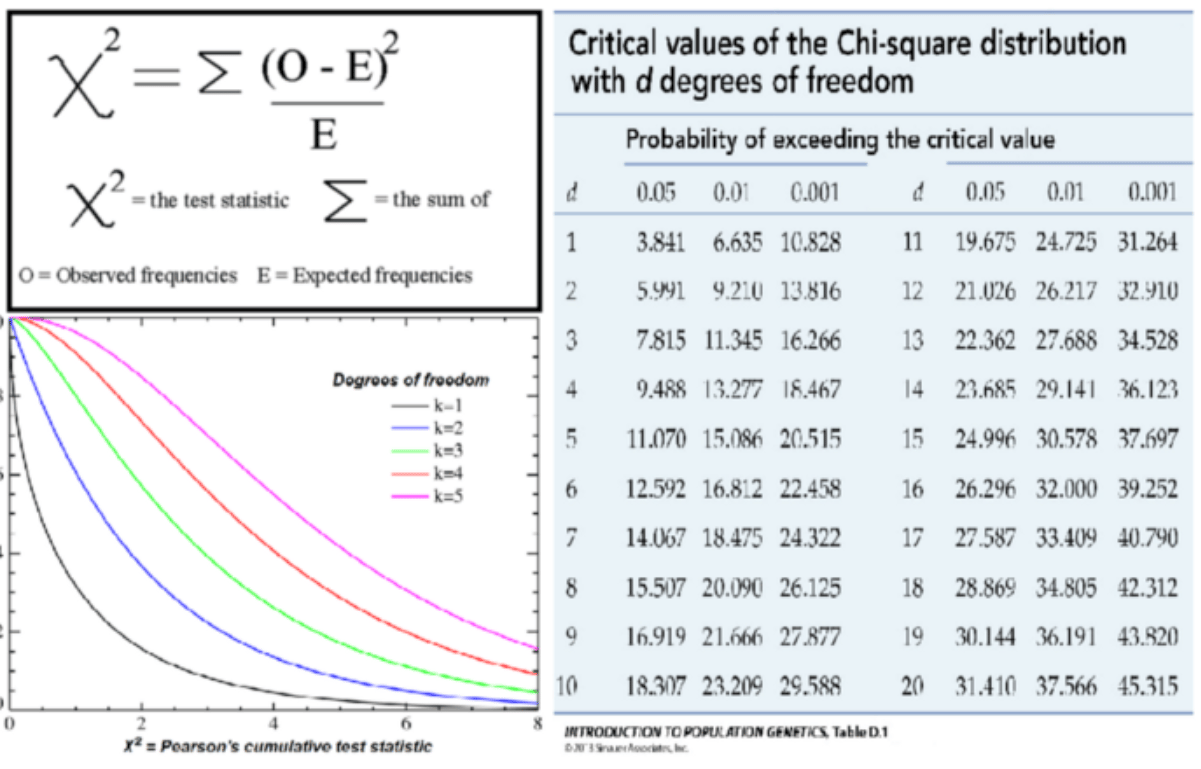
समझदारी से, इससे यह भ्रम होता है कि कौन सा टेस्ट करें और कैसे करें। हालाँकि, परिकल्पना परीक्षण के लिए ये सभी क्लासिकल सांख्यिकीय तकनीकें उस समय विकसित की गई थीं जब हमारे पास बहुत कम कंप्यूटिंग पावर थी, और वे बस p‑वैल्यू निकालने के क्लोज़्ड‑फॉर्म विश्लेषणात्मक समाधान थे, बस इतना ही! लेकिन उनके प्रतिबंधात्मक और कभी‑कभी अपारदर्शी अनुमानों के कारण दिए गए परिदृश्य के लिए सही सूत्र चुनने की अतिरिक्त जटिलता के साथ।
लेकिन खुश होइए!
एक बेहतर तरीका है। सिमुलेशन।
यह समझने के लिए कि सिमुलेशन हमारी कैसे मदद कर सकता है, चलिए खुद को याद दिलाएँ कि परिकल्पना परीक्षण क्या है:
हम यह जाँचना चाहते हैं कि “क्या हमारे डेटा में देखा गया प्रभाव वास्तविक है या यह केवल संयोग से हो सकता है” और इस परीक्षण को करने के लिए हम निम्न करते हैं:
यही है 3 स्टेप्स में परिकल्पना परीक्षण! हम चाहे जो भी परिघटना जाँच रहे हों, सवाल हमेशा एक जैसा है: “क्या देखा गया प्रभाव वास्तविक है, या यह संयोग से है”
Only one test है! Allen Downey का यह बढ़िया ब्लॉग परिकल्पना परीक्षण पर और विवरण देता है
सिमुलेशन की असली ताकत यह है कि हमें अपने मॉडल अनुमानों को कोड के जरिए स्पष्ट रूप से व्यक्त करना पड़ता है। जबकि क्लासिकल तकनीकें अपने अनुमानों के मामले में ‘ब्लैक‑बॉक्स’ हो सकती हैं।
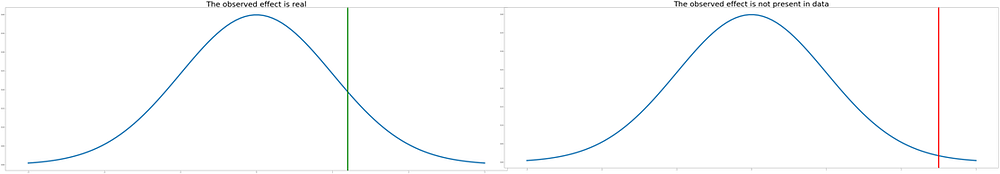
नीचे उदाहरण: बाएँ प्लॉट में वास्तविक डेटा और एक निश्चित प्रायिकता (हरा) के साथ देखा गया प्रभाव दिखता है। दाएँ प्लॉट हमारा सिमुलेटेड नल डेटा है जिसमें यह दर्ज है कि कब देखा गया प्रभाव संयोग से दिखा (लाल)। यही परिकल्पना परीक्षण का आधार है: हमारे नल डेटा पर देखा गया प्रभाव देखने की प्रायिकता क्या है।
परिकल्पना परीक्षण का सबसे महत्वपूर्ण हिस्सा है यह स्पष्ट होना कि हम कौन सा सवाल जवाब देना चाह रहे हैं। हमारे केस में हम पूछ रहे हैं:
“क्या सबसे चरम वैल्यू संयोग से हो सकती है?”
सबसे चरम वैल्यू को हम परिभाषित करते हैं औसत से सबसे बड़ा एब्सोल्यूट AMVR डिविएशन के रूप में। यही सवाल हमारी नल परिकल्पना बनाता है।
हमारे डेटा में, सबसे चरम वैल्यू दिसंबर (1.23) की है न कि अक्टूबर (1.08), क्योंकि हम औसत से सबसे बड़े एब्सोल्यूट डिविएशन को देख रहे हैं, सिर्फ सबसे अधिक वोलैटिलिटी को नहीं।
1. एब्सोल्यूट डिविएशन पाने के लिए, हम बस प्रत्येक वैल्यू से औसत घटाते हैं और abs() फंक्शन लगाते हैं।
2. sort_values() मेथड का उपयोग करके, हम परिणामों को सबसे छोटे से सबसे बड़े तक क्रमबद्ध कर सकते हैं। फिर 2 सबसे बड़ी वैल्यूज़, Oct और Dec, को चुन लें।
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
अब जब हमें पता है कि हम कौन सा सवाल पूछ रहे हैं, हमें अपना ‘नल मॉडल’ बनाना है।
यहाँ कई विकल्प हैं:
सैंपलिंग एक बड़ा विषय है, लेकिन हम एक खास तकनीक पर ध्यान देंगे, परम्यूटेशन या शफलिंग।
वांछित नल मॉडल पाने के लिए, हमें ऐसा डेटा सेट बनाना होगा जिसमें कोई सीजनैलिटी न हो। यदि नल सही है, कि डेटा में कोई सीजनैलिटी नहीं है और देखा गया प्रभाव केवल संयोग था, तो हर महीने (जन, फ़रवरी, आदि) के लेबल्स का कोई मतलब नहीं रह जाता और इसलिए हम डेटा को बार‑बार शफल कर सकते हैं ताकि क्लासिकल स्टैटिस्टिक्स जिसे ‘नल परिकल्पना के अंतर्गत टेस्ट स्टैटिस्टिक का सैंपलिंग डिस्ट्रीब्यूशन’ कहेंगे, बनाया जा सके। इसका वांछित प्रभाव यह है कि देखी गई परिघटना (चरम दिसंबर वैल्यू) सभी महीनों के लिए समान रूप से संभावित हो, जो हमारे नल मॉडल की ठीक आवश्यकता है।
यह दिखाने के लिए कि आधुनिक कंप्यूटिंग पावर के साथ सिमुलेशन तकनीकें कितनी शक्तिशाली हैं, इस उदाहरण का कोड वास्तव में दैनिक प्राइस डेटा को परम्यूट करेगा, जिसे बहुत अधिक प्रोसेसिंग पावर चाहिए, फिर भी यह एक आधुनिक CPU पर सेकंडों में पूरा हो जाता है।
नोट: हमारे केस में दैनिक या मासिक लेबल्स में से किसी को भी शफल करना हमें वांछित नल डेटा सेट देगा।
Shuffle 'date' label to create null dataset

सैंपलिंग सीखने के लिए एक बढ़िया संसाधन है Julian Simon।
नोट: हमारा टेस्ट जिस तरह से बना है, वह ‘क्लासिकल’ तरीकों जैसे Welch’s t‑टेस्ट या ANOVA आदि का दो‑तरफ़ा टेस्ट के समकक्ष है, क्योंकि हमें सबसे चरम वैल्यू में दिलचस्पी है, चाहे वह औसत से ऊपर हो या नीचे।
ये फ़ैसले डिज़ाइन चॉइसेज़ हैं, और हमारे पास यह स्वतंत्रता है क्योंकि नल मॉडल बस एक मॉडल ही है! इसका अर्थ है कि हम इसके पैरामीटर अपनी पसंद से निर्दिष्ट कर सकते हैं; कुंजी यह है कि हम किस सवाल का जवाब देना चाहते हैं, इसे वास्तव में स्पष्ट रखें।
तो हम Python का उपयोग करके बहुत सारा डेटा सिमुलेट करना चाहते हैं ताकि नल डेटा सेट बनाया जा सके। इसे हासिल करने के लिए, हम 12 AMVR के 1000 सेट सिमुलेट करेंगे, हर बार 'date' लेबल्स को परम्यूट करके सैंपलिंग डिस्ट्रीब्यूशन बनाएँगे। इस कोड का आउटपुट नीचे p‑हैकिंग सेक्शन में शामिल है।
1. पहले हम अपने परिणाम स्टोर करने के लिए कुछ कंटेनर्स परिभाषित करते हैं: हम pd.Dataframe() और एक सिंपल array [ ] का उपयोग करेंगे।
2. अगला, हम एक काउंटर परिभाषित करते हैं और उसे शून्य पर सेट करते हैं, फिर 1000 इटरेशन का for‑लूप शुरू करते हैं ताकि सिमुलेटेड डेटा बन सके।
3. for‑लूप की 1ली लाइन मूल दैनिक रिटर्न लेती है (ट्यूटोरियल की शुरुआत से) और pandas की sample() मेथड का उपयोग करती है। यह दिए गए बार दैनिक रिटर्न डेटा से रैंडम सैंपल लेती है। हमारे केस में, हमारे पास 8191 डेटा पॉइंट्स हैं (32 वर्षों में 252 ट्रेडिंग डेज़)। हम reset_index() का उपयोग करके इंडेक्स भी ड्रॉप करते हैं, ताकि नया इंडेक्स जोड़ सकें। हमें यह इसलिए करना है क्योंकि मूल डेट इंडेक्स डेटा के साथ शफल हो जाता है, जबकि हम केवल 'डेटा' को 'शफल' करना चाहते हैं।
4. अगली लाइन नए डेट इंडेक्स को जोड़ती है, daily_ret_shuffle इंडेक्स को मूल डेटा जितनी लंबाई के pd.bdate_range से पुनः असाइन करके। हम date_range के बजाय bdate_range का उपयोग करते हैं, क्योंकि हम हफ्ते में 7 दिन के बजाय बिज़नेस डेज़ (5, सोम–शुक्र) चाहते हैं।
5. अब जब हमने अपना 'शफल्ड' डेटा जेनरेट कर लिया है, हम वही डेटा रैंगलिंग करते हैं जो शुरुआत में AMVR वैल्यूज़ बनाने के लिए की थी। अगली 3 लाइनों का कोड यही करता है।
6. अब जब हमारे पास सिमुलेटेड AMVR वैल्यूज़ हैं, हमें उन्हें अपने डेटा फ्रेम में जोड़ना है जो सिमुलेशन की सभी 1000 रन स्टोर करेगा। pd.concat हमारे वर्तमान डेटा फ्रेम को लेता है और प्रत्येक सबसीक्वेंट डेटा फ्रेम को अंत में जोड़ देता है। हम axis 1 चुनते हैं, ताकि हमें कॉलम्स के रूप में डेटा मिले।
7. Maximonth एक वेरिएबल है जो प्रत्येक सिमुलेशन से केवल सबसे ऊँची वैल्यू स्टोर करता है (हम इसे बाद में अपने विश्लेषण में उपयोग करेंगे)।
8. क्योंकि हमारे विश्लेषण को एब्सोल्यूट AMVR वैल्यूज़ चाहिए, अगली 3 लाइनों का कोड सभी 1000 AMVR रन को एक बड़े एरे में फ्लैट कर देता है। फिर हम औसत लेते हैं और इस औसत से व्यक्तिगत वैल्यूज़ घटाते हैं और अंत में एब्सोल्यूट वैल्यू लेते हैं।
9. हम 'केवल सबसे ऊँची' डेटा के लिए भी यही करते हैं। नोट: यहाँ हमने डेटा फ्रेम के बजाय एक लिस्ट का उपयोग किया है जिसका मतलब है कि हम लिस्ट कॉम्प्रिहेंशन का उपयोग करके अपनी सबसे ऊँची वैल्यूज़ के लिए abs(AMVR) निकाल सकते हैं।
अब हमारे पास अपने विश्लेषण के लिए सभी आवश्यक डेटा हैं, मूल ऑब्ज़र्वेशंस भी और हमारा नया सिमुलेटेड डेटा सेट भी।
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
अब मज़ेदार हिस्सा आता है। हमने एक परिकल्पना बनाई, हमने डेटा के 'date' लेबल्स को शफल करके सिमुलेटेड डेटा जनरेट किया, अब हमें अपना परिकल्पना परीक्षण करना है ताकि यह पता चले कि नल परिकल्पना (कोई सीजनैलिटी नहीं) सत्य मानते हुए दिसंबर जैसा महत्वपूर्ण परिणाम देखने की प्रायिकता क्या है।
टेस्ट करने से पहले अपनी अपेक्षाएँ सेट करते हैं।
5% सिग्निफिकेंस लेवल दिए जाने पर कम से कम एक महत्वपूर्ण परिणाम देखने की प्रायिकता क्या है?
= 1‑p(महत्वपूर्ण नहीं)
= 1‑(1–0.05)¹²
= 0.46
तो 46% चांस है कि हमारा नल सत्य होने पर कम से कम एक महीने में महत्वपूर्ण परिणाम दिखे।
अब पूछते हैं, प्रत्येक व्यक्तिगत टेस्ट के लिए (12 महीनों के प्रत्येक एब्सोल्यूट AMVR की औसत से तुलना) हम अपने रैंडम, नॉन‑सीज़नल डेटा में कितने महत्वपूर्ण मान देखने की अपेक्षा करें?
12 x 0.05 = 0.6
तो 0.05 सिग्निफिकेंस लेवल के साथ, हमें 0.6 का फ़ॉल्स पॉज़िटिव रेट अपेक्षित है। दूसरे शब्दों में, प्रत्येक टेस्ट (नल डेटा के साथ) में सभी 12 महीनों के AMVR की औसत से तुलना करते हुए, 0.6 महीने महत्वपूर्ण परिणाम दिखाएँगे। (स्पष्ट है, हम 1 से कम महीने नहीं दिखा सकते, लेकिन रिपीट टेस्टिंग पर गणित इसी संख्या की ओर झुकेगा).
इस पूरी कवायद में, हमने इस बात पर ज़ोर दिया है कि हम जो सवाल जवाब देना चाहते हैं, उसे बहुत स्पष्ट रखें। अभी जो अपेक्षाएँ हमने निकालीं उनका मसला यह है कि हमने मान लिया कि हम सभी 12 महीनों के खिलाफ एक महत्वपूर्ण परिणाम का परीक्षण कर रहे हैं! यही वजह है कि कम से कम एक फ़ॉल्स पॉज़िटिव देखने की प्रायिकता 46% जैसी ऊँची है।
यह मल्टिपल कम्पैरिजन बायस का उदाहरण है, जहाँ हमने अपने सर्च स्पेस का विस्तार कर दिया और महत्वपूर्ण परिणाम पाने की संभावना बढ़ा दी। यह समस्या है क्योंकि हम इस परिघटना का दुरुपयोग करके अपने मॉडल के उन पैरामीटर्स को चेरी‑पिक कर सकते हैं जो हमें ‘वांछित’ p‑वैल्यू देते हैं।
यही है p‑हैकिंग का सार
p‑हैकिंग के प्रभाव और मल्टिप्लिसिटी को कैसे घटाएँ, यह दिखाने के लिए हमें निम्न 2 सवालों के बीच सूक्ष्म परंतु महत्वपूर्ण अंतर समझना होगा:
सिमुलेशन की खूबसूरती इसकी सादगी में है। निम्न कोड 1ले सवाल का p‑वैल्यू निकालने के लिए पर्याप्त है। हम बस गिनते हैं कि हमारे डेटा सेट में सभी 12000 AMVR डिविएशंस (12 महीने x 1000 ट्रायल्स) में से कितनी वैल्यूज़ देखी गई दिसंबर वैल्यू से बड़ी हैं। हमें 4.4% का p‑वैल्यू मिलता है, जो हमारे कुछ हद तक मनमाने 5% कट‑ऑफ के क़रीब है, लेकिन फिर भी महत्वपूर्ण।
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
2रे सवाल का जवाब देने और मल्टिप्लिसिटी से बचने के लिए, सभी 12000 AMVR डिविएशंस से बनी डिस्ट्रीब्यूशन से तुलना करने के बजाय, हम हर एक 1000 ट्रायल के एब्सोल्यूट AMVR में से केवल सबसे ऊँची वैल्यू को ही मानते हैं। इससे 23% का p‑वैल्यू मिलता है, जो साफ तौर पर महत्वपूर्ण नहीं है!
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
अब जब हमारे पास अंतिम परिणाम हैं, तो इन डिस्ट्रीब्यूशनों को प्लॉट करते हैं ताकि p‑हैकिंग का प्रभाव और हमारे विश्लेषण के नतीजे दृश्य रूप में दिखें:
1. पहले np.quantile() का उपयोग करके 5% सिग्निफिकेंस लेवल निकालते हैं, इसे हम नीचे के प्लॉट्स में axvline से दिखाएँगे।
2. फिर हम अपनी 4 बॉक्स सबप्लॉट्स परिभाषित करते हैं। यहाँ plt.subplots 'fig' = हमारी फ़िगर और 'ax1,ax2,ax3,ax4' = 4 सबप्लॉट्स के वेरिएबल्स लौटाता है।
3. #प्लॉट 1 पहला कॉलम दिखाता है। यहाँ हम बस अपने डेटा 'abs_all_months' का हिस्टोग्राम परिभाषित करते हैं और type='bar' चुनते हैं। नीचे के प्लॉट्स के लिए हम cumulative='True' सेट करते हैं, इससे हमें pdf की जगह cdf मिलता है। Bins यह तय करता है कि हर वैल्यू को भरने के लिए कितनी बार्स हों, हमारे डेटा के लिए 30 एक उचित संख्या है। फिर हम पहले सीखी तकनीकों से प्लॉट्स को फॉर्मैट करते हैं, जैसे सिग्निफिकेंस और ऑब्ज़र्वेशन वैल्यूज़ दिखाने के लिए axvline।
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
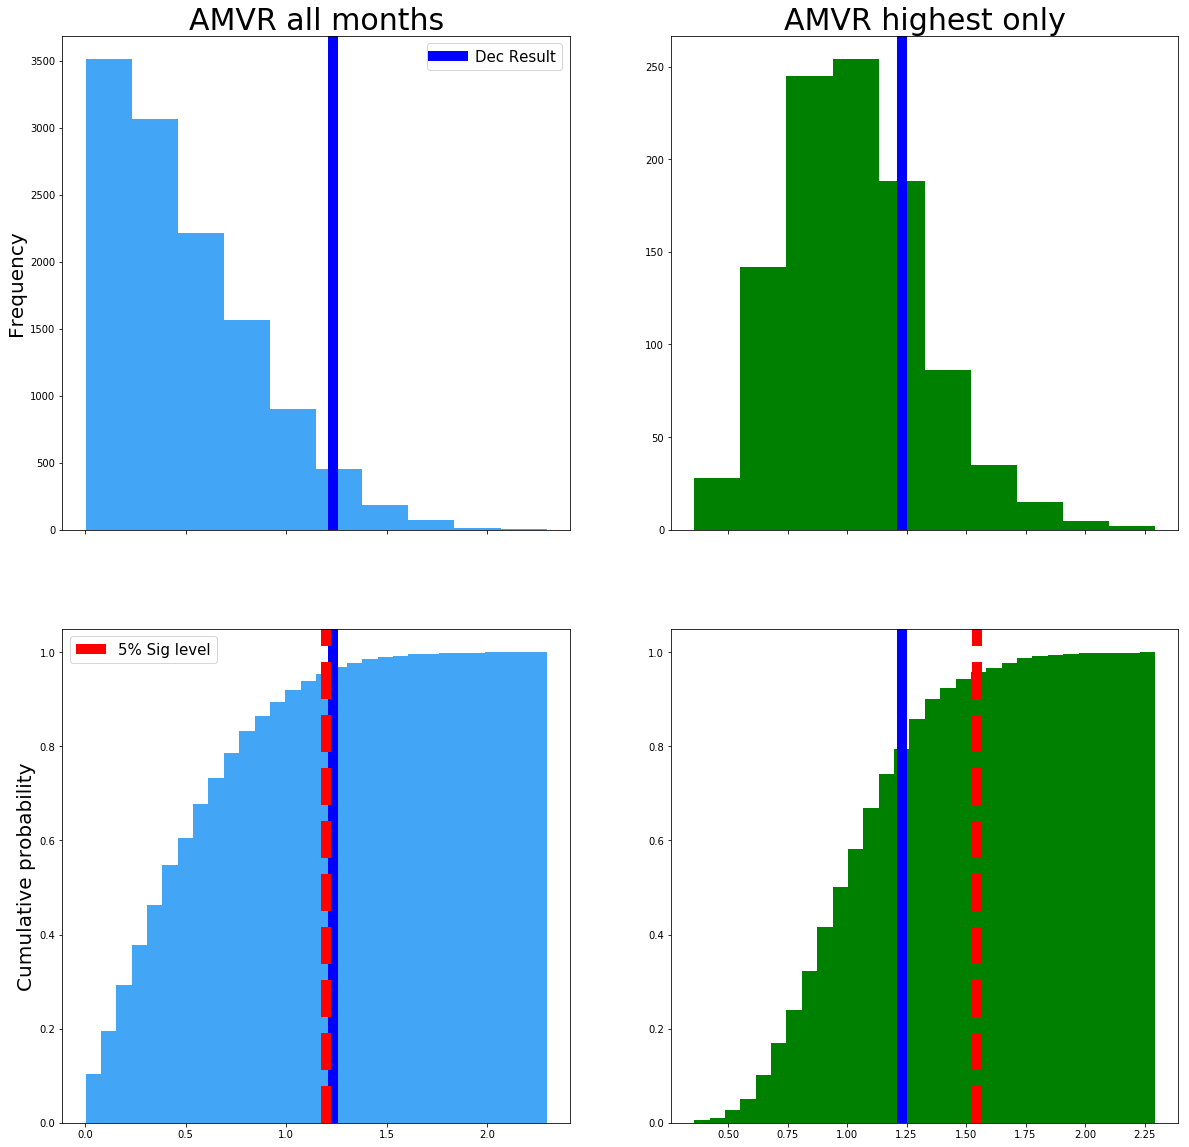
बाएँ कॉलम का डेटा सवाल 1 का जवाब देता है और दाएँ कॉलम सवाल 2 का। ऊपर की पंक्ति प्रायिकता डिस्ट्रीब्यूशंस है, और नीचे की पंक्ति CDF। लाल डैश्ड लाइन वह 5% सिग्निफिकेंस लेवल है जो हमने मनमाने रूप से तय किया। नीली लाइन मूल चरम दिसंबर AMVR वैल्यू 1.23 है।
बाएँ प्लॉट दिखाता है कि मूल दिसंबर वैल्यू 5% लेवल पर महत्वपूर्ण है, लेकिन बस थोड़ा! हालाँकि, जब हम मल्टिपल कम्पैरिजन बायस का हिसाब रखते हैं, तो दाएँ प्लॉट में सिग्निफिकेंस की दहलीज लगभग 1.2 (abs AMVR) से बढ़कर लगभग 1.6 हो जाती है (लाल रेखा देखें)।
मल्टिपल कम्पैरिजन बायस का हिसाब रखने पर, हमारी दिसंबर वैल्यू 1.23 अब महत्वपूर्ण नहीं रहती!
जिस खास सवाल का जवाब हम देना चाहते हैं उसे ध्यान में रखकर और मल्टिपल कम्पैरिजन बायस से बचकर, हमने अपने मॉडल को p‑हैकिंग से बचाया और वहाँ महत्वपूर्ण परिणाम दिखाने से बचे जहाँ वास्तव में कुछ नहीं था।
p‑हैकिंग को और एक्सप्लोर करने और यह कैसे किसी खास कहानी के लिए दुरुपयोग हो सकता है, यह देखने के लिए FiveThirtyEight का यह शानदार इंटरैक्टिव ऐप देखें
लेखक के नोट्स: हमारे परिणाम मूल Winton शोध से थोड़ा अलग हैं, आंशिक रूप से इसलिए कि हमारा डेटा सेट कुछ अलग है (32 वर्ष बनाम 87 वर्ष) और उनके यहाँ अक्टूबर रुचि का महीना है जबकि हमारे यहाँ दिसंबर। साथ ही, उन्होंने अपने ‘सिमुलेटेड डेटा’ के लिए एक अप्रकाशित विधि का उपयोग किया जबकि हमने उस डेटा को बनाने की अपनी कार्यप्रणाली कोड के माध्यम से स्पष्ट की है। हमने इस काम में कुछ मॉडलिंग मान्यताएँ बनाई हैं, जिन्हें फिर स्पष्ट रूप से कोड में देखा जा सकता है। ये डिज़ाइन और मॉडलिंग चॉइसेज़ वैज्ञानिक प्रक्रिया का हिस्सा हैं; जब तक वे स्पष्ट हैं, विश्लेषण का महत्व है।
यदि आप Python में फ़ाइनेंस के बारे में और सीखना चाहते हैं, तो DataCamp का Intro to Python for Finance कोर्स लें और देखें Python For Finance Tutorial: Algorithmic Trading।
मुझे twitter.com/pdquant पर फ़ॉलो करें!
Python के बारे में और जानें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें