Curso
Introdução ao Python para finanças
4 h
106.6K
Outubro é historicamente o mês mais volátil para ações, mas isso é um sinal persistente ou apenas ruído nos dados?
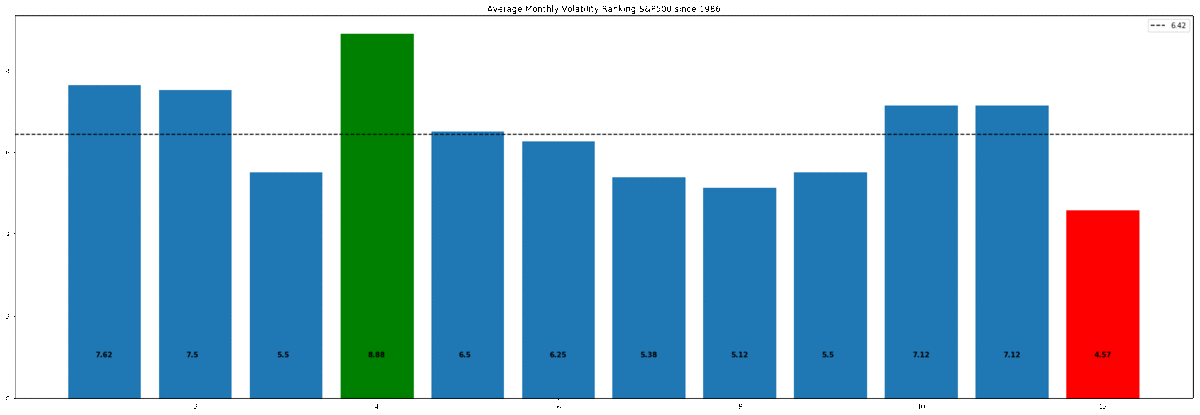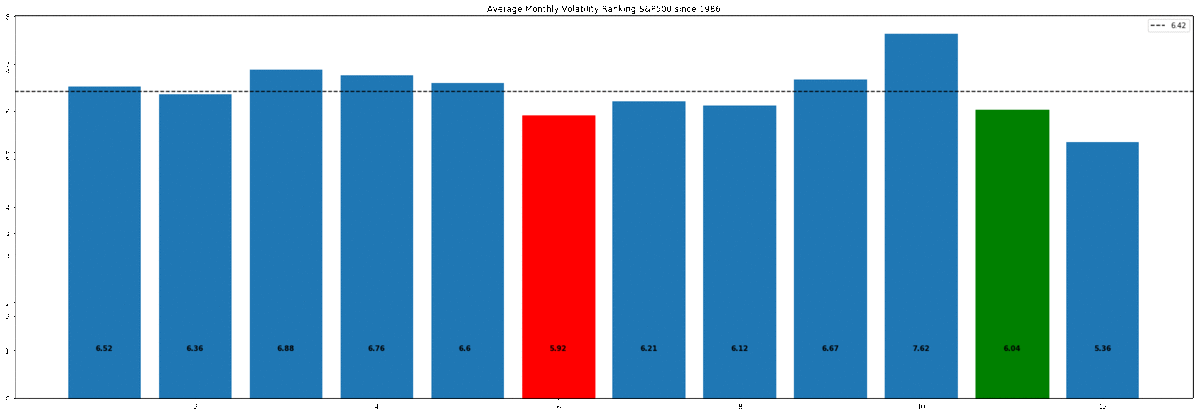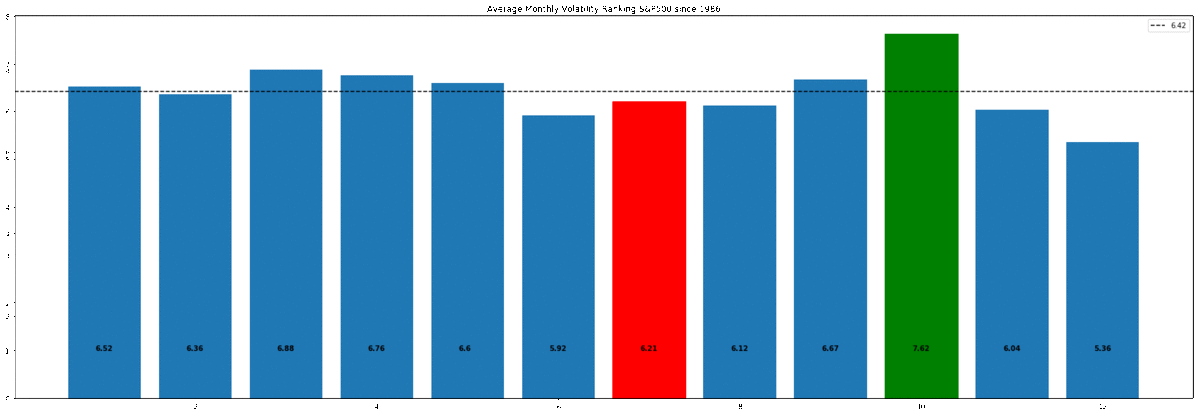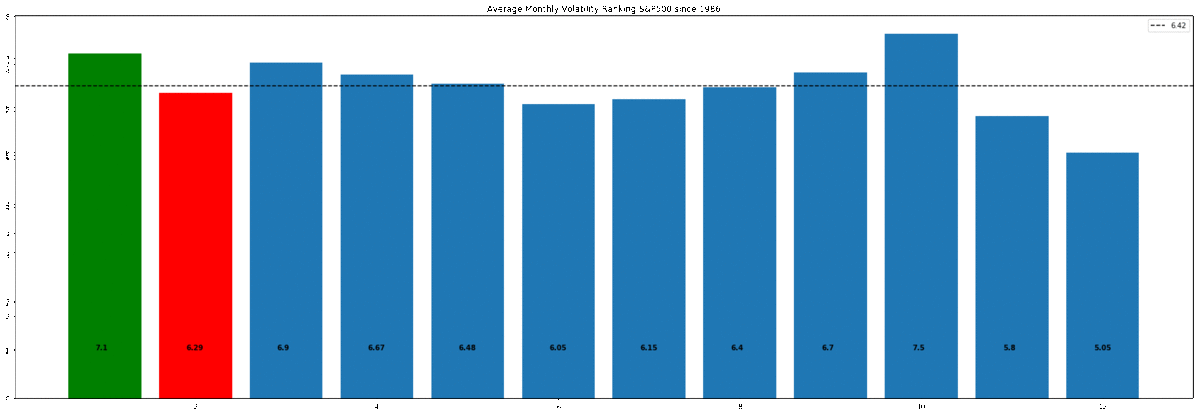
"Nos últimos 32 anos, outubro foi, em média, o mês mais volátil para o S&P500 e dezembro o menos volátil".
Neste tutorial, vamos usar Python para percorrer uma análise completa e testar esse fenômeno para verificar se ele é estatisticamente significativo ou não.
Vamos usar os recursos de séries temporais do pandas, como Resample, para transformar os preços brutos das ações em um formato que dê vida aos dados.
Em seguida, vamos ver como conduzir testes de hipótese usando simulação em Python, em vez de fórmulas trabalhosas.
Por fim, vamos discutir um grande problema em análises estatísticas, o viés de múltiplas comparações, aprender como lidar com ele e mostrar visualmente, via matplotlib, o efeito do "p-hacking".
Usaremos dados diários do S&P500 para esta análise; em particular, usaremos os preços de fechamento diários brutos de 1986 a 2018 (o que é surpreendentemente difícil de encontrar, então eu os tornei publicamente disponíveis).
A inspiração para este post veio da Winton, cuja análise vamos reproduzir aqui, embora com 32 anos de dados contra os 87 anos deles.
Para responder se a volatilidade extrema vista em certos meses é realmente significativa e, portanto, tende a continuar, precisamos transformar nossos 32 anos de preços em um formato que evidencie o fenômeno que estamos investigando.
O formato escolhido será o ranking médio mensal de volatilidade (AMVR).
O código a seguir mostra como levamos os preços brutos até esse formato. Vamos lá!
Primeiro, os imports padrão. (matplotlib.patches nos dá controle sobre o estilo de barras individuais em um histograma)
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
Um truque útil para fazer os gráficos ocuparem a largura total no Jupyter Notebook:
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
Este é opcional — teste para ver o que acontece!
#plt.xkcd()
Importe os dados usando read_csv, que recebe um caminho, no nosso caso uma URL. Também informamos para usar "date" como índice e analisar as datas automaticamente a partir do texto, da melhor forma possível.
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
Isso nos dá os preços de fechamento brutos e não ajustados do S&P500 (SPX). Agora precisamos converter esses preços em retornos diários em %. Para isso, temos duas opções:
Para nosso propósito, vamos usar a opção 2, já que o pandas dá conta da computação instantaneamente em um conjunto desse tamanho (mais de 8 mil valores). Também vamos limpar os dados removendo o primeiro valor, que vira 'NaN' por não haver variação em relação ao dia anterior. pct_change() aceita o parâmetro opcional 'periods' para alterar o deslocamento; vamos manter o padrão (1).
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
O próximo passo é pegar essas variações diárias em % e transformá-las em "volatilidade mensal anualizada". A primeira linha de código abaixo mostra que dá para fazer isso em apenas uma linha. Esse é o poder do pandas! Mas vamos detalhar passo a passo.
1. Para obter mnthly_annu, primeiro usamos 'resample' nos retornos diários. Resample permite mudar a frequência dos períodos. Ele recebe uma "string de frequência", isto é, uma letra que corresponde à nova frequência desejada, como:
Como queremos reagrupar de diário para mensal, passamos 'M' como parâmetro.
2. Depois, precisamos decidir como chegar a esse valor mensal. Poderíamos somar, multiplicar, etc. Para nossa análise, queremos uma medida de volatilidade; o desvio padrão funciona bem, então aplicamos std() aos dados reamostrados para obter a volatilidade mensal.
3. O passo final é anualizar esse valor. Fazemos isso multiplicando pela raiz quadrada de 12, sendo 12 o número de períodos (meses) no ano. Isso nos dá a volatilidade mensal anualizada que precisamos.
Boas práticas em análise de dados recomendam visualizar os dados ao longo do processo. Então vamos ver nossa volatilidade anualizada.
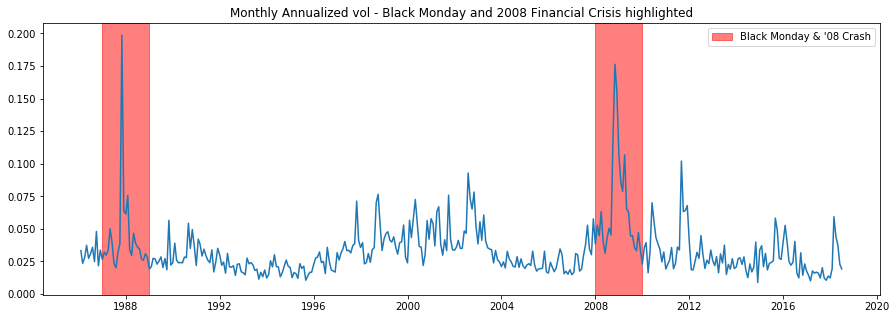
O gráfico abaixo evidencia eventos marcantes do mercado, como a Black Monday e a crise financeira de 2008. O método 'axvspan' do matplotlib permite adicionar faixas verticais (axhspan é o correspondente horizontal). Ele recebe 'xmin' e 'xmax' que especificam a largura do retângulo; como o eixo x é um índice datetime, podemos simplesmente passar os anos a destacar. O parâmetro alpha ajusta a transparência para ainda enxergarmos o gráfico por baixo.
O atributo mpatches permite criar uma legenda personalizada. Definimos a variável 'labs' com cor, alpha e texto desejado e passamos em 'handles' no plt.legend para renderizar a legenda.
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
Vimos um método poderoso do pandas, o resample. Agora, vamos usar outro, o groupby. Precisamos ir da volatilidade mensal anualizada ao nosso AMVR desejado. Dá para fazer isso em poucas linhas.
1. Primeiro, aplicamos 'groupby' aos valores de mnthly_annu. Groupby precisa de um parâmetro que especifique como agrupar. Pode ser uma função ou, como no nosso caso, uma Series. Passamos 'mnthly_annu.index.year', que é o atributo de ano do índice datetime de mnthly_annu. Isso agrupa a volatilidade mensal para cada um dos 32 anos do conjunto.
2. Em seguida, aplicamos o método rank, que ordena os dados em ordem crescente.
3. Por fim, repetimos o processo e tiramos a média, por mês, ao longo de todos os anos. Isso nos dá o AMVR final!
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
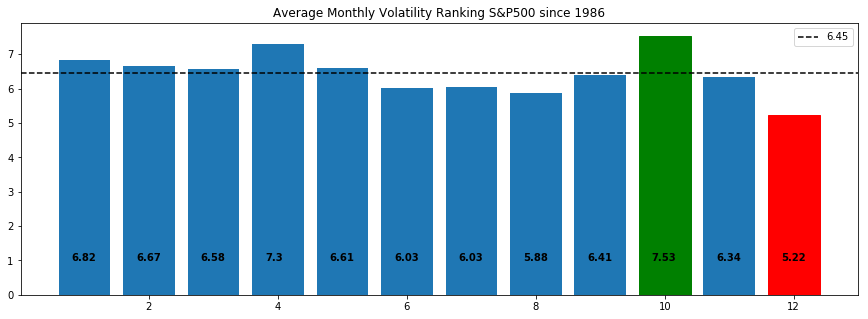
Isso nos dá o ranking médio mensal de volatilidade final. Numericamente, vemos que o mês 10 (outubro) é o mais alto e o 12 (dezembro) é o mais baixo.
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
Escolher a visualização certa é importante porque queremos contar a história dos dados com o máximo impacto. Para nossa análise, queremos mostrar claramente o maior e o menor nível de volatilidade. Para isso, vamos usar o gráfico de barras do matplotlib, anotando e colorindo para destacar.
1. Indexando b_plot (b_plot[9]) com a barra desejada, podemos definir a cor para evidenciar os valores mais alto e mais baixo.
2. Para adicionar os valores de AMVR em cada barra, percorremos 'final' com enumerate e arredondamos para 2 casas decimais. 'i' e 'v' são o índice e o valor; 'i' vai de 1 a 12 e 'v' é o AMVR. Usamos plt.text() com 'i' (ajustado por 0,8) no eixo x e a string do valor como rótulo.
3. Para mostrar a média, usamos axhline e passamos 'label' para exibir a legenda no canto superior direito. Basta informar o valor no eixo y (a média) e estilizar.
Esse é o melhor visual até agora do fenômeno que estamos investigando. Dá para ver claramente que outubro tem sido o mês mais volátil e dezembro o menos. Importante: dezembro é o valor mais "extremo" em termos absolutos. Isso será relevante na próxima seção.
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
Esses são nossos dados. Agora, vamos ao teste de hipótese…
Teste de hipótese é uma das técnicas mais fundamentais em ciência de dados, mas também uma das mais intimidadoras e mal compreendidas. A base desse medo está em como ela é ensinada no curso introdutório de estatística, quando ouvimos:
"faça um teste t; é unilateral ou bilateral? Escolha uma estatística de teste adequada, como o t de Welch; calcule os graus de liberdade; calcule o t; consulte o valor crítico na tabela; compare com a estatística t ……"
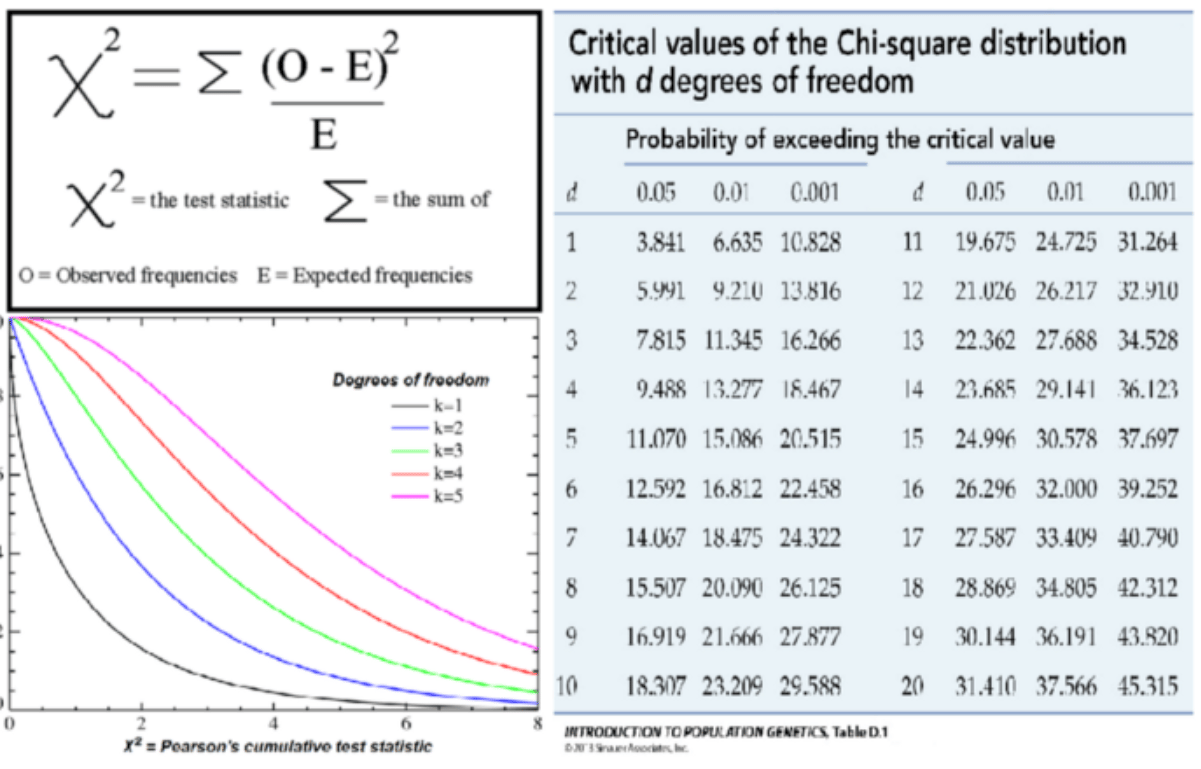
Compreensivelmente, isso gera confusão sobre qual teste fazer e como fazê-lo. Porém, todas essas técnicas clássicas foram desenvolvidas quando quase não havia poder computacional e eram apenas soluções analíticas fechadas para calcular um p-valor — só isso! Com o adicional de ter que escolher a fórmula certa para cada situação, dadas suas premissas restritivas e, às vezes, opacas.
Mas anime-se!
Existe um caminho melhor: simulação.
Para entender como a simulação ajuda, vamos relembrar o que é um teste de hipótese:
Queremos testar “se o efeito observado nos dados é real ou se poderia ocorrer simplesmente por acaso” e, para isso, fazemos o seguinte:
Esse é o teste de hipótese em 3 passos! Não importa o fenômeno, a pergunta é sempre: “o efeito observado é real ou é fruto do acaso?”
There is only one test! Este ótimo post do Allen Downey traz mais detalhes sobre testes de hipótese
O verdadeiro poder da simulação é explicitar nossas premissas do modelo via código. Já as técnicas clássicas podem ser uma “caixa-preta” quanto às suas suposições.
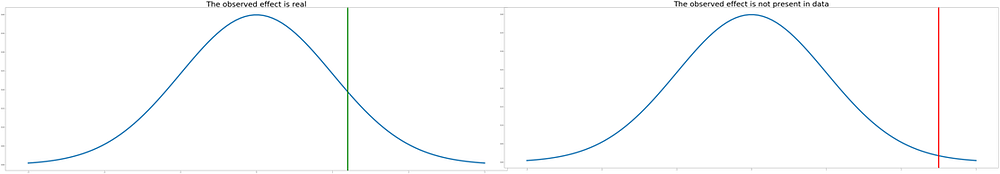
Exemplo abaixo: o gráfico da esquerda mostra os dados reais e o efeito observado com certa probabilidade (verde). O da direita é nosso dado nulo simulado, registrando quando o efeito aparece por acaso (vermelho). Essa é a base do teste: qual a probabilidade de ver o efeito observado nos dados nulos.
A parte mais crítica é deixar clara a pergunta que estamos respondendo. No nosso caso:
“O valor mais extremo poderia ocorrer por acaso?”
Definimos o valor mais extremo como o maior desvio absoluto do AMVR em relação à média. Essa pergunta define nossa hipótese nula.
Nos dados, o valor mais extremo é o de dezembro (1,23), não o de outubro (1,08), porque olhamos o desvio absoluto em relação à média, não apenas a maior volatilidade.
1. Para obter o desvio absoluto, subtraímos a média de cada valor e aplicamos abs().
2. Usando sort_values(), ordenamos do menor para o maior e selecionamos os 2 maiores, out e dez.
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
Agora que sabemos a pergunta, precisamos construir nosso “modelo nulo”.
Há algumas opções:
Amostragem é um tema vasto; vamos focar em uma técnica: permutação (embaralhamento).
Para obter o modelo nulo desejado, precisamos construir um conjunto de dados sem sazonalidade. Se a nula for verdadeira — não há sazonalidade e o efeito observado ocorreu por acaso — então os rótulos de cada mês (jan, fev, etc.) não têm significado e podemos embaralhar repetidamente para construir o que a estatística clássica chamaria de “distribuição amostral da estatística de teste sob a hipótese nula”. Isso torna o fenômeno observado (o valor extremo de dezembro) igualmente provável para todos os meses, exatamente o que nosso modelo nulo requer.
Para mostrar a força da simulação com o poder computacional atual, o código deste exemplo vai permutar os dados diários de preço — o que exige bem mais processamento — e ainda assim roda em segundos em um CPU moderno.
Observação: embaralhar os rótulos diários ou mensais produz o conjunto nulo desejado no nosso caso.
Shuffle 'date' label to create null dataset

Um ótimo recurso para aprender amostragem é de Julian Simon.
Observação: A forma como construímos o teste equivale a um teste bicaudal nos métodos clássicos (como t de Welch ou ANOVA), porque nos interessa o valor mais extremo, acima ou abaixo da média.
Essas decisões são escolhas de design, e temos essa liberdade porque o modelo nulo é justamente isso: um modelo! Podemos especificar seus parâmetros; o essencial é deixar claríssima a pergunta que queremos responder.
Queremos usar Python para simular muitos dados e criar o conjunto nulo. Para isso, vamos simular 1000 conjuntos de 12 AMVR, permutando os rótulos de 'date' a cada vez para construir a distribuição amostral. A saída desse código aparece abaixo na seção de p-hacking.
1. Primeiro, definimos alguns recipientes para armazenar resultados: um pd.DataFrame() e um array simples [].
2. Depois, definimos um contador (zero) e iniciamos um for de 1000 iterações para criar os dados simulados.
3. A primeira linha dentro do loop pega os retornos diários originais (do começo do tutorial) e usa sample() do pandas. Isso amostra aleatoriamente dos retornos diários um certo número de vezes. Temos 8191 pontos (252 pregões por 32 anos). Também removemos o índice com reset_index() para adicionar um novo; precisamos disso porque o índice de data original seria embaralhado junto, e queremos “embaralhar” apenas os dados.
4. A próxima linha adiciona um novo índice de datas atribuindo ao índice de daily_ret_shuffle um pd.bdate_range do mesmo comprimento do original. Usamos bdate_range, não date_range, porque queremos dias úteis (seg–sex), não 7 dias na semana.
5. Com os dados “embaralhados”, repetimos o mesmo tratamento do início para construir os valores de AMVR. É o que fazem as 3 próximas linhas.
6. Com os AMVR simulados, concatenamos ao DataFrame que guardará as 1000 execuções. pd.concat agrega cada novo DataFrame ao final. Escolhemos axis 1 para formar colunas.
7. maxi_month guarda apenas o maior valor de cada simulação (vamos usar depois na explicação de p-hacking).
8. Como a análise requer valores absolutos de AMVR, as 3 linhas seguintes achatam as 1000 execuções em um único array. Em seguida, calculamos a média, subtraímos cada valor dessa média e tiramos o valor absoluto.
9. Fazemos o mesmo para os “maiores apenas”. Aqui usamos uma lista, e assim podemos aplicar uma list comprehension para calcular abs(AMVR) de cada máximo.
Agora temos todos os dados necessários para concluir a análise: as observações originais e o novo conjunto simulado.
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
Agora vem a parte interessante. Construímos uma hipótese a testar, geramos dados simulados embaralhando os rótulos de 'date' e agora vamos realizar o teste para encontrar a probabilidade de observar um resultado tão significativo quanto o de dezembro supondo que a nula (sem sazonalidade) seja verdadeira.
Antes do teste, vamos alinhar expectativas.
Qual é a probabilidade de ver pelo menos um resultado significativo com nível de 5%?
= 1-p(não significativo)
= 1-(1–0,05)¹²
= 0,46
ou seja, há 46% de chance de ver pelo menos um mês com resultado significativo, dado que a nula é verdadeira.
Agora, vamos perguntar: para cada teste individual (comparando o AMVR absoluto de cada um dos 12 meses com a média), quantos valores significativos devemos esperar ver em nossos dados aleatórios, sem sazonalidade?
12 x 0,05 = 0,6
Então, com nível de 0,05, esperamos uma taxa de falso positivo de 0,6. Em outras palavras, para cada teste (com os dados nulos) comparando os 12 meses à média, 0,6 mês apresentará resultado significativo. (obviamente, não existe “menos de 1 mês”, mas em testes repetidos a média tende a esse número).
Reforçamos o tempo todo a importância de ser muito claro sobre a pergunta. O problema com essas expectativas é que assumimos que estamos testando significância contra todos os 12 meses! Por isso a probabilidade de pelo menos um falso positivo é tão alta (46%).
Esse é um exemplo de viés de múltiplas comparações: ampliamos o espaço de busca e aumentamos a chance de encontrar um resultado “significativo”. Isso é um problema porque podemos abusar desse efeito para escolher a dedo os parâmetros do modelo que entreguem o p-valor “desejado”.
Essa é a essência do p-hacking
Para ilustrar o efeito do p-hacking e como reduzir a multiplicidade, precisamos entender a diferença — sutil, mas crucial — entre estas duas perguntas:
A beleza da simulação está na simplicidade. O código a seguir é tudo o que precisamos para calcular o p-valor e responder à 1ª pergunta. Basta contar quantos valores no nosso conjunto, usando todos os 12.000 desvios de AMVR (12 meses x 1000 execuções), são maiores que o valor observado de dezembro. Obtemos um p-valor de 4,4%, perto do nosso corte arbitrário de 5%, mas ainda assim significativo.
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
Para responder à 2ª pergunta e evitar multiplicidade, em vez de comparar nosso resultado com a distribuição formada por todos os 12.000 desvios, consideramos apenas o maior valor de cada uma das 1000 execuções de AMVR absoluto. Isso dá um p-valor de 23%, claramente não significativo!
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
Com os resultados finais, vamos plotar essas distribuições para mostrar o efeito do p-hacking e os resultados da análise visualmente:
1. Primeiro usamos np.quantile() para achar o nível de 5% e o desenhamos com axvline nos gráficos inferiores.
2. Depois definimos os 4 subplots em caixa. plt.subplots retorna 'fig' (a figura) e 'ax1,ax2,ax3,ax4' (os eixos dos 4 subplots).
3. O gráfico 1 mostra a 1ª coluna. Definimos um histograma de 'abs_all_months' com type='bar'. Nos gráficos inferiores, definimos cumulative='True' para obter a CDF em vez da PDF. Bins define o número de barras; 30 é razoável aqui. Em seguida, formatamos com axvline para traçar o nível de significância e o valor observado.
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
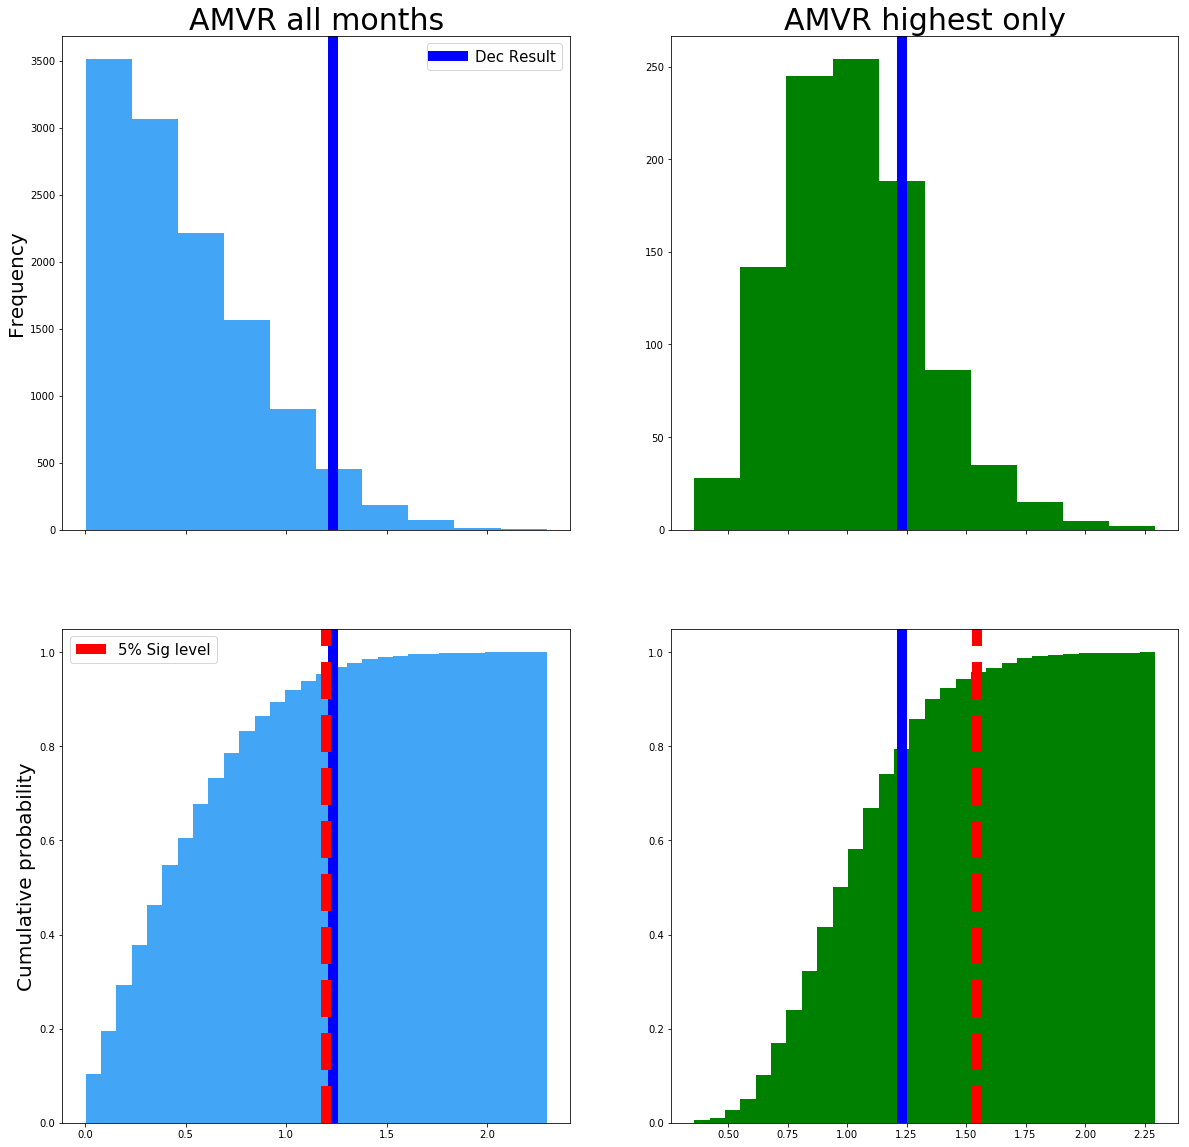
A coluna da esquerda responde à pergunta 1 e a da direita, à pergunta 2. A linha de cima traz as distribuições de probabilidade, e a de baixo, a CDF. A linha tracejada vermelha marca o nível de 5% que escolhemos. A linha azul é o valor de AMVR absoluto de dezembro (1,23).
O gráfico da esquerda mostra que o valor de dezembro é significativo a 5%, mas por pouco! Já quando consideramos o viés de múltiplas comparações, no da direita o limiar de significância sobe de cerca de 1,2 (AMVR abs) para perto de 1,6 (veja a linha vermelha).
Ao considerar o viés de múltiplas comparações, nosso valor de dezembro (1,23) deixa de ser significativo!
Ao levar em conta a pergunta específica e evitar o viés de múltiplas comparações, evitamos fazer p-hacking no modelo e evitar mostrar significância onde não há.
Para explorar mais sobre p-hacking e como ele pode ser usado para “contar uma história” específica com os dados, veja este app interativo da FiveThirtyEight
Notas do autor: Nossos resultados diferem um pouco da pesquisa original da Winton, em parte por termos um conjunto diferente (32 anos vs. 87 anos) e porque eles apontam outubro como mês de interesse, enquanto nós apontamos dezembro. Além disso, eles usaram um método não divulgado para seus “dados simulados”, enquanto nós explicitamos, via código, nossa metodologia. Fizemos certas suposições de modelagem ao longo do trabalho; novamente, tudo foi explicitado no código. Essas escolhas fazem parte do processo científico; desde que sejam claras, a análise tem mérito.
Se você quer aprender mais sobre finanças em Python, faça o curso Intro to Python for Finance da DataCamp e confira o Python For Finance Tutorial: Algorithmic Trading.
Siga-me em twitter.com/pdquant para mais!
Saiba mais sobre Python
Curso
Curso
Curso
Tutorial
Karlijn Willems
15 min
Tutorial
Kevin Babitz
25 min
Tutorial
Elena Kosourova
8 min
Tutorial
Thushan Ganegedara
15 min
Tutorial
Vidhi Chugh
15 min
Tutorial
DataCamp Team
7 min