

处理缺失数据
处理缺失数据有多种方法。本节将介绍其中一些及其优缺点。
为更好地演示用例,我们将使用DataLab 上提供的贷款数据以及教程中涵盖的源码。
由于该数据集本身没有缺失值,我们将取 100 行子集,并手动引入缺失值。
import pandas as pdsample_customer_data = pd.read_csv("data/customer_churn.csv", nrows=100)
sample_customer_data.info()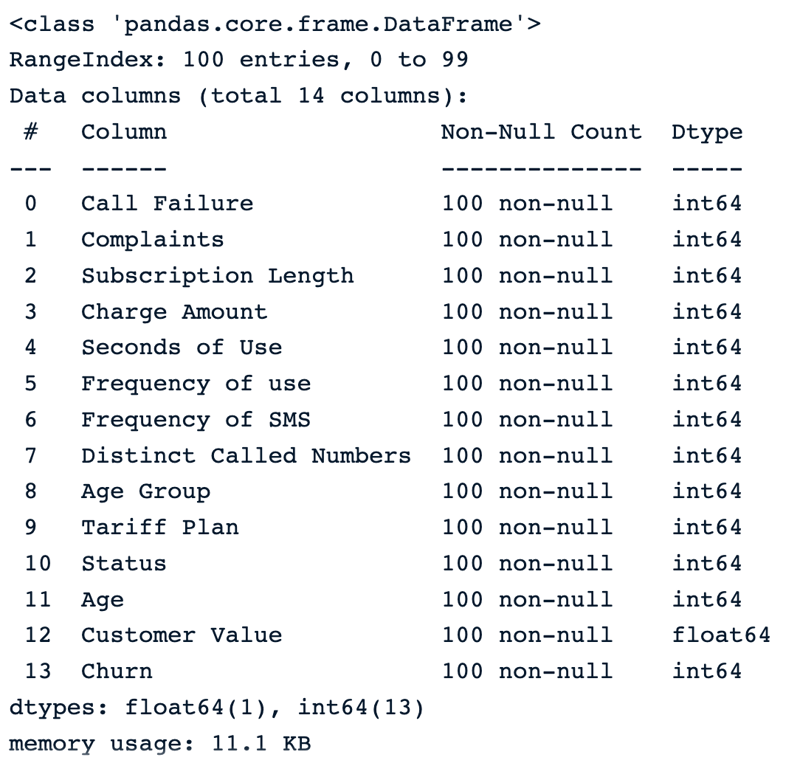
引入缺失值前的 100 条随机样本
让我们在数据框的每一列中引入 50% 的缺失值。
import numpy as np
def introduce_nan(x,percentage):
n = int(len(x)*(percentage - x.isna().mean()))
idxs = np.random.choice(len(x), max(n,0), replace=False, p=x.notna()/x.notna().sum())
x.iloc[idxs] = np.nan将该函数应用到数据后,得到如下结果。
sample_customer_data.apply(introduce_nan, percentage=.5)
sample_customer_data.info()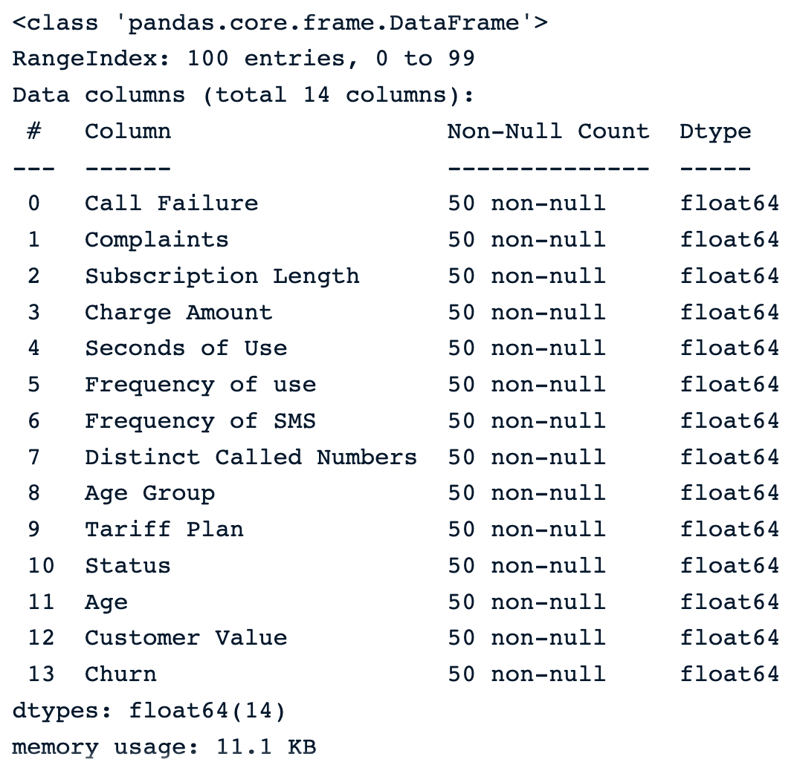
引入缺失值后的 100 条随机样本
下面是数据集的前五行。
sample_customer_data.head()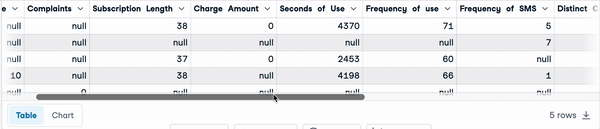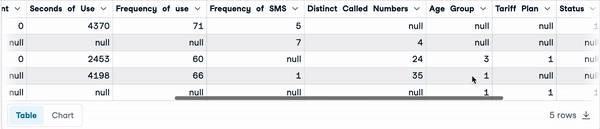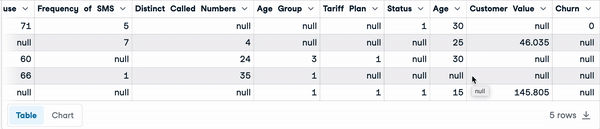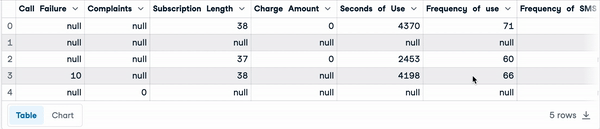
包含空值的前五行
删除数据
使用 dropna() 是从数据框中移除包含缺失值的观测或特征的最简便方法。如下是一些技巧。
1) 删除含缺失值的观测
当尝试从数据集中移除观测时,可能出现以下三种情况:
dropna():删除所有包含缺失值的行。
drop_na_strategy = sample_customer_data.dropna()
drop_na_strategy.info()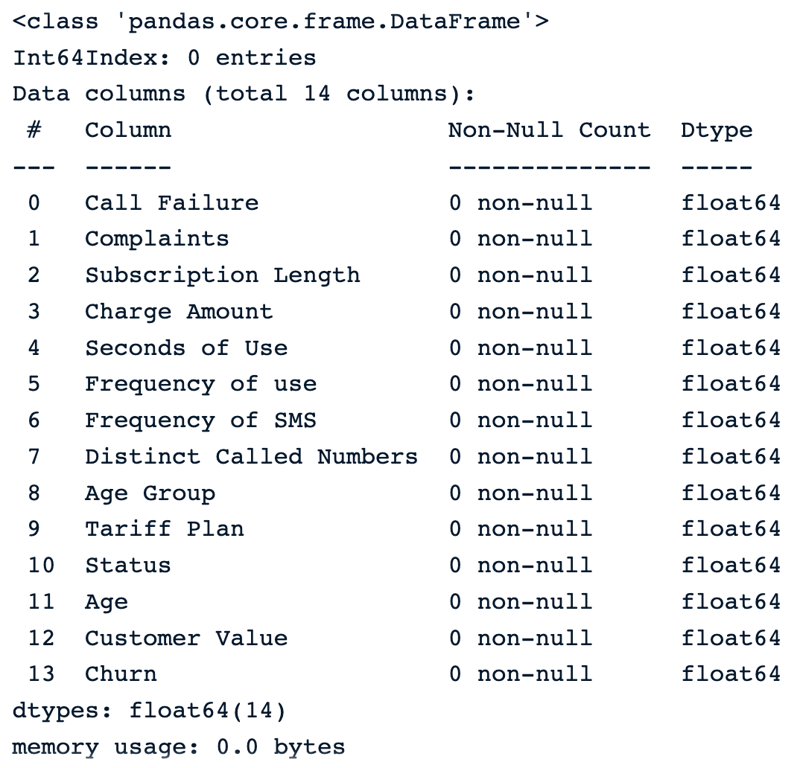
使用默认 dropna() 删除观测
可以看到数据集中的所有观测都被删除了,这对后续分析可能尤其危险。
dropna(how = ‘all’):删除所有列值均缺失的行。
drop_na_all_strategy = sample_customer_data.dropna(how="all")
drop_na_all_strategy.info()从下方输出可见,没有观测同时在所有列上都是缺失的。
使用 “all” 策略删除观测
dropna(thresh = minimum_value):基于阈值删除行。该策略设置一个最小非缺失值数量以保留行。
drop_na_thres_strategy = sample_customer_data.dropna(thresh=0.6)
drop_na_thres_strategy.info()将阈值设置为 60%,结果与前一个相同。
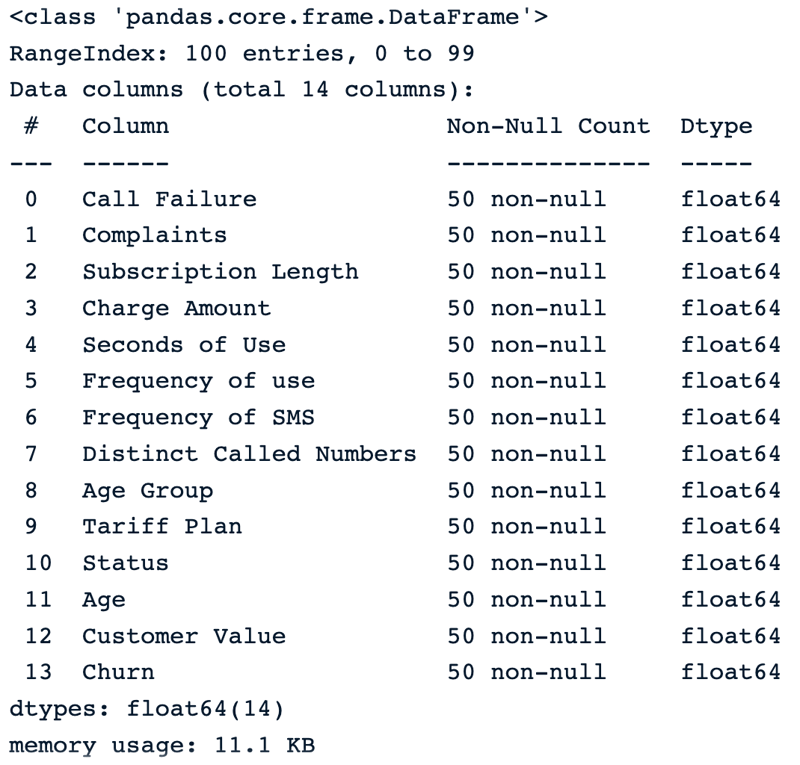
使用阈值删除观测
2) 删除含缺失值的列
参数 axis = 1 可用于明确指定我们关注的是列而非行。
dropna(axis = 1):删除所有包含缺失值的列。
drop_na_cols_strategy = sample_customer_data.dropna(axis=1)
drop_na_cols_strategy.info()数据中已没有任何列。这是因为所有列至少都有一个缺失值。
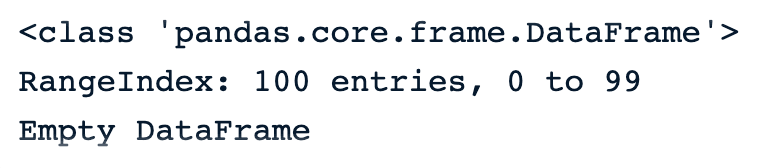
对列执行 dropna() 后的数据框为空
与许多其他方法一样,dropna() 也有其优缺点。
优点
- 简单直观,易于使用。
- 当缺失值不重要时很有用。
缺点
- 此方法可能导致信息损失,进而为最终数据集带来偏差。
- 当数据并非完全随机缺失时不适用。
- 缺失比例较大的数据集可能被显著缩小,影响后续所有统计分析结果。
均值/中位数填补
这些替换策略顾名思义。均值和中位数填补分别用某列非缺失值的均值和中位数替换该列的缺失值。
理想情况是正态分布,但现实并非总是如此。这时中位数填补就很有帮助,因为它对离群值不敏感。
在 Python 中,可使用 pandas 的 fillna() 函数进行这些替换。
- 均值填补示例。
mean_value = sample_customer_data.mean()
mean_imputation = sample_customer_data.fillna(mean_value)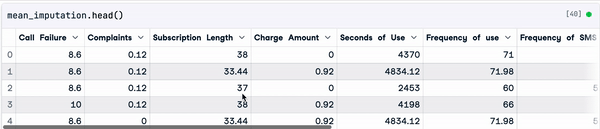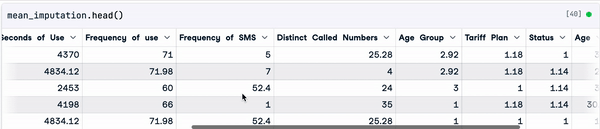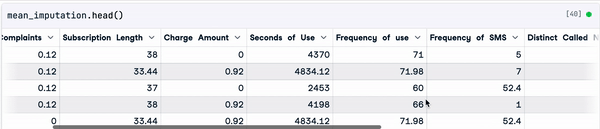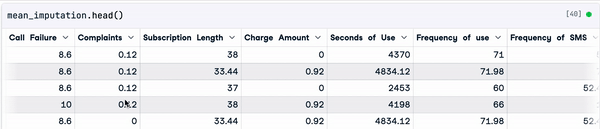
均值填补的结果
- 中位数填补示例
median_value = sample_customer_data.median()
median_imputation = sample_customer_data.fillna(median_value)
median_imputation.head()
中位数填补的结果
优点
- 简单易行是均值和中位数填补的优势之一。
- 填补基于非缺失数据中的现有信息,无需额外数据。
- 对于正态分布数据与偏态数据,均值与中位数填补分别能给出较好的缺失值估计。
缺点
- 这两种策略不能用于分类变量,只适用于数值变量。
- 均值填补对离群值敏感,可能无法很好代表数据的集中趋势。类似地,中位数也不一定更能代表集中趋势。
- 中位数填补假设数据为完全随机缺失(MCAR),而这并不总是成立。
随机样本填补
随机样本填补的思想不同于前述方法,且涉及额外步骤。
- 首先,从原始数据中创建两个子集。
- 第一个子集包含所有无缺失的观测,第二个子集包含有缺失的观测。
- 随后,从每个子集中随机抽取一个观测。
- 接着,用完整观测中的现有值替换之前所选有缺失观测中的缺失数据。
- 最后,重复该过程直到不再有缺失信息。
def random_sample_imputation(df):
cols_with_missing_values = df.columns[df.isna().any()].tolist()
for var in cols_with_missing_values:
# extract a random sample
random_sample_df = df[var].dropna().sample(df[var].isnull().sum(),
random_state=0)
# re-index the randomly extracted sample
random_sample_df.index = df[
df[var].isnull()].index
# replace the NA
df.loc[df[var].isnull(), var] = random_sample_df
return dfdf = sample_customer_data.copy()
random_sample_imp_df = random_sample_imputation(sample_customer_data)
random_sample_imp_df.head()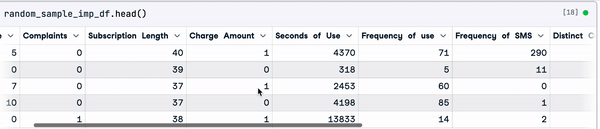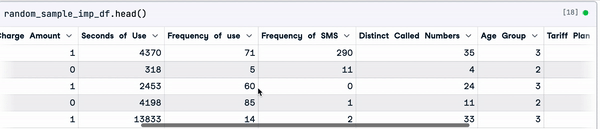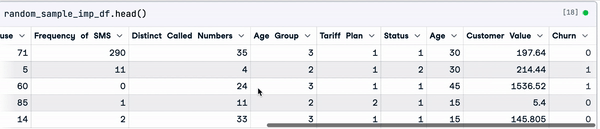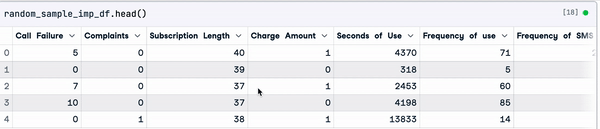
随机样本填补
优点
- 方法简单易行。
- 可同时处理数值型与分类型数据。
- 对方差的扭曲更小,且能保留数据的原始分布,这一点是均值、中位数等方法所不具备的。
缺点
- 随机性并非在所有情境下都有效,可能给数据引入噪声,导致错误的统计结论。
- 与均值和中位数类似,该方法也假设数据为完全随机缺失(MCAR)。
多重插补
这是一种多变量插补技术,即在填补缺失信息时会综合考虑其他列的信息。
例如,如果某人的收入缺失,我们并不能确定 TA 是否有按揭贷款。要确定更合理的取值,就需要结合信用评分、职业、是否拥有住房等其他特征来评估。
链式方程多重插补(MICE)是多变量插补中最流行的方法之一。为更好理解 MICE 方法,假设有一组变量 X1、X2、…、Xn,其中部分或全部存在缺失值。
算法流程如下:
- 对每个变量,先用简单策略(如均值插补)填补缺失,作为“占位符”。
- 以第一个变量 X1 的“占位符”为因变量,其他变量为自变量,拟合回归模型;随后以 X2 为因变量、其余为自变量,如此循环,直至每个变量都至少作为一次因变量。
- 将最初的“占位符”用回归模型的预测值替换。
- 按文献Raghunathan 等,2002所述,通常重复多个轮次(一般为 10 次),每一轮都会更新插补。
- 在循环结束时,缺失值理想情况下将被最能反映数据中关系的预测值所替代。
实现可使用 miceforest 库。
首先使用 pip 安装该库。
pip install miceforest然后导入 ImputationKernel 模块并创建用于插补的内核。
from miceforest import ImputationKernel
mice_kernel = ImputationKernel(
data = sample_customer_data,
save_all_iterations = True,
random_state = 2023
)接着在数据上运行两次迭代,最后生成插补后的数据。
mice_kernel.mice(2)
mice_imputation = mice_kernel.complete_data()
mice_imputation.head()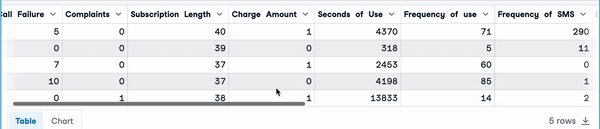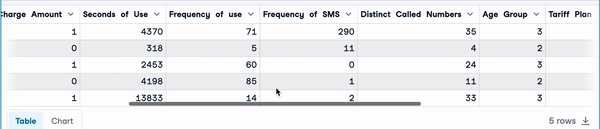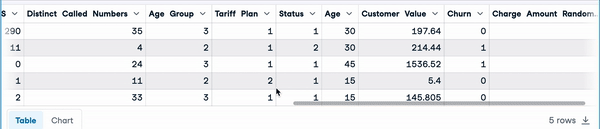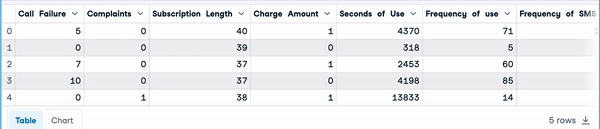
多重插补
优点
缺点
- 多重插补假设数据为随机缺失(MAR)。
- 尽管优势显著,但与其他技术相比,该方法计算成本更高,尤其在处理大型数据集时。
- 相较前述方法,该方法需要投入更多精力。
在这些插补方法中,可以评估哪一种最接近原始数据的分布。
从下图可见,均值(黄色)和中位数(红色)与“Charge amount”列数据的原始分布相距较远,因此并不适合用于该数据的插补。
mean_imputation["Charge Amount Mean Imp"] = mean_imputation["Charge Amount"]
median_imputation["Charge Amount Median Imp"] = median_imputation["Charge Amount"]
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]为每种插补创建了新列后,我们可以绘制分布图。
import matplotlib.pyplot as plt
plt.figure(figsize=(12,8))
sample_customer_data["Charge Amount"].plot(kind='kde',color='blue')
mean_imputation["Charge Amount Mean Imp"].plot(kind='kde',color='yellow')
median_imputation["Charge Amount Median Imp"].plot(kind='kde',color='red')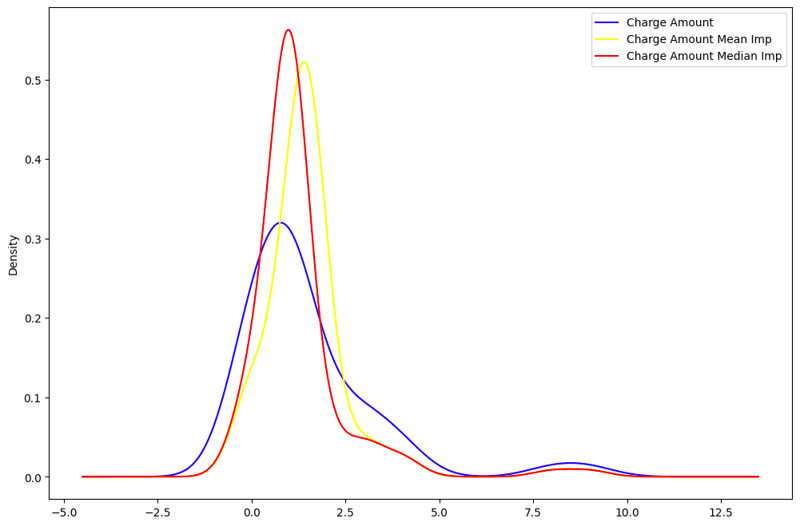
“Charge Amount” 分布:原始数据 vs. 均值 vs. 中位数
下图绘制了多重插补与随机插补,它们与原始数据的分布几乎完全重合。这意味着这些插补优于均值和中位数插补。
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"] = mice_imputation["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"].plot(kind='kde',color='black')
random_sample_imp_df["Charge Amount Random Imp"].plot(kind='kde',color='purple')
plt.legend()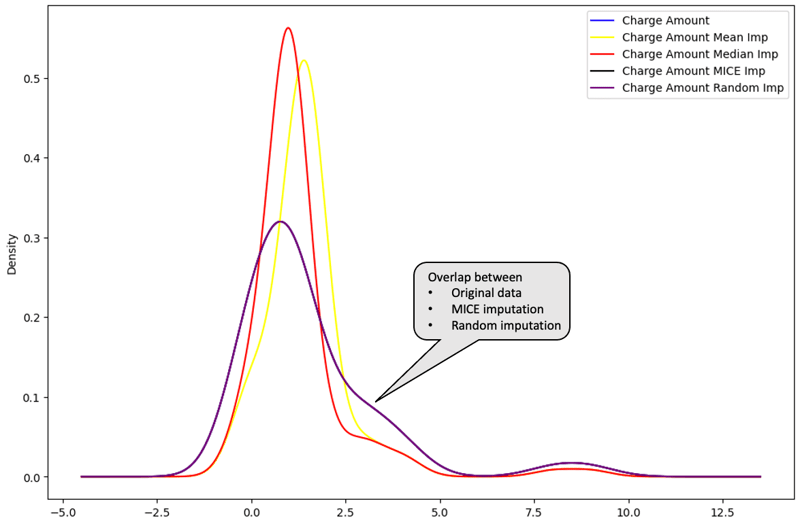
“Charge Amount” 分布:原始数据 vs. 均值 vs. 中位数 vs. MICE vs. 随机
Handling Missing Data with Imputations in R 课程是进一步学习缺失值处理策略的优质资源。课程涵盖如何运用可视化与统计检验识别缺失模式,以及如何用统计和机器学习技术进行插补。
同样,dealing with missing data in python 课程讲解如何在 Python 中识别、分析、删除与插补缺失数据。
最佳实践
基于缺失类型选择合适的插补方法
插补策略众多,不应盲目使用。采用正确方法有助于避免在数据中引入偏差并防止做出错误决策。
下表展示了根据缺失数据类型选择插补方法的建议。方法并不穷尽,但都是最常用的。
|
缺失数据类型 |
插补方法 |
|
完全随机缺失 |
均值、中位数、众数或其他任意插补方法 |
|
随机缺失 |
多重插补、回归插补 |
|
非随机缺失 |
模式替代、极大似然估计 |
评估插补对整体分析的影响
需要牢记,无论采用何种插补技术,原始数据都无法完全还原。但我们可以采用尽可能贴近真实情况的插补方法。
评估时可考虑以下关键步骤。
- 尝试多种插补技术以识别最稳健的方法,有助于发现不同技术间的偏差与差异。
- 将最终插补数据与原始未插补数据对比,评估插补方法的可靠性。
- 将插补过程纳入整体分析流水线,从数据清洗到机器学习建模全流程中加以考虑。
向相关方沟通缺失数据与插补方法
高质量数据是各方相关者与数据从业者共同的目标。
在沟通分析中缺失的数据时,诚实与透明至关重要。以下是需重点关注的方面。
- 了解缺失数据的背景,是 MCAR、MAR 还是 MNAR。
- 清晰解释并文档化处理总体数据缺失的方法,并讨论各方法的优缺点。
- 以相关方能够理解的方式传达结果。
结论
本文介绍了何为缺失数据及其对数据驱动决策的影响,并引导您了解若干处理策略及其优缺点,以支持可执行的决策制定。
希望这能为您高效应对缺失数据问题提供有价值的思路与方法。
缺失值常见问答
什么是缺失数据?
缺失数据指数据中部分或全部变量存在缺失值。
缺失数据有哪些类型?
缺失数据主要有三类:完全随机缺失(MCAR)、随机缺失(MAR)以及非随机缺失(MNAR)。
如何处理缺失数据?
可采用以下方法处理缺失值:均值、中位数、众数填补,随机样本填补,多重插补。该列表并不穷尽,每种方法都有其优缺点。
为什么缺失数据很重要?
之所以重要,是因为它们会影响机器学习模型的表现,并使基于数据的统计结论产生偏差,进而导致业务做出错误决策。
在数据收集过程中,尤其处理大型数据集时,缺失数据是常见且难以避免的问题。产生缺失数据的原因多种多样,例如参与者提供的信息不完整、拒绝回答导致的不回应、问卷设计不佳,或因保密需要删除部分数据。
如果未妥善处理,缺失数据会对后续统计分析的结论造成偏差,从而使业务做出错误决策。
本文将聚焦若干高效处理缺失值的技术及其在 Python 中的实现。我们将说明各方法的优缺点,帮助您在特定场景中做出合适选择。
识别缺失数据
缺失数据会以不同形式出现。本节将介绍缺失数据的不同类型及其识别方法。
缺失数据的类型
缺失数据主要有三类:(1)完全随机缺失(MCAR),(2)随机缺失(MAR),(3)非随机缺失(MNAR)。
充分理解每一类有助于选择恰当的处理方法。
1) MCAR - 完全随机缺失
当所有变量和观测具有相同的缺失概率时,即为此类。想象给一个孩子一堆不同颜色的乐高积木来搭房子。每块乐高代表一条信息,如形状和颜色。孩子在玩耍时可能会丢失一些乐高。这些丢失的乐高就像丢失的信息,类似于他们记不起手里那块乐高的形状或颜色。虽然这些信息是随机丢失的,但并不会改变孩子手上其他乐高的信息。
2) MAR - 随机缺失
对于 MAR,值缺失的概率与该变量的值或数据集中其他变量的值相关。也就是说,并非所有观测与变量都有相同的缺失机会。一个例子是数据社区里的问卷:不常更新技能的数据科学家更可能不了解最新的前沿算法或技术,因此会跳过某些问题。在这种情况下,缺失数据与该数据科学家提升技能的频率相关。
3) MNAR- 非随机缺失
MNAR 被认为是三种缺失类型中最棘手的。当 MCAR 和 MAR 均不适用时,就属于 MNAR。在这种情形下,同一变量的不同取值具有完全不同的缺失概率,且缺失原因可能对我们而言是未知的。一个例子是关于已婚夫妻的调查:关系不佳的伴侣可能出于尴尬而不愿回答某些问题。
识别缺失数据的方法
在 pandas 中有多种方法可用于识别缺失数据。以下是最常用的一些。
函数
说明
.isnull()
返回一个 pandas 数据框,值为布尔类型;若该值缺失则为 True,否则为 False。
.notnull()
与前一个函数类似,但当检测到 NaN 或 None 时,该函数的值为 False。
.info()
该函数生成三列关键信息,其中包括“Non-Null Count”(非空计数),显示每一列的非缺失值数量。
.isna()
与 isnull 和 notnull 类似。但它仅在缺失值为 NaN 类型时显示 True。