

Menangani Data Hilang
Ada banyak pendekatan untuk menangani data hilang. Bagian ini membahas beberapa di antaranya beserta kelebihan dan kekurangannya.
Untuk memperjelas studi kasus, kita akan menggunakan Loan Data yang tersedia di DataLab beserta kode sumber yang dibahas dalam tutorial.
Karena dataset tidak memiliki nilai hilang, kita akan menggunakan subset data (100 baris) lalu secara manual memperkenalkan nilai hilang.
import pandas as pdsample_customer_data = pd.read_csv("data/customer_churn.csv", nrows=100)
sample_customer_data.info()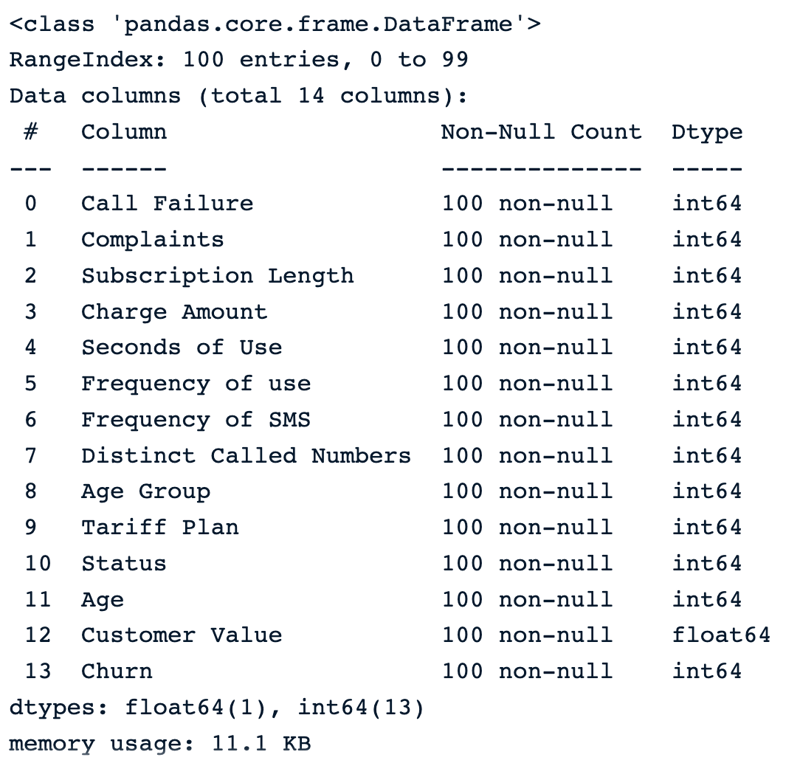
Sampel 100 baris acak sebelum memperkenalkan nilai hilang
Mari kita perkenalkan 50% nilai hilang di tiap kolom dataframe.
import numpy as np
def introduce_nan(x,percentage):
n = int(len(x)*(percentage - x.isna().mean()))
idxs = np.random.choice(len(x), max(n,0), replace=False, p=x.notna()/x.notna().sum())
x.iloc[idxs] = np.nanMenerapkan fungsi pada data menghasilkan keluaran berikut.
sample_customer_data.apply(introduce_nan, percentage=.5)
sample_customer_data.info()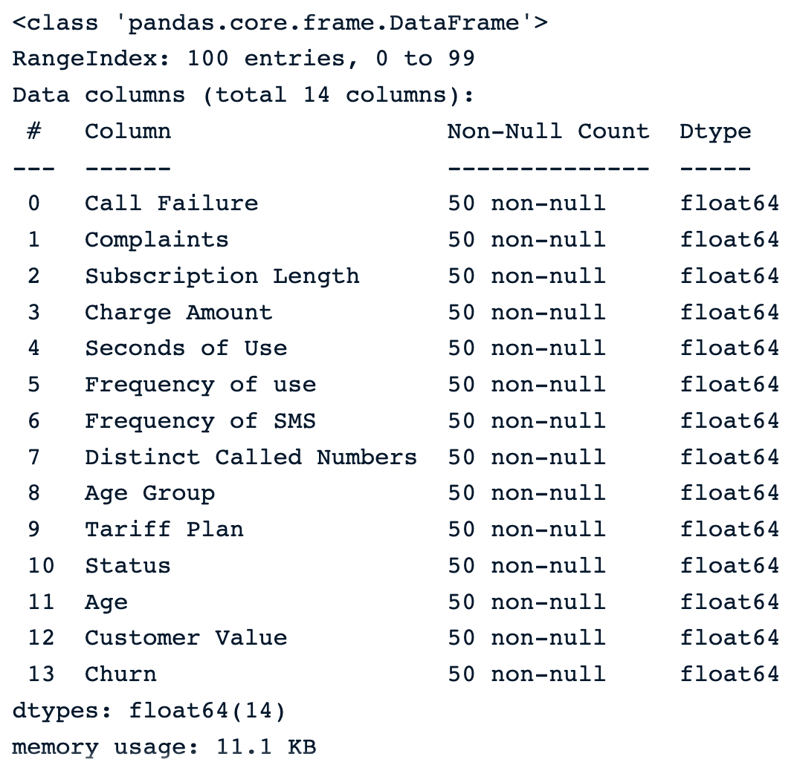
Sampel 100 baris acak setelah memperkenalkan nilai hilang
Di bawah ini adalah lima baris pertama dataset.
sample_customer_data.head()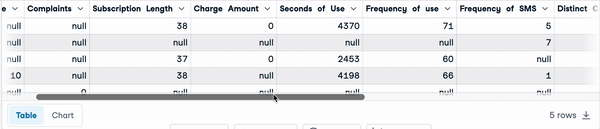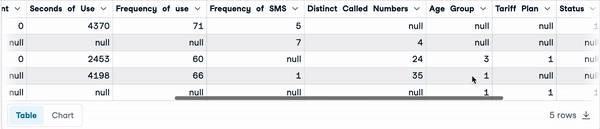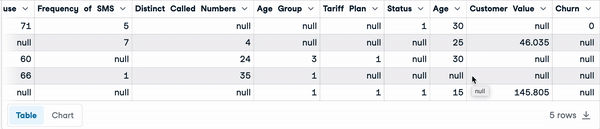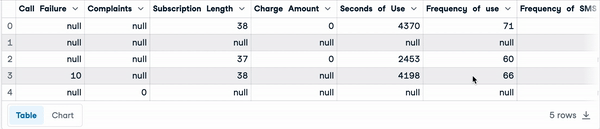
Lima baris pertama dengan nilai null
Menghapus Data
Menggunakan fungsi dropna() adalah cara termudah untuk menghapus observasi atau fitur dengan nilai hilang dari dataframe. Berikut beberapa tekniknya.
1) Hapus observasi dengan nilai hilang
Ada tiga skenario yang dapat terjadi saat mencoba menghapus observasi dari dataset:
dropna(): menghapus semua baris yang memiliki nilai hilang.
drop_na_strategy = sample_customer_data.dropna()
drop_na_strategy.info()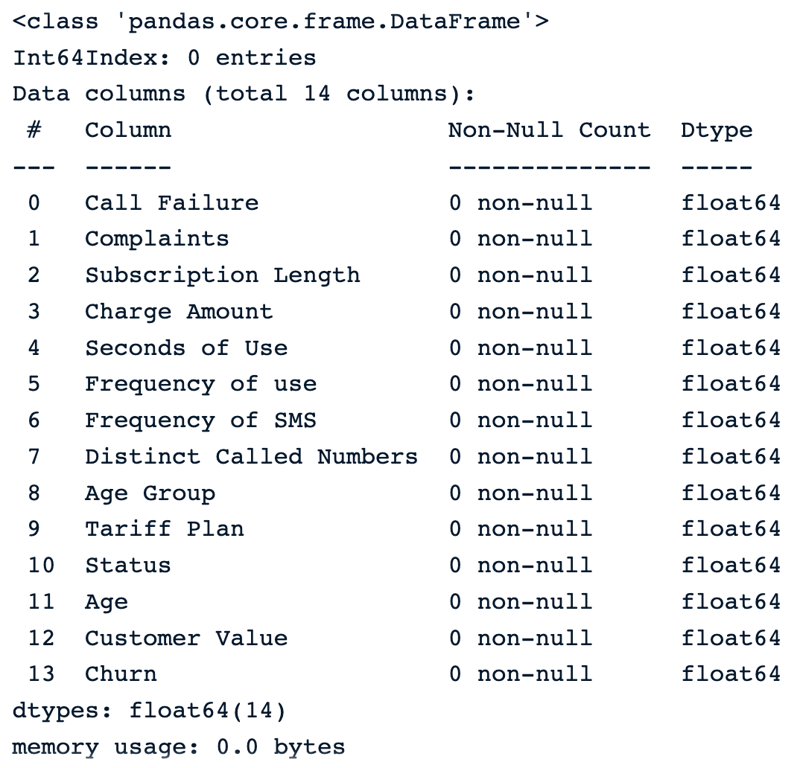
Hapus observasi menggunakan fungsi dropna() default
Kita dapat melihat bahwa semua observasi dihapus dari dataset, yang bisa sangat berbahaya untuk analisis selanjutnya.
dropna(how = ‘all’): baris di mana semua nilai kolom hilang.
drop_na_all_strategy = sample_customer_data.dropna(how="all")
drop_na_all_strategy.info()Dari output di bawah, kita perhatikan tidak ada observasi dengan seluruh kolom hilang.
Hapus observasi menggunakan strategi “all”
dropna(thresh = minimum_value): hapus baris berdasarkan ambang. Strategi ini menetapkan jumlah minimum nilai tidak hilang yang disyaratkan agar baris dipertahankan.
drop_na_thres_strategy = sample_customer_data.dropna(thresh=0.6)
drop_na_thres_strategy.info()Dengan ambang 60%, hasilnya sama dengan sebelumnya.
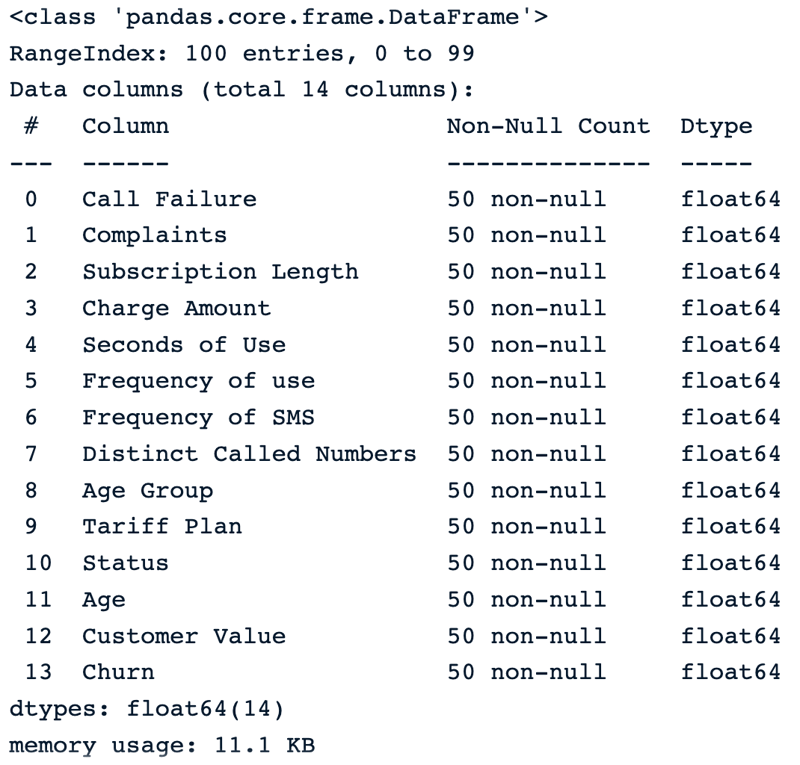
Hapus observasi menggunakan ambang
2) Hapus kolom dengan nilai hilang
Parameter axis = 1 dapat digunakan untuk menyatakan secara eksplisit bahwa kita tertarik pada kolom, bukan baris.
dropna(axis = 1): menghapus semua kolom yang memiliki nilai hilang.
drop_na_cols_strategy = sample_customer_data.dropna(axis=1)
drop_na_cols_strategy.info()Tidak ada lagi kolom dalam data. Ini karena semua kolom memiliki setidaknya satu nilai hilang.
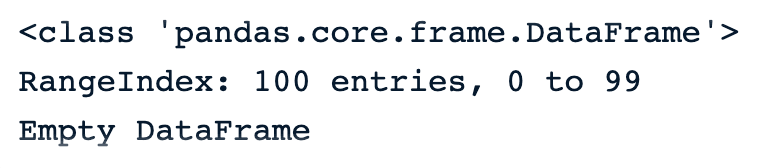
Dataframe kosong setelah dropna() pada kolom
Seperti banyak pendekatan lainnya, dropna() juga memiliki beberapa kelebihan dan kekurangan.
Kelebihan
- Langsung dan mudah digunakan.
- Bermanfaat ketika nilai hilang tidak penting.
Kekurangan
- Pendekatan ini dapat menyebabkan hilangnya informasi, yang dapat menimbulkan bias pada dataset akhir.
- Tidak sesuai ketika data tidak hilang sepenuhnya secara acak.
- Dataset dengan proporsi nilai hilang yang besar dapat berkurang secara signifikan, yang berdampak pada hasil semua analisis statistik atas dataset tersebut.
Imputasi Rata-rata/Median
Strategi penggantian ini cukup jelas. Imputasi mean dan median masing-masing digunakan untuk mengganti nilai hilang pada kolom tertentu dengan rata-rata dan median dari nilai tidak hilang pada kolom tersebut.
Distribusi normal adalah skenario ideal. Sayangnya, tidak selalu demikian. Di sinilah imputasi median berguna karena tidak sensitif terhadap pencilan.
Di Python, fungsi fillna() dari pandas dapat digunakan untuk melakukan penggantian ini.
- Ilustrasi imputasi mean.
mean_value = sample_customer_data.mean()
mean_imputation = sample_customer_data.fillna(mean_value)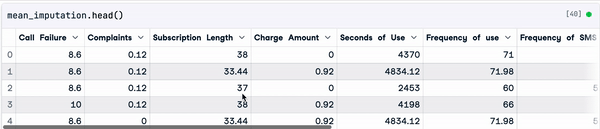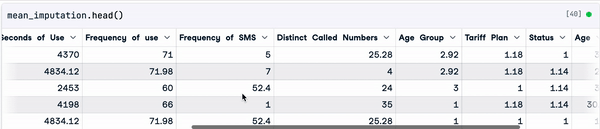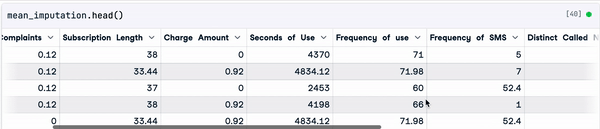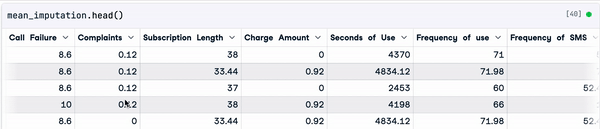
Hasil imputasi mean
- Ilustrasi imputasi median
median_value = sample_customer_data.median()
median_imputation = sample_customer_data.fillna(median_value)
median_imputation.head()
Hasil imputasi median
Kelebihan
- Sederhana dan mudah diimplementasikan merupakan beberapa keunggulan imputasi mean dan median.
- Imputasi dilakukan menggunakan informasi yang ada dari data tidak hilang; sehingga tidak memerlukan data tambahan.
- Imputasi mean dan median dapat memberikan perkiraan yang baik untuk nilai hilang, masing-masing untuk data berdistribusi normal dan data yang menceng.
Kekurangan
- Kedua strategi ini tidak dapat diterapkan pada kolom kategorikal. Hanya bekerja untuk data numerik.
- Imputasi mean sensitif terhadap pencilan dan mungkin tidak mewakili tendensi sentral data dengan baik. Serupa mean, median juga belum tentu lebih mewakili tendensi sentral.
- Imputasi median mengasumsikan data hilang sepenuhnya secara acak (MCAR), yang tidak selalu benar.
Imputasi Sampel Acak
Gagasan di balik imputasi sampel acak berbeda dari sebelumnya dan melibatkan langkah tambahan.
- Pertama, dimulai dengan membuat dua subset dari data asli.
- Subset pertama berisi semua observasi tanpa data hilang, dan subset kedua berisi observasi dengan data hilang.
- Kemudian, secara acak memilih satu observasi dari masing-masing subset.
- Selanjutnya, data hilang dari observasi yang dipilih sebelumnya diganti dengan data yang ada dari observasi yang memiliki semua data tersedia.
- Terakhir, proses berlanjut hingga tidak ada lagi informasi yang hilang.
def random_sample_imputation(df):
cols_with_missing_values = df.columns[df.isna().any()].tolist()
for var in cols_with_missing_values:
# extract a random sample
random_sample_df = df[var].dropna().sample(df[var].isnull().sum(),
random_state=0)
# re-index the randomly extracted sample
random_sample_df.index = df[
df[var].isnull()].index
# replace the NA
df.loc[df[var].isnull(), var] = random_sample_df
return dfdf = sample_customer_data.copy()
random_sample_imp_df = random_sample_imputation(sample_customer_data)
random_sample_imp_df.head()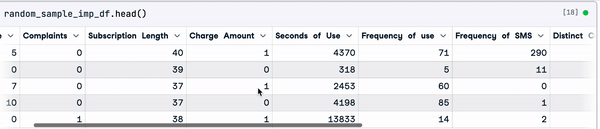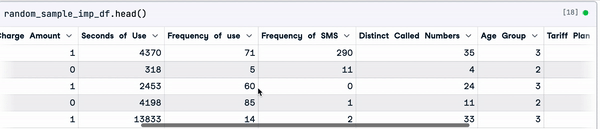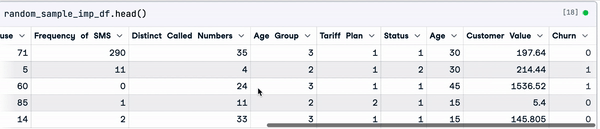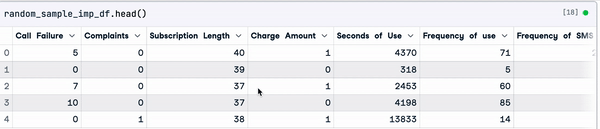
Imputasi sampel acak
Kelebihan
- Teknik yang mudah dan langsung.
- Menangani baik tipe data numerik maupun kategorikal.
- Lebih sedikit distorsi pada varians data, serta mempertahankan distribusi asli data, yang tidak terjadi pada mean, median, dan sejenisnya.
Kekurangan
- Keacakan tidak selalu cocok untuk setiap situasi, dan dapat memasukkan noise ke dalam data, sehingga berujung pada kesimpulan statistik yang keliru.
- Serupa mean dan median, pendekatan ini juga mengasumsikan data hilang sepenuhnya secara acak (MCAR).
Multiple Imputation
Ini adalah teknik imputasi multivariat, artinya informasi yang hilang diisi dengan mempertimbangkan informasi dari kolom lain.
Misalnya, jika nilai pendapatan seseorang hilang, belum tentu diketahui apakah ia memiliki hipotek. Jadi, untuk menentukan nilai yang benar, perlu dievaluasi karakteristik lain seperti skor kredit, pekerjaan, dan apakah individu tersebut memiliki rumah atau tidak.
Multiple Imputation by Chained Equations (disingkat MICE) adalah salah satu metode imputasi paling populer dalam imputasi multivariat. Untuk lebih memahami pendekatan MICE, mari kita pertimbangkan himpunan variabel X1, X2, … Xn, di mana beberapa atau semuanya memiliki nilai hilang.
Algoritme bekerja sebagai berikut:
- Untuk tiap variabel, ganti nilai hilang dengan strategi imputasi sederhana seperti imputasi mean, yang dianggap sebagai “placeholder”.
- “Placeholder” untuk variabel pertama, X1, diregresikan menggunakan model regresi di mana X1 adalah variabel dependen, dan variabel lainnya adalah variabel independen. Lalu X2 digunakan sebagai variabel dependen dan sisanya sebagai variabel independen. Proses berlanjut hingga semua variabel setidaknya sekali menjadi variabel dependen.
- “Placeholder” asli tersebut kemudian diganti dengan prediksi dari model regresi.
- Proses penggantian diulang sejumlah siklus yang umumnya sepuluh, menurut Raghunathan et al. 2002, dan imputasi diperbarui di setiap siklus.
- Di akhir siklus, nilai hilang idealnya digantikan dengan nilai prediksi yang paling mencerminkan hubungan yang teridentifikasi dalam data.
Implementasinya dilakukan menggunakan pustaka miceforest.
Pertama, kita perlu memasang pustaka menggunakan pip.
pip install miceforestKemudian kita impor modul ImputationKernel dan membuat kernel untuk imputasi.
from miceforest import ImputationKernel
mice_kernel = ImputationKernel(
data = sample_customer_data,
save_all_iterations = True,
random_state = 2023
)Selanjutnya, kita menjalankan kernel pada data selama dua iterasi, dan akhirnya membuat data hasil imputasi.
mice_kernel.mice(2)
mice_imputation = mice_kernel.complete_data()
mice_imputation.head()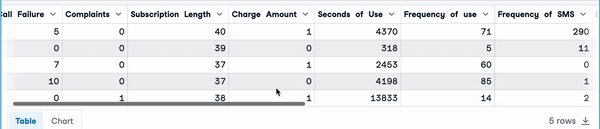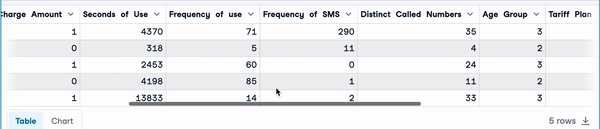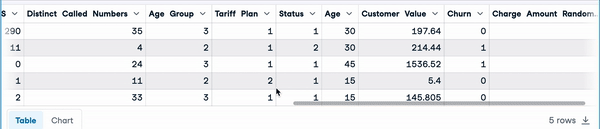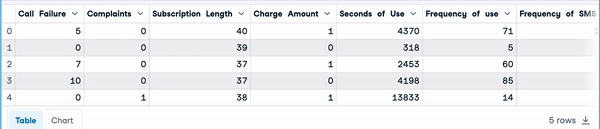
Multiple imputation
Kelebihan
- Multiple imputation efektif menangani data hilang pada banyak variabel dan berbagai tipe data.
- Pendekatan ini dapat menghasilkan hasil yang jauh lebih baik daripada imputasi mean dan median.
- Banyak algoritme lain, seperti K-Nearest Neighbors, Random forest, dan neural networks, dapat digunakan sebagai tulang punggung prediksi multiple imputation untuk membuat prediksi.
Kekurangan
- Multiple imputation mengasumsikan bahwa data hilang secara acak (MAR).
- Terlepas dari semua manfaatnya, pendekatan ini dapat memakan biaya komputasi lebih besar dibanding teknik lain, terutama saat bekerja dengan dataset besar.
- Pendekatan ini memerlukan upaya lebih dibanding yang sebelumnya.
Dari semua imputasi, dimungkinkan untuk mengidentifikasi mana yang paling mendekati distribusi data asli.
Mean (kuning) dan median (merah) jauh dari distribusi asli data kolom “Charge amount”, sehingga tidak dianggap baik untuk imputasi data.
mean_imputation["Charge Amount Mean Imp"] = mean_imputation["Charge Amount"]
median_imputation["Charge Amount Median Imp"] = median_imputation["Charge Amount"]
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]Dengan kolom baru yang dibuat untuk tiap jenis imputasi, kini kita dapat memplot distribusinya.
import matplotlib.pyplot as plt
plt.figure(figsize=(12,8))
sample_customer_data["Charge Amount"].plot(kind='kde',color='blue')
mean_imputation["Charge Amount Mean Imp"].plot(kind='kde',color='yellow')
median_imputation["Charge Amount Median Imp"].plot(kind='kde',color='red')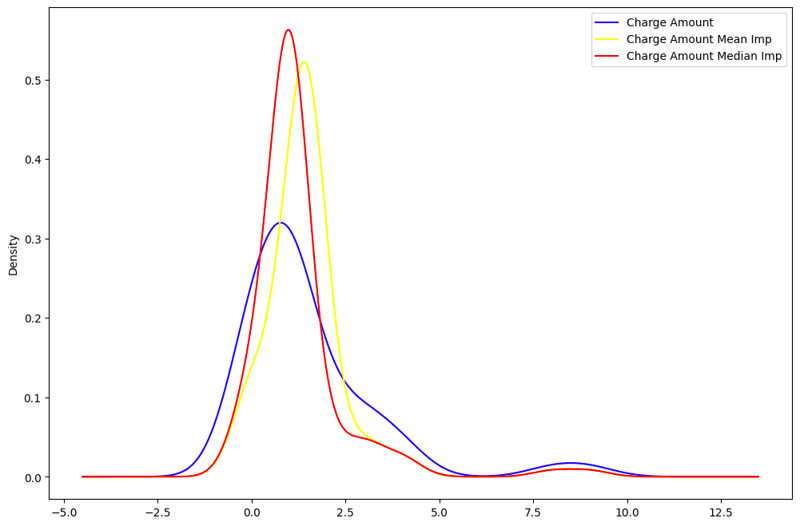
Distribusi “Charge Amount”: data asli vs. mean vs. median.
Saat memplot multiple imputation dan imputasi acak di bawah, distribusi ini tumpang tindih sempurna dengan data asli. Ini berarti imputasi tersebut lebih baik daripada imputasi mean dan median.
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"] = mice_imputation["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"].plot(kind='kde',color='black')
random_sample_imp_df["Charge Amount Random Imp"].plot(kind='kde',color='purple')
plt.legend()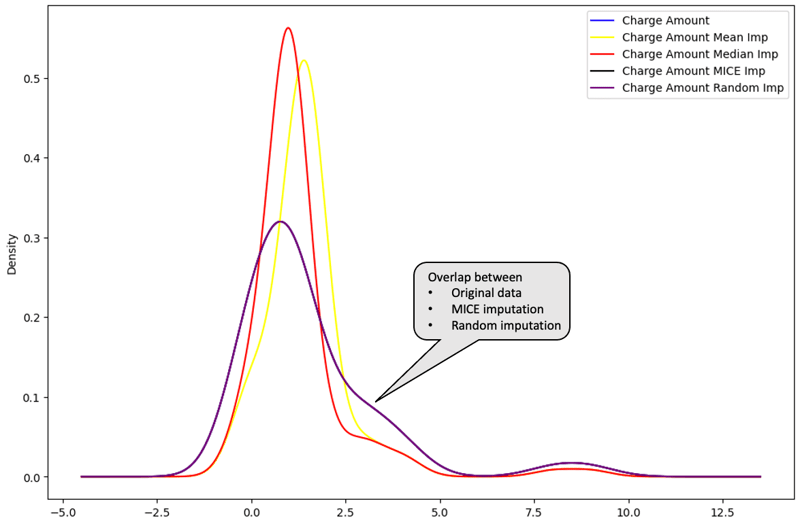
Distribusi “Charge Amount”: data asli vs. mean vs. median vs. MICE vs.random
Kursus Handling Missing Data with Imputations in R adalah sumber yang bagus untuk mempelajari lebih lanjut strategi menangani nilai hilang. Kursus ini membahas cara menerapkan visualisasi dan uji statistik untuk mengenali pola data hilang dan cara mengimputasinya dengan teknik statistik maupun machine learning.
Sejalan dengan itu, kursus dealing with missing data in python menjelaskan cara mengidentifikasi, menganalisis, menghapus, dan mengimputasi data hilang di Python.
Praktik Terbaik
Memilih metode imputasi yang tepat berdasarkan jenis data hilang
Ada banyak strategi imputasi, dan tidak boleh digunakan secara membabi buta. Mengadopsi pendekatan yang tepat dapat mencegah timbulnya bias dalam data dan keputusan yang salah.
Tabel berikut mengilustrasikan metode imputasi mana yang digunakan berdasarkan jenis data hilang. Daftar metodenya tidak lengkap, namun ini yang paling umum digunakan.
|
Jenis data hilang |
Metode imputasi |
|
Missing Completely At Random |
Mean, Median, Mode, atau metode imputasi lainnya |
|
Missing At Random |
Multiple imputation, Regression imputation |
|
Missing Not At Random |
Pattern Substitution, Maximum Likelihood estimation |
Menilai dampak imputasi terhadap analisis keseluruhan
Penting untuk diingat bahwa data asli tidak dapat dipulihkan apa pun teknik imputasinya. Namun, dimungkinkan menggunakan teknik yang dapat menghasilkan dataset imputasi yang sedekat mungkin dengan kenyataan.
Berikut beberapa langkah kunci yang perlu dipertimbangkan saat penilaian.
- Jalankan beberapa teknik imputasi untuk mengidentifikasi yang paling andal. Ini dapat membantu mengidentifikasi bias dan variasi dari satu teknik ke teknik lainnya.
- Bandingkan data akhir hasil imputasi dengan data asli tanpa imputasi untuk menilai keandalan metode imputasi.
- Sertakan proses imputasi dalam keseluruhan pipeline analisis mulai dari pembersihan data hingga membangun model machine learning apa pun.
Mengomunikasikan data hilang dan metode imputasi kepada pemangku kepentingan
Memiliki data berkualitas baik adalah tujuan setiap pemangku kepentingan dan praktisi data.
Kejujuran dan transparansi adalah kunci saat mengomunikasikan data yang hilang dari analisis. Berikut beberapa aspek penting yang perlu dipertimbangkan.
- Pahami konteks data hilang, apakah MCAR, MAR, atau MNAR.
- Jelaskan dan dokumentasikan dengan jelas metode yang digunakan untuk menangani data hilang dari keseluruhan data serta bahas kelebihan dan kekurangan tiap pendekatan.
- Komunikasikan hasil dengan cara yang dapat dipahami oleh para pemangku kepentingan.
Kesimpulan
Artikel ini membahas apa itu data hilang dan dampaknya pada proses pengambilan keputusan berbasis data. Artikel ini juga memandu Anda melalui beberapa strategi untuk menanganinya, beserta kelebihan dan kekurangannya untuk pengambilan keputusan yang dapat ditindaklanjuti.
Kami berharap ini memberi Anda strategi yang relevan untuk menangani masalah nilai hilang secara efisien.
FAQ Nilai Hilang
Apa itu data hilang?
Data hilang berarti sebagian atau seluruh variabel dalam data memiliki nilai yang hilang.
Apa saja jenis data hilang yang berbeda?
Ada tiga jenis utama data hilang. Missing Completely at Random (MCAR), Missing At Random (MAR), dan Missing Not At Random (MNAR)
Bagaimana cara menangani data hilang?
Pendekatan berikut dapat diadopsi untuk menangani nilai hilang: imputasi mean, median, modus, imputasi sampel acak, dan multiple imputation. Daftar ini tidak lengkap, dan masing-masing metode memiliki kelebihan dan kekurangan.
Mengapa data hilang itu penting?
Data hilang penting untuk dipertimbangkan karena dapat memengaruhi kinerja model machine learning Anda, dan membiaskan kesimpulan dari seluruh analisis statistik atas data, sehingga membuat bisnis mengambil keputusan yang salah.




Menangani data hilang adalah masalah umum dan melekat dalam pengumpulan data, terutama saat bekerja dengan dataset besar. Ada berbagai alasan terjadinya data hilang, seperti informasi yang tidak lengkap dari peserta, tidak ada respons dari mereka yang menolak berbagi informasi, survei yang dirancang dengan buruk, atau penghapusan data demi kerahasiaan.
Jika tidak ditangani dengan tepat, data hilang dapat memengaruhi bias kesimpulan dari seluruh analisis statistik atas data, sehingga membuat bisnis mengambil keputusan yang salah.
Artikel ini akan berfokus pada beberapa teknik untuk menangani nilai hilang secara efisien dan implementasinya di Python. Kami akan menjelaskan kelebihan dan kekurangan tiap teknik untuk membantu Anda memilih yang tepat sesuai situasi.
Mengidentifikasi Data Hilang
Data hilang muncul dalam berbagai format. Bagian ini menjelaskan berbagai jenis data hilang dan cara mengidentifikasinya.
Jenis data hilang
Ada tiga jenis utama data hilang: (1) Missing Completely at Random (MCAR), (2) Missing at Random (MAR), dan (3) Missing Not at Random (MNAR).
Penting untuk memahami masing-masing jenis ini guna memilih metode penanganan yang sesuai.
1) MCAR - Missing completely at random
Ini terjadi jika semua variabel dan observasi memiliki probabilitas yang sama untuk hilang. Bayangkan memberikan anak-anak Lego dengan warna berbeda untuk membangun rumah. Setiap Lego mewakili potongan informasi, seperti bentuk dan warna. Si anak mungkin kehilangan beberapa Lego saat bermain. Lego yang hilang ini mewakili informasi yang hilang, layaknya ketika mereka tidak ingat bentuk atau warna Lego yang dimiliki. Informasi itu hilang secara acak, tetapi tidak mengubah informasi yang dimiliki anak tentang Lego lainnya.
2) MAR - Missing at random
Pada MAR, probabilitas suatu nilai hilang berkaitan dengan nilai variabel tersebut atau variabel lain dalam dataset. Artinya, tidak semua observasi dan variabel memiliki peluang yang sama untuk hilang. Contoh MAR adalah survei di komunitas Data di mana data scientist yang jarang meningkatkan keterampilannya cenderung tidak mengetahui algoritma atau teknologi mutakhir, sehingga melewatkan pertanyaan tertentu. Data hilang dalam kasus ini terkait seberapa sering data scientist tersebut meningkatkan keterampilannya.
3) MNAR- Missing not at random
MNAR dianggap sebagai skenario paling sulit di antara tiga jenis data hilang. Ini berlaku ketika MAR maupun MCAR tidak berlaku. Dalam situasi ini, probabilitas hilang benar-benar berbeda untuk nilai-nilai berbeda dari variabel yang sama, dan alasannya bisa tidak kita ketahui. Contoh MNAR adalah survei tentang pasangan menikah. Pasangan dengan hubungan buruk mungkin tidak ingin menjawab pertanyaan tertentu karena merasa malu.
Metode mengidentifikasi data hilang
Ada beberapa metode yang dapat digunakan untuk mengidentifikasi data hilang di pandas. Berikut yang paling sering digunakan.
Fungsi
Deskripsi
.isnull()
Fungsi ini mengembalikan pandas dataframe, di mana tiap nilai berupa boolean True jika nilainya hilang, False jika tidak.
.notnull()
Serupa dengan fungsi sebelumnya, nilai untuk fungsi ini adalah False jika terdeteksi nilai NaN atau None.
.info()
Fungsi ini menghasilkan tiga kolom utama, termasuk “Non-Null Count” yang menunjukkan jumlah nilai tidak hilang untuk tiap kolom.
.isna()
Fungsi ini mirip dengan isnull dan notnull. Namun hanya menampilkan True ketika nilai hilang bertipe NaN.