

Missing Data को संभालना
Missing data को संभालने के कई तरीके मौजूद हैं। इस अनुभाग में उनमें से कुछ तरीकों के साथ उनके लाभ और सीमाएँ शामिल हैं।
उदाहरण को बेहतर ढंग से समझाने के लिए, हम DataLab पर उपलब्ध Loan Data और ट्यूटोरियल में शामिल सोर्स कोड का उपयोग करेंगे।
क्योंकि डेटासेट में कोई missing value नहीं है, हम डेटा का एक उपसमुच्चय (100 पंक्तियाँ) लेंगे और फिर manually missing values डालेंगे।
import pandas as pdsample_customer_data = pd.read_csv("data/customer_churn.csv", nrows=100)
sample_customer_data.info()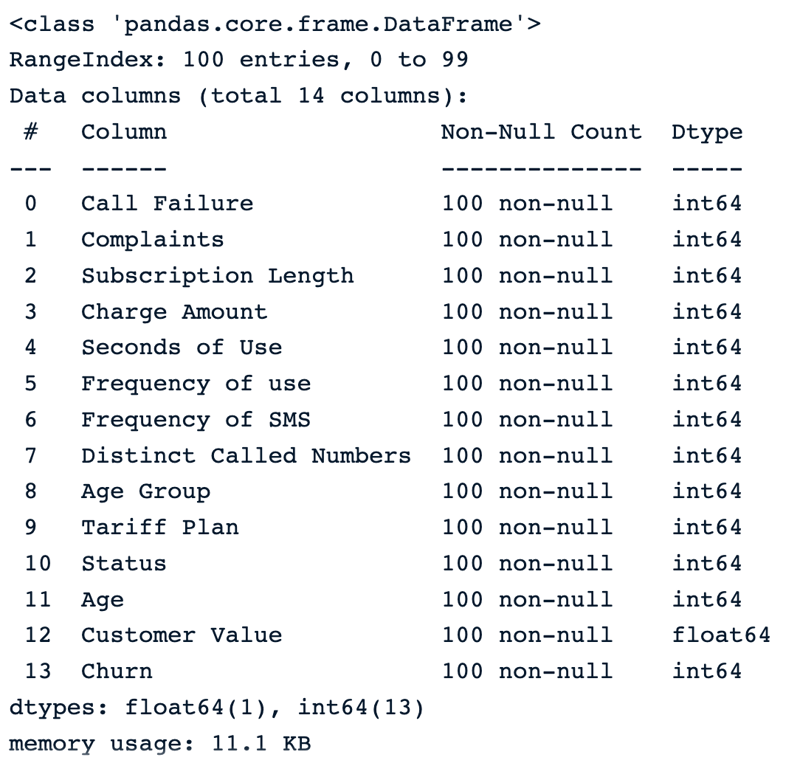
missing values डालने से पहले 100 यादृच्छिक नमूनों का सैंपल
आइए dataframe के प्रत्येक कॉलम में 50% missing values डालें।
import numpy as np
def introduce_nan(x,percentage):
n = int(len(x)*(percentage - x.isna().mean()))
idxs = np.random.choice(len(x), max(n,0), replace=False, p=x.notna()/x.notna().sum())
x.iloc[idxs] = np.nanडेटा पर फ़ंक्शन लागू करने पर यह परिणाम मिलता है।
sample_customer_data.apply(introduce_nan, percentage=.5)
sample_customer_data.info()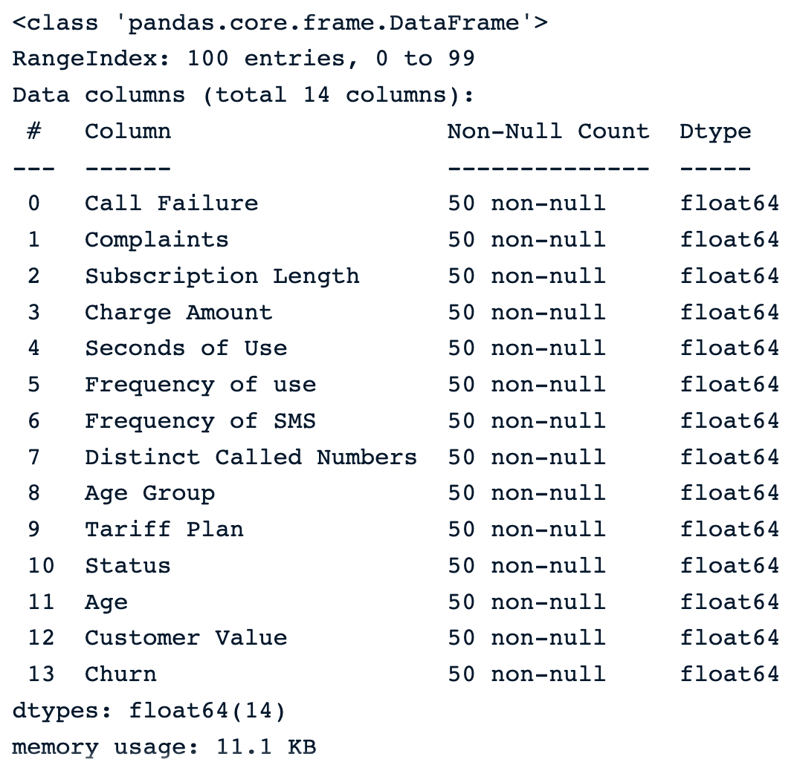
missing values डालने के बाद 100 यादृच्छिक नमूनों का सैंपल
नीचे डेटासेट की पहली पाँच पंक्तियाँ दी गई हैं।
sample_customer_data.head()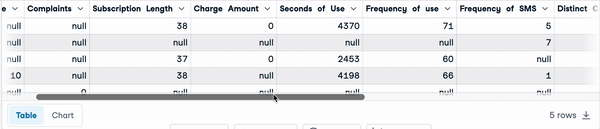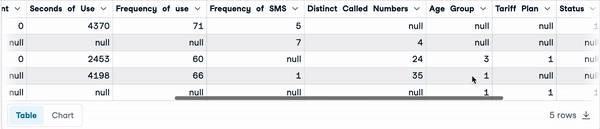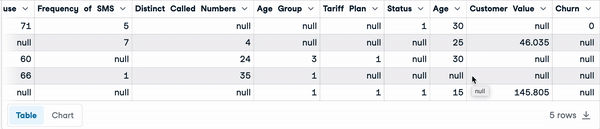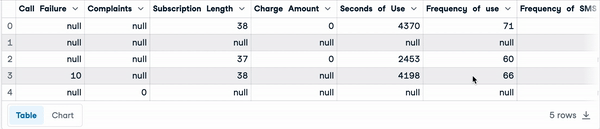
null values के साथ पहली पाँच पंक्तियाँ
Data Dropping
dropna() फ़ंक्शन का उपयोग करके dataframe से missing values वाली ऑब्ज़र्वेशंस या फीचर्स को हटाना सबसे आसान तरीका है। नीचे कुछ तकनीकें दी गई हैं।
1) missing values वाली ऑब्ज़र्वेशंस हटाएँ
डेटासेट से ऑब्ज़र्वेशंस हटाते समय ये तीन स्थितियाँ हो सकती हैं:
dropna(): missing values वाली सभी पंक्तियाँ हटाता है।
drop_na_strategy = sample_customer_data.dropna()
drop_na_strategy.info()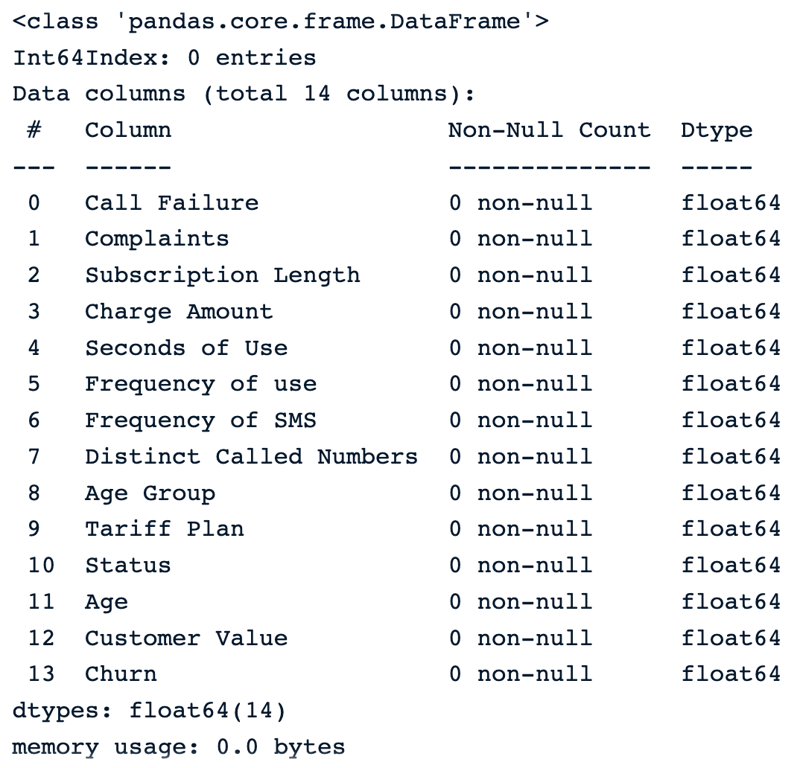
डिफ़ॉल्ट dropna() फ़ंक्शन का उपयोग कर ऑब्ज़र्वेशंस हटाएँ
हम देखते हैं कि डेटासेट से सभी ऑब्ज़र्वेशंस हट गई हैं, जो शेष विश्लेषण के लिए विशेष रूप से खतरनाक हो सकता है।
dropna(how = ‘all’): वे पंक्तियाँ जहाँ सभी कॉलम मान missing हैं।
drop_na_all_strategy = sample_customer_data.dropna(how="all")
drop_na_all_strategy.info()नीचे के आउटपुट से, हमें पता चलता है कि ऐसी कोई ऑब्ज़र्वेशन नहीं है जिसमें सभी कॉलम missing हों।
“all” रणनीति का उपयोग कर ऑब्ज़र्वेशंस हटाएँ
dropna(thresh = minimum_value): थ्रेशोल्ड के आधार पर पंक्तियाँ हटाएँ। यह रणनीति न्यूनतम non-missing मानों की संख्या तय करती है ताकि पंक्तियाँ बनी रहें।
drop_na_thres_strategy = sample_customer_data.dropna(thresh=0.6)
drop_na_thres_strategy.info()थ्रेशोल्ड 60% रखने पर परिणाम पिछले जैसा ही है।
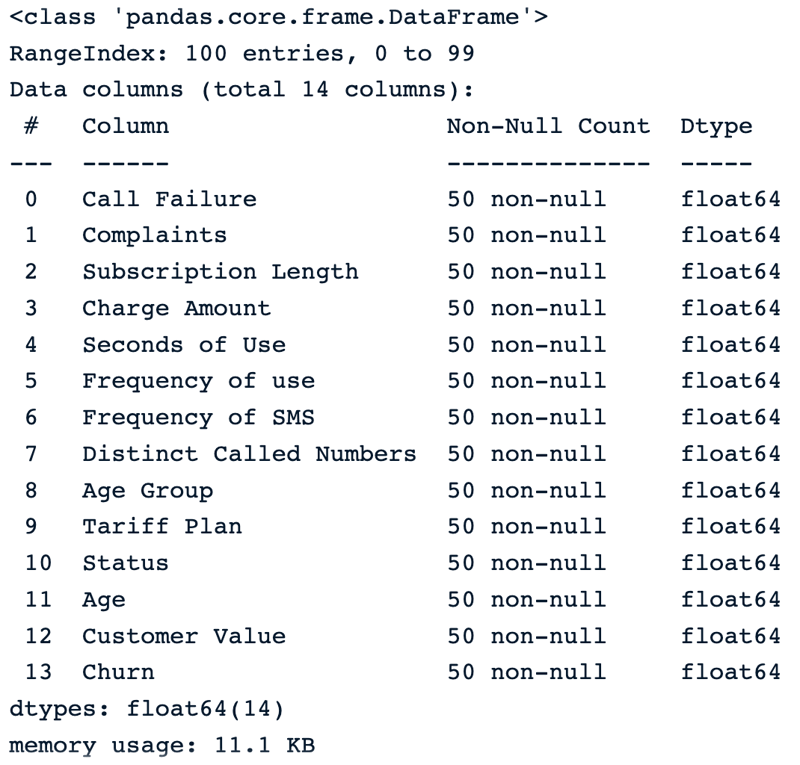
थ्रेशोल्ड का उपयोग कर ऑब्ज़र्वेशंस हटाएँ
2) missing values वाले कॉलम हटाएँ
axis = 1 पैरामीटर का उपयोग करके हम स्पष्ट कर सकते हैं कि हम पंक्तियों के बजाय कॉलम में रुचि रखते हैं।
dropna(axis = 1): missing values वाले सभी कॉलम हटाता है।
drop_na_cols_strategy = sample_customer_data.dropna(axis=1)
drop_na_cols_strategy.info()डेटा में अब कोई कॉलम नहीं बचा। ऐसा इसलिए क्योंकि हर कॉलम में कम से कम एक missing value है।
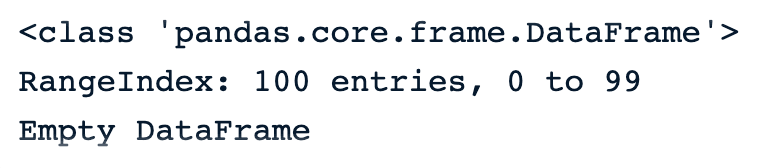
कॉलम पर dropna() के बाद खाली dataframe
अन्य कई तरीकों की तरह, dropna() के भी कुछ फायदे और नुकसान हैं।
Pros
- सीधा और उपयोग में सरल।
- जब missing values महत्वपूर्ण न हों, तब उपयोगी।
Cons
- इस तरीके से जानकारी का नुकसान हो सकता है, जो अंतिम डेटासेट में पक्षपात ला सकता है।
- जब डेटा पूरी तरह यादृच्छिक रूप से missing नहीं है, तब यह उपयुक्त नहीं।
- यदि बड़े अनुपात में missing values हों, तो डेटासेट काफी घट सकता है, जिससे उस पर होने वाले समस्त सांख्यिकीय विश्लेषण के परिणाम प्रभावित हो सकते हैं।
Mean/Median Imputation
ये प्रतिस्थापन रणनीतियाँ आत्म-व्याख्यात्मक हैं। Mean और median imputation क्रमशः किसी दिए गए कॉलम के missing values को उसी कॉलम के non-missing मानों के mean और median से प्रतिस्थापित करते हैं।
नॉर्मल वितरण आदर्श परिदृश्य है। दुर्भाग्यवश, यह हमेशा संभव नहीं होता। ऐसे में median imputation सहायक होता है क्योंकि यह outliers के प्रति संवेदनशील नहीं है।
Python में, pandas का fillna() फ़ंक्शन इन प्रतिस्थापनों के लिए उपयोग किया जा सकता है।
- Mean imputation का उदाहरण।
mean_value = sample_customer_data.mean()
mean_imputation = sample_customer_data.fillna(mean_value)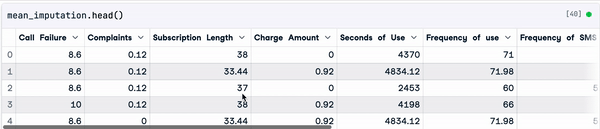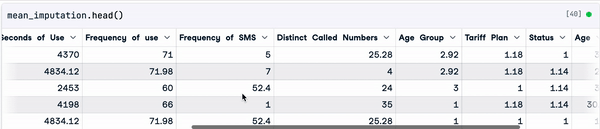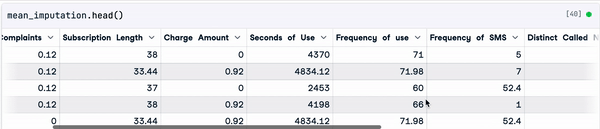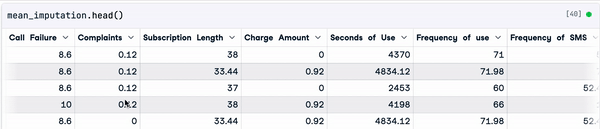
Mean imputation का परिणाम
- Median imputation का उदाहरण
median_value = sample_customer_data.median()
median_imputation = sample_customer_data.fillna(median_value)
median_imputation.head()
Median imputation का परिणाम
Pros
- सादगी और लागू करने में आसानी mean और median imputation के लाभ हैं।
- इम्प्यूटेशन non-missing डेटा से उपलब्ध जानकारी का उपयोग कर किया जाता है; इसलिए अतिरिक्त डेटा की आवश्यकता नहीं।
- Mean और median imputation क्रमशः नॉर्मल वितरित डेटा और skewed डेटा के लिए missing values का अच्छा अनुमान दे सकते हैं।
Cons
- इन दोनों रणनीतियों को कैटेगरिकल कॉलम्स पर लागू नहीं किया जा सकता। ये केवल संख्यात्मक कॉलम्स पर काम करती हैं।
- Mean imputation outliers के प्रति संवेदनशील है और डेटा की केन्द्रीय प्रवृत्ति का अच्छा प्रतिनिधित्व न कर पाए। इसी प्रकार median भी हमेशा बेहतर प्रतिनिधि नहीं हो सकता।
- Median imputation यह मानता है कि डेटा पूरी तरह यादृच्छिक रूप से missing (MCAR) है, जो हमेशा सत्य नहीं।
Random Sample Imputation
Random sample imputation के पीछे का विचार पहले के तरीकों से अलग है और इसमें अतिरिक्त चरण शामिल होते हैं।
- पहले, मूल डेटा से दो उपसमुच्चय बनाए जाते हैं।
- पहला उपसमुच्चय वे सभी ऑब्ज़र्वेशंस रखता है जिनमें missing डेटा नहीं है, और दूसरा उनमें से है जिनमें missing डेटा है।
- फिर, प्रत्येक उपसमुच्चय से यादृच्छिक रूप से एक-एक ऑब्ज़र्वेशन चुना जाता है।
- इसके बाद, पहले चुने गए ऑब्ज़र्वेशन के missing डेटा को उस ऑब्ज़र्वेशन के उपलब्ध मानों से बदला जाता है जिसमें सारा डेटा उपलब्ध है।
- अंत में, यह प्रक्रिया तब तक चलती है जब तक कोई missing जानकारी न बचे।
def random_sample_imputation(df):
cols_with_missing_values = df.columns[df.isna().any()].tolist()
for var in cols_with_missing_values:
# extract a random sample
random_sample_df = df[var].dropna().sample(df[var].isnull().sum(),
random_state=0)
# re-index the randomly extracted sample
random_sample_df.index = df[
df[var].isnull()].index
# replace the NA
df.loc[df[var].isnull(), var] = random_sample_df
return dfdf = sample_customer_data.copy()
random_sample_imp_df = random_sample_imputation(sample_customer_data)
random_sample_imp_df.head()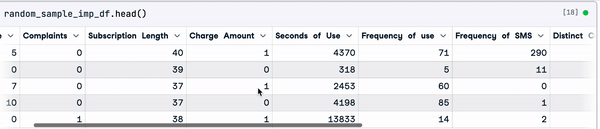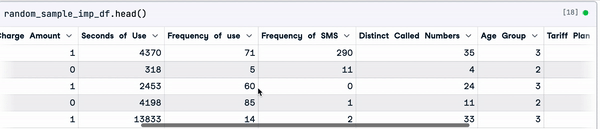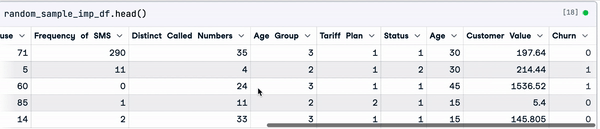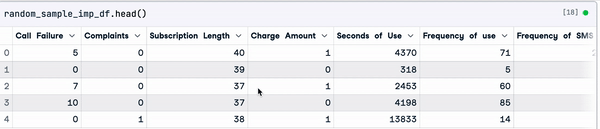
Random sample imputation
Pros
- यह एक सरल और सीधी तकनीक है।
- यह संख्यात्मक और कैटेगरिकल दोनों डेटा प्रकारों को संभालती है।
- डेटा variance में कम विकृति आती है, और यह मूल वितरण को संरक्षित रखती है, जो mean, median आदि में नहीं होता।
Cons
- यादृच्छिकता हर स्थिति में काम नहीं करती, और यह डेटा में शोर ला सकती है, जिससे गलत सांख्यिकीय निष्कर्ष निकल सकते हैं।
- Mean और median की तरह, यह तरीका भी मानता है कि डेटा पूरी तरह यादृच्छिक रूप से missing (MCAR) है।
Multiple Imputation
यह एक बहुवेरियेबल (multivariate) imputation तकनीक है, यानी missing जानकारी को अन्य कॉलम्स की जानकारी को ध्यान में रखते हुए भरा जाता है।
उदाहरण के लिए, यदि किसी व्यक्ति की आय (income) का मान missing है, तो यह अनिश्चित है कि उनके पास mortgage है या नहीं। इसलिए सही मान तय करने के लिए क्रेडिट स्कोर, व्यवसाय, और क्या व्यक्ति के पास घर है या नहीं जैसी अन्य विशेषताओं का मूल्यांकन आवश्यक है।
Multiple Imputation by Chained Equations (संक्षेप में MICE) बहुवेरियेबल imputation की सबसे लोकप्रिय विधियों में से एक है। MICE पद्धति को बेहतर समझने के लिए, चर के एक सेट X1, X2, … Xn पर विचार करें, जिनमें से कुछ या सभी में missing values हैं।
एल्गोरिद्म इस प्रकार काम करता है:
- प्रत्येक वेरिएबल के missing मानों को पहले एक सरल imputation रणनीति जैसे mean imputation से बदलें, जिन्हें “placeholders” माना जाता है।
- पहले वेरिएबल X1 के “placeholders” को एक regression मॉडल से रिग्रैस किया जाता है जहाँ X1 आश्रित (dependent) वेरिएबल होता है और बाकी वेरिएबल्स स्वतंत्र (independent) होते हैं। फिर X2 को आश्रित मानकर और बाकी को स्वतंत्र मानकर यही प्रक्रिया दोहराई जाती है। यह तब तक चलता है जब तक हर वेरिएबल कम से कम एक बार आश्रित वेरिएबल न बन जाए।
- मूल “placeholders” को फिर regression मॉडल से मिले प्रेडिक्शन से बदल दिया जाता है।
- यह प्रतिस्थापन प्रक्रिया कई चक्रों तक दोहराई जाती है, जो सामान्यतः दस होती है, Raghunathan et al. 2002 के अनुसार, और प्रत्येक चक्र में imputation अपडेट होता है।
- चक्र के अंत में, missing मानों को आदर्श रूप से उन प्रेडिक्शन मूल्यों से बदला जाता है जो डेटा में पहचाने गए संबंधों को सबसे अच्छा प्रतिबिंबित करते हैं।
इम्प्लीमेंटेशन miceforest लाइब्रेरी का उपयोग करके किया जाता है।
पहले, हमें pip का उपयोग करके लाइब्रेरी इंस्टॉल करनी होगी।
pip install miceforestफिर हम ImputationKernel मॉड्यूल इम्पोर्ट करते हैं और imputation के लिए kernel बनाते हैं।
from miceforest import ImputationKernel
mice_kernel = ImputationKernel(
data = sample_customer_data,
save_all_iterations = True,
random_state = 2023
)इसके बाद, हम डेटा पर kernel को दो iterations के लिए चलाते हैं, और अंत में imputed डेटा बनाते हैं।
mice_kernel.mice(2)
mice_imputation = mice_kernel.complete_data()
mice_imputation.head()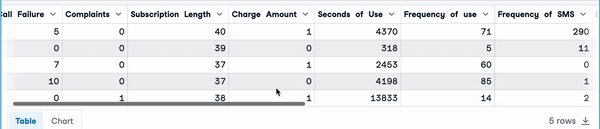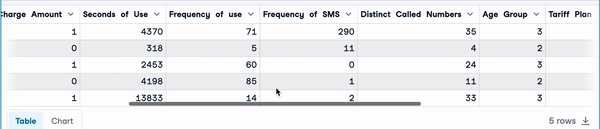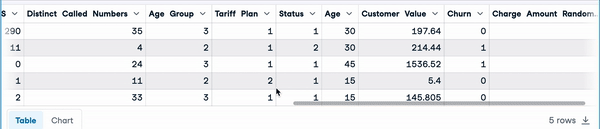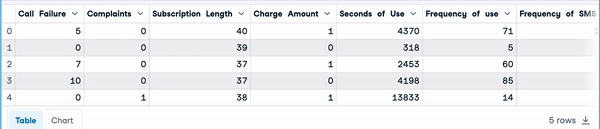
Multiple imputation
Pros
- Multiple imputation कई वेरिएबल्स और कई डेटा प्रकारों में missing data को संभालने में सक्षम है।
- यह तरीका mean और median imputations से बेहतर परिणाम दे सकता है।
- कई अन्य एल्गोरिद्म, जैसे K-Nearest Neighbors, Random forest, और neural networks, को मल्टिपल imputation प्रेडिक्शन के आधार (backbone) के रूप में उपयोग किया जा सकता है।
Cons
- Multiple imputation मानता है कि डेटा यादृच्छिक रूप से missing है (MAR)।
- लाभों के बावजूद, यह तरीका अन्य तकनीकों की तुलना में कम्प्यूटेशनल रूप से महंगा हो सकता है, खासकर बड़े डेटासेट्स के साथ।
- यह तरीका पहले के तरीकों की तुलना में अधिक प्रयास मांगता है।
सभी imputations में से यह संभव है पहचानना कि कौन सा मूल डेटा के वितरण के सबसे निकट है।
पीला रंग mean और लाल रंग median को दर्शाता है, जो “Charge amount” कॉलम के मूल वितरण से दूर हैं, इसलिए डेटा इम्प्यूट करने के लिए ये बेहतर नहीं माने जाते।
mean_imputation["Charge Amount Mean Imp"] = mean_imputation["Charge Amount"]
median_imputation["Charge Amount Median Imp"] = median_imputation["Charge Amount"]
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]हर प्रकार के imputation के लिए नए कॉलम बन जाने पर, अब हम वितरण प्लॉट कर सकते हैं।
import matplotlib.pyplot as plt
plt.figure(figsize=(12,8))
sample_customer_data["Charge Amount"].plot(kind='kde',color='blue')
mean_imputation["Charge Amount Mean Imp"].plot(kind='kde',color='yellow')
median_imputation["Charge Amount Median Imp"].plot(kind='kde',color='red')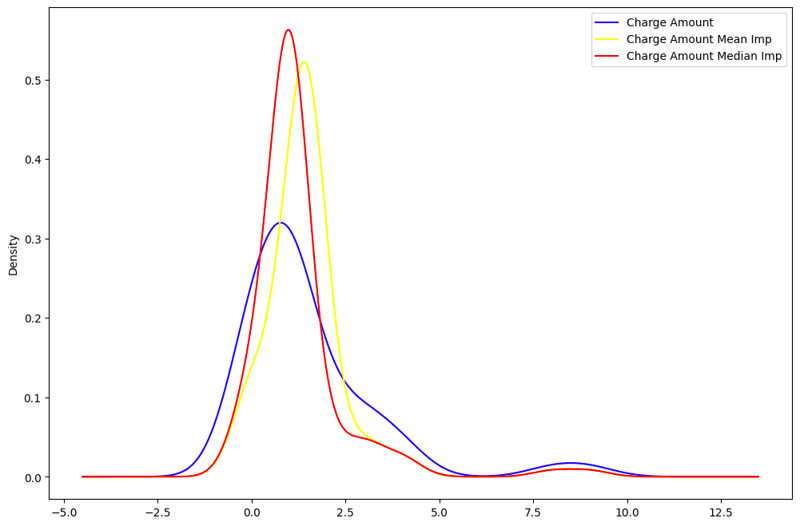
“Charge Amount” वितरण: मूल डेटा बनाम mean बनाम median
नीचे multiple imputation और random imputation प्लॉट करने पर, ये वितरण मूल डेटा के साथ पूरी तरह ओवरलैप होते हैं। इसका मतलब है कि ये imputations, mean और median imputations से बेहतर हैं।
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"] = mice_imputation["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"].plot(kind='kde',color='black')
random_sample_imp_df["Charge Amount Random Imp"].plot(kind='kde',color='purple')
plt.legend()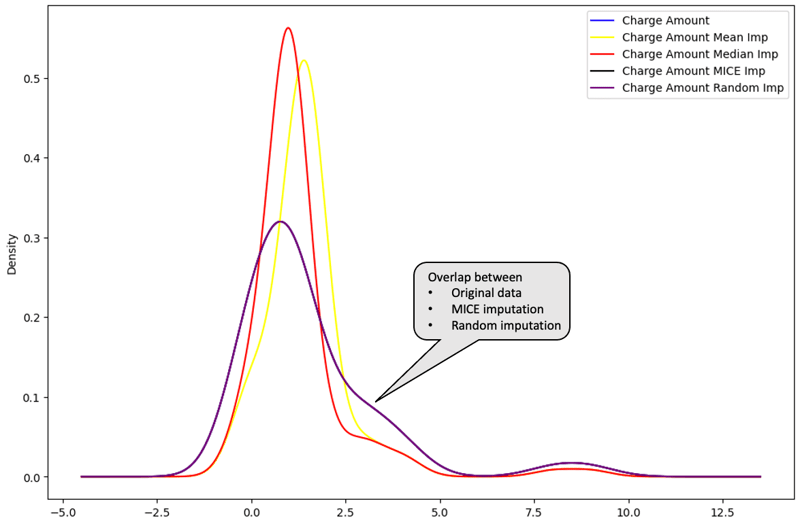
“Charge Amount” वितरण: मूल डेटा बनाम mean बनाम median बनाम MICE बनाम random
Handling Missing Data with Imputations in R कोर्स missing values को संभालने की रणनीतियों के बारे में और अधिक जानने के लिए उत्कृष्ट संसाधन है। इसमें विज़ुअलाइज़ेशन और सांख्यिकीय परीक्षणों का उपयोग कर missing data पैटर्न पहचानना और सांख्यिकीय व मशीन लर्निंग तकनीकों से उन्हें इम्प्यूट करना शामिल है।
इसी संदर्भ में, dealing with missing data in python कोर्स Python में missing data की पहचान, विश्लेषण, हटाने और इम्प्यूट करने के तरीके समझाता है।
Best Practices
Missing data के प्रकार के आधार पर सही imputation विधि चुनना
इम्प्यूटेशन की कई रणनीतियाँ हैं, और उन्हें आँख बंद करके नहीं अपनाना चाहिए। सही तरीका अपनाने से डेटा में पक्षपात जोड़ने और गलत निर्णय लेने से बचा जा सकता है।
नीचे दी गई तालिका missing data के प्रकार के आधार पर उपयोग करने योग्य imputation तरीकों को दर्शाती है। यह सूची संपूर्ण नहीं है, लेकिन ये सबसे अधिक उपयोग में आने वाले तरीके हैं।
|
Missing data का प्रकार |
Imputation विधि |
|
Missing Completely At Random |
Mean, Median, Mode, या अन्य कोई भी imputation विधि |
|
Missing At Random |
Multiple imputation, Regression imputation |
|
Missing Not At Random |
Pattern Substitution, Maximum Likelihood estimation |
समग्र विश्लेषण पर imputation के प्रभाव का आकलन
यह ध्यान में रखना महत्वपूर्ण है कि किसी भी imputation तकनीक से मूल डेटा वापस नहीं लाया जा सकता। फिर भी, ऐसी तकनीकों का उपयोग संभव है जो वास्तविकता के अधिकतम निकट imputed डेटासेट तैयार कर सकें।
आकलन के दौरान निम्नलिखित मुख्य चरणों पर विचार करें।
- कई imputation तकनीकें चलाएँ ताकि सबसे robust विधि पहचानी जा सके। इससे एक तकनीक से दूसरी में पक्षपात और भिन्नताएँ पहचानने में मदद मिलती है।
- अंतिम imputed डेटा की तुलना मूल non-imputed डेटा से करें ताकि imputation विधि की विश्वसनीयता आँकी जा सके।
- डेटा क्लीनिंग से लेकर किसी भी मशीन लर्निंग मॉडल के निर्माण तक, imputation प्रक्रिया को समग्र विश्लेषण पाइपलाइन में शामिल करें।
हितधारकों को missing data और imputation विधियाँ संप्रेषित करना
उच्च गुणवत्ता वाला डेटा सभी हितधारकों और डेटा प्रैक्टिशनर्स का लक्ष्य होता है।
विश्लेषण से missing डेटा को संप्रेषित करते समय ईमानदारी और पारदर्शिता महत्वपूर्ण हैं। नीचे कुछ अहम पहलू दिए गए हैं।
- Missing data का संदर्भ समझें—चाहे वह MCAR, MAR, या MNAR हो।
- समग्र डेटा से missing डेटा को संभालने के लिए अपनाई गई विधियों को स्पष्ट रूप से समझाएँ और प्रलेखित करें, तथा प्रत्येक दृष्टिकोण के लाभ और सीमाएँ बताएं।
- परिणामों को ऐसे तरीके से संप्रेषित करें जिसे हितधारक आसानी से समझ सकें।
निष्कर्ष
इस लेख में missing data क्या है और डेटा-आधारित निर्णय प्रक्रिया पर उसका प्रभाव कवर किया गया। साथ ही, उन्हें संभालने की कुछ रणनीतियों, उनके लाभ और सीमाओं को भी क्रियान्वयन योग्य निर्णय लेने के लिए समझाया गया।
हमें आशा है कि यह आपको अपने missing data संबंधी मुद्दों को कुशलतापूर्वक सुलझाने के लिए उपयुक्त रणनीतियाँ प्रदान करता है।
Missing Values FAQs
Missing data क्या है?
Missing data का अर्थ है कि डेटा में कुछ या सभी वेरिएबल्स के मान अनुपस्थित हैं।
Missing data के विभिन्न प्रकार क्या हैं?
Missing data के तीन मुख्य प्रकार हैं: Missing Completely at Random (MCAR), Missing At Random (MAR), और Missing Not At Random (MNAR)
Missing data से कैसे निपटें?
Missing values से निपटने के लिए इन तरीकों को अपनाया जा सकता है: mean, median, mode imputation, random sample imputation, और multiple imputations। यह सूची संपूर्ण नहीं है, और प्रत्येक तरीके के अपने फायदे और नुकसान हैं।
Missing data महत्वपूर्ण क्यों हैं?
इन्हें इसलिए महत्व देना चाहिए क्योंकि ये आपके मशीन लर्निंग मॉडलों के प्रदर्शन को प्रभावित कर सकते हैं और डेटा पर किए गए सांख्यिकीय विश्लेषणों से निकले निष्कर्षों में पक्षपात ला सकते हैं, जिससे व्यवसाय गलत निर्णय ले सकता है।
बड़े डेटासेट्स पर काम करते समय, missing data एक सामान्य और अंतर्निहित समस्या है। इसके कई कारण हो सकते हैं, जैसे प्रतिभागियों द्वारा अधूरी जानकारी देना, जानकारी साझा करने से इनकार करने वालों से non-response, खराब तरीके से डिजाइन किए गए सर्वे, या गोपनीयता के कारण डेटा हटाना।
यदि ठीक से न संभाला जाए, तो missing data डेटा पर किए गए सभी सांख्यिकीय विश्लेषणों के निष्कर्षों में पक्षपात ला सकता है, जिससे व्यवसाय गलत निर्णय ले सकता है।
यह लेख missing values को कुशलतापूर्वक संभालने की कुछ तकनीकों और उनके Python में इम्प्लीमेंटेशन पर केंद्रित है। हम प्रत्येक तकनीक के लाभ और सीमाएँ दर्शाएंगे ताकि आप किसी भी स्थिति में सही विकल्प चुन सकें।
Missing Data की पहचान
Missing data अलग-अलग रूपों में होता है। इस अनुभाग में missing data के विभिन्न प्रकार और उन्हें पहचानने के तरीके समझाए गए हैं।
Missing data के प्रकार
मुख्य रूप से missing data के तीन प्रकार हैं: (1) Missing Completely at Random (MCAR), (2) Missing at Random (MAR), और (3) Missing Not at Random (MNAR)।
उन्हें संभालने के लिए उपयुक्त विधियाँ चुनने हेतु प्रत्येक का बेहतर समझना महत्वपूर्ण है।
1) MCAR - Missing completely at random
यह तब होता है जब सभी वेरिएबल्स और ऑब्ज़र्वेशंस के missing होने की संभावना समान हो। कल्पना करें कि एक बच्चे को अलग-अलग रंगों के Lego से घर बनाने के लिए दिया गया है। हर Lego एक जानकारी का हिस्सा दर्शाता है, जैसे आकार या रंग। खेलते-खेलते बच्चा कुछ Lego खो सकता है। ये खोए हुए Lego missing जानकारी का प्रतिनिधित्व करते हैं, जैसे कि वह उस Lego का आकार या रंग याद न रख पाए। यह जानकारी यादृच्छिक रूप से खो गई, पर इससे बाकी Lego के बारे में बच्चे के पास जो जानकारी है, वह नहीं बदलती।
2) MAR - Missing at random
MAR में, किसी मान के missing होने की संभावना उसी वेरिएबल के मान या डेटासेट के अन्य वेरिएबल्स से संबंधित होती है। यानी सभी ऑब्ज़र्वेशंस और वेरिएबल्स के missing होने की संभावना समान नहीं होती। उदाहरण के तौर पर डेटा समुदाय में एक सर्वे में, वे डेटा साइंटिस्ट जो अक्सर अपने कौशल अपडेट नहीं करते, नई state-of-the-art एल्गोरिद्म या तकनीकों से अनजान होने की अधिक संभावना रखते हैं, इसलिए कुछ प्रश्न छोड़ देते हैं। इस स्थिति में missing डेटा, डेटा साइंटिस्ट के upskill करने की आवृत्ति से संबंधित है।
3) MNAR- Missing not at random
MNAR को इन तीनों में सबसे कठिन परिदृश्य माना जाता है। यह तब लागू होता है जब न MAR और न ही MCAR लागू होते हैं। इस स्थिति में, उसी वेरिएबल के विभिन्न मानों के लिए missing होने की संभावना पूरी तरह भिन्न होती है, और इसके कारण हमारे लिए अज्ञात हो सकते हैं। उदाहरण के लिए, विवाहित जोड़ों पर एक सर्वे में, जिनका रिश्ता खराब है वे कुछ प्रश्नों का उत्तर देने से झिझक सकते हैं क्योंकि उन्हें संकोच हो सकता है।
Missing data की पहचान करने के तरीके
pandas में missing data की पहचान करने के कई तरीके हैं। नीचे सबसे प्रचलित तरीके दिए गए हैं।
Functions
Descriptions
.isnull()
यह फ़ंक्शन एक pandas dataframe लौटाता है, जहाँ प्रत्येक मान boolean होता है — अगर मान missing है तो True, अन्यथा False।
.notnull()
पिछले फ़ंक्शन के समान, इसमें मान False होते हैं यदि NaN या None पाया जाए।
.info()
यह फ़ंक्शन तीन मुख्य कॉलम दिखाता है, जिनमें “Non-Null Count” शामिल है जो प्रत्येक कॉलम में non-missing मानों की संख्या दर्शाता है।
.isna()
यह isnull और notnull के समान है। हालाँकि, यह True केवल तब दिखाता है जब missing मान NaN प्रकार का हो।