

本教程将介绍 k 近邻(kNN)算法的概念、工作流程与示例。它是一种常用于分类与回归的流行监督学习模型,有助于理解距离函数、投票机制以及超参数优化。
为更好地理解本教程,您应具备 Python 基础知识,并有使用 DataFrame 的经验。熟悉 scikit-learn 的语法也会有所帮助。kNN 常与无监督方法 k-Means 聚类混淆。如果您对此感兴趣,请参阅使用 scikit-learn 在 Python 中进行 k-Means 聚类。您也可以立即注册我们的 Python 机器学习课程,更深入学习 kNN。
通过这个动手练习练习(KNN)分类。
尽管 kNN 可用于分类与回归,本文将专注于构建分类模型。机器学习中的分类是一种监督学习任务,旨在为给定输入数据点预测一个类别标签。算法在带标签的数据集上训练,使用输入特征学习输入与相应类别标签之间的映射关系。我们可以用训练好的模型来预测新的、未见过的数据。您也可以打开这个DataLab 工作簿来运行本教程中的代码。
K 近邻算法概览
kNN 算法可视作一种投票系统:在特征空间中,由最近的“k”(k 为整数)个邻居的多数类别来决定新数据点的类别。想象一个只有几百位居民的小村庄,您需要决定投票给哪个政党。为此,您可能会去询问最近的邻居他们支持哪个政党。如果最近的 k 位邻居中多数支持 A 党,那么您很可能也会投 A 党。这与 kNN 的工作方式类似:由最近 k 个邻居的多数类别来决定新数据点的类别。
我们再用另一个例子深入理解。假设您有关于水果的数据,具体是葡萄和梨。您为每个水果记录了“圆度得分”和“直径”,并将它们绘制在图上。如果有人给您一个新水果,您也可以把它绘制到图上,然后测量到最近 k(一个数值)个点的距离,以判断它是什么水果。在下例中,若选择测量 3 个点,最近的 3 个点都是梨,因此我们可以说 100% 确定它是梨。若选择测量最近的 4 个点,其中 3 个是梨、1 个是葡萄,则可以说有 75% 的把握它是梨。我们将在后文介绍如何选择最佳的 k 值,以及测量距离的不同方式。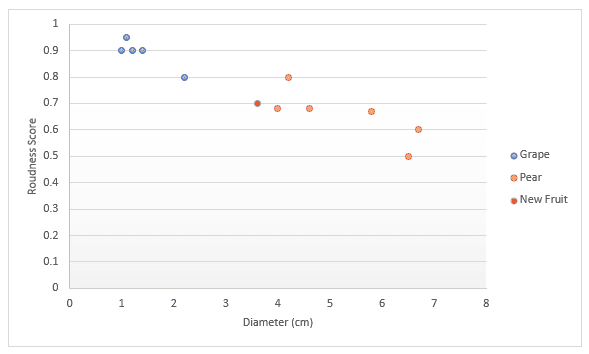
数据集
为进一步说明 kNN 算法,我们来做一个数据科学家工作中常见的案例。假设您是某电商平台的数据科学家,任务是识别欺诈交易。目前您只有以下特征:
dist_from_home:用户住址与发生交易地点之间的距离。purchase_price_ratio:本次交易中商品价格与该用户历史订单价格中位数之比。
数据包含 39 条观测,每条对应一笔交易。在本教程中,我们以变量 df 给出了数据集,其外观如下:
|
0
|
2.1
|
6.4
|
1
|
|
1
|
3.8
|
2.2
|
1
|
|
2
|
15.7
|
4.4
|
1
|
|
3
|
26.7
|
4.6
|
1
|
|
4
|
10.7
|
4.9
|
1
|
k 近邻的工作流程
为了拟合并训练该模型,我们将参考机器学习工作流程信息图。
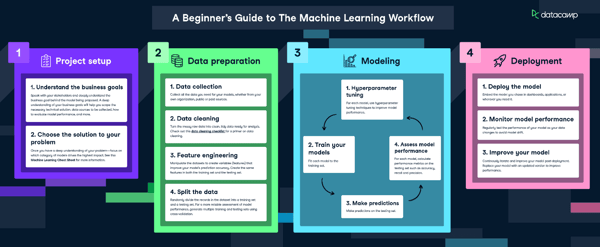
不过,由于我们的数据相当干净,并不会执行每一步。我们将进行以下步骤:
- 特征工程
- 划分数据
- 训练模型
- 超参数调优
- 评估模型性能
数据可视化
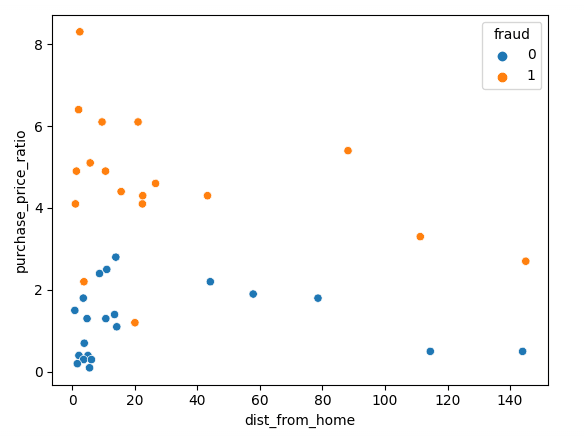
让我们用 Matplotlib 来可视化数据,将两个特征绘制为散点图。
sns.scatterplot(x=df['dist_from_home'],y=df['purchase_price_ratio'], hue=df['fraud'])可以看到,这些交易之间存在明显差异:与客户历史订单中位数相比,欺诈交易的金额更高。关于“离家距离”的趋势不太容易解读,非欺诈交易通常更接近住址,但也存在一些离群点。
数据归一化与划分
训练任何机器学习模型时,重要的一步是将数据划分为训练集和测试集。训练集用于拟合模型。算法利用训练数据学习特征与目标之间的关系,寻找可用于对新、未见数据进行预测的模式。测试集用于评估模型性能,即用模型在测试集上进行预测,并将预测结果与真实目标值进行比较。
在训练 kNN 分类器时,务必对特征进行归一化。这是因为 kNN 通过测量点与点之间的距离来工作。默认使用欧氏距离,即两个点之间差值的平方和再开方。在我们的例子中,purchase_price_ratio 的范围在 0 到 8 之间,而 dist_from_home 要大得多。如果不进行归一化,距离计算会被 dist_from_home 的较大数值严重主导。
我们应在将数据划分为训练集和测试集之后再进行归一化。这样可以防止“数据泄露”:若一次性对全部数据归一化,模型将获得关于测试集的额外信息。
以下代码将数据划分为训练/测试集,并使用scikit-learn 的 StandardScaler 进行归一化。我们先对训练数据调用 .fit_transform(),使缩放器拟合训练数据的均值与标准差。然后对测试数据调用 .transform(),使用先前学到的参数进行变换。
# Split the data into features (X) and target (y)
X = df.drop('fraud', axis=1)
y = df['fraud']
# Split the data into training and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
# Scale the features using StandardScaler
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)模型拟合与评估
现在可以训练模型了。这里我们先固定 k 为 3,稍后再进行优化。我们先创建一个 kNN 模型实例,然后将其拟合到训练数据上。我们同时传入特征与目标变量,以便模型学习。
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)模型已训练完成!我们可以对测试集进行预测,稍后用来对模型打分。
y_pred = knn.predict(X_test)评估该模型最简单的方法是使用准确率。我们将预测与测试集中的真实值进行比对,统计模型预测正确的数量。
accuracy = accuracy_score(y_test, y_pred)
print("Accuracy:", accuracy)Accuracy: 0.875这是个不错的成绩!不过,我们也许可以通过优化 k 的取值来进一步提升。
使用交叉验证获取最佳 k 值
很遗憾,没有“魔法公式”可以直接得到最佳 k。我们需要遍历多个取值,再结合判断进行选择。
在下面的代码中,我们选取一组 k 的取值范围,并创建一个空列表用于存储结果。我们使用交叉验证来获取准确率分数,这样就不需要再单独划分训练集与测试集,但仍需要对数据进行缩放。随后我们遍历各个取值,并将分数加入列表。
为实现交叉验证,我们使用scikit-learn 的 cross_val_score。我们传入一个 kNN 模型实例,以及数据与折数。在下方代码中使用了 5 折,这意味着模型将数据分为 5 份等大小的子集,每次用其中 4 份训练、1 份测试。它会对每一份循环并给出准确率,最后我们取平均以选择最佳模型。
k_values = [i for i in range (1,31)]
scores = []
scaler = StandardScaler()
X = scaler.fit_transform(X)
for k in k_values:
knn = KNeighborsClassifier(n_neighbors=k)
score = cross_val_score(knn, X, y, cv=5)
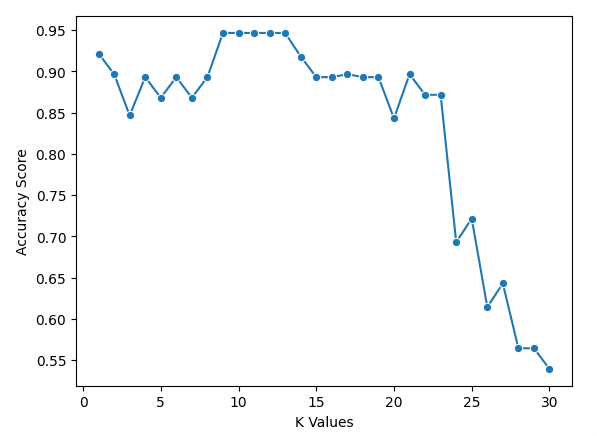
scores.append(np.mean(score))我们可以用下面的代码绘制结果
sns.lineplot(x = k_values, y = scores, marker = 'o')
plt.xlabel("K Values")
plt.ylabel("Accuracy Score")从图中可见,k = 9、10、11、12 和 13 的准确率都略低于 95%。既然它们并列为最佳,通常建议选取较小的 k 值。这是因为较大的 k 值会纳入更多距离原点更远的数据点。另一种做法是进一步探索其他评估指标。
更多评估指标
现在我们可使用最佳 k 值来训练模型,代码如下。
best_index = np.argmax(scores)
best_k = k_values[best_index]
knn = KNeighborsClassifier(n_neighbors=best_k)
knn.fit(X_train, y_train)然后用准确率、精准率与召回率进行评估(注意由于随机性,您的结果可能不同)
y_pred = knn.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
print("Accuracy:", accuracy)
print("Precision:", precision)
print("Recall:", recall)Accuracy: 0.875
Precision: 0.75
Recall: 1.0更进一步
- Supervised Learning with scikit-learn 课程是 DataCamp Python 机器学习课程体系的入门课程,涵盖 k 近邻。
- Anomaly Detection in Python、Dealing with Missing Data in Python 与 Machine Learning for Finance in Python 课程均展示了 k 近邻的应用示例。
- Decision Tree Classification in Python Tutorial 涵盖了另一种用于数据分类的机器学习模型。
- scikit-learn 速查表为常用机器学习功能提供了便捷参考。