

Eksik Verileri Ele Alma
Eksik verileri ele almak için birden fazla yaklaşım vardır. Bu bölümde bazılarını, avantajları ve dezavantajlarıyla birlikte ele alacağız.
Kullanım senaryosunu daha iyi göstermek için, öğreticide yer alan DataLab’deki Kredi Verilerini ve öğreticide yer alan kaynak kodu kullanacağız.
Veri kümesinde eksik değer olmadığından, verilerin bir alt kümesini (100 satır) kullanacak ve ardından eksik değerleri elle ekleyeceğiz.
import pandas as pdsample_customer_data = pd.read_csv("data/customer_churn.csv", nrows=100)
sample_customer_data.info()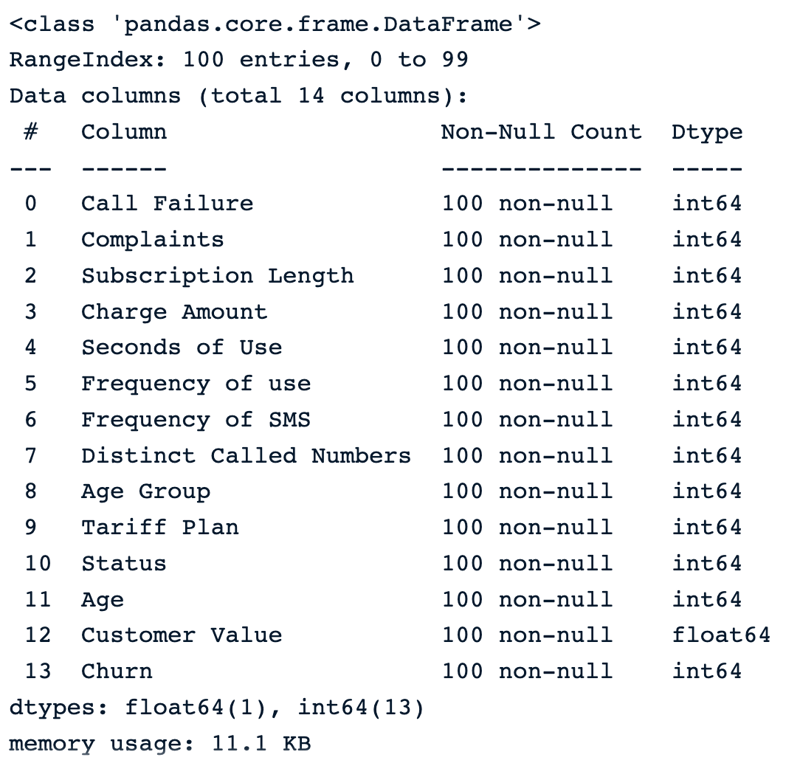
Eksik değerler eklenmeden önce 100 rastgele örnekten oluşan örneklem
Veri çerçevesindeki her sütunda %50 eksik değer ekleyelim.
import numpy as np
def introduce_nan(x,percentage):
n = int(len(x)*(percentage - x.isna().mean()))
idxs = np.random.choice(len(x), max(n,0), replace=False, p=x.notna()/x.notna().sum())
x.iloc[idxs] = np.nanFonksiyonu veriye uygulamak şu sonucu üretir.
sample_customer_data.apply(introduce_nan, percentage=.5)
sample_customer_data.info()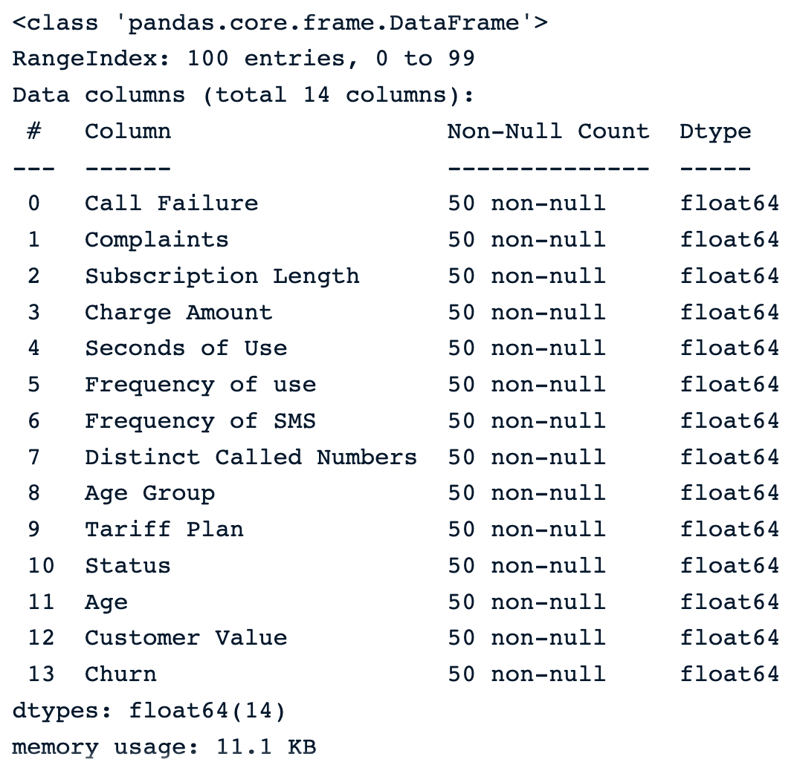
Eksik değerler eklendikten sonra 100 rastgele örnekten oluşan örneklem
Aşağıda veri kümesinin ilk beş satırı yer almaktadır.
sample_customer_data.head()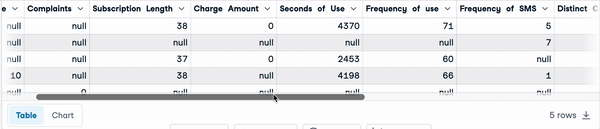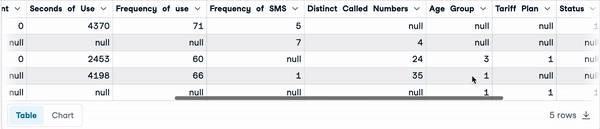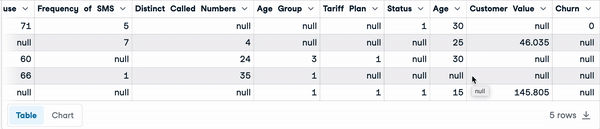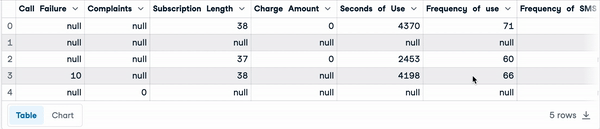
Null değerler içeren ilk beş satır
Veri Silme
dropna() fonksiyonunu kullanmak, veri çerçevesinden eksik değerlere sahip gözlemleri veya özellikleri kaldırmanın en kolay yoludur. Aşağıda bazı teknikler yer almaktadır.
1) Eksik değerlere sahip gözlemleri kaldırma
Bir veri setinden gözlemleri kaldırmaya çalışırken şu üç senaryo yaşanabilir:
dropna(): eksik değer içeren tüm satırları kaldırır.
drop_na_strategy = sample_customer_data.dropna()
drop_na_strategy.info()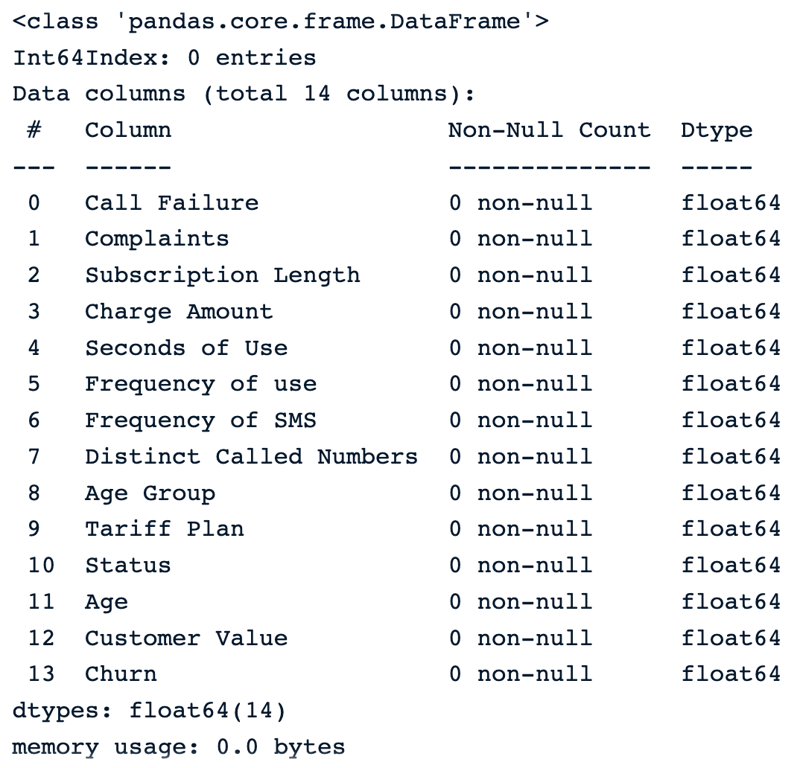
Varsayılan dropna() fonksiyonunu kullanarak gözlemleri kaldırma
Veri setinden tüm gözlemlerin kaldırıldığını görebiliyoruz; bu, analizin geri kalanı için özellikle tehlikeli olabilir.
dropna(how = ‘all’): tüm sütun değerlerinin eksik olduğu satırları kaldırır.
drop_na_all_strategy = sample_customer_data.dropna(how="all")
drop_na_all_strategy.info()Aşağıdaki çıktıda tüm sütunları eksik olan bir gözlem bulunmadığını görüyoruz.
“all” stratejisiyle gözlemleri kaldırma
dropna(thresh = minimum_value): eşik değerine göre satırları kaldırır. Bu strateji, satırların korunması için gerekli minimum eksik olmayan değer sayısını belirler.
drop_na_thres_strategy = sample_customer_data.dropna(thresh=0.6)
drop_na_thres_strategy.info()Eşik %60’a ayarlandığında sonuç, bir öncekiyle aynıdır.
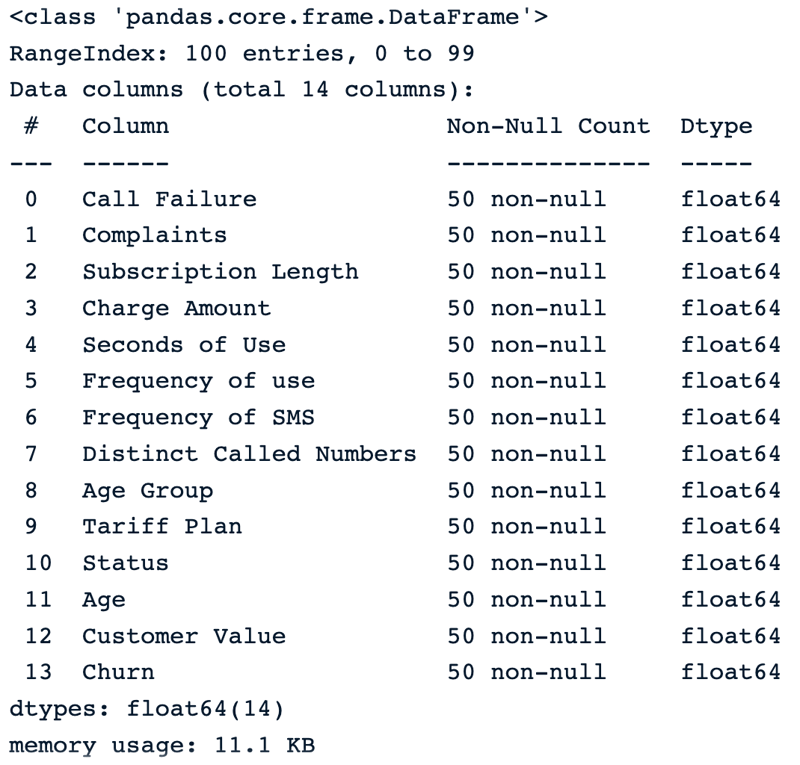
Eşik kullanarak gözlemleri kaldırma
2) Eksik değerlere sahip sütunları kaldırma
axis = 1 parametresi, satırlardan ziyade sütunlarla ilgilendiğimizi açıkça belirtmek için kullanılabilir.
dropna(axis = 1): eksik değer içeren tüm sütunları kaldırır.
drop_na_cols_strategy = sample_customer_data.dropna(axis=1)
drop_na_cols_strategy.info()Veride artık sütun kalmadı. Bunun nedeni, tüm sütunların en az bir eksik değere sahip olmasıdır.
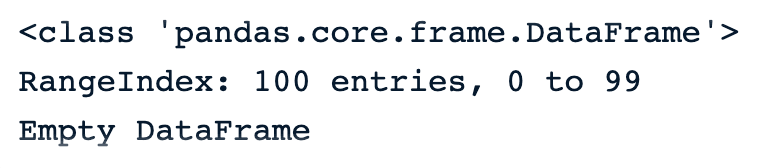
Sütunlarda dropna() sonrası boş veri çerçevesi
Pek çok yaklaşımda olduğu gibi, dropna()’nın da bazı artıları ve eksileri vardır.
Artılar
- Kullanımı doğrudan ve basittir.
- Eksik değerlerin önemi olmadığı durumlarda faydalıdır.
Eksiler
- Bu yaklaşım, bilgi kaybına yol açabilir ve nihai veri setine önyargı katabilir.
- Veriler tamamen rastgele eksik değilse uygun değildir.
- Büyük oranda eksik değer içeren veri setleri önemli ölçüde küçülebilir; bu da o veri seti üzerinde yapılan tüm istatistiksel analizlerin sonucunu etkileyebilir.
Ortalama/Medyan Atama
Bu yer değiştirme stratejileri kendini açıklayıcıdır. Ortalama ve medyan atama, sırasıyla belirli bir sütundaki eksik değerleri o sütundaki eksik olmayan değerlerin ortalaması ve medyanı ile değiştirmek için kullanılır.
Normal dağılım ideal senaryodur. Ne yazık ki her zaman böyle değildir. Bu noktada, aykırı değerlere duyarlı olmadığı için medyan atama yardımcı olabilir.
Python’da, bu değişimleri yapmak için pandas’ın fillna() fonksiyonu kullanılabilir.
- Ortalama atamanın gösterimi.
mean_value = sample_customer_data.mean()
mean_imputation = sample_customer_data.fillna(mean_value)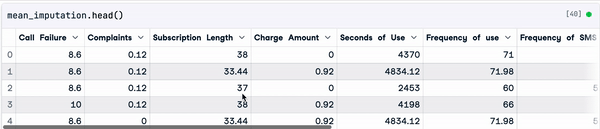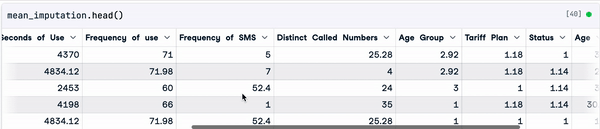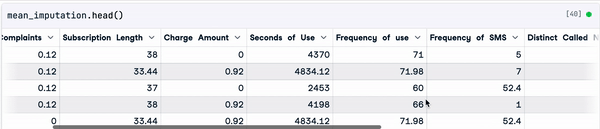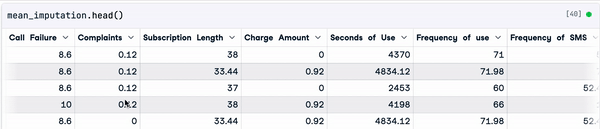
Ortalama atamanın sonucu
- Medyan atamanın gösterimi
median_value = sample_customer_data.median()
median_imputation = sample_customer_data.fillna(median_value)
median_imputation.head()
Medyan atamanın sonucu
Artılar
- Basitlik ve uygulama kolaylığı, ortalama ve medyan atamanın bazı faydalarıdır.
- Atama, eksik olmayan verilerden gelen mevcut bilgiler kullanılarak yapılır; dolayısıyla ek veriye gerek yoktur.
- Ortalama ve medyan atama, sırasıyla normal dağılan veriler ve çarpık veriler için eksik değerlere iyi birer tahmin sağlayabilir.
Eksiler
- Bu iki stratejiyi kategorik sütunlara uygulayamayız. Yalnızca sayısal olanlarda çalışırlar.
- Ortalama atama aykırı değerlere duyarlıdır ve verinin merkezi eğilimini iyi temsil etmeyebilir. Benzer şekilde medyan da merkezi eğilimi her zaman daha iyi temsil etmeyebilir.
- Medyan atama, verilerin tamamen rastgele eksik (MCAR) olduğunu varsayar; bu her zaman doğru değildir.
Rastgele Örnek Atama
Rastgele örnek atamanın ardındaki fikir, öncekilerden farklıdır ve ek adımlar içerir.
- Önce, orijinal veriden iki alt küme oluşturulur.
- İlk alt küme eksik veri içermeyen tüm gözlemleri, ikincisi ise eksik veri içerenleri kapsar.
- Ardından, her alt kümeden rastgele bir gözlem seçilir.
- Daha sonra, önceden seçilen gözlemdeki eksik veriler, tüm verileri mevcut olan gözlemdeki değerlerle değiştirilir.
- Son olarak, eksik bilgi kalmayana kadar süreç devam eder.
def random_sample_imputation(df):
cols_with_missing_values = df.columns[df.isna().any()].tolist()
for var in cols_with_missing_values:
# extract a random sample
random_sample_df = df[var].dropna().sample(df[var].isnull().sum(),
random_state=0)
# re-index the randomly extracted sample
random_sample_df.index = df[
df[var].isnull()].index
# replace the NA
df.loc[df[var].isnull(), var] = random_sample_df
return dfdf = sample_customer_data.copy()
random_sample_imp_df = random_sample_imputation(sample_customer_data)
random_sample_imp_df.head()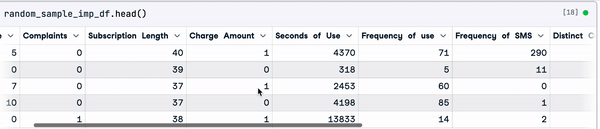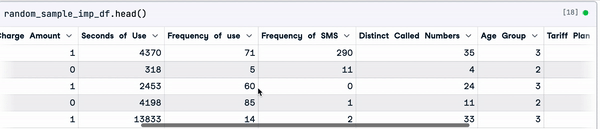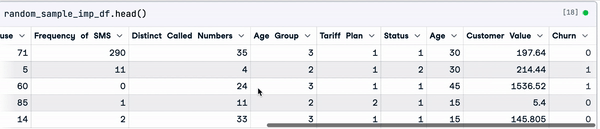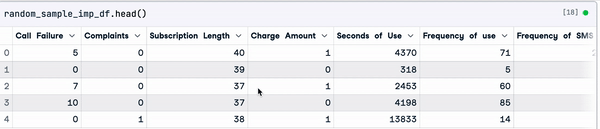
Rastgele örnek atama
Artılar
- Kolay ve doğrudan bir tekniktir.
- Hem sayısal hem kategorik veri türlerini ele alır.
- Veri varyansında daha az bozulma olur ve verinin orijinal dağılımını korur; bu, ortalama, medyan vb. için geçerli değildir.
Eksiler
- Rastgelelik her durumda işe yaramayabilir ve veriye gürültü katıp yanlış istatistiksel sonuçlara yol açabilir.
- Ortalama ve medyan gibi, bu yaklaşım da verilerin tamamen rastgele eksik (MCAR) olduğunu varsayar.
Çoklu Atama
Bu, çok değişkenli bir atama tekniğidir; yani eksik bilgiler, diğer sütunlardaki bilgiler dikkate alınarak doldurulur.
Örneğin bir kişinin gelir değeri eksikse, ipoteği olup olmadığı belirsizdir. Doğru değeri belirlemek için kredi skoru, meslek ve kişinin ev sahibi olup olmadığı gibi diğer özellikleri değerlendirmek gerekir.
Bağlı Denklemlerle Çoklu Atama (kısaca MICE), çok değişkenli atamada en popüler yöntemlerden biridir. MICE yaklaşımını daha iyi anlamak için, bazıları ya da tamamı eksik değerlere sahip olan X1, X2, … Xn değişken kümesini ele alalım.
Algoritma şu şekilde çalışır:
- Her değişken için eksik değerler, ortalama atama gibi basit bir atama stratejisiyle, “tutucu” olarak da adlandırılan değerlerle geçici olarak doldurulur.
- İlk değişken X1’in “tutucuları”, X1’in bağımlı değişken ve geri kalan değişkenlerin bağımsız değişken olduğu bir regresyon modeliyle tahmin edilir. Ardından X2 bağımlı değişken olarak kullanılır ve kalanlar bağımsız değişkendir. Tüm değişkenler en az bir kez bağımlı değişken olarak ele alınana kadar süreç böyle devam eder.
- Orijinal “tutucular” daha sonra regresyon modelinin tahminleriyle değiştirilir.
- Raghunathan vd. 2002’ye göre genellikle on olan bir sayıda döngü için bu değiştirme işlemi tekrarlanır ve her döngüde atama güncellenir.
- Döngünün sonunda, eksik değerler ideal olarak veride belirlenen ilişkileri en iyi yansıtan tahmin değerleriyle değiştirilmiş olur.
Uygulama miceforest kütüphanesi kullanılarak gerçekleştirilir.
Önce pip kullanarak kütüphaneyi kurmamız gerekir.
pip install miceforestArdından ImputationKernel modülünü içe aktarır ve atama için çekirdeği oluştururuz.
from miceforest import ImputationKernel
mice_kernel = ImputationKernel(
data = sample_customer_data,
save_all_iterations = True,
random_state = 2023
)Daha sonra, çekirdeği veri üzerinde iki yineleme çalıştırır ve son olarak ataması yapılmış veriyi oluştururuz.
mice_kernel.mice(2)
mice_imputation = mice_kernel.complete_data()
mice_imputation.head()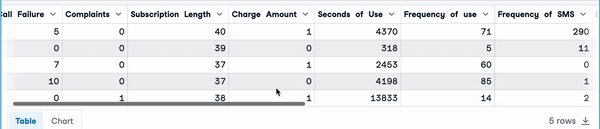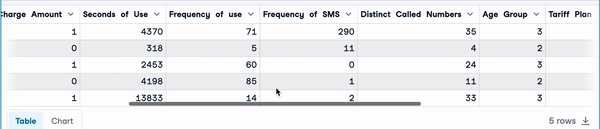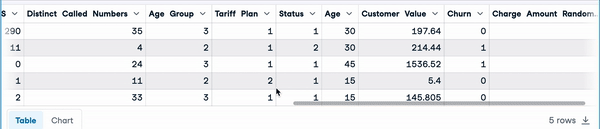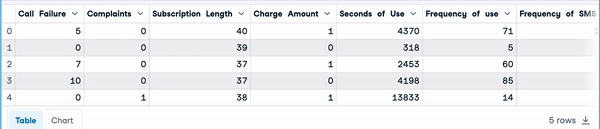
Çoklu atama
Artılar
- Çoklu atama, birden fazla değişkende ve çoklu veri türlerinde eksik verilerle başa çıkmada güçlüdür.
- Yaklaşım, ortalama ve medyan atamadan çok daha iyi sonuçlar üretebilir.
- K-En Yakın Komşular, Rastgele Orman ve yapay sinir ağları gibi birçok algoritma, tahmin yapmak için çoklu atamanın omurgası olarak kullanılabilir.
Eksiler
- Çoklu atama, verilerin rastgele eksik (MAR) olduğunu varsayar.
- Tüm faydalarına rağmen, özellikle büyük veri kümeleriyle çalışırken diğer tekniklere kıyasla hesaplama açısından maliyetli olabilir.
- Bu yaklaşım, öncekilere göre daha fazla çaba gerektirir.
Tüm atamalardan, hangisinin orijinal verinin dağılımına daha yakın olduğunu belirlemek mümkündür.
Sarı renkli ortalama ve kırmızı renkli medyan, “Charge amount” sütunu verisinin orijinal dağılımından oldukça uzaktır; bu nedenle veriyi atamak için iyi seçenekler değildir.
mean_imputation["Charge Amount Mean Imp"] = mean_imputation["Charge Amount"]
median_imputation["Charge Amount Median Imp"] = median_imputation["Charge Amount"]
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]Her atama türü için yeni sütunlar oluşturulduğuna göre, artık dağılımı görselleştirebiliriz.
import matplotlib.pyplot as plt
plt.figure(figsize=(12,8))
sample_customer_data["Charge Amount"].plot(kind='kde',color='blue')
mean_imputation["Charge Amount Mean Imp"].plot(kind='kde',color='yellow')
median_imputation["Charge Amount Median Imp"].plot(kind='kde',color='red')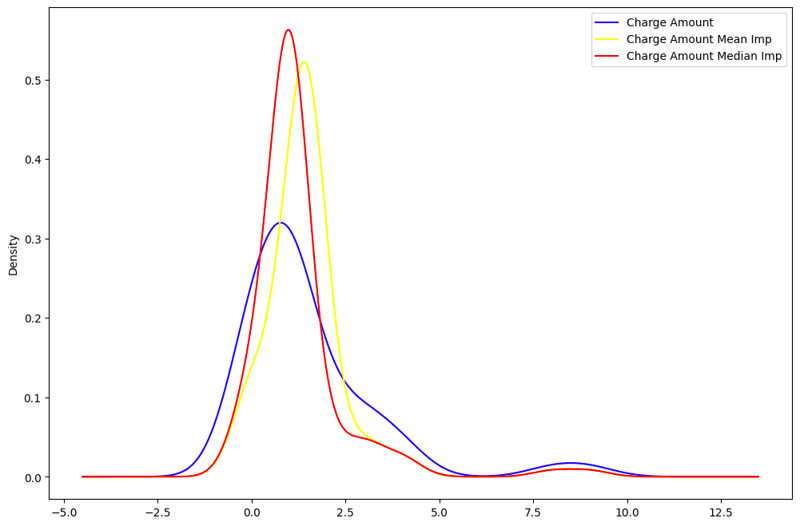
“Charge Amount” dağılımı: orijinal veri vs. ortalama vs. medyan.
Aşağıda çoklu atama ve rastgele atamayı çizdiğimizde, bu dağılımların orijinal verilerle mükemmel şekilde çakıştığını görüyoruz. Bu, bu atamaların ortalama ve medyan atamalardan daha iyi olduğu anlamına gelir.
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"] = mice_imputation["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"].plot(kind='kde',color='black')
random_sample_imp_df["Charge Amount Random Imp"].plot(kind='kde',color='purple')
plt.legend()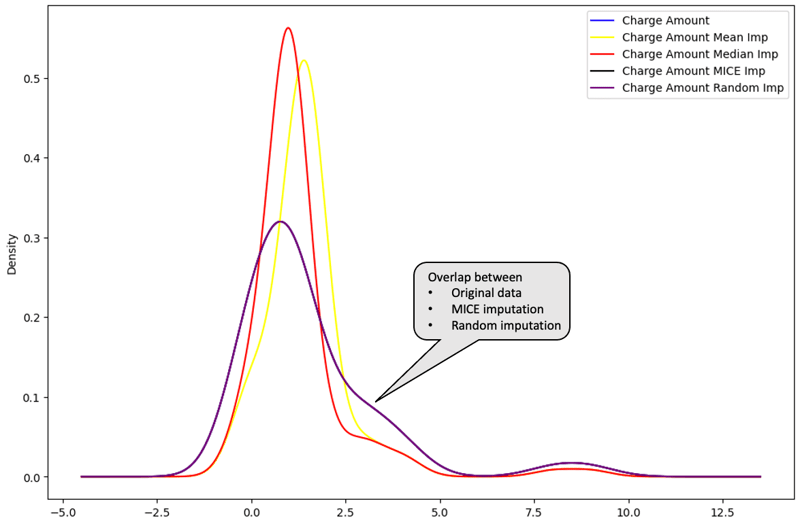
“Charge Amount” dağılımı: orijinal veri vs. ortalama vs. medyan vs. MICE vs. rastgele
R ile Atamalar Kullanarak Eksik Verileri Ele Alma kursu, eksik değerleri ele alma stratejileri hakkında daha fazla bilgi edinmek için harika bir kaynaktır. Eksik veri kalıplarını tanımak için görselleştirme ve istatistiksel testlerin nasıl uygulanacağını ve bunların hem istatistiksel hem de makine öğrenimi teknikleriyle nasıl atanacağını kapsar.
Aynı şekilde, Python’da eksik verilerle başa çıkma kursu, Python’da eksik verileri nasıl tanımlayacağınızı, analiz edeceğinizi, kaldıracağınızı ve atayacağınızı açıklar.
En İyi Uygulamalar
Eksik veri türüne göre doğru atama yöntemini seçmek
Birden fazla atama stratejisi vardır ve bunlar körü körüne kullanılmamalıdır. Doğru yaklaşımı benimsemek, veriye önyargı katmayı ve yanlış kararlar almayı önleyebilir.
Aşağıdaki tablo, eksik veri türüne göre hangi atama yönteminin kullanılacağını göstermektedir. Yöntem listesi kapsamlı değildir, ancak en yaygın kullanılanlar bunlardır.
|
Eksik veri türü |
Atama yöntemi |
|
Tamamen Rastgele Eksik |
Ortalama, Medyan, Mod veya diğer herhangi bir atama yöntemi |
|
Rastgele Eksik |
Çoklu atama, Regresyon ataması |
|
Rastgele Olmayan Eksik |
Kalıp İkamesi, En Büyük Olabilirlik kestirimi |
Atamanın genel analiz üzerindeki etkisini değerlendirmek
Hangi atama tekniği kullanılırsa kullanılsın, orijinal verinin geri getirilemeyeceğini akılda tutmak önemlidir. Ancak, gerçeğe olabildiğince yakın atanan veri setleri üreten teknikler kullanmak mümkündür.
Değerlendirme sırasında dikkate alınması gereken birkaç ana adım aşağıdadır.
- En sağlam olanı belirlemek için birden fazla atama tekniğini çalıştırın. Bu, teknikler arasındaki önyargı ve değişimleri belirlemeye yardımcı olabilir.
- Nihai atanan veriyi, orijinal (atanmamış) veriyle karşılaştırarak atama yönteminin güvenilirliğini değerlendirin.
- Atama sürecini, veri temizlemeden herhangi bir makine öğrenimi modeli kurmaya kadar genel analiz hattına dahil edin.
Eksik verileri ve atama yöntemlerini paydaşlara iletmek
Kaliteli veriye sahip olmak, tüm paydaşların ve veri uygulayıcılarının hedefidir.
Analizde eksik olan verileri iletirken dürüstlük ve şeffaflık esastır. Aşağıda dikkate alınması gereken bazı önemli noktalar vardır.
- Eksik verilerin bağlamının MCAR, MAR veya MNAR olup olduğunun farkında olun.
- Genel verilerden eksik olanları ele almak için kullanılan yöntemleri net şekilde açıklayın ve belgeleyin; her yaklaşımın fayda ve sınırlılıklarını tartışın.
- Sonuçları paydaşların anlayabileceği bir şekilde iletin.
Sonuç
Bu makalede eksik verilerin ne olduğu ve veriyle yönlendirilen karar alma sürecine etkileri ele alındı. Ayrıca, bunları ele almak için bazı stratejiler, eyleme geçirilebilir karar alma için avantaj ve dezavantajlarıyla birlikte aktarıldı.
Umarız eksik veri sorunlarınızı verimli şekilde ele almak için ilgili stratejileri sunabilmişizdir.
Eksik Değerler Hakkında SSS
Eksik veri nedir?
Eksik veri, verideki bazı ya da tüm değişkenlerin eksik değere sahip olması demektir.
Eksik verinin farklı türleri nelerdir?
Üç ana eksik veri türü vardır: Tamamen Rastgele Eksik (MCAR), Rastgele Eksik (MAR) ve Rastgele Olmayan Eksik (MNAR)
Eksik verilerle nasıl başa çıkılır?
Eksik değerlerle başa çıkmak için şu yaklaşımlar benimsenebilir: ortalama, medyan, mod atama; rastgele örnek atama ve çoklu atama. Liste kapsamlı değildir ve her yöntemin artıları ile eksileri vardır.
Eksik veriler neden önemlidir?
Önemlidirler çünkü makine öğrenimi modellerinizin performansını etkileyebilir ve veri üzerinde yapılan tüm istatistiksel analizlerden çıkarılan sonuçları çarpıtarak işletmenin yanlış kararlar almasına yol açabilirler.





Eksik verilerle uğraşmak, özellikle büyük veri kümeleriyle çalışırken veri toplamanın yaygın ve doğasında olan bir sorunudur. Eksik verilerin pek çok nedeni olabilir; katılımcıların eksik bilgi sağlaması, bilgi paylaşmayı reddedenlerin yanıt vermemesi, kötü tasarlanmış anketler ya da gizlilik nedeniyle verilerin kaldırılması bunlardan bazılarıdır.
Uygun şekilde ele alınmadığında eksik veriler, veri üzerindeki tüm istatistiksel analizlerin sonuçlarını çarpıtabilir ve işletmenin yanlış kararlar almasına yol açabilir.
Bu makalede, eksik değerleri verimli bir şekilde ele almak için bazı tekniklere ve bunların Python’daki uygulamalarına odaklanacağız. Her tekniğin faydalarını ve sınırlılıklarını örnekleyerek belirli bir durumda doğru yöntemi seçmenize yardımcı olacağız.
Eksik Verileri Belirleme
Eksik veriler farklı biçimlerde ortaya çıkar. Bu bölüm, eksik verilerin farklı türlerini ve bunların nasıl tespit edileceğini açıklar.
Eksik veri türleri
Üç ana eksik veri türü vardır: (1) Tamamen Rastgele Eksik (MCAR), (2) Rastgele Eksik (MAR) ve (3) Rastgele Olmayan Eksik (MNAR).
Onları ele almak için uygun yöntemleri seçebilmek adına her birini iyi anlamak önemlidir.
1) MCAR - Tamamen rastgele eksik
Tüm değişkenlerin ve gözlemlerin eksik olma olasılığı aynıysa bu durum söz konusudur. Farklı renklerde Legolar verilip bir ev inşa eden bir çocuğu hayal edin. Her bir Lego; şekil ve renk gibi bir bilgi parçasını temsil eder. Oyun sırasında çocuk bazı Legoları kaybedebilir. Bu kaybolan Legolar, ellerindeki Legonun şekli ya da rengini hatırlayamamaları gibi eksik bilgiyi temsil eder. Bu bilgiler rastgele kaybolmuştur ancak çocuğun elindeki diğer Legolarla ilgili bilgiyi değiştirmez.
2) MAR - Rastgele eksik
MAR’da bir değerin eksik olma olasılığı, o değişkenin ya da veri kümesindeki diğer değişkenlerin değeriyle ilişkilidir. Bu, tüm gözlem ve değişkenlerin eksik olma şansının aynı olmadığı anlamına gelir. MAR’a bir örnek, veri topluluğunda yapılan bir ankette, becerilerini sık güncellemeyen veri bilimcilerin yeni, son teknoloji algoritma veya teknolojilerden haberdar olmama olasılığının daha yüksek olması ve bu nedenle bazı soruları atlamasıdır. Bu durumda eksik veriler, veri bilimcisinin kendini ne sıklıkla geliştirdiğiyle ilişkilidir.
3) MNAR- Rastgele olmayan eksik
MNAR, üç eksik veri türü arasında en zor senaryo olarak kabul edilir. Ne MAR ne de MCAR geçerliyse uygulanır. Bu durumda, aynı değişkenin farklı değerleri için eksik olma olasılığı tamamen farklıdır ve bu nedenler bizim için bilinmeyebilir. MNAR’a bir örnek, evli çiftlerle ilgili bir ankettir. İlişkisi kötü olan çiftler, utanabileceklerini düşündükleri için bazı soruları yanıtlamak istemeyebilir.
Eksik verileri belirleme yöntemleri
pandas’ta eksik verileri tespit etmek için kullanılabilecek birden fazla yöntem vardır. Aşağıda en yaygın olanları yer almaktadır.
Fonksiyonlar
Açıklamalar
.isnull()
Bu fonksiyon, her değerin eksik olması durumunda True, aksi halde False olan boolean değerlerden oluşan bir pandas veri çerçevesi döndürür.
.notnull()
Önceki fonksiyona benzer şekilde, bu fonksiyon için değerler NaN veya None tespit edildiğinde False olur.
.info()
Bu fonksiyon, her sütun için eksik olmayan değer sayısını gösteren “Non-Null Count” dahil olmak üzere üç ana sütun oluşturur.
.isna()
Bu fonksiyon isnull ve notnull’a benzer. Ancak yalnızca eksik değer türü NaN olduğunda True gösterir.