

Xử lý dữ liệu thiếu
Có nhiều cách tiếp cận để xử lý dữ liệu thiếu. Phần này đề cập một số phương pháp cùng lợi ích và hạn chế của chúng.
Để minh họa rõ hơn, chúng ta sẽ sử dụng Dữ liệu Khoản vay có sẵn trên DataLab kèm theo mã nguồn được đề cập trong hướng dẫn.
Vì tập dữ liệu không có giá trị khuyết, chúng ta sẽ dùng một phần dữ liệu (100 hàng) rồi chủ động tạo giá trị thiếu theo cách thủ công.
import pandas as pdsample_customer_data = pd.read_csv("data/customer_churn.csv", nrows=100)
sample_customer_data.info()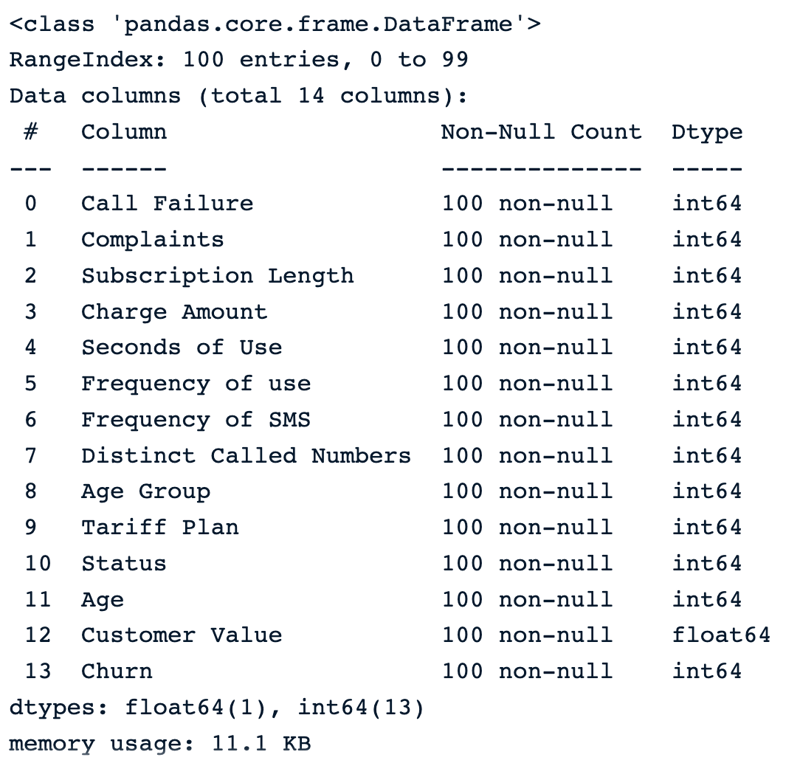
Mẫu gồm 100 quan sát ngẫu nhiên trước khi tạo giá trị thiếu
Hãy tạo 50% giá trị thiếu ở mỗi cột của dataframe bằng cách sau.
import numpy as np
def introduce_nan(x,percentage):
n = int(len(x)*(percentage - x.isna().mean()))
idxs = np.random.choice(len(x), max(n,0), replace=False, p=x.notna()/x.notna().sum())
x.iloc[idxs] = np.nanÁp dụng hàm cho dữ liệu tạo ra kết quả sau.
sample_customer_data.apply(introduce_nan, percentage=.5)
sample_customer_data.info()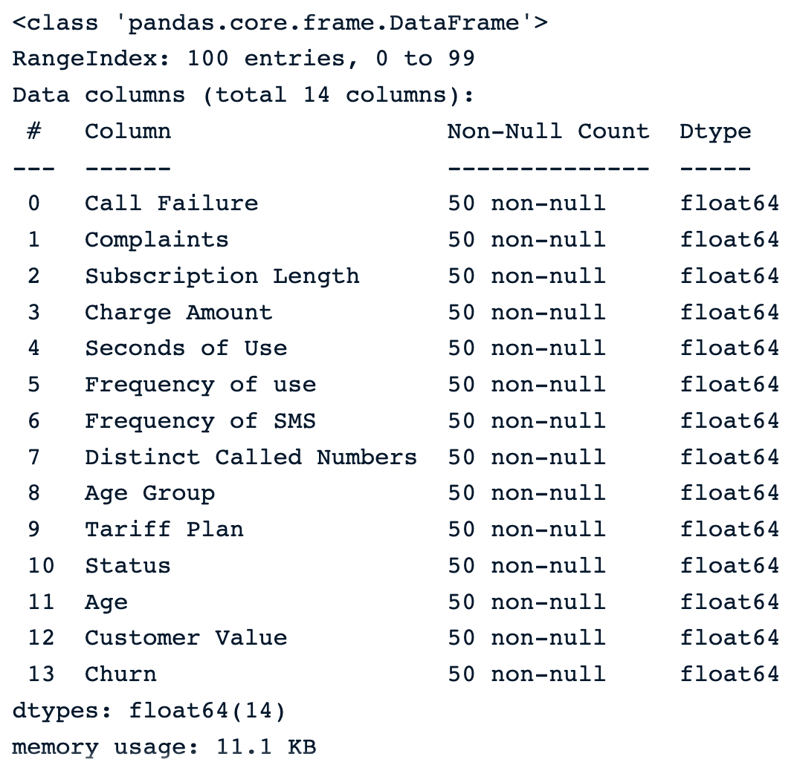
Mẫu gồm 100 quan sát ngẫu nhiên sau khi tạo giá trị thiếu
Dưới đây là năm hàng đầu tiên của tập dữ liệu.
sample_customer_data.head()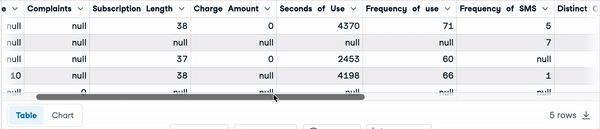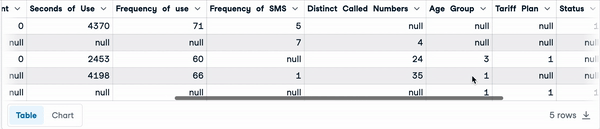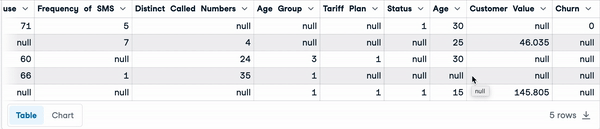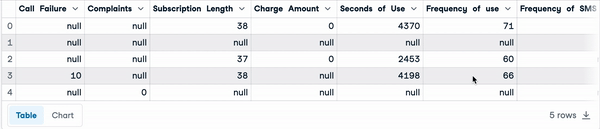
Năm hàng đầu tiên với giá trị null
Loại bỏ dữ liệu
Sử dụng hàm dropna() là cách dễ nhất để loại bỏ các quan sát hoặc đặc trưng có giá trị thiếu khỏi dataframe. Dưới đây là một số kỹ thuật.
1) Loại bỏ quan sát có giá trị thiếu
Có ba kịch bản có thể xảy ra khi cố gắng loại bỏ quan sát khỏi một tập dữ liệu:
dropna(): loại bỏ tất cả các hàng có giá trị thiếu.
drop_na_strategy = sample_customer_data.dropna()
drop_na_strategy.info()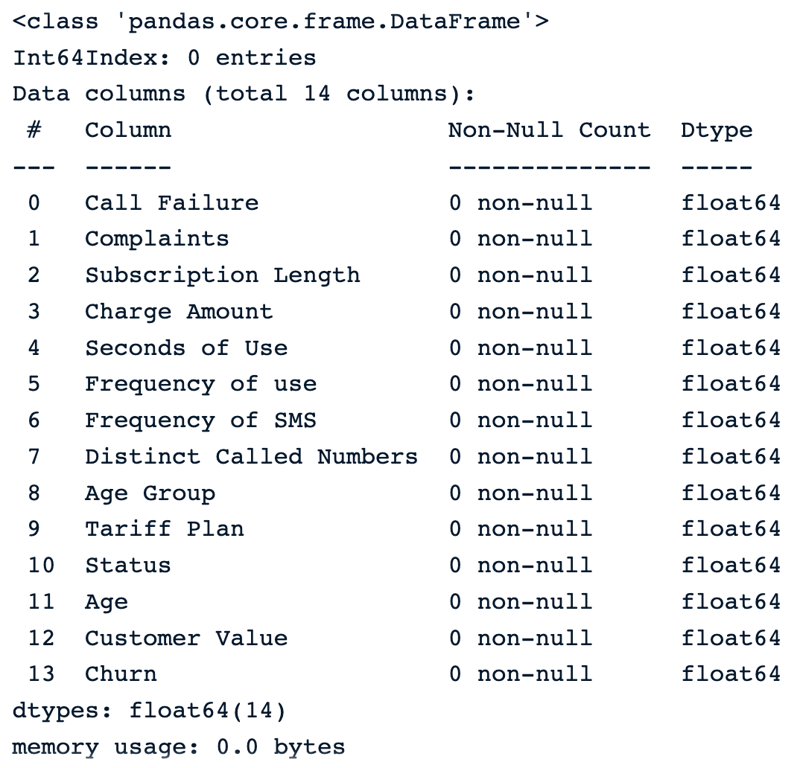
Loại bỏ quan sát bằng dropna() mặc định
Có thể thấy tất cả các quan sát đã bị loại khỏi tập dữ liệu, điều này đặc biệt nguy hiểm cho các phân tích tiếp theo.
dropna(how = ‘all’): các hàng mà mọi giá trị cột đều bị thiếu.
drop_na_all_strategy = sample_customer_data.dropna(how="all")
drop_na_all_strategy.info()Từ kết quả dưới đây, ta thấy không có quan sát nào mà tất cả các cột đều thiếu.
Loại bỏ quan sát bằng chiến lược “all”
dropna(thresh = minimum_value): loại hàng dựa trên ngưỡng. Chiến lược này đặt số lượng tối thiểu giá trị không thiếu cần có để giữ lại hàng.
drop_na_thres_strategy = sample_customer_data.dropna(thresh=0.6)
drop_na_thres_strategy.info()Đặt ngưỡng 60%, kết quả giống như trường hợp trước.
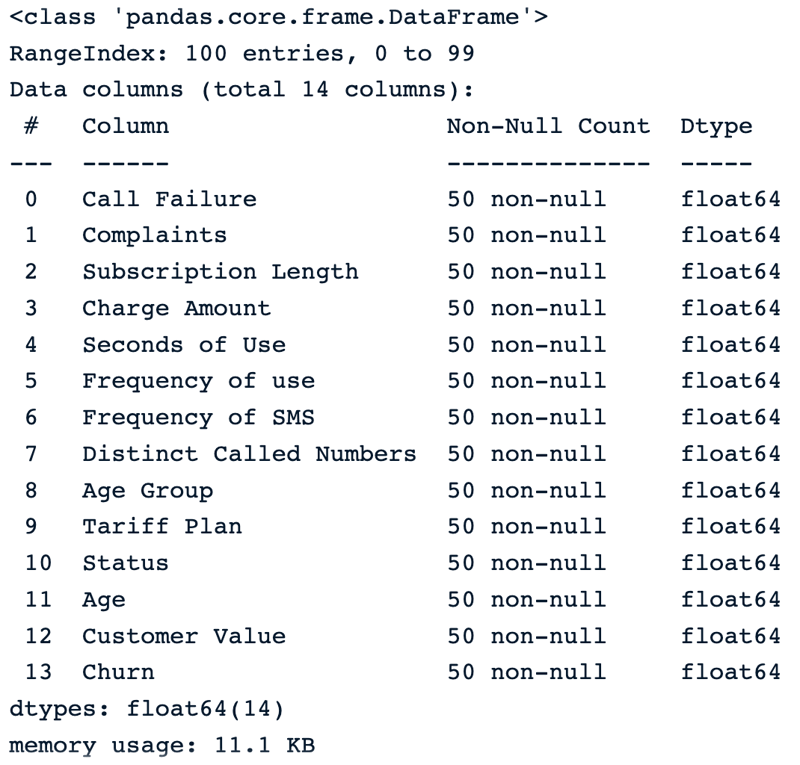
Loại bỏ quan sát bằng ngưỡng
2) Loại bỏ cột có giá trị thiếu
Tham số axis = 1 có thể dùng để chỉ rõ chúng ta quan tâm đến các cột thay vì các hàng.
dropna(axis = 1): loại bỏ tất cả các cột có giá trị thiếu.
drop_na_cols_strategy = sample_customer_data.dropna(axis=1)
drop_na_cols_strategy.info()Không còn cột nào trong dữ liệu. Nguyên nhân là mọi cột đều có ít nhất một giá trị thiếu.
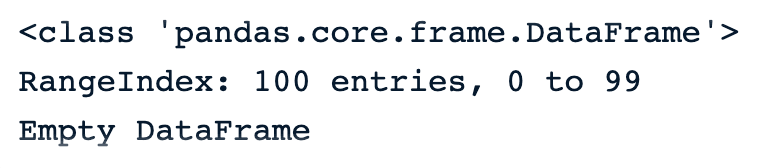
Dataframe trống sau khi dropna() trên cột
Giống nhiều cách tiếp cận khác, dropna() cũng có ưu và nhược điểm.
Ưu điểm
- Đơn giản và dễ sử dụng.
- Hữu ích khi giá trị thiếu không quan trọng.
Nhược điểm
- Cách tiếp cận này có thể gây mất mát thông tin, từ đó đưa sai lệch vào tập dữ liệu cuối.
- Không phù hợp khi dữ liệu không thiếu hoàn toàn ngẫu nhiên.
- Tập dữ liệu có tỷ lệ giá trị thiếu lớn có thể bị giảm đáng kể, ảnh hưởng đến kết quả của mọi phân tích thống kê trên tập dữ liệu đó.
Thế giá trị bằng trung bình/trung vị
Những chiến lược thay thế này khá dễ hiểu. Lần lượt dùng trung bình và trung vị để thay thế các giá trị thiếu của một cột bằng trung bình và trung vị của các giá trị không thiếu trong cột đó.
Phân phối chuẩn là kịch bản lý tưởng. Đáng tiếc, điều này không phải lúc nào cũng đúng. Khi đó thế bằng trung vị có thể hữu ích vì nó không nhạy với ngoại lệ.
Trong Python, hàm fillna() từ pandas có thể được dùng để thực hiện các thay thế này.
- Minh họa thế bằng trung bình.
mean_value = sample_customer_data.mean()
mean_imputation = sample_customer_data.fillna(mean_value)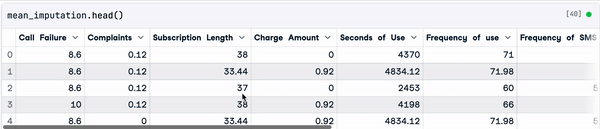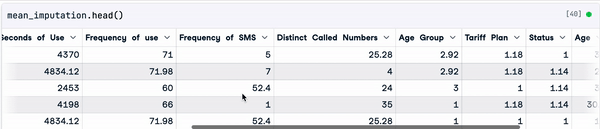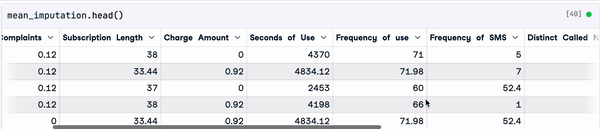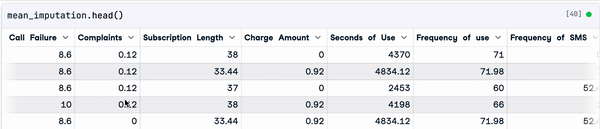
Kết quả thế bằng trung bình
- Minh họa thế bằng trung vị
median_value = sample_customer_data.median()
median_imputation = sample_customer_data.fillna(median_value)
median_imputation.head()
Kết quả thế bằng trung vị
Ưu điểm
- Đơn giản và dễ triển khai là một trong những lợi ích của thế bằng trung bình và trung vị.
- Việc thế giá trị dùng chính thông tin hiện có từ dữ liệu không thiếu; do đó không cần dữ liệu bổ sung.
- Thế bằng trung bình và trung vị có thể cho ước lượng tốt về giá trị thiếu, lần lượt với dữ liệu phân phối chuẩn và dữ liệu lệch.
Nhược điểm
- Không thể áp dụng hai chiến lược này cho cột phân loại. Chúng chỉ hoạt động với dữ liệu số.
- Thế bằng trung bình nhạy với ngoại lệ và có thể không đại diện tốt cho xu hướng trung tâm của dữ liệu. Tương tự trung bình, trung vị cũng có thể không đại diện tốt cho xu hướng trung tâm.
- Thế bằng trung vị giả định dữ liệu thiếu hoàn toàn ngẫu nhiên (MCAR), điều này không phải lúc nào cũng đúng.
Thế bằng mẫu ngẫu nhiên
Ý tưởng đằng sau thế bằng mẫu ngẫu nhiên khác với các phương pháp trước và bao gồm thêm vài bước.
- Đầu tiên, tạo hai tập con từ dữ liệu gốc.
- Tập con thứ nhất chứa tất cả quan sát không có dữ liệu thiếu, tập thứ hai chứa những quan sát có dữ liệu thiếu.
- Sau đó, chọn ngẫu nhiên một quan sát từ mỗi tập con.
- Tiếp theo, dữ liệu thiếu từ quan sát vừa chọn được thay bằng dữ liệu hiện có từ quan sát có đầy đủ dữ liệu.
- Cuối cùng, lặp lại quá trình cho đến khi không còn thông tin bị thiếu.
def random_sample_imputation(df):
cols_with_missing_values = df.columns[df.isna().any()].tolist()
for var in cols_with_missing_values:
# extract a random sample
random_sample_df = df[var].dropna().sample(df[var].isnull().sum(),
random_state=0)
# re-index the randomly extracted sample
random_sample_df.index = df[
df[var].isnull()].index
# replace the NA
df.loc[df[var].isnull(), var] = random_sample_df
return dfdf = sample_customer_data.copy()
random_sample_imp_df = random_sample_imputation(sample_customer_data)
random_sample_imp_df.head()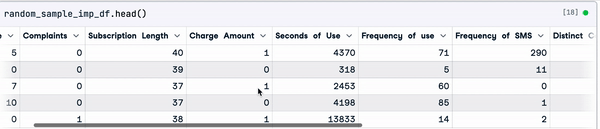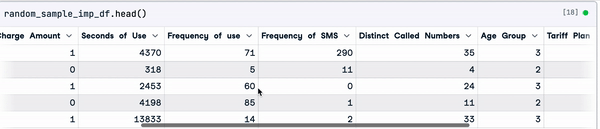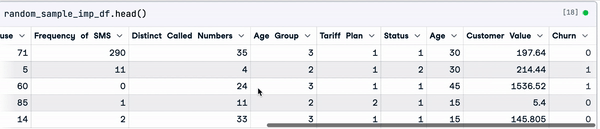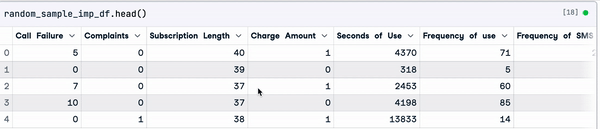
Thế bằng mẫu ngẫu nhiên
Ưu điểm
- Đây là kỹ thuật dễ và trực quan.
- Xử lý được cả dữ liệu số và dữ liệu phân loại.
- Ít làm sai lệch phương sai dữ liệu và cũng bảo toàn phân phối gốc của dữ liệu, điều mà trung bình, trung vị và các phương pháp khác không làm được.
Nhược điểm
- Tính ngẫu nhiên không phải lúc nào cũng phù hợp, có thể đưa nhiễu vào dữ liệu, dẫn đến kết luận thống kê sai.
- Tương tự trung bình và trung vị, cách này cũng giả định dữ liệu thiếu hoàn toàn ngẫu nhiên (MCAR).
Thế đa lần (Multiple Imputation)
Đây là kỹ thuật thế giá trị đa biến, nghĩa là điền thông tin thiếu bằng cách xét đến thông tin từ các cột khác.
Ví dụ, nếu giá trị thu nhập bị thiếu đối với một cá nhân, sẽ không rõ họ có khoản thế chấp hay không. Vì vậy, để xác định giá trị đúng, cần đánh giá các đặc điểm khác như điểm tín dụng, nghề nghiệp và việc họ có sở hữu nhà hay không.
Multiple Imputation by Chained Equations (viết tắt là MICE) là một trong những phương pháp thế đa biến phổ biến nhất. Để hiểu rõ cách tiếp cận MICE, hãy xét tập biến X1, X2, … Xn, trong đó một phần hoặc tất cả có giá trị thiếu.
Thuật toán hoạt động như sau:
- Với mỗi biến, thay giá trị thiếu bằng một chiến lược thế đơn giản như thế bằng trung bình, còn được xem như “giá trị giữ chỗ”.
- “Giá trị giữ chỗ” cho biến đầu tiên, X1, được hồi quy bằng mô hình hồi quy trong đó X1 là biến phụ thuộc, các biến còn lại là biến độc lập. Sau đó X2 được dùng làm biến phụ thuộc và phần còn lại làm biến độc lập. Quá trình tiếp tục như vậy cho đến khi tất cả biến đều được xét ít nhất một lần làm biến phụ thuộc.
- Những “giá trị giữ chỗ” ban đầu sau đó được thay bằng dự đoán từ mô hình hồi quy.
- Quá trình thay thế được lặp lại qua một số vòng, thường là mười theo Raghunathan et al. 2002, và việc thế được cập nhật ở mỗi vòng.
- Kết thúc các vòng, các giá trị thiếu lý tưởng sẽ được thay bằng các giá trị dự đoán phản ánh tốt nhất các mối quan hệ được nhận diện trong dữ liệu.
Việc triển khai được thực hiện bằng thư viện miceforest.
Đầu tiên, cần cài thư viện bằng pip.
pip install miceforestSau đó import module ImputationKernel và tạo kernel cho việc thế giá trị.
from miceforest import ImputationKernel
mice_kernel = ImputationKernel(
data = sample_customer_data,
save_all_iterations = True,
random_state = 2023
)Tiếp nữa, chạy kernel trên dữ liệu trong hai vòng lặp, và cuối cùng tạo dữ liệu đã được thế.
mice_kernel.mice(2)
mice_imputation = mice_kernel.complete_data()
mice_imputation.head()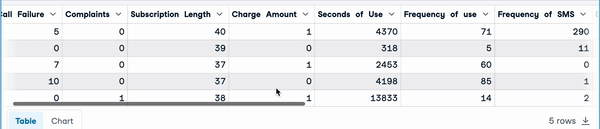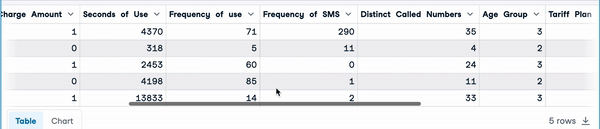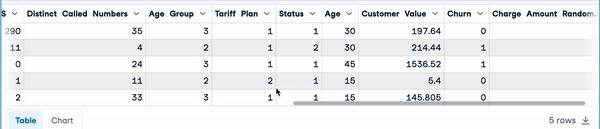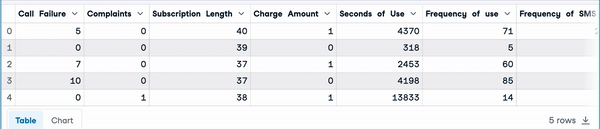
Thế đa lần
Ưu điểm
- Thế đa lần mạnh mẽ trong xử lý dữ liệu thiếu ở nhiều biến và nhiều kiểu dữ liệu.
- Cách tiếp cận này có thể cho kết quả tốt hơn nhiều so với thế bằng trung bình và trung vị.
- Nhiều thuật toán khác như K-Nearest Neighbors, Random Forest, và mạng nơ-ron có thể được dùng làm xương sống cho dự đoán trong thế đa lần.
Nhược điểm
- Thế đa lần giả định dữ liệu thiếu ngẫu nhiên (MAR).
- Dù có nhiều lợi ích, phương pháp này có thể tốn kém về tính toán so với các kỹ thuật khác, đặc biệt khi làm việc với tập dữ liệu lớn.
- Phương pháp này đòi hỏi nhiều công sức hơn các cách trước.
Từ tất cả các phương pháp thế, có thể xác định phương pháp nào gần với phân phối của dữ liệu gốc hơn.
Giá trị trung bình (màu vàng) và trung vị (màu đỏ) cách xa phân phối gốc của cột “Charge amount”, do đó không được xem là tốt để thế dữ liệu.
mean_imputation["Charge Amount Mean Imp"] = mean_imputation["Charge Amount"]
median_imputation["Charge Amount Median Imp"] = median_imputation["Charge Amount"]
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]Với các cột mới được tạo cho từng loại thế, giờ ta có thể vẽ phân phối.
import matplotlib.pyplot as plt
plt.figure(figsize=(12,8))
sample_customer_data["Charge Amount"].plot(kind='kde',color='blue')
mean_imputation["Charge Amount Mean Imp"].plot(kind='kde',color='yellow')
median_imputation["Charge Amount Median Imp"].plot(kind='kde',color='red')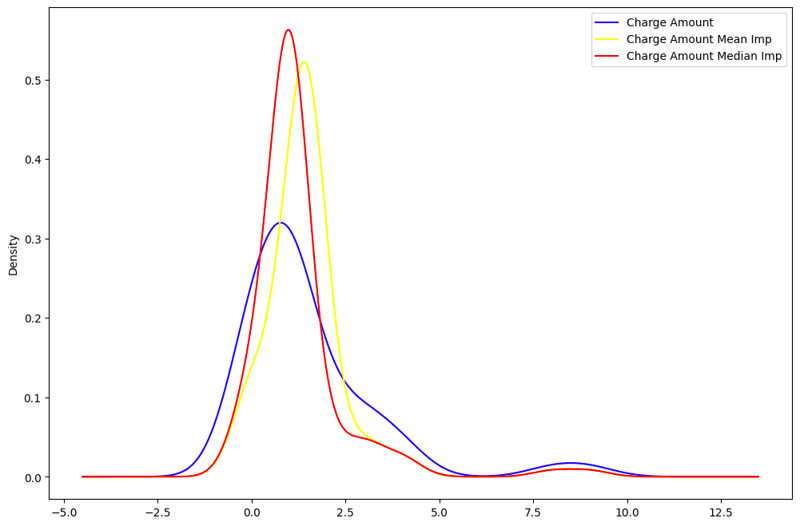
Phân phối “Charge Amount”: dữ liệu gốc so với trung bình và trung vị.
Khi vẽ phân phối của thế đa lần và thế ngẫu nhiên bên dưới, các phân phối này trùng khít với dữ liệu gốc. Điều này có nghĩa những phương pháp thế đó tốt hơn so với thế bằng trung bình và trung vị.
random_sample_imp_df["Charge Amount Random Imp"] = random_sample_imp_df["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"] = mice_imputation["Charge Amount"]
mice_imputation["Charge Amount MICE Imp"].plot(kind='kde',color='black')
random_sample_imp_df["Charge Amount Random Imp"].plot(kind='kde',color='purple')
plt.legend()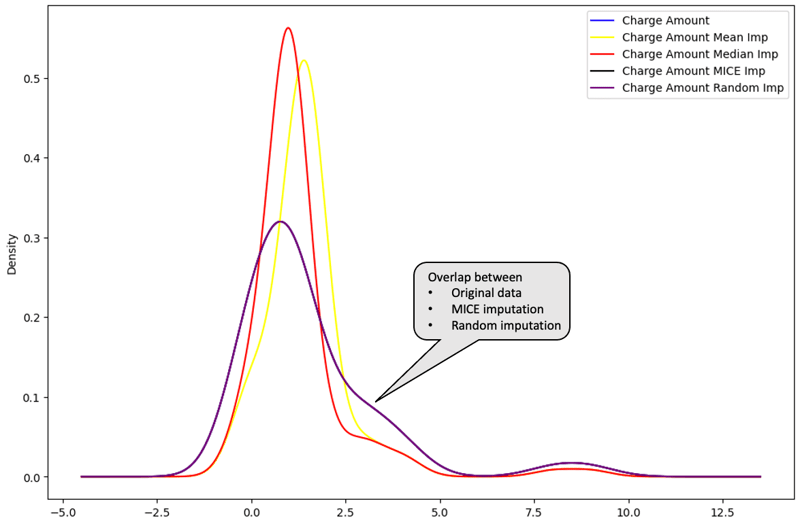
Phân phối “Charge Amount”: dữ liệu gốc so với trung bình, trung vị, MICE và ngẫu nhiên
Khóa học Handling Missing Data with Imputations in R là nguồn học tập tuyệt vời để tìm hiểu thêm về các chiến lược xử lý giá trị thiếu. Khóa học bao gồm cách áp dụng trực quan hóa và kiểm định thống kê để nhận diện mẫu hình dữ liệu thiếu và cách thế chúng bằng cả kỹ thuật thống kê và máy học.
Tương tự, khóa học dealing with missing data in python giải thích cách nhận diện, phân tích, loại bỏ và thế dữ liệu thiếu trong Python.
Thực tiễn tốt nhất
Chọn phương pháp thế phù hợp dựa trên loại dữ liệu thiếu
Có nhiều chiến lược thế giá trị, và không nên dùng một cách mù quáng. Chọn cách tiếp cận đúng có thể giúp tránh đưa sai lệch vào dữ liệu và đưa ra quyết định sai.
Bảng sau minh họa nên dùng phương pháp thế nào dựa trên loại dữ liệu thiếu. Danh sách phương pháp không đầy đủ, nhưng đây là những cách thường dùng nhất.
|
Loại dữ liệu thiếu |
Phương pháp thế |
|
Thiếu hoàn toàn ngẫu nhiên |
Trung bình, Trung vị, Mode, hoặc bất kỳ phương pháp thế nào khác |
|
Thiếu ngẫu nhiên |
Thế đa lần, Thế bằng hồi quy |
|
Thiếu không ngẫu nhiên |
Thay thế theo mẫu hình, Ước lượng Hợp lý tối đa |
Đánh giá tác động của việc thế giá trị lên phân tích tổng thể
Cần lưu ý rằng dữ liệu gốc không thể phục hồi cho dù dùng kỹ thuật thế nào. Tuy nhiên, có thể sử dụng các kỹ thuật tạo ra tập dữ liệu đã thế gần với thực tế nhất có thể.
Dưới đây là một vài bước then chốt cần cân nhắc khi đánh giá.
- Chạy nhiều kỹ thuật thế để xác định phương pháp vững vàng nhất. Điều này giúp nhận diện sai lệch và biến thiên giữa các kỹ thuật.
- So sánh dữ liệu sau khi thế với dữ liệu gốc chưa thế để đánh giá độ tin cậy của phương pháp thế.
- Tích hợp quá trình thế giá trị vào toàn bộ pipeline phân tích, từ làm sạch dữ liệu đến xây dựng mô hình máy học.
Truyền đạt dữ liệu thiếu và phương pháp thế tới các bên liên quan
Có dữ liệu chất lượng tốt là mục tiêu của mọi bên liên quan và người làm dữ liệu.
Trung thực và minh bạch là chìa khóa khi truyền đạt dữ liệu bị thiếu trong phân tích. Dưới đây là một số khía cạnh quan trọng cần xem xét.
- Nắm rõ bối cảnh của dữ liệu thiếu, liệu đó là MCAR, MAR hay MNAR.
- Giải thích rõ ràng và ghi lại các phương pháp dùng để xử lý dữ liệu thiếu khỏi dữ liệu tổng thể, đồng thời thảo luận lợi ích và hạn chế của từng cách tiếp cận.
- Trình bày kết quả theo cách mà các bên liên quan có thể hiểu được.
Kết luận
Bài viết đã đề cập dữ liệu thiếu là gì và tác động của nó đến quá trình ra quyết định dựa trên dữ liệu. Bài viết cũng hướng dẫn bạn qua một số chiến lược để xử lý chúng, cùng với ưu và nhược điểm cho việc ra quyết định mang tính hành động.
Hy vọng bài viết cung cấp cho bạn những chiến lược phù hợp để xử lý hiệu quả các vấn đề dữ liệu thiếu.
Câu hỏi thường gặp về Giá trị khuyết
Dữ liệu thiếu là gì?
Dữ liệu thiếu nghĩa là một phần hoặc toàn bộ các biến trong dữ liệu có giá trị bị thiếu.
Các loại dữ liệu thiếu khác nhau là gì?
Có ba loại dữ liệu thiếu chính: Thiếu hoàn toàn ngẫu nhiên (MCAR), Thiếu ngẫu nhiên (MAR), và Thiếu không ngẫu nhiên (MNAR)
Làm thế nào để xử lý dữ liệu thiếu?
Có thể áp dụng các cách tiếp cận sau để xử lý giá trị khuyết: thế bằng trung bình, trung vị, mode, thế bằng mẫu ngẫu nhiên và thế đa lần. Danh sách này không đầy đủ, và mỗi phương pháp đều có ưu và nhược điểm.
Tại sao dữ liệu thiếu lại quan trọng?
Chúng quan trọng vì có thể ảnh hưởng đến hiệu suất của mô hình máy học, và làm sai lệch các kết luận rút ra từ mọi phân tích thống kê trên dữ liệu, từ đó khiến doanh nghiệp đưa ra quyết định sai.
Xử lý dữ liệu thiếu là một vấn đề phổ biến và cố hữu trong thu thập dữ liệu, đặc biệt khi làm việc với tập dữ liệu lớn. Có nhiều nguyên nhân dẫn đến thiếu dữ liệu, như thông tin do người tham gia cung cấp không đầy đủ, không phản hồi do họ từ chối chia sẻ thông tin, bảng khảo sát thiết kế kém, hoặc loại bỏ dữ liệu vì lý do bảo mật.
Nếu không được xử lý đúng cách, dữ liệu thiếu có thể làm sai lệch kết luận của mọi phân tích thống kê trên dữ liệu, dẫn đến doanh nghiệp đưa ra quyết định sai lầm.
Bài viết này sẽ tập trung vào một số kỹ thuật để xử lý hiệu quả các giá trị khuyết và cách triển khai chúng trong Python. Chúng tôi sẽ minh họa lợi ích và hạn chế của từng kỹ thuật để giúp bạn chọn phương pháp phù hợp cho từng tình huống.
Nhận diện dữ liệu thiếu
Dữ liệu thiếu xuất hiện dưới nhiều dạng. Phần này giải thích các loại dữ liệu thiếu khác nhau và cách nhận diện chúng.
Các loại dữ liệu thiếu
Có ba loại dữ liệu thiếu chính: (1) Thiếu hoàn toàn ngẫu nhiên (MCAR), (2) Thiếu ngẫu nhiên (MAR), và (3) Thiếu không ngẫu nhiên (MNAR).
Điều quan trọng là cần hiểu rõ từng loại để chọn phương pháp xử lý phù hợp.
1) MCAR - Thiếu hoàn toàn ngẫu nhiên
Điều này xảy ra nếu tất cả biến và quan sát có cùng xác suất bị thiếu. Hãy tưởng tượng đưa cho một đứa trẻ bộ Lego nhiều màu để xây nhà. Mỗi mảnh Lego đại diện cho một mẩu thông tin, như hình dạng và màu sắc. Trong lúc chơi, đứa trẻ có thể làm mất vài mảnh Lego. Những mảnh bị mất đó tượng trưng cho thông tin bị thiếu, giống như khi chúng không nhớ hình dạng hoặc màu sắc của mảnh Lego đã có. Thông tin đó bị mất một cách ngẫu nhiên, nhưng không làm thay đổi thông tin mà đứa trẻ có về các mảnh Lego khác.
2) MAR - Thiếu ngẫu nhiên
Với MAR, xác suất một giá trị bị thiếu liên quan đến giá trị của chính biến đó hoặc các biến khác trong tập dữ liệu. Điều này có nghĩa không phải tất cả quan sát và biến đều có cùng khả năng bị thiếu. Một ví dụ về MAR là khảo sát trong cộng đồng dữ liệu, nơi các nhà khoa học dữ liệu ít nâng cấp kỹ năng có khả năng không biết về các thuật toán hoặc công nghệ tiên tiến mới, do đó bỏ qua một số câu hỏi. Dữ liệu thiếu trong trường hợp này liên quan đến tần suất họ trau dồi kỹ năng.
3) MNAR - Thiếu không ngẫu nhiên
MNAR được xem là kịch bản khó nhất trong ba loại dữ liệu thiếu. Nó áp dụng khi cả MAR lẫn MCAR đều không phù hợp. Trong tình huống này, xác suất bị thiếu hoàn toàn khác nhau với các giá trị khác nhau của cùng một biến, và lý do có thể không rõ với chúng ta. Ví dụ về MNAR là khảo sát về các cặp vợ chồng: những cặp có mối quan hệ không tốt có thể không muốn trả lời một số câu hỏi do cảm thấy xấu hổ.
Phương pháp nhận diện dữ liệu thiếu
Có nhiều phương pháp có thể dùng để nhận diện dữ liệu thiếu trong pandas. Dưới đây là những phương pháp thường gặp nhất.
Hàm
Mô tả
.isnull()
Hàm này trả về một dataframe của pandas, trong đó mỗi giá trị là boolean: True nếu giá trị bị thiếu, False nếu không.
.notnull()
Tương tự hàm trước, các giá trị cho hàm này là False nếu phát hiện giá trị NaN hoặc None.
.info()
Hàm này tạo ra ba cột chính, bao gồm “Non-Null Count” thể hiện số lượng giá trị không thiếu cho mỗi cột.
.isna()
Hàm này giống isnull và notnull. Tuy nhiên, nó chỉ hiển thị True khi giá trị thiếu thuộc kiểu NaN.