Kurs
Datenwissenschaft verstehen
2 Std.
876.1K
Distanzmaße sind essenziell, um Unterschiede zwischen Objekten zu quantifizieren. Während Metriken wie die Euklidische oder die Manhattan-Distanz räumliche Abstände messen, folgt die Hamming-Distanz einem anderen Ansatz: Sie zählt die Positionen, an denen sich zwei Sequenzen unterscheiden. Das macht sie besonders wertvoll für Fehlererkennung, Datenvalidierung und die Informationstheorie.
Ursprünglich 1950 von Richard Hamming bei Bell Labs im Rahmen von Code-Prüfsystemen entwickelt, ist die Hamming-Distanz längst über ihre Wurzeln in der Telekommunikation hinausgewachsen. Heute ist sie eine Schlüsselmetrik in Bereichen wie:
In diesem Guide schauen wir uns an, wie die Hamming-Distanz funktioniert, wo sie praktisch eingesetzt wird und wie du sie in Python und R implementierst. Die Konzepte und Implementierungen helfen dir, Probleme in Datenvalidierung, Bioinformatik und Machine Learning gezielt zu lösen.
Die Hamming-Distanz misst die Anzahl der Positionen, an denen sich zwei Zeichenketten gleicher Länge in ihren Symbolen unterscheiden. Du kannst sie dir als die minimale Anzahl von Ersetzungen vorstellen, die nötig sind, um eine Zeichenkette in die andere zu überführen.
Beispiel: Vergleich zweier Binärstrings:
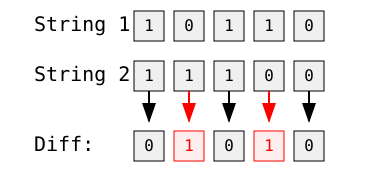
Bild: Autor
Die Hamming-Distanz beträgt hier 2, da sich die Strings an zwei Positionen unterscheiden – am zweiten und vierten Bit.
Mathematisch gilt für zwei Strings x und y mit gleicher Länge n: Die Hamming-Distanz D(x,y) ist:
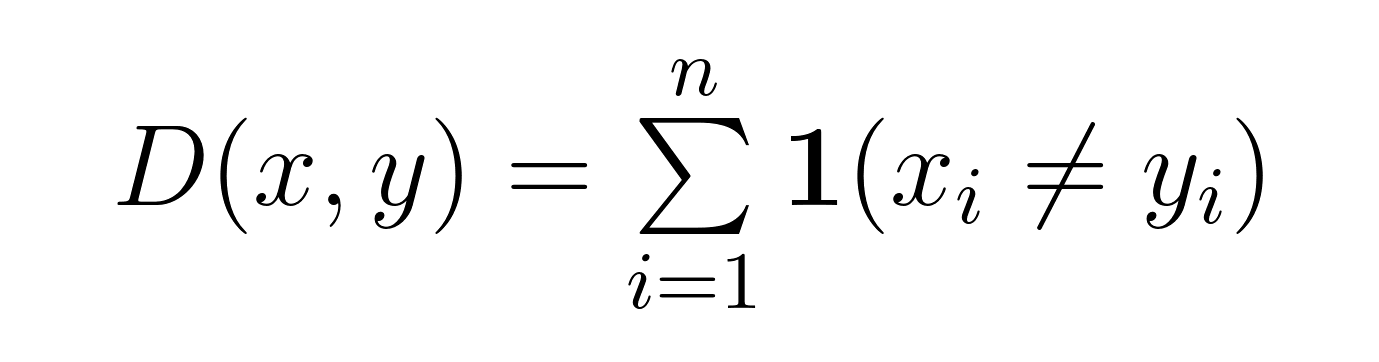
Diese Formel zählt die Positionen, an denen xᵢ ≠ yᵢ gilt. Für Binärstrings vereinfacht sich das auf das Zählen der unterschiedlichen Bits. Bei anderen Sequenzen (z. B. DNA oder Text) werden Positionen mit unterschiedlichen Symbolen gezählt.
Zwei Eigenschaften sind besonders wichtig:
Diese Eigenschaften machen die Hamming-Distanz ideal, wenn:
Schauen wir uns die Berechnung anhand von Beispielen an – von einfachen Binärstrings bis zu komplexeren Anwendungen.
Die naheliegendste Anwendung ist der Vergleich von Binärstrings. Betrachten wir zwei 8-Bit-Strings:
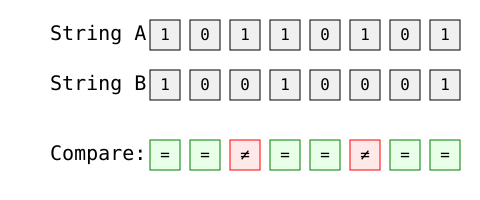
Bild: Autor
Schrittweise Berechnung:
Die Hamming-Distanz beträgt 2, da sich die Strings an zwei Positionen unterscheiden (Position 3 und 6).
In der Bioinformatik wird die Hamming-Distanz häufig zum Vergleich genetischer Sequenzen eingesetzt. Betrachten wir zwei DNA-Fragmente:
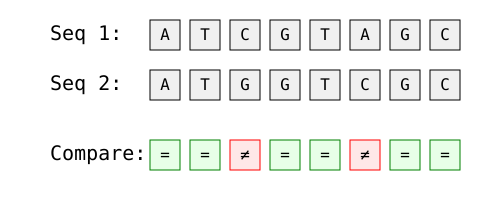
Bild: Autor
Schrittweise Analyse:
Dieser Vergleich hilft Biologinnen und Biologen, genetische Mutationen zu quantifizieren und die Ähnlichkeit von DNA zu analysieren.
Die Hamming-Distanz funktioniert auch mit normalen Textstrings gleicher Länge:
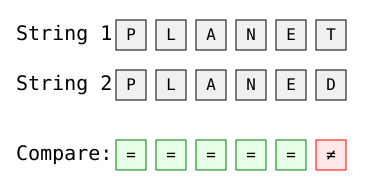
Bild: Autor
Die Hamming-Distanz beträgt hier 1, mit dem einzigen Unterschied an der letzten Position ('T' vs. 'D').
Diese Art von Vergleich ist nützlich für:
Alle Beispiele zeigen, wie die Hamming-Distanz Unterschiede zwischen Sequenzen einfach und effektiv quantifiziert – unabhängig vom Datentyp. Der Kern: Sie betrachtet positionsweise Abweichungen und ignoriert die konkrete Art der Änderung.
Die Hamming-Distanz bildet die Grundlage für fehlererkennende und fehlerkorrigierende Codes in der digitalen Kommunikation. Durch das gezielte Hinzufügen von Paritätsbits entstehen Mindestabstände zwischen gültigen Codewörtern. So können Systeme erkennen, wenn empfangene Daten keinem gültigen Muster entsprechen, und Fehler durch Zuordnung zum nächstgelegenen gültigen Codewort sogar korrigieren. Dieses Prinzip steckt hinter Technologien wie ECC-Speicher (Error-Correcting Code) in Computern, der Fehlerkorrektur von QR-Codes und Kommunikationssystemen in der Raumfahrt, wo Datenintegrität entscheidend ist.
In der Informationstheorie wird die Hamming-Distanz genutzt, um zuverlässige Kommunikationssysteme zu entwerfen. Bei der Entwicklung von Fehlerbehandlungscodes achten Ingenieurinnen und Ingenieure darauf, dass sich gültige Nachrichten (Codewörter) um mindestens eine bestimmte Anzahl an Bits unterscheiden. Unterscheiden sich gültige Nachrichten beispielsweise immer um mindestens zwei Bits, kann das System erkennen, wenn während der Übertragung ein einzelnes Bit verfälscht wurde. Liegt der Mindestabstand bei mindestens drei Bits, kann das System sogar Ein-Bit-Fehler korrigieren, indem es die nächstgelegene gültige Nachricht identifiziert. Diese Prinzipien machen Kommunikationssysteme robust – von Satellitenkommunikation bis Datenspeicherung.
Genetische Forschung nutzt die Hamming-Distanz, um DNA-Sequenzen zu vergleichen und Mutationen zu quantifizieren. Durch positionsweisen Vergleich lassen sich Punktmutationen erkennen, evolutionäre Veränderungen nachverfolgen und genetische Diversität untersuchen. Das ist besonders hilfreich bei Krankheitsmutationen, da die genauen Positionen der genetischen Veränderungen zeigen, wie sich Krankheiten entwickeln und in Populationen verbreiten.
Im Machine Learning dient die Hamming-Distanz als Ähnlichkeitsmaß für binäre oder kategoriale Daten. Sie hilft beim Vergleich von Feature-Vektoren in der Mustererkennung, misst Ähnlichkeiten in Empfehlungssystemen und analysiert kategoriale Daten in Klassifikationsaufgaben. Ihre Einfachheit und Effizienz ist besonders wertvoll bei hochdimensionalen Binärdaten oder wenn in großen Datensätzen schnelle Ähnlichkeitsberechnungen gefragt sind.
Die Hamming-Distanz bildet einen metrischen Raum und erfüllt damit vier Grundregeln. Erstens ist die Distanz immer nichtnegativ – eine negative Anzahl abweichender Positionen gibt es nicht. Zweitens ist die Distanz genau dann null, wenn zwei Sequenzen identisch sind. Drittens ist sie symmetrisch – der Vergleich von A mit B liefert dasselbe Ergebnis wie B mit A. Und viertens gilt die Dreiecksungleichung: Die Distanz zwischen A und C ist nicht größer als die Summe der Distanzen von A nach B und B nach C.
Bei Binärstrings zeigt die Hamming-Distanz besondere Merkmale, die sie für die Fehlererkennung nützlich machen. Für zwei Binärstrings der Länge n kann die Hamming-Distanz höchstens n betragen, was nur eintritt, wenn die Strings bitweise Komplemente sind. Die Wahrscheinlichkeit für eine spezifische Hamming-Distanz „d“ zwischen zwei zufälligen Binärstrings folgt einer Binomialverteilung, wobei der wahrscheinlichste Abstand n/2 ist. Diese Eigenschaft hilft beim Entwurf von Fehlererkennungscodes, die erkennen, wenn Bits während der Übertragung kippen.
Python bietet sowohl Bibliotheksfunktionen als auch eigene Implementierungen zur Berechnung der Hamming-Distanz. Die SciPy-Bibliothek liefert über ihre Funktionen für räumliche Distanzen die effizienteste Lösung:
from scipy.spatial.distance import hamming

# For working with strings
string1 = "1010101"
string2 = "1000101"

# Convert to list of integers for hamming function
arr1 = [int(bit) for bit in string1]
arr2 = [int(bit) for bit in string2]

# Calculate Hamming distance
distance = hamming(arr1, arr2) * len(arr1)  # Multiply by length because SciPy returns fraction
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1

# For DNA sequences
sequence1 = "ATCGTACT"
sequence2 = "ATCGCACT"
distance = hamming(list(sequence1), list(sequence2)) * len(sequence1)
print(f"Hamming distance: {int(distance)}")  # Output: Hamming distance: 1
Falls du eine eigene Implementierung bevorzugst:
def hamming_distance(str1: str, str2: str) -> int:
    """Calculate Hamming distance between two strings."""
    if len(str1) != len(str2):
        raise ValueError("Strings must be of equal length")
    return sum(c1 != c2 for c1, c2 in zip(str1, str2))

# Example usage
print(hamming_distance("1010101", "1000101")) # Output: 1R ermöglicht die Berechnung der Hamming-Distanz mit Bordmitteln recht einfach:
hamming_distance <- function(str1, str2) {
    if (nchar(str1) != nchar(str2)) {
        stop("Strings must be equal length")
    }
    sum(strsplit(str1, "")[[1]] != strsplit(str2, "")[[1]])
}

# Example usage
hamming_distance("1010101", "1000101")
# [1] 1

# For DNA sequences
hamming_distance("ATCGTACT", "ATCGCACT")
# [1] 1
Wenn du auf diesen Codebeispielen aufbauen und weitere Anwendungen von Distanzmaßen in der Praxis erkunden möchtest, schau dir diese umfassenden Ressourcen an:
Diese Kurse helfen dir, über Basisimplementierungen hinaus zu verstehen, wie Distanzmaße Machine-Learning-Anwendungen beeinflussen – unabhängig von deiner bevorzugten Programmiersprache.
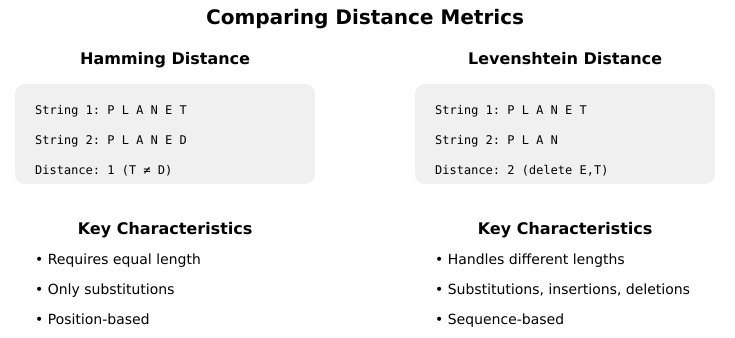
Bild: Autor
Die Levenshtein-Distanz ist die minimale Anzahl an Ein-Zeichen-Operationen, um einen String in einen anderen zu überführen. Anders als die Hamming-Distanz kann sie auch Strings unterschiedlicher Länge vergleichen, da sie Einfügungen und Löschungen neben Ersetzungen berücksichtigt. Diese Flexibilität ist z. B. für Rechtschreibkorrektur, DNA-Alignment und unscharfes String-Matching wertvoll – allerdings auf Kosten höherer Rechenkomplexität. Beim Vergleich von "planet" und "plan" würde die Levenshtein-Distanz das Löschen von 'e' und 't' als zwei Operationen zählen, während die Hamming-Distanz diesen Vergleich gar nicht zuließe.
Aufbauend auf der Standard-Levenshtein-Distanz erlaubt die Damerau-Levenshtein-Distanz zusätzlich die Transposition benachbarter Zeichen. Das erfasst typische Tippfehler, bei denen Zeichen vertauscht werden, besonders gut. Beim Vergleich von "form" und "from" würde sie dies als eine Transposition statt als zwei Ersetzungen werten. Diese Metrik ist weit verbreitet in NLP-Anwendungen, insbesondere in automatischen Rechtschreibkorrekturen, wo Zeichenvertauschungen häufig sind.
Die Jaro-Winkler-Distanz gewichtet Zeichenpositionen, insbesondere Übereinstimmungen am Anfang eines Strings, stärker. Statt Edit-Operationen zu zählen, liefert sie einen Ähnlichkeitswert zwischen 0 und 1, wobei 1 eine perfekte Übereinstimmung bedeutet. Sie eignet sich besonders für den Vergleich von Eigennamen und kurzen Strings – ideal für Record Linkage und Deduplikation. Beim Vergleich von Namen wie "Martha" und "Marhta" fällt der Score höher aus, weil sich die abweichenden Zeichen weiter hinten befinden.
Je nach Szenario passt ein anderes Distanzmaß. Berücksichtige diese Punkte bei der Auswahl:
Der strukturierte Vergleich zeigt: Jedes Distanzmaß hat seinen Zweck. Die Hamming-Distanz punktet besonders dort, wo ihre Einfachheit und Geschwindigkeit zu Vergleichen mit fester Länge passen.
Die Eleganz der Hamming-Distanz liegt in ihrer Einfachheit. Indem sie Positionen zählt, an denen sich Sequenzen unterscheiden, liefert sie ein robustes Maß für Unähnlichkeit – ob bei der Fehlererkennung in übertragenen Daten oder der Analyse genetischer Mutationen. Besonders stark ist sie in Domänen, in denen jede Position gleich wichtig ist und Ersetzungen im Fokus stehen.
Wenn du in deiner Arbeit Distanzmaße einsetzt, denke an die Hamming-Distanz, wenn:
Um dein Wissen über Distanzmaße und weitere grundlegende Data-Science-Konzepte zu vertiefen, wirf einen Blick auf unser Data Scientist Certification-Programm – verfügbar in Python und R.
Lerne mit DataCamp
Kurs
Kurs
Kurs
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Aditya Sharma
7 Min.