

¿Qué es DeepSeek V4?
DeepSeek V4 es la última generación de modelos de lenguaje Mixture-of-Experts (MoE) de DeepSeek AI. La serie incluye dos variantes:
- DeepSeek-V4-Pro: Tiene 1,6T de parámetros totales (49B activados) y admite una longitud de contexto de 1 M de tokens.
- DeepSeek-V4-Flash: La versión más pequeña suma 284B de parámetros totales (13B activados), también con una ventana de contexto de 1 M de tokens.
Varias mejoras arquitectónicas distinguen V4 de sus predecesores:
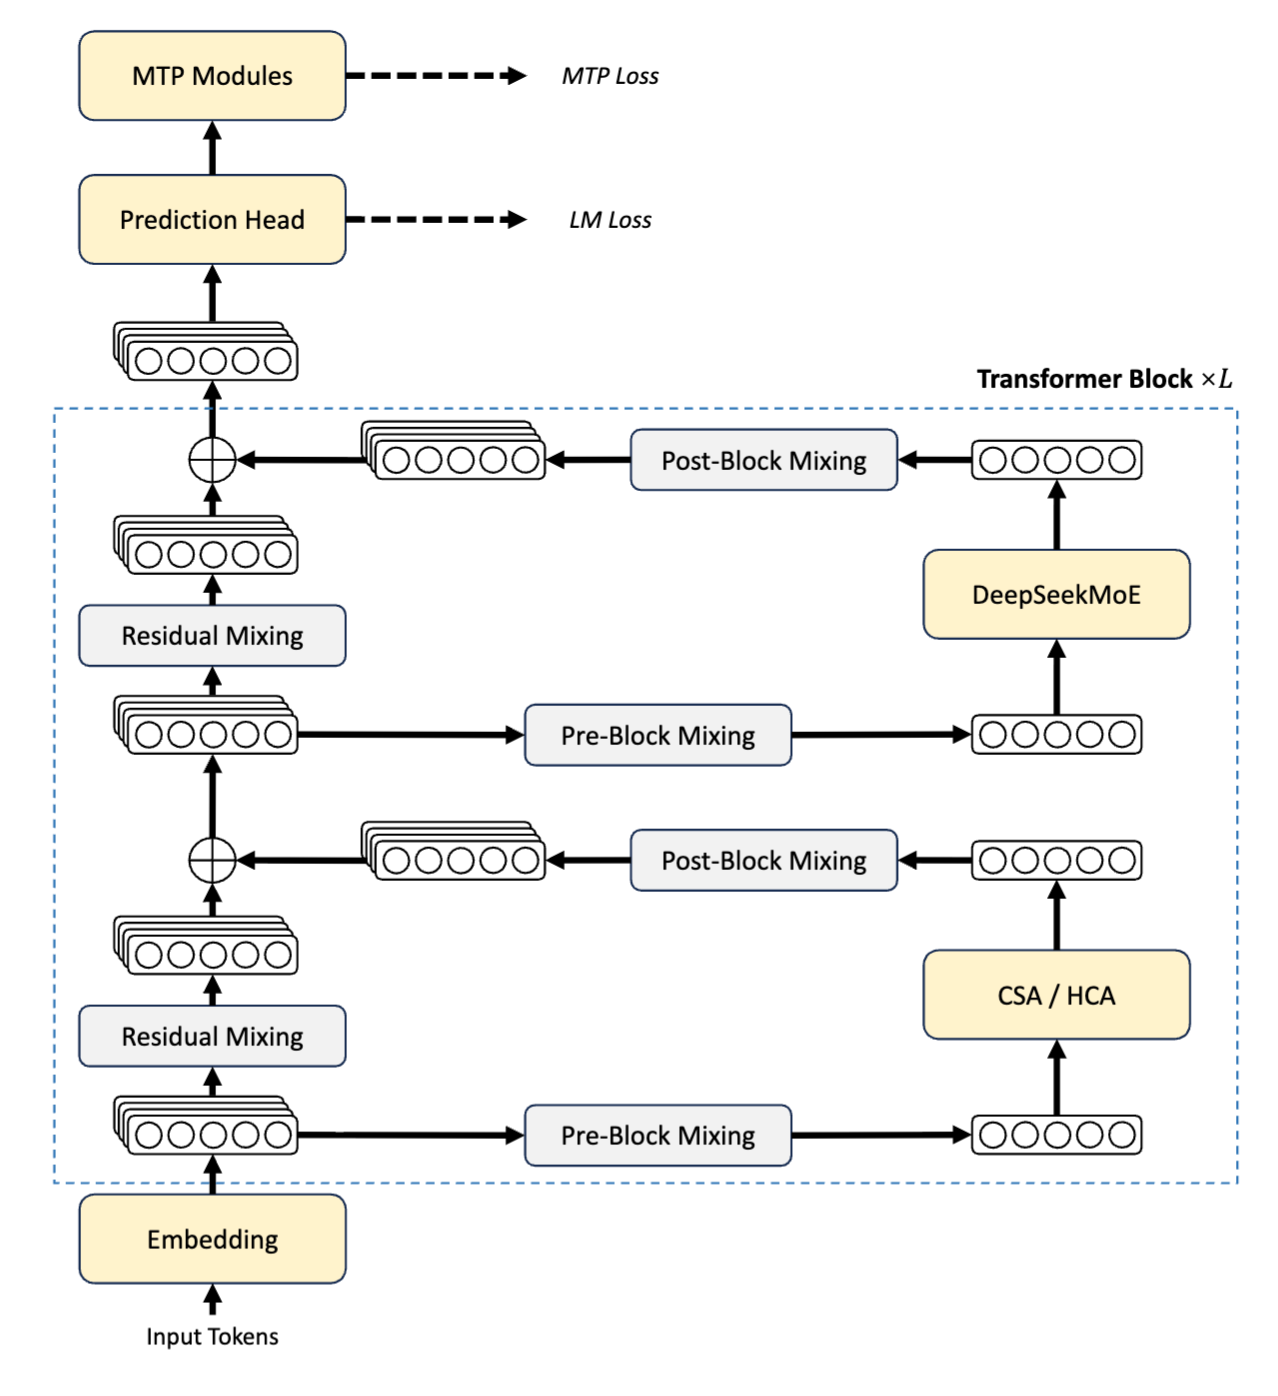
Figura: arquitectura de la serie DeepSeek V4 (informe técnico de DeepSeek)
- Arquitectura de atención híbrida (CSA / HCA): La ruta derecha (en la figura) de cada bloque empieza con Compressed Sparse Attention (CSA) y Heavily Compressed Attention (HCA). En lugar de atender a cada token en cada capa, estos mecanismos comprimen selectivamente el cómputo de atención. En un contexto de 1 M de tokens, esto implica que DeepSeek-V4-Pro necesita solo el 27% de los FLOPs de inferencia por token y el 10% de la caché KV respecto a DeepSeek-V3.2. La salida de atención pasa por Pre-Block y Post-Block Mixing antes de volver al estado oculto principal mediante la conexión residual.
- DeepSeekMoE: Tras la atención, la misma ruta alimenta la capa DeepSeekMoE, donde el componente MoE activa solo un subconjunto de parámetros por token. Esto hace que los 284B parámetros totales de V4-Flash se comporten como un modelo de 13B en inferencia, y que los 1,6T de V4-Pro se comporten como uno de 49B.
- Manifold-Constrained Hyper-Connections (mHC): La ruta izquierda (en la figura) muestra representaciones del estado oculto apiladas que fluyen mediante Residual Mixing en la parte inferior y superior de cada bloque. Estas son las capas mHC, donde un sustituto de las conexiones residuales estándar restringe las actualizaciones a un variedad aprendida, mejorando la estabilidad de la señal de gradiente en pilas profundas sin sacrificar expresividad.
- Optimizador Muon: Muon (no visible en el diagrama) sustituye a AdamW para la mayoría de parámetros con una regla de actualización inspirada en segundo orden que aporta convergencia más rápida y curvas de pérdida más estables a la escala a la que se entrena V4.
Ambos modelos admiten tres modos de esfuerzo de razonamiento diferenciados, Non-think, Think High y Think Max, que exploraremos y compararemos en este tutorial.
Puntuaciones en benchmarks de DeepSeek V4
El equipo de DeepSeek comparó el rendimiento del modelo V4 con sus homólogos y esto fue lo que encontraron:
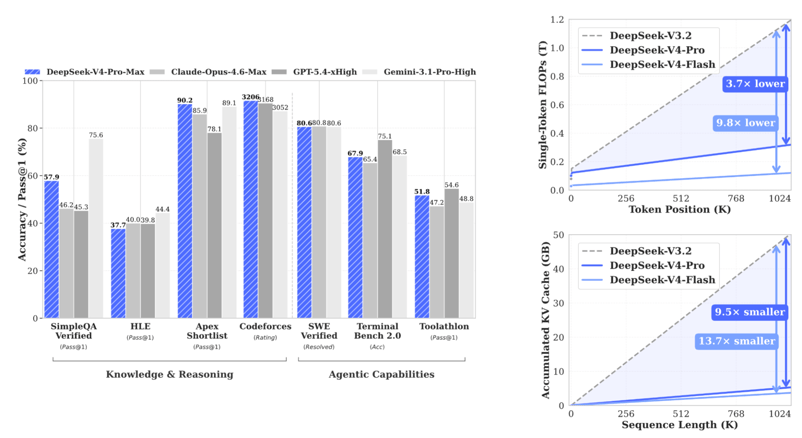
Figura: rendimiento en benchmarks de la serie DeepSeek V4 (informe técnico de DeepSeek)
El gráfico de barras de la izquierda muestra dónde se sitúa V4-Pro-Max frente a modelos cerrados punteros en tareas de conocimiento, razonamiento y agentes. Las dos gráficas de la derecha explican por qué importan las ganancias de eficiencia, y son los resultados más sorprendentes. DeepSeek-V4-Pro-Max (el modo de razonamiento Think Max) logra resultados competitivos frente a modelos cerrados punteros:
|
Benchmark |
DeepSeek-V4-Pro Max |
Claude Opus 4.6 Max |
Gemini-3.1-Pro High |
|
LiveCodeBench (Pass@1) |
93.5 |
88.8 |
91.7 |
|
Codeforces Rating |
3206 |
— |
3052 |
|
GPQA Diamond (Pass@1) |
90.1 |
91.3 |
94.3 |
|
SWE Verified (Resolved) |
80.6 |
80.8 |
80.6 |
La puntuación de 3206 en Codeforces sitúa a V4-Pro-Max en nivel Legendary Grandmaster, lo que convierte las tareas de programación de nuestra arena en una prueba de estrés realmente interesante.
Entender los tres modos de razonamiento
Antes de construir la app, merece la pena entender qué hace realmente cada modo:
Non-think: El modelo responde directamente, sin cadena de pensamiento interna. Es ideal cuando prima la velocidad sobre la profundidad: conversión de formatos, consultas sencillas y resúmenes en una frase.Think High: El modelo razona paso a paso antes de fijar una respuesta. Es un buen equilibrio entre profundidad y coste para tareas de complejidad media como depuración, diseño de sistemas y planificación.Think Max: El modelo lleva el razonamiento al máximo, explora múltiples enfoques, verifica su lógica con rigor y solo se compromete con una respuesta final cuando está seguro. Así, el modoThink Maxes mejor para demostraciones matemáticas difíciles, refactors complejos multiarchivo o cualquier tarea donde una respuesta incorrecta y segura sea peor que otra más lenta pero verificada.
La idea clave que demuestra este tutorial es que Think Max no siempre gana. En tareas triviales, desperdicia cómputo para una calidad idéntica. El objetivo de la arena es mostrar qué modo merece realmente la pena según el tipo de tarea, basándose en latencia real, recuento de tokens, coste y valoraciones de usuarios.
Si te interesa ver cómo se compara el modelo con otros LLM de última generación, te recomendamos leer nuestros artículos sobre Claude Opus 4.7 vs DeepSeek V4 y GPT-5.5 vs DeepSeek V4.
Tutorial: crea una Think Mode Arena con DeepSeek V4
En este tutorial, construiremos una aplicación en Streamlit que:
-
Acepte un prompt y una categoría de tarea del usuario
-
Lance tres llamadas a la API en paralelo, una por modo de razonamiento, usando
ThreadPoolExecutorde Python -
Analice trazas de razonamiento desde bloques
<think>...</think>en la salida del modelo -
Registre latencia, recuentos de tokens y coste estimado por modo
-
Presente una comparación lado a lado con métricas, sistema de valoración y resumen de ganador
La app completa funciona en un único archivo app.py, sin bases de datos externas ni servicios en segundo plano.
El código completo de este tutorial está en mi repositorio de GitHub.
Paso 1: configuración del proyecto y dependencias
Empieza creando una carpeta de proyecto e instalando los dos paquetes necesarios:
mkdir deepseek-arena && cd deepseek-arena
pip install streamlit>=1.32.0 openai>=1.12.0Aquí usamos la librería openai porque la API de DeepSeek es compatible con OpenAI, lo que significa que podemos apuntar el cliente de OpenAI a la URL base de DeepSeek sin más cambios. No hace falta un SDK específico de DeepSeek.
Obtén una clave de API en platform.deepseek.com y configúrala como variable de entorno:
export DEEPSEEK_API_KEY="sk-..."Con el entorno listo, pasamos a configurar modelos y modos.
Paso 2: configuración — modelos, modos y precios
Antes de escribir lógica, definimos los imports, identificadores de modelos, configuraciones de los modos de razonamiento y constantes de precios. Estos diccionarios controlan el comportamiento de toda la app: el desplegable de modelos, los parámetros de API que activan cada modo de razonamiento, el esquema de color de la UI y las estimaciones de coste que se muestran en el panel de comparación.
import os
import time
import concurrent.futures
from dataclasses import dataclass
from typing import Optional, Dict
import streamlit as st
from openai import OpenAI
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY_ENV = "DEEPSEEK_API_KEY"
MODELS = {
"DeepSeek-V4-Flash (default)": "deepseek-v4-flash",
"DeepSeek-V4-Pro": "deepseek-v4-pro",
}
MODES: Dict[str, dict] = {
"Non-think": {
"icon": "",
"color": "#10b981",
"badge": "green",
"desc": "Fast, direct answers — no internal reasoning",
"thinking_type": "disabled",
"reasoning_effort": None,
},
"Think High": {
"icon": "",
"color": "#3b82f6",
"badge": "blue",
"desc": "Careful step-by-step reasoning before responding",
"thinking_type": "enabled",
"reasoning_effort": "high",
},
"Think Max": {
"icon": "",
"color": "#ef4444",
"badge": "red",
"desc": "Exhaustive reasoning — push analysis to the limit",
"thinking_type": "enabled",
"reasoning_effort": "max",
},
}
PRICING = {
"deepseek-v4-flash": {
"input_cache_hit": 0.0028,
"input_cache_miss": 0.14,
"output": 0.28,
},
"deepseek-v4-pro": {
"input_cache_hit": 0.003625,
"input_cache_miss": 0.435,
"output": 0.87,
},
}Algunas decisiones de diseño que conviene comentar:
-
Parámetros para el modo de razonamiento: Cada entrada en
MODESlleva dos campos de API en lugar de un system prompt. Incluyenthinking_typeyreasoning_effort("high","max"oNone).thinking_typese pasa víaextra_body={"thinking": {"type": ...}}, yreasoning_effortes un parámetro de nivel superior. Non-think establecethinking_typecomo "disabled"y dejareasoning_effortenNone, por lo que no se envía cuerpo de razonamiento. -
Flash como modelo por defecto: Flash activa 13B parámetros por token frente a los 49B de Pro, lo que hace que las tres llamadas en paralelo sean lo bastante baratas como para iterar durante la experimentación. Pro está disponible en el desplegable cuando necesites rendimiento de frontera, pero
Think Maxen Pro consume cuota rápido, por lo que mantenerlo como opt-in y no por defecto es una salvaguarda de costes deliberada.
Nota: Los valores del código anterior reflejan V4-Pro con su descuento promocional actual. Verifica siempre las tarifas vigentes en api-docs.deepseek.com/quick_start/pricing antes de publicar comparativas de coste, ya que tarifas base y descuentos promocionales cambian con frecuencia tras el lanzamiento de un modelo.
Paso 3: plantillas de tareas
El diseño de tareas es la parte más infravalorada al construir una comparación de razonamiento. Si todas las tareas son difíciles y abiertas, Think Max gana siempre y la demo no enseña nada. El conjunto de tareas debe cubrir todo el rango de dificultad para que cada modo tenga al menos una categoría donde gane.
TASKS = {
"Trivial / Lookup": {
"prompt": (
"Complete both tasks below:\n\n"
"Task A — Convert this JSON to YAML:\n"
'{"name": "Alice", "age": 30, "skills": ["Python", "ML", "LLMs"],\n'
' "address": {"city": "San Francisco", "zip": "94105"}}\n\n'
"Task B — Summarize this paragraph in exactly one sentence:\n"
'"Large language models have rapidly transformed natural language processing '
"by demonstrating unprecedented capabilities across translation, summarization, "
"reasoning, and code generation, driven by scale and alignment techniques like RLHF "
'that bring model outputs closer to human intent."'
),
"expected_winner": "Non-think",
"tip": "Non-think should dominate here. No reasoning is required.",
},
"Coding / Debugging": {
"prompt": (
"Find every bug in the Python code below, explain each bug clearly, "
"and provide a fully corrected version:\n\n"
"```python\n"
"def binary_search(arr, target):\n"
" left, right = 0, len(arr)\n"
" while left < right:\n"
" mid = (left + right) // 2\n"
" if arr[mid] == target:\n"
" return mid\n"
" elif arr[mid] < target:\n"
" left = mid\n"
" else:\n"
" right = mid - 1\n"
" return -1\n\n"
"print(binary_search([1, 3, 5, 7, 9], 7))\n"
"```"
),
"expected_winner": "Think High",
"tip": "Think High usually finds the bugs and explains them well.",
},
"System Design": {
"prompt": (
"Design a scalable vector search system for 100 million documents.\n\n"
"Address each of the following:\n"
"1. Indexing strategy and pipeline\n"
"2. ANN algorithm selection (HNSW vs IVF-PQ vs ScaNN — justify your choice)\n"
"3. Sharding and replication strategy\n"
"4. p99 query latency target (< 50 ms) — how do you hit it?\n"
"5. Real-time document update handling\n"
"6. Top 3 failure modes and their mitigations"
),
"expected_winner": "Think High",
"tip": "Think High often gives the best quality-per-dollar design answer.",
},
"Planning": {
"prompt": (
"Create a detailed 6-month roadmap for deploying an enterprise RAG system.\n\n"
"Include:\n"
"- Month-by-month phases with concrete, measurable milestones\n"
"- Top 5 risks and mitigation strategies\n"
"- Team roles and headcount required per phase\n"
"- Evaluation metrics for each phase (how do you know it's working?)\n"
"- Go / no-go production checklist"
),
"expected_winner": "Think High",
"tip": "Think High should produce a more structured, complete roadmap.",
},
"Math (IMO-style)": {
"prompt": (
"Solve this problem completely and verify your answer:\n\n"
"Find all positive integers n such that n² + 1 is divisible by n + 1.\n\n"
"Your answer must include:\n"
"1. A complete proof with clear logical steps\n"
"2. Verification with at least 3 concrete numerical examples\n"
"3. A rigorous argument for why your solution set is complete "
"(i.e., there are no other solutions)"
),
"expected_winner": "Think Max",
"tip": "Think Max earns its cost when thorough verification matters.",
},
}Las cinco tareas se ajustan bien a los tres ganadores esperados:
|
Tarea |
Ganador esperado |
Motivo |
|
Trivial / Lookup |
Non-think |
No hace falta razonamiento; pensar aquí solo añade tiempo inútil |
|
Coding / Debugging |
Think High |
Una pasada metódica detecta todos los bugs; Max aporta valor marginal |
|
System Design |
Think High |
La profundidad mejora la calidad; agotar no añade arquitectura útil |
|
Planning |
Think High |
La estructura gana al cómputo bruto; una hoja de ruta no es una prueba |
|
Math (IMO-style) |
Think Max |
La verificación lo sostiene todo; una prueba errónea es peor que otra lenta pero correcta |
Cada tarea también incluye un campo expected_winner. La app lo muestra tras recibir los resultados para que los usuarios comprueben si el ganador previsto se mantiene o no.
Paso 4: clase de datos
Con las plantillas de tareas definidas, necesitamos una estructura para almacenar los resultados de cada llamada a la API. En lugar de pasar objetos de respuesta en bruto por la app, definimos una dataclass RunResult que captura todas las métricas que requiere el panel de comparación.
@dataclass
class RunResult:
mode: str
answer: str = ""
thinking: str = ""
latency: float = 0.0
input_tokens: int = 0
output_tokens: int = 0
cost_usd: float = 0.0
error: Optional[str] = None
@property
def tokens_per_second(self) -> Optional[float]:
if self.latency > 0 and self.output_tokens > 0:
return self.output_tokens / self.latency
return None
@property
def thinking_word_count(self) -> int:
return len(self.thinking.split()) if self.thinking else 0El campo thinking está separado de answer porque la API de DeepSeek V4 devuelve la cadena de pensamiento en un campo dedicado reasoning_content, al mismo nivel que content en la respuesta. Mantenerlos separados permite a la UI mostrar una traza de razonamiento plegable junto a la respuesta final limpia, lo que hace la diferencia entre modos inmediata y palpable, especialmente en la tarea de mates, donde la traza de Think Max puede llegar a miles de palabras.
La propiedad tokens_per_second mide el rendimiento de generación independientemente de la longitud del prompt. Es útil para comparar eficiencia entre modos cuando los tokens de salida difieren significativamente. Ten en cuenta que Think Max produce naturalmente más tokens, así que la latencia en bruto puede ser engañosa si no ves también a qué ritmo generó cada modo.
Paso 5: utilidades de estimación de costes
Antes de escribir la lógica de llamadas a la API, definimos dos pequeñas utilidades que median entre la respuesta del SDK y RunResult. Son fáciles de pasar por alto pero importan mucho para la precisión del coste.
def get_cached_prompt_tokens(usage) -> int:
prompt_details = getattr(usage, "prompt_tokens_details", None)
if prompt_details is None:
return 0
cached_tokens = getattr(prompt_details, "cached_tokens", None)
if cached_tokens is not None:
return cached_tokens or 0
if isinstance(prompt_details, dict):
return prompt_details.get("cached_tokens", 0) or 0
return 0
def estimate_cost_usd(
model: str,
prompt_tokens: int,
completion_tokens: int,
cached_prompt_tokens: int,
) -> float:
pricing = PRICING.get(model, PRICING["deepseek-v4-flash"])
cached_tokens = min(cached_prompt_tokens, prompt_tokens)
uncached_tokens = max(prompt_tokens - cached_tokens, 0)
return (
cached_tokens / 1_000_000 * pricing["input_cache_hit"]
+ uncached_tokens / 1_000_000 * pricing["input_cache_miss"]
+ completion_tokens / 1_000_000 * pricing["output"]
)La función get_cached_prompt_tokens() no accede a campos directamente porque la estructura prompt_tokens_details no es consistente entre versiones del SDK. Primero comprueba si existe el atributo tipado, después recurre a acceso por diccionario y, si no, devuelve cero en lugar de lanzar una excepción. Esto es importante dentro de un ThreadPoolExecutor, donde un error silencioso en un hilo produciría una estimación de coste engañosamente baja sin mostrar ningún fallo visible.
La utilidad estimate_cost_usd() separa los tokens del prompt en porciones en caché y no en caché antes de aplicar tarifas. Dado que DeepSeek redujo el precio de aciertos de caché a una décima parte de la tarifa de fallo, la diferencia entre un prompt en frío y uno en caliente puede ser enorme. En ejecuciones repetidas, Non-think puede parecer casi gratis frente a Think Max, no porque genere menos tokens, sino porque su prompt más corto probablemente esté ya caliente en la caché.
Paso 6: ejecución paralela de la API
Este es el núcleo arquitectónico de la arena. Los tres modos se lanzan a la vez usando ThreadPoolExecutor, de modo que el tiempo total de pared equivale al del modo más lento y no a la suma de los tres.
def call_mode(client: OpenAI, model: str, mode_name: str, user_prompt: str) -> RunResult:
result = RunResult(mode=mode_name)
mode_cfg = MODES[mode_name]
start = time.perf_counter()
try:
request_kwargs = {
"model": model,
"messages": [{"role": "user", "content": user_prompt}],
"max_tokens": 4096,
"extra_body": {"thinking": {"type": mode_cfg["thinking_type"]}},
}
if mode_cfg["reasoning_effort"]:
request_kwargs["reasoning_effort"] = mode_cfg["reasoning_effort"]
response = client.chat.completions.create(**request_kwargs)
result.latency = time.perf_counter() - start
message = response.choices[0].message
result.thinking = (getattr(message, "reasoning_content", None) or "").strip()
result.answer = (message.content or "").strip()
usage = response.usage
result.input_tokens = getattr(usage, "prompt_tokens", 0) or 0
result.output_tokens = getattr(usage, "completion_tokens", 0) or 0
result.cost_usd = estimate_cost_usd(
model=model,
prompt_tokens=result.input_tokens,
completion_tokens=result.output_tokens,
cached_prompt_tokens=get_cached_prompt_tokens(usage),
)
except Exception as exc:
result.latency = time.perf_counter() - start
result.error = str(exc)
return result
def run_parallel(client: OpenAI, model: str, prompt: str) -> Dict[str, RunResult]:
results: Dict[str, RunResult] = {}
with concurrent.futures.ThreadPoolExecutor(max_workers=3) as pool:
futures = {
pool.submit(call_mode, client, model, mode_name, prompt): mode_name
for mode_name in MODES
}
for fut in concurrent.futures.as_completed(futures):
results[futures[fut]] = fut.result()
return resultsVarias decisiones de diseño a destacar:
-
Construcción condicional de
request_kwargs: El modoNon-thinkenvíathinking_type: "disabled"y no incluyereasoning_effort.Think HighyThink Maxenvíanthinking_type: "enabled"y su nivel de esfuerzo correspondiente. La guardaif mode_cfg["reasoning_effort"]garantiza omitir por completo el parámetro paraNon-thinken lugar de enviarlo comoNone, lo que podría provocar un error de validación de la API. -
Lectura directa de
reasoning_content: La traza de cadena de pensamiento se lee demessage.reasoning_contentusandogetattr()con retroceso a cadena vacía. Es más robusto que analizar etiquetas<think>...</think>del contenido. Usa el campo oficial, maneja el caso sin traza (Non-think) y no falla si el modelo usa la palabra "think" por otros motivos. -
getattr()defensivo en campos de uso: Se accede a campos de uso congetattr(..., 0) or 0en lugar de acceso directo. Así, si falta un campo en una versión antigua del SDK o en una respuesta inusual, se obtiene cero en vez de unAttributeErrorque invalidaría toda la ejecución. -
Gestión de errores: Si una llamada falla, el dataclass
RunResultalmacena el texto del error en lugar de lanzar. La UI compruebaresult.errory muestra una tarjeta informativa sin tumbar toda la ejecución de tres modos.
Paso 7: UI y CSS en Streamlit
Este paso cubre la capa de presentación: el diseño de página, el sistema de estilos CSS, la columna de resultados por modo y la estructura de pestañas que organiza la comparación sin abrumar al usuario al cargar.
La app usa st.set_page_config con layout="wide" para dar espacio horizontal suficiente a las tres columnas de comparación:
def main():
st.set_page_config(
page_title="DeepSeek V4 Think Mode Arena",
layout="wide",
initial_sidebar_state="expanded",
)
inject_css()La función inject_css() inyecta un sistema de diseño completo vía st.markdown. Usa un fondo tipo pergamino cálido con Space Mono para cabeceras monoespaciadas y chips de métricas, y DM Sans para el texto base.
def render_mode_column(result: RunResult, mode_name: str):
cfg = MODES[mode_name]
badge_cls = f"mode-{cfg['badge']}"
st.markdown(
f'<div class="mode-header {badge_cls}">{mode_name}</div>',
unsafe_allow_html=True,
)
st.markdown(f'<div class="subtle-copy">{cfg["desc"]}</div>', unsafe_allow_html=True)
if result.error:
st.error(f"**API Error:** {result.error}")
return
chips = [
("Latency", f"{result.latency:.1f}s"),
("Output tokens", f"{result.output_tokens:,}"),
("Cost", f"${result.cost_usd:.5f}"),
]
if result.tokens_per_second:
chips.append(("Tok/s", f"{result.tokens_per_second:.0f}"))
chip_html = "".join(
f'<span class="metric-chip">{label} <span>{val}</span></span>'
for label, val in chips
)
st.markdown(chip_html, unsafe_allow_html=True)
if result.thinking:
with st.expander(f" Thinking trace — {result.thinking_word_count:,} words"):
preview = result.thinking[:5000]
if len(result.thinking) > 5000:
preview += "\n\n[… truncated for display …]"
st.text(preview)
elif mode_name != "Non-think":
st.caption("_No thinking trace emitted_")
st.markdown('<div class="answer-label">Final answer</div>', unsafe_allow_html=True)
st.markdown(result.answer if result.answer else "_No answer returned._")El desplegable de la traza de razonamiento es especialmente útil porque hace tangible la diferencia entre modos: la traza de Think Max puede alcanzar miles de palabras de autocorrección y verificación en un problema difícil, mientras que Non-think puede no tener traza alguna.
El layout principal usa pestañas de Streamlit para separar contenidos sin meterlo todo en un único scroll:
overview_tab, answers_tab, ratings_tab = st.tabs(
["Overview", "Full Responses", "Ratings"]
)La pestaña “Overview” muestra el resumen de ganadores y la tabla de métricas. “Full Responses” muestra la comparación en tres columnas con trazas de razonamiento, y “Ratings” incluye deslizadores para valoraciones de calidad (1–5) por modo.
Paso 8: métricas y valoraciones
Este último paso construye los dos componentes de la pestaña Overview: una tabla plana de métricas que pone todas las dimensiones medidas lado a lado y un resumen de ganadores que destaca el mejor en cuatro categorías.
def render_metrics_table(results: Dict[str, RunResult], ratings: Dict[str, int]):
rows = []
for mode_name, res in results.items():
ok = not res.error
rows.append({
"Mode": mode_name,
"Latency (s)": f"{res.latency:.2f}" if ok else "—",
"Input Tokens": f"{res.input_tokens:,}" if ok else "—",
"Output Tokens": f"{res.output_tokens:,}" if ok else "—",
"Tok/s": f"{res.tokens_per_second:.0f}" if (ok and res.tokens_per_second) else "—",
"Est. Cost (USD)": f"${res.cost_usd:.5f}" if ok else "—",
"Thinking Words": f"{res.thinking_word_count:,}" if ok else "—",
"User Rating": f"{ratings.get(mode_name)}/5" if ratings.get(mode_name) else "—",
})
st.table(rows)
def render_winner_summary(results: Dict[str, RunResult], ratings: Dict[str, int], expected: str):
valid = {k: v for k, v in results.items() if not v.error}
fastest = min(valid, key=lambda k: valid[k].latency)
cheapest = min(valid, key=lambda k: valid[k].cost_usd)
most_efficient = max(
valid,
key=lambda k: valid[k].output_tokens / max(valid[k].cost_usd, 1e-9),
)
top_rated = max(ratings, key=ratings.get) if ratings else NoneEn resumen, estas funciones hacen lo siguiente:
-
render_metrics_table()recorre cadaRunResulty construye una fila por modo. Las ocho columnas cubren toda la comparación: tiempo (latencia, tok/s), escala (tokens de entrada y salida, palabras de razonamiento), dinero (coste estimado) y juicio humano (valoración). -
render_winner_summary()primero filtra ejecuciones fallidas antes de calcular ganadores, de modo que un único error de API no sesgue los resultados. Luego encuentra el campeón en cuatro dimensiones independientes: velocidad, coste en bruto, eficiencia de salida y valoración de usuarios.
Estas cuatro categorías se mantienen separadas en lugar de combinarse en una sola puntuación, porque un compuesto ponderado exigiría decidir que la latencia importa más que el coste, lo cual es una decisión de producto, no del marco.
La app también muestra el ganador previsto por tarea, invitando a confirmar si ha coincidido:
st.markdown(
f"> **Expected winner for this task type:** {expected} — "
"does your result match? Rate answers to confirm.",
)Paso 9: ejecutar la app
Toda la app vive en un único app.py con dos dependencias, y arrancarla requiere dos comandos:
# Set your API key
export DEEPSEEK_API_KEY="sk-..."
# Run
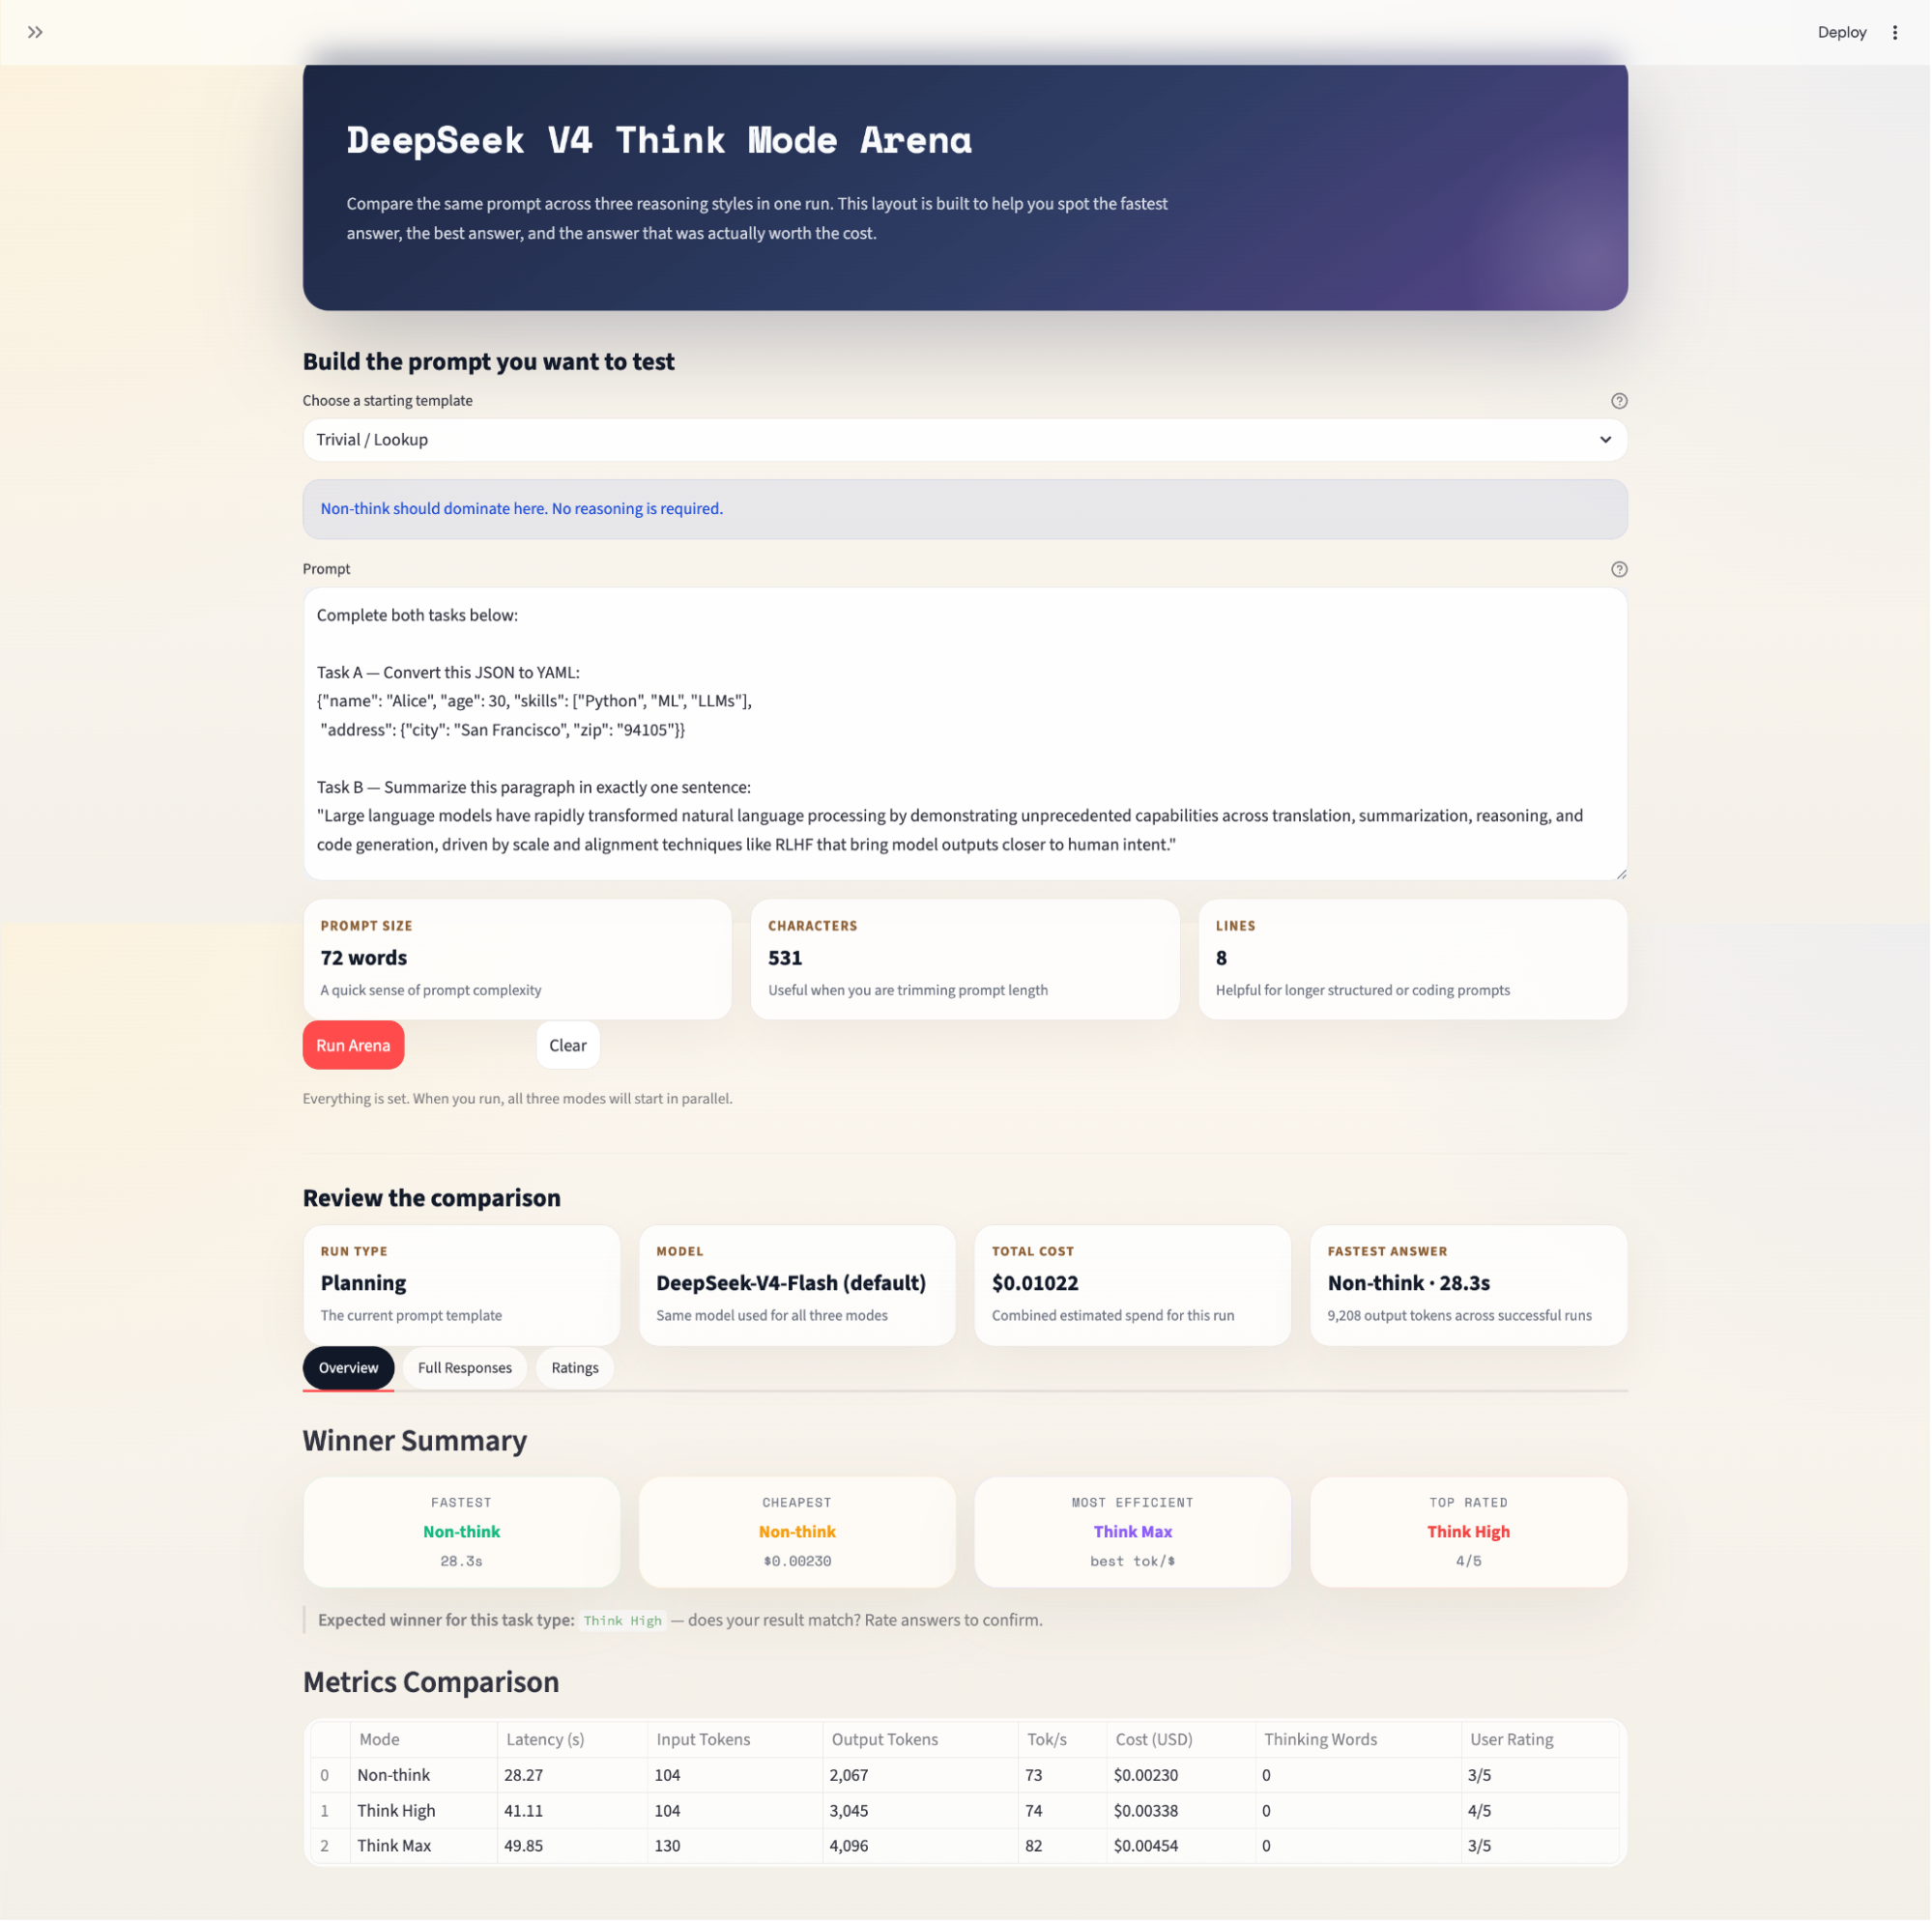
streamlit run app.pyLa app se abre en tu navegador en localhost:8501. Selecciona una plantilla de tarea en el desplegable, edita el prompt si quieres y haz clic en Run Arena. Una barra de progreso se actualiza a medida que termina cada modo. Los resultados se guardan en st.session_state para que puedas cambiar de pestaña y valorar respuestas sin forzar una reejecución.
Nota sobre precios: DeepSeek ha ajustado significativamente las tarifas de la API de V4 desde su lanzamiento. V4-Pro está actualmente con descuento promocional y en abril de 2026 los precios por acierto de caché se redujeron a una décima parte de la tarifa por fallo. Las cifras de coste que muestra la app reflejan estas tarifas actuales, pero pueden cambiar. Verifica siempre en api-docs.deepseek.com/quick_start/pricing antes de usar cualquier modelo.
Conclusión
En este tutorial, hemos creado una aplicación en Streamlit que ejecuta el mismo prompt en paralelo con los tres modos de razonamiento de DeepSeek V4 y compara resultados en latencia, coste, uso de tokens, profundidad de la traza de razonamiento y calidad valorada por usuarios. Las decisiones arquitectónicas clave fueron:
-
ThreadPoolExecutorpara paralelismo real, de forma que el tiempo total de pared sea el del modo más lento y no la suma de los tres -
Los parámetros de API
thinkingyreasoning_effortgarantizan que el control de modo sea claro, explícito y alineado con la API de DeepSeek, sin depender de prompts de sistema -
La estimación de costes consciente de la caché divide los tokens de entrada entre aciertos y fallos, produciendo cifras de coste mucho más precisas, especialmente en ejecuciones repetidas donde los descuentos por caché caliente pueden hacer que
Non-thinkparezca casi gratis
Para ampliar este proyecto, plantéate añadir una capa de LLM-as-judge (usando un modelo aparte como Claude o GPT-4 para puntuar respuestas automáticamente), cachear respuestas por hash del prompt para evitar reejecutar consultas idénticas o añadir un eje entre modelos que enfrente Flash Think Max con Pro Think High, una cuestión de paridad de costes realmente interesante que el paper de V4 plantea pero no responde del todo.
Preguntas frecuentes sobre la Think Mode Arena de la API DeepSeek V4
¿Por qué usar OpenAI en lugar de un SDK de DeepSeek?
La API de DeepSeek es compatible con OpenAI, lo que permite apuntar el cliente de OpenAI a https://api.deepseek.com con una clave de API de DeepSeek. Esto también significa que la app funcionará con cualquier proveedor compatible con OpenAI que aloje DeepSeek V4 cambiando solo la URL base y la cadena de modelo.
¿Por qué se omite reasoning_effort para Non-think en lugar de establecerlo a None?
La guarda if mode_cfg["reasoning_effort"] en call_mode() omite por completo el parámetro cuando es None, en lugar de pasar reasoning_effort=None. Algunos validadores de API rechazan parámetros desconocidos con valores nulos explícitos; por tanto, omitirlos es el patrón más seguro cuando se trabaja con endpoints recién lanzados.
¿Por qué a veces no aparece la traza de razonamiento en Think High?
La traza se lee de message.reasoning_content. Si el modelo devuelve un campo vacío o nulo en una ejecución —algo que puede pasar con prompts más cortos o menos complejos donde Think High converge rápido—, entonces result.thinking será una cadena vacía.

Soy experta Google Developers en ML (Gen AI), triple experta en Kaggle y embajadora de Women Techmakers, con más de tres años de experiencia en el sector tecnológico. Cofundé una startup de salud en 2020 y actualmente curso un máster en informática en Georgia Tech, con especialización en aprendizaje automático.





Los modelos de lenguaje grandes cada vez son más explícitos sobre cómo piensan. Con los tres modos de razonamiento de DeepSeek V4,
Non-think,Think HighyThink Max, ahora puedes controlar la profundidad del razonamiento desde la API, y la elección adecuada depende por completo de la tarea.En este tutorial, te enseño a crear una Think Mode Arena de DeepSeek V4 con Streamlit. La app lanza el mismo prompt contra los tres modos de razonamiento en paralelo y presenta una comparación lado a lado de las respuestas, la latencia, el uso de tokens, el coste y la profundidad del rastro de razonamiento. Al final tendrás una herramienta funcional que puede:
Ejecutar simultáneamente los tres modos de razonamiento de DeepSeek V4 mediante llamadas paralelas a la API
Analizar y mostrar trazas de razonamiento plegables a partir de bloques
<think>...</think>Registrar latencia, tokens de salida, rendimiento y coste estimado por modo
Destacar un resumen del ganador en cuatro dimensiones: más rápido, más barato, más eficiente y mejor valorado por personas
El código completo del tutorial está en mi repositorio de GitHub.