Curso
Programación asistida por IA para desarrolladores
1 h 30 min
9.9K
Más pequeño y más rápido ya no significa automáticamente menos capaz. Según las evaluaciones publicadas por DeepSeek, DeepSeek-V4-Flash-0731 utiliza un número de parámetros activados mucho menor que DeepSeek-V4-Pro y aun así logra un rendimiento casi de vanguardia en tareas de agentes: obtiene 82,7 en Terminal Bench 2.1, frente a 81,0 de GLM-5.2 y 85,0 de Opus 4.8. Además, su puntuación en Agents’ Last Exam es de 25,2, muy cerca del 25,7 de Opus 4.8.
Como los pesos están disponibles abiertamente, en teoría puedes ejecutar el modelo en tu propio hardware si cuentas con suficiente RAM o VRAM combinada, manteniendo la inferencia y los datos del proyecto bajo tu control.
En esta guía configuraremos un entorno RunPod con tres GPU, instalaremos y lanzaremos Unsloth Studio, descargaremos y cargaremos la versión Q8 de DeepSeek-V4-Flash-0731 repartida entre las GPU, probaremos el modelo desde Studio, conectaremos el servidor de inferencia local a OpenCode y usaremos el agente de código para crear y publicar una web interactiva de analítica bursátil.
DeepSeek-V4-Flash-0731 es la versión oficial que sustituye a la anterior vista previa, con mejoras importantes en programación, uso de herramientas y tareas autónomas de agentes. Su arquitectura Mixture-of-Experts activa solo parte del modelo por token, lo que ayuda a mantener la eficiencia sin perder rendimiento.
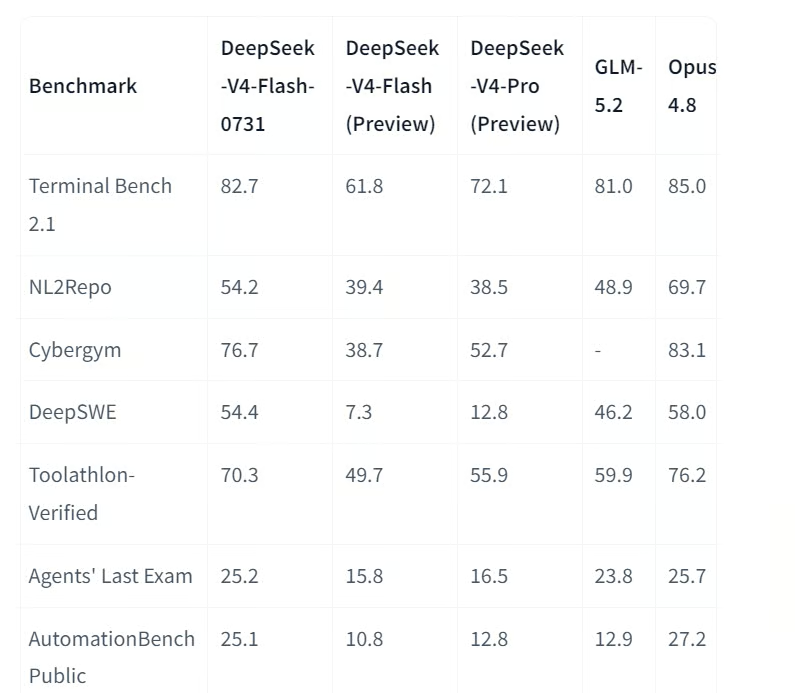
Fuente: deepseek-ai/DeepSeek-V4-Flash-0731 · Hugging Face
DeepSeek informa de que el modelo mejoró de 61,8 a 82,7 en Terminal Bench 2.1 y de 7,3 a 54,4 en DeepSWE. También superó al más grande DeepSeek-V4-Pro Preview en varios benchmarks de agentes.
El modelo admite ventanas de contexto de hasta un millón de tokens. Esto lo hace adecuado para grandes bases de código, documentos extensos y flujos complejos que requieren mucho contexto. Además, permite elegir entre esfuerzo de razonamiento bajo, alto y máximo, según el tiempo que deba dedicar a resolver una tarea.
DeepSeek-V4-Flash-0731 incluye también decodificación especulativa DSpark. DSpark esboza varios tokens antes de que el modelo principal los verifique, lo que, según DeepSeek, puede acelerar la generación entre un 60% y un 85% al usar un motor de inferencia compatible.
Empezaremos creando un entorno en RunPod con suficiente memoria GPU y almacenamiento para ejecutar la versión Q8 de DeepSeek-V4-Flash-0731 y alojar tanto Unsloth Studio como la web generada por OpenCode.
Configura el Pod con:
/workspace como ruta de montaje del volumen persistenteHF_TOKEN8910 y 9101 expuestos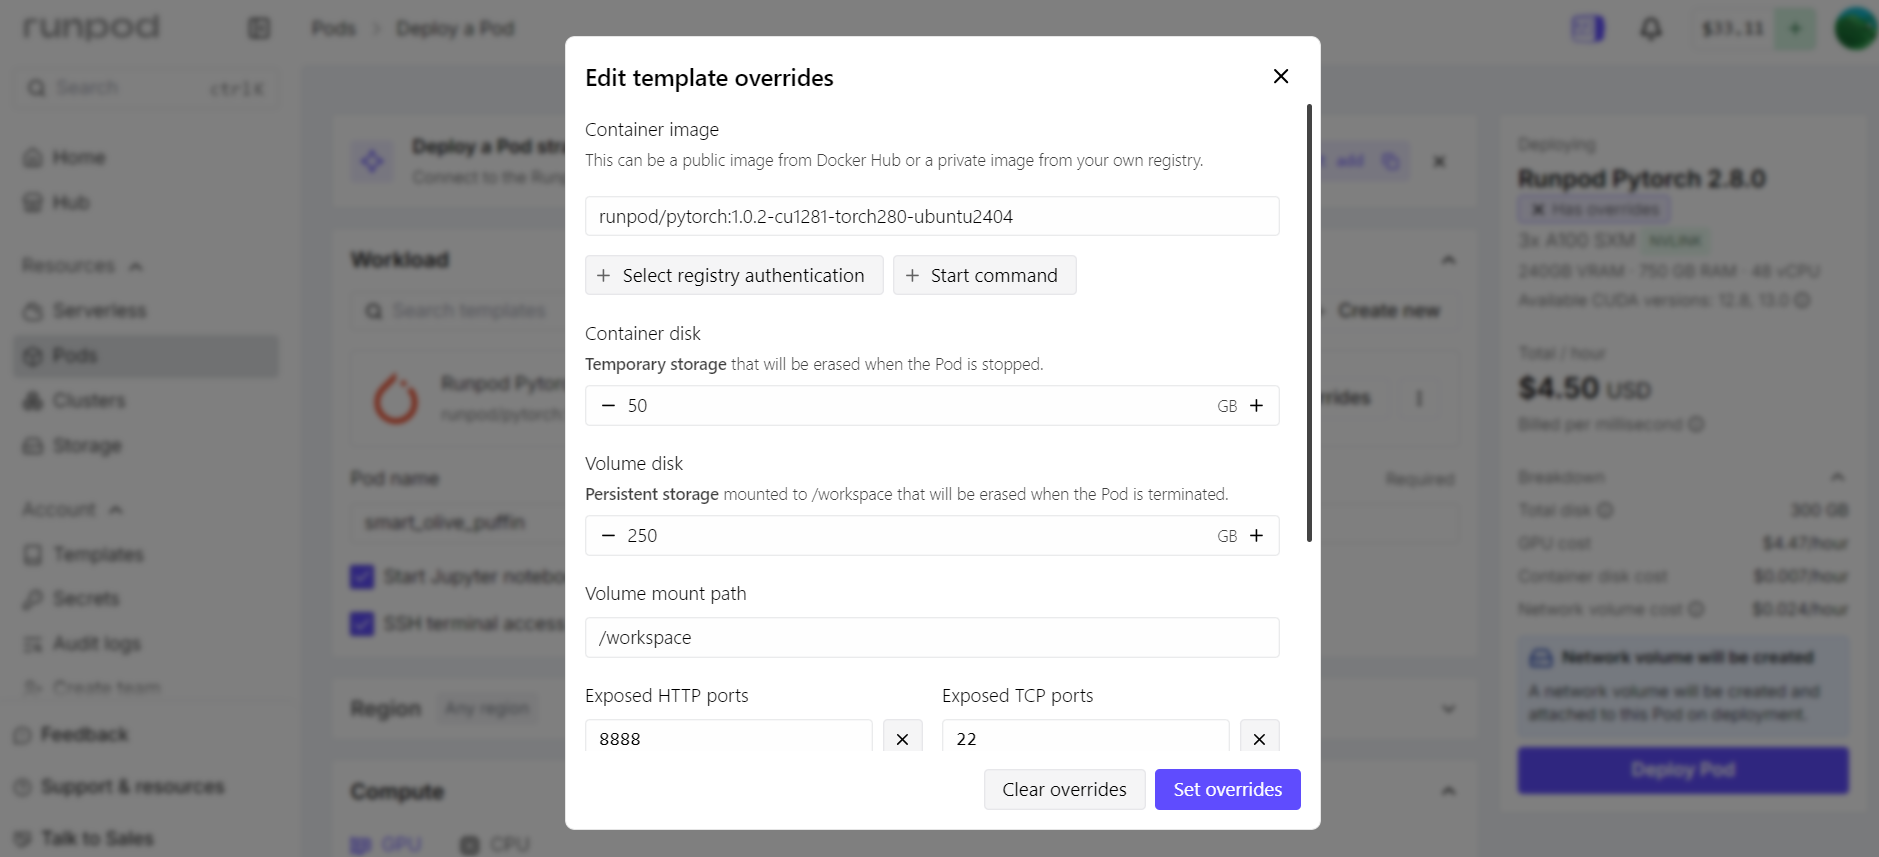
El puerto 8910 se usará para Unsloth Studio y su API de inferencia local. El puerto 9101 alojará la web interactiva creada por OpenCode.
RunPod expone estos servicios a través de su proxy HTTP, por lo que ambas aplicaciones deben escuchar en 0.0.0.0 y no solo en 127.0.0.1.
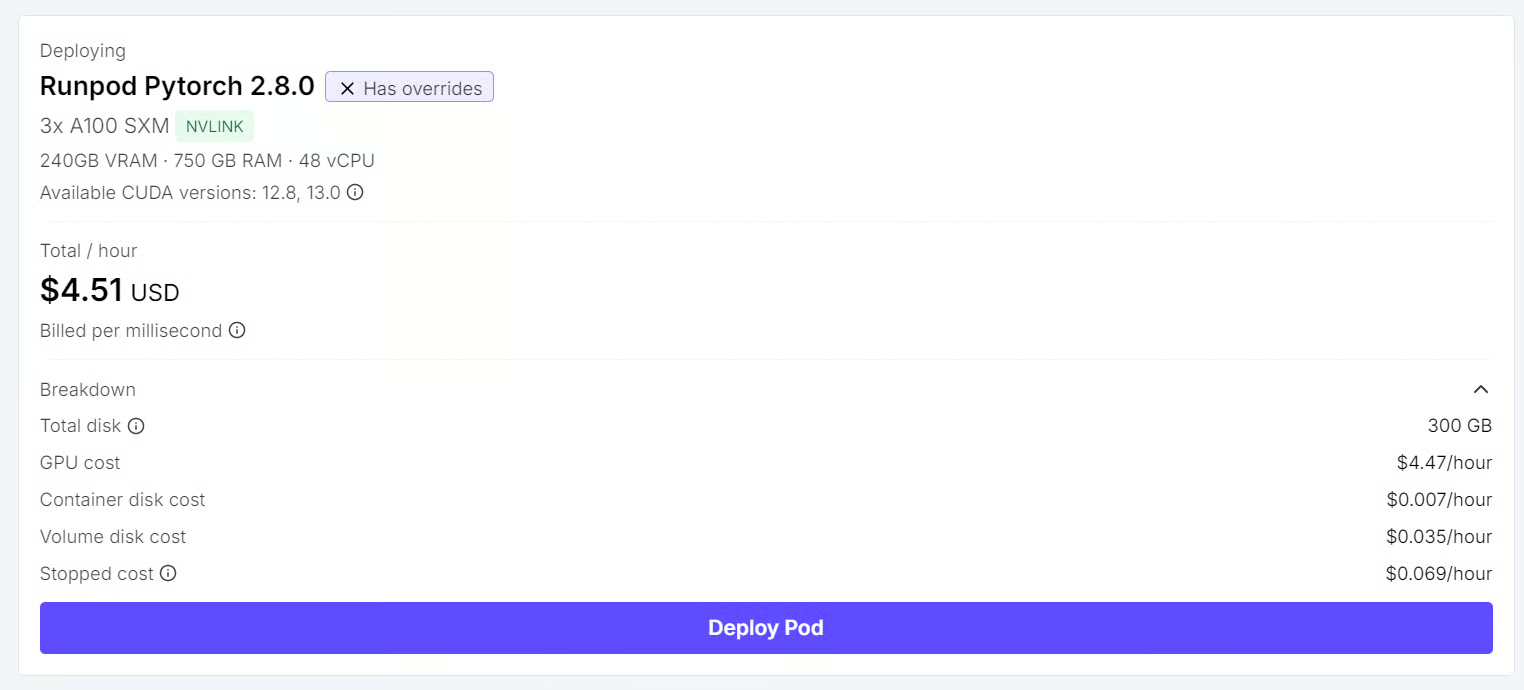
Tras desplegar el Pod, abre la pestaña Connect, lanza JupyterLab y crea tres sesiones de terminal:
Terminal 1: Unsloth Studio
Terminal 2: GPU monitoring
Terminal 3: OpenCode
Mantener las tareas en terminales separadas facilita supervisar las GPU, depurar el modelo y ejecutar el agente de código al mismo tiempo.
Ahora instalaremos Unsloth Studio, configuraremos una caché persistente de Hugging Face y lanzaremos la interfaz en el puerto 8910.
En la Terminal 1, confirma que las tres GPU están disponibles:
nvidia-smiDeberías ver listadas las tres A100 en el servidor Linux.
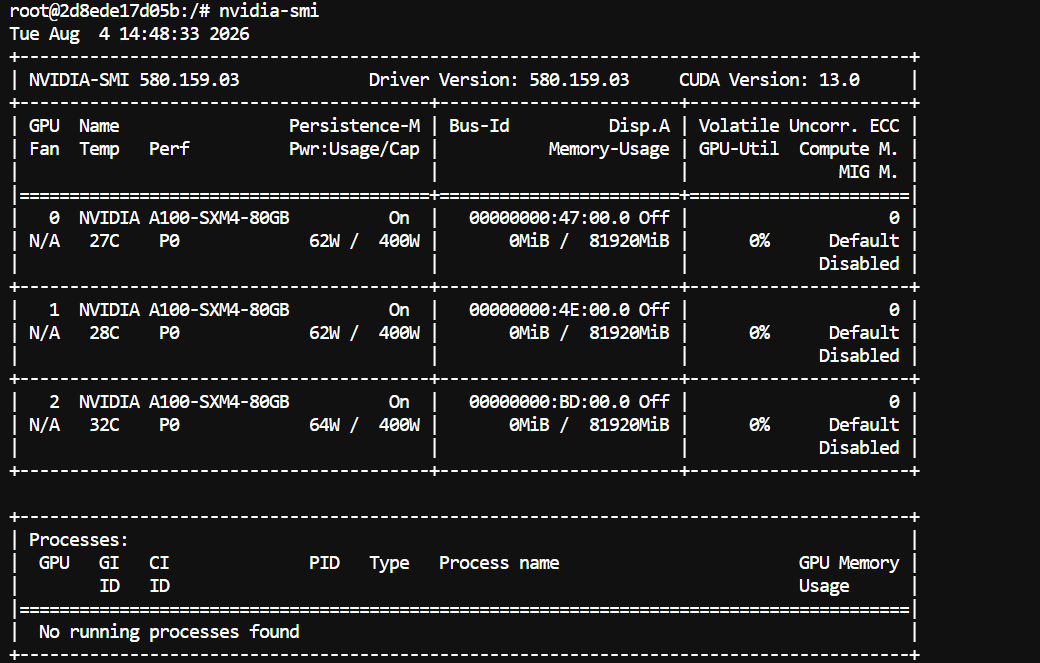
Crea una caché persistente de Hugging Face dentro de /workspace para que los modelos descargados permanezcan en el volumen de RunPod:
mkdir -p /workspace/huggingface
export HF_HOME=/workspace/huggingface

echo 'export HF_HOME=/workspace/huggingface' >> ~/.bashrc
A continuación, instala los paquetes de sistema necesarios y Unsloth Studio:
cd /workspace

apt-get update
apt-get install -y curl git cmake build-essential libcurl4-openssl-dev

curl -fsSL https://unsloth.ai/install.sh | sh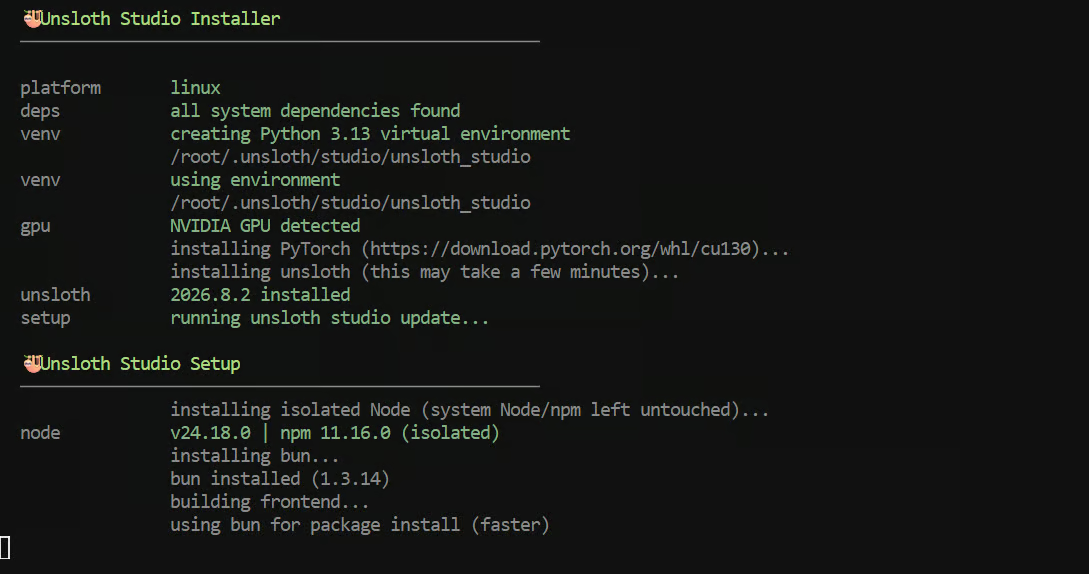
El instalador configura la interfaz de Studio, el entorno de Python, las dependencias y los componentes de inferencia local.
La primera instalación puede tardar varios minutos.
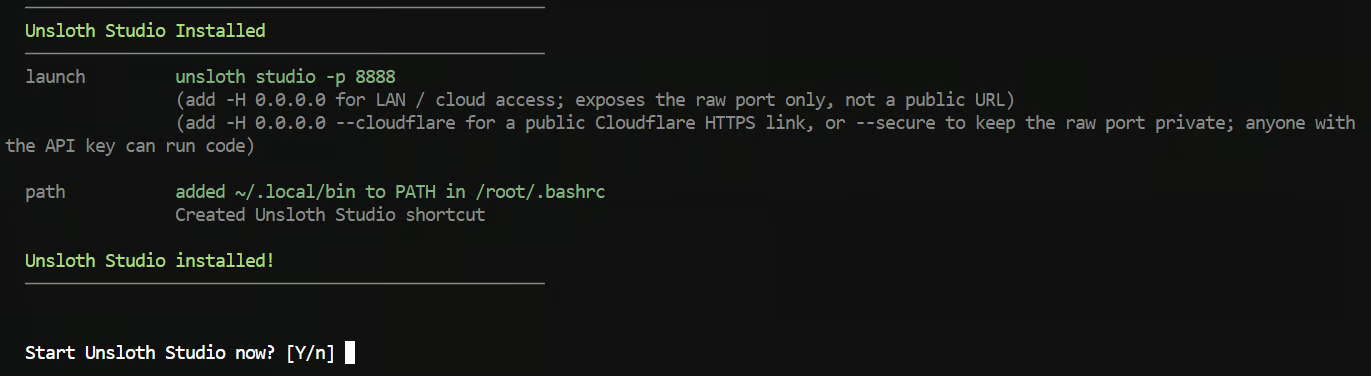
Cuando el instalador te pregunte si quieres iniciar Unsloth Studio ahora, introduce «n».
Lo iniciaremos manualmente para usar el puerto 8910 y escuchar en la dirección de red correcta.
Reinicia la shell para que los nuevos comandos estén disponibles:
exec bash
cd /workspace
Antes de lanzar Studio, restablece la contraseña por defecto:
unsloth studio reset-passwordCopia la contraseña temporal que se mostró durante la instalación, ya que puede que la necesites para completar el restablecimiento.
Ahora lanza Unsloth Studio:
unsloth studio \
  -H 0.0.0.0 \
  -p 8910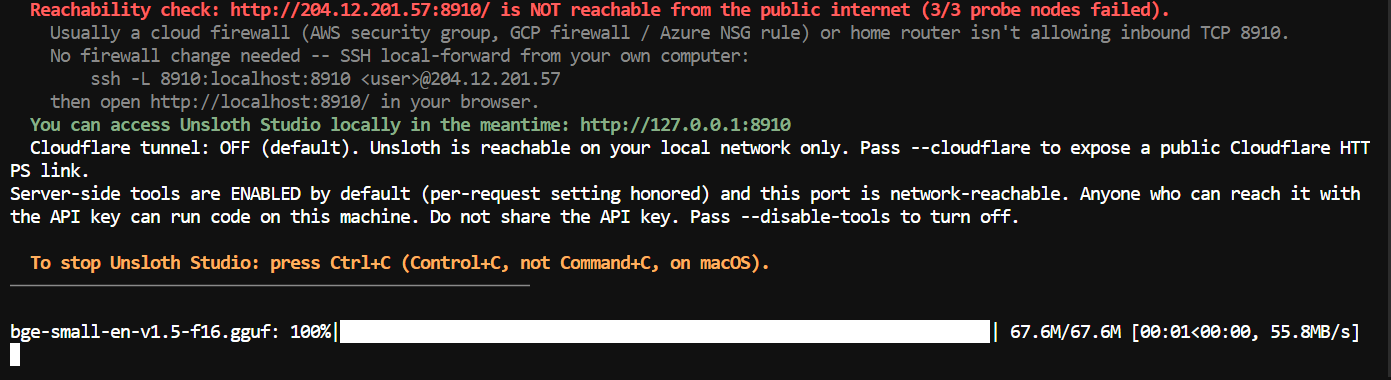
Studio debería indicar que se está ejecutando en el puerto 8910. Mantén la Terminal 1 abierta mientras usas Unsloth Studio y OpenCode.
Vuelve a la página Connect de RunPod y abre el servicio HTTP del puerto 8910.
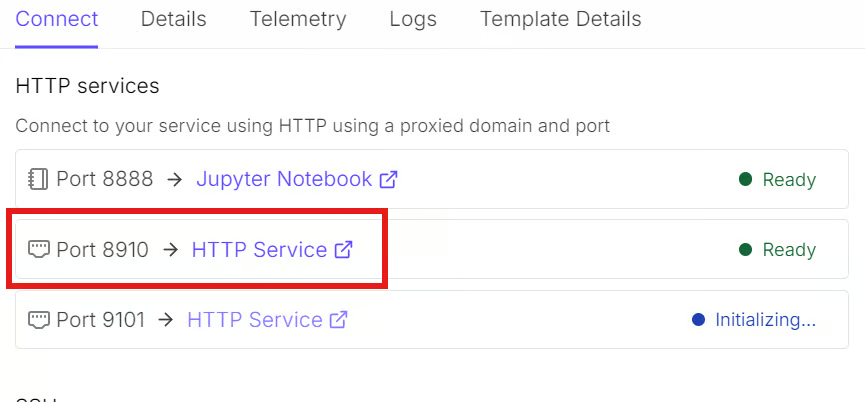
Usa la contraseña temporal generada antes para completar el restablecimiento y entra con la nueva contraseña que creaste.
Completa o salta el onboarding y abre la página de Chat.
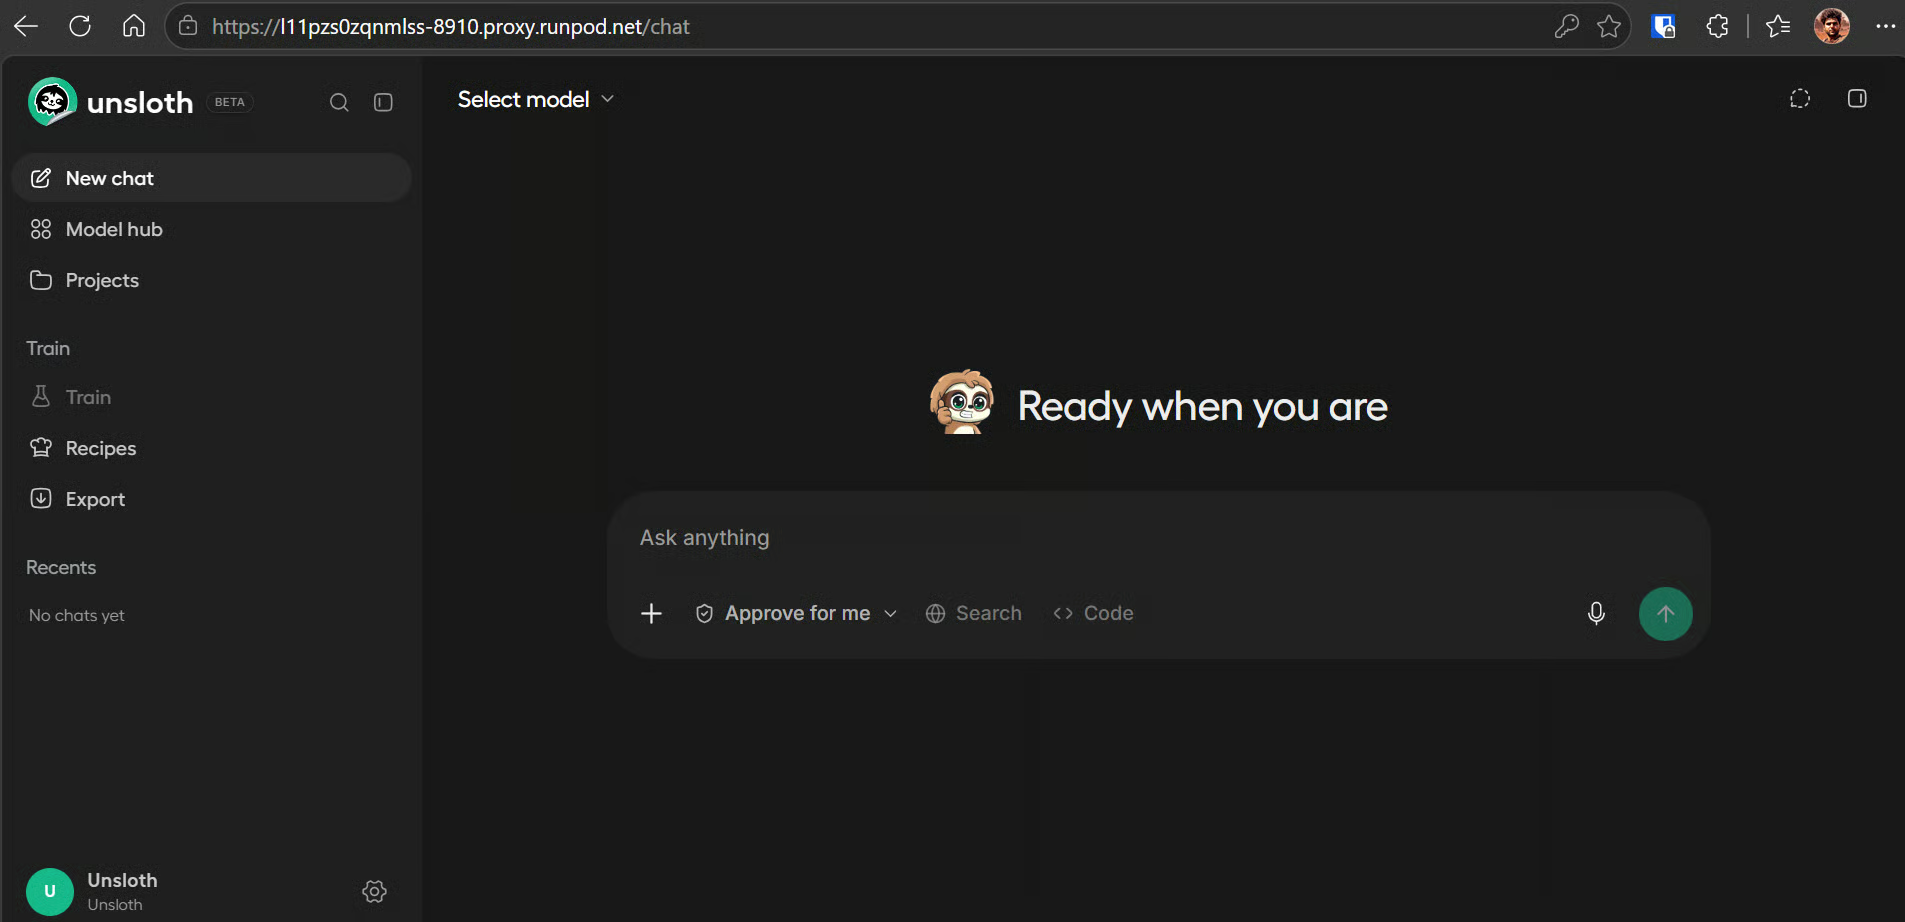
Con Unsloth Studio en marcha, ya podemos descargar el modelo Q8, cargarlo en las tres GPU y probar sus capacidades de chat y uso de herramientas.
Abre el selector de modelos en la esquina superior izquierda, busca unsloth/DeepSeek-V4-Flash-0731-GGUF y selecciona la cuantización Q8 UD-Q8_K_XL.
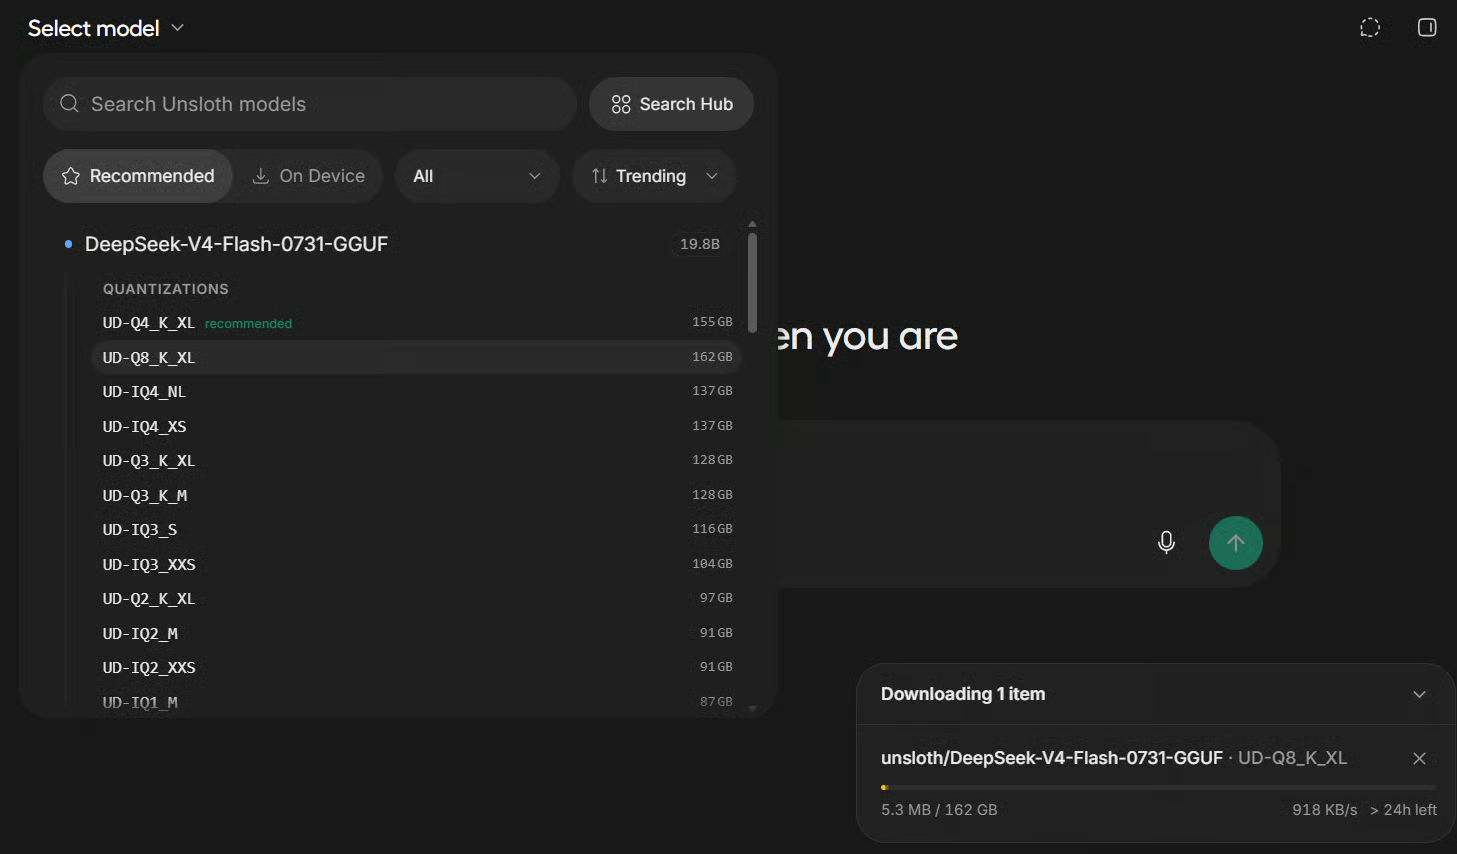
Usamos Q8 porque las tres A100 ofrecen VRAM suficiente en conjunto. Mantiene una calidad más próxima al modelo original, mientras que cuantizaciones inferiores son más útiles cuando la memoria del hardware es limitada.
Una vez termine la descarga, Unsloth Studio empezará automáticamente a cargar el modelo en la memoria de las GPU. Puede tardar varios minutos porque el modelo Q8 es muy grande.
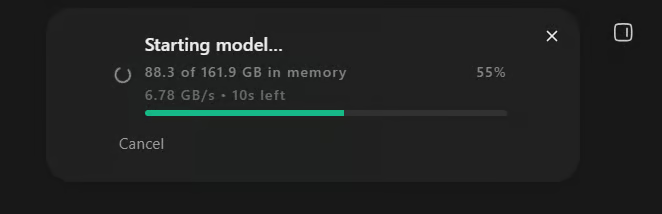
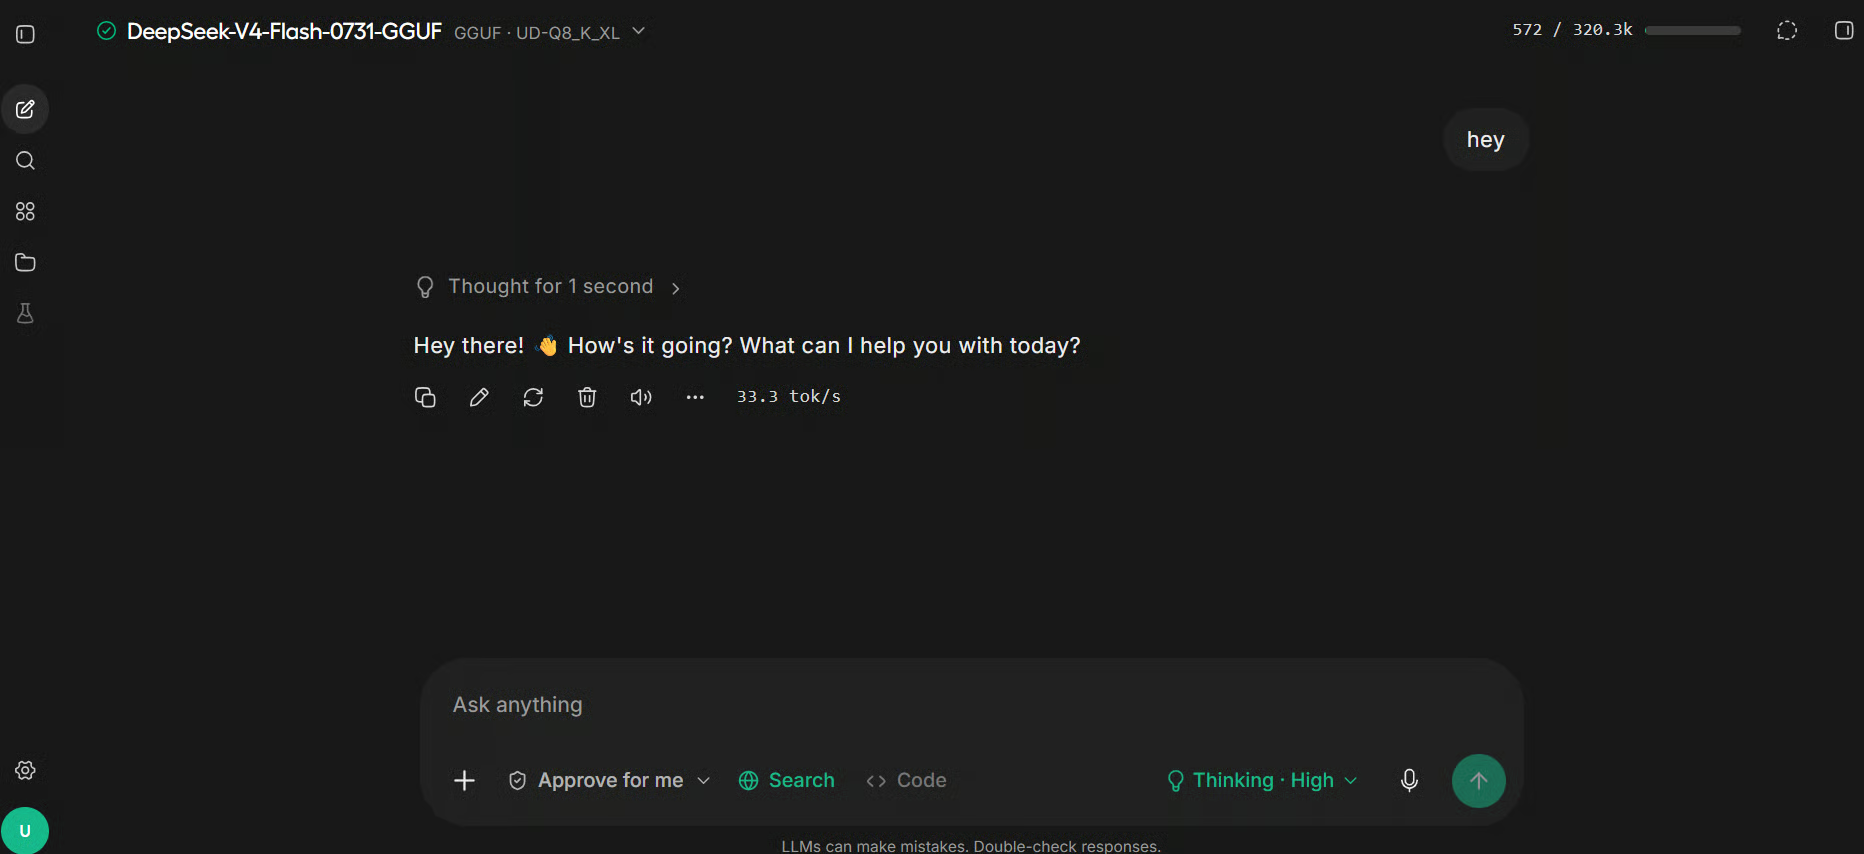
Tras la carga, usa la página de Chat para probar el modelo con algunos prompts sencillos.
En nuestras pruebas, la generación alcanzó aproximadamente 33 tokens por segundo sin decodificación especulativa, un resultado razonable para un modelo de este tamaño.
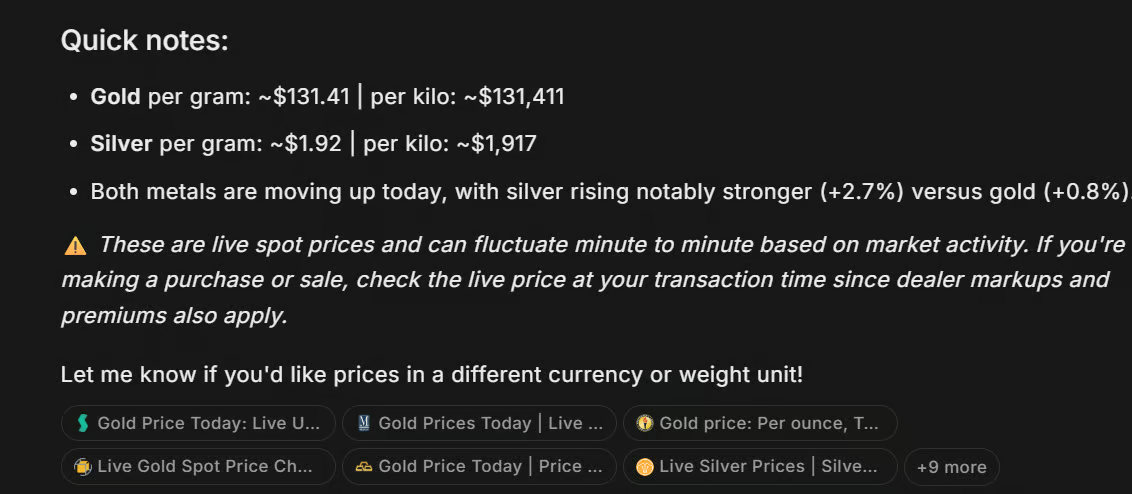
También puedes activar la herramienta de búsqueda web de Studio y pedir al modelo que consulte información actual, como los precios más recientes del oro y la plata. Es una forma útil de confirmar que el modelo puede llamar a herramientas externas y no depende solo de su conocimiento interno.
En la Terminal 2, comprueba cómo se reparte el modelo entre las GPU:
nvidia-smi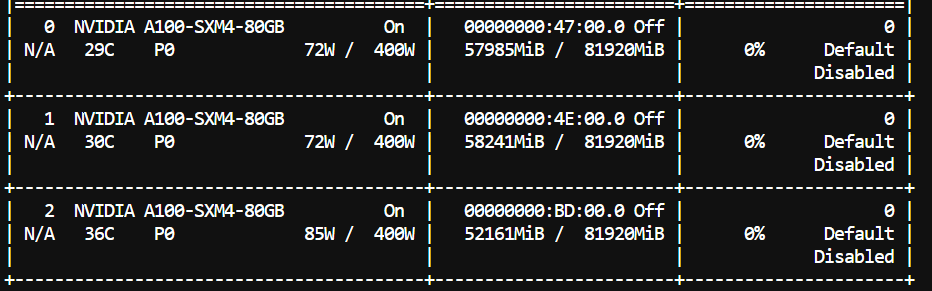
Deberías ver un uso de memoria elevado en las tres GPU.
En nuestra prueba, cada GPU estaba en torno al 70% de su capacidad. Sin embargo, esto no significa necesariamente que el modelo Q8 completo quepa holgadamente en solo dos GPU de 80 GB, porque aún se necesita VRAM adicional para la ventana de contexto, la caché KV y los búferes de inferencia.
Por último, prueba el modelo con el prompt de planificación de la aplicación que construiremos:
Create a concise architecture plan for an interactive stock analytics website
using Next.js, financial charts, technical indicators, portfolio tracking,
and responsive animations.
El modelo devuelve un plan de desarrollo estructurado que cubre la arquitectura de la aplicación, componentes, flujo de datos, librerías de gráficos, cálculos financieros y diseño de la interfaz.
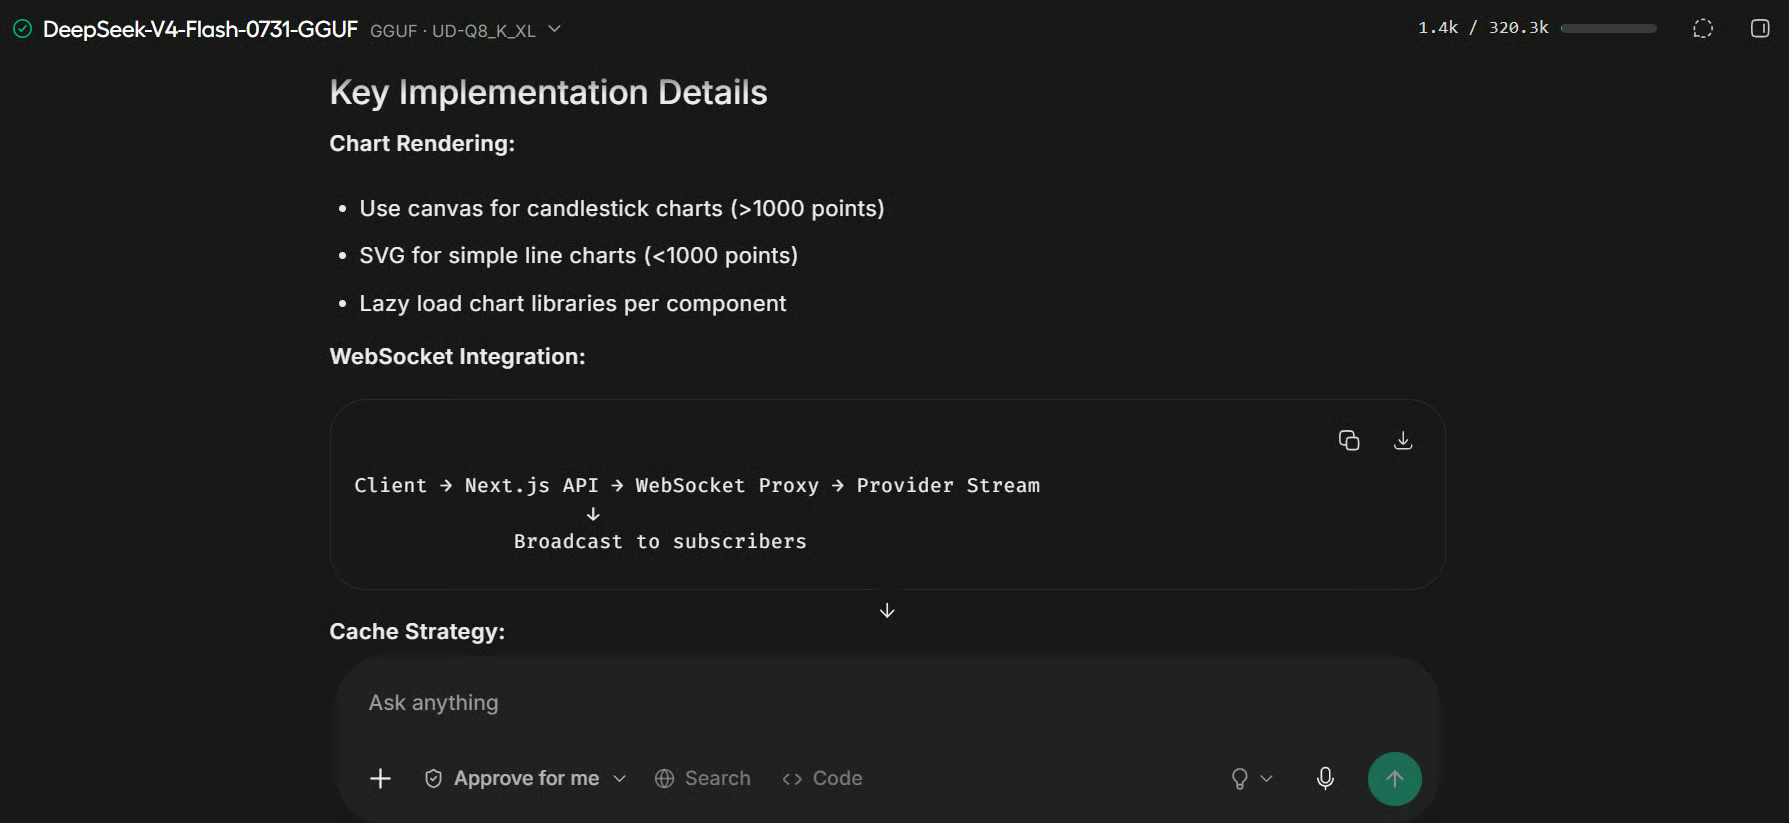
Con el modelo ejecutándose en Unsloth Studio, podemos conectarlo a OpenCode y usarlo como agente de programación local.
En la Terminal 3, establece la URL de Studio:
echo 'export UNSLOTH_STUDIO_URL="http://127.0.0.1:8910"' >> ~/.bashrc
source ~/.bashrc
Crea un nuevo directorio de proyecto:
mkdir -p /workspace/market-pulse
cd /workspace/market-pulse
Inicia OpenCode a través de Unsloth Studio:
unsloth start opencodeLa primera vez que ejecutes este comando te pedirá permiso para instalar OpenCode. Introduce «y».
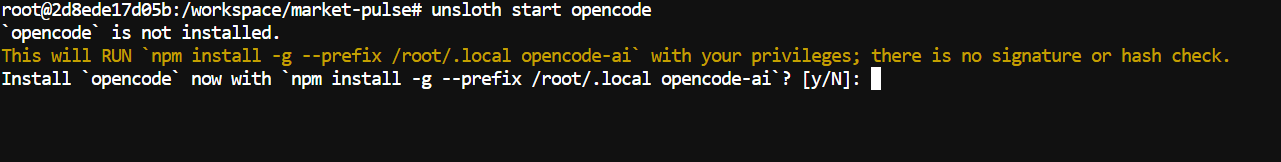
Una vez completada la instalación, OpenCode se iniciará con el modelo DeepSeek-V4-Flash-0731 en local ya configurado.
Pega el siguiente prompt de dos líneas en OpenCode:
Build a polished, highly interactive stock analytics website using Bun, Next.js App Router,
TypeScript, shadcn/ui, Motion, TradingView Lightweight Charts, and a free financial-data API,
with live stock search, charts, technical indicators, gains, losses, watchlists, portfolio tracking,
comparisons, responsive design, animations, loading states, and error handling.

Work autonomously: install everything, create every file, test and fix the complete application,
and run the finished website on 0.0.0.0:9101.
En pocos segundos, el agente de código debería crear una lista detallada de tareas y empezar a trabajar en el proyecto paso a paso.
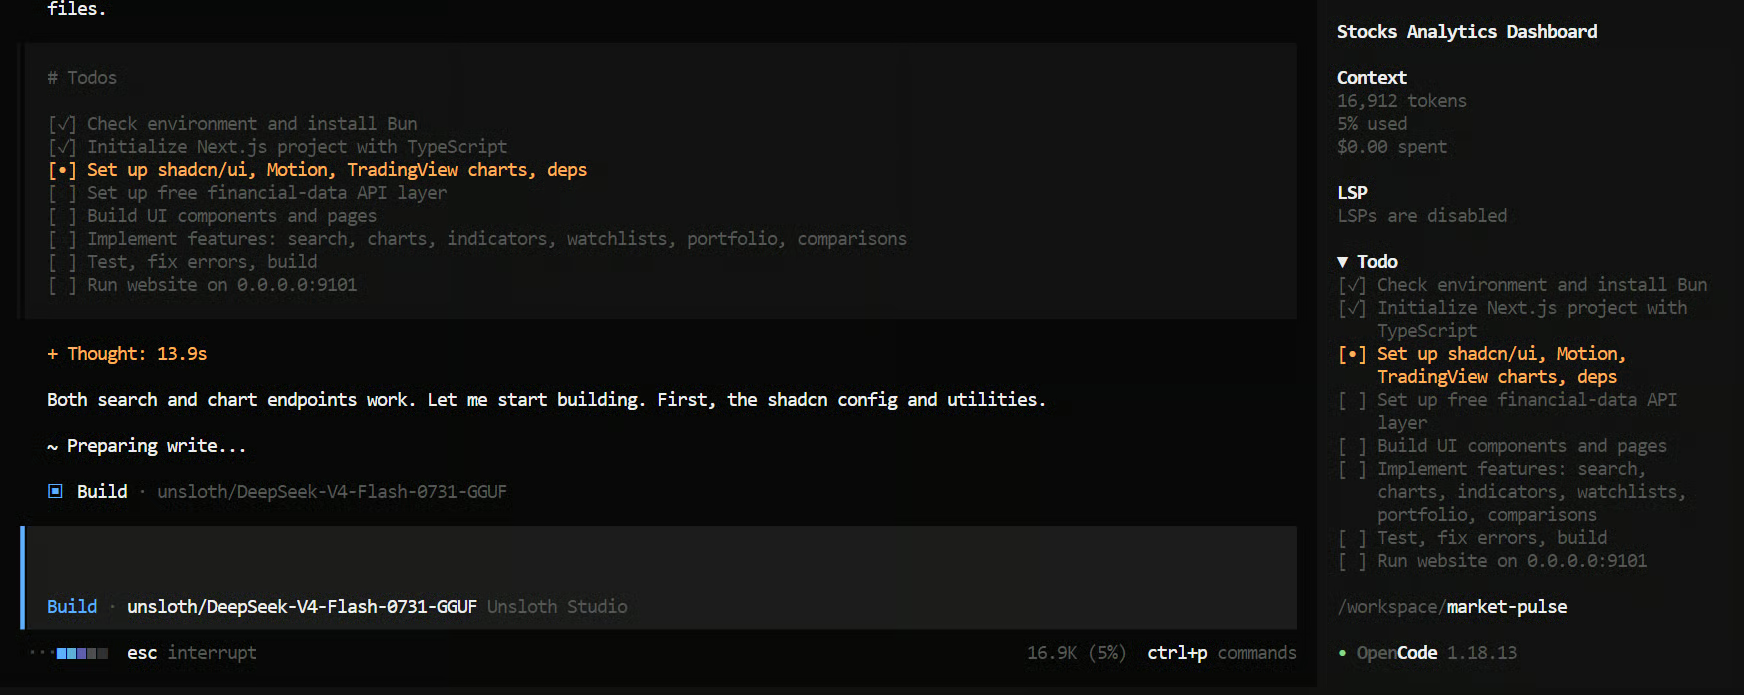
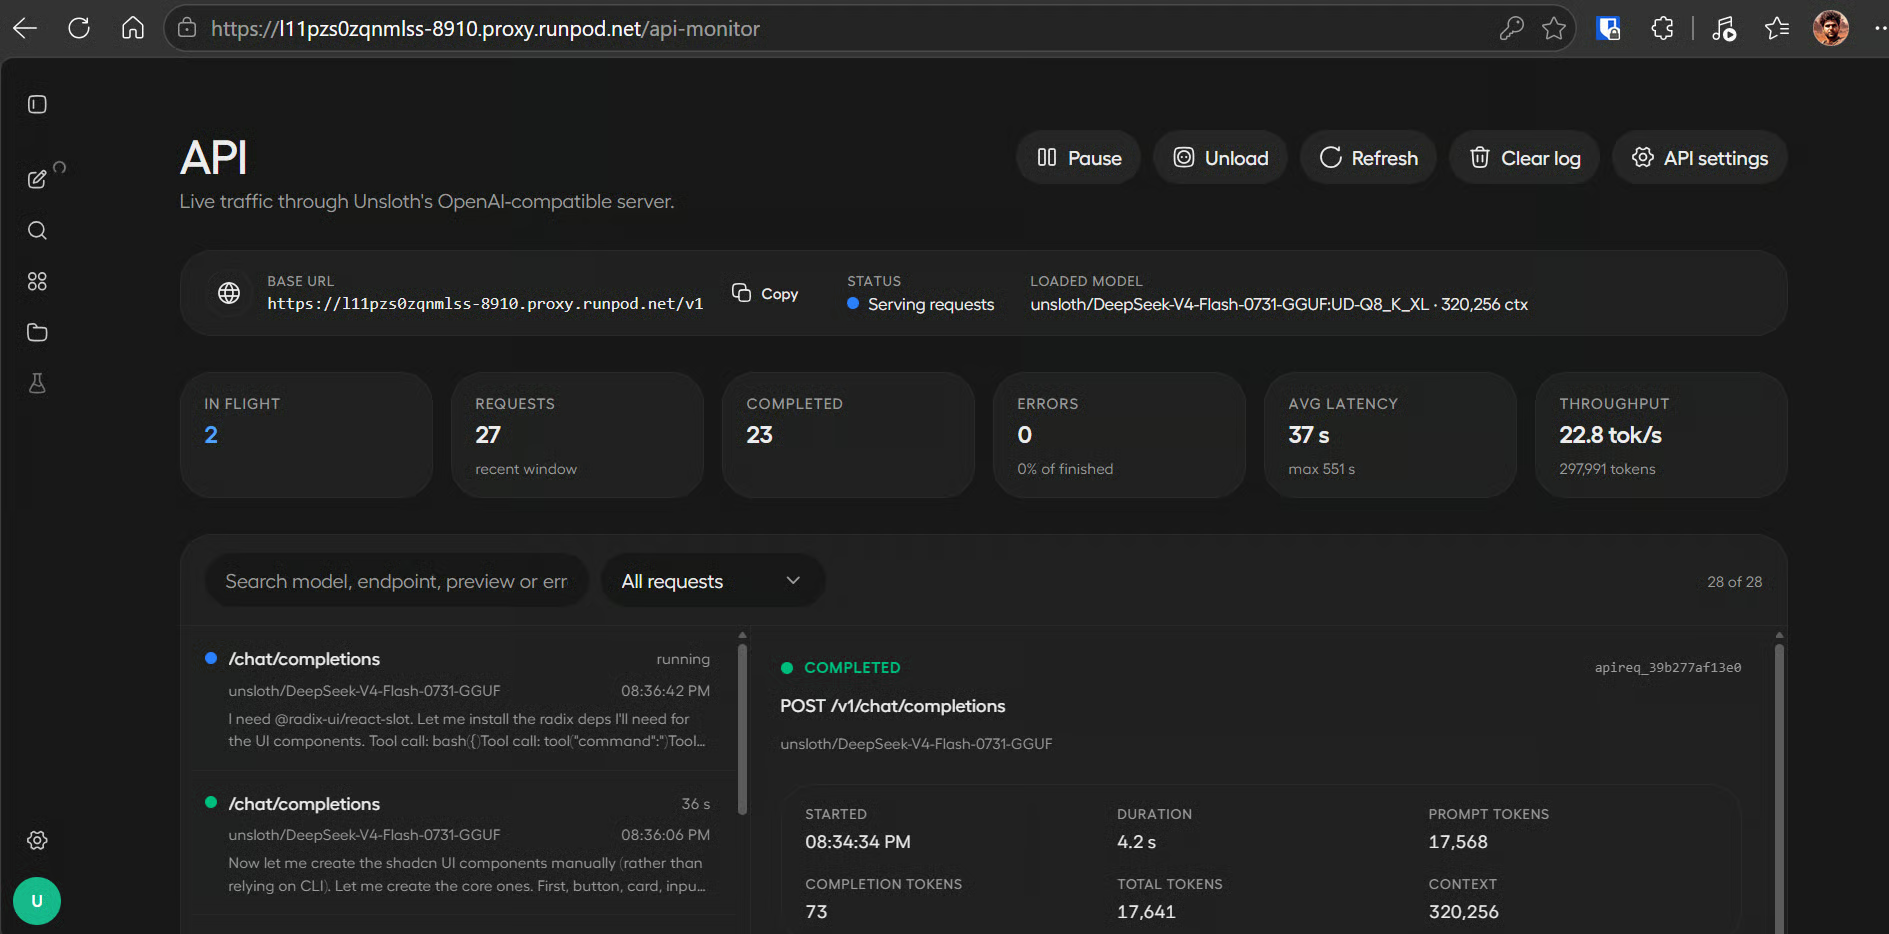
La construcción completa nos llevó unos 20 minutos en la prueba. Mientras se ejecuta, puedes volver a Unsloth Studio y abrir la página de monitorización de la API en Settings para seguir el uso del modelo y la velocidad de generación.
Observamos una media de aproximadamente 22,6 tokens por segundo durante el flujo de programación. La velocidad puede bajar a medida que crecen la conversación y el contexto del proyecto.
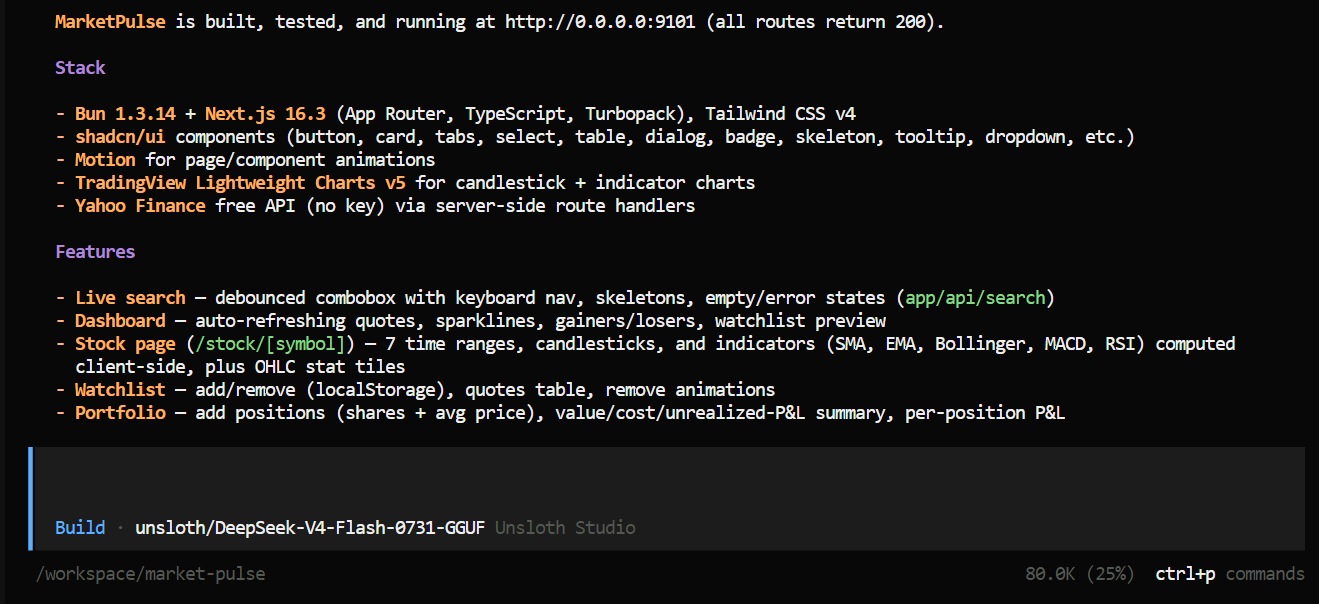
Al finalizar las tareas, OpenCode debería mostrar un resumen de los archivos, funcionalidades y comandos creados. También debería iniciar la web finalizada en el puerto 9101.
Vuelve a la página Connect de RunPod y abre el servicio HTTP del puerto 9101.
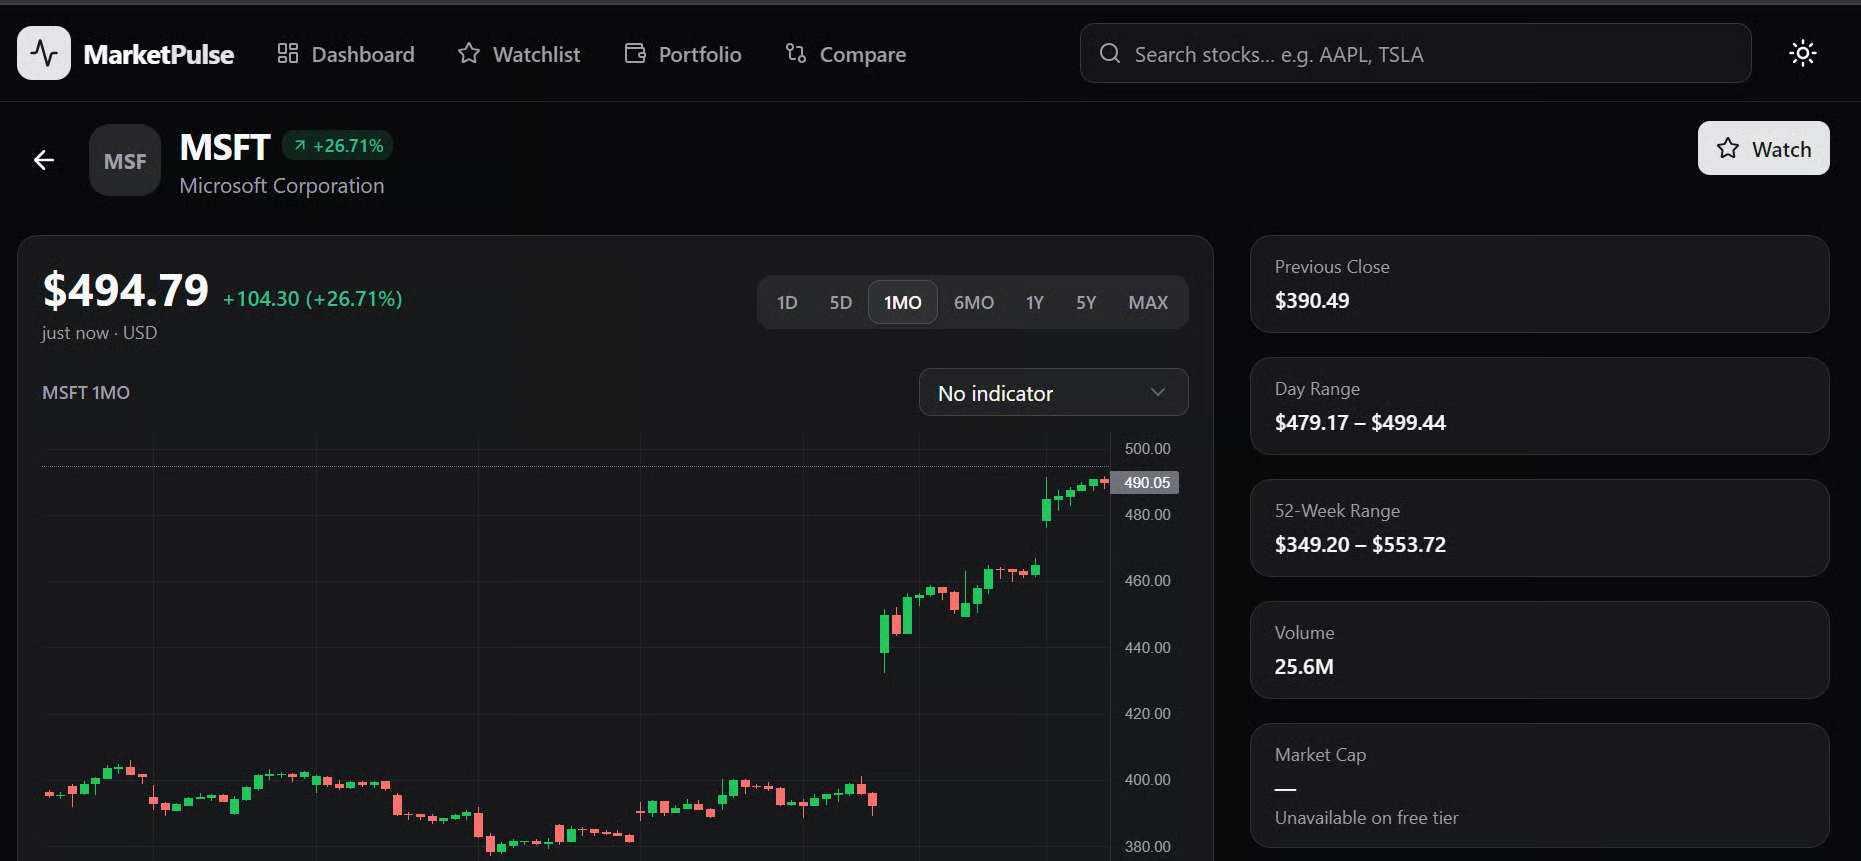
El resultado fue sorprendentemente pulido. La web se veía limpia, con animaciones, y recordaba a un panel profesional de trading. El modelo completó la aplicación web con un único prompt, incluyendo interfaz, vistas de datos, gráficos y navegación.
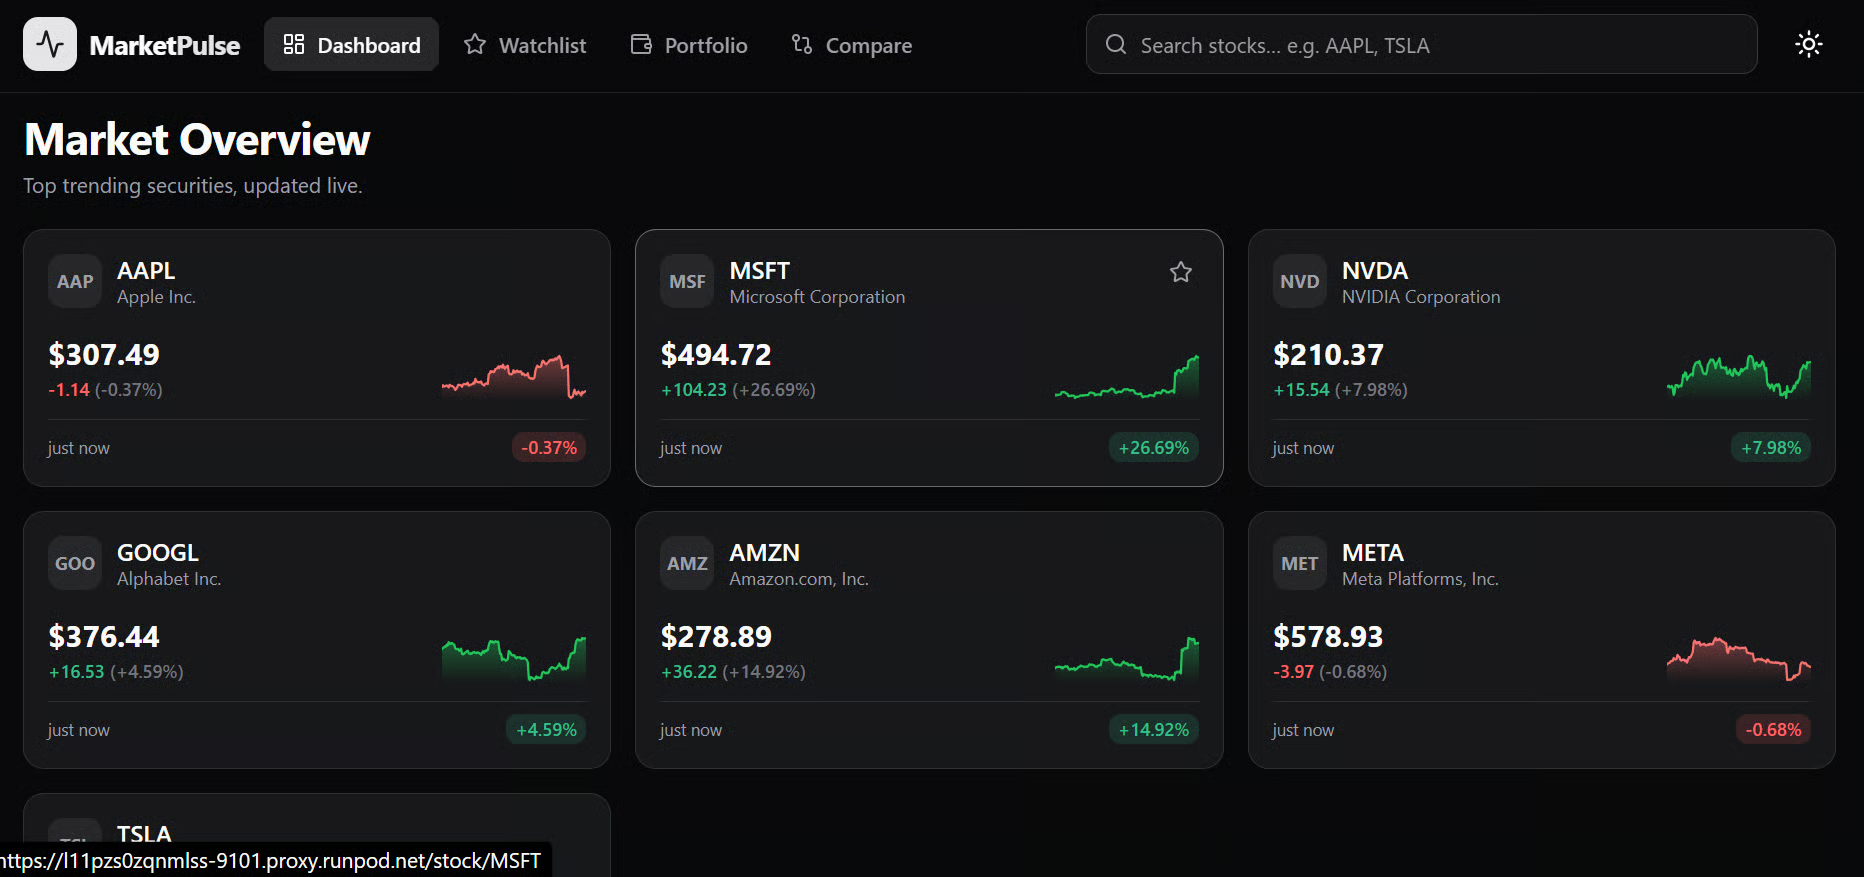
Puedes seleccionar valores individuales para ver gráficos de velas, rendimiento histórico, indicadores e información adicional de la compañía.
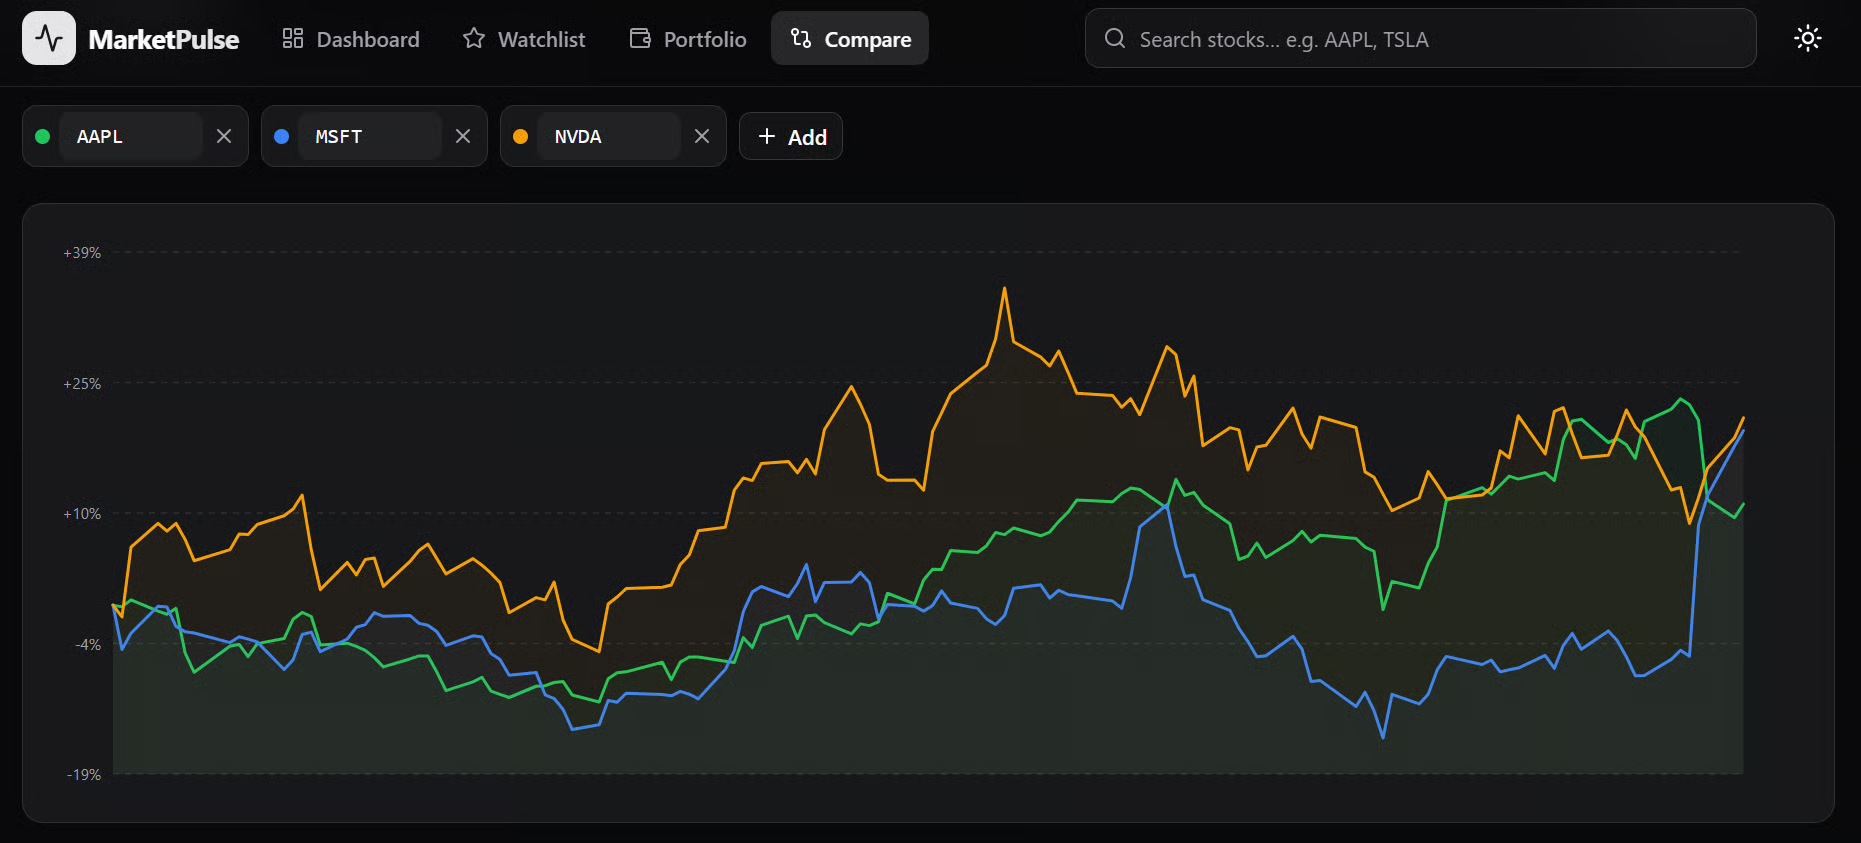
La pestaña Compare también permite comparar varios valores y ver cuál lo ha hecho mejor en el periodo seleccionado.
Me sorprendió de verdad que un modelo local más pequeño pudiera construir toda la web a partir de un único prompt.
Tras probar la aplicación, todas las funciones principales funcionaron como se esperaba, incluidos los precios en tiempo real, los datos históricos del mercado, los gráficos, los indicadores y las herramientas de comparación.
Es impresionante lo rápido que están mejorando los modelos locales y lo capaces que se han vuelto para completar tareas complejas de desarrollo de extremo a extremo.
Para mí, DeepSeek-V4-Flash-0731 es el mejor modelo local que he probado hasta ahora.
Rindió mejor que Inkling, la cuantización de 2 bits de GLM-5.2 y Qwen3.6-27B, que hasta entonces había sido mi favorito. Se basa en mi experiencia y no en un benchmark formal, pero ahora es mi modelo local preferido.
Para la mayoría de cargas de trabajo prácticas, seguiría empezando con la API oficial de DeepSeek porque es muy asequible.
V4 Flash cuesta actualmente 0,14 $ por millón de tokens de entrada no almacenados en caché, 0,0028 $ por millón de tokens de entrada en caché y 0,28 $ por millón de tokens de salida. A ese precio, mil millones de tokens de entrada en caché costarían unos 2,80 $ antes de los cargos por salida.
Antes de decantarme por Unsloth Studio, probé a ejecutar el modelo con llama.cpp. El instalador precompilado no ofrecía un binario reciente de CUDA adecuado para mi entorno y, aunque compilé la última versión desde el código fuente, me encontré con más problemas al activar la decodificación especulativa DSpark.
Unsloth Studio terminó siendo la opción más sencilla, eliminando la mayor parte de la configuración manual. Funcionó bien con OpenCode, aunque construir la aplicación completa llevó unos 20 minutos.
Los mejores cursos de DataCamp
Curso
Curso
programa
blog
Abid Ali Awan
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
15 min
Tutorial
Zoumana Keita
12 min