
Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.5K
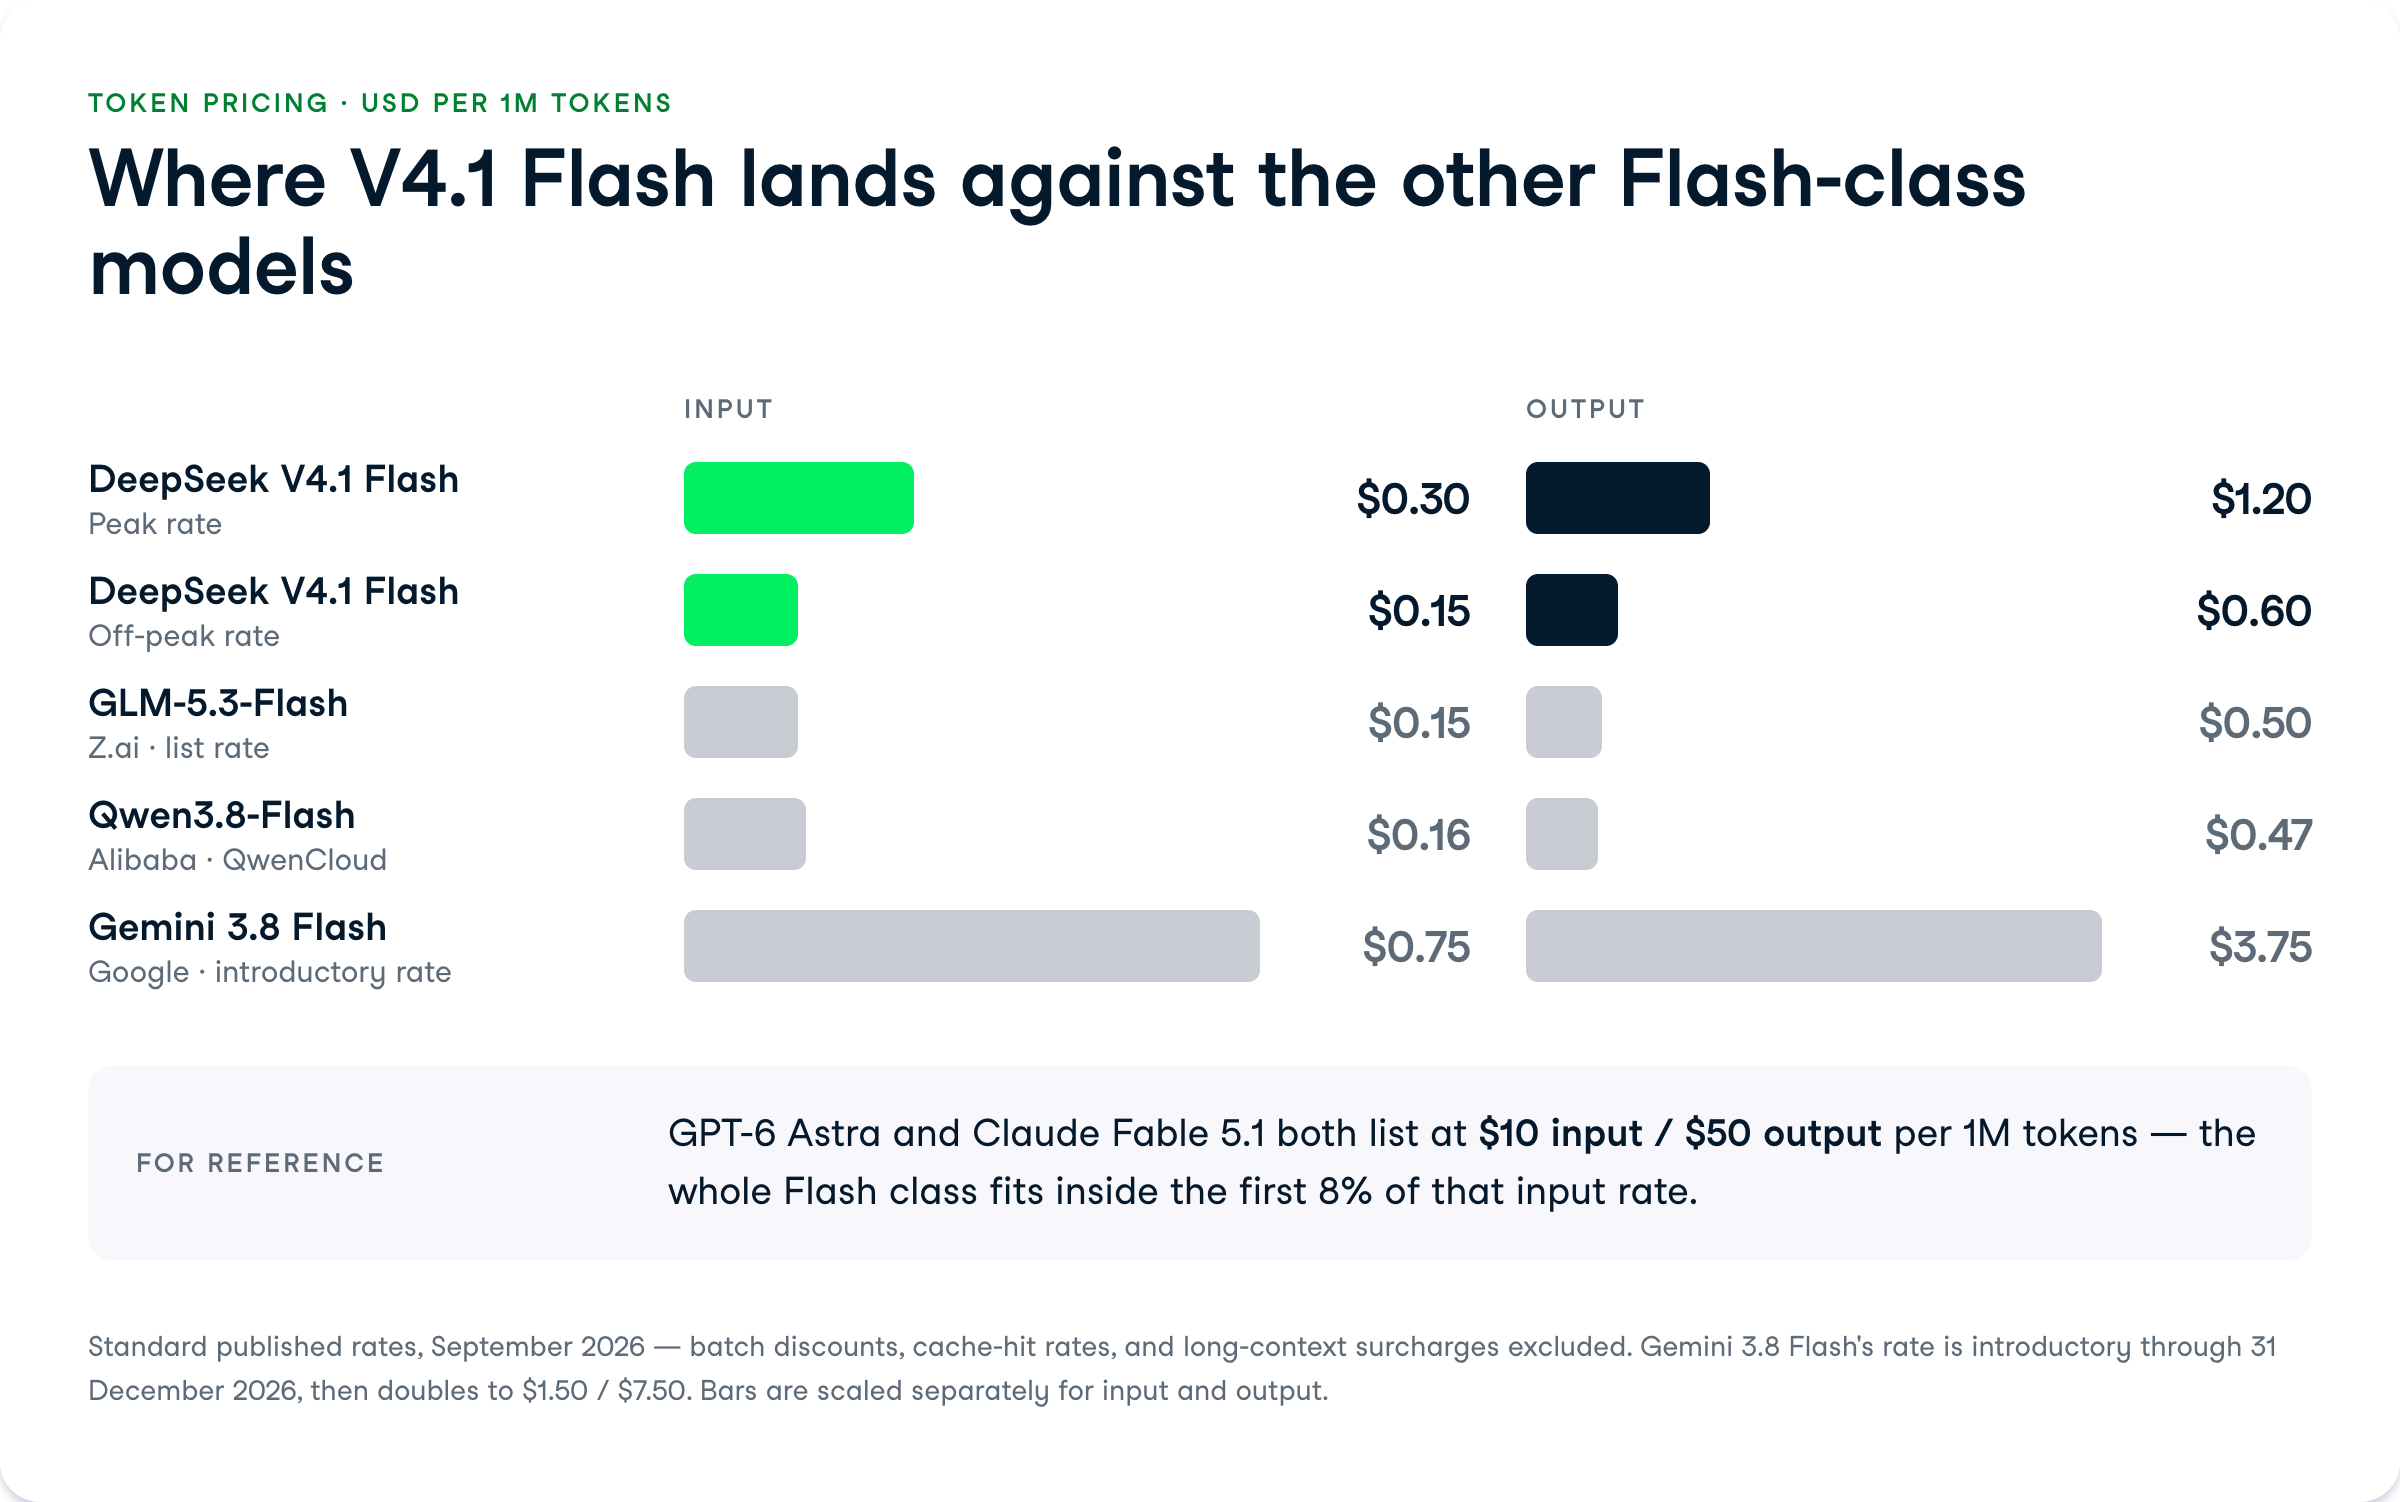
La carrera por los modelos punteros a finales de 2026 se ha convertido, sobre todo, en una guerra de precios más que de capacidad pura. Solo en septiembre hemos visto a GPT-6 Astra de OpenAI y Claude Fable 5.1 de Anthropic situarse en $10 por 1M de tokens de entrada y $50 por 1M de tokens de salida, sin disponibilidad en planes gratuitos.
La respuesta de DeepSeek va en la dirección contraria.
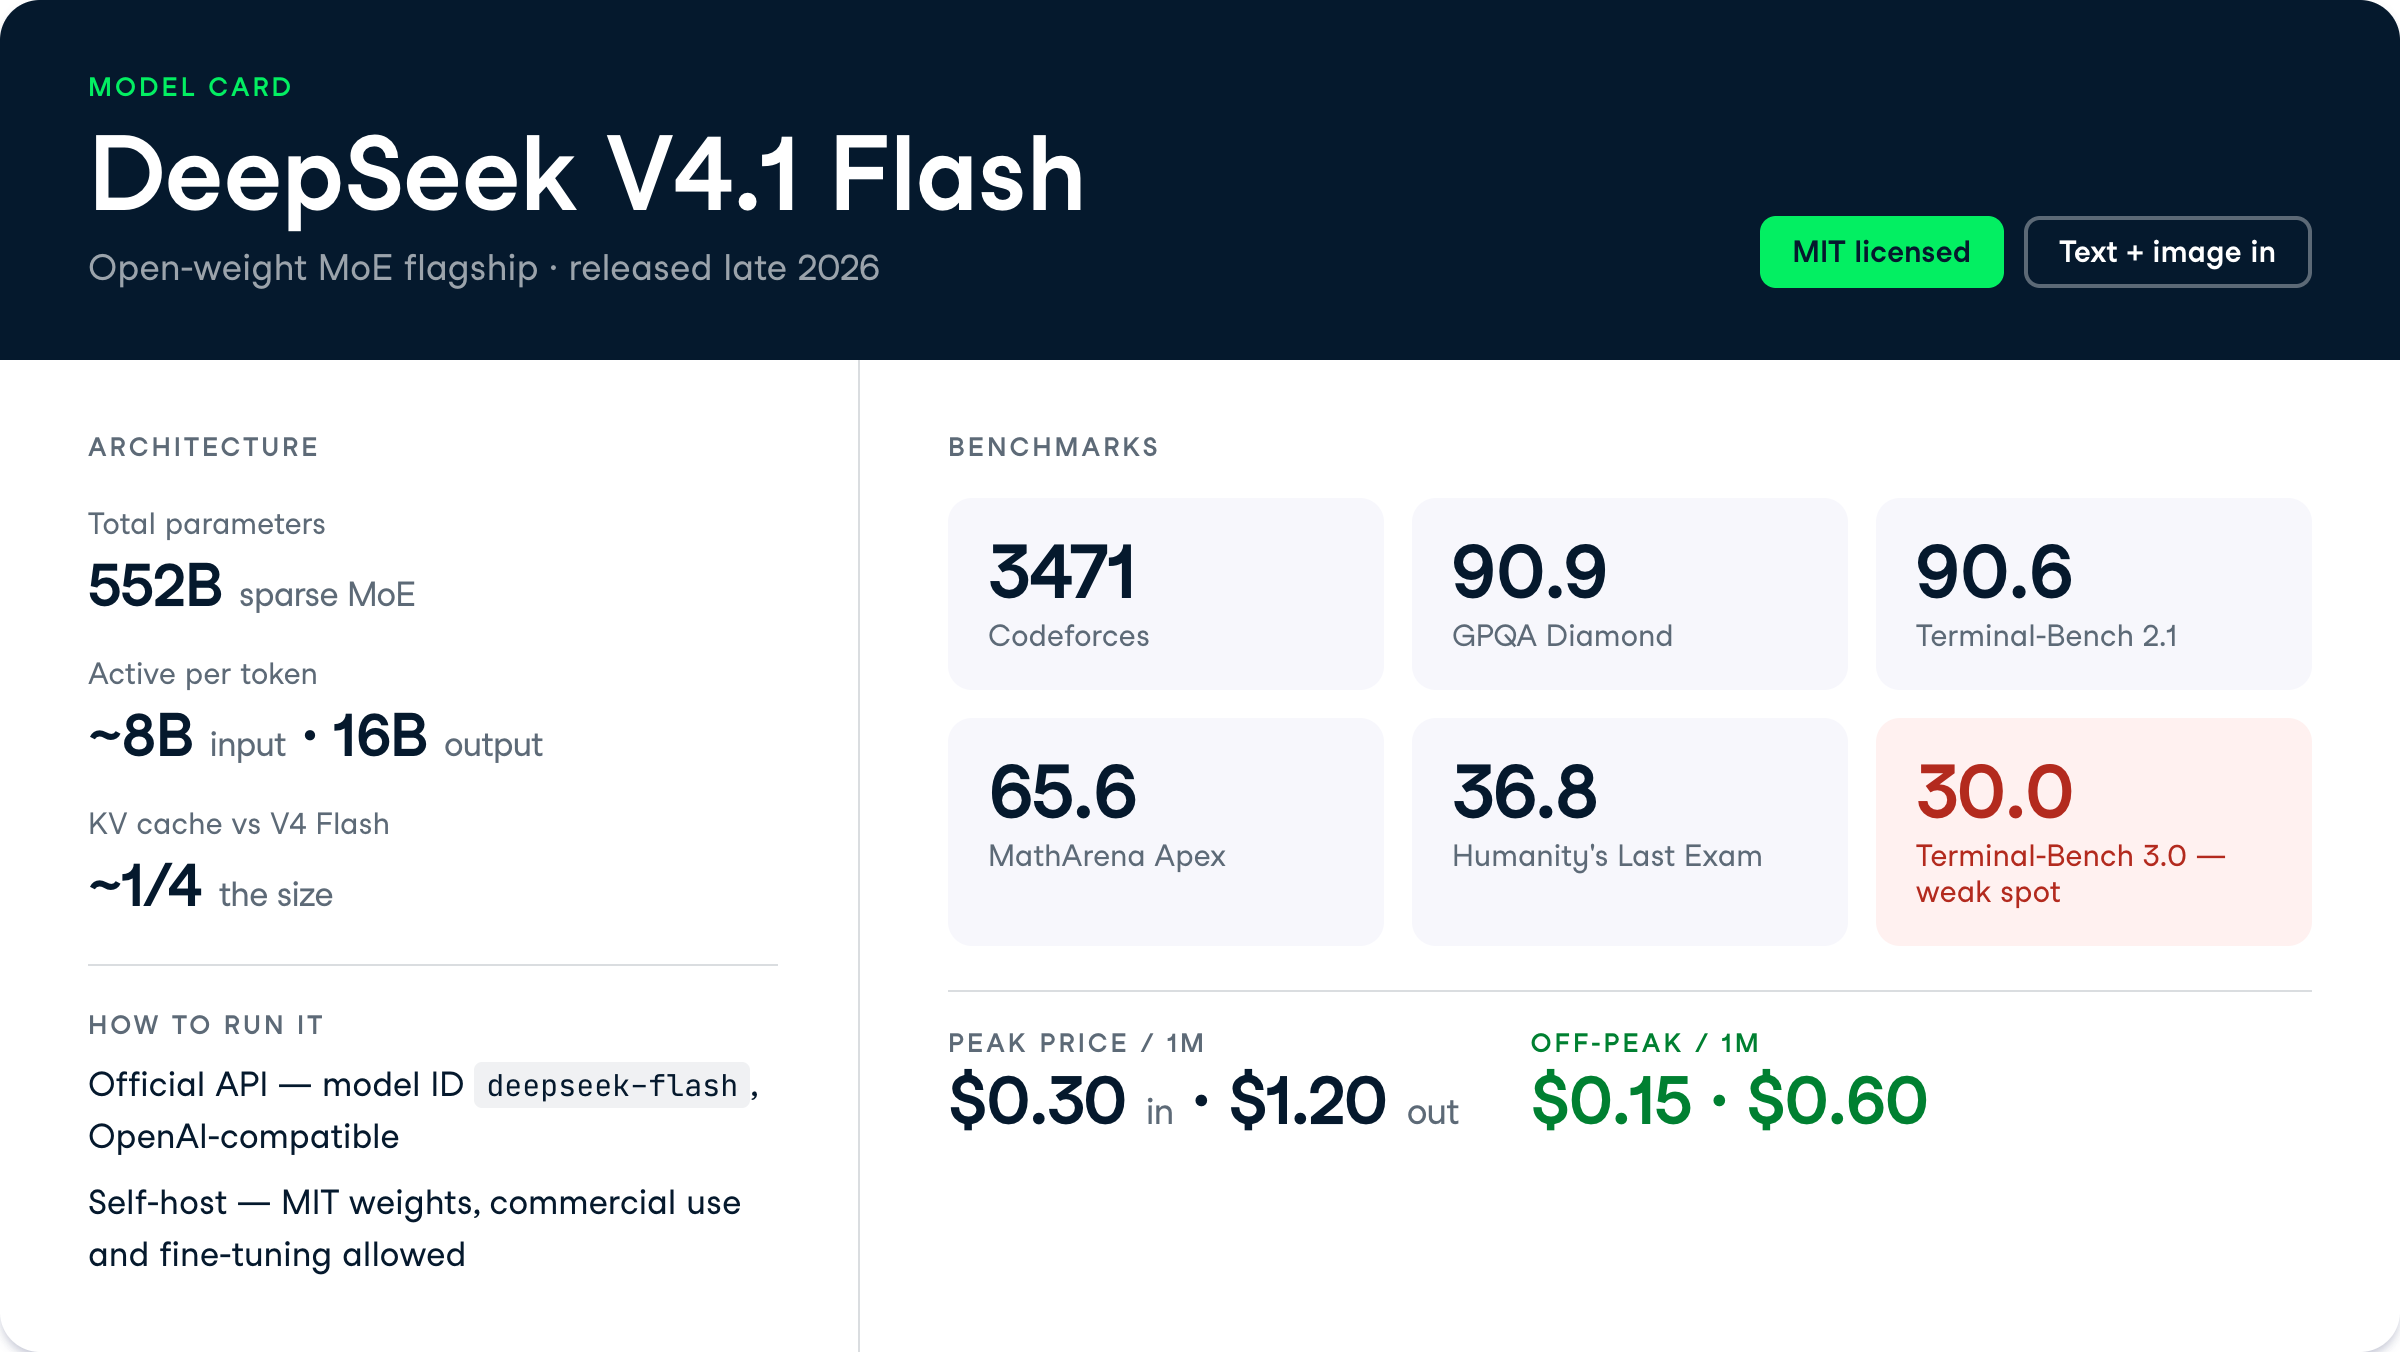
DeepSeek V4.1 Flash es un modelo mixture-of-experts de 552B parámetros que activa aproximadamente 8B para la entrada y 16B para la salida, ofrece pesos abiertos con licencia MIT y cuesta $0.30/$1.20 por 1M de tokens en horas punta, bajando a $0.15/$0.60 fuera de punta, superando a otros modelos Flash similares como Gemini 3.8 Flash y GLM-5.3-Flash.
En este artículo, cubro todo lo nuevo de DeepSeek V4.1 Flash, repasando sus funciones y analizando los benchmarks. Si quieres ver el modelo en acción, lee nuestro tutorial del API de DeepSeek V4.1.
Para saber más sobre la familia DeepSeek, consulta nuestra guía para ejecutar DeepSeek-V4-Flash-0731 con Unsloth Studio y OpenCode, y nuestra comparativa de DeepSeek v4.1 Flash vs Gemini 3.8 Flash.
DeepSeek V4.1 Flash es el modelo más reciente de la línea Flash de DeepSeek, pensado como una capa eficiente y de alto rendimiento en lugar de un modelo de investigación de gran tamaño.
Utiliza una arquitectura MoE dispersa con 552B parámetros totales, de los que solo unos 8B se activan por token en entrada y 16B en salida. Esa activación dispersa mantiene bajos los costes de inferencia a la vez que alcanza puntuaciones de primer nivel en varios benchmarks.
El cambio principal frente a la generación anterior es la eficiencia.
DeepSeek redujo la caché KV a aproximadamente una cuarta parte del tamaño del anterior V4 Flash, lo que reduce la huella de memoria y permite servir contextos más largos a menor coste. La compañía también afirma que V4.1 Flash supera al antiguo V4 Pro 0813 en rendimiento, coste, velocidad y tiempo total, por lo que V4 Pro se está retirando.
En benchmarks, el número que destaca es 90.6 en Terminal-Bench 2.1. Cuando probamos el anterior DeepSeek-V4-Flash-0731, obtuvo 82.7 en el mismo benchmark, así que V4.1 Flash supone un salto real en trabajo agentico en terminal dentro de la misma familia.
El conjunto de funciones de V4.1 Flash se basa en dos ideas: costes bajos y apertura. Estas son las capacidades que más importan a un data scientist o ML engineer en activo.
V4.1 Flash se distribuye con pesos bajo licencia MIT, la licencia permisiva más común, que permite uso comercial, redistribución y fine-tuning sin umbrales de ingresos.
Para equipos con restricciones de privacidad de datos, esto significa que puedes ejecutar el modelo íntegramente en tu propio hardware en lugar de enviar peticiones al API de DeepSeek.
La contrapartida es que la licencia MIT traslada a ti la responsabilidad de la seguridad, el fine-tuning y la optimización de inferencia.
Cuando ejecutamos localmente el anterior V4-Flash-0731, necesitó tres GPUs NVIDIA A100 de 80GB con cuantización Q8, así que el autoalojamiento solo es viable si cuentas con memoria de GPU de verdad.
V4.1 Flash acepta imágenes directamente como entrada, sin adaptador de visión ni un paso de preprocesado aparte. Esto te permite enviar capturas de pantalla, gráficos o escaneos de documentos en la misma petición junto al texto, útil para flujos con muchos documentos y agentes de UI.
La entrada multimodal nativa a este precio es poco común. En la evaluación ZeroBench-main con herramientas, V4.1 Flash obtiene 49.0, lo que da una idea de cómo razona sobre entradas visuales.
La caché KV de V4.1 Flash es aproximadamente una cuarta parte de la del anterior V4 Flash, lo que reduce el coste de memoria de mantener contextos largos en una sesión de servicio.
Para quienes ejecutan inferencia continua, una caché KV más pequeña significa más sesiones concurrentes por GPU o menor sobrecarga de memoria por petición.
Combinado con la entrada con acierto de caché a $0.006 por 1M de tokens en punta, esto hace que la reutilización de contexto sea baratísima. Si envías repetidamente el mismo prompt del sistema o el mismo documento, la parte cacheada cuesta casi nada.
DeepSeek aplica un esquema de dos niveles en el que los precios fuera de punta son la mitad que en punta, con la intención de desplazar cargas por lotes y programadas a ventanas fuera de punta. Eso convierte $0.30/$1.20 en $0.15/$0.60 por 1M de tokens si puedes programar tus trabajos.
La pega es operativa. Las cargas siempre activas son más difíciles de predecir en coste, y capturar el descuento exige lógica de planificación que tienes que construir y mantener.
V4.1 Flash destaca en benchmarks de agentes y razonamiento, donde alcanza puntuaciones cercanas a la frontera a una fracción del coste por token.
Sus resultados caen con fuerza en las evaluaciones agenticas más duras, algo a tener en cuenta antes de asignarle tareas de largo recorrido.
V4.1 Flash logra 90.6 en Terminal-Bench 2.1, que mide cómo completa un modelo tareas multi‑paso en un entorno de terminal.
A modo de escala, DeepSeek-V4-Flash-0731 obtuvo 82.7 en el mismo benchmark en nuestras pruebas, y GPT-5.6 Terra alcanzó 87.4 en nuestra comparativa Terra vs. Sonnet 5.
La foto cambia en evaluaciones agenticas más exigentes.
V4.1 Flash baja a 30.0 en Terminal-Bench 3.0, así que el modelo resuelve bien tareas estándar en terminal pero sufre con la batería de pruebas más difícil. Su rating de Codeforces de 3471 señala una fuerte capacidad en programación competitiva.
En GPQA Diamond, un conjunto de preguntas de ciencias a nivel de posgrado diseñadas para que no se puedan responder solo de memoria, V4.1 Flash obtiene 90.9.
Es un gran resultado para un modelo en este rango de precio y lo pone a la altura de modelos punteros mucho más caros.
En Humanity's Last Exam (HLE), un benchmark deliberadamente duro a nivel experto, V4.1 Flash marca 36.8, o 39.1 con la configuración con asterisco.
Por comparación, evaluaciones agenticas de ciencia como Terminal-Bench-Science 0.1 sitúan a Claude Fable 5.1 en 52.6% frente a rivales más duros, así que V4.1 Flash no encabeza las pruebas más exigentes, pero tampoco desentona.
V4.1 Flash logra 65.6 en MathArena Apex, un benchmark de matemáticas de competición que premia el razonamiento simbólico multi‑paso.
Es uno de los mejores resultados del modelo y sugiere que es una opción sólida para cargas cuantitativas y con mucha matemática.
Una puntuación en la franja de 60 y pico importa para quien construye herramientas que requieren aritmética y álgebra fiables, ya que muchos modelos baratos fallan justo en estas tareas.
La decisión aquí depende menos de variantes de modelo y más de cómo despliegas V4.1 Flash, ya que los mismos pesos se ejecutan de tres formas. Tu elección se reduce a la previsibilidad de costes, la privacidad de datos y si puedes programar trabajos.
DeepSeek también está en periodo de migración. Desde las 12:00 hora de Pekín del 14 de septiembre de 2026, y hasta el lanzamiento de V4.1 Pro, las peticiones a endpoints heredados se redirigen, lo que empuja a los usuarios existentes hacia la familia V4.1. Si sigues en V4 Pro 0813, ese modelo se está retirando, así que planifica ya el paso a V4.1 Flash.
| Uso | Ruta recomendada | Por qué |
|---|---|---|
| Agente de código de alto volumen y siempre activo | API oficial, precio en punta | $0.30/$1.20 por 1M ya está muy por debajo de los rivales punteros; sin sobrecarga de planificación |
| Trabajos grandes por lotes de razonamiento o matemáticas | API oficial, fuera de punta | Fuera de punta reduce la tarifa a $0.15/$0.60 por 1M si puedes programar la ejecución |
| Datos sensibles o propietarios | Autoalojar pesos MIT | Mantiene la inferencia en tu propio hardware; requiere memoria de GPU real |
| Reutilización intensiva de contexto | API con caché de prompts | La entrada con acierto de caché a $0.006 por 1M hace que el contexto repetido sea casi gratis |
V4.1 Flash es uno de los modelos capaces más baratos disponibles, especialmente fuera de punta. Así se desglosan los precios por token.
| Tarifa | Punta | Fuera de punta |
|---|---|---|
| Entrada por 1M de tokens | $0.30 | $0.15 |
| Salida por 1M de tokens | $1.20 | $0.60 |
| Entrada con acierto de caché por 1M de tokens | $0.006 | No publicado |
Los precios fuera de punta se fijan en la mitad de los de punta, y el esquema busca desplazar las cargas por lotes y programadas a las ventanas fuera de punta.
Para poner la tarifa en punta en contexto, GPT-6 Astra y Claude Fable 5.1 cobran $10 por 1M de entrada y $50 por 1M de salida, así que V4.1 Flash es unas 30 veces más barato en entrada y 40 veces más barato en salida en punta.
El modelo que se retira, V4 Pro 0813, tiene un precio de $0.435 por 1M de entrada y $0.87 por 1M de salida con un contexto de 1M de tokens.
Como DeepSeek afirma que V4.1 Flash supera a V4 Pro en rendimiento, coste y velocidad, hay pocas razones para quedarse en el modelo anterior.
V4.1 Flash está disponible a través del API oficial de DeepSeek, y sus pesos con licencia MIT se publican para autoalojamiento.
Desde el 14 de septiembre de 2026, las peticiones a endpoints heredados se redirigen hacia la familia V4.1 hasta que se lance V4.1 Pro.
V4.1 Flash es a la vez un modelo de API y una versión con pesos abiertos, así que puedes llegar a él de dos formas.
En el API, el ID del modelo suele figurar como deepseek-flash, y el endpoint es compatible con OpenAI, lo que significa que la mayoría del código cliente de OpenAI funciona cambiando la URL base.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Para autoalojar, la licencia MIT de los pesos permite uso comercial, redistribución y fine-tuning sin umbrales de ingresos.
Cuando ejecutamos localmente el anterior V4-Flash-0731 con Unsloth Studio, necesitó tres GPUs NVIDIA A100 de 80GB con cuantización Q8, así que reserva hardware similar para la configuración a plena precisión.
Para una guía local completa, consulta nuestro tutorial sobre ejecutar DeepSeek-V4-Flash con Unsloth Studio y OpenCode, que cubre en detalle la distribución en GPU y la configuración de la inferencia.
V4.1 Flash es la declaración de DeepSeek sobre precio y apertura, mientras el resto de la frontera escala hacia $10/$50 por 1M de tokens y cierra el acceso tras planes de pago.
Un modelo MoE de 552B con pesos MIT, entrada nativa de imágenes, 90.9 en GPQA Diamond y un precio en punta 30 veces por debajo de GPT-6 Astra es una propuesta seria para cargas de trabajo a gran escala.
Yo me pasaría a él para agentes de código y trabajos de razonamiento por lotes, especialmente si puedes programar fuera de punta.
Los puntos negativos aparecen al ver la puntuación de 30.0 en Terminal-Bench 3.0, que muestra que tambalea en las tareas agenticas más duras, y la facturación punta/fuera de punta añade un trabajo de planificación que te toca asumir.
Si quieres construir flujos con agentes alrededor de modelos como este, nuestro itinerario de aprendizaje AI Agent Fundamentals es un buen punto de partida.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Bhavishya Pandit
7 min
blog
blog
Abid Ali Awan
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Moez Ali
11 min





