Curso
Web scraping en Python
4 h
94.1K
Si quieres una introducción al web scraping en Python, haz el curso de DataCamp Web Scraping with Python.
En este tutorial aprenderás a usar Scrapy, un framework de Python con el que podrás manejar grandes volúmenes de datos. Aprenderás Scrapy creando un scraper para AliExpress.com, un sitio de comercio electrónico. ¡Manos a la obra!
Tener nociones básicas de HTML y CSS te ayudará a seguir este tutorial con más facilidad y rapidez. Revisa este artículo para refrescar HTML y CSS.
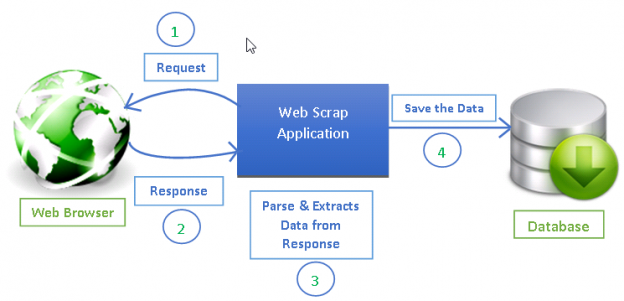
El web scraping se ha convertido en una forma eficaz de extraer información de la web para tomar decisiones y analizar datos. Es una parte esencial del kit de herramientas de la ciencia de datos. Quienes trabajan con datos deberían saber cómo recopilar datos de páginas web y almacenarlos en distintos formatos para su análisis posterior.
Cualquier página que ves en internet puede rastrearse para extraer información y todo lo que es visible en una página web se puede extraer [2]. Cada página tiene su propia estructura y elementos, por lo que tienes que escribir tus crawlers o spiders en función de la página que quieras extraer.
Scrapy ofrece un framework potente para extraer datos, procesarlos y guardarlos.
Scrapy usa spiders, que son rastreadores autónomos a los que se les da un conjunto de instrucciones [1]. Con Scrapy es más fácil crear y escalar proyectos de crawling grandes, ya que permite a los desarrolladores reutilizar su código.
En esta sección verás una visión general de una de las herramientas de scraping más populares, BeautifulSoup, y su comparación con Scrapy.
Scrapy es un framework de Python para web scraping que ofrece un paquete completo para desarrolladores sin tener que preocuparse por el mantenimiento del código.
Beautiful Soup también se usa ampliamente para scraping. Es un paquete de Python para analizar documentos HTML y XML y extraer datos de ellos. Está disponible para Python 2.6+ y Python 3.
Estas son algunas diferencias, en pocas palabras:
| Scrapy | BeautifulSoup |
|---|---|
| Funcionalidad | --- |
| Scrapy es el paquete completo para descargar páginas, procesarlas y guardarlas en ficheros y bases de datos | BeautifulSoup es básicamente un parser de HTML y XML y necesita librerías adicionales como requests, urlib2 para abrir URLs y almacenar el resultado [6] |
| Curva de aprendizaje | --- |
| Scrapy es una bestia para el scraping y ofrece muchas formas de extraer una página. Requiere más tiempo para aprender cómo funciona, pero una vez dominado, facilita crear crawlers y ejecutarlos con un solo comando. Llegar a ser experto en Scrapy puede llevar algo de práctica y tiempo para conocer todas sus funcionalidades. | BeautifulSoup es relativamente fácil de entender para quienes empiezan a programar y permite resolver tareas pequeñas muy rápido |
| Velocidad y carga | --- |
Scrapy resuelve trabajos grandes con mucha facilidad. Puede rastrear un conjunto de URLs en menos de un minuto, según el tamaño, y lo hace con fluidez porque usa Twister, que funciona de forma asíncrona (no bloqueante) para la concurrencia. |
BeautifulSoup se usa para trabajos sencillos de scraping con eficiencia. Es más lento que Scrapy si no usas multiprocessing. |
| Ampliación de funcionalidades | --- |
| Scrapy ofrece item pipelines que te permiten escribir funciones en tu spider para procesar datos: validar, limpiar y guardar en una base de datos. Proporciona spider contracts para probar tus spiders y te permite crear crawlers genéricos y de gran profundidad. También te deja gestionar muchas variables como reintentos, redirecciones, etc. | Si el proyecto no requiere mucha lógica, BeautifulSoup va bien, pero si necesitas mucha personalización como proxys, gestión de cookies y pipelines de datos, Scrapy es la mejor opción. |
Información: sincrónico significa que tienes que esperar a que termine una tarea para empezar otra; asíncrono significa que puedes pasar a otra antes de que acabe la anterior.
Aquí tienes un interesante tutorial de BeautifulSoup de DataCamp para aprender.

Con Python 3.0 (o superior) instalado, si usas Anaconda, puedes usar conda para instalar scrapy. Escribe el siguiente comando en el prompt de Anaconda:
conda install -c conda-forge scrapy
Para instalar Anaconda, consulta estos tutoriales de DataCamp para Mac y Windows.
Como alternativa, puedes usar el instalador de paquetes de Python, pip. Funciona en Linux, Mac y Windows:
pip install scrapy
Scrapy también ofrece una consola de rastreo web llamada Scrapy Shell, que los desarrolladores usan para probar sus hipótesis sobre el comportamiento de un sitio. Tomemos una página de tablets en el sitio de e-commerce AliExpress. Puedes usar la shell de Scrapy para ver qué componentes devuelve la página y cómo aprovecharlos según tus necesidades.
Abre la línea de comandos y escribe:
scrapy shell
Si usas Anaconda, también puedes ejecutar el comando en el prompt de Anaconda. Verás una salida similar a esta:

Tienes que ejecutar un crawler sobre la página con el comando fetch en la shell de Scrapy. Un crawler o spider recorre una página y descarga su texto y metadatos.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Nota: encierra siempre la URL entre comillas; funcionan tanto simples como dobles.

El crawler devuelve una response que puedes ver con el comando view(response) en la shell:
view(response)
Y la página se abrirá en el navegador predeterminado.

Puedes ver el HTML en bruto con este comando en la shell de Scrapy:
print(response.text)

Verás el script que genera la página. Es el mismo contenido que aparece cuando haces clic derecho en un área en blanco de una página y eliges ver código fuente. Como solo necesitas la información relevante del script, usando las herramientas de desarrollador del navegador inspeccionarás el elemento necesario. Tomemos estos elementos:
Haz clic derecho sobre el elemento que quieras y pulsa inspeccionar como abajo:

Las herramientas de desarrollador del navegador te serán de gran ayuda para el scraping. Puedes ver que es una etiqueta <a> con una class product y cuyo texto contiene el nombre del producto:

Puedes extraerlo usando los atributos del elemento o el selector CSS de sus clases. Escribe lo siguiente en la shell de Scrapy para extraer el nombre del producto:
response.css(".product::text").extract_first()
La salida será:

extract_first() extrae el primer elemento que cumple el selector CSS. Si quieres extraer todos los nombres de producto usa extract():
response.css(".product::text").extract()

El siguiente código extrae el rango de precios de los productos:
response.css(".value::text").extract()

De forma similar, puedes probar con el número de pedidos y el nombre de la tienda.
XPath es un lenguaje de consulta para seleccionar nodos en un documento XML [7]. Puedes navegar por un documento XML con XPath. Scrapy usa XPath por debajo para moverse por los elementos de un documento HTML. Los selectores CSS que usaste arriba también se convierten a XPath, aunque en muchos casos CSS es más sencillo. Aun así, conviene saber cómo funciona XPath en Scrapy.
Ve a tu Scrapy Shell y escribe fetch(https://pt.aliexpress.com/category/201005406/special-store.html/) igual que antes. Prueba estos fragmentos [3]:
response.xpath('/html').extract()
Esto mostrará todo el código bajo la etiqueta <html>. / significa hijo directo del nodo. Si quieres obtener las etiquetas <div> bajo la etiqueta html, escribirás [3]:
response.xpath('/html//div').extract()
En XPath debes entender el uso de / y // para navegar por nodos hijo y descendientes. Aquí tienes un tutorial útil sobre nodos XPath y algunos ejemplos para practicar.
Si quieres obtener todas las etiquetas <div>, puedes hacerlo yendo directamente sin usar /html [3]:
response.xpath("//div").extract()
Puedes filtrar aún más los nodos desde los que partes hasta llegar a los deseados usando atributos y sus valores. Abajo tienes la sintaxis para usar clases y sus valores.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Usa text() para extraer todo el texto dentro de los nodos
Considera el siguiente código HTML:

Quieres obtener el texto dentro de la etiqueta <a>, que es hija de un <div> con clases site-notice-container container; puedes hacerlo así:
response.xpath('//div[@class="site-notice-container container"]/a[@class="notice-close"]/text()').extract()

Puedes usar el scraping para crear un agregador con el que comparar datos. Por ejemplo, si quieres comprar una tablet y comparar productos y precios, puedes rastrear las páginas que te interesen y guardarlo en un Excel. Aquí vas a extraer información de aliexpress.com sobre tablets.
Ahora crearás un spider personalizado para esa misma página. Primero necesitas crear un proyecto de Scrapy donde se guardará tu código y resultados. Escribe este comando en la línea de comandos o en el prompt de Anaconda.
scrapy startproject aliexpress

Esto creará una carpeta en tu instalación predeterminada de Python o Anaconda. aliexpress será el nombre de la carpeta (puedes poner el que quieras). Puedes ver el contenido directamente desde el explorador. Esta es la estructura:

| archivo/carpeta | Propósito |
|---|---|
| scrapy.cfg | archivo de configuración de despliegue |
| aliexpress/ | módulo de Python del proyecto; desde aquí importarás tu código |
__init.py__ |
archivo de inicialización |
| items.py | archivo de items del proyecto |
| pipelines.py | archivo de pipelines del proyecto |
| settings.py | archivo de configuración del proyecto |
| spiders/ | directorio donde después colocarás tus spiders |
__init.py__ |
archivo de inicialización |
Cuando hayas creado el proyecto, cambia al directorio recién creado y escribe el siguiente comando:
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Esto crea un archivo de plantilla llamado aliexpress_tablets.py en el directorio spiders como se indicó antes. El código de ese archivo es el siguiente:
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
En el código anterior puedes ver name, allowed_domains, start_urls y una función parse.
scrapy crawl nombre_del_spider.response (que usaste en la shell de Scrapy) devuelta tras el rastreo se pasa a esta función, y aquí escribes el código de extracción.Información: puedes usar BeautifulSoup dentro de la función parse() del spider de Scrapy para parsear el documento HTML.
Nota: puedes extraer datos con selectores CSS usando response.css() como vimos en la sección de la shell, pero también con XPath (XML), que te permite acceder a elementos hijo. Verás el ejemplo de response.xpath() en el código editado en la función pass().
Vas a hacer cambios en el archivo aliexpress_tablet.py. He añadido otra URL en start_urls. Puedes añadir la lógica de extracción en la función pass() como abajo:
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Información: zip() toma n iterables y devuelve una lista de tuplas. El elemento i de cada tupla se crea usando el elemento i de cada iterable [8]
La palabra clave yield se usa al definir una función generadora. Una función generadora es como una función normal, salvo que usa yield en vez de return. yield se utiliza cuando la función que llama necesita un valor; la función con yield mantiene su estado local y continúa ejecutándose donde lo dejó tras ceder el valor. Aquí, yield entrega el diccionario generado a Scrapy, que lo procesará y guardará.
Ahora puedes ejecutar el spider:
scrapy crawl aliexpress_tablets
Verás una salida extensa en la consola, como esta:


Necesitarás los datos en CSV o JSON para poder analizarlos después. En esta sección verás cómo guardar este contenido en CSV y JSON.
Para guardar un CSV, abre settings.py del directorio del proyecto y añade estas líneas:
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Después de guardar settings.py, vuelve a ejecutar scrapy crawl aliexpress_tablets en el directorio del proyecto.

El archivo CSV se verá así:

Nota: cada vez que ejecutes el spider, añadirá datos al archivo.
     + JSON
     + CSV
     + JSON Lines
     + XML
El sistema de exportación de feeds de Scrapy también puede añadir una marca temporal y el nombre del spider al nombre del fichero, o puedes usar estos valores para identificar un directorio donde guardarlo.
%(time)s: se reemplaza por una marca temporal cuando se crea el feed [5]%(name)s: se reemplaza por el nombre del spider [5]Por ejemplo:
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
Los cambios de Feed que hagas en settings.py se aplicarán a todos los spiders del proyecto. También puedes definir ajustes personalizados para un spider concreto que sobrescriban los de settings.py.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url devuelve la URL de la página de la que se genera la respuesta. Tras ejecutar el crawler con scrapy crawl aliexpress_tablets, podrás ver el archivo JSON:

Habrás notado que hay dos enlaces en start_urls. El segundo es la página 2 de los resultados de búsqueda de tablets. No es práctico añadir todos los enlaces. Un crawler debería poder avanzar por todas las páginas por sí solo, y en start_urls solo indicar el punto de partida.
Si una página tiene más páginas, verás una paginación al final que permite moverte adelante y atrás. En el caso de este tutorial, la verás así:

Este es el código que verás:

Como ves, hay una etiqueta <span> con la clase .ui-pagination-active que indica la página actual, y debajo están todas las etiquetas <a> con enlaces a la siguiente página. Cada vez tendrás que obtener las etiquetas <a> que vienen después de ese <span>. Aquí entra un poco de CSS: en este caso necesitas el nodo hermano, no el hijo, así que debes crear un selector CSS que diga al crawler que encuentre las etiquetas <a> que siguen a la etiqueta <span> con la clase .ui-pagination-active.
¡Recuerda! Cada página tiene su propia estructura. Tendrás que estudiarla un poco para llegar al elemento deseado. Prueba siempre response.css(SELECTOR) en la shell de Scrapy antes de escribirlo en el código.
Modifica tu aliexpress_tablets.py como sigue:
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
En el código anterior:
primero extraes el enlace de la siguiente página con next_page = response.css(NEXT_PAGE_SELECTOR).extract_first() y, si la variable next_page obtiene un enlace y no está vacía, entra en el cuerpo del if.
response.urljoin(next_page): el método parse() usa este método para construir una nueva URL y crear una nueva petición, que se enviará después al callback [9]
Tras recibir la nueva URL, hará scraping de ese enlace ejecutando el cuerpo del for y volverá a buscar la siguiente página. Esto continuará hasta que no haya más enlace de siguiente página.
Aquí puedes sentarte y ver cómo tu spider recorre todas las páginas. El spider anterior extraerá de todas las páginas siguientes. ¡Será mucho scraping! Pero tu spider podrá con ello. Abajo puedes ver que el archivo ha llegado a 1,1 MB.

En este tutorial has aprendido qué es Scrapy, cómo se compara con BeautifulSoup, qué es Scrapy Shell y cómo escribir tus propios spiders en Scrapy. Scrapy se encarga de gran parte del trabajo pesado del código: desde crear archivos y carpetas del proyecto hasta gestionar URLs duplicadas. Te permite hacer scraping de alto rendimiento en minutos y ofrece soporte para todos los formatos de datos habituales que luego puedes usar en otros programas. Este tutorial te habrá ayudado a entender Scrapy, su framework y lo que puedes hacer con él. Para dominarlo, tendrás que explorar todas sus fantásticas funcionalidades, pero con lo que has visto ya puedes extraer grupos de páginas de forma eficiente.
Para seguir aprendiendo, consulta la documentación oficial de Scrapy.
Y no olvides echar un vistazo al curso de DataCamp Web Scraping with Python.
Cursos relacionados con Python
Curso
Curso
Curso
Tutorial
Abid Ali Awan
6 min
Tutorial
Kurtis Pykes
7 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Moez Ali
9 min
Tutorial
Kurtis Pykes
10 min
Tutorial
Natassha Selvaraj
10 min