Cours
Web Scraping en Python
4 h
94.1K
Pour une vue d'ensemble du web scraping en Python, suivez le cours Web Scraping with Python de DataCamp.
Dans ce tutoriel, vous allez apprendre à utiliser Scrapy, un framework Python grâce auquel vous pouvez gérer de gros volumes de données ! Vous apprendrez Scrapy en créant un web scraper pour AliExpress.com, un site d'e-commerce. Allons scraper !
Des connaissances de base en HTML et CSS vous aideront à suivre ce tutoriel plus facilement et plus rapidement. Consultez cet article pour vous rafraîchir la mémoire sur HTML et CSS.
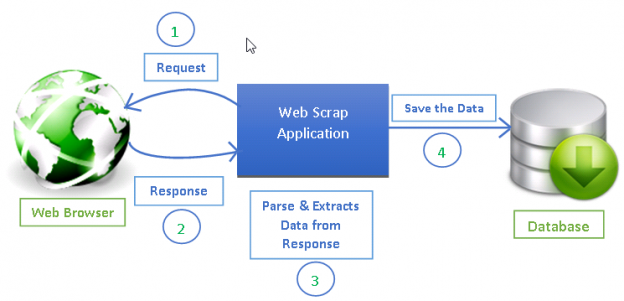
Le web scraping est devenu un moyen efficace d'extraire des informations du web pour décider et analyser. C'est un élément incontournable de la boîte à outils de la data science. Les data scientists doivent savoir collecter des données depuis des pages web et les stocker dans différents formats pour analyse ultérieure.
Toute page web accessible sur Internet peut être crawlée et tout ce qui est visible sur une page peut être extrait [2]. Chaque page possède sa propre structure et ses éléments ; c'est pourquoi vous devez écrire vos crawlers/araignées en fonction de la page à extraire.
Scrapy fournit un framework puissant pour extraire les données, les traiter puis les enregistrer.
Scrapy utilise des spiders, des crawlers autonomes auxquels on fournit un ensemble d'instructions [1]. Avec Scrapy, il est plus simple de construire et faire monter en charge de grands projets de crawling en permettant aux développeurs de réutiliser leur code.
Dans cette section, vous aurez un aperçu de l'outil de scraping BeautifulSoup, très populaire, et de sa comparaison avec Scrapy.
Scrapy est un framework Python de web scraping qui offre un package complet aux développeurs, sans avoir à se soucier de la maintenance du code.
Beautiful Soup est également très utilisé pour le scraping. C'est un package Python pour analyser des documents HTML et XML et en extraire des données. Il est disponible pour Python 2.6+ et Python 3.
Voici, en bref, quelques différences :
| Scrapy | BeautifulSoup |
|---|---|
| Fonctionnalité | --- |
| Scrapy est une solution complète pour télécharger des pages web, les traiter et les enregistrer dans des fichiers ou des bases de données | BeautifulSoup est avant tout un parseur HTML et XML et nécessite des bibliothèques supplémentaires comme requests, urlib2 pour ouvrir des URLs et stocker le résultat [6] |
| Courbe d'apprentissage | --- |
| Scrapy est une véritable centrale pour le scraping et offre de nombreuses façons d'extraire une page. Il demande plus de temps pour bien comprendre son fonctionnement, mais une fois maîtrisé, il simplifie la création et l'exécution de crawlers depuis une simple ligne de commande. Devenir expert de Scrapy peut nécessiter un peu de pratique et du temps pour en explorer toutes les fonctionnalités. | BeautifulSoup est relativement facile à appréhender pour les débutants et permet de réaliser rapidement de petites tâches |
| Vitesse et charge | --- |
Scrapy gère très facilement les gros travaux. Il peut crawler un ensemble d'URLs en moins d'une minute selon sa taille et le fait très fluidement, car il utilise Twister qui fonctionne de manière asynchrone (non bloquante) pour la concurrence. |
BeautifulSoup est efficace pour des tâches simples. Il est plus lent que Scrapy si vous n'utilisez pas le multiprocessing. |
| Étendre les fonctionnalités | --- |
| Scrapy propose des pipelines d'items qui permettent d'écrire des fonctions dans votre spider pour traiter vos données : validation, nettoyage, enregistrement en base, etc. Il fournit des contrats de spiders pour tester vos spiders et vous permet de créer des crawlers génériques et profonds. Il autorise la gestion de nombreuses variables : tentatives, redirections, etc. | Si le projet ne demande pas beaucoup de logique, BeautifulSoup fait l'affaire, mais si vous avez besoin de forte personnalisation comme des proxys, la gestion des cookies et des pipelines de données, Scrapy est la meilleure option. |
Information : synchrone signifie que vous devez attendre la fin d'une tâche pour en démarrer une autre, tandis qu'asynchrone signifie que vous pouvez passer à une autre tâche avant que la précédente soit terminée
Voici un intéressant tutoriel BeautifulSoup de DataCamp à découvrir.

Avec Python 3.0 (et versions ultérieures) installé, si vous utilisez Anaconda, vous pouvez utiliser conda pour installer scrapy. Saisissez la commande suivante dans l'invite Anaconda :
conda install -c conda-forge scrapy
Pour installer Anaconda, consultez ces tutoriels DataCamp pour Mac et Windows.
Alternativement, vous pouvez utiliser l'installateur de packages Python pip. Cela fonctionne sous Linux, Mac et Windows :
pip install scrapy
Scrapy fournit aussi une console de crawling appelée Scrapy Shell, que les développeurs peuvent utiliser pour tester leurs hypothèses sur le comportement d'un site. Prenons une page produits pour tablettes sur le site e-commerce AliExpress. Vous pouvez utiliser la Shell Scrapy pour voir quels composants la page renvoie et comment les exploiter selon vos besoins.
Ouvrez votre ligne de commande et écrivez :
scrapy shell
Si vous utilisez Anaconda, vous pouvez aussi saisir la commande ci-dessus dans l'invite Anaconda. La sortie dans le terminal ou l'invite Anaconda ressemblera à ceci :

Vous devez exécuter un crawler sur la page web avec la commande fetch dans la Shell Scrapy. Un crawler (ou spider) parcourt une page en téléchargeant son texte et ses métadonnées.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Remarque : encadrez toujours l'URL de guillemets ; simples ou doubles, les deux fonctionnent

Le crawler renvoie une response que vous pouvez visualiser avec la commande view(response) dans la Shell :
view(response)
La page s'ouvrira alors dans le navigateur par défaut.

Vous pouvez afficher le HTML brut avec la commande suivante dans la Shell Scrapy :
print(response.text)

Vous verrez le script qui génère la page. C'est le même contenu que lorsque vous faites un clic droit sur une zone vide d'une page et cliquez sur afficher le code source. Comme vous n'avez besoin que des informations pertinentes dans tout ce script, vous allez inspecter l'élément voulu avec les outils de développement du navigateur. Prenons les éléments suivants :
Faites un clic droit sur l'élément souhaité et cliquez sur inspect comme ci-dessous :

Les outils de développement du navigateur sont très utiles pour le scraping. Vous voyez qu'il s'agit d'une balise <a> avec une class product et que le texte contient le nom du produit :

Vous pouvez extraire en vous basant sur les attributs d'élément ou sur des sélecteurs CSS comme les classes. Saisissez ce qui suit dans la Shell Scrapy pour extraire le nom du produit :
response.css(".product::text").extract_first()
La sortie sera :

extract_first() extrait le premier élément qui correspond au sélecteur CSS. Si vous souhaitez extraire tous les noms de produits, utilisez extract() :
response.css(".product::text").extract()

Le code suivant extrait la plage de prix des produits :
response.css(".value::text").extract()

De même, vous pouvez essayer avec le nombre de commandes et le nom de la boutique.
XPath est un langage de requête pour sélectionner des nœuds dans un document XML [7]. Vous pouvez parcourir un document XML avec XPath. En coulisses, Scrapy utilise XPath pour naviguer dans les éléments du document HTML. Les sélecteurs CSS utilisés plus haut sont également convertis en XPath, mais dans bien des cas, le CSS est plus simple à employer. Vous devez toutefois comprendre le fonctionnement de XPath dans Scrapy.
Allez dans votre Shell Scrapy et écrivez fetch(https://pt.aliexpress.com/category/201005406/special-store.html/) comme précédemment. Testez les extraits suivants [3] :
response.xpath('/html').extract()
Cela affichera tout le code sous la balise <html>. / désigne l'enfant direct du nœud. Si vous voulez récupérer les balises <div> sous la balise html, écrivez [3] :
response.xpath('/html//div').extract()
Avec XPath, vous devez bien comprendre l'usage de / et // pour naviguer entre enfants et descendants. Voici un tutoriel utile sur les nœuds XPath et quelques exemples à tester.
Si vous souhaitez récupérer toutes les balises <div>, vous pouvez le faire sans /html [3] :
response.xpath("//div").extract()
Vous pouvez ensuite affiner les nœuds d'origine et atteindre les nœuds visés en utilisant des attributs et leurs valeurs. Ci-dessous, la syntaxe pour cibler des classes et leurs valeurs.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Utilisez text() pour extraire tout le texte à l'intérieur des nœuds
Considérez le code HTML suivant :

Vous voulez récupérer le texte à l'intérieur de la balise <a>, enfant de <div> portant les classes site-notice-container container ; vous pouvez faire ainsi :
response.xpath('//div[@class=\"site-notice-container container\"]/a[@class=\"notice-close\"]/text()').extract()

Le web scraping peut servir à construire un agrégateur pour comparer des données. Par exemple, si vous souhaitez acheter une tablette et comparer produits et prix, vous pouvez crawler les pages visées et stocker le tout dans un fichier Excel. Ici, vous allez scraper aliexpress.com pour obtenir des informations sur les tablettes.
Vous allez maintenant créer un spider personnalisé pour la même page. Commencez par créer un projet Scrapy dans lequel votre code et vos résultats seront stockés. Saisissez la commande suivante dans la ligne de commande ou l'invite Anaconda.
scrapy startproject aliexpress

Un dossier sera créé à l'emplacement par défaut de votre installation Python ou Anaconda. aliexpress sera le nom du dossier. Vous pouvez lui donner n'importe quel nom. Vous pouvez afficher son contenu directement via l'explorateur. Voici la structure du dossier :

| fichier/dossier | Objectif |
|---|---|
| scrapy.cfg | fichier de configuration de déploiement |
| aliexpress/ | module Python du projet ; vous y importerez votre code |
__init.py__ |
fichier d'initialisation |
| items.py | fichier des items du projet |
| pipelines.py | fichier des pipelines du projet |
| settings.py | fichier de configuration du projet |
| spiders/ | répertoire où vous placerez vos spiders |
__init.py__ |
fichier d'initialisation |
Une fois le projet créé, déplacez-vous dans le nouveau répertoire et saisissez la commande suivante :
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Cela crée un fichier modèle nommé aliexpress_tablets.py dans le répertoire spiders mentionné ci-dessus. Le code de ce fichier est le suivant :
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
Dans le code ci-dessus, vous voyez name, allowed_domains, start_urls et une fonction parse.
scrapy crawl name_of_spider.response (utilisé dans la Shell Scrapy) renvoyé par le crawl est passé à cette fonction, et vous y écrivez votre logique d'extraction !Information : vous pouvez utiliser BeautifulSoup dans la fonction parse() du spider Scrapy pour parser le document HTML.
Remarque : vous pouvez extraire des données via des sélecteurs CSS avec response.css() comme vu dans la section Scrapy Shell, mais aussi avec XPath (XML) qui permet d'accéder aux éléments enfants. Vous verrez un exemple de response.xpath() dans le code modifié de la fonction pass().
Vous allez modifier le fichier aliexpress_tablet.py. J'ai ajouté une autre URL dans start_urls. Vous pouvez ajouter la logique d'extraction dans la fonction pass() comme ci-dessous :
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Information : zip() prend n itérables et renvoie une liste de tuples. Le ième élément du tuple est créé avec le ième élément de chacun des itérables. [8]
Le mot-clé yield est utilisé lorsque vous définissez une fonction génératrice. Une fonction génératrice est semblable à une fonction classique, sauf qu'elle utilise yield au lieu de return. Le mot-clé yield renvoie une valeur quand la fonction appelante en a besoin, et la fonction qui contient yield conserve son état local et reprend l'exécution là où elle s'était arrêtée après avoir fourni la valeur. Ici, yield transmet le dictionnaire généré à Scrapy, qui le traitera et l'enregistrera !
Vous pouvez maintenant exécuter le spider :
scrapy crawl aliexpress_tablets
Vous verrez une longue sortie dans la ligne de commande, comme ci-dessous :


Vous aurez besoin de présenter les données en CSV ou JSON pour les analyser ensuite. Cette section du tutoriel vous montre comment enregistrer ce jeu de données en CSV et en JSON.
Pour sauvegarder en CSV, ouvrez settings.py dans le répertoire du projet et ajoutez les lignes suivantes :
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Après avoir enregistré settings.py, relancez scrapy crawl aliexpress_tablets dans votre répertoire de projet.

Le fichier CSV ressemblera à ceci :

Remarque : à chaque exécution du spider, le fichier sera enrichi (ajout en fin de fichier).
     + JSON
     + CSV
     + JSON Lines
     + XML
Le module d'export de flux (Feed Export) de Scrapy peut également ajouter un horodatage et le nom du spider au nom du fichier, ou vous pouvez les utiliser pour identifier un répertoire de stockage.
%(time)s : remplacé par un horodatage lors de la création du flux [5]%(name)s : remplacé par le nom du spider [5]Par exemple :
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
Les modifications du flux que vous faites dans settings.py s'appliqueront à tous les spiders du projet. Vous pouvez aussi définir des paramètres personnalisés pour un spider particulier qui écraseront ceux de settings.py.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url renvoie l'URL de la page à l'origine de la réponse. Après exécution du crawler avec scrapy crawl aliexpress_tablets, vous pouvez consulter le fichier JSON :

Vous aurez remarqué qu'il y a deux liens dans start_urls. Le second lien correspond à la page 2 des résultats de recherche pour les tablettes. Ajouter tous les liens à la main serait impraticable. Un crawler doit être capable de parcourir seul toutes les pages, et seules les URLs de départ doivent être renseignées dans start_urls.
Si une page comporte des pages suivantes, vous trouverez une pagination en bas de page pour naviguer. Dans le cas du tutoriel, vous la verrez comme ceci :

Voici le code correspondant :

Comme vous le voyez, il y a une balise <span> avec la classe .ui-pagination-active qui correspond à la page courante, et en dessous, toutes les balises <a> vers les pages suivantes. Il faut donc récupérer les <a> qui suivent ce <span>. Un peu de CSS s'impose ! Ici, vous devez cibler un nœud frère et non un enfant ; il faut donc un sélecteur CSS qui demande au crawler de trouver les balises <a> situées après la balise <span> de classe .ui-pagination-active.
Important ! Chaque page web a sa propre structure. Vous devrez l'étudier un minimum pour cibler l'élément voulu. Testez toujours vos sélecteurs avec response.css(SÉLECTEUR) dans la Shell Scrapy avant de les écrire dans le code.
Modifiez votre aliexpress_tablets.py comme ci-dessous :
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
Dans le code ci-dessus :
vous commencez par extraire le lien de la page suivante avec next_page = response.css(NEXT_PAGE_SELECTOR).extract_first(), puis si la variable next_page contient un lien et n'est pas vide, elle entre dans le bloc if.
response.urljoin(next_page) : la méthode parse() utilisera cette méthode pour construire une nouvelle URL et fournir une nouvelle requête, qui sera ensuite envoyée au callback. [9]
Après réception de la nouvelle URL, le spider la scrape en exécutant le corps du for puis recherche à nouveau la page suivante. Cela continue jusqu'à ce qu'aucun lien de page suivante ne soit trouvé.
Vous pouvez maintenant vous détendre et laisser votre spider parcourir toutes les pages. Le spider ci-dessus extraira toutes les pages suivantes. Cela fait beaucoup de scraping ! Mais votre spider s'en charge ! Ci-dessous, vous voyez que la taille du fichier a atteint 1,1 Mo.

Dans ce tutoriel, vous avez découvert Scrapy, sa comparaison avec BeautifulSoup, la Scrapy Shell et la façon d'écrire vos propres spiders. Scrapy prend en charge la lourdeur du code : de la création des fichiers et dossiers du projet à la gestion des URLs dupliquées, il vous permet de mettre en place un scraping puissant en quelques minutes et vous offre la prise en charge de tous les formats de données courants, exploitables ensuite dans d'autres programmes. Ce tutoriel vous aura permis de comprendre Scrapy, son framework et ce que vous pouvez en faire. Pour en devenir expert, explorez ses nombreuses fonctionnalités, mais vous avez désormais les bases pour scraper efficacement des groupes de pages web.
Pour aller plus loin, référez-vous à la documentation officielle de Scrapy.
Et n'oubliez pas de consulter le cours Web Scraping with Python de DataCamp.
Cours liés à Python
Cours
Cours
Cours