Curso
Introducción al Deep Learning en Python
4 h
264.6K
A principios de esta semana hice una sesión de Facebook Live de code along. En ella, usamos técnicas básicas de procesamiento del lenguaje natural para representar las palabras que más aparecen en la novela Moby Dick. Al hacerlo, también vemos lo eficaz que es pensar en términos del siguiente flujo de trabajo de ciencia de datos, manteniendo siempre el foco en el proceso:
En este post aprenderás a construir un flujo de ciencia de datos para representar distribuciones de frecuencia de palabras en Moby Dick, y en muchas otras novelas.
Consejo: si quieres volver a ver el Facebook Live, echa un vistazo al siguiente vídeo; puedes saltar al minuto 12, cuando entra Hugo y empieza realmente la sesión.
No te daremos las novelas: aprenderás a extraerlas de la web Project Gutenberg (que contiene un gran corpus de libros) con la librería de Python requests y a sacar el texto de esas páginas con BeautifulSoup. Después pasarás a analizar las novelas con Natural Language ToolKit (nltk). Por el camino, verás aspectos clave de NLP como la tokenización y las stopwords.
Terminarás siendo capaz de visualizar distribuciones de frecuencia de palabras de cualquier novela que encuentres en Project Gutenberg. Las habilidades de NLP que desarrollarás, además, se aplican a gran parte de los datos con los que trabajan los data scientists, ya que una proporción enorme de los datos del mundo es no estructurada e incluye muchísimo texto.
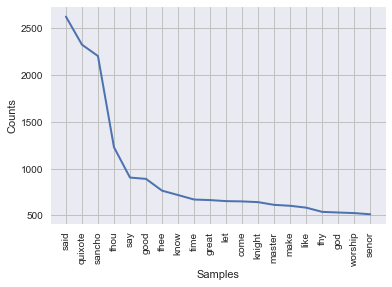
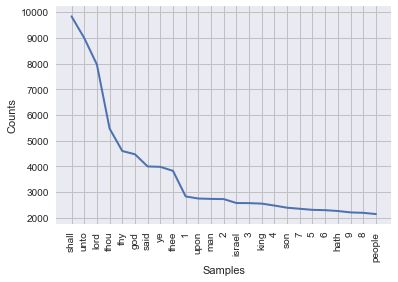
Por ejemplo, ¿de qué texto podría ser la siguiente distribución de frecuencia de palabras?
Este post se generó a partir de un Jupyter Notebook; puedes encontrarlo en este repositorio. Si tienes ideas, comentarios o reflexiones, escríbeme en Twitter: @hugobowne.
Sigue las instrucciones del README.md para preparar tu entorno y dejarlo listo.
¿Cuáles son las palabras más frecuentes en la novela Moby Dick y con qué frecuencia aparecen?
Tus datos en bruto son el texto de la novela Moby Dick de Melville. ¿Cómo harías para llevar el texto de este libro de ~800 páginas a Python?
Hay varias maneras, pero lo primero es darte cuenta de que el texto está disponible gratis en Project Gutenberg. Vamos allí, buscamos Moby Dick y guardamos la URL pertinente en tu espacio de trabajo de Python:
# Store url
url = 'https://www.gutenberg.org/files/2701/2701-h/2701-h.htm'
Ahora que tienes la URL, necesitas obtener el HTML de la página.
Nota: HTML significa Hypertext Markup Language y es el lenguaje estándar de marcado para la web.
Vas a usar requests para hacerlo, una de las librerías de Python más populares y útiles que hay. Puedes saber más en el curso de DataCamp Importing Data in Python (Part 2).
Según la web de requests:
Requests te permite enviar peticiones HTTP/1.1 "orgánicas", sin necesidad de trabajo manual.
y las siguientes organizaciones afirman usar requests internamente:
El Gobierno de Su Majestad, Amazon, Google, Twilio, NPR, Obama for America, Twitter, Sony y organismos federales de EE. UU. que prefieren no ser nombrados.
Además,
Requests es una de las librerías de Python más descargadas de todos los tiempos, con más de 13.000.000 de descargas al mes. ¡Todo el mundo la usa!
Vas a hacer una petición GET al sitio web, lo que significa que obtienes datos de él. Esto es lo que hace tu navegador cuando visitas una página. Hay otros tipos de peticiones, como las POST, pero aquí no nos ocuparemos de ellas.
requests lo simplifica con su función get. Haz la petición y comprueba el tipo de objeto devuelto.
# Import `requests`
import requests

# Make the request and check object type
r = requests.get(url)
type(r)
requests.models.Response
Esto es un objeto Response. En la guía de inicio de requests verás que un Response tiene un atributo text que te permite obtener el HTML. Hagámoslo e imprimimos el HTML para echarle un vistazo:
# Extract HTML from Response object and print
html = r.text
#print(html)
¡Bien! Este HTML no es exactamente lo que quieres. Sin embargo, contiene lo que buscas: el texto de Moby Dick. Ahora necesitas limpiar ese HTML para extraer la novela.
Aquí usarás la librería BeautifulSoup. En su web se dice:
¡Tiene buena pinta!
Primero, una nota sobre el nombre: ¿Beautiful Soup? En desarrollo web, el término "tag soup" se usa para referirse a HTML con estructura o sintaxis incorrecta. Lo que mejor hace Beautiful Soup es dejar ese "sopa de etiquetas" como nueva y extraer información con facilidad. De hecho, el objeto principal que se crea y consulta al usar esta librería se llama BeautifulSoup. Una vez creada la sopa, podemos usar su método .get_text() para extraer el texto.
# Import BeautifulSoup from bs4
from bs4 import BeautifulSoup


# Create a BeautifulSoup object from the HTML
soup = BeautifulSoup(html, "html5lib")
type(soup)
bs4.BeautifulSoup
A partir de estos objetos soup puedes extraer todo tipo de información interesante de la web que estás raspando, como el título:
# Get soup title
soup.title
<title>
      Moby Dick; Or the Whale, by Herman Melville
    </title>
O el título como cadena:
# Get soup title as string
soup.title.string
'\n Moby Dick; Or the Whale, by Herman Melville\n '
O todas las URL que se encuentran en las etiquetas <a> (enlaces):
# Get hyperlinks from soup and check out first several
soup.findAll('a')[:8]
[<a href="#link2H_4_0002"> ETYMOLOGY. </a>,
 <a href="#link2H_4_0003"> EXTRACTS (Supplied by a Sub-Sub-Librarian).
         </a>,
 <a href="#link2HCH0001"> CHAPTER 1. Loomings. </a>,
 <a href="#link2HCH0002"> CHAPTER 2. The Carpet-Bag. </a>,
 <a href="#link2HCH0003"> CHAPTER 3. The Spouter-Inn. </a>,
 <a href="#link2HCH0004"> CHAPTER 4. The Counterpane. </a>,
 <a href="#link2HCH0005"> CHAPTER 5. Breakfast. </a>,
 <a href="#link2HCH0006"> CHAPTER 6. The Street. </a>]
Lo que quieres es extraer el texto de soup, y para eso existe el método .get_text(), tremendamente útil.
Obtén el texto, imprímelo y échale un vistazo. ¿Es lo que buscas?
# Get the text out of the soup and print it
text = soup.get_text()
#print(text)
Observa que ahora casi tienes lo que necesitas.
Es el texto de la novela con algo de contenido no deseado al principio y al final. Podrías eliminarlo si quisieras. Sin embargo, como esto es mucho menor en tamaño que el texto de Moby Dick, a primera aproximación es aceptable dejarlo; esta será nuestra aproximación aquí. Para resultados más robustos, te sugiero quitarlo.
Ahora que ya tienes el texto que te interesa, toca contar cuántas veces aparece cada palabra y representar el histograma de frecuencias que quieres: ¡que entre en juego el procesamiento del lenguaje natural!
Ahora usarás nltk, el Natural Language Toolkit, para:
Quieres tokenizar tu texto, es decir, dividirlo en una lista de palabras. Básicamente, separar por los espacios en blanco.
Para ello, vas a usar una herramienta potente llamada expresiones regulares. Una expresión regular, o regex, es una secuencia de caracteres que define un patrón de búsqueda. Son famosas por ser confusas y lo mejor es verlas con ejemplos.
La expresión regular que coincide con todas las palabras que empiezan por "p" es "p\w+". Desgranémosla:
Juntándolo todo, la expresión regular "p\w+" casará con todos los fragmentos que empiecen por "p" y vayan seguidos de caracteres alfanuméricos y guiones bajos. En la mayoría de los textos en inglés con sentido, esto corresponderá a palabras que empiezan por "p".
Ahora usarás el paquete estándar de Python re para extraer todas las palabras que comienzan por "p" de la frase "peter piper picked a peck of pickled peppers" como calentamiento.
# Import regex package
import re

# Define sentence
sentence = 'peter piper pick a peck of pickled peppers'

# Define regex
ps = 'p\w+'


# Find all words in sentence that match the regex and print them
re.findall(ps, sentence)
['peter', 'piper', 'pick', 'peck', 'pickled', 'peppers']
Tiene buena pinta. Ahora bien, si "p\w+" es la regex que casa con palabras que empiezan por "p", ¿cuál es la regex que casa con todas las palabras?
Tu tarea ahora es aplicarla a nuestra frase de prueba de Peter Piper.
# Find all words and print them
re.findall('\w+', sentence)
['peter', 'piper', 'pick', 'a', 'peck', 'of', 'pickled', 'peppers']
Ahora puedes hacer lo mismo con text, la cadena que contiene Moby Dick:
# Find all words in Moby Dick and print several
tokens = re.findall('\w+', text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
Nota: también hay una forma de hacerlo con nltk, el Natural Language Toolkit:
# Import RegexpTokenizer from nltk.tokenize
from nltk.tokenize import RegexpTokenizer

# Create tokenizer
tokenizer = RegexpTokenizer('\w+')


# Create tokens
tokens = tokenizer.tokenize(text)
tokens[:8]
['Moby', 'Dick', 'Or', 'the', 'Whale', 'by', 'Herman', 'Melville']
¡Perfecto! Ya casi lo tienes. Fíjate, eso sí, en que arriba "Or" aparece con "O" mayúscula y en otros lugares puede no hacerlo, pero tanto "Or" como "or" querrás contarlos como la misma palabra. Por eso, necesitarás construir una lista de todas las palabras de Moby Dick en minúsculas. Te será útil el método de cadena .lower():
# Initialize new list
words = []


# Loop through list tokens and make lower case
for word in tokens:
    words.append(word.lower())


# Print several items from list as sanity check
words[:8]
['moby', 'dick', 'or', 'the', 'whale', 'by', 'herman', 'melville']
Es habitual eliminar palabras muy frecuentes en inglés como "the", "of" o "a" (conocidas como stopwords) porque no aportan mucho. Para profundizar en estas técnicas, echa un vistazo a nuestro curso Natural Language Processing Fundamentals in Python.
La librería nltk incluye una lista de stopwords en inglés que ahora guardarás como sw y de la que imprimirás los primeros elementos.
Si aquí te aparece un error, ejecuta nltk.download('stopwords') para instalar las stopwords en tu sistema.
# Import nltk
import nltk

# Get English stopwords and print some of them
sw = nltk.corpus.stopwords.words('english')
sw[:5]
['i', 'me', 'my', 'myself', 'we']
Quieres la lista de todas las palabras en words que no estén en sw. Una forma es recorrer words y añadir a una nueva lista solo aquellas que no estén en sw:
# Initialize new list
words_ns = []

# Add to words_ns all words that are in words but not in sw
for word in words:
    if word not in sw:
        words_ns.append(word)

# Print several list items as sanity check
words_ns[:5]
['moby', 'dick', 'whale', 'herman', 'melville']
Nuestra pregunta era: "¿Cuáles son las palabras más frecuentes en la novela Moby Dick y con qué frecuencia aparecen?"
Ahora puedes representar un histograma de frecuencias de palabras en Moby Dick con dos líneas de código usando nltk. Para ello,
nltk.FreqDist();plot() del objeto resultante.#Import datavis libraries
import matplotlib.pyplot as plt
import seaborn as sns
# Figures inline and set visualization style
%matplotlib inline
sns.set()
# Create freq dist and plot
freqdist1 = nltk.FreqDist(words_ns)
freqdist1.plot(25)
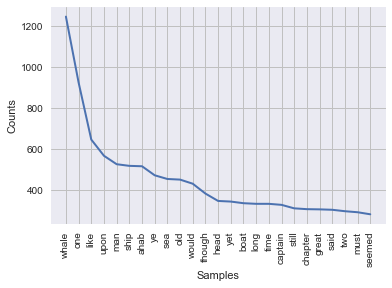
Lo bueno es que, al usar nltk para responder a la pregunta, ya hemos presentado la solución de una forma comprensible para otros: ¡una gráfica de distribución de frecuencias! Puedes leer cuáles son las palabras más comunes y su frecuencia. Por ejemplo, "whale" es la palabra más común de la novela (quién lo diría), excluyendo stopwords, y aparece ¡más de 1200 veces!
Dado que has visto que en Project Gutenberg hay muchísimas novelas para las que podemos hacer estos histogramas, tiene sentido escribir tu propia función que lo haga todo:
 def plot_word_freq(url):
    """Takes a url (from Project Gutenberg) and plots a word frequency
    distribution"""
    # Make the request and check object type
    r = requests.get(url)
    # Extract HTML from Response object and print
    html = r.text
    # Create a BeautifulSoup object from the HTML
    soup = BeautifulSoup(html, "html5lib")
    # Get the text out of the soup and print it
    text = soup.get_text()
    # Create tokenizer
    tokenizer = RegexpTokenizer('\w+')
    # Create tokens
    tokens = tokenizer.tokenize(text)
    # Initialize new list
    words = []
    # Loop through list tokens and make lower case
    for word in tokens:
        words.append(word.lower())
    # Get English stopwords and print some of them
    sw = nltk.corpus.stopwords.words('english')
    # Initialize new list
    words_ns = []
    # Add to words_ns all words that are in words but not in sw
    for word in words:
        if word not in sw:
            words_ns.append(word)
    # Create freq dist and plot
    freqdist1 = nltk.FreqDist(words_ns)
    freqdist1.plot(25)
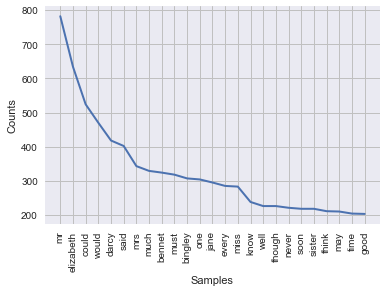
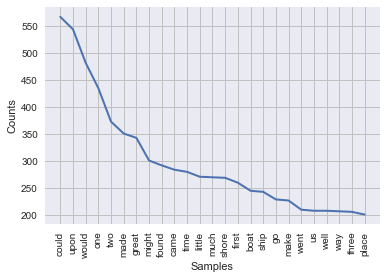
Ahora usa la función para representar distribuciones de frecuencia de palabras de otros textos en Project Gutenberg:
plot_word_freq('https://www.gutenberg.org/files/42671/42671-h/42671-h.htm')
plot_word_freq('https://www.gutenberg.org/files/521/521-h/521-h.htm')
plot_word_freq('https://www.gutenberg.org/files/10/10-h/10-h.htm')
En este post has aprendido a construir un flujo de ciencia de datos para representar distribuciones de frecuencia de palabras en Moby Dick, entre otras muchas novelas. Has aprendido a extraerlas del sitio web Project Gutenberg (gran corpus de libros) con la librería de Python requests y a sacar el texto de esas páginas con BeautifulSoup. Luego te has lanzado a analizar las novelas con Natural Language ToolKit (nltk). Por el camino has visto aspectos importantes de NLP como la tokenización y las stopwords. Ahora ya puedes visualizar distribuciones de frecuencia de palabras de cualquier novela que encuentres en Project Gutenberg. Las habilidades de NLP que has desarrollado también se aplican a gran parte de los datos con los que se encuentran los data scientists, ya que una proporción enorme de los datos del mundo es no estructurada e incluye una gran cantidad de texto.
Este post se generó a partir de un Jupyter Notebook; puedes encontrarlo en este repositorio. Si tienes ideas, comentarios o reflexiones, escríbeme en Twitter: @hugobowne. Cuéntame qué proyectos chulos construyes.
Echa un vistazo a los tutoriales de DataCamp Web Scraping using Python (and Beautiful Soup) y How to Use Python to Scrape Amazon.
Aprende más sobre Python
Curso
Curso
Curso
Tutorial
Moez Ali
13 min
Tutorial
Duong Vu
11 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
12 min


