Kurs
Web Scraping in Python
4 Std.
94.1K
Wenn du einen Überblick über Web Scraping in Python möchtest, schau dir den DataCamp-Kurs Web Scraping with Python an.
In diesem Tutorial lernst du Scrapy kennen – ein Python-Framework, mit dem du große Datenmengen verarbeiten kannst. Du lernst Scrapy, indem du einen Web-Scraper für AliExpress.com, eine E‑Commerce-Website, baust. Legen wir los mit dem Scrapen!
Grundkenntnisse in HTML und CSS helfen dir, dem Tutorial schneller und leichter zu folgen. Frische dein Wissen mit diesem Artikel zu HTML und CSS auf.
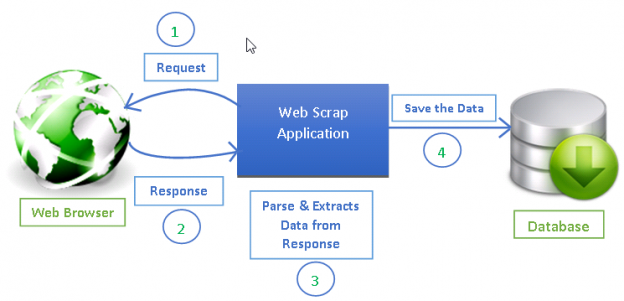
Web Scraping ist zu einer effektiven Methode geworden, um Informationen aus dem Web für Entscheidungen und Analysen zu gewinnen. Es gehört heute zum Standard‑Werkzeugkasten in der Data Science. Datenexpertinnen und -experten sollten wissen, wie sie Daten von Webseiten erfassen und in unterschiedlichen Formaten für weitere Analysen speichern.
Grundsätzlich lässt sich jede Webseite im Internet nach Informationen crawlen, und alles, was auf einer Webseite sichtbar ist, kann extrahiert werden [2]. Jede Seite hat jedoch ihre eigene Struktur und eigene Elemente. Daher musst du deine Web-Crawler bzw. Spiders immer an die zu extrahierende Seite anpassen.
Scrapy stellt ein leistungsstarkes Framework bereit, um Daten zu extrahieren, zu verarbeiten und zu speichern.
Scrapy nutzt spiders – eigenständige Crawler mit einem vordefinierten Satz an Anweisungen [1]. Mit Scrapy lassen sich große Crawling-Projekte einfacher aufbauen und skalieren, da du Code wiederverwenden kannst.
In diesem Abschnitt bekommst du einen Überblick über eines der populärsten Web-Scraping-Tools, BeautifulSoup, und wie es sich mit Scrapy vergleichen lässt.
Scrapy ist ein Python-Framework für Web Scraping und liefert ein Komplettpaket, ohne dass du dich um Code‑Wartung kümmern musst.
Beautiful Soup wird ebenfalls häufig für Web Scraping eingesetzt. Es ist ein Python-Paket zum Parsen von HTML- und XML‑Dokumenten und zum Extrahieren von Daten daraus. Es ist für Python 2.6+ und Python 3 verfügbar.
Hier die wichtigsten Unterschiede auf einen Blick:
| Scrapy | BeautifulSoup |
|---|---|
| Funktionalität | --- |
| Scrapy ist ein Rundum‑Paket: Es lädt Webseiten herunter, verarbeitet sie und speichert die Daten in Dateien oder Datenbanken. | BeautifulSoup ist primär ein HTML‑/XML‑Parser und benötigt zusätzliche Bibliotheken wie requests, urlib2, um URLs zu öffnen und Ergebnisse zu speichern [6] |
| Lernkurve | --- |
| Scrapy ist ein echtes Kraftpaket fürs Web Scraping und bietet viele Wege, eine Seite zu scrapen. Das erfordert etwas mehr Einarbeitung, aber sobald du es beherrschst, baust und startest du Crawler mit einem einzigen Befehl. Um Scrapy wirklich zu meistern, brauchst du etwas Übung und Zeit. | BeautifulSoup ist für Einsteigerinnen und Einsteiger relativ leicht zu verstehen und eignet sich hervorragend für kleine Aufgaben. |
| Geschwindigkeit und Last | --- |
Scrapy bewältigt große Jobs mühelos. Je nach Umfang kann es eine Gruppe von URLs in weniger als einer Minute crawlen – sehr effizient, da es Twister nutzt, das für asynchrone (nicht blockierende) Parallelität sorgt. |
BeautifulSoup eignet sich effizient für einfache Scraping‑Jobs, ist aber ohne multiprocessing langsamer als Scrapy. |
| Funktionalität erweitern | --- |
| Scrapy bietet Item Pipelines, mit denen du Daten validieren, bereinigen und in eine Datenbank speichern kannst. Mit Spider Contracts testest du deine Spiders. Außerdem kannst du generische und tiefe Crawler bauen und Variablen wie Retries, Weiterleitungen u. v. m. steuern. | Wenn dein Projekt wenig Logik braucht, ist BeautifulSoup eine gute Wahl. Für mehr Anpassung – etwa Proxys, Cookie‑Handling und Datenpipelines – ist Scrapy die bessere Option. |
Info: Synchron bedeutet, dass ein Job erst enden muss, bevor der nächste startet. Asynchron heißt, du kannst schon mit dem nächsten beginnen, bevor der vorherige fertig ist.
Hier findest du ein spannendes DataCamp‑BeautifulSoup‑Tutorial zum Einstieg.

Wenn Python 3.0 (oder höher) installiert ist und du Anaconda nutzt, kannst du scrapy mit conda installieren. Gib folgenden Befehl in der Anaconda‑Eingabeaufforderung ein:
conda install -c conda-forge scrapy
Wie du Anaconda installierst, zeigen dir diese DataCamp‑Anleitungen für Mac und Windows.
Alternativ nutzt du den Python‑Paketinstaller pip. Das funktioniert unter Linux, Mac und Windows:
pip install scrapy
Scrapy bietet außerdem eine interaktive Umgebung namens Scrapy Shell, mit der Entwickler Annahmen über das Verhalten einer Website testen können. Nehmen wir die Tablet‑Kategorie auf der E‑Commerce‑Seite AliExpress. Mit der Scrapy Shell siehst du, welche Komponenten die Seite zurückliefert und wie du sie für deine Zwecke nutzt.
Öffne die Kommandozeile und gib Folgendes ein:
scrapy shell
Wenn du Anaconda verwendest, kannst du den Befehl auch in der Anaconda‑Eingabeaufforderung ausführen. Die Ausgabe sieht in etwa so aus:

Nun startest du in der Scrapy Shell mit dem Befehl fetch einen Crawler auf der Webseite. Ein Crawler oder Spider läuft über eine Seite und lädt Text sowie Metadaten herunter.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Hinweis: Setze URLs immer in Anführungszeichen, einfache oder doppelte funktionieren.

Der Crawler gibt eine response zurück, die du mit dem Shell‑Befehl view(response) ansehen kannst:
view(response)
Die Webseite öffnet sich im Standardbrowser.

Den Roh‑HTML‑Code siehst du mit folgendem Befehl in der Scrapy Shell:
print(response.text)

Du siehst das Skript, das die Seite erzeugt. Es ist derselbe Inhalt, den du bekommst, wenn du auf einer Seite mit der rechten Maustaste ins Leere klickst und Seitenquelltext anzeigen auswählst. Da du nur die relevanten Informationen brauchst, untersuchst du mit den Entwicklertools des Browsers das gewünschte Element. Nehmen wir folgende Elemente:
Klicke mit der rechten Maustaste auf das gewünschte Element und dann auf inspect wie hier:

Die Entwicklertools helfen dir beim Web Scraping enorm. Du siehst, dass es sich um ein <a>-Tag mit der class product handelt und der Text den Produktnamen enthält:

Du kannst über Attributwerte oder CSS‑Selektoren wie Klassen extrahieren. Schreibe Folgendes in die Scrapy Shell, um den Produktnamen zu ziehen:
response.css(".product::text").extract_first()
Die Ausgabe ist:

extract_first() gibt das erste Element zurück, das dem CSS‑Selektor entspricht. Wenn du alle Produktnamen extrahieren willst, nutze extract():
response.css(".product::text").extract()

Der folgende Code extrahiert die Preisspannen der Produkte:
response.css(".value::text").extract()

Analog kannst du die Anzahl der Bestellungen und den Namen des Shops versuchen.
XPath ist eine Abfragesprache zum Auswählen von Knoten in einem XML‑Dokument [7]. Du kannst damit durch XML‑Dokumente navigieren. Unter der Haube nutzt Scrapy XPath, um HTML‑Elemente anzusteuern. Die oben genutzten CSS‑Selektoren werden ebenfalls in XPath übersetzt – CSS ist aber in vielen Fällen einfacher. Trotzdem solltest du wissen, wie XPath in Scrapy funktioniert.
Wechsle in deine Scrapy Shell und schreibe wie zuvor fetch(https://pt.aliexpress.com/category/201005406/special-store.html/). Probiere dann diese Snippets aus [3]:
response.xpath('/html').extract()
Damit siehst du den gesamten Code unter dem <html>-Tag. / bedeutet direktes Kind des Knotens. Wenn du die <div>-Tags unter html erhalten willst, schreibst du [3]:
response.xpath('/html//div').extract()
Für XPath musst du die Bedeutung von / und // verstehen, um durch Kind‑ und Nachfahrenknoten zu navigieren. Hier ist ein hilfreiches Tutorial zu XPath‑Knoten sowie einige Beispiele.
Wenn du alle <div>-Tags holen willst, geht das auch ohne /html [3]:
response.xpath("//div").extract()
Du kannst weiter filtern, indem du von bestimmten Knoten aus startest und über Attribute samt Werten zu deinen Zielknoten navigierst. Unten siehst du die Syntax für Klassen und deren Werte.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Nutze text(), um allen Text innerhalb von Knoten zu extrahieren.
Betrachte den folgenden HTML‑Code:

Du möchtest den Text im <a>-Tag erhalten, einem Kindknoten des <div> mit den Klassen site-notice-container container. Das geht so:
response.xpath('//div[@class=\"site-notice-container container\"]/a[@class=\"notice-close\"]/text()').extract()

Mit Web Scraping kannst du z. B. einen Aggregator bauen, um Daten zu vergleichen. Willst du etwa ein Tablet kaufen und Produkte samt Preisen vergleichen, kannst du die gewünschten Seiten crawlen und die Daten in eine Excel‑Datei speichern. Hier scrapest du Informationen zu Tablets von aliexpress.com.
Jetzt erstellst du einen eigenen Spider für dieselbe Seite. Zuerst brauchst du ein Scrapy‑Projekt, in dem dein Code und die Ergebnisse liegen. Gib in der Kommandozeile oder Anaconda‑Eingabeaufforderung Folgendes ein:
scrapy startproject aliexpress

Dadurch wird ein Ordner in deiner Standard‑Python‑ oder Anaconda‑Installation angelegt. aliexpress ist der Ordnername – du kannst jeden beliebigen wählen. Du kannst den Inhalt im Explorer ansehen. So ist die Struktur:

| Datei/Ordner | Zweck |
|---|---|
| scrapy.cfg | Deploy‑Konfigurationsdatei |
| aliexpress/ | Python‑Modul des Projekts, hier importierst du deinen Code |
__init.py__ |
Initialisierungsdatei |
| items.py | Datei für Project Items |
| pipelines.py | Datei für Project Pipelines |
| settings.py | Datei für Projekteinstellungen |
| spiders/ | Verzeichnis, in das du später deine Spiders legst |
__init.py__ |
Initialisierungsdatei |
Nachdem das Projekt erstellt ist, wechselst du in das neue Verzeichnis und gibst Folgendes ein:
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Dadurch wird im Verzeichnis spiders eine Vorlage namens aliexpress_tablets.py angelegt. Der Code darin sieht so aus:
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
Im obigen Code siehst du name, allowed_domains, start_urls und die Funktion parse.
scrapy crawl name_of_spider.start_urls, sonst erhältst du Warnungen.response (wie in der Scrapy Shell) wird an diese Funktion übergeben, und du schreibst darin deinen Extraktions‑Code.Info: Du kannst BeautifulSoup innerhalb der Funktion parse() eines Scrapy‑Spiders verwenden, um das HTML‑Dokument zu parsen.
Hinweis: Du kannst Daten über CSS‑Selektoren per response.css() wie im Scrapy‑Shell‑Abschnitt extrahieren oder über XPath (XML), um Kind‑Elemente anzusprechen. Ein Beispiel für response.xpath() siehst du gleich im bearbeiteten pass()-Block.
Als Nächstes passt du die Datei aliexpress_tablet.py an. Ich habe eine weitere URL in start_urls ergänzt. Außerdem fügst du die Extraktionslogik in den pass()-Block ein:
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Info: zip() nimmt n Iterables und gibt eine Liste von Tupeln zurück. Das i‑te Element jedes Tupels wird aus dem i‑ten Element der jeweiligen Iterables gebildet [8].
Das Schlüsselwort yield wird in Generatorfunktionen verwendet. Eine Generatorfunktion ähnelt einer normalen Funktion, nutzt aber yield statt return. Wenn die aufrufende Funktion einen Wert benötigt, liefert yield ihn zurück, die Funktion behält dabei ihren lokalen Zustand und macht danach genau dort weiter. Hier übergibt yield das erzeugte Dictionary an Scrapy, das es weiterverarbeitet und speichert.
Jetzt kannst du den Spider starten:
scrapy crawl aliexpress_tablets
In der Konsole siehst du eine lange Ausgabe wie hier:


Für weitere Analysen brauchst du die Daten oft als CSV oder JSON. In diesem Abschnitt lernst du, wie du CSV‑ und JSON‑Dateien speicherst.
Um eine CSV zu speichern, öffne settings.py im Projektverzeichnis und ergänze:
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Speichere settings.py und führe im Projektverzeichnis erneut scrapy crawl aliexpress_tablets aus.

Die CSV sieht so aus:

Hinweis: Bei jedem Lauf hängt Scrapy neue Daten an die Datei an.
     + JSON
     + CSV
     + JSON Lines
     + XML
Scrapys Feed‑Export kann zudem einen Zeitstempel und den Spidernamen in den Dateinamen einfügen – ideal, um Ordner oder Dateien eindeutig zu benennen.
%(time)s: Wird beim Erstellen des Feeds durch einen Zeitstempel ersetzt [5]%(name)s: Wird durch den Spidernamen ersetzt [5]Beispiel:
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
Die Feed‑Einstellungen in settings.py gelten für alle Spiders im Projekt. Du kannst aber auch spzielfische Einstellungen für einen einzelnen Spider setzen, die settings.py überschreiben.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url liefert die URL der Seite, aus der die Response stammt. Nach dem Start mit scrapy crawl aliexpress_tablets kannst du die JSON‑Datei ansehen:

Dir ist sicher aufgefallen, dass in start_urls zwei Links stehen. Der zweite ist Seite 2 derselben Ergebnisliste. Es ist unpraktisch, alle Links manuell zu ergänzen. Ein Crawler sollte sich selbst durch alle Seiten hangeln können – in start_urls steht nur der Einstiegspunkt.
Wenn eine Seite Folgeseiten hat, gibt es am Ende oft eine Navigation zum Vor‑ und Zurückblättern. Im Beispiel in diesem Tutorial sieht sie so aus:

Der dazugehörige Code sieht so aus:

Du siehst ein <span>-Tag mit der Klasse .ui-pagination-active für die aktuelle Seite. Darauf folgen mehrere <a>-Tags mit den Links zur nächsten Seite. Du musst also stets die <a>-Tags finden, die auf dieses <span> folgen. Hier kommt etwas CSS ins Spiel: Du brauchst den Geschwister‑Knoten, nicht den Kind‑Knoten, also einen Selektor, der <a>-Tags nach dem <span> mit Klasse .ui-pagination-active findet.
Merke: Jede Webseite hat ihre eigene Struktur. Du musst kurz analysieren, wie du an das gewünschte Element gelangst. Probiere Selektoren immer zuerst mit response.css(SELECTOR) in der Scrapy Shell aus, bevor du sie in den Code schreibst.
Ändere deine aliexpress_tablets.py wie folgt:
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
Im obigen Code:
Extrahierst du zunächst den Link zur nächsten Seite mit next_page = response.css(NEXT_PAGE_SELECTOR).extract_first(). Wenn next_page einen Link enthält und nicht leer ist, springt der Code in den if-Block.
response.urljoin(next_page): Die Methode parse() baut damit eine neue URL und erstellt eine neue Request, die anschließend mit dem angegebenen Callback versendet wird [9].
Nach Erhalt der neuen URL wird diese Seite gecrawlt, der for-Block ausgeführt und erneut nach der nächsten Seite gesucht – bis kein weiterer Link gefunden wird.
Jetzt kannst du dich zurücklehnen und zusehen, wie dein Spider alle Seiten scrapet. Der obige Spider extrahiert Daten von sämtlichen Folgeseiten – das ist eine Menge! Aber dein Spider schafft das. Unten siehst du, dass die Datei bereits 1,1 MB groß ist.

In diesem Tutorial hast du Scrapy kennengelernt, den Vergleich zu BeautifulSoup gesehen, die Scrapy Shell ausprobiert und eigene Spiders geschrieben. Scrapy nimmt dir viel Entwicklungsarbeit ab – von der Projekterstellung bis zum Umgang mit doppelten URLs – und liefert Unterstützung für alle gängigen Datenformate, die du anschließend in anderen Programmen weiterverarbeiten kannst. Dieses Tutorial macht dich fit, um ganze Gruppen von Webseiten effizient zu scrapen. Um Scrapy wirklich zu meistern, solltest du dir nach und nach die weiteren Funktionen anschauen.
Fürs Vertiefen lohnt sich die offizielle Scrapy‑Dokumentation.
Und vergiss nicht den DataCamp‑Kurs Web Scraping with Python.
Python-Kurse
Kurs
Kurs
Kurs