Curso
Raspagem da Web em Python
4 h
94.1K
Se você quer uma visão geral de web scraping em Python, faça o curso Web Scraping with Python da DataCamp.
Neste tutorial, você vai aprender a usar o Scrapy, um framework Python com o qual dá para lidar com grandes volumes de dados! Você vai aprender Scrapy construindo um web scraper para o AliExpress.com, um site de e-commerce. Vamos colocar a mão na massa!
Ter conhecimentos básicos de HTML e CSS vai ajudar bastante a acompanhar este tutorial com mais facilidade e rapidez. Leia este artigo para relembrar HTML e CSS.
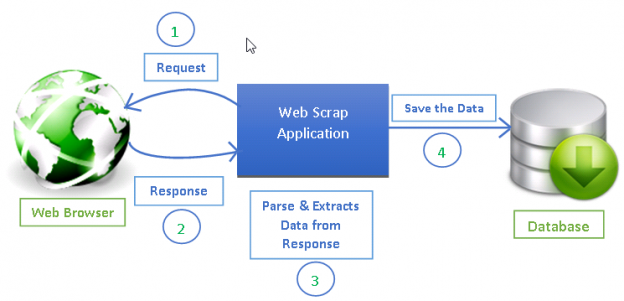
O web scraping se tornou uma forma eficaz de extrair informações da web para tomada de decisão e análise. Hoje ele é parte essencial do kit de ferramentas de ciência de dados. Cientistas de dados devem saber coletar dados de páginas web e armazená-los em diferentes formatos para análises posteriores.
Qualquer página que você vê na internet pode ser rastreada para coletar informações e tudo o que é visível em uma página pode ser extraído [2]. Cada página tem sua própria estrutura e elementos, por isso você precisa escrever seus crawlers/spiders de acordo com a página que está extraindo.
O Scrapy oferece um framework poderoso para extrair dados, processá-los e depois salvá-los.
O Scrapy usa spiders, que são crawlers independentes com um conjunto de instruções [1]. No Scrapy é mais fácil criar e escalar projetos grandes de crawling, permitindo que desenvolvedores reutilizem seu código.
Nesta seção, você vai ver uma visão geral de uma das ferramentas de web scraping mais populares, o BeautifulSoup, e sua comparação com o Scrapy.
Scrapy é um framework Python para web scraping que oferece um pacote completo para desenvolvedores, sem se preocupar em manter muita infraestrutura de código.
Beautiful Soup também é amplamente usado para web scraping. É um pacote Python para fazer parsing de documentos HTML e XML e extrair dados deles. Está disponível para Python 2.6+ e Python 3.
Veja algumas diferenças entre eles, de forma resumida:
| Scrapy | BeautifulSoup |
|---|---|
| Funcionalidade | --- |
| Scrapy é um pacote completo para baixar páginas, processá-las e salvar em arquivos e bancos de dados | BeautifulSoup é basicamente um parser de HTML e XML e requer bibliotecas adicionais como requests, urlib2 para abrir URLs e armazenar o resultado [6] |
| Curva de aprendizado | --- |
| Scrapy é uma potência para web scraping e oferece várias formas de extrair uma página. Exige mais tempo para aprender e entender como o Scrapy funciona, mas, depois que você pega o jeito, facilita muito criar crawlers e executá-los com um único comando. Tornar-se expert em Scrapy pode exigir prática e tempo para aprender todas as funcionalidades. | BeautifulSoup é relativamente fácil de entender para iniciantes em programação e resolve tarefas menores rapidinho |
| Velocidade e carga | --- |
Scrapy resolve trabalhos grandes com facilidade. Consegue rastrear um conjunto de URLs em questão de um minuto, dependendo do tamanho do grupo, e faz isso de forma fluida, pois utiliza Twister, que funciona assincronamente (non-blocking) para concorrência. |
BeautifulSoup é eficiente para tarefas simples de scraping. É mais lento que o Scrapy se você não usar multiprocessing. |
| Extensibilidade | --- |
| Scrapy oferece pipelines de itens que permitem escrever funções no seu spider para processar dados, como validar, remover e salvar em banco. Também fornece contratos de spider para testar seus spiders e permite criar crawlers genéricos e profundos. Dá para gerenciar várias variáveis, como tentativas, redirecionamento e muito mais. | Se o projeto não exige muita lógica, BeautifulSoup dá conta do recado. Mas se você precisa de bastante customização, como proxies, gerenciamento de cookies e pipelines de dados, Scrapy é a melhor opção. |
Informação: Síncrono significa que você precisa esperar um trabalho terminar para iniciar outro; assíncrono significa que dá para começar outra tarefa antes da anterior finalizar
Aqui vai um tutorial de BeautifulSoup da DataCamp para você aprender mais.

Com o Python 3.0 (ou superior) instalado, se você usa Anaconda, pode usar o conda para instalar o scrapy. Digite o comando abaixo no prompt do Anaconda:
conda install -c conda-forge scrapy
Para instalar o Anaconda, confira estes tutoriais da DataCamp para Mac e Windows.
Como alternativa, você pode usar o instalador de pacotes do Python, o pip. Funciona em Linux, Mac e Windows:
pip install scrapy
O Scrapy também oferece um shell de crawling chamado Scrapy Shell, que os desenvolvedores podem usar para testar hipóteses sobre o comportamento de um site. Vamos pegar uma página de tablets no site de e-commerce AliExpress. Você pode usar o Scrapy Shell para ver que componentes a página retorna e como aproveitá-los conforme sua necessidade.
Abra a linha de comando e digite o seguinte:
scrapy shell
Se você usa Anaconda, pode digitar o comando acima no prompt do Anaconda também. A saída na linha de comando ou no prompt do Anaconda será algo assim:

Você precisa executar um crawler na página usando o comando fetch no Scrapy Shell. Um crawler ou spider percorre a página baixando seu texto e metadados.
fetch(https://pt.aliexpress.com/category/201005406/special-store.html)
Observação: sempre coloque a URL entre aspas; tanto aspas simples quanto duplas funcionam

O crawler retorna uma response, que pode ser visualizada com o comando view(response) no shell:
view(response)
E a página será aberta no navegador padrão.

Você pode ver o HTML bruto com o seguinte comando no Scrapy Shell:
print(response.text)

Você verá o script que gera a página. É o mesmo conteúdo que aparece quando você clica com o botão direito em uma área em branco da página e escolhe exibir código-fonte ou ver código-fonte da página. Como você precisa apenas das informações relevantes desse script inteiro, use as ferramentas de desenvolvedor do navegador para inspecionar o elemento desejado. Vamos pegar os seguintes elementos:
Clique com o botão direito no elemento desejado e selecione inspecionar, como abaixo:

As ferramentas de desenvolvedor do navegador ajudam muito no web scraping. Você pode ver que é uma tag <a> com uma class product e o texto contém o nome do produto:

Você pode extrair usando atributos do elemento ou o seletor CSS, como classes. Digite o seguinte no Scrapy Shell para extrair o nome do produto:
response.css(".product::text").extract_first()
A saída será:

extract_first() extrai o primeiro elemento que atende ao seletor CSS. Se você quiser extrair todos os nomes dos produtos, use extract():
response.css(".product::text").extract()

O código a seguir vai extrair a faixa de preço dos produtos:
response.css(".value::text").extract()

Da mesma forma, você pode tentar com o número de pedidos e o nome da loja.
XPath é uma linguagem de consulta para selecionar nós em um documento XML [7]. Você pode navegar por um documento XML usando XPath. Por baixo dos panos, o Scrapy usa XPath para navegar pelos itens do documento HTML. Os seletores CSS usados acima também são convertidos para XPath, mas em muitos casos CSS é mais fácil de usar. Ainda assim, você deve saber como o XPath funciona no Scrapy.
Vá ao seu Scrapy Shell e digite fetch(https://pt.aliexpress.com/category/201005406/special-store.html/) como antes. Teste os trechos de código abaixo [3]:
response.xpath('/html').extract()
Isso mostrará todo o código dentro da tag <html>. / significa filho direto do nó. Se você quiser obter as tags <div> sob a tag html, escreva [3]:
response.xpath('/html//div').extract()
No XPath, você precisa entender o uso de / e // para navegar por nós filhos e descendentes. Aqui há um tutorial útil sobre nós em XPath e alguns exemplos para praticar.
Se você quiser obter todas as tags <div>, pode fazer um drill down sem usar /html [3]:
response.xpath("//div").extract()
Você pode filtrar ainda mais os nós de partida e chegar aos nós desejados usando atributos e seus valores. Abaixo está a sintaxe para usar classes e seus valores.
response.xpath("//div[@class='quote']/span[@class='text']").extract()
response.xpath("//div[@class='quote']/span[@class='text']/text()").extract()
Use text() para extrair todo o texto dentro dos nós
Considere o HTML a seguir:

Você quer obter o texto dentro da tag <a>, que é filha do <div> com as classes site-notice-container container. Você pode fazer assim:
response.xpath('//div[@class=\"site-notice-container container\"]/a[@class=\"notice-close\"]/text()').extract()

Você pode usar web scraping para criar um agregador e comparar dados. Por exemplo, se quer comprar um tablet e comparar produtos e preços, dá para rastrear as páginas desejadas e guardar tudo em um arquivo do Excel. Aqui você vai fazer scraping do aliexpress.com para obter informações de tablets.
Agora, vamos criar um spider customizado para a mesma página. Primeiro, crie um projeto Scrapy onde seu código e resultados serão armazenados. Digite o seguinte na linha de comando ou no prompt do Anaconda.
scrapy startproject aliexpress

Isso criará uma pasta no seu ambiente padrão do Python ou do Anaconda. aliexpress será o nome da pasta. Você pode dar qualquer nome. Você pode ver o conteúdo diretamente no explorador de arquivos. A estrutura da pasta é a seguinte:

| arquivo/pasta | Finalidade |
|---|---|
| scrapy.cfg | arquivo de configuração de deploy |
| aliexpress/ | módulo Python do projeto; é daqui que você vai importar seu código |
__init.py__ |
arquivo de inicialização |
| items.py | arquivo de itens do projeto |
| pipelines.py | arquivo de pipelines do projeto |
| settings.py | arquivo de configurações do projeto |
| spiders/ | diretório onde você vai colocar seus spiders |
__init.py__ |
arquivo de inicialização |
Depois de criar o projeto, mude para o diretório recém-criado e digite o seguinte comando:
[scrapy genspider aliexpress_tablets](https://pt.aliexpress.com/category/201005406/special-store.html)

Isso cria um arquivo de template chamado aliexpress_tablets.py no diretório spiders, conforme discutido acima. O código nesse arquivo é o seguinte:
import scrapy

class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    def parse(self, response):
         pass
No código acima você vê name, allowed_domains, start_urls e a função parse.
scrapy crawl name_of_spider.response (usada no Scrapy Shell) retornada pelo crawling é passada para essa função, e é dentro dela que você escreve o código de extração!Informação: você pode usar BeautifulSoup dentro da função parse() do spider Scrapy para fazer parsing do documento HTML.
Observação: você pode extrair dados por seletores CSS usando response.css(), como vimos na seção do Scrapy Shell, mas também por XPath (XML), que permite acessar elementos filhos. Você verá o exemplo de response.xpath() no código editado na função pass().
Você vai alterar o arquivo aliexpress_tablet.py. Adicionei outra URL em start_urls. Você pode incluir a lógica de extração na função pass() como abaixo:
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']


    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info
Informação: zip() recebe n iteráveis e retorna uma lista de tuplas. O i-ésimo elemento da tupla é criado usando o i-ésimo elemento de cada iterável. [8]
A palavra-chave yield é usada quando você define uma função geradora. Uma função geradora é como uma função normal, exceto que usa yield em vez de return. O yield é usado quando a função chamadora precisa de um valor, e a função que contém yield mantém seu estado local e continua a execução de onde parou após entregar o valor à chamadora. Aqui, yield entrega o dicionário gerado ao Scrapy, que vai processá-lo e salvá-lo!
Agora você pode executar o spider:
scrapy crawl aliexpress_tablets
Você verá uma saída extensa na linha de comando, como abaixo:


Você vai precisar dos dados em CSV ou JSON para poder usá-los em análises. Nesta parte do tutorial, você vai ver como salvar arquivos CSV e JSON com esses dados.
Para salvar um CSV, abra o settings.py no diretório do projeto e adicione as linhas abaixo:
FEED_FORMAT="csv"
FEED_URI="aliexpress.csv"
Depois de salvar o settings.py, execute novamente scrapy crawl aliexpress_tablets no diretório do seu projeto.

O arquivo CSV ficará assim:

Observação: toda vez que você executar o spider, ele vai anexar dados ao arquivo.
     + JSON
     + CSV
     + JSON Lines
     + XML
O Feed Export do Scrapy também pode adicionar timestamp e o nome do spider ao nome do arquivo, ou você pode usar esses placeholders para indicar um diretório onde deseja salvar.
%(time)s: é substituído por um timestamp quando o feed está sendo criado [5]%(name)s: é substituído pelo nome do spider [5]Por exemplo:
ftp://user:password@ftp.example.com/scraping/feeds/%(name)s/%(time)s.json
As alterações de Feed que você fizer em settings.py se aplicam a todos os spiders do projeto. Você também pode definir configurações personalizadas para um spider específico, que substituem as configurações do settings.py.
# -*- coding: utf-8 -*-
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html',
                 'https://www.aliexpress.com/category/200216607/tablets/2.html?site=glo&g=y&tag=']

    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.json",
                       'FEED_FORMAT': 'json'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to Scrapy
            yield scraped_info
response.url retorna a URL da página de onde a response foi gerada. Depois de executar o crawler com scrapy crawl aliexpress_tablets, você pode ver o arquivo JSON:

Você deve ter reparado que há dois links em start_urls. O segundo link é a página 2 dos resultados de tablets. Fica inviável adicionar todos os links. Um crawler deve ser capaz de navegar sozinho por todas as páginas, e apenas o ponto de partida deve ser informado em start_urls.
Se uma página tem páginas seguintes, você verá um paginador no fim que permite avançar e voltar. No caso que estamos implementando neste tutorial, ele aparece assim:

O código fica assim:

Como você pode ver, há uma tag <span> com a classe .ui-pagination-active indicando a página atual e, em seguida, várias tags <a> com os links para as próximas páginas. Sempre será necessário pegar as tags <a> que vêm depois dessa tag <span>. Entra aqui um pouquinho de CSS! Neste caso, você precisa do nó-irmão, não do nó-filho. Então, crie um seletor CSS que diga ao crawler para encontrar as tags <a> que vêm depois do <span> com a classe .ui-pagination-active.
Lembre-se: cada página tem sua própria estrutura. Você vai precisar estudar um pouco como obter o elemento desejado. Sempre teste response.css(SELETOR) no Scrapy Shell antes de escrever no código.
Altere seu aliexpress_tablets.py como abaixo:
import scrapy


class AliexpressTabletsSpider(scrapy.Spider):
    name = 'aliexpress_tablets'
    allowed_domains = ['aliexpress.com']
    start_urls = ['https://www.aliexpress.com/category/200216607/tablets.html']


    custom_settings={ 'FEED_URI': "aliexpress_%(time)s.csv",
                       'FEED_FORMAT': 'csv'}

    def parse(self, response):

        print("procesing:"+response.url)
        #Extract data using css selectors
        product_name=response.css('.product::text').extract()
        price_range=response.css('.value::text').extract()
        #Extract data using xpath
        orders=response.xpath("//em[@title='Total Orders']/text()").extract()
        company_name=response.xpath("//a[@class='store $p4pLog']/text()").extract()

        row_data=zip(product_name,price_range,orders,company_name)

        #Making extracted data row wise
        for item in row_data:
            #create a dictionary to store the scraped info
            scraped_info = {
                #key:value
                'page':response.url,
                'product_name' : item[0], #item[0] means product in the list and so on, index tells what value to assign
                'price_range' : item[1],
                'orders' : item[2],
                'company_name' : item[3],
            }

            #yield or give the scraped info to scrapy
            yield scraped_info


            NEXT_PAGE_SELECTOR = '.ui-pagination-active + a::attr(href)'
            next_page = response.css(NEXT_PAGE_SELECTOR).extract_first()
            if next_page:
                yield scrapy.Request(
                response.urljoin(next_page),
                callback=self.parse)
No código acima:
você primeiro extrai o link da próxima página com next_page = response.css(NEXT_PAGE_SELECTOR).extract_first() e, se a variável next_page receber um link e não estiver vazia, entra no bloco if.
response.urljoin(next_page): o método parse() usa esse método para montar uma nova URL e criar uma nova requisição, que será enviada depois ao callback. [9]
Depois de receber a nova URL, ele faz scraping desse link, executa o corpo do for e novamente procura a próxima página. Isso continua até não haver mais link de próxima página.
Aqui você pode sentar e assistir seu spider varrendo todas as páginas. O spider acima vai extrair de todas as páginas seguintes. Vai ser muito scraping! Mas seu spider dá conta! Abaixo você vê que o arquivo chegou a 1,1 MB.

Neste tutorial, você aprendeu sobre o Scrapy, como ele se compara ao BeautifulSoup, o Scrapy Shell e como escrever seus próprios spiders no Scrapy. O Scrapy assume a parte pesada do código para você: desde criar arquivos e pastas do projeto até lidar com URLs duplicadas, ele permite um scraping poderoso em minutos e oferece suporte a todos os formatos de dados comuns que você pode usar em outros programas. Este tutorial certamente vai ajudar você a entender o Scrapy, seu framework e o que dá para fazer com ele. Para dominar o Scrapy, explore todas as funcionalidades incríveis que ele oferece, mas aqui você já saiu capaz de extrair grupos de páginas de forma eficiente.
Para se aprofundar, consulte a documentação oficial do Scrapy.
E não deixe de conferir o curso Web Scraping with Python da DataCamp.
Cursos relacionados a Python
Curso
Curso
Curso
blog
DataCamp Team
5 min
blog
blog
Javier Canales Luna
13 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Oluseye Jeremiah
15 min
Tutorial
Vidhi Chugh
15 min