

¿Qué es PySpark?
PySpark es la API de Python para Apache Spark. Tu código en Python describe las transformaciones que quieres, y el motor de Spark, que se ejecuta en la Máquina Virtual de Java (JVM), las planifica y ejecuta en todo el clúster. Obtienes la ejecución distribuida de Spark sin escribir Scala ni Java.
Las personas de data science usan PySpark para limpiar y agregar grandes datasets; quienes trabajan en ingeniería de datos lo usan para pipelines ETL; y ambos usan pyspark.ml para entrenar modelos con datos que no caben en una sola máquina. Si hoy haces la mayor parte de tu trabajo en pandas, la API de DataFrame te resultará familiar.
Cuándo usar PySpark en lugar de pandas
PySpark compensa cuando los datos superan una máquina; por debajo de ese umbral, pandas suele ser más rápido porque no tiene el arranque de la JVM ni la sobrecarga de planificación de tareas.
| Funcionalidad | pandas | PySpark |
|---|---|---|
| Tamaño de los datos | Limitado por la RAM de una sola máquina | Limitado por la memoria y el disco combinados del clúster |
| Ejecución | Ansiosa, mayoritariamente en un solo núcleo | Perezosa, en paralelo entre núcleos o máquinas |
| Coste de arranque | Ninguno | Unos segundos para iniciar la JVM y la SparkSession |
| Datos en streaming | No soportado | Structured Streaming |
| Machine learning | Ecosistema scikit-learn | pyspark.ml (distribuido) |
| Tolerancia a fallos | Ninguna; un fallo pierde el trabajo | Las particiones perdidas se recomputan a partir de su linaje |
Mi regla: si los datos caben en memoria con margen y el trabajo corre en un portátil, quédate en pandas. Pásate a PySpark cuando luches con errores de memoria, o cuando el trabajo vaya a ejecutarse en un clúster o una plataforma como Databricks.
Cómo instalar PySpark
PySpark se instala desde PyPI con un solo comando pip que incluye el runtime de Spark, así que no necesitas una descarga separada de Spark o Hadoop para trabajar en local. Antes de ejecutarlo, comprueba dos requisitos previos.
Requisitos previos
Según la guía oficial de instalación, PySpark 4.3 requiere:
- Python 3.11 o posterior. PySpark 4.3 dejó de soportar Python 3.10; si necesitas una versión más nueva, mira nuestra guía de configuración de Python.
- Java 17 o posterior (Spark 4.3 funciona con Java 17, 21 y 25) con la variable de entorno
JAVA_HOMEapuntando a esa instalación. Nuestra guía de instalación de Java te acompaña en cada sistema operativo.
Puedes comprobar ambos desde una terminal:
python3 --version # Python 3.11 o posterior
java -version # openjdk version "17" o posteriorSi trabajas en DataLab o Databricks, PySpark ya está instalado y puedes saltar al dataset.
Instalar PySpark con pip
Te recomiendo un entorno virtual para que las dependencias de PySpark no choquen con otros proyectos:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0En Windows, usa python en lugar de python3, y activa el entorno con pyspark-env\Scripts\activate. El extra [sql] añade pandas, PyArrow y NumPy, que PySpark usa para toPandas() y UDFs de pandas. Fijo pandas<3 porque PySpark 4.3 muestra un aviso de que aún no soporta por completo pandas 3.0.
Dos errores explican la mayoría de los primeros fallos:
JAVA_GATEWAY_EXITEDo "Unable to locate a Java Runtime": falta Java o no está definidaJAVA_HOME.PYTHON_VERSION_MISMATCH: los procesos worker de Spark tomaron un Python distinto al de tu script. DefinePYSPARK_PYTHONal intérprete de tu entorno, por ejemploexport PYSPARK_PYTHON=$(which python).
Para pasos específicos por sistema operativo, incluido Windows, consulta nuestra guía de instalación de PySpark.
Obtener el dataset
Los ejemplos usan un dataset de e‑commerce con 541.909 transacciones de un minorista online del Reino Unido, de diciembre de 2010 a diciembre de 2011. Cada fila es una línea de producto en una factura, con 8 columnas:
InvoiceNo: número de factura (las que empiezan por "C" son cancelaciones)StockCodeyDescription: código y nombre del productoQuantityyUnitPrice: unidades compradas y precio por unidad, en libras esterlinasInvoiceDate: fecha y hora de la compraCustomerID: identificador del cliente (falta en algunas filas)Country: país del cliente
Puedes descargarlo como datacamp_ecommerce.csv desde la página del dataset en DataLab. Es el dataset Online Retail del UCI Machine Learning Repository, así que también puedes construir el mismo archivo desde la fuente pública (requiere pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Igualamos el formato de fecha del archivo de DataLab, p. ej., 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)Leer el Excel de 23 MB tarda alrededor de un minuto. Guarda el CSV en la carpeta desde la que ejecutarás el resto del código.
Crear una SparkSession
Una SparkSession es la puerta de entrada a cualquier programa en PySpark: conecta tu código en Python con el motor de Spark y crea DataFrames. Creas una por aplicación con el patrón builder:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() devuelve la sesión en ejecución si ya existe, así que es seguro llamarla dos veces en un notebook. Si lanzas Spark desde un proceso de Python normal, se ejecuta en modo local (local[*]), usando todos los núcleos de tu máquina como workers, y expone la UI de Spark en http://localhost:4040 para monitorizar los jobs. Al terminar, spark.stop() libera los recursos.
Cargar el dataset de e‑commerce
Con la sesión en marcha, podemos leer el CSV en un DataFrame. Paso un esquema explícito en vez de inferSchema=True, que hace que Spark escanee el archivo entero una vez más solo para adivinar los tipos:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)Dos detalles de ese fragmento importan:
escape='"'gestiona nombres de producto con comillas dobles repetidas, comoRECORD FRAME 7"" SINGLE SIZE. El carácter de escape por defecto en Spark es la barra invertida.- El patrón de fecha
M/d/yy H:mmcoincide con valores como12/1/10 8:26. Desde Spark 4.0, el modo ANSI SQL está activado por defecto, así queto_timestamp()lanza un errorCANNOT_PARSE_TIMESTAMPsi un valor no encaja con el patrón. UsaF.try_to_timestamp()si prefieres obtenerNULLen filas erróneas.
Para ver las primeras filas y contarlas:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909Para más opciones de lectura, como múltiples archivos, delimitadores y registros corruptos, consulta nuestro tutorial de lectura de CSV en PySpark.
RDDs vs. DataFrames
RDDs y DataFrames son las dos formas de representar datos distribuidos en PySpark, y para casi todo el código nuevo, los DataFrames son la opción adecuada.
| Abstracción | Qué es | Cuándo usarla |
|---|---|---|
| RDD (Resilient Distributed Dataset) | Colección de bajo nivel, inmutable, de objetos arbitrarios de Python, dividida en particiones | Datos no estructurados o cuando necesitas control fino del particionado |
| DataFrame | Tabla distribuida con columnas con nombre y tipo, similar a un DataFrame de pandas | Análisis, consultas SQL, ETL y machine learning |
La misma agregación (cantidad total por país) escrita de ambas formas:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD: escribes la lógica con funciones de Python
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame: declaras el resultado y Spark planifica cómo calcularlo
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+La versión con RDD ejecuta tu lambda en procesos worker de Python. La versión con DataFrame pasa por el optimizador Catalyst de Spark, que reescribe la consulta en un plan eficiente que corre dentro de la JVM, así que el código con DataFrames suele ser más rápido sin ajustar nada. El resto del tutorial usa DataFrames.
Evaluación perezosa: transformaciones vs. acciones
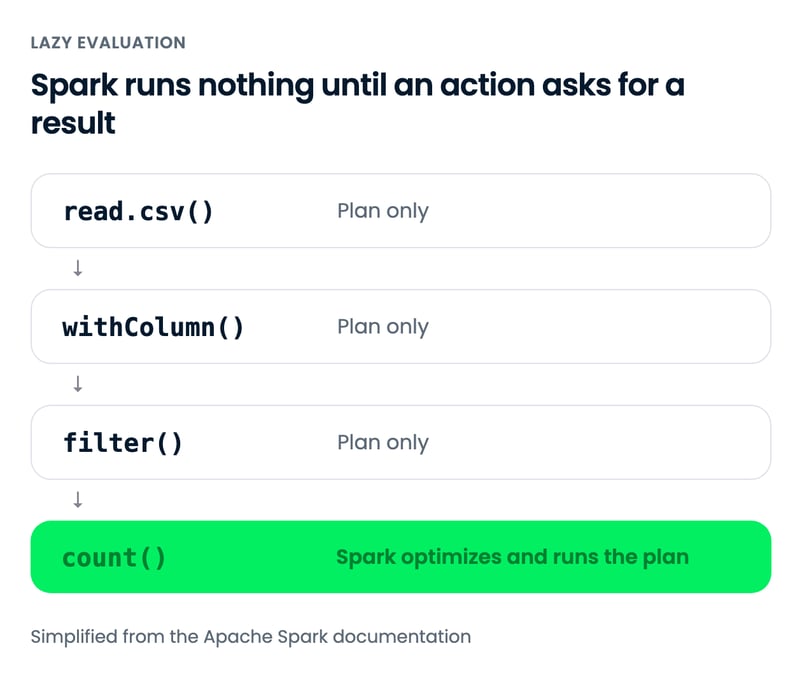
Evaluación perezosa significa que Spark no ejecuta una transformación cuando la llamas; anota el paso en un plan y ejecuta el plan completo solo cuando una acción pide un resultado.
| Transformaciones | Acciones | |
|---|---|---|
| Qué hacen | Describen un nuevo DataFrame | Devuelven un resultado o escriben datos |
| Cuándo corren | Nunca por sí solas | Al instante, disparando todas las transformaciones pendientes |
| Ejemplos | select(), filter(), withColumn(), groupBy(), join() | show(), count(), collect(), toPandas(), write |
El filtro de abajo devuelve al instante, aunque el dataset tenga más de medio millón de filas, porque aún no se ha leído nada. La llamada a count() es la que lanza un job:
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # transformación: aún sin job
print(uk_orders.count()) # acción: Spark lee el archivo ahora495478Esperar hasta una acción permite a Spark optimizar toda la cadena a la vez. explain() imprime el plan físico elegido (recortado aquí):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...La entrada PushedFilters muestra cómo Spark empuja el filtro de país hacia la lectura del archivo, de modo que se descartan las filas de otros países según se lee el CSV. Una consecuencia práctica: un error de datos dentro de una transformación, como una fecha que falla al parsearse en modo ANSI, aparece solo cuando se ejecuta la siguiente acción, varias líneas más tarde.
Operaciones comunes con DataFrames
La mayoría del código en PySpark es una cadena de cinco operaciones de DataFrame: select(), filter(), withColumn(), groupBy() y join(). Cada una devuelve un nuevo DataFrame, así que puedes encadenarlas en cualquier orden.
Seleccionar columnas con select()
select() devuelve un DataFrame solo con las columnas que indiques:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rowsFiltrar filas con filter()
filter() mantiene las filas que cumplen una condición. Este dataset mezcla ventas con cancelaciones (facturas que empiezan por "C"), cantidades negativas y filas sin cliente, así que me quedo solo con ventas válidas:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884Combina condiciones con & (and), | (or) y ~ (not), y pon cada una entre paréntesis, porque de lo contrario la precedencia de operadores en Python evaluaría & antes que >. Nuestro tutorial de filter en PySpark cubre más patrones.
Añadir columnas con withColumn()
withColumn() añade una columna, o reemplaza una con el mismo nombre. Aquí calcula el importe de cada línea:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rowsConsulta nuestro tutorial de withColumn() en PySpark para columnas condicionales con F.when().
Agregar con groupBy() y agg()
groupBy() agrupa filas por una o más columnas, y agg() calcula uno o varios resúmenes por grupo. ¿Qué países generan más ingresos?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rowsReino Unido domina, como cabría esperar de un minorista británico. Las filas más interesantes son Países Bajos e Irlanda (aparece como EIRE): 9 y 3 clientes gastan más que los 94 de Alemania, lo que sugiere compradores mayoristas.
Fíjate en que importo el módulo de funciones como F en lugar de usar from pyspark.sql.functions import *, que pisa los sum(), min() y max() incorporados de Python. Desde PySpark 4.0, ese import con comodín tampoco expone ya el nombre en camelCase antiguo countDistinct.
Nuestro tutorial de groupBy en PySpark profundiza en las agregaciones.
Unir DataFrames con join()
join() combina dos DataFrames sobre una clave común. Para etiquetar cada país con una región, uniré una pequeña tabla de referencia que a propósito deja fuera Australia:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rowsUn left join mantiene todas las filas del DataFrame izquierdo y rellena las coincidencias faltantes con NULL, por eso Australia permanece en el resultado. Un inner join (how="inner", por defecto) la eliminaría. Nuestro tutorial de joins en PySpark compara todos los tipos de join y su rendimiento.
Spark SQL en PySpark
Spark SQL te permite consultar un DataFrame con SQL estándar registrándolo como una vista temporal. Esta consulta reproduce la tabla de ingresos por país de la sección de groupBy:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+Ambas versiones compilan al mismo plan optimizado, así que ninguna es más rápida. Uso SQL para agregaciones largas que leerán analistas, y la API de DataFrame cuando necesito lógica en Python alrededor de la consulta, como construir filtros en un bucle. spark.sql() devuelve un DataFrame, así que puedes mezclar ambas libremente.
La vista temporal dura hasta que se detiene la SparkSession.
Machine learning con PySpark: un ejemplo de K‑Means
El módulo pyspark.ml de PySpark entrena modelos sobre DataFrames, y una Pipeline encadena la preparación de variables y el modelo en un único objeto que puedes ajustar y reutilizar. Para ilustrarlo, segmentaré a los clientes del minorista con K‑Means sobre recencia, frecuencia y valor monetario (RFM), una segmentación clásica en marketing:
- Recency: días desde la última compra del cliente
- Frequency: número de facturas distintas
- Monetary: importe total gastado
Construir variables RFM con groupBy()
Un único groupBy() sobre el DataFrame limpio sales_only produce las 3 variables. La recencia se mide desde el día posterior a la última factura del dataset:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+Fíjate en la columna monetary: una media de unas £2.054, una desviación estándar más de cuatro veces mayor y un máximo por encima de £280.000. K‑Means mide distancia euclídea, así que unos pocos grandes gastadores dominarían los clústeres. Tomar el logaritmo de cada variable primero comprime esa cola larga.
Escalado y clustering en una Pipeline
La Pipeline tiene 3 etapas: VectorAssembler empaqueta las variables en la única columna vector que esperan los modelos de pyspark.ml, StandardScaler las pone en la misma escala y KMeans hace el clustering. Ajusto k de 2 a 6 y puntúo cada modelo con el silhouette score, que va de −1 a 1, cuanto más alto mejor separados los clústeres:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() mantiene rfm_log en memoria, porque cada ajuste y evaluación del bucle lo vuelve a leer; sin ello, Spark recomputaría la tabla RFM desde el CSV en cada ajuste.
Elegir k y leer los segmentos
El silhouette máximo está en k = 2, pero 2 segmentos suelen separar sobre todo a clientes activos de inactivos, algo con poco juego para marketing. k = 4 puntúa igual que k = 3 y separa a los activos en grandes gastadores y recién llegados, así que lo usaré y perfilaré cada clúster:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
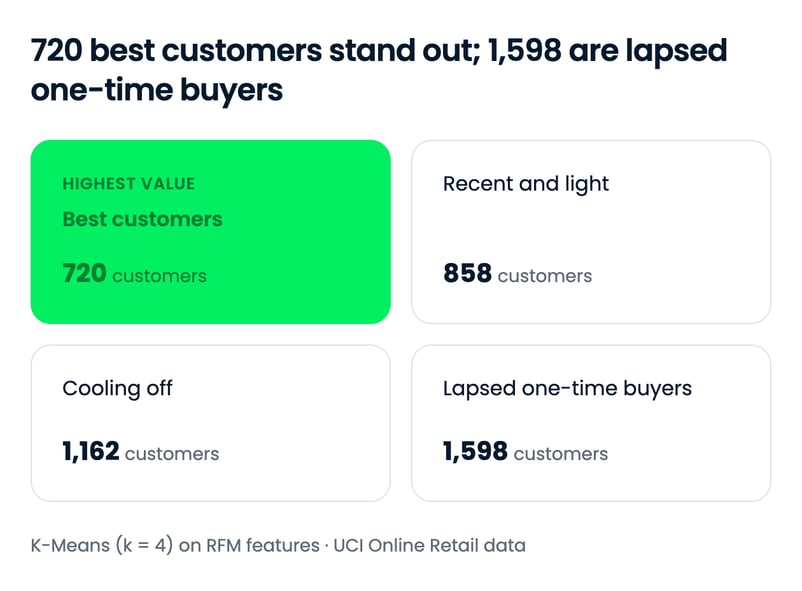
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+Los cuatro segmentos se leen con claridad:
- Clúster 1, mejores clientes (720): han comprado de media en las últimas 2 semanas, con unas 14 órdenes y más de £8.000 gastados cada uno. Aquí van acciones de retención y fidelización.
- Clúster 3, recientes y ligeros (858): activos en las últimas 3 semanas pero con solo 2 pedidos aprox. Muchos serán nuevos clientes a los que merece la pena acompañar hacia el segundo y tercer pedido.
- Clúster 2, enfriándose (1.162): gasto medio, pero unas 11 semanas desde la última compra. Una campaña de reactivación tiene mejores opciones aquí.
- Clúster 0, compradores puntuales inactivos (1.598): en su mayoría un solo pedido, alrededor de £326, hace unos 6 meses. El grupo más grande y el menos valioso.
Los números de clúster son etiquetas arbitrarias, y una semilla distinta puede reordenarlos, así que perfílalos siempre antes de nombrarlos. Para entender cómo K‑Means elige sus centroides, consulta nuestra introducción al clustering k‑means, y la referencia de la API de pyspark.ml lista todos los modelos y transformadores. Nuestro curso Machine Learning with PySpark cubre clasificación, regresión y ajuste de modelos con Pipelines.
Conclusiones
PySpark se resume en unas pocas ideas: una SparkSession para empezar, DataFrames para casi todo, transformaciones perezosas que solo corren cuando una acción necesita un resultado y la posibilidad de escribir cada consulta en Python o en SQL. Todo en este tutorial se ejecutó en modo local en un portátil, y el mismo código corre sin cambios en un clúster.
Un archivo de 541.909 filas no necesita un clúster, y pandas habría podido con él. Fue deliberado, porque los hábitos que importan con datos grandes (esquemas explícitos, filtrar cuanto antes, cachear lo que reutilizas y revisar explain()) se adquieren mejor con datos que puedes inspeccionar.
A partir de aquí, estas son las mejores próximas paradas, según tu objetivo:
- Practica la API de DataFrame con ejercicios: Introduction to PySpark
- Prepara datos reales con desorden: Cleaning Data with PySpark
- Ten la sintaxis a mano: nuestra chuleta de PySpark
- Prepárate para una entrevista: Top PySpark interview questions
Si quieres ir más allá, te recomiendo nuestro itinerario Big Data with PySpark, que recorre gestión de datos, ingeniería de variables, pipelines de machine learning y sistemas de recomendación. Para equipos, DataCamp for Business ofrece hojas de ruta para roles de ingeniería de datos.
Preguntas frecuentes sobre PySpark
¿Cuáles son los requisitos para aprender PySpark?
PySpark 4.3 necesita Python 3.11 o posterior y Java 17 o posterior (Spark 4.3 funciona con Java 17, 21 y 25), con JAVA_HOME apuntando a tu instalación de Java. Deberías manejarte con Python básico; tener experiencia con DataFrames de pandas ayuda, porque la API de DataFrame de PySpark usa ideas similares. No necesitas experiencia previa con sistemas distribuidos.
¿PySpark es más rápido que pandas?
No en datos pequeños. pandas se ejecuta en el mismo proceso sin coste de arranque, mientras que PySpark tarda unos segundos en iniciar la JVM y planificar tareas, así que pandas suele ganar cuando los datos caben con holgura en memoria. PySpark es más rápido cuando el trabajo supera la memoria o la CPU de una sola máquina, porque procesa particiones en paralelo entre núcleos o nodos del clúster.
¿Cuál es la diferencia entre RDDs y DataFrames en PySpark?
Un RDD (Resilient Distributed Dataset) es la estructura de bajo nivel de PySpark: una colección distribuida de objetos arbitrarios de Python que procesas con tus funciones. Un DataFrame organiza datos en columnas con nombre y tipo, como un DataFrame de pandas, y el optimizador Catalyst de Spark convierte consultas de DataFrame en planes de ejecución eficientes. Usa DataFrames para casi todo el código nuevo, y RDDs solo para datos no estructurados o control fino del particionado.
¿Cómo ejecuto PySpark en un Jupyter Notebook?
Instala Java 17 o posterior y luego ejecuta pip install "pyspark[sql]" en el entorno que use tu notebook. Crea una SparkSession en la primera celda:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()Si prefieres evitar la configuración local, los notebooks de DataLab y Databricks vienen con PySpark preinstalado.
¿Cuándo debería usar PySpark en lugar de pandas?
Usa PySpark cuando tus datos no caben en la memoria de una sola máquina, cuando un trabajo deba ejecutarse en un clúster o en una plataforma como Databricks, o cuando estés construyendo pipelines que crecerán más allá de un portátil. Para análisis exploratorio con datos que caben en memoria, pandas es más sencillo y arranca al instante. El código de PySpark escrito en local corre sin cambios en un clúster, así que empezar con él tiene sentido si es probable que escales.
¿Qué es la evaluación perezosa en PySpark?
La evaluación perezosa significa que PySpark no ejecuta transformaciones como filter() o withColumn() cuando las llamas. Las registra en un plan y solo ejecuta ese plan cuando una acción, como count(), show() o write, necesita un resultado. Esperar permite a Spark optimizar toda la cadena, por ejemplo empujando filtros a la lectura de archivos.
¿Cómo ejecuto consultas SQL en PySpark?
Registra un DataFrame como vista temporal con df.createOrReplaceTempView("sales") y luego consúltalo con spark.sql("SELECT ... FROM sales"). El resultado es un DataFrame normal, así que puedes mezclar SQL y la API de DataFrame sin problema. Ambas compilan al mismo plan optimizado, por lo que ninguna es más rápida.
¿Necesito Hadoop para ejecutar PySpark?
No. pip install pyspark incluye el runtime de Spark, que se ejecuta en modo local en tu máquina sin Hadoop. Solo necesitas componentes de Hadoop si lees desde HDFS o ejecutas Spark en un clúster YARN.
Natassha es una consultora de datos que trabaja en la intersección de la ciencia de datos y el marketing. Cree que los datos, cuando se utilizan sabiamente, pueden inspirar un enorme crecimiento para las personas y las organizaciones. Como profesional de datos autodidacta, a Natassha le encanta escribir artículos que ayuden a otros aspirantes a entrar en el sector de la ciencia de datos. Sus artículos en su blog personal, así como en publicaciones externas, acumulan una media de 200.000 visitas mensuales.





PySpark es la API de Python para Apache Spark. Escribes código de DataFrame o SQL en Python, y Spark reparte el trabajo entre todos los núcleos de tu portátil o entre todas las máquinas de un clúster. Lo uso cuando un dataset ya no cabe con holgura en pandas, o cuando ese mismo trabajo tendrá que ejecutarse más tarde en un clúster sin reescribirlo.
En este tutorial de PySpark, instalaré PySpark 4.3, crearé una SparkSession y explicaré las dos ideas que más confunden al empezar: RDDs frente a DataFrames y la evaluación perezosa. Luego practicaremos las operaciones del día a día (select, filter, groupBy, join y Spark SQL) sobre un dataset de e‑commerce con 541.909 filas, y cerraremos con un modelo de segmentación de clientes K‑Means construido con la API Pipeline de
pyspark.ml.Si quieres ejercicios guiados junto a este tutorial, nuestro curso Introduction to PySpark cubre lo mismo. Para un plan de aprendizaje más largo, consulta la guía How to Learn PySpark From Scratch.
Resumen
pip install "pyspark[sql]"; PySpark 4.3 requiere Python 3.11+ y Java 17+.SparkSession, y los DataFrames (no los RDDs) son la API por defecto.count()oshow().pyspark.mlencadenan la preparación de variables y modelos como K‑Means en un único objeto.¿Qué es Apache Spark?
Apache Spark es un motor de código abierto para el procesamiento distribuido de datos. Divide un dataset en particiones, las procesa en paralelo en un clúster y mantiene los resultados intermedios en memoria en lugar de escribirlos a disco entre pasos.
Ese diseño en memoria es la principal razón por la que Spark sustituyó a Hadoop MapReduce en la mayoría de cargas por lotes (comparamos ambos en Hadoop vs Spark). Spark nació en 2009 en el AMPLab de la UC Berkeley, se convirtió en proyecto de nivel superior en Apache en 2014 y alcanzó la versión 4.3 el 30 de octubre de 2026.
Un único motor cubre varios tipos de trabajo gracias a sus librerías integradas:
pyspark.ml) para machine learning distribuidoPara ver cómo el driver, el gestor del clúster y los ejecutores se reparten el trabajo, consulta nuestra guía de la arquitectura de Apache Spark.