Curso
Introducción a R
4 h
3.1M
Si te fijas, muchas funciones de R usan fórmulas: paquetes como ggplot2, stats, lattice y dplyr las utilizan. Ejemplos habituales de funciones donde emplearás estos objetos de R son glm(), lm(), facet_wrap(), etc. Pero ¿qué son exactamente las fórmulas y por qué deberías usarlas?
Como las fórmulas son una clase especial en el lenguaje de programación R, conviene repasar brevemente los tipos y estructuras de datos disponibles en este lenguaje.
Recuerda que R es un lenguaje de programación orientado a objetos: todo gira en torno a objetos. En R, todo es un objeto.
Empecemos por el principio: en programación, trabajas con estructuras de datos que almacenan tu información y funciones que la procesan. Una estructura de datos es la interfaz hacia datos organizados en la memoria del ordenador. Como indica la definición del lenguaje R, R no ofrece acceso directo a la memoria del ordenador sino que proporciona varias estructuras de datos especializadas a las que te puedes referir como "objetos". Cada estructura está diseñada para optimizar algún aspecto del almacenamiento, el acceso o el procesamiento.
Las cinco estructuras de datos principales en R son:
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)

b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
Consejo: puedes usar la función typeof() para devolver el tipo de un objeto de R. El tipo de un objeto te dice más sobre el tipo interno de R o el modo de almacenamiento de cualquier objeto:
# Retrieve the types of `a` and `b`
typeof(a)

typeof(b)
'double'
'list'
En el ejemplo anterior, donde definiste las variables a y b, puedes ver que las estructuras de datos contienen secuencias de elementos. Estos elementos pueden ser del mismo tipo o de tipos diferentes. En R encontrarás los siguientes 6 tipos atómicos:
100, 5, 4; incluye enteros."Hello", "True" o "23.4"; son cadenas de caracteres de teclado;TRUE o FALSE; son "valores de verdad";48 65 6c 6c 6f; consiste en bits;2+5i; incluye números complejos; y por último,3.14; incluye números decimales.Casi todos los objetos tienen atributos asociados en R. Por ejemplo, quizá ya sepas que las matrices y los arrays son simplemente vectores con el atributo dim y, opcionalmente, dimnames adjuntos al vector. Los atributos se usan para implementar la estructura de clases en R. Como lenguaje orientado a objetos, el concepto de clases, junto con los métodos, es central. Una clase es la definición de un objeto: define qué información contiene y cómo puede usarse.
Fíjate en el siguiente ejemplo:
# Retrieve the classes of `a` and `b`
class(a)

class(b)
'numeric'
'list'
Nota: si un objeto no tiene un atributo class, tiene una clase implícita, "matrix", "array" o el resultado de la función mode().
Algunas clases especiales que puedes encontrarte son Dates y Formulas; ¡y esta última es el tema del tutorial de hoy!
Como viste en la introducción, quizá ya te hayas cruzado con fórmulas al trabajar con paquetes como ggplot2 o en funciones como lm(). Dado que normalmente usas fórmulas dentro de estas llamadas para expresar la idea de un modelo estadístico, es lógico que emplees estos objetos de R tanto en funciones de modelado como en algunas funciones gráficas.
¿Verdad?
Sin embargo, las fórmulas no se limitan a los modelos. Son una herramienta potente y versátil que te permite capturar dos cosas:
Esto explica por qué las fórmulas se usan dentro de llamadas a funciones para generar "comportamientos especiales": permiten capturar los valores de variables sin evaluarlas, de modo que la función pueda interpretarlas.
Con las estructuras de datos frescas en la memoria, puedes describir estos objetos de R como objetos de “lenguaje” o expresiones no evaluadas que tienen clase “formula” y un atributo que almacena el entorno.
En la sección anterior, viste que los objetos tienen ciertos tipos (internos de R) que indican cómo se almacenan. En este caso, una fórmula es un objeto de tipo "language".
Pero ¿qué significa exactamente?
Suele aparecer este tipo de objeto cuando estás procesando el propio lenguaje R. Mira este ejemplo para entenderlo mejor:
# Retrieve the object type
typeof(quote(x * 10))

# Retrieve the class
class(quote(x * 10))
'language'
'call'
En el ejemplo anterior, le pides a R que devuelva el tipo y la clase de quote(x*10). Como resultado, ves que el tipo de quote(x*10) es 'language' y la class es 'call'.
Esto no es una fórmula, ya que necesitarías que class() devolviera 'formula'.
Entonces, ¿qué sí lo es?
Algo que caracteriza a las fórmulas en R es el operador tilde ~. Con este operador, básicamente dices: "captura el significado de este código, sin evaluarlo ahora mismo". Por eso puedes pensar en una fórmula en R como un operador de "cita".
¿Y cómo es exactamente una fórmula? Fíjate en este código:
# A formula
c <- y ~ x
d <- y ~ x + b

# Double check the class of `c`
class(c)
'formula'
La variable a la izquierda de la tilde (~) se llama "variable dependiente", mientras que las de la derecha son las "variables independientes" y se unen con signos +.
Ten en cuenta que los nombres de estas variables cambian según el contexto. Puede que hayas visto a las independientes como "predictoras", "controladas", "features", etc. Del mismo modo, las dependientes pueden aparecer como "respuesta", "resultado" o "etiqueta".
Nota: aunque la fórmula d que definiste arriba contiene varias variables, la estructura básica de una fórmula es simplemente el símbolo ~ y al menos una variable independiente (del lado derecho).
Recuerda que las fórmulas son objetos de lenguaje con atributos que almacenan el entorno:
# Return the type of `d`
typeof(d)

# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"

$.Environment
<environment: R_GlobalEnv>
Como viste en los ejemplos, las variables incluidas en una fórmula pueden ser vectores, por ejemplo. No obstante, a menudo verás que provienen de un data frame, como en el siguiente ejemplo:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Nota: los valores de datos asignados a los símbolos de la fórmula no se consultan cuando se crea la propia fórmula.
Ahora que ya sabes cómo son y qué son las fórmulas en R, conviene mencionar que el objeto fórmula subyacente varía en función de si tienes una fórmula de un lado o de dos lados. Puedes reconocer la primera mirando la variable del lado izquierdo. Si no hay ninguna, como en ~ x, es de un solo lado.
Esto también significa que una fórmula de un lado tendrá longitud 2, mientras que la de dos lados tendrá longitud 3.
¿No te convence? Mira este bloque de código. Puedes acceder a los elementos de una fórmula con corchetes: [[ y ]].
e <- ~ x + y + z
f <- y ~ x + b

# Return the length of `g`
length(e)
length(f)

# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`


x + y + z


x + bComo has visto, las fórmulas son herramientas potentes y de propósito general que te permiten capturar valores de variables sin evaluarlos, para que la función pueda interpretarlos. Esa ya es una parte de la respuesta de por qué usarlas en R.
Además, empleas estos objetos para expresar una relación entre variables.
Por ejemplo, en la primera línea del siguiente bloque dices "y es función de x, a y b"; Por supuesto, también puedes encontrarte fórmulas más complejas, como en la segunda línea, donde dices "el ancho del sépalo es función del ancho del pétalo, condicionado por la especie".
y ~ x + a + b

Sepal.Width ~ Petal.Width | Species
y ~ x + a + b


Sepal.Width ~ Petal.Width | SpeciesAhora que ya conoces el "qué" y el "por qué" de estos objetos especiales, toca ver cómo usarlos, desde fórmulas básicas hasta otras más complejas. En esta sección verás cómo crear y concatenar fórmulas sencillas y cómo construir otras más avanzadas con operadores.
¡Esto ya lo sabes! Ya has visto algunos ejemplos en este tutorial, pero recapitulemos:
y ~ x
~ x + y + z
g <- y ~ x + b
Exacto: ¡puedes escribir la fórmula directamente!
Aun así, te encontrarás situaciones en las que necesites o quieras crear una fórmula a partir de un objeto de R, como una cadena. En esos casos, puedes usar formula o as.formula():
"y ~ x1 + x2"

h <- as.formula("y ~ x1 + x2")

h <- formula("y ~ x1 + x2")
¡Fácil!
Para unir varias fórmulas, tienes dos opciones. Primero, puedes crear variables separadas para cada fórmula y luego usar list():
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2

# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))

# Double check the class of the list elements
class(formulae[[1]])
'formula'
Alternativamente, también puedes usar la función lapply(), pasando un vector con todas tus fórmulas como primer argumento y as.formula como la función a aplicar a cada elemento del vector:
# Join all with `c()`
l <- c(i, j, k)

# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x

[[2]]
y ~ x + x1

[[3]]
y ~ x + x1 + x2
Con estas bases, ya puedes profundizar en fórmulas más complejas. Ya has visto que lo que caracteriza a las fórmulas es el símbolo ~. Además, necesitas variables dependientes e independientes, y estas últimas se unen con el signo +.
¡Pero hay más!
Además de +, hay otros símbolos que añaden significado especial a tus fórmulas:
- para eliminar términos;: para interacción;* para cruce (incluye interacción y principales);%in% para anidamiento; y^ para limitar cruces hasta el grado especificado.Verás ejemplos de todos estos operadores a continuación. Empecemos por + y -:
# Usar varias variables independientes
y ~ x1 + x2

# Ignorar objetos en un análisis
y ~ x1 - x2
Nota: los símbolos : y * se usan a menudo en regresión para especificar términos de interacción. El primero indica solo la interacción entre variables, no los efectos principales. El segundo, cruce: incluye ambas variables y su interacción.
¡Ojo! Algunas fórmulas pueden parecer distintas pero ser equivalentes. Considera estos ejemplos, que producirán la misma regresión:
y ~ x1 * x2

y ~ x1 + x2 + x1:x2
¿No ves por qué son iguales? Fíjate en estos bloques de R:
# Set seed
set.seed(123)

# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)

# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
No te preocupes si aún no conoces la función model.frame(); ¡la verás más adelante en el tutorial!
Además, aquí tienes un ejemplo de anidamiento, que puedes expandir a y ~ a + a:b:
y ~ a + b %in% a
Todos estos operadores están muy bien, pero ¿y si quieres realizar una operación aritmética de verdad? Imagina que quieres incluir x y x^2 en tu modelo. Podrías sentir la tentación de escribir y ~ x + x^2.
¿Será eso lo que necesitas? ¡Mira!
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
¡No es el resultado que esperabas!
En el ejemplo anterior no proteges la expresión aritmética y, como consecuencia, R elimina el término x^2 al considerarlo un duplicado de x.
¿Por qué?
Pues porque x aporta el efecto principal de x, y x^2 aportaría el efecto principal y la interacción de segundo orden de x. Al final, solo se incluirá x en el model frame porque el efecto principal ya está incluido por el término x de la fórmula, y no hay nada con lo que cruzar x para obtener interacciones de segundo orden en el término x^2.
Para evitarlo, tienes varias soluciones:
I() o "tal cual": y ~ x + I(x^2)Mira este ejemplo para ver qué pasa al añadir I() al código:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Esta última línea le dice a R que calcule los valores de x^2 antes de usar la fórmula. Nota también que puedes usar el operador "tal cual" para escalar una variable en un modelo; basta con envolver el nombre en I():
y ~ I(2 * x)
Todo esto puede parecer abstracto con los ejemplos anteriores, así que veamos otros casos; Por ejemplo, en una regresión polinómica necesitarás I(). En cambio, para un ANOVA factorial limitado a interacciones de depth=2, no lo necesitarás porque quieres expandir a una fórmula con los efectos principales de a, b y c y sus interacciones de segundo orden:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)

# Factorial ANOVA
y ~ (a*b*c)^2
Por último, hay otra característica útil cuando trabajas con muchas variables: el operador .. Cuando lo usas dentro de una fórmula, hace referencia a todas las otras variables de la matriz que aún no se han incluido en el modelo. Es muy práctico, por ejemplo, si quieres ajustar una regresión sobre una matriz o un data frame sin teclear todas las variables:
y ~ .
Cuando creas una fórmula, quizá también quieras inspeccionarla. En esta sección verás algunas herramientas para explorar en detalle los objetos especiales que has creado.
Nota: ya has visto algunas formas de examinar fórmulas en secciones anteriores: funciones como attributes(), typeof(), class(), etc.
terms() functionPara examinar y comparar fórmulas, puedes usar terms():
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
   x1 x2
y   0  0
x1  1  0
x2  0  1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.varsSi quieres conocer los nombres de las variables del modelo, usa all.vars. Esta función devuelve un vector de caracteres con todos los nombres que aparecen en una fórmula:
print(all.vars(m))
[1] "y" "x1" "x2"update() functionPara modificar fórmulas sin convertirlas a texto, usa update():
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Nota: también podrías actualizar la fórmula convirtiéndola a texto con as.character(); luego puedes construir fórmulas muy rápido usando paste(). Por ejemplo, si quieres añadir otra variable al lado derecho, simplemente pégala:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))

factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3


y ~ x2 + x3
En el código anterior, puedes ver que puedes usar los argumentos sep o collapse para indicar la cadena que separa los términos dentro de tu fórmula.
Sin embargo, paste() no es la única forma de ajustar tu fórmula: también puedes usar reformulate():
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()Comprueba si tu variable es una fórmula pasándola a is.formula(). Ten en cuenta que esta función forma parte de la librería plyr, así que debes cargarla antes de llamar a is.formula():
# Load `plyr`
library(plyr)

# Check `m`
is.formula(m)
TRUE
Hasta ahora has visto que las fórmulas de R son herramientas de propósito general que no se limitan al modelado y has visto algunos ejemplos de uso. En esta sección profundizarás en este tema: verás algunos casos donde te resultan especialmente útiles. Por supuesto, cubriremos funciones de modelado y gráficas de paquetes como lattice y stats, y también evaluación no estándar en dplyr.
R es ideal cuando necesitas hacer modelado estadístico. Como sabes, el modelado estadístico es una forma simplificada y formal (matemática) de aproximar la realidad y, opcionalmente, hacer predicciones a partir de esa aproximación. Un modelo estadístico suele representar el proceso generador de datos de forma idealizada. Para modelar, necesitas funciones de modelado.
Las funciones de modelado en R son un ejemplo típico donde necesitas un objeto formula como argumento. Otros argumentos comunes son data, que te permite especificar el data frame que quieres adjuntar durante la creación del modelo, subset para seleccionar los datos que quieres usar, ... En general, si quieres saber qué argumentos pasar a una función concreta, no dudes en usar help() o ? en tu consola de R.
Las funciones de modelado devuelven un objeto modelo que contiene toda la información del ajuste. Funciones genéricas como print(), summary(), plot(), anova(), etc. tienen métodos definidos para clases de objeto específicas y devuelven información adecuada a ese tipo de objeto.
Probablemente una de las funciones más conocidas es lm(), que usa todos los argumentos descritos. Sirve para ajustar modelos lineales: regresión, ANOVA de un solo estrato y análisis de covarianza. Veamos un ejemplo con lm() y cómo inspeccionar el modelo con print():
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
        data = iris,
        subset = Sepal.Length > 4.6)

print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
    Species, data = iris, subset = Sepal.Length > 4.6)

Coefficients:
      (Intercept)        Petal.Width  log(Petal.Length)  Speciesversicolor
           3.1531             0.6620             0.4612            -1.9265
 Speciesvirginica
          -2.3088
lm() usa inicialmente la fórmula y el entorno adecuado para traducir las relaciones entre variables y crear un data frame con los datos.
También están los métodos model.frame(), de los que ya viste un ejemplo, que se usan para recuperar o recrear el model frame a partir del objeto ajustado, sin otros argumentos. Esto permite recuperar columnas del data frame que corresponden a argumentos de la llamada original distintos de formula, subset y weights: por ejemplo, el método de glm() maneja offset, etastart y mustart.
En el siguiente bloque usas model.frame() para obtener un data frame del objeto ajustado; Fíjate en que el código difiere ligeramente del anterior: el argumento subset se ha modificado.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
                   data = iris,
                   subset = Sepal.Length > 6.9,
                   drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
Consejo: hay más funciones en el paquete stats que permiten usar fórmulas, como aggregate().
Para modelos lineales de efectos mixtos, que permiten modelar efectos aleatorios para recoger variación debida a factores como diferencias entre observadores, puedes usar el paquete nlme con la función lme(). También aquí verás que formula es el primer argumento y que hay un argumento data.
# Load packages
library(MASS)
library(nlme)

# Get some data
data(oats)

# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen

# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
             random = ~ 1|block/mainplot,
             data = oats)

# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
 Data: oats
       AIC      BIC    logLik
  559.0285 590.4437 -264.5143

Random effects:
 Formula: ~1 | block
        (Intercept)
StdDev:    14.64496

 Formula: ~1 | mainplot %in% block
        (Intercept) Residual
StdDev:    10.29863 13.30727

Fixed effects: yield ~ variety * nitrogen
                                    Value Std.Error DF   t-value p-value
(Intercept)                      80.00000  9.106958 45  8.784492  0.0000
varietyMarvellous                 6.66667  9.715028 10  0.686222  0.5082
varietyVictory                   -8.50000  9.715028 10 -0.874933  0.4021
nitrogen0.2cwt                   18.50000  7.682957 45  2.407927  0.0202
nitrogen0.4cwt                   34.66667  7.682957 45  4.512152  0.0000
nitrogen0.6cwt                   44.83333  7.682957 45  5.835427  0.0000
varietyMarvellous:nitrogen0.2cwt  3.33333 10.865342 45  0.306786  0.7604
varietyVictory:nitrogen0.2cwt    -0.33333 10.865342 45 -0.030679  0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482  0.7032
varietyVictory:nitrogen0.4cwt     4.66667 10.865342 45  0.429500  0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500  0.6696
varietyVictory:nitrogen0.6cwt     2.16667 10.865342 45  0.199411  0.8428
 Correlation:
                                 (Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous                -0.533
varietyVictory                   -0.533  0.500
nitrogen0.2cwt                   -0.422  0.395  0.395
nitrogen0.4cwt                   -0.422  0.395  0.395  0.500
nitrogen0.6cwt                   -0.422  0.395  0.395  0.500  0.500
varietyMarvellous:nitrogen0.2cwt  0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt     0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt  0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt     0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt  0.298 -0.559 -0.280 -0.354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt     0.298 -0.280 -0.559 -0.354 -0.354 -0.707
                                 vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt     0.500
varietyMarvellous:nitrogen0.4cwt  0.500  0.250
varietyVictory:nitrogen0.4cwt     0.250  0.500  0.500
varietyMarvellous:nitrogen0.6cwt  0.500  0.250  0.500  0.250
varietyVictory:nitrogen0.6cwt     0.250  0.500  0.250  0.500  0.500

Standardized Within-Group Residuals:
        Min          Q1         Med          Q3         Max
-1.81300898 -0.56144838  0.01758044  0.63864476  1.57034166

Number of Observations: 72
Number of Groups:
              block mainplot %in% block
6 18 Nota: además de nlme, hay otros paquetes como lme4, también dedicado al ajuste de modelos lineales y lineales generalizados de efectos mixtos.
Otro ejemplo de funciones de modelado y uso de fórmulas es nls(), con la que harías modelos no lineales:
# Set seed
set.seed(20160227)

# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)

# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
             start=c(a=4, b=1))
Un último ejemplo son las funciones para construir modelos lineales generalizados (GLM). En R, puedes usar glm() para ello. De nuevo, necesitas los argumentos formula y data:
# Load package
library(MPDiR)

# Get the data
data(Chromatic)

# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
             family = Gamma(link = "identity"),
             data = Chromatic)

# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
    data = Chromatic)

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-1.2160  -0.3728  -0.0805   0.2311   1.2932

Coefficients:
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)          3.282e-04  9.965e-05   3.294  0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03  3.686e-04  21.172  < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03  3.863e-04  21.410  < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02  5.284e-04  22.065  < 2e-16 ***
AxisDeutan:Age       1.521e-05  3.418e-06   4.450 1.06e-05 ***
AxisProtan:Age       1.540e-05  3.434e-06   4.484 9.10e-06 ***
AxisTritan:Age       4.812e-05  5.838e-06   8.241 1.48e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for Gamma family taken to be 0.2054848)

    Null deviance: 543.35  on 510  degrees of freedom
Residual deviance: 100.40  on 504  degrees of freedom
AIC: -4777.6

Number of Fisher Scoring iterations: 6
Antes de pasar a las funciones gráficas, hay algo más que conviene saber: cuando usas fórmulas en funciones de modelado como lm(), se realiza una conversión estándar de fórmula a funciones. Para explicar qué conversión se produce, volvamos al ejemplo anterior:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
           data = iris,
           subset = Sepal.Length > 4.6)
Aunque el objetivo de este bloque es ajustar un modelo de regresión lineal, la fórmula se usa para especificar el modelo simbólico y para generar la matriz de diseño. Una matriz de diseño es la representación bidimensional del conjunto de variables independientes donde las filas son observaciones y las columnas, atributos. También se conoce como matriz X.
Dicho esto, el método de fórmula también define las columnas que deben incluirse en la matriz de diseño.
¿Qué significa realmente? Mira estas líneas de código:
# A formula
y ~ x

# A converted formula
y = a_1 + a_2 * x
Este es un ejemplo de conversión sencilla: y ~ x se traduce en y = a_1 + a_2 * x.
Para ver y entender qué hace R realmente, puedes usar la función model_matrix(). Esta crea una matriz de diseño expandiendo, por ejemplo, factores a variables ficticias (dummies) en función de los contrastes, y expandiendo interacciones de forma similar.
No olvides pasar el data frame df y la fórmula para obtener un tibble que define la ecuación del modelo:
# Load packages
library(tidyverse)
library(modelr)

# A data frame
df <- tribble(
  ~y, ~x1, ~x2,
  4, 2, 5,
  5, 1, 6
)

# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Aparece una columna extra (Intercept). Es el comportamiento por defecto en R. La forma en que R añade el intercepto es incluyendo una columna llena de unos. Si no lo quieres, elimínalo explícitamente añadiendo -1 a la fórmula, así:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Nota: la matriz de diseño crece de forma nada sorprendente cuando añades más variables al modelo.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
Otro lugar importante donde encontrarás fórmulas en R son las funciones gráficas. Hay muchos paquetes, así que este tutorial se centrará en graphics, lattice, ggplot2 y ggformula.
graphicsEl paquete base graphics te permite especificar un diagrama de dispersión o añadir puntos, líneas o texto usando una fórmula. Mira este ejemplo:
# Get data
data(airquality)

# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
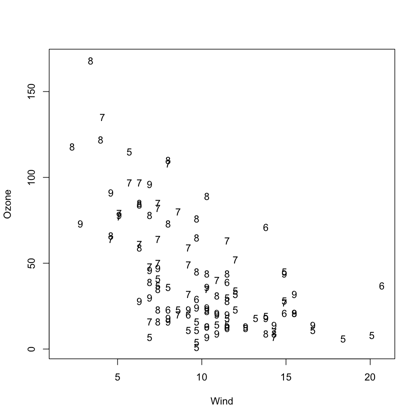
Si quieres saber más, consulta esta página.
latticelattice es un paquete construido sobre grid graphics. Es un paquete de gráficos de propósito general que ofrece implementaciones alternativas de muchas funciones de trazado disponibles en base graphics. Ejemplos concretos incluyen xyplot() para dispersión, barchart() para barras y bwplot() para boxplots.
Consejo: ¿quieres aprender más sobre lattice? Valora hacer el curso de DataCamp Data Visualization in R with lattice.
Lo especial de este paquete es que usa la notación de fórmulas de los modelos estadísticos para describir la gráfica deseada y, en concreto, las variables a representar. Además, añade la barra vertical | para especificar la variable de condicionamiento:
# Load package
library(lattice)

# Plot histogram
histogram(~ Ozone | factor(Month),
          data = airquality,
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
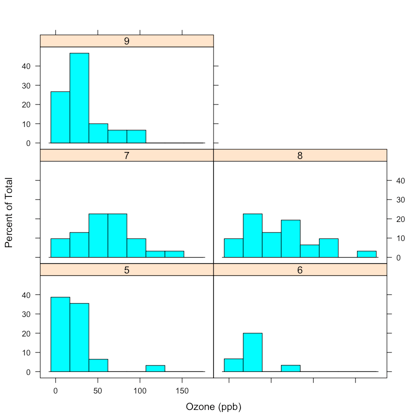
Nota: igual que en las funciones de modelado, las funciones de la librería lattice tienen, además de un argumento formula, también un argumento data, como cabría esperar.
Recuerda que también podrías omitir el argumento data en el código anterior, pero entonces tendrías que adjuntar los datos:
# Load package
library(lattice)

# Attach data
attach(airquality)

# Plot
histogram(~ Ozone | factor(Month),
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
ggplot2Puedes usar fórmulas en varias funciones de ggplot2:
geom_smooth() o stats_smooth(), para especificar la fórmula a usar en el suavizado; esto influye en la forma del ajuste.facet_wrap(), para definir paneles de trazado.facet_grid(), para especificar las filas y columnas a representar, con o sin facetado.# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
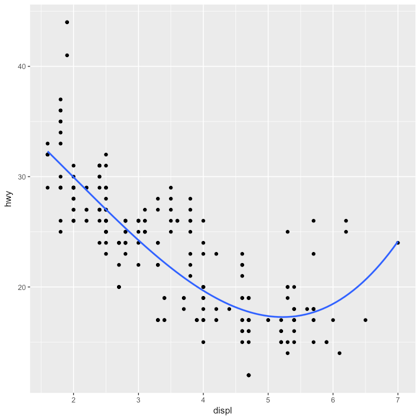
Fíjate en que, para crear esta gráfica, la fórmula usa las letras x y y, no los nombres de las variables. Esto no es así cuando usas facet_wrap():
ggplot(mpg, aes(displ, hwy)) +
  geom_point() +
  geom_smooth(span = 0.8) +
  facet_wrap(~drv)
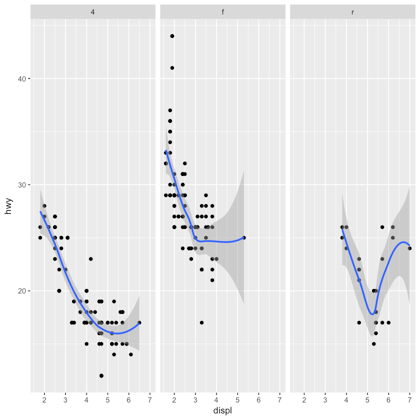
¿Quieres aprender más sobre ggplot2? Echa un vistazo a este curso o revisa la documentación.
ggformulaEl paquete ggformula se apoya en ggplot2, pero ofrece una interfaz basada en fórmulas, similar a la de lattice. También encontrarás que el operador pipe se usa en este paquete para construir gráficos más complejos a partir de componentes sencillos.
Consejo: si quieres saber más sobre el operador pipe en R, echa un ojo a este tutorial.
La forma básica de crear una gráfica con ggformula es
gf_plottype(formula, data = mydata)Nota: la función gf_plottype() empieza por gf para recordarte que trabajas con funciones cuya interfaz basada en fórmulas se apoya en ggplot2; la g es de ggplot2 y la f de “formula”.
Mira este ejemplo en código R:
# Load package
library(ggformula)

# Plot
gf_point(mpg ~ hp, data = mtcars)
Por supuesto, esto es solo una gráfica básica; con este paquete puedes hacer mucho más. Puedes elegir un tipo de glifo distinto y atributos específicos, crear gráficos de 1 o 2 variables, ajustar posiciones, etc. Este tutorial no entrará en más detalle, pero la idea clave es que este paquete hace de las fórmulas el ingrediente principal para crear gráficos.
Si quieres profundizar más, lee sobre el paquete ggformula aquí o consulta la página de RDocumentation.
dplyrdplyr es un ejemplo de paquete que trabaja con evaluación no estándar (NSE). Otros ejemplos son library(magrittr) frente a library("magrittr"), que funcionan igual aunque en una línea hay comillas y en la otra no. Compáralo con install.packages():
# This will work
install.packages("magrittr")

# This won't work
install.packages(magrittr)
En R, normalmente debes usar comillas cuando nombras parte de un objeto, pero en algunas funciones —como library()— no. Estas funciones están diseñadas para funcionar de forma no estándar. Es más, ¡algunas ni siquiera tienen una forma estándar!
En lo que respecta a dplyr, verás que la mayoría de sus funciones funcionan como otras: todas tienen evaluación estándar (SE). Sin embargo, para uso interactivo, también tienen una variante con evaluación no estándar (NSE), que te ahorra tecleo.
(Seamos sinceros: ¡todas esas comillas cansan!)
Por eso la mayoría de funciones de dplyr usan evaluación no estándar. No siguen las reglas habituales de evaluación de R. En su lugar, capturan la expresión que tecleaste y la evalúan de forma personalizada.
Eso no significa que no exista una variante de evaluación estándar. Cada función que usa NSE tiene (y debería tener) una vía de escape de evaluación estándar que hace el cálculo real. La función con evaluación estándar suele terminar en _. Esto implica que hay múltiples verbos en dplyr: select(), select_(), mutate(), mutate_(), etc.
Usadas de forma interactiva, estas funciones se evalúan primero con el paquete lazyeval antes de enviarse a la versión de evaluación estándar. Es decir, bajo el capó, select() se evalúa con lazyeval y se envía a select_().
Dicho esto, hay 3 formas de citar variables en funciones de evaluación estándar que dplyr y lazyeval entienden:
quote(), y# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
Consejo: si quieres leer más sobre evaluación no estándar, consulta el capítulo correspondiente en el libro Advanced R de Hadley Wickham.
Ya has visto que puedes crear e inspeccionar fórmulas usando funciones como as.formula, update(), all.vars, ... Eran operaciones y manipulaciones sencillas, pero ¿qué hay de manipulaciones avanzadas? ¡Quizá estos paquetes te interesen!
Formula PackageEste paquete se publicó recientemente en CRAN. Es ideal si quieres llevar las fórmulas al siguiente nivel. Amplía la clase base formula.
Más concretamente, los objetos Formula amplían los objetos fórmula básicos: con este paquete puedes definir fórmulas que aceptan un operador adicional | que separa múltiples partes o que pueden contener todos los operadores (incluida la barra) en el lado izquierdo para soportar múltiples respuestas.
Ejemplos de fórmulas que podrás crear:
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2y1 + y2 ~ x1 + x2 + x3y1 | y2 + y3 ~ x, y# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
Nota: las funciones as.formula() e is.formula() también se han actualizado en este paquete: usarás is.Formula() y as.Formula().
Lee más aquí.
formula.toolsEste paquete se publicó recientemente y te ofrece "utilidades programáticas para manipular fórmulas, expresiones, llamadas, asignaciones y otros objetos de R". Es mucho, pero en esencia: puedes usarlo para acceder y modificar estructuras de fórmulas y extraer y reemplazar nombres y símbolos de esos objetos. Este paquete lo escribió Christopher Brown.
Algunas funciones útiles al trabajar con este paquete son:
get.vars(): en lugar de all.vars(), extrae nombres de variables de varios objetos de R, interpolando todos los símbolos, etc., a nombres de variables.invert(): invierte los operadores de un objeto, como una fórmula.is.one.sided(): muy útil para determinar si una fórmula es de uno o dos lados.Recuerda que una fórmula es de un solo lado si tiene esta forma: ~x; será de dos lados si es x~y.
¡Bien! Has llegado al final de este tutorial sobre fórmulas en R. Si quieres leer más, no dejes de consultar el libro de Hadley Wickham R for Data Science, que tiene un capítulo dedicado a fórmulas y familias de modelos en R.
Echa un vistazo al tutorial de DataCamp Primeros pasos con el Tidyverse.
¿Se te ocurren más casos en los que aparezcan fórmulas o paquetes para manipularlas? Cuéntamelo en Twitter: @willems_karlijn.
Cursos de R
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Javier Canales Luna
11 min
Tutorial
Kevin Babitz
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Łukasz Deryło
10 min
Tutorial
Abid Ali Awan
10 min