Curso
Introdução ao R
4 h
3.1M
Se você parar para pensar, muitas funções em R usam fórmulas: pacotes como ggplot2, stats, lattice e dplyr usam todas elas! Exemplos comuns de funções em que você vai usar esses objetos R são glm(), lm(), facet_wrap() etc. Mas, afinal, o que são exatamente essas fórmulas e por que você deveria usá-las?
Como fórmulas são uma classe especial na linguagem R, vale a pena revisar rapidamente os tipos e as estruturas de dados disponíveis nessa linguagem.
Lembre-se: R é uma linguagem de programação orientada a objetos — tudo em R é um objeto.
Começando do começo: em programação, você trabalha com estruturas de dados que armazenam seus dados e funções que os processam. Uma estrutura de dados é a interface para dados organizados na memória do computador. Como define a R Language Definition, R não fornece acesso direto à memória do computador; em vez disso, oferece diversas estruturas de dados especializadas às quais você se refere como "objetos". Cada estrutura é projetada para otimizar algum aspecto de armazenamento, acesso ou processamento.
As cinco principais estruturas de dados em R são:
# Create variables
a <- c(1,2,3,4,5,6,7,8,9)

b <- list(x = LifeCycleSavings[,1], y = LifeCycleSavings[,2])
Dica: você pode usar a função typeof() para retornar o tipo de um objeto em R. O tipo informa mais sobre o tipo interno (do R) ou modo de armazenamento de qualquer objeto:
# Retrieve the types of `a` and `b`
typeof(a)

typeof(b)
'double'
'list'
No exemplo acima, em que você definiu as variáveis a e b, dá para ver que as estruturas de dados contêm sequências de elementos. Esses elementos podem ser de tipos iguais ou diferentes. Em R, você encontra os seguintes 6 tipos atômicos:
100, 5, 4, inclui inteiros;"Hello", "True" ou "23.4", são cadeias de caracteres de teclado;TRUE ou FALSE, consistem em "valores lógicos";48 65 6c 6c 6f, consistem em bits;2+5i, incluem números complexos; e, por fim,3.14, incluem números decimais.Quase todos os objetos em R têm atributos. Por exemplo, você talvez já saiba que matrizes e arrays são simplesmente vetores com o atributo dim e, opcionalmente, dimnames anexados ao vetor. Atributos são usados para implementar a estrutura de classes em R. Como linguagem orientada a objetos, o conceito de classes, junto com métodos, é central. Uma classe define um objeto: determina quais informações ele contém e como pode ser usado.
Veja o exemplo a seguir:
# Retrieve the classes of `a` and `b`
class(a)

class(b)
'numeric'
'list'
Observação: se um objeto não tem atributo class, ele possui uma classe implícita, "matrix", "array" ou o resultado da função mode().
Algumas das classes especiais que você pode encontrar são Dates e Formulas; e é justamente esta última o tema do tutorial de hoje!
Como você leu na introdução, provavelmente já viu fórmulas ao trabalhar com pacotes como ggplot2 ou em funções como lm(). Como geralmente você usa fórmulas nessas chamadas de função para expressar a ideia de um modelo estatístico, é natural que esses objetos R apareçam com frequência em funções de modelagem e também em algumas funções gráficas.
Certo?
No entanto, fórmulas não se limitam a modelos. Elas são uma ferramenta poderosa e versátil que permite capturar duas coisas:
Isso explica por que fórmulas são usadas dentro de chamadas de funções para gerar um "comportamento especial": elas permitem capturar os valores das variáveis sem avaliá-los de imediato, para que a função possa interpretá-los.
Com as estruturas de dados frescas na mente, dá para descrever esses objetos como objetos de “linguagem” ou expressões não avaliadas que têm classe “formula” e um atributo que armazena o ambiente.
Na seção anterior, você viu que objetos têm certos tipos (internos do R) que indicam como o objeto foi armazenado. Neste caso, uma fórmula é um objeto do tipo "language".
Mas o que isso quer dizer na prática?
Normalmente você esbarra nesse tipo de objeto quando está processando a própria linguagem R. Veja o exemplo a seguir para entender melhor:
# Retrieve the object type
typeof(quote(x * 10))

# Retrieve the class
class(quote(x * 10))
'language'
'call'
No exemplo acima, você pede ao R para retornar o tipo e a classe de quote(x*10). Como resultado, vê que o tipo de quote(x*10) é 'language' e a class é 'call'.
Definitivamente não é uma fórmula, já que você precisaria que class() retornasse 'formula'!
Então, o que é?
Algo que caracteriza as fórmulas em R é o operador til (~). Com esse operador, você basicamente diz: "capture o significado deste código sem avaliá-lo agora". Isso também explica por que você pode pensar na fórmula em R como um operador de "citação".
Mas como exatamente é uma fórmula? Observe este trecho de código:
# A formula
c <- y ~ x
d <- y ~ x + b

# Double check the class of `c`
class(c)
'formula'
A variável à esquerda do til (~) é chamada de "variável dependente", enquanto as variáveis à direita são as "variáveis independentes" e são unidas por sinais de adição +.
É bom saber que os nomes dessas variáveis mudam conforme o contexto. Você pode ver variáveis independentes como "preditor", "variável controlada", "feature" etc. Da mesma forma, variáveis dependentes podem aparecer como "variável resposta", "variável de desfecho" ou "label".
Observação: embora a fórmula d definida no trecho acima contenha várias variáveis, a estrutura básica de uma fórmula é apenas o símbolo ~ e pelo menos uma variável independente (do lado direito).
Lembre-se: fórmulas são objetos de linguagem com atributos que armazenam o ambiente:
# Return the type of `d`
typeof(d)

# Retrieve the attributes of `d`
attributes(d)
'language'
$class
[1] "formula"

$.Environment
<environment: R_GlobalEnv>
Como você viu, as variáveis incluídas em uma fórmula podem ser, por exemplo, vetores. Porém, com frequência elas vêm de um data frame, como no exemplo a seguir:
Sepal.Width ~ Petal.Width + log(Petal.Length) + Species
Observação: quaisquer valores atribuídos aos símbolos na fórmula não são acessados quando a própria fórmula é criada.
Agora que você sabe como são as fórmulas e o que elas são em R, vale mencionar que o objeto de fórmula muda dependendo de ser unilateral (one-sided) ou bilateral (two-sided). Você reconhece a primeira olhando o lado esquerdo: se não houver nada, como em ~ x, é uma fórmula unilateral.
Isso também significa que uma fórmula unilateral terá comprimento 2, enquanto a bilateral terá comprimento 3.
Ficou na dúvida? Veja o trecho abaixo. Você pode acessar os elementos de uma fórmula usando colchetes: [[ e ]].
e <- ~ x + y + z
f <- y ~ x + b

# Return the length of `g`
length(e)
length(f)

# Retrieve the elements at index 1 and 2
e[[1]]
e[[2]]
f[[3]]
2
3
`~`


x + y + z


x + bComo você viu, fórmulas são ferramentas poderosas e gerais que permitem capturar valores de variáveis sem avaliá-los, para que a função possa interpretá-los. Essa já é parte da resposta de por que usar fórmulas em R.
Além disso, você usa esses objetos para expressar um relacionamento entre variáveis.
Por exemplo, na primeira linha do bloco abaixo, você diz "y é função de x, a e b"; e também pode haver fórmulas mais complexas, como na segunda linha, onde a intenção é "a largura da sépala é função da largura da pétala, condicionada à espécie".
y ~ x + a + b

Sepal.Width ~ Petal.Width | Species
y ~ x + a + b


Sepal.Width ~ Petal.Width | SpeciesAgora que você já entende o "o quê" e o "por quê" desses objetos especiais, é hora de ver como usar fórmulas básicas e mais complexas! Nesta seção, você vai aprender a criar e concatenar fórmulas simples e também a construir fórmulas mais ricas com a ajuda de operadores.
Você já sabe fazer isso! Vimos alguns exemplos, mas vamos recapitular:
y ~ x
~ x + y + z
g <- y ~ x + b
Isso mesmo — basta digitar a fórmula!
Mas pode ser que você precise ou queira criar uma fórmula a partir de um objeto R, como uma string. Nesses casos, use as funções formula ou as.formula():
"y ~ x1 + x2"

h <- as.formula("y ~ x1 + x2")

h <- formula("y ~ x1 + x2")
Simples!
Para "colar" ou reunir várias fórmulas, você tem duas opções. Primeiro, pode criar variáveis separadas para cada fórmula e depois usar list():
# Create variables
i <- y ~ x
j <- y ~ x + x1
k <- y ~ x + x1 + x2

# Concatentate
formulae <- list(as.formula(i),as.formula(j),as.formula(k))

# Double check the class of the list elements
class(formulae[[1]])
'formula'
Alternativamente, você pode usar lapply(), passando um vetor com todas as fórmulas como primeiro argumento e as.formula como a função a aplicar a cada elemento:
# Join all with `c()`
l <- c(i, j, k)

# Apply `as.formula` to all elements of `f`
lapply(l, as.formula)
[[1]]
y ~ x

[[2]]
y ~ x + x1

[[3]]
y ~ x + x1 + x2
Com esses fundamentos em mente, vamos mergulhar nas fórmulas mais complexas! Acima, você já viu que o que caracteriza fórmulas é o símbolo ~. Além dele, você precisa de variáveis dependentes e independentes, que podem ser reunidas com o sinal +.
Mas tem mais!
Além de +, há outros símbolos que adicionam significados especiais às fórmulas:
- para remover termos;: para interação;* para cruzamento (inclui interação e principais);%in% para aninhamento; e^ para limitar cruzamentos até o grau especificado.Você verá exemplos de todos eles a seguir! Vamos começar com + e -:
# Use multiple independent variables
y ~ x1 + x2

# Ignore objects in an analysis
y ~ x1 - x2
Observação: os símbolos : e * aparecem muito em regressão, quando é preciso especificar termos de interação. O primeiro indica apenas a interação das variáveis, sem incluir os termos principais. Já o segundo inclui as duas variáveis e também a interação entre elas.
Cuidado! Usando esses operadores, algumas fórmulas podem parecer diferentes, mas são equivalentes. Veja os exemplos a seguir, que produzem a mesma regressão:
y ~ x1 * x2

y ~ x1 + x2 + x1:x2
Não tem certeza de como elas são iguais? Confira estes trechos em R:
# Set seed
set.seed(123)

# Data
x = rnorm(5)
x2 = rnorm(5)
y = rnorm(5)

# Model frame
model.frame(y ~ x * x2, data = data.frame(x = x, y = y, x2=x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
model.frame(y ~ x + x2 + x:x2, data = data.frame(x = x, y = y, x2))
| y | x | x2 |
|---|---|---|
| 1.7150650 | -0.56047565 | 1.2240818 |
| 0.4609162 | -0.23017749 | 0.3598138 |
| -1.2650612 | 1.55870831 | 0.4007715 |
| -0.6868529 | 0.07050839 | 0.1106827 |
| -0.4456620 | 0.12928774 | -0.5558411 |
Sem problemas se você ainda não conhece a função model.frame(); mais adiante neste tutorial voltaremos a ela!
Além disso, segue um exemplo de aninhamento, que pode ser expandido para y ~ a + a:b:
y ~ a + b %in% a
Todos esses operadores são ótimos, mas e se você quiser realizar uma operação aritmética de fato? Suponha que você quer incluir x e x^2 no modelo. Nesses casos, pode bater a tentação de escrever y ~ x + x^2.
Mas será que dá o resultado esperado? Veja:
model.frame( y ~ x + x^2, data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + x^2
| y | x |
|---|---|
| -0.2053091 | 1.18231565 |
| -0.3030972 | 0.04779636 |
| -0.7621604 | 0.86382418 |
| -0.1377784 | -1.18333097 |
| -0.3813125 | -1.25247842 |
Não era esse o resultado que você esperava!
No exemplo acima, você não protege a expressão aritmética e, como consequência, o R descarta o termo x^2, pois o considera duplicado de x.
Por quê?
Porque x fornece o efeito principal de x, e x^2 daria o efeito principal e a interação de segunda ordem de x. No fim, você acaba incluindo apenas x no model frame porque o efeito principal já está presente no termo x da fórmula, e não há nada para cruzar com x a fim de gerar as interações de segunda ordem no termo x^2.
Para evitar isso, você tem algumas soluções:
I() ("as is"): y ~ x + I(x^2)Veja o exemplo abaixo para entender o efeito de adicionar I() ao código:
model.frame( y ~ x + I(x^2), data = data.frame(x = rnorm(5), y = rnorm(5)))
y ~ x + I(x^2)| y | x | I(x^2) |
|---|---|---|
| 1.414090 | -0.1996230 | 0.039849.... |
| 1.777646 | -1.0675904 | 1.139749.... |
| 1.710137 | -1.4071841 | 1.980167.... |
| 1.259111 | -1.3747289 | 1.889879.... |
| -1.490866 | 0.8323668 | 0.692834.... |
Essa última linha de código diz ao R para calcular x^2 antes de usar a fórmula. Observação: você também pode usar o operador "as is" para escalar uma variável no modelo; basta envolver o nome da variável em I():
y ~ I(2 * x)
Tudo isso pode parecer meio abstrato, então vamos a outros casos. Em regressão polinomial, por exemplo, você vai precisar de I(). Já em um modelo ANOVA fatorial limitado a interações de depth=2, você não precisa dessa função, pois quer expandir para uma fórmula que contenha os efeitos principais de a, b e c, junto com suas interações de segunda ordem:
# Polynomial Regression
y ~ x + I(x^2) + I(x^3)

# Factorial ANOVA
y ~ (a*b*c)^2
Por fim, há mais um recurso útil ao trabalhar com muitas variáveis: o operador .. Quando você o usa em uma fórmula, está se referindo a todas as outras variáveis na matriz que ainda não foram incluídas no modelo. Isso é prático quando você quer rodar uma regressão em uma matriz ou data frame sem digitar todas as variáveis:
y ~ .
Depois de criar uma fórmula, você pode querer inspecioná-la. Nesta seção, veja algumas ferramentas para explorar melhor esses objetos especiais que você criou!
Observação: você já viu algumas maneiras de examinar fórmulas nas seções anteriores: funções como attributes(), typeof(), class() etc.
terms() functionPara examinar e comparar fórmulas diferentes, use a função terms():
m <- formula("y ~ x1 + x2")
terms(m)
y ~ x1 + x2
attr(,"variables")
list(y, x1, x2)
attr(,"factors")
   x1 x2
y   0  0
x1  1  0
x2  0  1
attr(,"term.labels")
[1] "x1" "x2"
attr(,"order")
[1] 1 1
attr(,"intercept")
[1] 1
attr(,"response")
[1] 1
attr(,".Environment")
<environment: R_GlobalEnv>all.varsSe quiser saber os nomes das variáveis no modelo, use all.vars. Essa função retorna um vetor de caracteres com todos os nomes que aparecem na fórmula:
print(all.vars(m))
[1] "y" "x1" "x2"update() functionPara modificar fórmulas sem convertê-las para texto, use a função update():
update(y ~ x1 + x2, ~. + x3)
y ~ x1 + x2 + x3
Observação: você também poderia atualizar a fórmula convertendo-a para character com as.character(); em seguida, dá para criar fórmulas rapidamente com paste(). Por exemplo, para adicionar outra variável do lado direito, basta concatenar:
as.formula(paste("y ~ x1 + x2", "x3", sep = "+"))

factors <- c("x2", "x3")
as.formula(paste("y~", paste(factors, collapse="+")))
y ~ x1 + x2 + x3


y ~ x2 + x3
No trecho acima, repare que você pode usar os argumentos sep ou collapse para indicar a string que separa os termos da sua fórmula.
No entanto, paste() não é a única forma de ajustar fórmulas: você também pode usar reformulate():
reformulate(termlabels = factors, response = 'y')
y ~ x2 + x3
is.formula()Confira se sua variável é uma fórmula passando-a para is.formula(). Considere que essa função faz parte da biblioteca plyr, então você precisa carregá-la antes de chamar is.formula()!
# Load `plyr`
library(plyr)

# Check `m`
is.formula(m)
TRUE
Até agora, você já viu que fórmulas em R são ferramentas gerais que não se limitam à modelagem e conferiu alguns exemplos de uso. Nesta seção, vamos nos aprofundar nisso: você verá casos em que essas ferramentas trazem vantagens. Claro que vamos passar por funções de modelagem e de gráficos de pacotes como lattice e stats, e também por avaliação não padrão no dplyr.
R é ótimo para modelagem estatística. Como você já sabe, modelar estatisticamente é uma forma simplificada e formal de aproximar a realidade e, opcionalmente, fazer previsões a partir dessa aproximação. Um modelo estatístico costuma representar o processo gerador de dados de forma idealizada. Para isso, você precisa de funções de modelagem.
As funções de modelagem em R são um exemplo típico de onde você precisa passar um objeto formula como argumento. Outros argumentos comuns são data, para indicar o data frame a ser usado durante o ajuste do modelo, subset para selecionar os dados que você quer usar, ... No geral, se quiser saber quais argumentos passar para uma função específica, não hesite em usar help() ou ? no console do R.
Essas funções retornam um objeto de modelo com todas as informações sobre o ajuste. Funções genéricas como print(), summary(), plot(), anova() etc. têm métodos definidos para classes específicas de objetos a fim de retornar informações apropriadas para cada tipo.
Provavelmente uma das funções mais conhecidas é a lm(), que usa todos os argumentos descritos acima. Você usa lm() para ajustar modelos lineares: regressão, ANOVA de um estrato e análise de covariância. Veja um exemplo com lm() e inspecione o modelo com print():
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
        data = iris,
        subset = Sepal.Length > 4.6)

print(lm.m)
Call:
lm(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) +
    Species, data = iris, subset = Sepal.Length > 4.6)

Coefficients:
      (Intercept)        Petal.Width  log(Petal.Length)  Speciesversicolor
           3.1531             0.6620             0.4612            -1.9265
 Speciesvirginica
          -2.3088
lm() usa inicialmente a fórmula e o ambiente apropriado para traduzir os relacionamentos entre variáveis na criação de um data frame com os dados.
Também existem os métodos model.frame(), dos quais você já viu um exemplo, usados para recuperar ou recriar o model frame a partir do objeto ajustado, sem outros argumentos. Isso permite recuperar colunas do data frame que correspondem a argumentos da chamada original além de formula, subset e weights: por exemplo, o método de glm() lida com offset, etastart e mustart.
No trecho a seguir, você usa model.frame() para obter um data frame do objeto ajustado; note que o código é um pouco diferente do trecho mostrado acima: o argumento subset foi levemente modificado.
stats::model.frame(formula = Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
                   data = iris,
                   subset = Sepal.Length > 6.9,
                   drop.unused.levels = TRUE)
| Sepal.Width | Petal.Width | log(Petal.Length) | Species | |
|---|---|---|---|---|
| 51 | 3.2 | 1.4 | 1.547563 | versicolor |
| 103 | 3.0 | 2.1 | 1.774952 | virginica |
| 106 | 3.0 | 2.1 | 1.887070 | virginica |
| 108 | 2.9 | 1.8 | 1.840550 | virginica |
| 110 | 3.6 | 2.5 | 1.808289 | virginica |
| 118 | 3.8 | 2.2 | 1.902108 | virginica |
| 119 | 2.6 | 2.3 | 1.931521 | virginica |
| 123 | 2.8 | 2.0 | 1.902108 | virginica |
| 126 | 3.2 | 1.8 | 1.791759 | virginica |
| 130 | 3.0 | 1.6 | 1.757858 | virginica |
| 131 | 2.8 | 1.9 | 1.808289 | virginica |
| 132 | 3.8 | 2.0 | 1.856298 | virginica |
| 136 | 3.0 | 2.3 | 1.808289 | virginica |
Dica: há ainda mais funções no pacote stats que permitem usar fórmulas, como aggregate().
Para modelos lineares de efeitos mistos, que permitem modelar efeitos aleatórios para capturar variações decorrentes de fatores como diferenças entre observadores, você pode usar o pacote nlme com a função lme(). Aqui também, formula é o primeiro argumento a ser informado, e há um argumento data!
# Load packages
library(MASS)
library(nlme)

# Get some data
data(oats)

# Adjust the data names and columns
names(oats) = c('block', 'variety', 'nitrogen', 'yield')
oats$mainplot = oats$variety
oats$subplot = oats$nitrogen

# Fit a non-linear mixed-effects model
nlme.m = lme(yield ~ variety*nitrogen,
             random = ~ 1|block/mainplot,
             data = oats)

# Retrieve a summary
summary(nlme.m)
Linear mixed-effects model fit by REML
 Data: oats
       AIC      BIC    logLik
  559.0285 590.4437 -264.5143

Random effects:
 Formula: ~1 | block
        (Intercept)
StdDev:    14.64496

 Formula: ~1 | mainplot %in% block
        (Intercept) Residual
StdDev:    10.29863 13.30727

Fixed effects: yield ~ variety * nitrogen
                                    Value Std.Error DF   t-value p-value
(Intercept)                      80.00000  9.106958 45  8.784492  0.0000
varietyMarvellous                 6.66667  9.715028 10  0.686222  0.5082
varietyVictory                   -8.50000  9.715028 10 -0.874933  0.4021
nitrogen0.2cwt                   18.50000  7.682957 45  2.407927  0.0202
nitrogen0.4cwt                   34.66667  7.682957 45  4.512152  0.0000
nitrogen0.6cwt                   44.83333  7.682957 45  5.835427  0.0000
varietyMarvellous:nitrogen0.2cwt  3.33333 10.865342 45  0.306786  0.7604
varietyVictory:nitrogen0.2cwt    -0.33333 10.865342 45 -0.030679  0.9757
varietyMarvellous:nitrogen0.4cwt -4.16667 10.865342 45 -0.383482  0.7032
varietyVictory:nitrogen0.4cwt     4.66667 10.865342 45  0.429500  0.6696
varietyMarvellous:nitrogen0.6cwt -4.66667 10.865342 45 -0.429500  0.6696
varietyVictory:nitrogen0.6cwt     2.16667 10.865342 45  0.199411  0.8428
 Correlation:
                                 (Intr) vrtyMr vrtyVc ntr0.2 ntr0.4 ntr0.6
varietyMarvellous                -0.533
varietyVictory                   -0.533  0.500
nitrogen0.2cwt                   -0.422  0.395  0.395
nitrogen0.4cwt                   -0.422  0.395  0.395  0.500
nitrogen0.6cwt                   -0.422  0.395  0.395  0.500  0.500
varietyMarvellous:nitrogen0.2cwt  0.298 -0.559 -0.280 -0.707 -0.354 -0.354
varietyVictory:nitrogen0.2cwt     0.298 -0.280 -0.559 -0.707 -0.354 -0.354
varietyMarvellous:nitrogen0.4cwt  0.298 -0.559 -0.280 -0.354 -0.707 -0.354
varietyVictory:nitrogen0.4cwt     0.298 -0.280 -0.559 -0.354 -0.707 -0.354
varietyMarvellous:nitrogen0.6cwt  0.298 -0.559 -0.280 -0.354 -0.354 -0.707
varietyVictory:nitrogen0.6cwt     0.298 -0.280 -0.559 -0.354 -0.354 -0.707
                                 vM:0.2 vV:0.2 vM:0.4 vV:0.4 vM:0.6
varietyMarvellous
varietyVictory
nitrogen0.2cwt
nitrogen0.4cwt
nitrogen0.6cwt
varietyMarvellous:nitrogen0.2cwt
varietyVictory:nitrogen0.2cwt     0.500
varietyMarvellous:nitrogen0.4cwt  0.500  0.250
varietyVictory:nitrogen0.4cwt     0.250  0.500  0.500
varietyMarvellous:nitrogen0.6cwt  0.500  0.250  0.500  0.250
varietyVictory:nitrogen0.6cwt     0.250  0.500  0.250  0.500  0.500

Standardized Within-Group Residuals:
        Min          Q1         Med          Q3         Max
-1.81300898 -0.56144838  0.01758044  0.63864476  1.57034166

Number of Observations: 72
Number of Groups:
              block mainplot %in% block
6 18 Observação: além do nlme, há outros pacotes, como o lme4, também dedicados ao ajuste de modelos lineares e lineares generalizados de efeitos mistos.
Outro exemplo de funções de modelagem com fórmulas é nls(), usada para modelos não lineares:
# Set seed
set.seed(20160227)

# Data
x <- seq(0,50,1)
y <- ((runif(1,10,20)*x)/(runif(1,0,10)+x))+rnorm(51,0,1)

# Non-linear model
nls.m <- nls(y ~ a*x/(b+x),
             start=c(a=4, b=1))
Um último exemplo são funções para construir Modelos Lineares Generalizados (GLM). Em R, você usa glm() para isso. E, como você já imagina, aqui também entram os argumentos formula e data:
# Load package
library(MPDiR)

# Get the data
data(Chromatic)

# Model
glm.m <- glm(Thresh ~ Axis:(I(Age^-1) + Age),
             family = Gamma(link = "identity"),
             data = Chromatic)

# Get back a summary
summary(glm.m)
Call:
glm(formula = Thresh ~ Axis:(I(Age^-1) + Age), family = Gamma(link = "identity"),
    data = Chromatic)

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-1.2160  -0.3728  -0.0805   0.2311   1.2932

Coefficients:
                      Estimate Std. Error t value Pr(>|t|)
(Intercept)          3.282e-04  9.965e-05   3.294  0.00106 **
AxisDeutan:I(Age^-1) 7.803e-03  3.686e-04  21.172  < 2e-16 ***
AxisProtan:I(Age^-1) 8.271e-03  3.863e-04  21.410  < 2e-16 ***
AxisTritan:I(Age^-1) 1.166e-02  5.284e-04  22.065  < 2e-16 ***
AxisDeutan:Age       1.521e-05  3.418e-06   4.450 1.06e-05 ***
AxisProtan:Age       1.540e-05  3.434e-06   4.484 9.10e-06 ***
AxisTritan:Age       4.812e-05  5.838e-06   8.241 1.48e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for Gamma family taken to be 0.2054848)

    Null deviance: 543.35  on 510  degrees of freedom
Residual deviance: 100.40  on 504  degrees of freedom
AIC: -4777.6

Number of Fisher Scoring iterations: 6
Antes de passar às funções gráficas, vale saber mais uma coisa: quando você usa fórmulas em funções de modelagem como lm(), ocorre uma conversão padrão de fórmula para funções. Para explicar que tipo de conversão é essa, vamos voltar ao exemplo anterior:
lm.m <- lm(Sepal.Width ~ Petal.Width + log(Petal.Length) + Species,
           data = iris,
           subset = Sepal.Length > 4.6)
Embora o objetivo seja ajustar um modelo de regressão linear, a fórmula serve para especificar o modelo simbólico e também para gerar a matriz de desenho (design matrix). Ela é a representação bidimensional do conjunto de preditores (variáveis independentes), com instâncias nas linhas e atributos nas colunas. Também é conhecida como matriz X.
Dito isso, o método de fórmula também define quais colunas devem ser incluídas nessa matriz.
O que isso significa na prática? Veja as linhas a seguir:
# A formula
y ~ x

# A converted formula
y = a_1 + a_2 * x
Esse é um exemplo simples: y ~ x é traduzido para y = a_1 + a_2 * x.
Para ver e entender o que o R faz, você pode usar model_matrix(). Essa função cria a design matrix expandindo fatores em variáveis dummy (dependendo dos contrastes) e expandindo interações de forma semelhante.
Não esqueça de passar o data frame df e a fórmula para obter um tibble que define a equação do modelo:
# Load packages
library(tidyverse)
library(modelr)

# A data frame
df <- tribble(
  ~y, ~x1, ~x2,
  4, 2, 5,
  5, 1, 6
)

# Model matrix
model_matrix(df, y ~ x1)
| (Intercept) | x1 |
|---|---|
| 1 | 2 |
| 1 | 1 |
Repare na coluna extra (Intercept). Esse é o comportamento padrão do R. A forma de adicionar o intercepto é simplesmente uma coluna cheia de 1s. Se você não quiser isso, elimine explicitamente adicionando -1 à fórmula, assim:
model_matrix(df, y ~ x1-1)
| x1 |
|---|
| 2 |
| 1 |
Observação: a matriz do modelo cresce de forma previsível quando você adiciona mais variáveis ao modelo.
model_matrix(df, y ~ x1 + x2)
| (Intercept) | x1 | x2 |
|---|---|---|
| 1 | 2 | 5 |
| 1 | 1 | 6 |
Outro lugar importante onde você vai encontrar fórmulas em R são as funções gráficas. Existem muitos pacotes, então este tutorial foca em graphics, lattice, ggplot2 e ggformula.
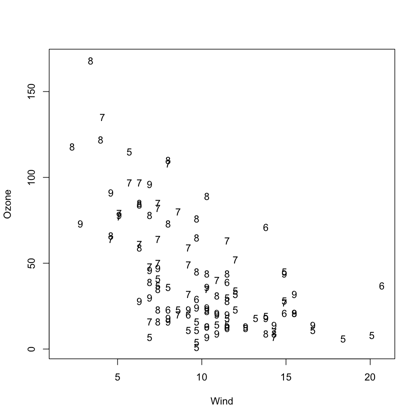
graphicsO pacote base graphics permite especificar um scatterplot ou adicionar pontos, linhas ou texto usando uma fórmula. Veja:
# Get data
data(airquality)

# Plot
plot(Ozone ~ Wind, data = airquality, pch = as.character(Month))
Se quiser saber mais, confira esta página.
latticelattice é um pacote construído sobre grid graphics. Ele oferece implementações alternativas para muitas funções de plotagem da base. Exemplos: scatterplots com xyplot(), gráficos de barras com barchart() e boxplots com bwplot().
Dica: quer aprender mais sobre lattice? Considere o curso da DataCamp Data Visualization in R with lattice.
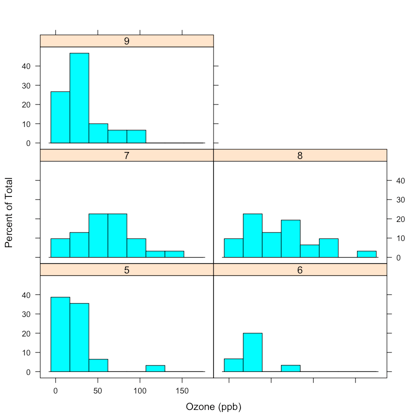
O diferencial desse pacote é usar a notação de fórmulas de modelos estatísticos para descrever o gráfico desejado e, especificamente, as variáveis a plotar. Ele também adiciona a barra vertical | para especificar a variável de condicionamento:
# Load package
library(lattice)

# Plot histogram
histogram(~ Ozone | factor(Month),
          data = airquality,
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
Observação: assim como nas funções de modelagem, as funções do lattice têm, além do argumento formula, também um data, como esperado!
Lembre-se de que você poderia omitir o argumento data acima, mas, nesse caso, precisaria anexar os dados:
# Load package
library(lattice)

# Attach data
attach(airquality)

# Plot
histogram(~ Ozone | factor(Month),
          layout = c(2, 3),
          xlab = "Ozone (ppb)")
ggplot2Você pode usar fórmulas em várias funções do ggplot2:
geom_smooth() ou stats_smooth(), para especificar a fórmula usada na suavização; isso influencia a forma do ajuste.facet_wrap(), para definir painéis de plotagem.facet_grid(), para especificar as linhas e colunas a serem plotadas, com ou sem facetamento.# Load package
library(ggplot2)
# Plot
ggplot(mpg, aes(displ, hwy)) +
geom_point() +
geom_smooth(method = "lm",
formula = y ~ splines::bs(x, 3),
se = FALSE)
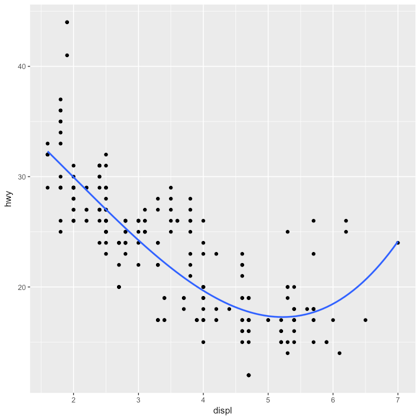
Note que, para criar esse gráfico, a fórmula usa as letras x e y, não os nomes das variáveis. Já em facet_wrap() não é assim:
ggplot(mpg, aes(displ, hwy)) +
  geom_point() +
  geom_smooth(span = 0.8) +
  facet_wrap(~drv)
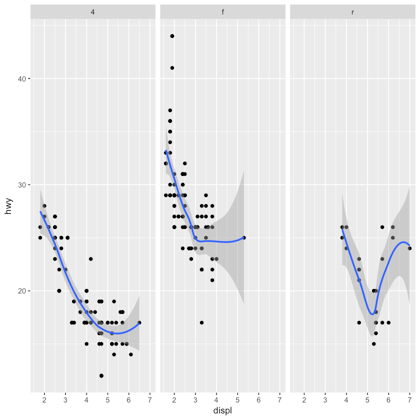
Quer aprender mais sobre ggplot2? Dê uma olhada neste curso ou consulte a documentação.
ggformulaO pacote ggformula atualmente é construído sobre o ggplot2, mas fornece uma interface baseada em fórmulas, semelhante ao lattice. Você também vai notar que o operador pipe é usado para montar gráficos mais complexos a partir de componentes simples.
Dica: se quiser saber mais sobre o operador pipe em R, confira este tutorial.
A forma básica de criar um gráfico com ggformula é
gf_plottype(formula, data = mydata)Observação: a função gf_plottype() começa com gf para lembrar que você está trabalhando com interfaces baseadas em fórmulas para o ggplot2; o g é de ggplot2 e o f de “formula”.
Veja um exemplo em R:
# Load package
library(ggformula)

# Plot
gf_point(mpg ~ hp, data = mtcars)
Claro, esse é só um gráfico básico; dá para fazer muito mais com esse pacote! Você pode escolher outro tipo de glifo e atributos específicos, criar gráficos de 1 ou 2 variáveis, ajustar posições, e por aí vai. Este tutorial não entra em mais detalhes, mas a principal mensagem é: este pacote torna as fórmulas o ingrediente principal para fazer gráficos!
Se quiser ir além do que cobrimos aqui, leia sobre o pacote ggformula ou consulte a página no RDocumentation.
dplyrdplyr é um exemplo de pacote que trabalha com avaliação não padrão (Non-Standard Evaluation). Outros exemplos: library(magrittr) versus library("magrittr") — ambos funcionam, mesmo com aspas em um e no outro não! Compare com install.packages():
# This will work
install.packages("magrittr")

# This won't work
install.packages(magrittr)
Em R, você geralmente precisa de aspas ao nomear partes de um objeto, mas em algumas funções — como library() — não. Essas funções foram projetadas para funcionar de forma não padrão. E algumas nem têm uma forma padrão!
No dplyr, a maioria das funções funciona como outras funções: todas têm avaliação padrão (SE). Porém, para uso interativo, as funções também têm uma avaliação não padrão (NSE), que economiza digitação.
(Vamos combinar: digitar todas aquelas aspas cansa!)
Por isso, a maior parte das funções do dplyr usa avaliação não padrão. Elas não seguem as regras usuais de avaliação do R. Em vez disso, capturam a expressão que você digitou e a avaliam de um jeito customizado.
Isso, porém, não significa que não exista uma variante de avaliação padrão. Toda função que usa NSE tem (e deve ter) uma "escape hatch" de avaliação padrão que faz o cálculo de fato. A versão SE termina com _. Assim, há múltiplos verbos no dplyr: select(), select_(), mutate(), mutate_() etc.
Usadas interativamente, essas funções primeiro são avaliadas com o pacote lazyeval e então enviadas para a versão SE. Ou seja, por baixo dos panos, select() é avaliada com lazyeval e enviada para select_().
Dito isso, há 3 formas de citar variáveis em funções SE que dplyr e lazyeval entendem:
quote(), e# Load `dplyr`
library(dplyr)
# NSE evaluation
select(iris, Sepal.Length, Petal.Length)
# standard evaluation
select_(iris, ~Sepal.Length)
select_(iris, ~Sepal.Length, ~Petal.Length) #works
select_(iris, quote(Sepal.Length), quote(Petal.Length)) # yes!
select_(iris, "Sepal.Length", "Petal.Length", "Species")
Dica: se quiser ler mais sobre avaliação não padrão, confira o capítulo sobre o tema no livro Advanced R, de Hadley Wickham.
Você viu que pode criar e inspecionar fórmulas usando funções como as.formula, update(), all.vars etc. Essas são operações simples, mas e as manipulações avançadas com fórmulas? Talvez os pacotes a seguir interessem!
Formula PackageRecentemente, esse pacote foi publicado no CRAN. Ele é ideal para quem quer levar fórmulas a outro nível, estendendo a classe base formula.
Mais especificamente, objetos Formula estendem as fórmulas básicas: com esse pacote, você pode definir fórmulas que aceitam um operador adicional | separando múltiplas partes ou que podem conter operadores de fórmula (incluindo a barra vertical) no lado esquerdo para suportar múltiplas respostas.
Exemplos de fórmulas que você poderá criar:
y ~ x1 + x2 | u1 + u2 + u3 | v1 + v2y1 + y2 ~ x1 + x2 + x3y1 | y2 + y3 ~ x; e# Load package
library(Formula)
# Create formulas
f1 <- y ~ x1 + x2 | z1 + z2 + z3
F1 <- Formula(f1)
# Retrieve the class of `F1`
class(F1)
Observação: as funções as.formula() e is.formula() também foram atualizadas neste pacote: use is.Formula() e as.Formula()!
Leia mais aqui.
formula.toolsEste pacote foi lançado recentemente e oferece "utilitários programáticos para manipular fórmulas, expressões, chamadas, atribuições e outros objetos R". É muita coisa, mas, em essência, você pode acessar e modificar estruturas de fórmulas e extrair/substituir nomes e símbolos desses objetos. O pacote foi escrito por Christopher Brown.
Alguns recursos úteis ao trabalhar com ele:
get.vars(): em vez de all.vars(), extrai nomes de variáveis de vários objetos R, interpolando todos os símbolos etc. para nomes de variáveis.invert(): inverte os operadores de um objeto, como uma fórmula.is.one.sided(): muito útil para determinar se uma fórmula é unilateral ou bilateral.Lembre-se: uma fórmula é unilateral se for assim: ~x; será bilateral quando formulada como x~y.
Parabéns! Você chegou ao fim deste tutorial sobre fórmulas em R. Se quiser se aprofundar, confira o livro R for Data Science, de Hadley Wickham, que tem um capítulo dedicado a fórmulas e famílias de modelos em R.
Veja também o tutorial da DataCamp Primeiros passos com o Tidyverse.
Você lembra de mais casos em que fórmulas aparecem ou de pacotes para manipulá-las? Me conta no Twitter: @willems_karlijn.
Cursos de R
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Karlijn Willems
15 min
Tutorial
Kevin Babitz
15 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Zoumana Keita
12 min