programa
Fundamentos de la IA
10 h
Adoptar la revolución de la IA en el desarrollo de aplicaciones marca una nueva era en la interacción humano-IA. Aunque las empresas se apoyan en la IA para mejorar la experiencia de usuario, la integración de soluciones basadas en LLM también plantea retos a la hora de mantener la integridad del contenido, la precisión y los estándares éticos.
La necesidad de una moderación responsable con IA se hace evidente a medida que las aplicaciones se expanden más allá de entornos controlados, donde garantizar respuestas razonables y precisas quizá no sea técnicamente tan sencillo, pero sí crucial.
En la atención al cliente, por ejemplo, la desinformación o el contenido inapropiado pueden provocar insatisfacción y dañar la reputación de la marca. Pero como desarrollador, ¿cómo te aseguras de que tu aplicación basada en IA ofrece respuestas razonables y exactas a tus usuarios? ¡Ahí es donde entra en juego la moderación con IA!
En este artículo, profundizaremos en una técnica para moderar aplicaciones basadas en GPT utilizando modelos GPT.
Moderar la calidad con IA también implica garantizar respuestas no sesgadas y adecuadas cuando trabajas con LLM. OpenAI ya ha presentado una API diseñada para estas necesidades de moderación. Si te interesa detectar respuestas sesgadas o inapropiadas de tu modelo o gestionar comportamientos indebidos de usuarios, encontrarás ideas útiles en el artículo ChatGPT Moderation API: Input/Output Control.
No obstante, este artículo propone un enfoque distinto de la moderación con IA. Aquí nos centramos en garantizar la calidad de las respuestas del modelo en términos de precisión y ajuste a los requisitos del usuario. Hasta donde sé, no existe un endpoint oficial específicamente diseñado para este propósito.
Aun así, dado el uso extensivo de modelos GPT en multitud de aplicaciones, ¿por qué no emplearlos también como verificadores de calidad de instancias del mismo modelo?
Podemos apoyarnos en modelos GPT para evaluar el resultado que genera el propio modelo ante las peticiones del usuario. Este enfoque de testeo ayuda a prevenir respuestas vagas o erróneas y mejora la capacidad del modelo para cumplir con lo que el usuario ha pedido.
Este artículo cubre cómo emplear modelos GPT para moderar aplicaciones basadas en GPT en términos de calidad y corrección dentro del alcance de tu aplicación.
Por ejemplo, si utilizas modelos GPT para impulsar el chatbot de tu negocio, seguro que te interesa evitar que tu chatbot proporcione información fuera de tus productos o características del catálogo.
En las siguientes secciones, daremos vida a este último ejemplo con llamadas sencillas a la API de OpenAI mediante el paquete de Python openai y los conocidos Jupyter Notebooks.
El objetivo principal será generar una aplicación sencilla basada en un LLM y moderar su salida con un verificador de calidad también basado en LLM. Para nuestro ejemplo, crearemos un agente de atención al cliente, el agente verificador de calidad —en adelante, agente de QA— y, lo más importante, definiremos la interacción entre ambos.
El siguiente esquema ofrece una buena representación del flujo de trabajo mencionado:
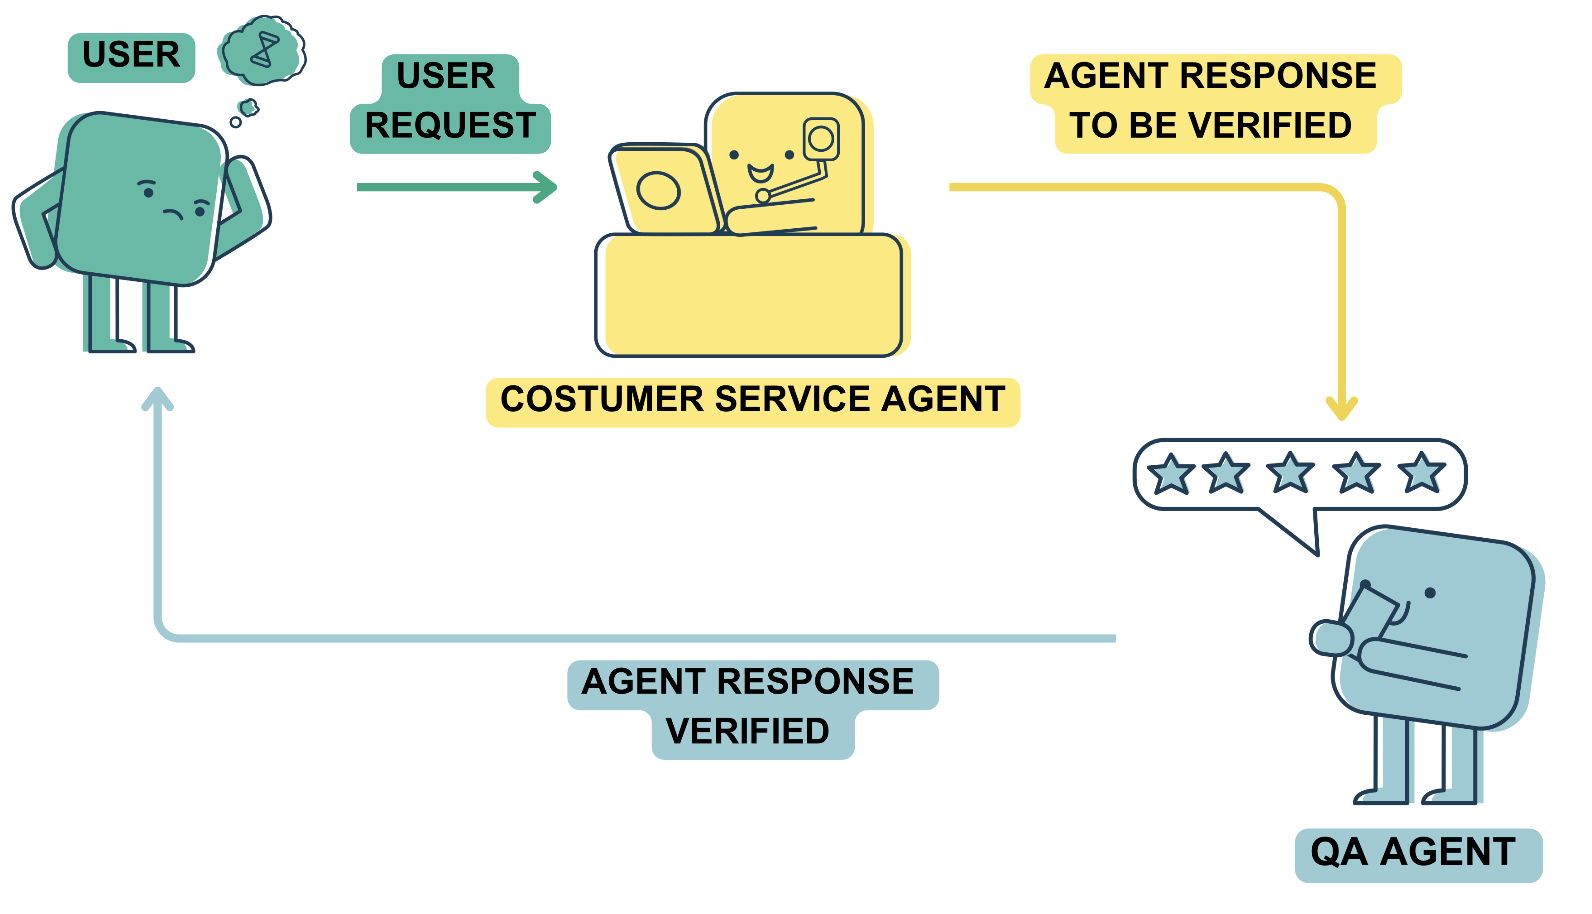
Imagen propia. Representación del flujo de moderación: 1. El usuario envía una petición a la aplicación basada en LLM, en este ejemplo un chatbot de atención al cliente. 2. El chatbot genera la respuesta, pero primero la envía al agente de QA. 3. El agente de QA devuelve la respuesta al usuario tras comprobar que es adecuada.
¡Vamos paso a paso!
Empecemos creando un agente conversacional para el servicio de atención al cliente de una tienda.
Si ya tienes una aplicación con LLM en marcha, puedes saltarte esta primera sección o implementar tu propio ejemplo. Y si aún te preguntas si tu negocio puede beneficiarse de una aplicación basada en LLM, te recomiendo este podcast.
Imaginemos que estamos creando un agente de atención al cliente para nuestra tienda. Queremos usar un modelo como ChatGPT detrás del agente para aprovechar su capacidad de entender consultas en lenguaje natural y responder de forma natural.
Para definir nuestro chatbot de atención al cliente, necesitaremos dos ingredientes clave:
Por último, como en cualquier otra aplicación basada en LLM, necesitamos una forma de llamar a la API de OpenAI desde nuestros scripts. En este artículo, usaré la siguiente implementación que solo depende del paquete openai:
import openai
import os

# Get the OpenAI key from the environment
openai_api_key = os.environ["OPENAI_API_KEY"]

# Simple OpenAI API call with a memory of past interactions
def gpt_call(prompt, message_history, model="gpt-3.5-turbo"):
message_history.append({'role': 'user', 'content': prompt})
response = openai.ChatCompletion.create(
model=model,
messages=message_history
)

response_text = response.choices[0].message["content"]
message_history.append({'role': 'assistant', 'content': response_text})
return response_text
La idea es inicializar un historial de mensajes independiente —que incluya el mensaje de sistema— para cada instancia del modelo e ir actualizándolo con las siguientes interacciones.
Si buscas una forma más optimizada de gestionar las interacciones, te recomiendo usar el framework langchain como hicimos en Building Context-Aware Chatbots: Leveraging LangChain Framework for ChatGPT.
Si eres nuevo en la API de OpenAI, echa un vistazo al webinar Getting Started with the OpenAI API and ChatGPT.
Ahora que tenemos los bloques necesarios, vamos a unirlos:
# Define our sample product catalog
product_information = """
{ "name": "UltraView QLED TV", "category": "Televisions and Home Theater Systems", "brand": "UltraView", "model_number": "UV-QLED65", "warranty": "3 years", "rating": 4.9, "features": [ "65-inch QLED display", "8K resolution", "Quantum HDR", "Dolby Vision", "Smart TV" ], "description": "Experience lifelike colors and incredible clarity with this high-end QLED TV.", "price": 2499.99 }
{ "name": "ViewTech Android TV", "category": "Televisions and Home Theater Systems", "brand": "ViewTech", "model_number": "VT-ATV55", "warranty": "2 years", "rating": 4.7, "features": [ "55-inch 4K display", "Android TV OS", "Voice remote", "Chromecast built-in" ], "description": "Access your favorite apps and content on this smart Android TV.", "price": 799.99 }
{ "name": "SlimView OLED TV", "category": "Televisions and Home Theater Systems", "brand": "SlimView", "model_number": "SL-OLED75", "warranty": "2 years", "rating": 4.8, "features": [ "75-inch OLED display", "4K resolution", "HDR10+", "Dolby Atmos", "Smart TV" ], "description": "Immerse yourself in a theater-like experience with this ultra-thin OLED TV.", "price": 3499.99 }
{ "name": "TechGen X Pro", "category": "Smartphones and Accessories", "brand": "TechGen", "model_number": "TG-XP20", "warranty": "1 year", "rating": 4.5, "features": [ "6.4-inch AMOLED display", "128GB storage", "48MP triple camera", "5G", "Fast charging" ], "description": "A feature-packed smartphone designed for power users and mobile enthusiasts.", "price": 899.99 }
{ "name": "GigaPhone 12X", "category": "Smartphones and Accessories", "brand": "GigaPhone", "model_number": "GP-12X", "warranty": "2 years", "rating": 4.6, "features": [ "6.7-inch IPS display", "256GB storage", "108MP quad camera", "5G", "Wireless charging" ], "description": "Unleash the power of 5G and high-resolution photography with the GigaPhone 12X.", "price": 1199.99 }
{ "name": "Zephyr Z1", "category": "Smartphones and Accessories", "brand": "Zephyr", "model_number": "ZP-Z1", "warranty": "1 year", "rating": 4.4, "features": [ "6.2-inch LCD display", "64GB storage", "16MP dual camera", "4G LTE", "Long battery life" ], "description": "A budget-friendly smartphone with reliable performance for everyday use.", "price": 349.99 }
{ "name": "PixelMaster Pro DSLR", "category": "Cameras and Camcorders", "brand": "PixelMaster", "model_number": "PM-DSLR500", "warranty": "2 years", "rating": 4.8, "features": [ "30.4MP full-frame sensor", "4K video", "Dual Pixel AF", "3.2-inch touchscreen" ], "description": "Unleash your creativity with this professional-grade DSLR camera.", "price": 1999.99 }
{ "name": "ActionX Waterproof Camera", "category": "Cameras and Camcorders", "brand": "ActionX", "model_number": "AX-WPC100", "warranty": "1 year", "rating": 4.6, "features": [ "20MP sensor", "4K video", "Waterproof up to 50m", "Wi-Fi connectivity" ], "description": "Capture your adventures with this rugged and versatile action camera.", "price": 299.99 }
{ "name": "SonicBlast Wireless Headphones", "category": "Audio and Headphones", "brand": "SonicBlast", "model_number": "SB-WH200", "warranty": "1 year", "rating": 4.7, "features": [ "Active noise cancellation", "50mm drivers", "30-hour battery life", "Comfortable earpads" ], "description": "Immerse yourself in superior sound quality with these wireless headphones.", "price": 149.99 }
"""

# Define a proper system message for our use case
customer_agent_sysmessage = f"""
You are a customer service agent that responds to \
customer questions about the products in the catalog. \
The product catalog will be delimited by 3 backticks, i.e. ```. \
Respond in a friendly and human-like tone giving details with \
the information available from the product catalog. \

Product catalog: ```{product_information}```
"""

# Initialize your model's memory
customer_agent_history = [{'role': 'system', 'content': customer_agent_sysmessage}]
Como vemos, hemos definido un catálogo de ejemplo (product_catalog) en formato jsonl y un mensaje de sistema (customer_agent_sysmessage) con tres requisitos:
Por último, también hemos inicializado el historial de mensajes para el agente de atención (customer_agent_history).
Es interesante observar el estilo usado en el mensaje de sistema y la información adicional, por ejemplo, las triple comillas invertidas. ¡Es una de las buenas prácticas de prompting! Si te interesan más buenas prácticas, el webinar A Beginner's Guide to Prompt Engineering with ChatGPT es para ti.
Llegados a este punto, ya podemos usar nuestro chatbot de ejemplo así:
user_prompt = "Which is the best TV in your shop?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: In our shop, the UltraView QLED TV is considered to be the best TV. It has a rating of 4.9 and offers a 65-inch QLED display with 8K resolution. It also features Quantum HDR, Dolby Vision, and Smart TV capabilities. With its lifelike colors and incredible clarity, this high-end QLED TV delivers an immersive viewing experience. The UltraView QLED TV is priced at $2499.99 and comes with a warranty of 3 years.
Parece una respuesta natural, ¿verdad? Hagamos una interacción de seguimiento:
user_prompt = "I want to buy the latest iphone. Can you help me?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: Of course! I'd be happy to help you find the latest iPhone. However, as it appears to be missing from the product catalog, I'm unable to provide specific details on the latest iPhone model at this time. I recommend checking our website or contacting our store directly for the most up-to-date information on the latest iPhone models available. Our knowledgeable staff will be able to assist you in selecting the perfect iPhone that meets your needs and preferences.
¡Tiene sentido! El agente identifica que no hay iPhone en el catálogo y responde en consecuencia. ¡Incluso anima al usuario a contactar con la tienda!
Probemos una petición más:
user_prompt = "Can you help me buy a Samsung TV?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: Absolutely! I'd be delighted to assist you in purchasing a Samsung TV. Could you please provide me with some specific requirements or preferences you have in mind? This way, I can recommend the best Samsung TV model that suits your needs.
Bien, parece que en algunos casos el agente puede pasar por alto la información del catálogo. En esos casos, el agente de QA puede ayudar a filtrar respuestas no deseadas.
Como ya hemos comentado, el propósito del agente de QA es comprobar la calidad del agente de atención al cliente dado el mensaje del usuario y el catálogo de productos. Por tanto, es importante definir un mensaje de sistema que establezca exactamente este comportamiento de alto nivel:
qa_sysmessage = f"""
	You are a quality assistant that evaluates whether \
	a customer service agent answers to the customer \
	questions correctly. \
	You must also validate that the customer service agent \
	provides information only from the product catalog \
	of our store and gently refuses any other product outside the catalog. \
	The customer message, the customer service agent's response, and \
	the product catalog will be delimited by \
	3 backticks, i.e. ```. \

	Give a reason for your answer.
	"""
En el caso del agente de atención, el prompt del usuario es imprevisible, ya que depende de sus necesidades y estilo. En el caso del agente de QA, nosotros nos encargamos de pasar la petición del usuario, la respuesta del agente y el catálogo al modelo. Así, nuestro prompt tendrá siempre la misma estructura, cambiando la consulta del usuario (user_request) y la respuesta del modelo (customer_agent_response):
qa_prompt = f"""
Customer question: ```{user_prompt}```
Product catalog: ```{product_information}```
Agent response: ```{customer_agent_response}```
"""
Una vez definidos el mensaje de sistema y el prompt de QA, podemos probar el agente de QA con la última respuesta del agente de atención así:
# Initialize the QA-agent memory
qa_history = [{'role': 'system', 'content': qa_sysmessage}]

# Call the QA-agent with our templated query
qa_response = chatgpt_call(qa_prompt, qa_history)
print(qa_response)

# Output: Quality Check: Incorrect Response

Feedback: The customer asked for help in buying a Samsung TV but the agent did not address that request. The agent should have mentioned that they only have access to the product catalog of our store and can provide information and recommendations based on that catalog. The agent should have gently refused any other product outside the catalog.
Para evaluar la respuesta del agente de QA, desglosamos la interacción que analiza:
Can you help me buy a Samsung TV?»Absolutely! I'd be delighted to assist you in purchasing a Samsung TV. Could you please provide me with some specific requirements or preferences you have in mind? This way, I can recommend the best Samsung TV model that suits your needs.»Quality Check: Incorrect ResponseFeedback: The customer asked for help in buying a Samsung TV but the agent did not address that request. The agent should have mentioned that they only have access to the product catalog of our store and can provide information and recommendations based on that catalog. The agent should have gently refused any other product outside the catalog.»¡El agente de calidad es capaz de detectar respuestas inadecuadas del agente de atención!
Ahora que tenemos los dos agentes funcionando de forma independiente, toca definir su interacción.
Podemos representar ambos agentes y sus requisitos en un esquema sencillo:
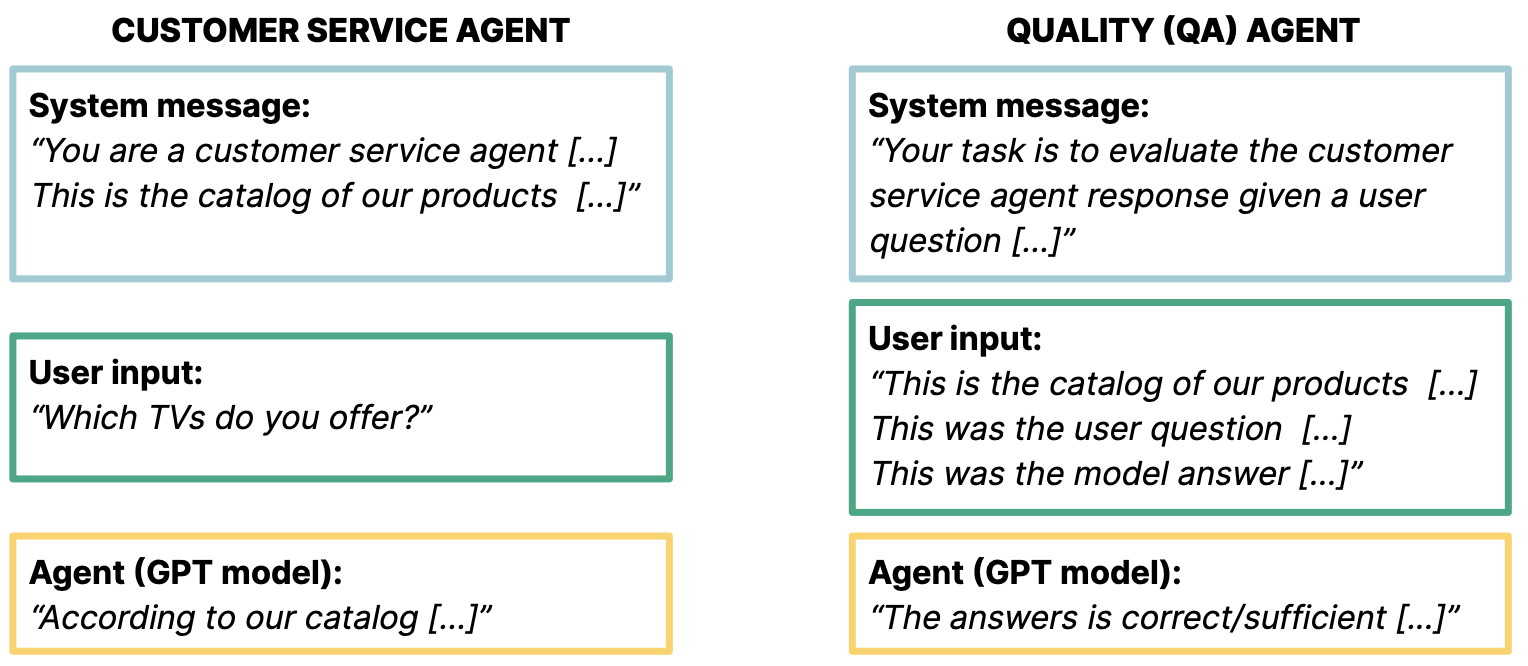
Imagen propia. Representación de los tres bloques de cada agente: mensaje de sistema (azul), entrada del modelo (verde) y salida del modelo (amarillo).
¿Qué sigue? ¡Ahora debemos implementar la interacción entre ambos modelos!
Aquí tienes una propuesta para filtrar respuestas inexactas:
Primero, dejamos que el agente de atención genere la respuesta a partir de la consulta del usuario. Si el agente de QA considera que la respuesta es suficientemente buena y se ajusta al catálogo, simplemente la enviamos al usuario.
Por el contrario, si el agente de QA determina que la respuesta no satisface la petición del usuario o incluye información que no está en el catálogo, podemos pedir al agente de atención que la mejore antes de enviarla.
Con esta idea, podemos mejorar la última parte del esquema original así:
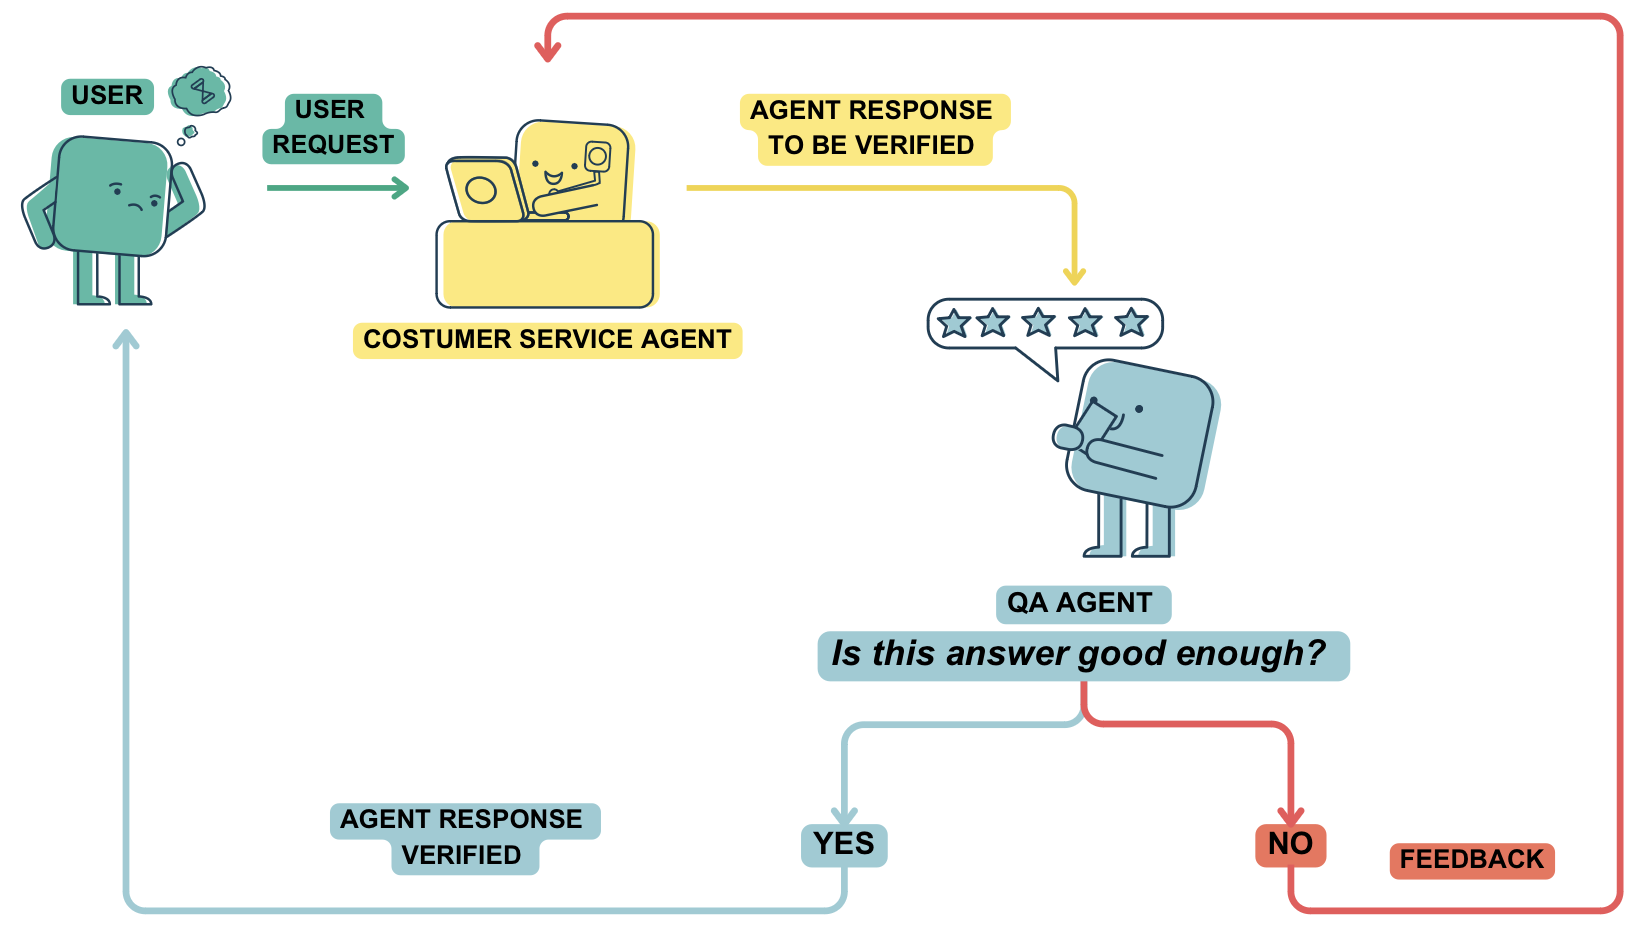
Imagen propia. Representación del flujo de moderación ampliado. Podemos usar el juicio del agente de QA para proporcionar feedback a la aplicación basada en LLM.
Para usar el agente de QA como filtro, debemos asegurarnos de que produzca una salida consistente en cada iteración.
Una forma de lograrlo es modificar ligeramente su mensaje de sistema y pedirle que devuelva solo True si la respuesta del agente de atención es suficiente o False en caso contrario:
qa_sysmessage = f"""
	You are a quality assistant that evaluates whether \
	a customer service agent answers to the customer \
	questions correctly. \

	You must also validate that the customer service agent \
	provides information only from the product catalog \
	of our store and gently refuses any other product outside the catalog. \

	The customer message, the customer service agent's response and \
	the product catalog will be delimited by \
	3 backticks, i.e. ```. \

	Respond with True or False no punctuation: \
	True - if the agent sufficiently answers the question \
	AND the response correctly uses product information \
	False - otherwise
	"""
Por tanto, al evaluar de nuevo la última respuesta del agente de atención, obtendremos simplemente un booleano:
# Let's reinitialize the memory
qa_history = [{'role': 'system', 'content': qa_sysmessage}]

qa_response = gpt_call(qa_prompt, qa_history)
print(qa_response)

# Output: False
Podemos usar este valor booleano para enviar la respuesta al usuario —si el agente de QA evalúa True— o para darle al modelo una segunda oportunidad de generar una nueva respuesta —si evalúa False.
¡Juntemos todas las piezas!
Dado que ya hemos inicializado las dos memorias —con sus respectivos mensajes de sistema e información adicional—, cada petición del usuario se puede procesar así:
user_prompt = "Can you help me buy a Samsung TV?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)

qa_response = gpt_call(qa_prompt, qa_history)

if qa_response == "False":
print("The chatbot response is not sufficient!")
else:
print("Sending response to user...")
print(customer_agent_response)
Como hemos descrito, hemos filtrado las respuestas según su corrección. Te dejo decidir qué hacer con las respuestas no válidas. Hemos propuesto enviar feedback al agente de atención y pedirle que reintente, pero ¿y si pedimos al agente de QA una respuesta mejor? ¡Hay muchas posibilidades!
En este artículo hemos explorado el potencial de usar modelos GPT como moderadores de otras instancias del mismo tipo. Hemos demostrado que las mismas capacidades que nos han llevado a integrar LLM en nuestras aplicaciones pueden ayudarlas a mejorar la precisión y la integridad de las interacciones con los usuarios.
Al contrario de lo que se piensa, introducir niveles de moderación no tiene por qué aumentar la complejidad de la aplicación y, como hemos visto, a veces basta con unas pocas líneas bien diseñadas para mejorar significativamente su funcionalidad.
En el mundo actual, impulsado por la IA, la moderación responsable de LLM es imprescindible. No es solo una opción, también es una obligación ética. Al integrar moderación con IA, nos aseguramos de que nuestras aplicaciones no solo sean potentes, sino también fiables y éticas. Avancemos con desarrollo responsable para seguir aprovechando la IA sin renunciar a la precisión.
¡Gracias por leer! Si te ha interesado la moderación con IA, te animo a continuar con Promoting Responsible AI: Content Moderation in ChatGPT como material de seguimiento.
¡Empieza hoy tu camino en IA!
programa
Curso
Curso
blog
Matt Crabtree
13 min
Tutorial
Moez Ali
11 min
Tutorial
Matt Crabtree
6 min
Tutorial
Moez Ali
7 min
Tutorial
Moez Ali
9 min
Tutorial
Adel Nehme
9 min