Lernpfad
Grundlagen der KI
10 Std.
Die KI-Revolution in der Anwendungsentwicklung markiert eine neue Ära der Mensch-KI-Interaktion. Unternehmen setzen KI ein, um Nutzererlebnisse zu verbessern — gleichzeitig bringt die Integration von LLM-basierten Lösungen Herausforderungen mit sich: Inhalte müssen integer, korrekt und ethisch einwandfrei bleiben.
Mit der Ausweitung von Anwendungen über kontrollierte Umgebungen hinaus wird der Bedarf an verantwortungsvoller KI-Moderation offensichtlich. Angemessene und akkurate Antworten sicherzustellen ist vielleicht technisch nicht trivial, aber absolut entscheidend.
In der Kundenkommunikation können Fehlinformationen oder unangebrachte Inhalte etwa zu Unzufriedenheit und Imageschäden führen. Doch wie sorgst du als Developer dafür, dass deine KI-Anwendung vernünftige und korrekte Antworten liefert? Genau hier kommt KI-Moderation ins Spiel!
In diesem Artikel schauen wir uns eine Technik zur Moderation GPT-basierter Anwendungen mit Hilfe von GPT-Modellen an.
Qualitätsmoderation für KI bedeutet auch: Antworten von LLMs müssen unverzerrt und angemessen sein. OpenAI hat bereits eine API für solche Moderationsfälle eingeführt. Wenn du Voreingenommenheiten oder unpassende Antworten deines Modells erkennen oder Fehlverhalten der Nutzenden adressieren möchtest, findest du wertvolle Einblicke im Artikel ChatGPT Moderation API: Input/Output Control.
Dieser Artikel wählt jedoch einen anderen Ansatz für KI-Moderation. Unser Fokus liegt darauf, die Qualität der Modellantworten im Hinblick auf Genauigkeit und Erfüllung der Nutzeranforderungen sicherzustellen. Soweit mir bekannt, gibt es dafür keinen offiziellen, speziell zugeschnittenen Endpoint.
Aber: Wenn wir GPT-Modelle ohnehin in verschiedenen Anwendungen einsetzen, warum sie nicht als Qualitätsprüfer für Instanzen desselben Modells nutzen?
Wir können GPT-Modelle heranziehen, um die vom Modell erzeugten Antworten auf Nutzeranfragen zu beurteilen. Dieser Testansatz hilft, vage oder falsche Antworten zu vermeiden und verbessert die Fähigkeit des Modells, Nutzerwünsche präzise zu erfüllen.
Dieser Artikel zeigt, wie du GPT-Modelle zur Qualitäts- und Korrektheitsmoderation GPT-basierter Anwendungen innerhalb deines Anwendungskontexts einsetzt.
Wenn du zum Beispiel GPT-Modelle für einen Business-Chatbot nutzt, willst du sicherstellen, dass er keine Informationen außerhalb deiner Katalogartikel oder -eigenschaften ausgibt.
In den folgenden Abschnitten setzen wir dieses Beispiel um — mit einfachen Aufrufen der OpenAI API über das Python-Paket openai und Jupyter Notebooks.
Das Hauptziel: eine einfache LLM-Anwendung bauen und deren Output mit einem LLM-basierten Qualitätsprüfer moderieren. Dafür erstellen wir einen Beispiel-Kundenservice-Agenten, den Quality-Checker — im Folgenden QA-Agent — und definieren vor allem die Interaktion zwischen beiden.
Das folgende Schema veranschaulicht den beschriebenen Ablauf:
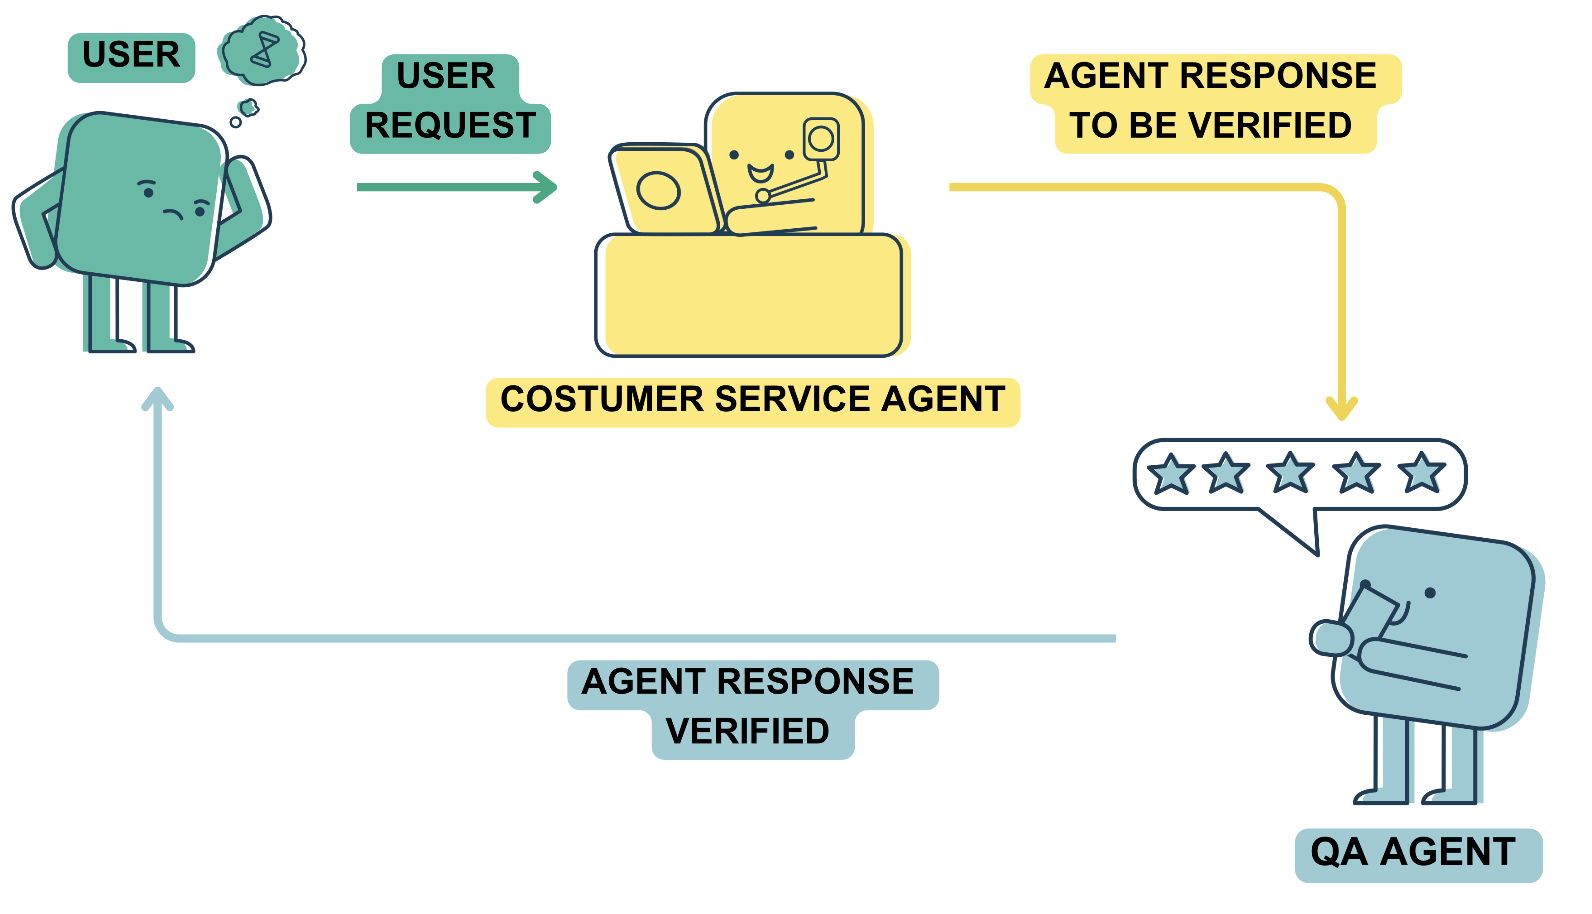
Eigenes Schaubild. Darstellung des Moderations-Workflows: 1. Der User sendet eine Anfrage an die LLM-Anwendung, hier einen Kundenservice-Chatbot. 2. Der Chatbot generiert die Antwort, sendet sie jedoch zuerst an den QA-Agenten. 3. Der QA-Agent gibt die Antwort nach Prüfung an den User weiter.
Gehen wir es Schritt für Schritt an!
Starten wir mit einem Conversation-Agent für den Kundenservice eines Shops.
Du kannst diesen ersten Abschnitt überspringen, wenn du bereits eine funktionierende LLM-Anwendung hast — oder dein eigenes Beispiel umsetzen möchtest. Und falls du dich fragst, ob dein Unternehmen von einer LLM-Anwendung profitiert: Hör in diese Podcast-Diskussion rein!
Stell dir vor, wir bauen einen Kundenservice-Agenten für unseren Shop. Wir wollen ein Modell wie ChatGPT einsetzen, um dank natürlicher Sprachfähigkeiten Anfragen zu verstehen und menschlich zu antworten.
Für unseren Kundenservice-Chatbot brauchen wir zwei zentrale Bausteine:
Wie bei jeder LLM-Anwendung brauchen wir außerdem eine Möglichkeit, die OpenAI API aus unseren Scripts aufzurufen. In diesem Artikel verwende ich folgende Implementierung, die nur das Paket openai nutzt:
import openai
import os

# Get the OpenAI key from the environment
openai_api_key = os.environ["OPENAI_API_KEY"]

# Simple OpenAI API call with a memory of past interactions
def gpt_call(prompt, message_history, model="gpt-3.5-turbo"):
message_history.append({'role': 'user', 'content': prompt})
response = openai.ChatCompletion.create(
model=model,
messages=message_history
)

response_text = response.choices[0].message["content"]
message_history.append({'role': 'assistant', 'content': response_text})
return response_text
Die Idee: Für jede Modellinstanz eine eigene Nachrichtenhistorie initialisieren — mit Systemnachricht — und sie mit jeder weiteren Interaktion fortschreiben.
Wenn du Interaktionen effizienter steuern willst, empfehle ich das LangChain-Framework, wie in Building Context-Aware Chatbots: Leveraging LangChain Framework for ChatGPT gezeigt.
Wenn du neu bei der OpenAI API bist, schau dir das Webinar Getting Started with the OpenAI API and ChatGPT an.
Jetzt fügen wir die Bausteine zusammen:
# Define our sample product catalog
product_information = """
{ "name": "UltraView QLED TV", "category": "Televisions and Home Theater Systems", "brand": "UltraView", "model_number": "UV-QLED65", "warranty": "3 years", "rating": 4.9, "features": [ "65-inch QLED display", "8K resolution", "Quantum HDR", "Dolby Vision", "Smart TV" ], "description": "Experience lifelike colors and incredible clarity with this high-end QLED TV.", "price": 2499.99 }
{ "name": "ViewTech Android TV", "category": "Televisions and Home Theater Systems", "brand": "ViewTech", "model_number": "VT-ATV55", "warranty": "2 years", "rating": 4.7, "features": [ "55-inch 4K display", "Android TV OS", "Voice remote", "Chromecast built-in" ], "description": "Access your favorite apps and content on this smart Android TV.", "price": 799.99 }
{ "name": "SlimView OLED TV", "category": "Televisions and Home Theater Systems", "brand": "SlimView", "model_number": "SL-OLED75", "warranty": "2 years", "rating": 4.8, "features": [ "75-inch OLED display", "4K resolution", "HDR10+", "Dolby Atmos", "Smart TV" ], "description": "Immerse yourself in a theater-like experience with this ultra-thin OLED TV.", "price": 3499.99 }
{ "name": "TechGen X Pro", "category": "Smartphones and Accessories", "brand": "TechGen", "model_number": "TG-XP20", "warranty": "1 year", "rating": 4.5, "features": [ "6.4-inch AMOLED display", "128GB storage", "48MP triple camera", "5G", "Fast charging" ], "description": "A feature-packed smartphone designed for power users and mobile enthusiasts.", "price": 899.99 }
{ "name": "GigaPhone 12X", "category": "Smartphones and Accessories", "brand": "GigaPhone", "model_number": "GP-12X", "warranty": "2 years", "rating": 4.6, "features": [ "6.7-inch IPS display", "256GB storage", "108MP quad camera", "5G", "Wireless charging" ], "description": "Unleash the power of 5G and high-resolution photography with the GigaPhone 12X.", "price": 1199.99 }
{ "name": "Zephyr Z1", "category": "Smartphones and Accessories", "brand": "Zephyr", "model_number": "ZP-Z1", "warranty": "1 year", "rating": 4.4, "features": [ "6.2-inch LCD display", "64GB storage", "16MP dual camera", "4G LTE", "Long battery life" ], "description": "A budget-friendly smartphone with reliable performance for everyday use.", "price": 349.99 }
{ "name": "PixelMaster Pro DSLR", "category": "Cameras and Camcorders", "brand": "PixelMaster", "model_number": "PM-DSLR500", "warranty": "2 years", "rating": 4.8, "features": [ "30.4MP full-frame sensor", "4K video", "Dual Pixel AF", "3.2-inch touchscreen" ], "description": "Unleash your creativity with this professional-grade DSLR camera.", "price": 1999.99 }
{ "name": "ActionX Waterproof Camera", "category": "Cameras and Camcorders", "brand": "ActionX", "model_number": "AX-WPC100", "warranty": "1 year", "rating": 4.6, "features": [ "20MP sensor", "4K video", "Waterproof up to 50m", "Wi-Fi connectivity" ], "description": "Capture your adventures with this rugged and versatile action camera.", "price": 299.99 }
{ "name": "SonicBlast Wireless Headphones", "category": "Audio and Headphones", "brand": "SonicBlast", "model_number": "SB-WH200", "warranty": "1 year", "rating": 4.7, "features": [ "Active noise cancellation", "50mm drivers", "30-hour battery life", "Comfortable earpads" ], "description": "Immerse yourself in superior sound quality with these wireless headphones.", "price": 149.99 }
"""

# Define a proper system message for our use case
customer_agent_sysmessage = f"""
You are a customer service agent that responds to \
customer questions about the products in the catalog. \
The product catalog will be delimited by 3 backticks, i.e. ```. \
Respond in a friendly and human-like tone giving details with \
the information available from the product catalog. \

Product catalog: ```{product_information}```
"""

# Initialize your model's memory
customer_agent_history = [{'role': 'system', 'content': customer_agent_sysmessage}]
Wie du siehst, haben wir einen Beispielkatalog (product_catalog) im jsonl-Format und eine Systemnachricht (customer_agent_sysmessage) mit drei Vorgaben definiert:
Außerdem haben wir die Nachrichtenhistorie für den Kundenservice-Agenten (customer_agent_history) initialisiert.
Auffällig ist der klare Stil der Systemnachricht und Zusatzinfos, z. B. die dreifachen Backticks. Das ist eine Prompting-Best Practice! Mehr dazu im Webinar A Beginner's Guide to Prompt Engineering with ChatGPT.
Jetzt können wir unseren Beispiel-Chatbot so nutzen:
user_prompt = "Which is the best TV in your shop?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: In our shop, the UltraView QLED TV is considered to be the best TV. It has a rating of 4.9 and offers a 65-inch QLED display with 8K resolution. It also features Quantum HDR, Dolby Vision, and Smart TV capabilities. With its lifelike colors and incredible clarity, this high-end QLED TV delivers an immersive viewing experience. The UltraView QLED TV is priced at $2499.99 and comes with a warranty of 3 years.
Klingt nach einer natürlichen Antwort, oder? Machen wir weiter:
user_prompt = "I want to buy the latest iphone. Can you help me?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: Of course! I'd be happy to help you find the latest iPhone. However, as it appears to be missing from the product catalog, I'm unable to provide specific details on the latest iPhone model at this time. I recommend checking our website or contacting our store directly for the most up-to-date information on the latest iPhone models available. Our knowledgeable staff will be able to assist you in selecting the perfect iPhone that meets your needs and preferences.
Nachvollziehbar! Der Agent erkennt, dass kein iPhone im Katalog steht, und reagiert entsprechend — inklusive Hinweis auf den direkten Kontakt.
Noch eine Anfrage:
user_prompt = "Can you help me buy a Samsung TV?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)
print(customer_agent_response)

# Output: Absolutely! I'd be delighted to assist you in purchasing a Samsung TV. Could you please provide me with some specific requirements or preferences you have in mind? This way, I can recommend the best Samsung TV model that suits your needs.
Genau, in manchen Fällen ignoriert der Agent den Katalog. Hier hilft der QA-Agent, unerwünschte Antworten zu filtern.
Wie besprochen prüft der QA-Agent die Qualität der Antwort des Kundenservice-Agenten auf Basis der Nutzeranfrage und des Produktkatalogs. Dafür brauchen wir eine Systemnachricht, die genau dieses Verhalten festlegt:
qa_sysmessage = f"""
	You are a quality assistant that evaluates whether \
	a customer service agent answers to the customer \
	questions correctly. \
	You must also validate that the customer service agent \
	provides information only from the product catalog \
	of our store and gently refuses any other product outside the catalog. \
	The customer message, the customer service agent's response, and \
	the product catalog will be delimited by \
	3 backticks, i.e. ```. \

	Give a reason for your answer.
	"""
Beim Kundenservice-Agenten ist der User-Prompt unvorhersehbar — er hängt vom Bedarf und Schreibstil ab. Beim QA-Agenten übergeben wir gezielt Nutzeranfrage, Antwort des Kundenservice-Agenten und Katalog. Unser Prompt hat also stets dieselbe Struktur, nur mit wechselnder Nutzeranfrage (user_request) und Antwort (customer_agent_response):
qa_prompt = f"""
Customer question: ```{user_prompt}```
Product catalog: ```{product_information}```
Agent response: ```{customer_agent_response}```
"""
Sind Systemnachricht und QA-Prompt definiert, testen wir den QA-Agenten mit der letzten Kundenservice-Antwort so:
# Initialize the QA-agent memory
qa_history = [{'role': 'system', 'content': qa_sysmessage}]

# Call the QA-agent with our templated query
qa_response = chatgpt_call(qa_prompt, qa_history)
print(qa_response)

# Output: Quality Check: Incorrect Response

Feedback: The customer asked for help in buying a Samsung TV but the agent did not address that request. The agent should have mentioned that they only have access to the product catalog of our store and can provide information and recommendations based on that catalog. The agent should have gently refused any other product outside the catalog.
Zur Bewertung der QA-Antwort zerlegen wir die Interaktion, die geprüft wird:
Can you help me buy a Samsung TV?“Absolutely! I'd be delighted to assist you in purchasing a Samsung TV. Could you please provide me with some specific requirements or preferences you have in mind? This way, I can recommend the best Samsung TV model that suits your needs.“Quality Check: Incorrect ResponseFeedback: The customer asked for help in buying a Samsung TV but the agent did not address that request. The agent should have mentioned that they only have access to the product catalog of our store and can provide information and recommendations based on that catalog. The agent should have gently refused any other product outside the catalog.“Der Quality-Agent erkennt ungeeignete Antworten des Kundenservice-Agenten!
Jetzt, wo beide Agenten unabhängig funktionieren, definieren wir ihre Interaktion.
Wir können beide Agenten und ihre Anforderungen in einem einfachen Schema darstellen:
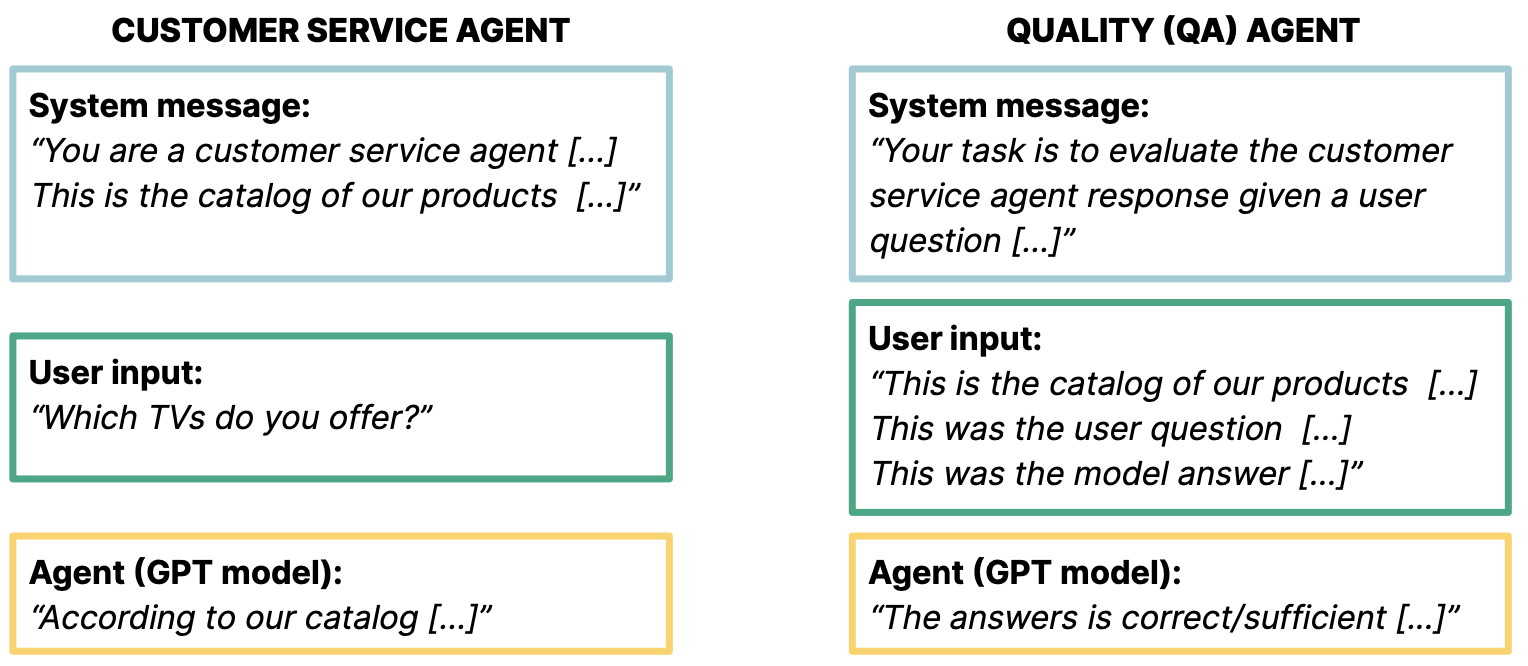
Eigenes Schaubild. Darstellung der drei Bausteine jedes Agenten: Systemnachricht (blau), Model-Input (grün) und Model-Output (gelb).
Wie geht es weiter? Jetzt implementieren wir die Interaktion der beiden Modelle!
Ein Vorschlag, um ungenaue Antworten zu filtern:
Zuerst lässt du den Kundenservice-Agenten eine Antwort auf die Nutzeranfrage generieren. Hält der QA-Agent die Antwort für ausreichend und katalogkonform, schicken wir sie direkt an die Nutzerin oder den Nutzer.
Andernfalls, wenn die Antwort die Anfrage nicht erfüllt oder falsche Kataloginfos enthält, bitten wir den Kundenservice-Agenten, die Antwort zu verbessern, bevor sie rausgeht.
Diesen Ablauf können wir im Schema wie folgt erweitern:
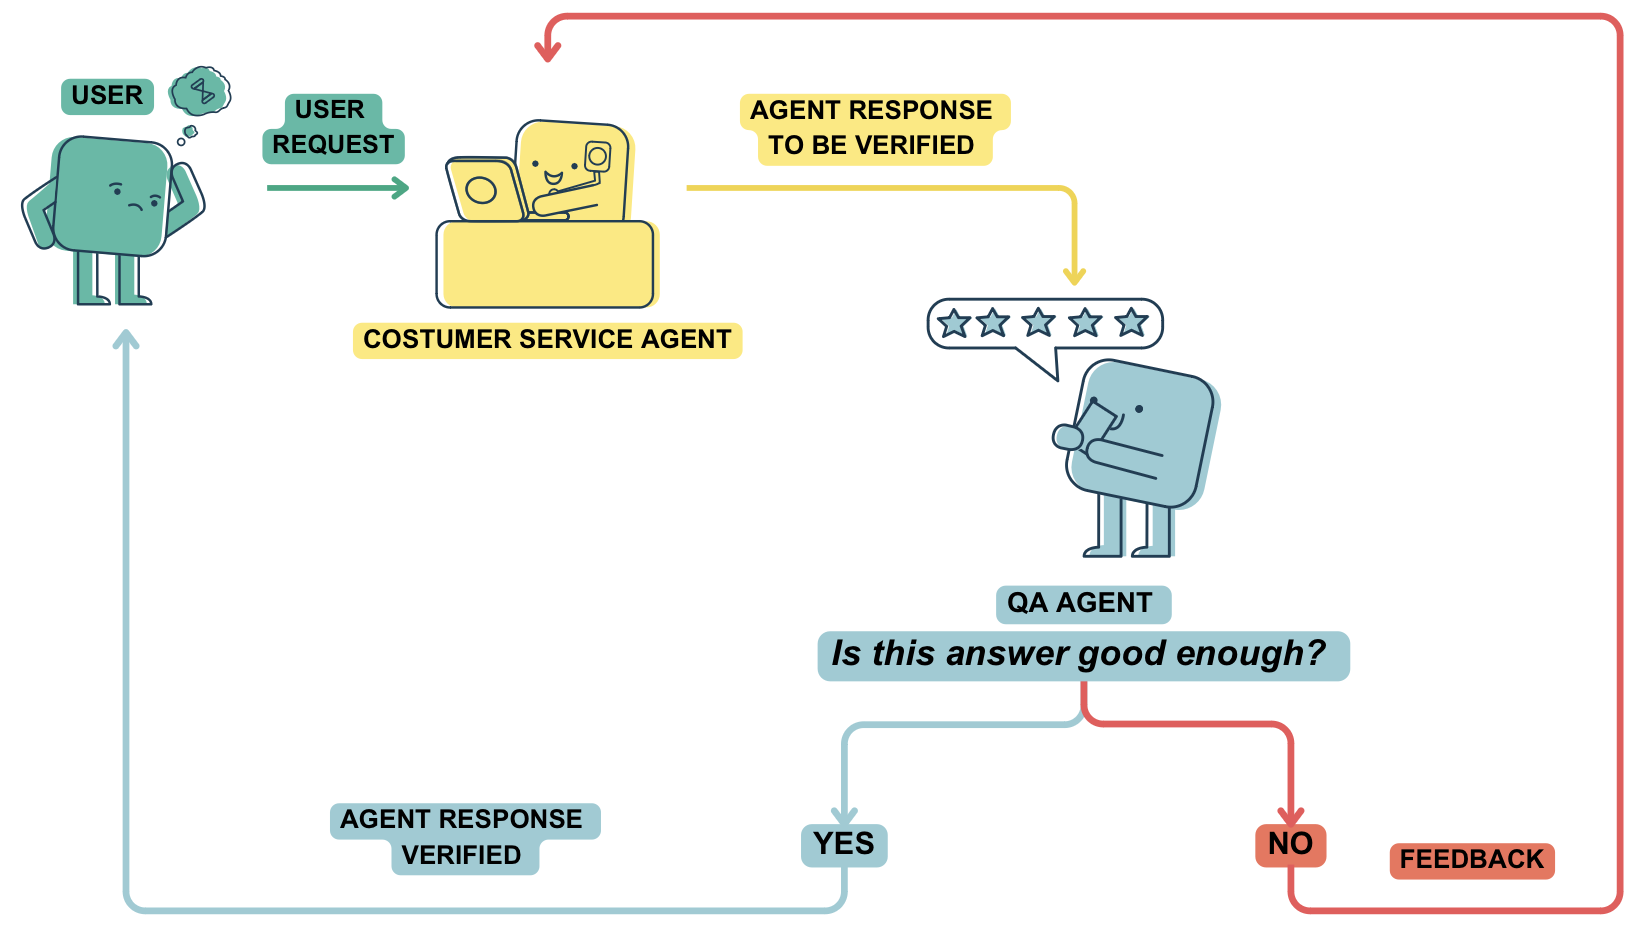
Eigenes Schaubild. Erweiterter Moderations-Workflow. Das Urteil des QA-Agenten kann als Feedback für die LLM-Anwendung genutzt werden.
Damit der QA-Agent als Filter dient, muss er in jeder Iteration ein konsistentes Ergebnis liefern.
Eine Möglichkeit: Wir passen die Systemnachricht des QA-Agenten leicht an und lassen ihn nur True ausgeben, wenn die Antwort genügt, sonst False:
qa_sysmessage = f"""
	You are a quality assistant that evaluates whether \
	a customer service agent answers to the customer \
	questions correctly. \

	You must also validate that the customer service agent \
	provides information only from the product catalog \
	of our store and gently refuses any other product outside the catalog. \

	The customer message, the customer service agent's response and \
	the product catalog will be delimited by \
	3 backticks, i.e. ```. \

	Respond with True or False no punctuation: \
	True - if the agent sufficiently answers the question \
	AND the response correctly uses product information \
	False - otherwise
	"""
Damit erhalten wir beim erneuten Prüfen der letzten Antwort des Kundenservice-Agenten einen booleschen Output:
# Let's reinitialize the memory
qa_history = [{'role': 'system', 'content': qa_sysmessage}]

qa_response = gpt_call(qa_prompt, qa_history)
print(qa_response)

# Output: False
Mit diesem booleschen Wert können wir weiterarbeiten: Antwort direkt senden, wenn der QA-Agent True ausgibt, oder dem Modell bei False eine zweite Chance geben, eine neue Antwort zu erzeugen.
Jetzt fügen wir alles zusammen!
Da wir beide Memories — mit ihren Systemnachrichten und Zusatzinfos — bereits initialisiert haben, lässt sich jede Kundenanfrage so verarbeiten:
user_prompt = "Can you help me buy a Samsung TV?"

customer_agent_response = gpt_call(user_prompt, customer_agent_history)

qa_response = gpt_call(qa_prompt, qa_history)

if qa_response == "False":
print("The chatbot response is not sufficient!")
else:
print("Sending response to user...")
print(customer_agent_response)
Wie beschrieben, filtern wir Antworten nach ihrer Korrektheit. Was mit ungeeigneten Antworten passieren soll, liegt bei dir. Wir haben vorgeschlagen, Feedback an den Kundenservice-Agenten zu geben und ihn neu antworten zu lassen — oder du bittest den QA-Agenten direkt um eine bessere Antwort. Viele Wege sind denkbar!
In diesem Artikel haben wir gezeigt, wie sich GPT-Modelle als Moderatoren für andere Instanzen desselben Typs einsetzen lassen. Die starken Fähigkeiten, die LLMs in unsere Anwendungen bringen, können zugleich helfen, Genauigkeit und Integrität der Interaktionen zu erhöhen.
Entgegen mancher Annahmen erhöht Moderation nicht zwingend die Komplexität einer Anwendung. Wie gesehen, reichen mitunter wenige, gut gesetzte Codezeilen, um die Funktionalität deutlich zu erweitern.
In einer KI-getriebenen Welt ist verantwortungsvolle LLM-Moderation ein Muss — nicht nur eine Option, sondern eine ethische Verpflichtung. Mit integrierter KI-Moderation stellen wir sicher, dass unsere Anwendungen nicht nur leistungsfähig, sondern auch verlässlich und ethisch sind. Gehen wir verantwortungsvoll voran, damit wir die Vorteile von KI nutzen und zugleich auf Genauigkeit achten.
Vielen Dank fürs Lesen! Wenn dich das Thema KI-Moderation interessiert, lies als Nächstes Promoting Responsible AI: Content Moderation in ChatGPT als ergänzendes Material!
Starte heute deine KI-Reise!
Lernpfad
Kurs
Kurs