

हम सभी ChatGPT की लोकप्रियता और लोग इसे अपनी उत्पादकता बढ़ाने के लिए कैसे उपयोग कर रहे हैं, के बारे में जानते हैं। लेकिन यदि आप नए हैं, तो डेमो के लिए मुफ्त साइन अप करना और इसकी क्षमताओं के साथ प्रयोग करना फायदेमंद होगा। आपको हमारा Introduction to ChatGPT कोर्स भी करना चाहिए ताकि प्रभावी प्रॉम्प्ट लिखने के सर्वोत्तम अभ्यास सीख सकें और इस शक्तिशाली AI टूल का लाभ उठाने के सामान्य व्यावसायिक उपयोग मामलों को समझ सकें।
इस ट्यूटोरियल में, हम सीखेंगे कि ChatGPT का उपयोग करके एंड-टू-एंड डेटा साइंस प्रोजेक्ट पर कैसे काम किया जा सकता है। हम विभिन्न प्रॉम्प्ट्स का उपयोग करके प्रोजेक्ट आउटलाइन बनाएंगे, Python कोड लिखेंगे, रिसर्च करेंगे, और एप्लिकेशन को डीबग करेंगे। साथ ही, हम प्रभावी ChatGPT प्रॉम्प्ट्स लिखने के टिप्स भी सीखेंगे। यदि आप विभिन्न उद्देश्यों के लिए AI के उपयोग में रुचि रखते हैं, तो सभी स्तरों के लिए हमारे आर्टिफिशियल इंटेलिजेंस प्रोजेक्ट्स गाइड को देखें।
एंड-टू-एंड डेटा साइंस प्रोजेक्ट के लिए ChatGPT का उपयोग
इस प्रोजेक्ट में, हम DataLab से Loan Data का उपयोग करेंगे और इसके इर्द-गिर्द डेटा साइंस प्रोजेक्ट की योजना बनाएंगे।
यहां 80 प्रतिशत काम ChatGPT करता है; हमें बस प्रॉम्प्ट इंजीनियरिंग में महारत हासिल करनी है ताकि सबकुछ सही हो, और इसके लिए हमारे पास शानदार ChatGPT चीट शीट फॉर डेटा साइंस है। इसमें SQL, R, और Python पर आधारित डेटा साइंस कार्यों के लिए 60+ ChatGPT प्रॉम्प्ट्स शामिल हैं।
प्रोजेक्ट प्लानिंग
यह प्रोजेक्ट का सबसे महत्वपूर्ण हिस्सा है, जहां हम उपलब्ध संसाधनों और लक्ष्यों को देखते हुए एक इष्टतम रणनीति बनाते हैं।
आप chat.openai.com पर जाकर एक नई चैट शुरू कर सकते हैं। इसके बाद, हम उपलब्ध लोन डेटासेट का उल्लेख करेंगे और ChatGPT से एक एंड-टू-एंड जेनेरिक पोर्टफोलियो प्रोजेक्ट बनाने के लिए चरण बताने के लिए कहेंगे।
प्रॉम्प्ट: “मेरे पास 9500 रो और 14 कॉलम वाला एक लोन डेटासेट है: ['credit.policy', 'purpose', 'int.rate', 'installment', 'log.annual.inc','dti', 'fico', 'days.with.cr.line', 'revol.bal', 'revol.util', 'inq.last.6mths', 'delinq.2yrs', 'pub.rec', 'not.fully.paid']। क्या आप वे चरण सूचीबद्ध कर सकते हैं जिन्हें मुझे अपने पोर्टफोलियो के लिए एंड-टू-एंड प्रोजेक्ट विकसित करने के लिए फॉलो करना चाहिए?”
हमें सूची मिल गई, लेकिन हम क्लास असंतुलन समस्या और प्रोजेक्ट लक्ष्य बताना भूल गए, जो है “loan not paid back” की सटीक भविष्यवाणी करना।
अपडेटेड प्रॉम्प्ट: “कृपया क्लास असंतुलन मुद्दों को शामिल करें और यह सटीक रूप से भविष्यवाणी करें कि लोन वापस नहीं चुकाया जाएगा, बजाय इसके कि लोन चुकाया गया है या नहीं।”
फिर से, हमें मॉडल मॉनिटरिंग में दिलचस्पी नहीं है, और हम Gradio ऐप बनाकर उसे Huggingface Spaces पर डिप्लॉय करना चाहते हैं।
अपडेटेड प्रॉम्प्ट: “हम Gradio का उपयोग करके एक वेब ऐप बनाएंगे और उसे Spaces पर डिप्लॉय करेंगे, और प्रोडक्शन में मॉडल मॉनिटर नहीं करेंगे।”
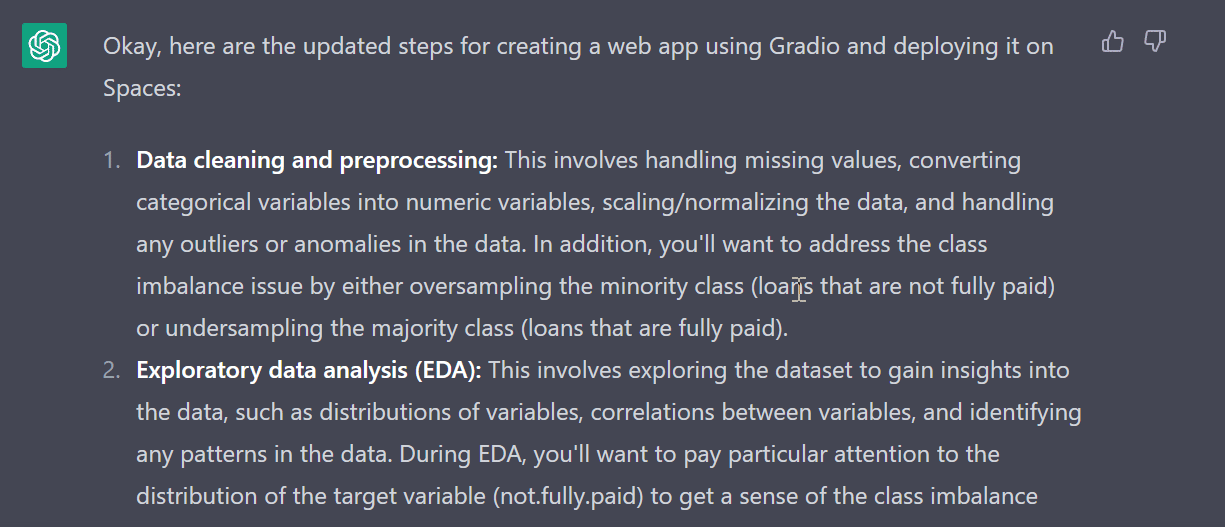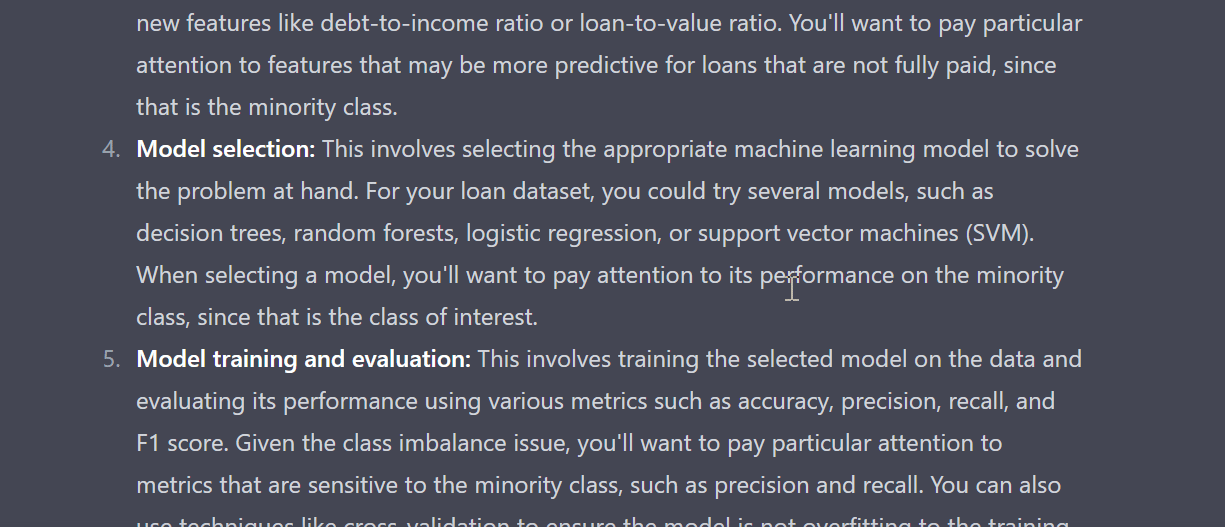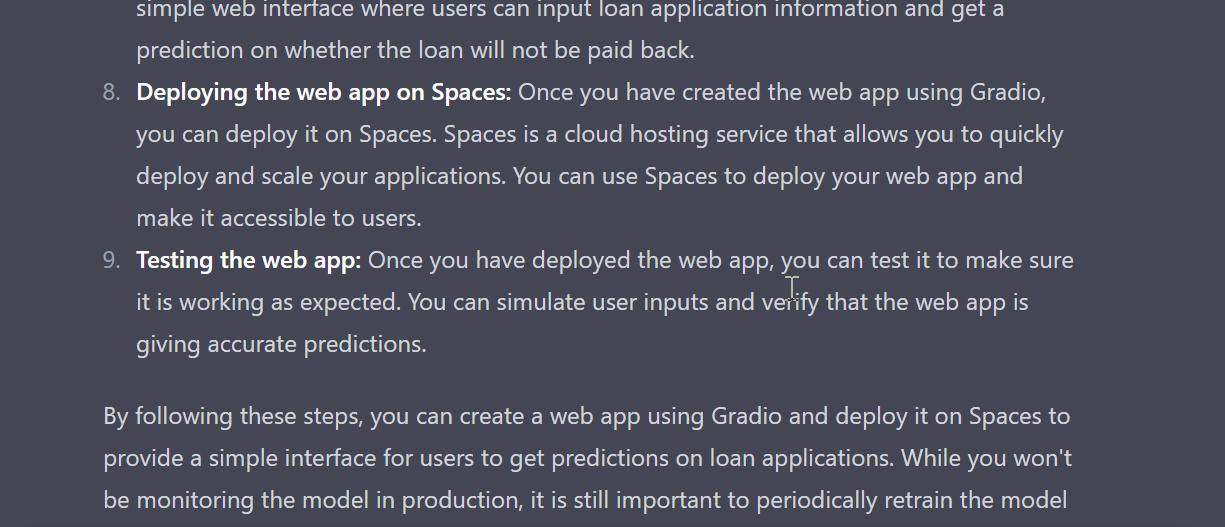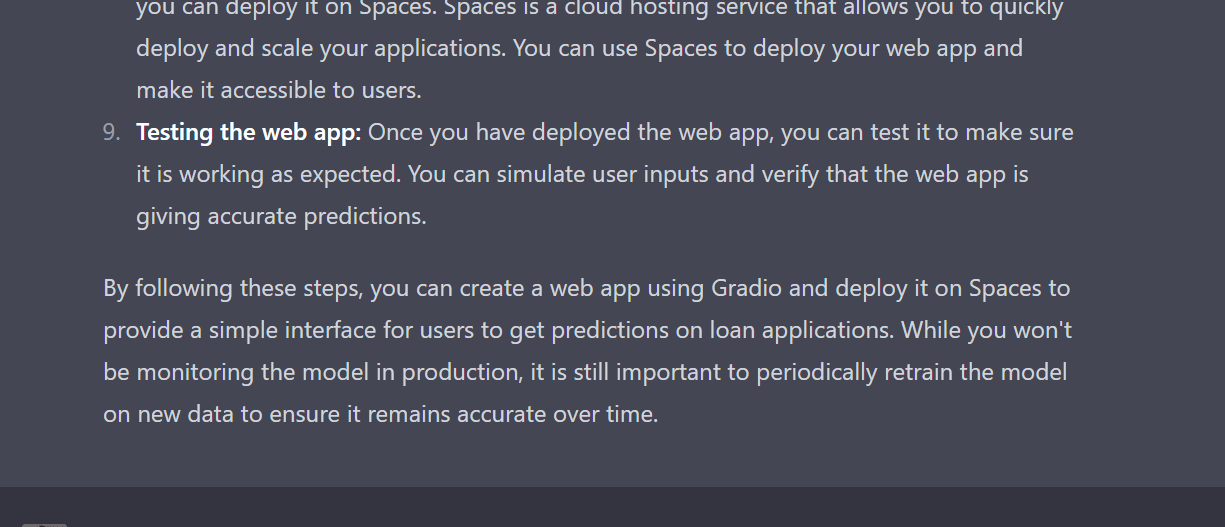
लेखक द्वारा Gif | प्रोजेक्ट में शामिल चरणों की अंतिम सूची
जैसा कि ऊपर दिखाया गया है, हमें 9 चरणों की सूची मिली और प्रत्येक चरण को कैसे अपनाना है, इस पर विस्तृत विवरण भी मिला।
यहां वे कार्य हैं जिन्हें हम इस ट्यूटोरियल में फॉलो करने जा रहे हैं:
- डेटा क्लीनिंग और प्रीप्रोसेसिंग। मिसिंग वैल्यूज़ को संभालना, श्रेणीबद्ध वेरिएबल्स को संख्यात्मक वेरिएबल्स में बदलना, डेटा को स्केल/नॉर्मलाइज़ करना, और आउटलायर या विसंगतियों को हैंडल करना। साथ ही, आपको क्लास असंतुलन मुद्दे को भी संबोधित करना होगा—या तो माइनॉरिटी क्लास (जो लोन पूरी तरह चुकाए नहीं गए) का ओवरसैंपलिंग करके या मेजॉरिटी क्लास (जो लोन पूरी तरह चुकाए गए) का अंडरसैंपलिंग करके।
- एक्सप्लोरेटरी डेटा एनालिसिस (EDA)। वेरिएबल्स के वितरण, वेरिएबल्स के बीच सह-संबंध (कोरिलेशन), और डेटा में किसी भी पैटर्न की पहचान जैसे इनसाइट्स पाने के लिए डेटासेट का अन्वेषण।
- फीचर इंजीनियरिंग। मॉडल की प्रेडिक्टिव क्षमता बढ़ाने के लिए नए फीचर्स बनाना या मौजूदा फीचर्स को ट्रांसफॉर्म करना।
- मॉडल चयन। निर्णय पेड़, रैंडम फॉरेस्ट, लॉजिस्टिक रिग्रेशन, या सपोर्ट वेक्टर मशीन (SVM) जैसे कई मॉडलों को आज़माना।
- मॉडल प्रशिक्षण और मूल्यांकन। चुने गए मॉडल को डेटा पर ट्रेन करना और एक्यूरेसी, प्रीसिशन, रिकॉल, और F1 स्कोर जैसे विभिन्न मेट्रिक्स का उपयोग करके उसका मूल्यांकन करना।
- हाइपरपैरामीटर ट्यूनिंग। चुने गए मॉडल के हाइपरपैरामीटर्स को फाइन-ट्यून करना ताकि उसका प्रदर्शन बेहतर हो सके।
- Gradio का उपयोग करके वेब ऐप बनाना। एक बार जब आपने सर्वश्रेष्ठ मॉडल चुन लिया, तो आप Gradio का उपयोग करके वेब ऐप बना सकते हैं।
- Spaces पर वेब ऐप को डिप्लॉय करना। Gradio से बना वेब ऐप Spaces पर डिप्लॉय करें।
- वेब ऐप का परीक्षण। सुनिश्चित करने के लिए परीक्षण करें कि यह अपेक्षा के अनुसार काम कर रहा है।
एक्सप्लोरेटरी डेटा एनालिसिस (EDA)
एक्सप्लोरेटरी डेटा एनालिसिस डेटा मैनिपुलेशन, सांख्यिकीय विश्लेषण और डेटा विज़ुअलाइज़ेशन से जुड़ा होता है। हम अपने डेटासेट पर EDA के लिए Python कोड लिखने के बारे में एक फॉलो-अप प्रॉम्प्ट लिखकर इसे पूरा कर सकते हैं।
फॉलो-अप प्रॉम्प्ट: “कृपया लोन डेटासेट को लोड करने और उस पर एक्सप्लोरेटरी डेटा एनालिसिस (EDA) करने के लिए Python कोड लिखें”
बॉट संदर्भ समझ लेगा और कमेंट्स सहित Python कोड और यह कैसे काम करता है इसकी विस्तृत व्याख्या देगा।
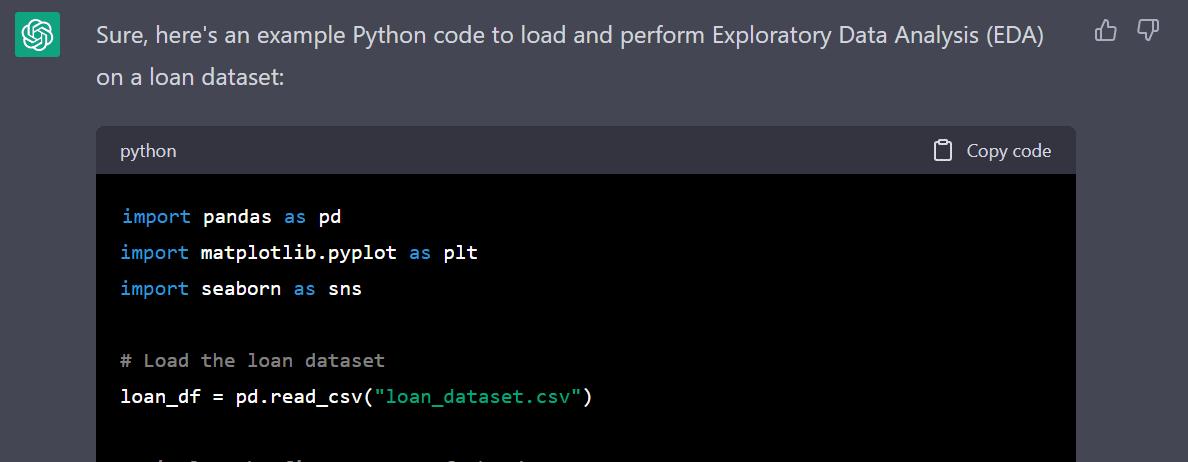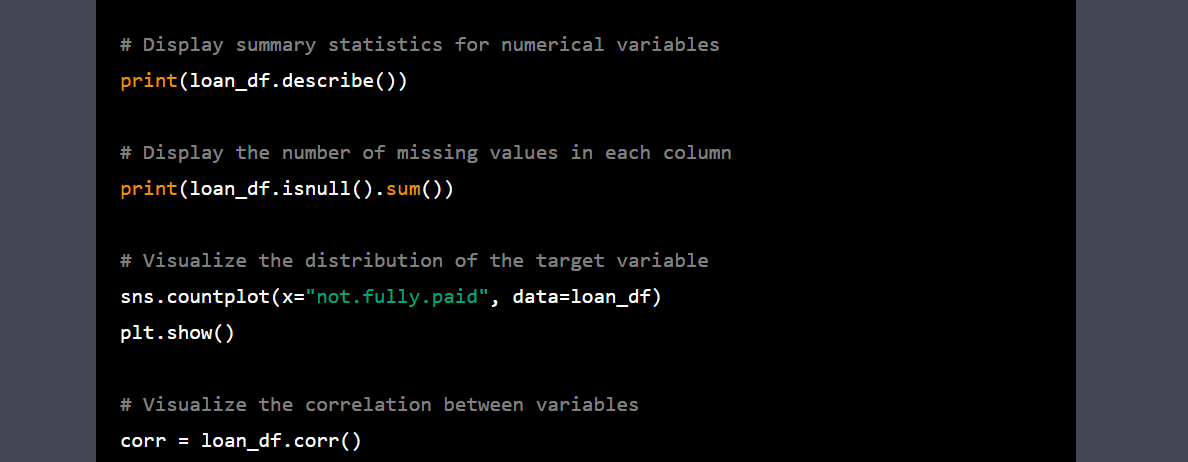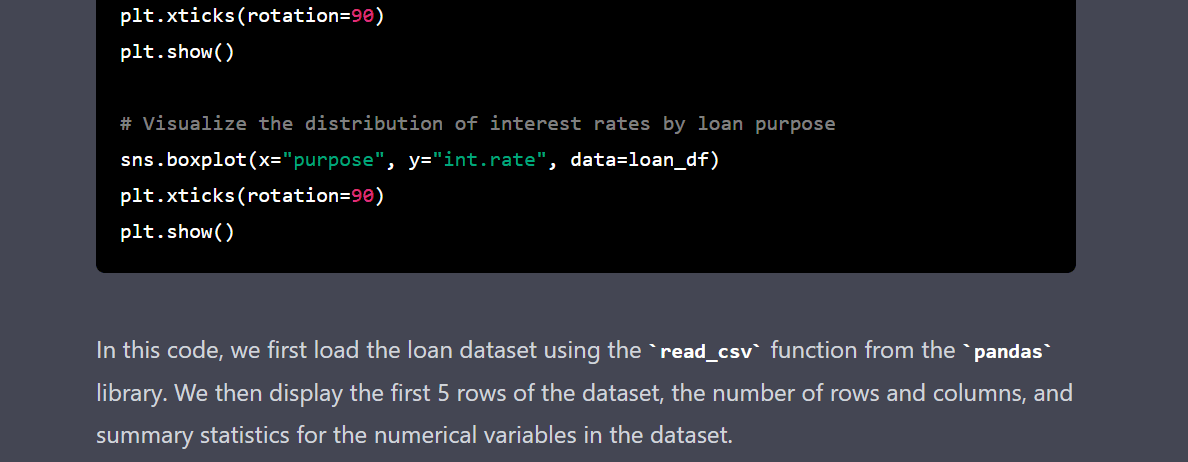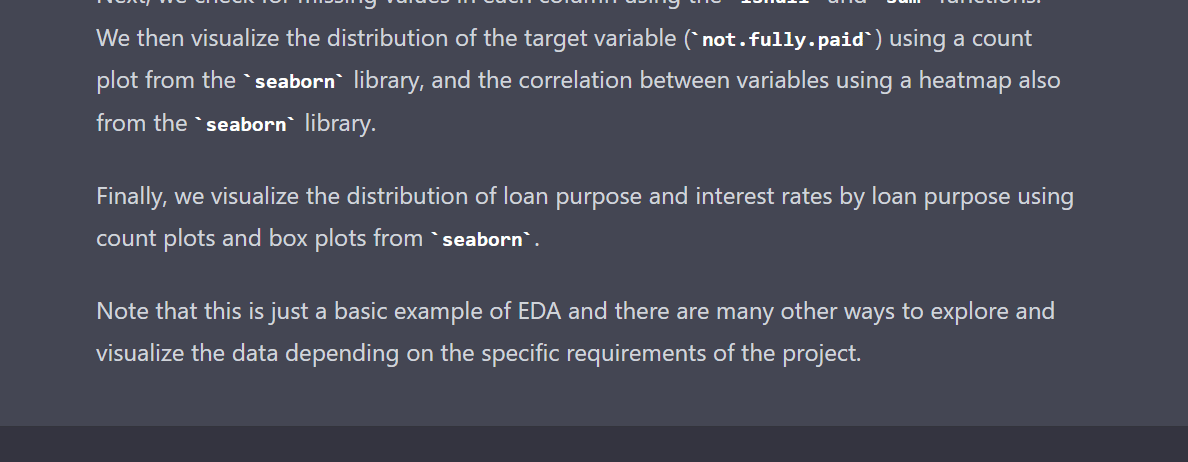
लेखक द्वारा Gif | EDA के लिए Python कोड
- Pandas डेटा फ़्रेम के रूप में डेटासेट को लोड करना और प्रदर्शित करना।
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
loan_df = pd.read_csv("loan_data.csv")
loan_df.head()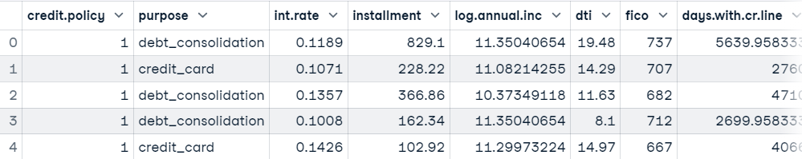
- रो और कॉलम की संख्या तथा संख्यात्मक वेरिएबल्स के लिए सांख्यिकीय सारांश प्रदर्शित करना।
# Display the number of rows and columns in the dataset
print("Number of rows and columns:", loan_df.shape)
# Display summary statistics for numerical variables
print(loan_df.describe())Number of rows and columns: (9578, 14)
credit.policy int.rate ... pub.rec not.fully.paid
count 9578.000000 9578.000000 ... 9578.000000 9578.000000
mean 0.804970 0.122640 ... 0.062122 0.160054
std 0.396245 0.026847 ... 0.262126 0.366676
min 0.000000 0.060000 ... 0.000000 0.000000
25% 1.000000 0.103900 ... 0.000000 0.000000
50% 1.000000 0.122100 ... 0.000000 0.000000
75% 1.000000 0.140700 ... 0.000000 0.000000
max 1.000000 0.216400 ... 5.000000 1.000000- प्रत्येक कॉलम में मिसिंग वैल्यूज़ दिखाना। जैसा कि हम देख सकते हैं, कोई नहीं है।
print(loan_df.isnull().sum())credit.policy 0
purpose 0
int.rate 0
installment 0
log.annual.inc 0
dti 0
fico 0
days.with.cr.line 0
revol.bal 0
revol.util 0
inq.last.6mths 0
delinq.2yrs 0
pub.rec 0
not.fully.paid 0- टारगेट वेरिएबल “not.fully.paid” के वितरण का विज़ुअलाइज़ेशन
sns.countplot(x="not.fully.paid", data=loan_df)
plt.show()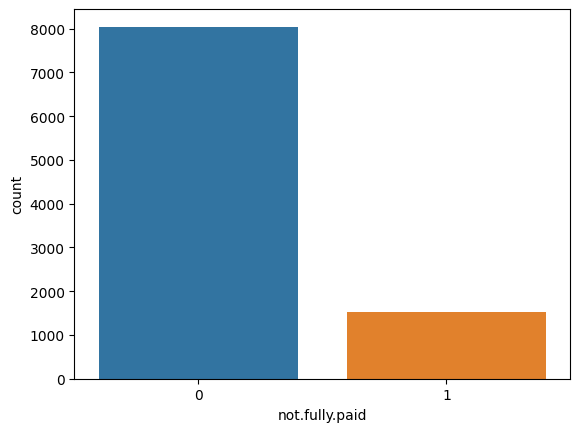
- वेरिएबल्स के बीच सह-संबंध का विज़ुअलाइज़ेशन।
corr = loan_df.corr()
sns.heatmap(corr, annot=True, cmap="coolwarm")
plt.show()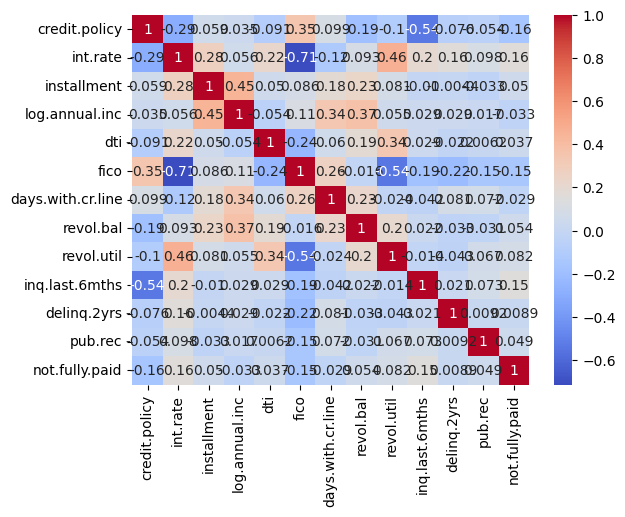
- लोन उद्देश्यों के वितरण को समझना।
sns.countplot(x="purpose", data=loan_df)
plt.xticks(rotation=90)
plt.show()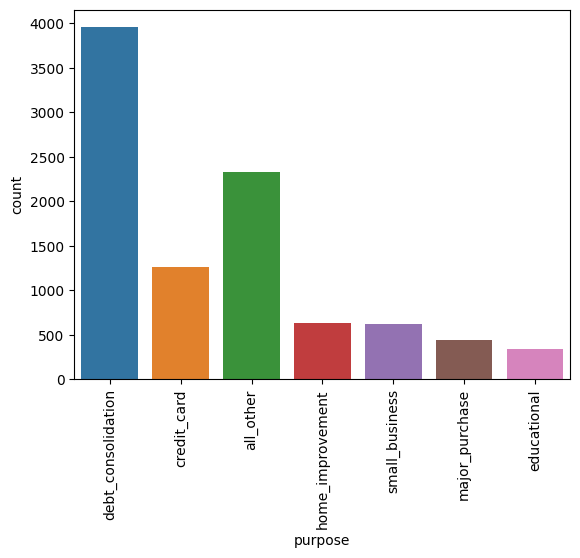
- लोन उद्देश्य के अनुसार ब्याज दरों के वितरण को समझना।
sns.boxplot(x="purpose", y="int.rate", data=loan_df)
plt.xticks(rotation=90)
plt.show()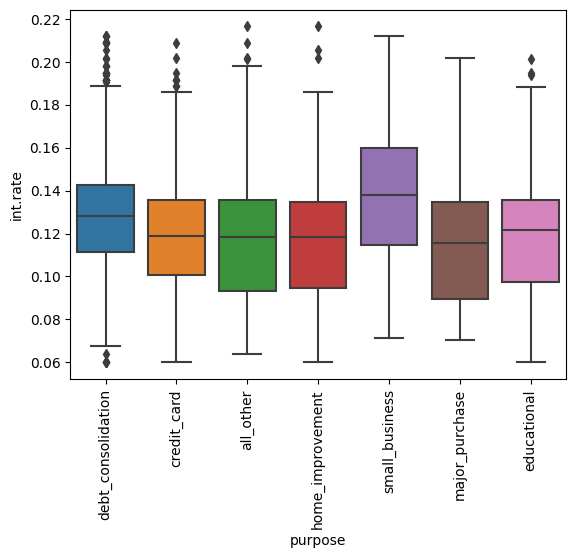
फीचर इंजीनियरिंग
प्रीप्रोसेसिंग और डेटा क्लीनिंग के बजाय, हम प्रीप्रोसेसिंग कार्य को सरल बनाने के लिए फीचर इंजीनियरिंग करेंगे।
फॉलो-अप प्रॉम्प्ट: “फीचर इंजीनियरिंग करने के लिए Python कोड लिखें”
हमें सही समाधान मिला, लेकिन उसमें अप्रासंगिक कोड शामिल था, इसलिए हमें कोड संशोधित कराने के लिए एक अपडेट प्रॉम्प्ट लिखना पड़ा।
अपडेटेड प्रॉम्प्ट: “सिर्फ फीचर इंजीनियरिंग वाला भाग जोड़ें।”
# Perform feature engineering
loan_df["installment_to_income_ratio"] = (
loan_df["installment"] / loan_df["log.annual.inc"]
)
loan_df["credit_history"] = (loan_df["delinq.2yrs"] + loan_df["pub.rec"]) / loan_df[
"fico"
]ChatGPT ने दो नए फीचर्स सुझाए हैं: “installment_to_income_ratio” और “credit_history”。
डेटा का प्रीप्रोसेसिंग और बैलेंसिंग
फिर से, ChatGPT को प्रोजेक्ट का संदर्भ पता है। हमें सबकुछ दोबारा समझाने की ज़रूरत नहीं। तो, हम बस इससे डेटा को क्लीन और प्रीप्रोसेस करने के लिए Python कोड लिखने को कहेंगे।
फॉलो-अप प्रॉम्प्ट: “अब डेटासेट को क्लीन और प्रीप्रोसेस करने के लिए Python कोड लिखें”
- अनावश्यक कॉलम हटाना और श्रेणीबद्ध वेरिएबल्स को संख्यात्मक में बदलना।
from sklearn.preprocessing import LabelEncoder, StandardScaler
loan_df = loan_df.drop(['credit.policy', 'days.with.cr.line', 'purpose'], axis=1)
# Convert categorical variables to numerical using LabelEncoder
le = LabelEncoder()
loan_df['not.fully.paid'] = le.fit_transform(loan_df['not.fully.paid'])- Standard Scaler का उपयोग करके संख्यात्मक फीचर्स को स्केल करना।
scaler = StandardScaler()
numerical_cols = ['int.rate', 'installment', 'log.annual.inc', 'dti', 'fico', 'revol.bal', 'revol.util', 'inq.last.6mths', 'delinq.2yrs', 'pub.rec','credit_history','installment_to_income_ratio']
loan_df[numerical_cols] = scaler.fit_transform(loan_df[numerical_cols])- imblearn की ओवरसैंपलिंग विधि का उपयोग करके क्लास असंतुलन को संभालना।
from imblearn.over_sampling import SMOTE
sm = SMOTE(random_state=42)
X = loan_df.drop('not.fully.paid', axis=1)
y = loan_df['not.fully.paid']
X_resampled, y_resampled = sm.fit_resample(X, y)
loan_df = pd.concat([X_resampled, y_resampled], axis=1)
loan_df['not.fully.paid'].value_counts()जैसा कि हम देख सकते हैं, हमने सफलतापूर्वक क्लास को बैलेंस कर लिया है।
0 8045
1 8045
Name: not.fully.paid, dtype: int64मॉडल चयन
इस हिस्से में, हमने मॉडल चयन कार्य के लिए ChatGPT से विभिन्न मॉडलों पर डेटा ट्रेन करने के लिए कहा।
फॉलो-अप प्रॉम्प्ट: “मॉडल चयन के लिए फॉलो-अप Python कोड लिखें। निर्णय पेड़, रैंडम फॉरेस्ट, लॉजिस्टिक रिग्रेशन, या सपोर्ट वेक्टर मशीन (SVM) आज़माएं। नोट: केवल मॉडल चयन भाग शामिल करें।”
इसने डेटासेट को ट्रेनिंग और टेस्ट में विभाजित करने और निर्दिष्ट मॉडलों पर ट्रेन करके एक्यूरेसी मेट्रिक्स दिखाने के लिए Python स्क्रिप्ट जेनरेट की।
from sklearn.model_selection import train_test_split
# Split the dataset into training and testing sets
X = loan_df.drop('not.fully.paid', axis=1)
y = loan_df['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Fit and evaluate decision tree classifier
dt = DecisionTreeClassifier(random_state=42)
dt.fit(X_train, y_train)
dt_score = dt.score(X_test, y_test)
print("Decision Tree Classifier Accuracy: {:.2f}%".format(dt_score*100))
# Fit and evaluate random forest classifier
rf = RandomForestClassifier(random_state=42)
rf.fit(X_train, y_train)
rf_score = rf.score(X_test, y_test)
print("Random Forest Classifier Accuracy: {:.2f}%".format(rf_score*100))
# Fit and evaluate logistic regression classifier
lr = LogisticRegression(random_state=42)
lr.fit(X_train, y_train)
lr_score = lr.score(X_test, y_test)
print("Logistic Regression Classifier Accuracy: {:.2f}%".format(lr_score*100))
# Fit and evaluate support vector machine classifier
svm = SVC(random_state=42)
svm.fit(X_train, y_train)
svm_score = svm.score(X_test, y_test)
print("Support Vector Machine Classifier Accuracy: {:.2f}%".format(svm_score*100))रैंडम फॉरेस्ट एल्गोरिथ्म ने अन्य मॉडलों की तुलना में उल्लेखनीय रूप से बेहतर प्रदर्शन किया।
Decision Tree Classifier Accuracy: 81.21%
Random Forest Classifier Accuracy: 89.14%
Logistic Regression Classifier Accuracy: 61.32%
Support Vector Machine Classifier Accuracy: 66.54%हाइपरपैरामीटर ट्यूनिंग और मॉडल मूल्यांकन
हम बेहतर प्रदर्शन करने वाले मॉडल का चयन करेंगे और मॉडल मूल्यांकन करेंगे। हमने एक्यूरेसी, प्रीसिशन, रिकॉल, और F1 स्कोर को मेट्रिक्स के रूप में तथा क्रॉस-वैलिडेशन को मॉडल की स्थिरता सुनिश्चित करने के लिए निर्दिष्ट किया है।
फॉलो-अप प्रॉम्प्ट: “RandomForestClassifier चुनें और मॉडल मूल्यांकन के लिए Python कोड लिखें। एक्यूरेसी, प्रीसिशन, रिकॉल, और F1 स्कोर को मेट्रिक के रूप में उपयोग करें और यह सुनिश्चित करने के लिए क्रॉस-वैलिडेशन करें कि मॉडल ट्रेनिंग डेटा पर ओवरफिट नहीं हो रहा है।”
हम हाइपरपैरामीटर ट्यूनिंग कार्य जोड़ने और सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल को सेव करने के लिए Python को अपडेट करेंगे।
अपडेटेड प्रॉम्प्ट: “उपरोक्त कोड में हाइपरपैरामीटर ट्यूनिंग भी शामिल करें और सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडल को सेव करें”
कोड के अंतिम संस्करण में हाइपरपैरामीटर ट्यूनिंग के लिए GridSearchCV का उपयोग किया गया है, जिसमें पाँच क्रॉस-वैलिडेशन स्प्लिट हैं और सर्वश्रेष्ठ हाइपरपैरामीटर्स खोजने के लिए f1 मेट्रिक का उपयोग किया गया है।
इसके बाद, ChatGPT ने स्वतः ही टेस्टिंग सेट पर मॉडल मूल्यांकन के लिए सर्वश्रेष्ठ मॉडल चुनने और सर्वश्रेष्ठ हाइपरपैरामीटर्स प्रदर्शित करने का कोड जोड़ दिया।
from sklearn.model_selection import GridSearchCV
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
# Define the parameter grid for hyperparameter tuning
param_grid = {
'n_estimators': [100, 200, 300],
'max_depth': [10, 20, 30, None],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 2, 4]
}
# Perform grid search with cross-validation to find the best hyperparameters
grid_search = GridSearchCV(rf, param_grid, cv=5, scoring='f1')
grid_search.fit(X_train, y_train)
# Get the best model and its hyperparameters
best_model = grid_search.best_estimator_
best_params = grid_search.best_params_
# Evaluate the best model on the testing set
y_pred = best_model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
precision = precision_score(y_test, y_pred)
recall = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
# Print the results
print("Random Forest Classifier Evaluation Results:")
print("Accuracy: {:.2f}%".format(accuracy * 100))
print("Precision: {:.2f}%".format(precision * 100))
print("Recall: {:.2f}%".format(recall * 100))
print("F1 Score: {:.2f}%".format(f1 * 100))
print("Best hyperparameters:", best_params)हमारे पास 89.35 की एक्यूरेसी स्कोर के साथ एक स्थिर मॉडल है। प्रीसिशन और रिकॉल दोनों समान हैं।
Random Forest Classifier Evaluation Results:
Accuracy: 89.35%
Precision: 89.92%
Recall: 88.33%
F1 Score: 89.12%
Best hyperparameters: {'max_depth': None, 'min_samples_leaf': 1, 'min_samples_split': 2, 'n_estimators': 300}अंत में, हम joblib का उपयोग करके मॉडल को सेव करेंगे।
import joblib
# Save the best model to disk
joblib.dump(best_model, 'loan_classifier.joblib')आप आउटपुट्स के साथ सोर्स कोड इस DataLab वर्कबुक में पा सकते हैं; आप आसानी से इसकी अपनी कॉपी बनाकर ब्राउज़र में कोड एडिट और रन कर सकते हैं—वह भी बिना अपने कंप्यूटर पर कुछ इंस्टॉल किए।
Gradio का उपयोग करके वेब ऐप बनाना
अब आता है सबसे मजेदार हिस्सा। हम केवल प्रॉम्प्ट्स का उपयोग करके एक पूरी तरह कस्टमाइज़ेबल वेब ऐप बनाएंगे, जो संख्यात्मक इनपुट लेगा और मशीन लर्निंग मॉडल के जरिए परिणाम दिखाएगा।
ChatGPT को पहले से संदर्भ पता है, इसलिए हमें बस उससे लोन डेटा क्लासिफायर के लिए Gradio वेब ऐप लिखने के लिए कहना है।
फॉलो-अप प्रॉम्प्ट: “लोन डेटा क्लासिफायर्स के लिए Gradio वेब ऐप बनाने का Python कोड लिखें। हम ['credit.policy', 'days.with.cr.line', 'purpose'] कॉलम का उपयोग नहीं कर रहे हैं।”
ChatGPT से कहें कि ट्रेनिंग और फिर इंफरेंस स्क्रिप्ट की बजाय केवल Gradio ऐप वाला भाग शामिल करे।
अपडेटेड प्रॉम्प्ट: “सिर्फ gradio ऐप वाला भाग शामिल करें।”
जो कोड मिला वह प्रेडिक्टिव क्लास प्रॉबेबिलिटी दिखाता है, जबकि हम क्लासिफिकेशन लेबल्स दिखाना चाहते हैं।
अपडेटेड प्रॉम्प्ट: “कोड को इस तरह संशोधित करें कि क्लास प्रॉबेबिलिटी के बजाय क्लासिफिकेशन दिखे।”
कोड चलाने के बाद, हमें कई चेतावनियां और त्रुटियां दिखीं। आप त्रुटियों का उल्लेख करके इसे ChatGPT से बेहतर करवा सकते हैं।
हमें ChatGPT की सीमाएं समझनी होंगी। इसे पुराने डेटा पर प्रशिक्षित किया गया था, और यदि आप उम्मीद करते हैं कि यह कोड को नवीनतम API के साथ अपडेट कर देगा, तो आप अटक जाएंगे। इसके बजाय, हमें Gradio की डॉक्यूमेंटेशन पढ़कर कोड को मैन्युअली अपडेट करना चाहिए।
असफल प्रॉम्प्ट: “gradio.components से कंपोनेंट का उपयोग करके Gradio कोड अपडेट करें”
Gradio ऐप में, हम सेव किए गए मॉडल को लोड कर रहे हैं और उपयोगकर्ताओं से इनपुट लेकर मॉडल प्रेडिक्शंस दिखा रहे हैं।
Gradio कैसे काम करता है, यह Gradio Docs पढ़कर जानें।
import gradio as gr
import joblib
# Load the trained model
model = joblib.load("loan_classifier.joblib")
def predict_loan_status(
int_rate,
installment,
log_annual_inc,
dti,
fico,
revol_bal,
revol_util,
inq_last_6mths,
delinq_2yrs,
pub_rec,
installment_to_income_ratio,
credit_history,
):
input_dict = {
"int.rate": int_rate,
"installment": installment,
"log.annual.inc": log_annual_inc,
"dti": dti,
"fico": fico,
"revol.bal": revol_bal,
"revol.util": revol_util,
"inq.last.6mths": inq_last_6mths,
"delinq.2yrs": delinq_2yrs,
"pub.rec": pub_rec,
"installment_to_income_ratio": installment_to_income_ratio,
"credit_history": credit_history,
}
# Convert the dictionary to a 2D array
input_array = [list(input_dict.values())]
prediction = model.predict(input_array)[0]
if prediction == 0:
return "Loan fully paid"
else:
return "Loan not fully paid"
inputs = [
gr.Slider(0.06, 0.23, step=0.01, label="Interest Rate"),
gr.Slider(100, 950, step=10, label="Installment"),
gr.Slider(7, 15, step=0.1, label="Log Annual Income"),
gr.Slider(0, 40, step=1, label="DTI Ratio"),
gr.Slider(600, 850, step=1, label="FICO Score"),
gr.Slider(0, 120000, step=1000, label="Revolving Balance"),
gr.Slider(0, 120, step=1, label="Revolving Utilization"),
gr.Slider(0, 10, step=1, label="Inquiries in Last 6 Months"),
gr.Slider(0, 20, step=1, label="Delinquencies in Last 2 Years"),
gr.Slider(0, 10, step=1, label="Public Records"),
gr.Slider(0, 5, step=0.1, label="Installment to Income Ratio"),
gr.Slider(0, 1, step=0.01, label="Credit History"),
]
outputs = [gr.Label(num_top_classes=2)]
title = "Loan Approval Classifier"
description = (
"Enter the details of the loan applicant to check if the loan is approved or not."
)
gr.Interface(
fn=predict_loan_status,
inputs=inputs,
outputs=outputs,
title=title,
description=description,
).launch()आप ऊपर का कोड `app.py` फ़ाइल में सेव कर सकते हैं और टर्मिनल में `python app.py` स्क्रिप्ट चलाकर ब्राउज़र में ऐप लॉन्च कर सकते हैं।

लेखक द्वारा Gif | लोन अप्रूवल क्लासिफायर ऐप
हालांकि हमारा ऐप ठीक काम कर रहा है, ChatGPT यह पूरी तरह चूक गया कि हमने संख्यात्मक फीचर्स को स्केल किया है। इसलिए, कोड अपडेट कराने के बजाय, आप वापस जाकर स्टैंडर्ड स्केलर पैरामीटर्स सेव कर सकते हैं।
scalar = joblib.load('std_scaler.bin')उसके बाद, joblib का उपयोग करके अपने ऐप में स्केलर लोड करें।
input_array = [list(input_dict.values())]
scaled_array = scalar.transform(input_array)
prediction = model.predict(scaled_array)[0]तो, हम इसे मैन्युअली क्यों कर रहे हैं? यदि आप ChatGPT से एक ही लाइन संशोधित करने को कहते हैं, तो यह पूरे कोड और यहां तक कि वेरिएबल नाम भी बदल सकता है।
हाँ, ChatGPT परफेक्ट नहीं है, और यह कभी भी डेवलपर की जगह नहीं लेगा।
Spaces पर वेब ऐप डिप्लॉय करना
आप ChatGPT से बस Hugging Face Spaces पर Gradio ऐप को डिप्लॉय करने का सरल तरीका सिखाने के लिए कह सकते हैं, और यह आवश्यक चरण सूचीबद्ध कर देगा।
प्रॉम्प्ट: “gradio ऐप को huggingface spaces पर कैसे डिप्लॉय करें।”
- Hugging Face वेबसाइट पर जाएं और ऊपर बाईं ओर अपनी प्रोफ़ाइल तस्वीर पर क्लिक करके “New Space” विकल्प चुनें।
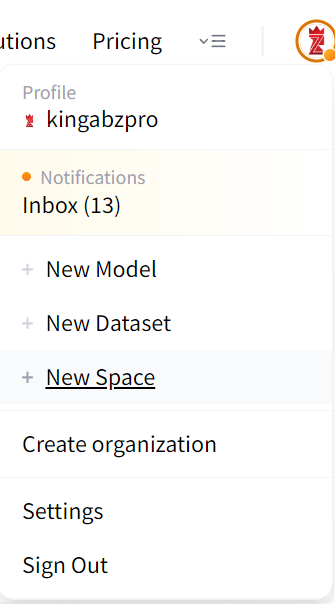
छवि: लेखक द्वारा
- ऐप रिपॉज़िटरी बनाने के लिए नाम और लाइसेंस प्रकार जोड़ें।
- Files and Versions टैब > + Add file > Upload files पर क्लिक करके रिपॉज़िटरी में फाइलें जोड़ें।
- app.py, मॉडल और स्केलर फाइलों को ड्रैग करें और “Commit change to main” बटन पर क्लिक करें तथा Git की तरह एक कमिट संदेश के साथ कमिट सेव करें।
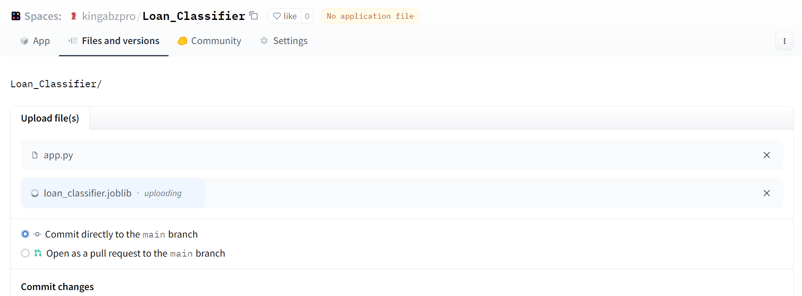
छवि: लेखक द्वारा
यदि आपको रनटाइम एरर आ रहा है, तो इसका कारण यह है कि आप requirements.txt फाइल जोड़ना भूल गए। Files and Versions टैब > + Add file > Create a new file चुनें और नीचे दिखाए अनुसार फाइल नाम तथा Python लाइब्रेरीज़ के वर्ज़न जोड़ें।
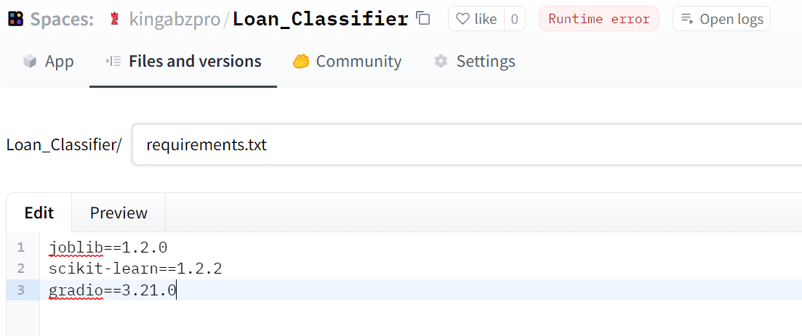
छवि: लेखक द्वारा
आपका ऐप तैयार है। आप स्लाइडर्स का उपयोग करके इनपुट बदल सकते हैं और यह प्रेडिक्ट कर सकते हैं कि ग्राहक को लोन मिलना चाहिए या नहीं।
आप kingabzpro द्वारा Hugging Face Space पर लाइव डेमो आज़मा सकते हैं।
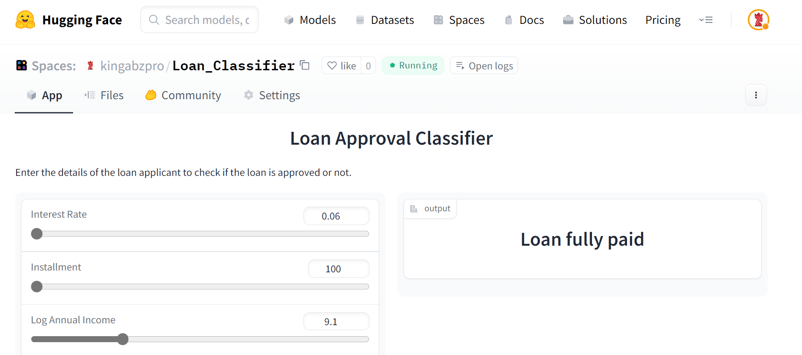
छवि: लेखक द्वारा | Loan Classifier
प्रभावी ChatGPT प्रॉम्प्ट्स लिखने के टिप्स
वास्तविक जीवन के प्रोजेक्ट्स में इसका उपयोग करने के मामले में प्रॉम्प्ट इंजीनियरिंग पेचीदा हो सकती है। हमें यह समझना होगा कि हम क्या कर सकते हैं और कहाँ हमें ChatGPT को ठीक करने के लिए हस्तक्षेप करना होगा।
यहां कुछ टिप्स हैं जिनसे आप प्रोजेक्ट से समझौता किए बिना ChatGPT के साथ अपना अनुभव बेहतर कर सकते हैं।
- हमेशा स्पष्ट और संक्षिप्त प्रॉम्प्ट्स लिखें। सुनिश्चित करें कि शुरुआत में ही आप अपनी ज़रूरतों का विस्तार से वर्णन कर दें।
- प्रोजेक्ट का इतिहास बनाएं। ChatGPT एक चैटबॉट है, इसलिए संदर्भ को प्रभावी ढंग से समझने के लिए आपको इतिहास स्थापित करना होगा।
- लगातार प्रयास करें। प्रॉम्प्ट लिखने का कोई मानक तरीका नहीं है। आपको बेस प्रॉम्प्ट से शुरू करना है और फॉलो-अप अपडेट प्रॉम्प्ट्स लिखकर उन्हें बेहतर बनाते रहना है।
- कोड एरर्स का उल्लेख करें। यदि आप अपने लोकल मशीन पर कोड चलाते हैं और एरर आता है, तो फॉलो-अप प्रॉम्प्ट में उस एरर का उल्लेख करें। ChatGPT तुरंत गलती से सीखेगा और बेहतर समाधान लेकर आएगा।
- मैन्युअल परिवर्तन करें। ChatGPT पुराने डेटा पर प्रशिक्षित है, और यदि आप उम्मीद करते हैं कि यह नया API कमांड या विचार लेकर आएगा, तो आप निराश होंगे। जहां संभव हो, अपने कोड में मैन्युअल बदलाव करने की कोशिश करें क्योंकि जेनरेट किया गया कोड परफेक्ट नहीं होता।
- सामान्य कार्यों के लिए इसका उपयोग करें। जब आप सामान्य कार्य पूछते हैं, तो ChatGPT के साथ सफलता की संभावना अधिक होती है।
- कुछ नया सीखने के लिए इसका उपयोग करें। हमेशा ChatGPT से नई चीज़ें समझाने या “कैसे करें” ट्यूटोरियल्स के लिए कहें। यह सरल चरणों की सूची देगा जिससे काम हो जाएगा। यदि आपको सीखने में कठिनाई होती है, तो यह काफी मददगार है।
यदि आप ChatGPT और OpenAI API में रुचि रखते हैं, तो वेबिनार के लिए रजिस्टर करें: Getting Started with the OpenAI API and ChatGPT। आप OpenAI API का उपयोग करके भाषा और कोड जेनरेशन कार्यों को करना और बहुत कुछ सीखेंगे।
निष्कर्ष
लोन अप्रूवल क्लासिफायर विकसित करना डेटा साइंस प्रोजेक्ट्स के लिए ChatGPT के उपयोग के कई उदाहरणों में से एक है। हम इसका उपयोग सिंथेटिक डेटा जनरेट करने, SQL क्वेरी चलाने, डेटा एनालिटिक्स रिपोर्ट बनाने, मशीन लर्निंग रिसर्च करने और बहुत कुछ के लिए कर सकते हैं। जेनरेटिव AI यहां रहने के लिए है, और यह हमारी ज़िंदगी आसान बनाएगा। हफ्तों और महीनों तक किसी प्रोजेक्ट पर समय बिताने के बजाय, आप घंटों में डेटा साइंस एप्लिकेशन डेवलप, टेस्ट और डिप्लॉय कर सकते हैं।
इस ट्यूटोरियल में, हमने ChatGPT का उपयोग प्रोजेक्ट प्लानिंग, डेटा विश्लेषण, डेटा क्लीनिंग और प्रीप्रोसेसिंग, मॉडल चयन, हाइपरपैरामीटर ऑप्टिमाइज़ेशन, तथा वेब एप्लिकेशन बनाने और डिप्लॉय करने में करना सीखा।
ChatGPT का उपयोग करने में एक पेंच है। प्रोजेक्ट के विभिन्न कार्यों को समझने के लिए आपको सांख्यिकीय विश्लेषण और Python कोडिंग का अनुभव होना चाहिए; इसके बिना, आप अंधेरे में चल रहे हैं। अपनी डेटा साइंस यात्रा शुरू करें Data Scientist with Python करियर ट्रैक लेकर और वह करियर-बिल्डिंग स्किल्स हासिल करें जो एक डेटा साइंटिस्ट के रूप में सफलता के लिए आवश्यक हैं।