
ओपन-सोर्स LLMs का उपयोग करने के फायदे
प्रोप्रायटरी LLMs की तुलना में ओपन-सोर्स LLMs चुनने के कई अल्पकालिक और दीर्घकालिक लाभ हैं। नीचे, आप सबसे ठोस कारणों की सूची पा सकते हैं:
बेहतर डेटा सुरक्षा और गोपनीयता
प्रोप्रायटरी LLMs का उपयोग करने की सबसे बड़ी चिंताओं में से एक है LLM प्रदाता द्वारा डेटा लीक या संवेदनशील डेटा तक अनधिकृत पहुंच का जोखिम। वास्तव में, प्रशिक्षण उद्देश्यों के लिए व्यक्तिगत और गोपनीय डेटा के कथित उपयोग को लेकर पहले ही कई विवाद हो चुके हैं।
ओपन-सोर्स LLM का उपयोग करके, कंपनियाँ व्यक्तिगत डेटा की सुरक्षा के लिए पूरी तरह जिम्मेदार होंगी, क्योंकि उसका संपूर्ण नियंत्रण उनके पास रहेगा।
लागत बचत और विक्रेता पर निर्भरता में कमी
अधिकांश प्रोप्रायटरी LLMs के उपयोग के लिए लाइसेंस की आवश्यकता होती है। लंबे समय में, यह एक महत्वपूर्ण खर्च बन सकता है जिसे कुछ कंपनियाँ, विशेषकर SMEs, वहन नहीं कर पातीं। ओपन-सोर्स LLMs के साथ ऐसा नहीं है, क्योंकि वे सामान्यतः नि:शुल्क उपयोग के लिए उपलब्ध होते हैं।
हालाँकि, ध्यान रखना महत्वपूर्ण है कि LLMs चलाने के लिए काफी संसाधनों की आवश्यकता होती है, केवल इन्फ़रेंस के लिए भी, जिसका मतलब है कि आमतौर पर आपको क्लाउड सेवाओं या शक्तिशाली इन्फ्रास्ट्रक्चर के उपयोग के लिए भुगतान करना होगा।
कोड पारदर्शिता और भाषा मॉडल का अनुकूलन
जो कंपनियाँ ओपन-सोर्स LLMs चुनती हैं उन्हें LLMs के कामकाज तक पहुँच मिलती है, जिसमें उनका सोर्स कोड, आर्किटेक्चर, प्रशिक्षण डेटा, और प्रशिक्षण व इन्फ़रेंस के मैकेनिज्म शामिल हैं। यह पारदर्शिता जांच-पड़ताल के साथ-साथ अनुकूलन की पहली सीढ़ी है।
क्योंकि ओपन-सोर्स LLMs सभी के लिए सुलभ हैं, उनके सोर्स कोड सहित, उन्हें उपयोग करने वाली कंपनियाँ उन्हें अपने विशिष्ट उपयोग मामलों के लिए कस्टमाइज़ कर सकती हैं।
सक्रिय समुदाय सहयोग और नवाचार को बढ़ावा
ओपन-सोर्स आंदोलन का वादा है कि वह LLM और जेनरेटिव AI तकनीकों के उपयोग और पहुँच का लोकतंत्रीकरण करेगा। डेवलपर्स को LLMs के अंदरूनी कामकाज देखने देना इस तकनीक के भविष्य के विकास के लिए महत्वपूर्ण है। दुनिया भर के कोडर्स के लिए प्रवेश बाधाएँ कम करके, ओपन-सोर्स LLMs नवाचार को बढ़ावा दे सकते हैं और पूर्वाग्रह घटाकर, शुद्धता और समग्र प्रदर्शन बढ़ाकर मॉडलों में सुधार कर सकते हैं।
AI के पर्यावरणीय प्रभाव का समाधान
LLMs के लोकप्रिय होने के बाद, शोधकर्ता और पर्यावरण प्रहरी इन तकनीकों को चलाने में लगने वाले कार्बन फ़ुटप्रिंट और जल खपत को लेकर चिंताएँ जता रहे हैं। प्रोप्रायटरी LLMs शायद ही कभी LLMs को ट्रेन और ऑपरेट करने के लिए आवश्यक संसाधनों या उससे जुड़े पर्यावरणीय प्रभाव के बारे में जानकारी प्रकाशित करते हैं।
ओपन-सोर्स LLM के साथ, शोधकर्ताओं के पास इस जानकारी तक पहुँच की अधिक संभावनाएँ होती हैं, जो AI के पर्यावरणीय फ़ुटप्रिंट को कम करने के लिए नए सुधारों के द्वार खोल सकती हैं।
2026 के लिए 11 शीर्ष ओपन-सोर्स लार्ज लैंग्वेज मॉडल
1. GLM 5.1
GLM 5.1 चीनी AI लैब Z.ai की फ्लैगशिप रिलीज़ है। यह 744B-पैरामीटर का Mixture of Experts मॉडल है जिसमें 40B सक्रिय पैरामीटर और 200K-टोकन कॉन्टेक्स्ट विंडो है, जिसे कोडिंग, रीजनिंग और एजेंटिक वर्कफ़्लोज़ के लिए पोज़िशन किया गया है।
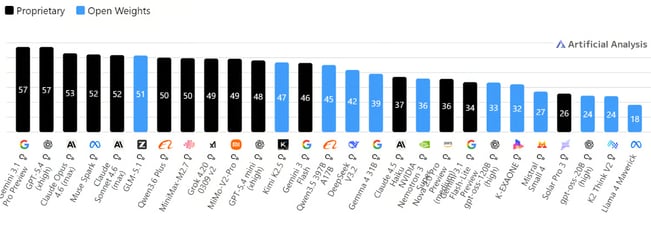
Artificial Analysis वर्तमान में GLM 5.1 को अपने इंटेलिजेंस इंडेक्स पर अग्रणी ओपन-वेट्स मॉडल के रूप में वर्णित करता है, जो अधिकांश रीजनिंग और कोडिंग बेंचमार्क्स पर DeepSeek, Kimi और Qwen प्रविष्टियों से आगे है। यह विशेष रूप से SWE-Bench Pro पर मजबूत है, जहाँ स्वतंत्र आकलनों ने इसे एजेंटिक वेब डेवलपमेंट श्रेणी में शीर्ष पर रखा है।
2. GLM 4.6
GLM-4.6 को एजेंटिक वर्कफ़्लोज़ को बेहतर बनाने, सुदृढ़ कोडिंग सहायता प्रदान करने, उन्नत रीजनिंग को सक्षम करने और उच्च-गुणवत्ता की नैचुरल लैंग्वेज जनरेशन के लिए डिज़ाइन किया गया है। मॉडल अनुसंधान और प्रोडक्शन दोनों परिवेशों के लिए लक्षित है, जिसमें लंबी-प्रसंग समझ, टूल-ऑगमेंटेड इन्फ़रेंस और उपयोगकर्ता प्राथमिकताओं के साथ स्वाभाविक रूप से संरेखित लेखन पर ध्यान केंद्रित है।
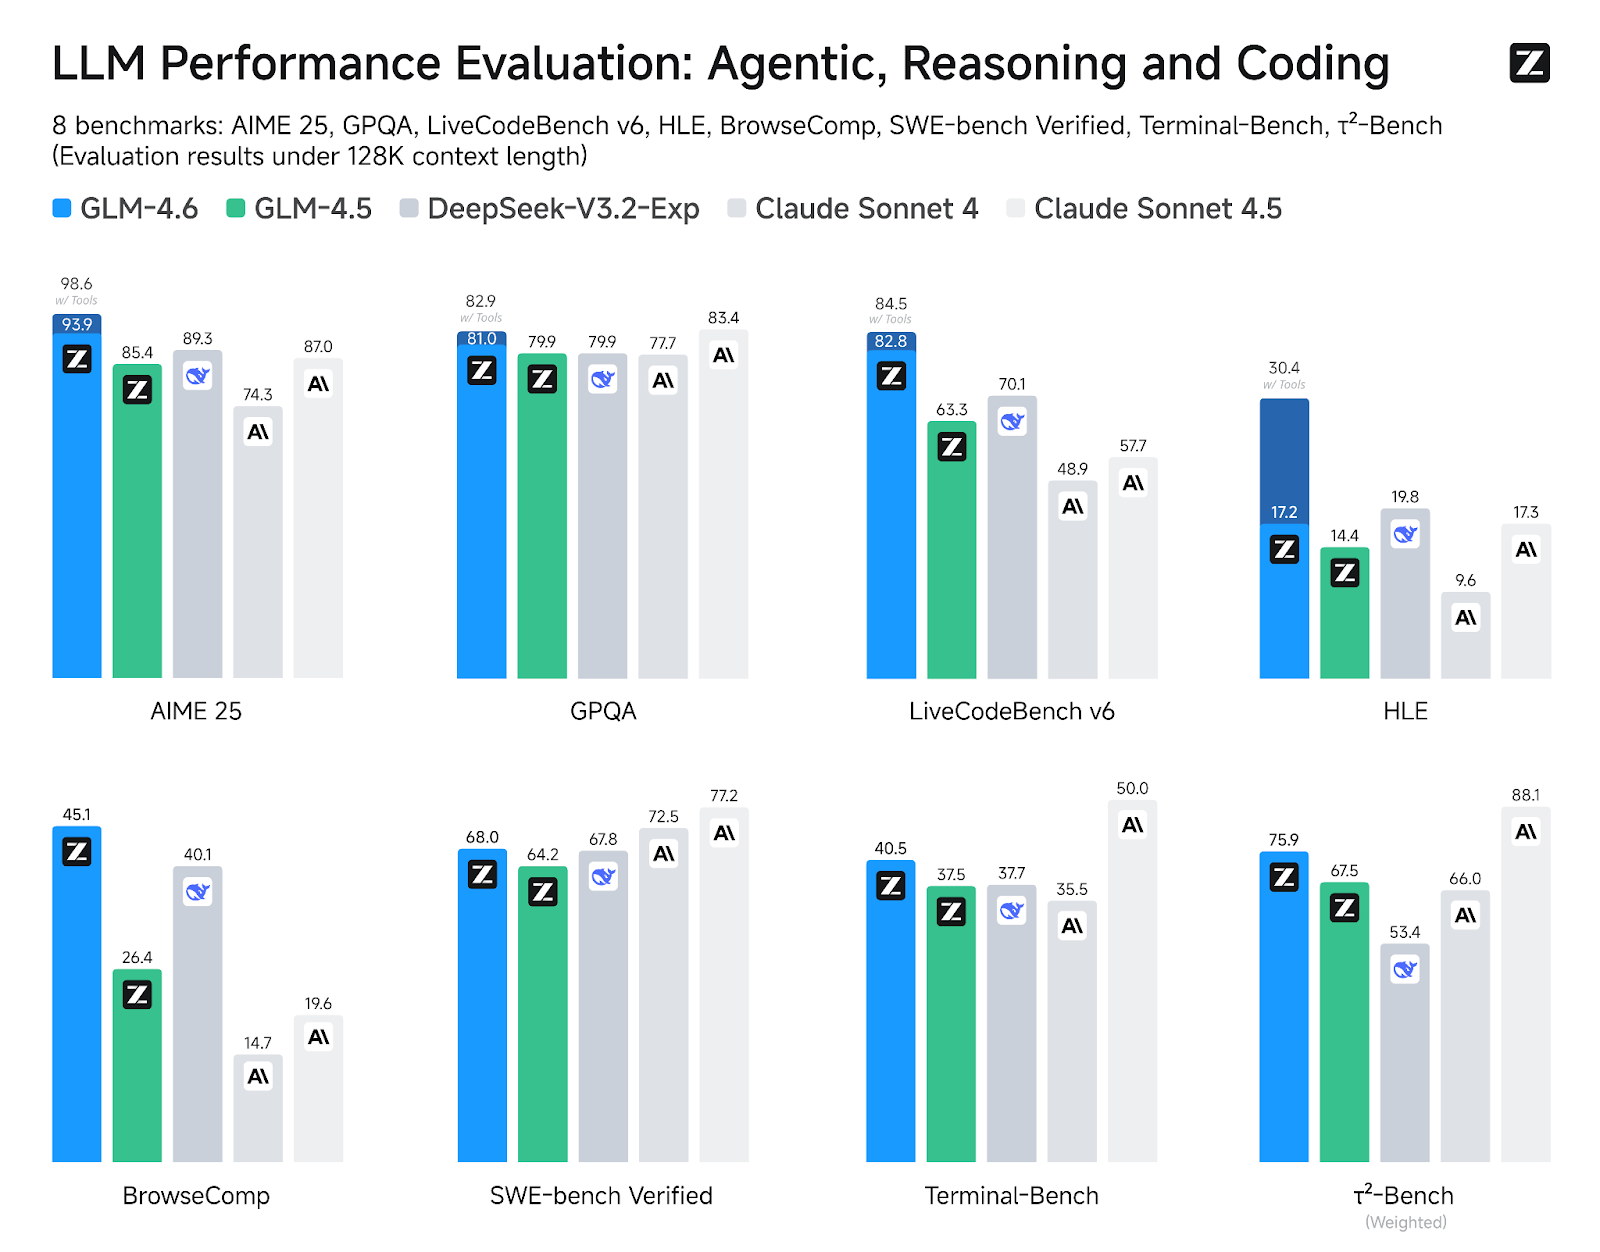
स्रोत:zai-org/GLM-4.6
GLM-4.5 की तुलना में, GLM-4.6 कई प्रमुख सुधार लाता है: कॉन्टेक्स्ट विंडो 128K से बढ़ाकर 200K टोकन कर दी गई है, जिससे अधिक जटिल एजेंटिक कार्य संभव होते हैं। कोडिंग परफ़ॉर्मेंस भी बेहतर हुई है, जिससे उच्चतर बेंचमार्क स्कोर और वास्तविक-जीवन अनुप्रयोगों में बेहतर परिणाम मिले हैं।
GLM-4.6 एजेंट्स, रीजनिंग और कोडिंग से संबंधित आठ सार्वजनिक बेंचमार्क्स में स्पष्ट बढ़त दिखाता है, GLM-4.5 से बेहतर प्रदर्शन करते हुए DeepSeek-V3.1-Terminus और Claude Sonnet 4 जैसे अग्रणी मॉडलों पर प्रतिस्पर्धी बढ़त प्रदर्शित करता है।
3. gpt-oss-120B
gpt-oss-120b gpt-oss श्रृंखला का शिखर है—OpenAI के ओपन-वेट मॉडल जो उन्नत रीजनिंग, एजेंटिक कार्यों और बहुमुखी डेवलपर वर्कफ़्लोज़ के लिए डिज़ाइन किए गए हैं। इस श्रृंखला में दो संस्करण शामिल हैं: gpt-oss-120b, जिसे उच्च-स्तरीय रीजनिंग की आवश्यकता वाले प्रोडक्शन-ग्रेड, सामान्य-उद्देश्य उपयोग मामलों के लिए बनाया गया है और जो एक 80GB GPU पर चल सकता है (117 बिलियन पैरामीटर्स, जिनमें 5.1 बिलियन सक्रिय); और gpt-oss-20b, जो कम लेटेंसी और लोकल या विशिष्ट डिप्लॉयमेंट्स के लिए ऑप्टिमाइज़्ड है (21 बिलियन पैरामीटर्स और 3.6 बिलियन सक्रिय)। दोनों मॉडलों को हार्मनी रेस्पॉन्स फ़ॉर्मेट से प्रशिक्षित किया गया है और प्रभावी ढंग से काम करने के लिए इन्हें हार्मनी फ्रेमवर्क के साथ उपयोग करना चाहिए।
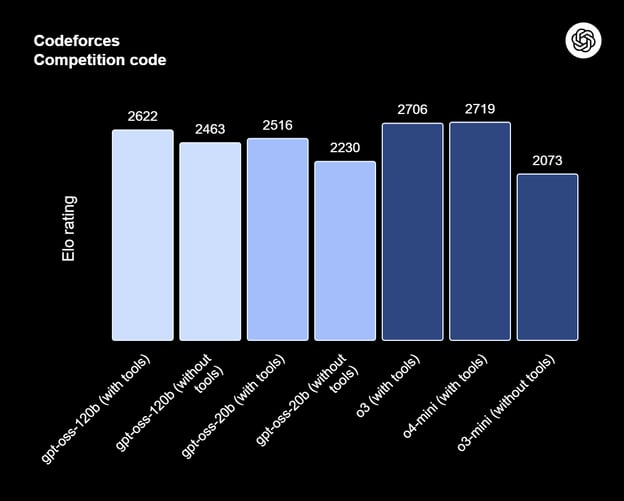
स्रोत: Introducing gpt-oss | OpenAI
gpt-oss-120b कॉन्फ़िगरेबल रीजनिंग इफ़ोर्ट्स भी देता है: लो, मीडियम या हाई, ताकि गहराई और लेटेंसी में संतुलन रहे। यह डिबगिंग और ऑडिटिंग उद्देश्यों के लिए पूर्ण चेन-ऑफ-थॉट एक्सेस प्रदान करता है। इन मॉडलों को फाइन-ट्यून किया जा सकता है और इनमें फ़ंक्शन कॉलिंग, वेब ब्राउज़िंग, Python कोड निष्पादन और स्ट्रक्चर्ड आउटपुट जैसे अंतर्निहित एजेंटिक क्षमताएँ हैं।
MoE वेट्स के MXFP4 क्वांटाइज़ेशन के कारण, gpt-oss-120b एक 80GB GPU पर चल सकता है, जबकि gpt-oss-20b 16GB परिवेश में ऑपरेट कर सकता है। हमारे लेख GPT-OSS 120B को मुफ़्त में एक्सेस करने के 10 तरीके पढ़ें।
4. Qwen3 235B 2507
Qwen3-235B-A22B-Instruct-2507 Qwen3-MoE परिवार का फ्लैगशिप नॉन-थिंकिंग मॉडल है, जिसे उच्च-परिशुद्धता निर्देश-अनुसरण, सख्त लॉजिकल रीजनिंग, बहुभाषी टेक्स्ट समझ, गणित, विज्ञान, कोडिंग, टूल उपयोग और बहुत लंबे प्रसंगों की आवश्यकता वाले कार्यों के लिए डिज़ाइन किया गया है। यह एक Mixture of Experts (MoE) कॉज़ल लैंग्वेज मॉडल है जिसमें कुल 235 बिलियन पैरामीटर्स हैं, जिनमें 22 बिलियन सक्रिय (128 विशेषज्ञों में से एक समय में 8 सक्रिय) होते हैं। मॉडल में 94 लेयर्स हैं, 64 क्वेरी हेड्स और 4 की-वैल्यू हेड्स के साथ GQA मैकेनिज्म शामिल है, और 262,000 टोकन्स की नेटिव कॉन्टेक्स्ट विंडो है, जिसे लगभग 1.01 मिलियन टोकन तक बढ़ाया जा सकता है।
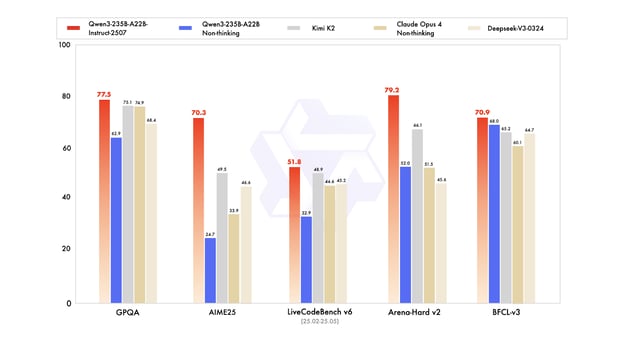
नवीनतम Instruct-2507 अपडेट सामान्य क्षमताओं में उल्लेखनीय सुधार लाता है और कई भाषाओं में लॉन्ग-टेल नॉलेज कवरेज का विस्तार करता है। यह ओपन-एंडेड कार्यों के लिए प्राथमिकता-संरेखण में भी काफ़ी बेहतर है और लेखन गुणवत्ता को बढ़ाता है, खासकर 256,000+ लंबे कॉन्टेक्स्ट की समझ के लिए।
सार्वजनिक बेंचमार्क्स पर यह असाधारण परिणाम दिखाता है। व्यवहार में, यह Instruct-2507 को शीर्ष-स्तरीय नॉन-थिंकिंग मॉडल के रूप में स्थापित करता है, जो पहले के Qwen3-235B-A22B नॉन-थिंकिंग वेरिएंट और DeepSeek-V3, GPT-4o, Claude Opus 4 (नॉन-थिंकिंग) और Kimi K2 जैसे अग्रणी प्रतिस्पर्धियों से बेहतर प्रदर्शन करता है।
हमारे विस्तृत लेख में Qwen3 के बारे में और जानें।
5. DeepSeek V3.2 Exp
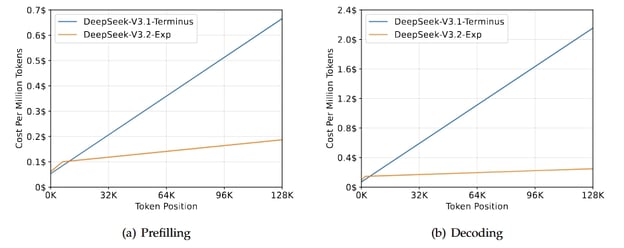
DeepSeek-V3.2-Exp DeepSeek आर्किटेक्चर की अगली पीढ़ी की ओर अग्रसर एक प्रायोगिक, मध्यवर्ती संस्करण है। यह V3.1-Terminus पर आधारित है और लंबे कॉन्टेक्स्ट परिदृश्यों में विशेष रूप से प्रशिक्षण और इन्फ़रेंस दक्षता बढ़ाने के लिए DeepSeek Sparse Attention पेश करता है। यह मॉडल विस्तारित अनुक्रमों के लिए ट्रांसफॉर्मर दक्षता में सुधार करने का लक्ष्य रखता है, जबकि Terminus वंश से अपेक्षित आउटपुट गुणवत्ता बनाए रखता है।
स्रोत: DeepSeek-V3.2-Exp
इस रिलीज़ का प्राथमिक परिणाम यह है कि यह V3.1-Terminus की समग्र क्षमताओं से मेल खाता है, जबकि लंबे कॉन्टेक्स्ट कार्यों के लिए उल्लेखनीय दक्षता सुधार प्रदान करता है। मूल्यांकनों और थर्ड-पार्टी विश्लेषणों से पता चलता है कि इसका प्रदर्शन Terminus के तुलनीय है, और कम्प्यूटेशनल लागत में उल्लेखनीय कमी आती है। यह पुष्टि करता है कि स्पार्स अटेंशन गुणवत्ता से समझौता किए बिना दक्षता बढ़ा सकता है।
6. DeepSeek V4
DeepSeek V4, चीनी AI लैब DeepSeek की V3 श्रृंखला का बहुप्रतीक्षित उत्तराधिकारी है, जिसे 24 अप्रैल, 2026 को जारी किया गया। यह श्रृंखला दो वेरिएंट में आती है: DeepSeek-V4-Pro और DeepSeek-V4-Flash। दोनों Mixture of Experts (MoE) मॉडल हैं जिनमें डिफ़ॉल्ट 1-मिलियन-टोकन कॉन्टेक्स्ट विंडो है, और दोनों MIT लाइसेंस के तहत ओपन वेट्स के रूप में जारी किए गए हैं।
V4-Pro में कुल 1.6 ट्रिलियन पैरामीटर्स हैं जिनमें 49 बिलियन सक्रिय हैं, जो इसे वर्तमान में उपलब्ध सबसे बड़ा ओपन-वेट्स मॉडल बनाते हैं। V4-Flash एक अधिक सुलभ 284B-पैरामीटर वेरिएंट है जिसका लक्ष्य लागत-संवेदी वर्कलोड्स हैं।
मुख्य विशेषता है V4 की हाइब्रिड अटेंशन आर्किटेक्चर, जो Compressed Sparse Attention (CSA) और Heavily Compressed Attention (HCA) को मिलाकर 1M-टोकन कॉन्टेक्स्ट को व्यावहारिक रूप से सर्व करने योग्य बनाती है। DeepSeek के तकनीकी नोट्स के अनुसार, 1M-टोकन परिदृश्य में V4-Pro को V3.2 की तुलना में सिंगल-टोकन इन्फ़रेंस FLOPs का केवल 27% और KV कैश का 10% चाहिए। मॉडल तीन रीजनिंग इफ़ोर्ट मोड्स — Non-think, Think High और Think Max — भी प्रदान करता है, जिससे उपयोगकर्ताओं को लेटेंसी/क्वालिटी ट्रेड-ऑफ़ पर सूक्ष्म नियंत्रण मिलता है।
7. DeepSeek R1 0528
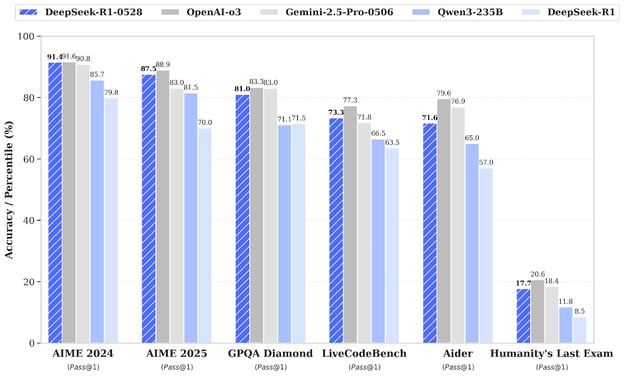
DeepSeek-R1 को एक मामूली संस्करण अपग्रेड मिला है: DeepSeek-R1-0528, जो प्रशिक्षण के बाद बढ़ी हुई कम्प्यूटेशनल पावर और एल्गोरिथ्मिक ऑप्टिमाइज़ेशंस के माध्यम से इसकी रीजनिंग और इन्फ़रेंस क्षमताओं को बढ़ाता है। परिणामस्वरूप, गणित, प्रोग्रामिंग और सामान्य लॉजिक सहित विभिन्न क्षेत्रों में महत्वपूर्ण सुधार हुए हैं। समग्र प्रदर्शन अब O3 और Gemini 2.5 Pro जैसे अग्रणी सिस्टम्स के और करीब है।
कच्ची क्षमताओं के अलावा, यह अपडेट फ़ंक्शन कॉलिंग और कोडिंग वर्कफ़्लोज़ को बेहतर करके व्यावहारिक उपयोगिता पर जोर देता है, जो अधिक भरोसेमंद और उत्पादकता-उन्मुख आउटपुट पर ध्यान को दर्शाता है।
स्रोत: deepseek-ai/DeepSeek-R1-0528
पिछले DeepSeel R1 संस्करण की तुलना में, अपग्रेडेड मॉडल जटिल रीजनिंग में ठोस प्रगति दिखाता है। उदाहरण के लिए, AIME 2025 परीक्षा में सटीकता 70% से बढ़कर 87.5% हो गई, जिसे गहरे विश्लेषणात्मक सोच का समर्थन मिला (प्रति प्रश्न औसत टोकन लगभग 12,000 से बढ़कर 23,000 हो गए)।
व्यापक मूल्यांकन भी ज्ञान, रीजनिंग और कोडिंग प्रदर्शन जैसे क्षेत्रों में सकारात्मक रुझान दिखाते हैं। उदाहरणों में LiveCodeBench, Codeforces रेटिंग्स, SWE Verified, और Aider-Polyglot में सुधार शामिल हैं, जो समस्या-समाधान की गहराई और वास्तविक-जीवन कोडिंग क्षमताओं में श्रेष्ठता का संकेत देते हैं।
8. Apriel-v1.5-15B-Thinker
Apriel-1.5-15b-Thinker ServiceNow की Apriel SLM श्रृंखला में एक मल्टीमोडल रीजनिंग मॉडल है। यह केवल 15 बिलियन पैरामीटर्स के साथ प्रतिस्पर्धी प्रदर्शन देता है, जिसका लक्ष्य एकल-GPU बजट की सीमाओं के भीतर फ्रंटियर-स्तरीय परिणाम हैं। यह मॉडल न केवल पिछले टेक्स्ट-ओनली मॉडल में इमेज रीजनिंग क्षमताएँ जोड़ता है, बल्कि अपने टेक्स्टुअल रीजनिंग कौशल को भी गहरा करता है।
रीजनिंग श्रृंखला के दूसरे मॉडल के रूप में, इसने टेक्स्ट और इमेज दोनों डोमेन्स में व्यापक निरंतर प्री-ट्रेनिंग प्राप्त की है। पोस्ट-ट्रेनिंग में केवल टेक्स्ट पर सुपरवाइज़्ड फाइन-ट्यूनिंग (SFT) शामिल है, बिना किसी इमेज-विशिष्ट SFT या रिइन्फोर्समेंट लर्निंग के। इन सीमाओं के बावजूद, मॉडल अपने आकार के लिए टेक्स्ट और इमेज रीजनिंग में अत्याधुनिक गुणवत्ता को लक्षित करता है।
स्रोत: ServiceNow-AI/Apriel-1.5-15b-Thinker
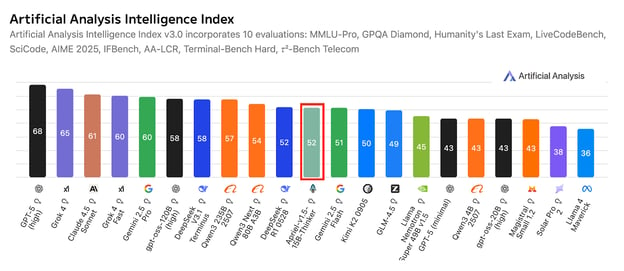
एकल GPU पर चलने के लिए डिज़ाइन किया गया, यह व्यावहारिक डिप्लॉयमेंट और दक्षता को प्राथमिकता देता है। मूल्यांकन परिणाम वास्तविक-जीवन अनुप्रयोगों के लिए मजबूत तत्परता का संकेत देते हैं, Artificial Analysis इंडेक्स स्कोर 52 के साथ, जो मॉडल को कहीं बड़े सिस्टम्स के मुकाबले प्रतिस्पर्धी स्थिति में रखता है। यह स्कोर अग्रणी कॉम्पैक्ट और फ्रंटियर समकक्षों की तुलना में इसके कवरेज को भी दर्शाता है, जबकि एंटरप्राइज उपयोग के लिए उपयुक्त स्मॉल-मॉडल फ़ुटप्रिंट बनाए रखता है।
9. Kimi K2 0905
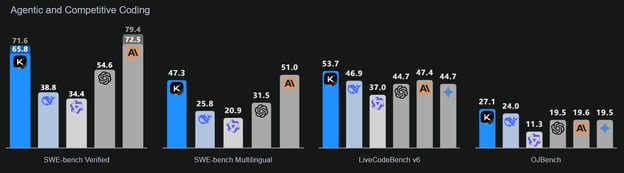
Kimi-K2-Instruct-0905 Kimi K2 लाइनअप में नवीनतम और सबसे उन्नत मॉडल है। यह अत्याधुनिक Mixture-of-Experts भाषा मॉडल है, जिसमें कुल 1 ट्रिलियन पैरामीटर्स और 32 बिलियन सक्रिय पैरामीटर्स हैं। यह मॉडल विशेष रूप से उच्च-स्तरीय रीजनिंग और कोडिंग वर्कफ़्लोज़ के लिए डिज़ाइन किया गया है।
K2-Instruct-0905 256,000-टोकन कॉन्टेक्स्ट विंडो के साथ K2 की दीर्घकालिक कार्यों को संभालने की क्षमता को काफ़ी बढ़ाता है, जो पहले के 128,000 टोकन्स से वृद्धि है। इसका लक्ष्य मजबूत एजेंट-आधारित उपयोग मामलों का समर्थन करना है, जिसमें टूल-ऑगमेंटेड चैट और कोड असिस्टेंस शामिल हैं। K2 Instruct श्रृंखला के फ्लैगशिप रिलीज़ के रूप में, यह डेवलपर एर्गोनॉमिक्स और प्रोडक्शन-क्वालिटी अनुप्रयोगों के लिए विश्वसनीयता पर केंद्रित है।
स्रोत: Kimi K2: Open Agentic Intelligence
यह मॉडल तीन प्रमुख क्षेत्रों पर जोर देता है: एजेंट-आधारित कार्यों के लिए उन्नत कोडिंग इंटेलिजेंस, जो सार्वजनिक बेंचमार्क्स और वास्तविक-जीवन अनुप्रयोगों में स्पष्ट सुधार दिखाता है; एक बेहतर यूज़र इंटरफ़ेस जो सौंदर्य और कार्यक्षमता दोनों को बढ़ाता है; और 256,000-टोकन विस्तारित कॉन्टेक्स्ट लंबाई जो अधिक व्यापक प्लानिंग और एडिटिंग लूप्स की अनुमति देती है।
10. Llama Nemotron Super 49B v1.5
Llama-3_3-Nemotron-Super-49B-v1_5 NVIDIA की Nemotron लाइन में एक अपग्रेडेड 49 बिलियन पैरामीटर मॉडल है, जो Meta के Llama-3.3-70B-Instruct से व्युत्पन्न है। इसे विशेष रूप से मानव-संरेखित चैट और एजेंटिक कार्यों, जैसे रिट्रीवल-ऑगमेंटेड जनरेशन (RAG) और टूल कॉलिंग, के लिए एक रीजनिंग मॉडल के रूप में डिज़ाइन किया गया है।
इस मॉडल ने अपनी रीजनिंग क्षमताओं, प्राथमिकता-संरेखण और टूल उपयोग को बढ़ाने के लिए पोस्ट-ट्रेनिंग प्राप्त की है। यह 128,000 टोकन्स तक की लंबी-प्रसंग वर्कफ़्लोज़ का भी समर्थन करता है, जो इसे जटिल, बहु-चरणीय अनुप्रयोगों के लिए उपयुक्त बनाता है।
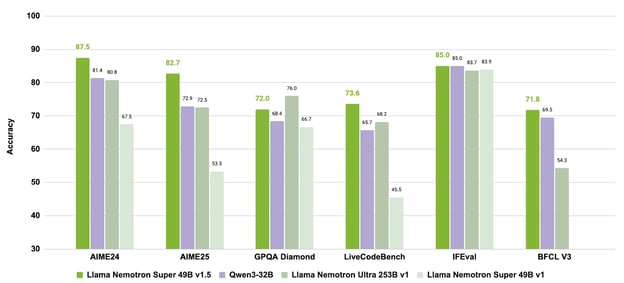
स्रोत: nvidia/Llama-3_3-Nemotron-Super-49B-v1_5
रीजनिंग और एजेंट व्यवहारों के लिए लक्षित पोस्ट-ट्रेनिंग को लंबी-प्रसंग कार्यों के समर्थन के साथ जोड़कर, Llama-3.3-Nemotron-Super-49B-v1.5 उन डेवलपर्स के लिए संतुलित समाधान प्रदान करता है जिन्हें उन्नत रीजनिंग क्षमताएँ और सुदृढ़ टूल उपयोग चाहिए, वह भी रनटाइम दक्षता से समझौता किए बिना।
11. Mistral-small-2506
Mistral-Small-3.2-24B-Instruct-2506 Mistral-Small-3.1-24B-Instruct-2503 पर एक महत्वपूर्ण अपग्रेड है, जो निर्देश-अनुसरण को बढ़ाता है, दोहराव त्रुटियों को कम करता है, और अधिक सुदृढ़ फ़ंक्शन कॉलिंग टेम्पलेट प्रदान करता है—यह सब करते हुए समग्र क्षमताओं को बनाए रखता या थोड़ा सुधारता है। एक 24B-पैरामीटर इन्स्ट्रक्ट मॉडल के रूप में, यह AWS मार्केटप्लेस सहित प्लेटफ़ॉर्म्स पर व्यापक रूप से सुलभ है, जहाँ इसे बेहतर निर्देश-अनुपालन के लिए नोट किया गया है।
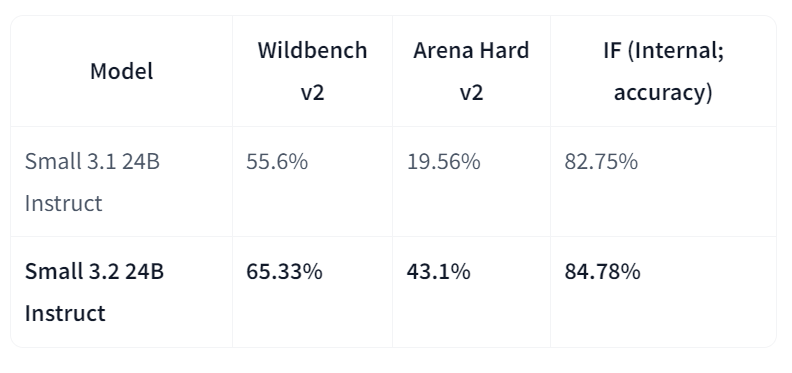
स्रोत: mistralai/Mistral-Small-3.2-24B-Instruct-2506
संस्करण 3.1 की प्रत्यक्ष तुलना में, Small-3.2 सहायक की गुणवत्ता और विश्वसनीयता में स्पष्ट प्रगति दिखाता है। यह Wildbench v2 (55.6% से 65.33%) और Arena Hard v2 (19.56% से 43.1%) पर निर्देश-अनुसरण प्रदर्शन को बढ़ाता है, जबकि आंतरिक निर्देश-अनुसरण सटीकता 82.75% से 84.78% हो जाती है। चुनौतीपूर्ण प्रॉम्प्ट्स पर दोहराव विफलताएँ आधी हो जाती हैं (2.11% से 1.29%)। इस बीच, STEM प्रदर्शन तुलनीय रहता है, MATH 69.42% पर, और HumanEval+ Pass@5 92.90% पर।
2026 के शीर्ष ओपन-सोर्स LLMs की तुलना
नीचे दी गई तालिका में, आप शीर्ष मॉडलों की तुलना देख सकते हैं:
| Model | Key Strengths | Notable Upgrades / Features |
|---|---|---|
| GLM 5.1 | कोडिंग, रीजनिंग और एजेंटिक वर्कफ़्लोज़ के लिए फ्लैगशिप ओपन-वेट्स मॉडल | 744B-पैरामीटर MoE (40B सक्रिय), 200K कॉन्टेक्स्ट; ओपन-वेट्स मॉडलों के लिए Artificial Analysis का इंटेलिजेंस इंडेक्स लीड करता है |
| GLM 4.6 | मज़बूत रीजनिंग, एजेंटिक वर्कफ़्लोज़, और कोडिंग क्षमताएँ | कॉन्टेक्स्ट विंडो 128K → 200K तक विस्तारित; GLM-4.5 और DeepSeek-V3.1 की तुलना में बेहतर बेंचमार्क प्रदर्शन |
| gpt-oss-120B | उन्नत रीजनिंग और एजेंटिक कार्यों के लिए ओपन-वेट GPT मॉडल | कॉन्फ़िगरेबल रीजनिंग गहराई, चेन-ऑफ-थॉट एक्सेस, फ़ंक्शन कॉलिंग, और हार्मनी रेस्पॉन्स फ़ॉर्मेट |
| Qwen3-235B-Instruct-2507 | बहुभाषी, उच्च-परिशुद्धता रीजनिंग और निर्देश-अनुसरण | 1M+ टोकन कॉन्टेक्स्ट, प्राथमिकता-संरेखित लेखन, GPT-4o और Claude Opus 4 (नॉन-थिंकिंग) से बेहतर प्रदर्शन |
| DeepSeek-V3.2-Exp | स्पार्स अटेंशन के माध्यम से कुशल लंबे-कॉन्टेक्स्ट प्रोसेसिंग | कम कम्प्यूट के साथ V3.1 के समकक्ष; ट्रांसफॉर्मर दक्षता ऑप्टिमाइज़्ड |
| DeepSeek V4 | सबसे बड़ा ओपन-वेट्स मॉडल; क्लोज़्ड-मॉडल प्राइसिंग के एक अंश पर लगभग फ्रंटियर प्रदर्शन | 1.6T-पैरामीटर MoE (49B सक्रिय), 1M-टोकन डिफ़ॉल्ट कॉन्टेक्स्ट, हाइब्रिड अटेंशन (CSA + HCA), तीन रीजनिंग इफ़ोर्ट मोड्स, MIT लाइसेंस |
| DeepSeek-R1-0528 | उन्नत रीजनिंग, गणित, और प्रोग्रामिंग क्षमता | AIME 2025 में 17.5% सुधार; विश्लेषणात्मक गहराई और कोडिंग विश्वसनीयता में वृद्धि |
| Apriel-1.5-15B-Thinker | एकल GPU पर मल्टीमोडल (टेक्स्ट + इमेज) रीजनिंग | टेक्स्ट और इमेज पर निरंतर प्री-ट्रेनिंग; कॉम्पैक्ट मॉडल आकार के लिए फ्रंटियर-स्तरीय रीजनिंग |
| Kimi-K2-Instruct-0905 | हाई-एंड रीजनिंग और एजेंट-आधारित कोडिंग वर्कफ़्लोज़ | 256K-टोकन कॉन्टेक्स्ट, बेहतर डेवलपर एर्गोनॉमिक्स, और टूल-ऑगमेंटेड टास्क सपोर्ट |
| Llama-3.3-Nemotron-Super-49B-v1.5 | संतुलित रीजनिंग और टूल-उपयोग मॉडल | RAG और एजेंटिक अनुप्रयोगों के लिए NVIDIA-ट्यून; 128K टोकन्स तक लंबा कॉन्टेक्स्ट सपोर्ट |
| Mistral-Small-3.2-24B-Instruct-2506 | कॉम्पैक्ट और विश्वसनीय निर्देश-अनुसरण | दोहराव त्रुटियाँ 50% कम और WildBench v2 तथा Arena Hard v2 पर प्रमुख बढ़त |
अपनी आवश्यकताओं के लिए सही ओपन-सोर्स LLM कैसे चुनें
ओपन-सोर्स LLM स्पेस तेजी से विस्तार कर रहा है। आज, ओपन-सोर्स LLMs प्रोप्रायटरी मॉडलों से कहीं अधिक हैं, और जैसे-जैसे दुनिया भर के डेवलपर मौजूदा LLMs को उन्नत करने और अधिक ऑप्टिमाइज़्ड मॉडल डिजाइन करने के लिए सहयोग कर रहे हैं, प्रदर्शन का अंतर भी जल्द भर सकता है।
इस जीवंत और रोमांचक परिदृश्य में, अपने उद्देश्य के लिए सही ओपन-सोर्स LLM चुनना कठिन हो सकता है। यहाँ कुछ कारक हैं जिन पर किसी विशिष्ट ओपन-सोर्स LLM को चुनने से पहले आपको विचार करना चाहिए:
- आप क्या करना चाहते हैं? सबसे पहले खुद से यह सवाल पूछें। ओपन-सोर्स LLMs हमेशा खुले होते हैं, लेकिन उनमें से कुछ केवल अनुसंधान उद्देश्यों के लिए जारी किए जाते हैं। इसलिए, यदि आप कोई कंपनी शुरू करने की योजना बना रहे हैं, तो संभावित लाइसेंसिंग सीमाओं से अवगत रहें।
- आपको LLM की आवश्यकता क्यों है? यह भी अत्यंत महत्वपूर्ण है। LLMs वर्तमान में चर्चा में हैं। हर कोई उनके और उनकी अनंत संभावनाओं के बारे में बात कर रहा है। लेकिन अगर आप अपना विचार बिना LLMs के बना सकते हैं, तो उनका उपयोग न करें। यह अनिवार्य नहीं है (और आप शायद बहुत पैसा बचाएँगे और संसाधनों का अतिरिक्त उपयोग भी रोकेंगे)।
- आपको कितनी सटीकता चाहिए? यह एक महत्वपूर्ण पहलू है। स्टेट-ऑफ़-द-आर्ट LLMs के आकार और सटीकता में प्रत्यक्ष संबंध है। इसका अर्थ है, समग्र रूप से, जितना बड़ा LLM (पैरामीटर्स और प्रशिक्षण डेटा के लिहाज़ से), उतना ही अधिक सटीक मॉडल होगा। इसलिए, यदि आपको उच्च सटीकता चाहिए, तो आपको LLaMA या Falcon जैसे बड़े LLMs चुनने चाहिए।
- आप कितना निवेश करना चाहते हैं? यह पिछले प्रश्न से गहराई से जुड़ा है। मॉडल जितना बड़ा होगा, उसे ट्रेन और ऑपरेट करने के लिए उतने ही अधिक संसाधनों की आवश्यकता होगी। इसका मतलब है अतिरिक्त इन्फ्रास्ट्रक्चर का उपयोग या क्लाउड में LLM चलाने पर क्लाउड प्रदाताओं का अधिक बिल। LLMs शक्तिशाली उपकरण हैं, लेकिन उनका उपयोग करने के लिए, यहाँ तक कि ओपन-सोर्स वाले भी, काफ़ी संसाधनों की आवश्यकता होती है।
- क्या आप प्री-ट्रेन किए गए मॉडल से अपने लक्ष्य हासिल कर सकते हैं? जब आप केवल प्री-ट्रेन मॉडल का उपयोग कर सकते हैं तो अपना LLM शून्य से ट्रेन करने में पैसा और ऊर्जा क्यों लगाएँ? वहाँ कई ओपन-सोर्स LLM संस्करण हैं जो किसी विशिष्ट उपयोग मामले के लिए ट्रेन किए गए हैं। यदि आपका विचार उन उपयोग मामलों में से किसी एक में फिट बैठता है, तो उसी का लाभ उठाएँ।
AI और LLMs के साथ अपनी टीम का अपस्किलिंग
ओपन-सोर्स LLMs केवल व्यक्तिगत प्रोजेक्ट्स या रुचियों के लिए नहीं हैं। जैसे-जैसे जेनरेटिव AI क्रांति तेज़ी से आगे बढ़ रही है, व्यवसाय इन टूल्स को समझने और लागू करने के महत्व को पहचान रहे हैं। चैटबॉट्स से लेकर जटिल डेटा प्रोसेसिंग कार्यों तक, उन्नत AI अनुप्रयोगों को सक्षम करने में LLMs पहले ही बुनियादी बन चुके हैं। सुनिश्चित करना कि आपकी टीम AI और LLM तकनीकों में दक्ष है, अब केवल प्रतिस्पर्धात्मक लाभ नहीं—यह आपके व्यवसाय को भविष्य के लिए तैयार करने की आवश्यकता है।
यदि आप टीम लीडर या व्यवसाय के मालिक हैं और अपनी टीम को AI और LLM विशेषज्ञता से सशक्त बनाना चाहते हैं, तो DataCamp for Business व्यापक प्रशिक्षण कार्यक्रम प्रदान करता है जो आपके कर्मचारियों को इन शक्तिशाली टूल्स का लाभ उठाने के लिए आवश्यक कौशल हासिल करने में मदद कर सकता है। हम प्रदान करते हैं:
- लक्षित AI और LLM लर्निंग पाथ्स: आपकी टीम के वर्तमान ज्ञान और आपके व्यवसाय की विशिष्ट आवश्यकताओं के अनुरूप अनुकूलन योग्य, जिसमें बुनियादी AI अवधारणाओं से लेकर उन्नत LLM विकास तक सब शामिल है।
- हैंड्स-ऑन AI प्रैक्टिस: वास्तविक-जीवन प्रोजेक्ट्स जो AI मॉडल बनाने और डिप्लॉय करने पर केंद्रित हैं, जिसमें GPT-4 जैसे लोकप्रिय LLMs और ओपन-सोर्स विकल्पों के साथ काम करना शामिल है।
- AI कौशल में प्रगति का ट्रैकिंग: ऐसे टूल्स जो आपकी टीम की प्रगति की निगरानी और आकलन करते हैं, ताकि वे प्रभावी ढंग से AI समाधान विकसित और लागू करने के लिए आवश्यक कौशल हासिल कर सकें।
AI और LLM अपस्किलिंग में निवेश न केवल आपकी टीम की क्षमताओं को बढ़ाता है, बल्कि आपके व्यवसाय को नवाचार के अग्रभाग में भी लाता है, जिससे आप इन परिवर्तनीय तकनीकों की पूरी क्षमता का लाभ उठा सकें। हमारी टीम से संपर्क करें और डेमो का अनुरोध करें और आज ही अपनी AI-रेडी वर्कफ़ोर्स बनाना शुरू करें।
निष्कर्ष
ओपन-सोर्स LLMs एक रोमांचक आंदोलन में हैं। उनकी तेज़ी से प्रगति को देखते हुए, ऐसा लगता है कि जेनरेटिव AI स्पेस अनिवार्य रूप से उन बड़े खिलाड़ियों द्वारा मोनोपोलाइज़ नहीं होगा जो इन शक्तिशाली टूल्स को बनाने और उपयोग करने में सक्षम हैं।
हमने यहाँ केवल आठ ओपन-सोर्स LLMs देखे हैं, लेकिन उनकी संख्या इससे कहीं अधिक है और तेजी से बढ़ रही है। DataCamp में हम LLM स्पेस की नवीनतम खबरों पर जानकारी, पाठ्यक्रम, लेख और ट्यूटोरियल उपलब्ध कराते रहेंगे। फिलहाल, हमारी क्यूरेटेड सामग्रियों की सूची देखें:
FAQs
ओपन-सोर्स LLMs क्या हैं?
ओपन-सोर्स लार्ज लैंग्वेज मॉडल (LLMs) वे मॉडल हैं जिनका सोर्स कोड और आर्किटेक्चर सार्वजनिक रूप से उपयोग, संशोधन और वितरण के लिए उपलब्ध होता है। ये मशीन लर्निंग एल्गोरिदम का उपयोग करके मानव-सदृश टेक्स्ट को प्रोसेस और जनरेट करते हैं, और ओपन-सोर्स होने के कारण, इनके विकास और अनुप्रयोग में पारदर्शिता, नवाचार, और समुदायिक सहयोग को बढ़ावा मिलता है।
ओपन-सोर्स LLMs महत्वपूर्ण क्यों हैं?
ओपन-सोर्स LLMs अत्याधुनिक AI तक पहुँच का लोकतंत्रीकरण करते हैं, जिससे दुनिया भर के डेवलपर्स बिना प्रोप्रायटरी मॉडलों की उच्च लागत के AI प्रगति में योगदान दे सकें और लाभ उठा सकें। वे पारदर्शिता बढ़ाते हैं, भरोसा पैदा करते हैं, और विशिष्ट आवश्यकताओं के अनुरूप कस्टमाइज़ेशन को सक्षम करते हैं।
ओपन-सोर्स LLMs में आम चुनौतियाँ क्या हैं?
चुनौतियों में रनिंग और ट्रेनिंग के लिए उच्च कम्प्यूटेशनल मांगें शामिल हैं, जो व्यक्तियों या छोटे संगठनों के लिए बाधा बन सकती हैं। नवीनतम शोध और सुरक्षा मानकों के साथ अद्यतन बने रहने के लिए मॉडलों का रखरखाव और अपडेट करना भी संरचनात्मक सहायता के बिना कठिन हो सकता है।
क्या ओपन-सोर्स LLMs सीखने के लिए मुफ़्त संसाधन उपलब्ध हैं?
हाँ! यदि आप विश्वविद्यालय के शिक्षक या छात्र हैं, तो आप DataCamp Classrooms का उपयोग करके हमारा पूरा कोर्स कैटलॉग नि:शुल्क प्राप्त कर सकते हैं, जिसमें ओपन-सोर्स LLMs पर कोर्स भी शामिल हैं।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
शक्तिशाली न्यूरल आर्किटेक्चर ट्रांसफॉर्मर्स पर आधारित, LLMs ऐसे AI सिस्टम हैं जो मानव भाषा का मॉडल बनाते और उसे प्रोसेस करते हैं। इन्हें “लार्ज” इसलिए कहा जाता है क्योंकि इनमें सैकड़ों मिलियन या बिलियन तक पैरामीटर्स होते हैं, जिन्हें विशाल टेक्स्ट डेटा कॉर्पस पर प्री-ट्रेन किया जाता है।
LLMs लोकप्रिय और व्यापक रूप से उपयोग किए जाने वाले चैटबॉट्स जैसे ChatGPT और Google Gemini के फाउंडेशन मॉडल हैं। विशेष रूप से, ChatGPT अब GPT-5.5 द्वारा संचालित है, जो OpenAI द्वारा विकसित और स्वामित्व वाला एक LLM है।
ChatGPT और Gemini, तथा अन्य कई लोकप्रिय चैटबॉट्स की समानता यह है कि उनके आधार LLMs मालिकाना (प्रोप्रायटरी) हैं। यानी वे किसी कंपनी के स्वामित्व में हैं और केवल लाइसेंस खरीदने के बाद ही ग्राहक उनका उपयोग कर सकते हैं। यह लाइसेंस अधिकार देता है, लेकिन साथ ही LLM के उपयोग के तरीकों पर संभावित प्रतिबंध और तकनीक के पीछे के तंत्र के बारे में सीमित जानकारी भी लेकर आता है।
फिर भी, LLM क्षेत्र में एक समानांतर आंदोलन तेजी से गति पकड़ रहा है: ओपन-सोर्स LLMs। प्रोप्रायटरी LLMs की पारदर्शिता की कमी और सीमित सुलभता को लेकर बढ़ती चिंताओं के बीच, जिन्हें मुख्यतः Microsoft, Google और Meta जैसे बिग टेक नियंत्रित करते हैं, ओपन-सोर्स LLMs वादा करते हैं कि वे LLMs और जेनरेटिव AI के तेजी से बढ़ते क्षेत्र को अधिक सुलभ, पारदर्शी और नवाचारी बनाएंगे।
यह लेख 2026 में उपलब्ध शीर्ष ओपन-सोर्स LLMs की पड़ताल करने का उद्देश्य रखता है। यद्यपि ChatGPT के लॉन्च और (प्रोप्रायटरी) LLMs के प्रसार को कुछ ही साल हुए हैं, ओपन-सोर्स समुदाय पहले ही महत्वपूर्ण उपलब्धियाँ हासिल कर चुका है और विभिन्न उद्देश्यों के लिए कई ओपन-सोर्स LLMs उपलब्ध हैं। सबसे लोकप्रिय मॉडलों को देखने के लिए पढ़ते रहें!
संक्षेप में: 2026 के शीर्ष ओपन-सोर्स LLMs
हमारा Large Language Models (LLMs) Concepts Course आज ही शुरू करें और जानें कि LLMs कैसे काम करते हैं।