
{count, plural, one {कोर्स} other {कोर्स}}
Python में Exploratory Data Analysis
{hours} घंटा
118.4K
हाल के वर्षों में डेटा विश्लेषण पहले से कहीं अधिक महत्वपूर्ण हो गया है। जहाँ पिछला दशक 'बिग डेटा' के संचय से परिभाषित था, वहीं 2026 गति और उपयोगिता से परिभाषित है। मेरे विचार में, अब केवल पेटाबाइट्स डेटा एकत्र करना पर्याप्त नहीं है। प्रतिस्पर्धात्मक बढ़त अब डिसीजन इंटेलिजेंस में निहित है: डेटा और AI का उपयोग करके निर्णय लेने को डिजिटाइज़ और स्वचालित करने की क्षमता।
Grand View Research के अनुसंधान के अनुसार, बिज़नेस इंटेलिजेंस उद्योग 2024 में लगभग $36.6 बिलियन से बढ़कर 2030 तक $86.6 बिलियन से अधिक होगा। इसका बड़ा हिस्सा BI टूल्स में जेनरेटिव AI के एकीकरण से प्रेरित है।
आज, संगठन वास्तविक समय में जटिल चुनौतियों को हल करने के लिए डेटा विश्लेषण का उपयोग कर रहे हैं:
डेटा विश्लेषण वह इंजन है जो असंरचित डेटा (वीडियो, टेक्स्ट, IoT सिग्नल) के कच्चे ईंधन को व्यावसायिक रणनीति के परिष्कृत उत्पाद में बदल देता है।
डेटा विश्लेषण की प्रक्रिया कई चरणों वाली एक व्यवस्थित पद्धति है। यहाँ हम आपको प्रत्येक चरण से गुज़ारेंगे—उद्देश्य तय करने से लेकर डेटा स्टोरीटेलिंग तक। आप अलग मार्गदर्शिका में व्यवसाय कैसे डेटा का विश्लेषण करते हैं के बारे में और जान सकते हैं।

संक्षेप में डेटा विश्लेषण प्रक्रिया
डेटा विश्लेषण प्रक्रिया का पहला चरण उद्देश्यों को परिभाषित करना और स्पष्ट, विशिष्ट प्रश्नों का निर्माण करना है जिनका उत्तर आपका विश्लेषण देगा। यह चरण पूरे अभियान की दिशा तय करता है। इसमें मौजूदा समस्या या स्थिति को समझना, उसे संबोधित करने के लिए आवश्यक डेटा की पहचान करना, और परिणामों को मापने के लिए मीट्रिक्स या संकेतकों को परिभाषित करना शामिल है।
उद्देश्य और प्रश्न तय होने के बाद अगला चरण प्रासंगिक डेटा एकत्र करना है। यह सर्वेक्षण, साक्षात्कार, अवलोकन, या मौजूदा डेटाबेस से निष्कर्षण जैसे विभिन्न तरीकों से किया जा सकता है। समस्या की प्रकृति और पूछे गए प्रश्नों के अनुसार एकत्रित डेटा मात्रात्मक (संख्यात्मक) या गुणात्मक (गैर-संख्यात्मक) हो सकता है।
डेटा सफाई, जिसे डेटा क्लेंज़िंग भी कहा जाता है, डेटा विश्लेषण प्रक्रिया का एक महत्त्वपूर्ण चरण है। इसमें त्रुटियों और असंगतियों के लिए डेटा की जाँच करना और उन्हें सुधारना या हटाना शामिल है। यह चरण डेटा की गुणवत्ता और विश्वसनीयता सुनिश्चित करता है, जो सटीक और सार्थक परिणाम पाने के लिए आवश्यक है।
डेटा के साफ हो जाने के बाद वास्तविक विश्लेषण का समय आता है। इसमें डेटा पर सांख्यिकीय या गणितीय तकनीकों को लागू करना शामिल है ताकि पैटर्न, संबंध, या रुझान खोजे जा सकें। इस उद्देश्य के लिए Python, R, Excel और SPSS, SAS जैसे विशेष सॉफ़्टवेयर उपलब्ध हैं।
डेटा के विश्लेषित हो जाने के बाद अगला चरण परिणामों की व्याख्या करना और उन्हें ऐसे दृश्य रूप में प्रस्तुत करना है जो आसानी से समझ में आए। इसमें चार्ट, ग्राफ़ या अन्य दृश्य प्रतिरूप बनाना शामिल हो सकता है। डेटा दृश्यांकन जटिल डेटा को समझने योग्य बनाता है और निष्कर्षों की स्पष्ट तस्वीर देता है।
डेटा विश्लेषण प्रक्रिया का अंतिम चरण डेटा स्टोरीटेलिंग है। इसमें विश्लेषण के निष्कर्षों को एक रोचक और आसानी से समझ आने वाली कथा के रूप में प्रस्तुत करना शामिल है। डेटा स्टोरीटेलिंग गैर-तकनीकी दर्शकों तक परिणामों को संप्रेषित करने और डेटा-आधारित निर्णय लेने के लिए अत्यंत महत्त्वपूर्ण है।
डेटा विश्लेषण को चार मुख्य प्रकारों में बाँटा जा सकता है, जिनमें से प्रत्येक का अलग उद्देश्य और अंतर्दृष्टि होती है। ये हैं—वर्णनात्मक, निदानात्मक, पूर्वानुमानात्मक, और उपदेशात्मक विश्लेषण।

वर्णनात्मक विश्लेषण नाम के अनुसार कच्चे डेटा का वर्णन या संक्षेपण करता है और उसे व्याख्यायनीय बनाता है। इसमें ऐतिहासिक डेटा का विश्लेषण शामिल है ताकि यह समझा जा सके कि अतीत में क्या हुआ। इसका उपयोग समय के साथ पैटर्न और रुझान पहचानने के लिए किया जाता है।
उदाहरण के लिए, कोई व्यवसाय पिछले वर्ष की औसत मासिक बिक्री समझने के लिए वर्णनात्मक विश्लेषण का उपयोग कर सकता है।
निदानात्मक विश्लेषण वर्णनात्मक विश्लेषण से एक कदम आगे बढ़कर यह निर्धारित करता है कि कुछ क्यों हुआ। इसमें अधिक विस्तृत डेटा अन्वेषण और विभिन्न डेटासेट्स की तुलना शामिल है ताकि किसी विशेष परिणाम के कारण को समझा जा सके।
उदाहरण के लिए, यदि किसी माह में कंपनी की बिक्री घट गई, तो निदानात्मक विश्लेषण इसके कारण तलाशने में मदद कर सकता है।
पूर्वानुमानात्मक विश्लेषण भविष्य को समझने के लिए सांख्यिकीय मॉडल और पूर्वानुमान तकनीकों का उपयोग करता है। इसमें अतीत के डेटा का उपयोग करके भविष्य में क्या हो सकता है, इसका अनुमान लगाया जाता है। इस प्रकार का विश्लेषण प्रायः जोखिम आकलन, मार्केटिंग, और बिक्री पूर्वानुमान में उपयोग होता है।
उदाहरण के लिए, कोई कंपनी ऐतिहासिक डेटा के आधार पर अगले तिमाही की बिक्री का पूर्वानुमान लगाने के लिए पूर्वानुमानात्मक विश्लेषण का उपयोग कर सकती है।
उपदेशात्मक (प्रेस्क्रिप्टिव) विश्लेषण डेटा विश्लेषण का सबसे उन्नत प्रकार है। यह न केवल भविष्य के परिणामों का अनुमान लगाता है, बल्कि उनसे लाभ उठाने के लिए क्रियाएँ भी सुझाता है। यह सिफारिशें देने के लिए मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस जैसी उन्नत तकनीकों का उपयोग करता है।
उदाहरण के लिए, उपदेशात्मक विश्लेषण भविष्य की बिक्री बढ़ाने के लिए सर्वोत्तम मार्केटिंग रणनीतियाँ सुझा सकता है।
नीचे दी गई तालिका में आप डेटा विश्लेषण के विभिन्न प्रकारों की तुलना देख सकते हैं:
| विश्लेषण का प्रकार | मुख्य प्रश्न | केंद्र | कार्यप्रणाली | व्यावसायिक उदाहरण |
|---|---|---|---|---|
| वर्णनात्मक | क्या हुआ? | पश्चदृष्टि (अतीत) | डेटा एकत्रीकरण, सारांकीय आँकड़े | एक डैशबोर्ड जो दिखाता है कि Q3 में मासिक बिक्री 15% घटी। |
| निदानात्मक | यह क्यों हुआ? | अंतर्दृष्टि (कारण) | ड्रिल-डाउन, खोज, सहसंबंध | पहचानना कि Q3 की गिरावट एक विशिष्ट क्षेत्र में प्रतिस्पर्धी की कीमतों में कटौती के कारण हुई। |
| पूर्वानुमानात्मक | क्या होने की संभावना है? | पूर्वदृष्टि (भविष्य) | प्रतिगमन विश्लेषण, पूर्वानुमान मॉडल | पूर्वानुमान लगाना कि यदि कोई कार्रवाई नहीं की गई तो Q4 में बिक्री और 5% गिरेगी। |
| उपदेशात्मक | हमें क्या करना चाहिए? | अनुकूलन (कार्रवाई) | मशीन लर्निंग, सिमुलेशन, AI सिफारिश | एक AI सिस्टम खोए हुए राजस्व की भरपाई के लिए वफादार ग्राहकों को स्वतः 10% छूट की सलाह देता है। |
डेटा विश्लेषण में अनेक तकनीकें प्रयुक्त होती हैं, जिनका उद्देश्य और उपयोग अलग-अलग होता है। यहाँ हम प्रचलित तकनीकों पर चर्चा करेंगे, जिनमें एक्सप्लोरेटरी (अन्वेषणात्मक) विश्लेषण, प्रतिगमन विश्लेषण, फैक्टर विश्लेषण आदि शामिल हैं।
अन्वेषणात्मक विश्लेषण किसी डेटासेट की मुख्य विशेषताओं को समझने के लिए उपयोग किया जाता है। इसे अक्सर डेटा विश्लेषण प्रक्रिया की शुरुआत में डेटा के प्रमुख पहलुओं को संक्षेपित करने, गायब मानों की जाँच करने, और धारणाओं का परीक्षण करने के लिए अपनाया जाता है। इस तकनीक में स्कैटर प्लॉट, हिस्टोग्राम, और बॉक्स प्लॉट जैसे दृश्य तरीकों का उपयोग होता है।
आप हमारे पाठ्यक्रम के साथ अन्वेषणात्मक डेटा विश्लेषण के बारे में अधिक जान सकते हैं, जिसमें Python का उपयोग कर डेटा का अन्वेषण, दृश्यांकन, और अंतर्दृष्टियाँ निकालना शामिल है।
प्रतिगमन विश्लेषण एक सांख्यिकीय पद्धति है जिसका उपयोग आश्रित चर और एक या अधिक स्वतंत्र चर के बीच संबंध समझने के लिए किया जाता है। इसे सामान्यतः पूर्वानुमान, टाइम सीरीज़ मॉडलिंग, और चरों के बीच कारण प्रभाव संबंधों को ढूँढने के लिए इस्तेमाल किया जाता है।
हमारे पास सरल रैखिक प्रतिगमन जैसे सहायक ट्यूटोरियल हैं, साथ ही प्रौद्योगिकी-विशिष्ट मार्गदर्शिकाएँ: Essentials of Linear Regression in Python और How to Do Linear Regression in R. रैखिक प्रतिगमन को विस्तार से जानना उपयोगी है क्योंकि यह संबंध समझने और पूर्वानुमान लगाने की सबसे व्यापक रूप से प्रयुक्त तकनीकों में से एक है।

लिनियर और लॉजिस्टिक रिग्रेशन
फैक्टर विश्लेषण एक तकनीक है जो बड़ी संख्या में चरों को कम फैक्टर्स में संकुचित करती है। फैक्टर्स इस प्रकार निर्मित किए जाते हैं कि वे मूल चरों से अधिकतम संभव जानकारी को समाहित करें। इसका उपयोग अक्सर मार्केट रिसर्च, ग्राहक विभाजन, और इमेज रिकग्निशन में होता है।
हमारे पाठ्यक्रम के साथ R में फैक्टर विश्लेषण के बारे में और जानें, जो एक्सप्लोरेटरी और कन्फर्मेटरी फैक्टर विश्लेषण के माध्यम से व्यक्तित्व जैसे गुप्त चरों का अन्वेषण करता है।
मोंटे कार्लो सिमुलेशन एक तकनीक है जो प्रायिकता वितरणों और यादृच्छिक सैंपलिंग का उपयोग करके संख्यात्मक परिणामों का अनुमान लगाती है। इसका उपयोग अक्सर उच्च अनिश्चितता वाले जोखिम विश्लेषण और निर्णय लेने में किया जाता है।
हमारे पास R में मोंटे कार्लो विधियों पर ट्यूटोरियल है, साथ ही Python में मोंटे कार्लो सिमुलेशन पर पाठ्यक्रम है, जो अनिश्चित घटनाओं के लिए संभावित परिणामों की रेंज का अनुमान लगा सकता है।

मोंटे कार्लो सिमुलेशन का उदाहरण
क्लस्टर विश्लेषण ऐसी तकनीक है जिसमें वस्तुओं के समूह इस प्रकार बनाए जाते हैं कि एक ही समूह (क्लस्टर) की वस्तुएँ आपस में अन्य समूहों की तुलना में अधिक समान हों। इसका उपयोग अक्सर मार्केट सेगमेंटेशन, इमेज सेगमेंटेशन, और रिकमेंडेशन सिस्टम्स में किया जाता है।
आप हमारे Cluster Analysis in R पाठ्यक्रम में हायरार्किकल क्लस्टरिंग और k-means क्लस्टरिंग सहित कई तकनीकों का अन्वेषण कर सकते हैं।
कोहोर्ट विश्लेषण व्यवहारिक एनालिटिक्स का एक उपसमुच्चय है, जो किसी डेटासेट से डेटा लेकर उसे विश्लेषण के लिए संबंधित समूहों में बाँटता है। ये संबंधित समूह, या कोहोर्ट्स, आम तौर पर परिभाषित समयावधि में सामान्य विशेषताएँ साझा करते हैं। इसका उपयोग अक्सर मार्केटिंग, यूज़र एंगेजमेंट, और ग्राहक जीवनचक्र विश्लेषण में किया जाता है।
हमारा Customer Segmentation in Python पाठ्यक्रम कोहोर्ट विश्लेषण सहित ग्राहक डेटा के विभाजन और विश्लेषण के लिए कई तकनीकों की पड़ताल करता है।

कोहोर्ट विश्लेषण का उदाहरण दिखाता ग्राफ
टाइम सीरीज़ विश्लेषण एक सांख्यिकीय तकनीक है जो समय-श्रृंखला डेटा या ट्रेंड विश्लेषण से संबंधित है। इसका उपयोग डेटा बिंदुओं के अनुक्रम का विश्लेषण करके सार्थक आँकड़े और अन्य विशेषताएँ निकालने में होता है। इसका उपयोग अक्सर बिक्री, आर्थिक, और मौसम पूर्वानुमान में होता है।
हमारा Time Series with Python स्किल ट्रैक और Forecasting in R पाठ्यक्रम विभिन्न लाइब्रेरीज़ के साथ टाइम सीरीज़ डेटा को संसाधित और विश्लेषित करना सिखाते हैं।
सेंटिमेंट विश्लेषण, जिसे ओपिनियन माइनिंग भी कहा जाता है, प्राकृतिक भाषा प्रक्रमण, टेक्स्ट विश्लेषण, और कंप्यूटेशनल लिंग्विस्टिक्स का उपयोग करके स्रोत सामग्री से व्यक्तिपरक जानकारी की पहचान और निष्कर्षण करता है। इसका उपयोग अक्सर सोशल मीडिया मॉनिटरिंग, ब्रांड मॉनिटरिंग, और ग्राहक फीडबैक समझने में होता है।
Python में सेंटिमेंट विश्लेषण से परिचित होने के लिए, आप हमारा ऑनलाइन पाठ्यक्रम ले सकते हैं, जो एंड-टू-एंड सेंटिमेंट विश्लेषण करना सिखाता है।
2026 में, AutoML डेटा पेशेवरों के लिए एक मानक "कोपायलट" बन चुका है। यह एल्गोरिद्म चयन और हाइपरपैरामीटर ट्यूनिंग जैसी समय-साध्य प्रक्रियाओं का स्वचालन करता है। विश्लेषक अब तेज़ी से उच्च-गुणवत्ता वाले बेसलाइन मॉडेल बनाते हैं और अपना मैनुअल प्रयास फीचर इंजीनियरिंग और रणनीतिक परिष्करण पर केंद्रित करते हैं।
आधुनिक विश्लेषण स्प्रेडशीट्स से बहुत आगे तक जाता है। इस तकनीक में डीप लर्निंग और कंप्यूटर विज़न का उपयोग करके छवियों, वीडियो फ़ीड्स, और ऑडियो रिकॉर्डिंग जैसे गैर-टैबुलर डेटा से अंतर्दृष्टियाँ निकालना शामिल है। यह वीडियो सामग्री में ब्रांड मॉनिटरिंग या मेडिकल इमेजिंग डायग्नोसिस जैसे कार्यों के लिए आवश्यक है।
जेनरेटिव AI और बड़े भाषा मॉडल (LLMs) 2026 में विश्लेषकों के डेटा से संवाद करने के तरीकों को बदल रहे हैं। विश्लेषक नियमित रूप से AI असिस्टेंट्स का उपयोग प्राकृतिक भाषा प्रॉम्प्ट से SQL क्वेरी लिखने, डेटा ट्रांसफ़ॉर्मेशन के लिए Python कोड जनरेट करने, और स्वतः विज़ुअलाइज़ेशन बनाने के लिए करते हैं। Power BI, Tableau, और Databricks में प्लेटफ़ॉर्म-नेटिव AI कोपायलट्स विश्लेषकों को बायलरप्लेट कोड लिखने के बजाय परिणामों की व्याख्या और रणनीतिक निर्णयों पर ध्यान केंद्रित करने देते हैं।
हालाँकि, विश्लेषण में AI का जिम्मेदार उपयोग सभी AI-जनित आउटपुट का सत्यापन, अंतर्निहित कार्यप्रणाली की समझ, और डेटा गवर्नेंस प्रथाओं को बनाए रखने की माँग करता है। AI कार्यप्रवाह को तेज़ करता है, परंतु विश्लेषक के निर्णय और डोमेन विशेषज्ञता का विकल्प नहीं है।
डेटा विश्लेषण कार्यप्रवाह में AI का उपयोग कैसे करें, इस पर सर्वोत्तम प्रथाएँ सीखने के लिए हमारे मार्गदर्शक Using ChatGPT for Data Science Projects और Prompt Engineering ज़रूर देखें।
डेटा विश्लेषण के क्षेत्र में, अलग-अलग आवश्यकताओं, जटिलताओं, और विशेषज्ञता स्तरों के अनुरूप कई टूल्स उपलब्ध हैं। इनमें Python और R जैसी प्रोग्रामिंग भाषाओं से लेकर Power BI और Tableau जैसे दृश्यांकन सॉफ़्टवेयर शामिल हैं। आइए इन टूल्स पर थोड़ा नज़दीक से नज़र डालें।
| टूल | श्रेणी | सर्वश्रेष्ठ उपयोग | कौशल स्तर |
|---|---|---|---|
| Python | प्रोग्रामिंग | कस्टम विश्लेषण, मशीन लर्निंग, स्वचालन | मध्यम |
| R | प्रोग्रामिंग | सांख्यिकीय कंप्यूटिंग, अकादमिक अनुसंधान | मध्यम |
| SQL | क्वेरी भाषा | डेटाबेस क्वेरी करना, डेटा निष्कर्षण | शुरुआती |
| Power BI | BI & दृश्यांकन | बिज़नेस डैशबोर्ड, Microsoft ईकोसिस्टम | शुरुआती |
| Tableau | BI & दृश्यांकन | उन्नत दृश्यांकन, बड़े डेटासेट्स | शुरुआती |
| Excel | स्प्रेडशीट | त्वरित विश्लेषण, ऐड-हॉक रिपोर्टिंग, प्रोटोटाइपिंग | शुरुआती |
लोकप्रिय डेटा विश्लेषण टूल्स की तुलना
Python एक उच्च-स्तरीय, सामान्य-उद्देश्य प्रोग्रामिंग भाषा है जो डेटा विश्लेषकों और डेटा वैज्ञानिकों के बीच बेहद लोकप्रिय है। इसकी सरलता और पठनीयता, साथ में pandas, NumPy, Matplotlib, और Polars जैसी व्यापक लाइब्रेरीज़, इसे डेटा विश्लेषण और दृश्यांकन के लिए उत्कृष्ट बनाती हैं। आधुनिक Python वर्कफ़्लो अब AI Coding Assistants पर बायलरप्लेट कोड जनरेट करने और जटिल स्क्रिप्ट्स को तुरंत डीबग करने के लिए बड़े पैमाने पर निर्भर करते हैं।
R एक प्रोग्रामिंग भाषा और मुक्त सॉफ़्टवेयर परिवेश है जिसे विशेष रूप से सांख्यिकीय कंप्यूटिंग और ग्राफ़िक्स के लिए डिज़ाइन किया गया है। यह सांख्यिकीविदों और डेटा माइनर्स के बीच सांख्यिकीय सॉफ़्टवेयर और डेटा विश्लेषण विकसित करने के लिए व्यापक रूप से प्रयुक्त है। R रैखिक और गैर-रैखिक मॉडलिंग, पारंपरिक सांख्यिकीय परीक्षण, टाइम-सीरीज़ विश्लेषण, आदि सहित सांख्यिकीय और ग्राफ़िकल तकनीकों की व्यापक रेंज प्रदान करता है।
SQL (Structured Query Language) डेटाबेस प्रबंधन और हेरफेर के लिए एक मानक भाषा है। इसका उपयोग रिलेशनल डेटाबेस में संग्रहीत डेटा को प्राप्त करने और संशोधित करने के लिए किया जाता है। डेटाबेस के भीतर डेटा प्रबंधन या हेरफेर से जुड़े कार्यों के लिए SQL आवश्यक है।
Power BI एक बिज़नेस एनालिटिक्स टूल है जिसे Microsoft ने विकसित किया है। यह स्व-सेवा बिज़नेस इंटेलिजेंस क्षमताओं के साथ इंटरैक्टिव दृश्यांकन प्रदान करता है। Power BI आसानी से समझ आने वाले डैशबोर्ड और रिपोर्ट्स के माध्यम से कच्चे डेटा को सार्थक अंतर्दृष्टियों में बदलता है।
Tableau बिज़नेस इंटेलिजेंस उद्योग में प्रयुक्त एक शक्तिशाली डेटा दृश्यांकन टूल है। यह आपको इंटरैक्टिव और साझा करने योग्य डैशबोर्ड बनाने देता है, जो चार्ट्स और ग्राफ़्स के रूप में डेटा के रुझान, विविधताएँ, और घनत्व दर्शाते हैं।
Microsoft Excel डेटा विश्लेषण के लिए सबसे व्यापक रूप से प्रयुक्त टूल्स में से एक है। यह डेटा हेरफेर, सांख्यिकीय विश्लेषण, और दृश्यांकन के लिए कई सुविधाएँ प्रदान करता है। Excel की सरलता और बहुमुखी प्रतिभा इसे सरल से जटिल तक सभी प्रकार के डेटा विश्लेषण कार्यों के लिए उपयुक्त बनाती है।
डेटा विश्लेषण, चाहे छोटे या बड़े पैमाने पर, व्यवसाय के प्रदर्शन पर गहरा प्रभाव डाल सकता है। यह महत्वपूर्ण बदलाव ला सकता है—दक्षता में सुधार, लाभप्रदता में वृद्धि, और बाज़ार रुझानों व ग्राहक व्यवहार की गहरी समझ।
डेटा विश्लेषण व्यवसायों को अनुमान या अंतर्ज्ञान पर निर्भर रहने के बजाय तथ्यों, आँकड़ों, और रुझानों के आधार पर निर्णय लेने में सक्षम बनाता है। यह रणनीतिक योजना और नीतिनिर्माण के लिए ठोस आधार प्रदान करता है, जिससे संसाधनों का प्रभावी आवंटन सुनिश्चित होता है और प्रयास उन क्षेत्रों में केंद्रित होते हैं जहाँ अधिकतम लाभ संभव है।
छोटे व्यवसायों के लिए, साधारण डेटा विश्लेषण भी महत्वपूर्ण सुधार ला सकता है। उदाहरण के लिए, बिक्री डेटा का विश्लेषण यह पहचानने में मदद कर सकता है कि कौन-से उत्पाद अच्छा प्रदर्शन कर रहे हैं और कौन-से नहीं। इसके आधार पर विपणन रणनीतियाँ, मूल्य निर्धारण, और इन्वेंट्री प्रबंधन समायोजित किए जा सकते हैं, जिससे बिक्री और लाभप्रदता बढ़ सकती है।
बड़े व्यवसायों के लिए, डेटा विश्लेषण का प्रभाव और भी गहरा हो सकता है। बिग डेटा विश्लेषण जटिल पैटर्न और रुझानों का खुलासा कर सकता है, जिन्हें अन्यथा पहचानना असंभव होता। इससे क्रांतिकारी अंतर्दृष्टियाँ मिल सकती हैं, नवाचार को बढ़ावा मिलता है, और प्रतिस्पर्धात्मक बढ़त मिलती है।
उदाहरण के लिए, कोई बड़ा रिटेलर अपनी आपूर्ति शृंखला को अनुकूलित करने के लिए डेटा विश्लेषण का उपयोग कर सकता है, जिससे लागत घटती है और दक्षता बढ़ती है। या कोई टेक कंपनी उपयोगकर्ता व्यवहार समझने के लिए डेटा विश्लेषण का उपयोग कर सकती है, जिससे उत्पाद डिज़ाइन में सुधार और बेहतर यूज़र एंगेजमेंट संभव होता है।
आज की डेटा-संचालित दुनिया में, डेटा का विश्लेषण और व्याख्या करने की क्षमता एक अनिवार्य कौशल है। जो व्यवसाय डेटा विश्लेषण की शक्ति का उपयोग कर पाते हैं, वे बदलती बाज़ार परिस्थितियों के अनुरूप ढलने, ग्राहक आवश्यकताओं को पूरा करने, और विकास व लाभप्रदता को आगे बढ़ाने के लिए बेहतर स्थिति में होते हैं।
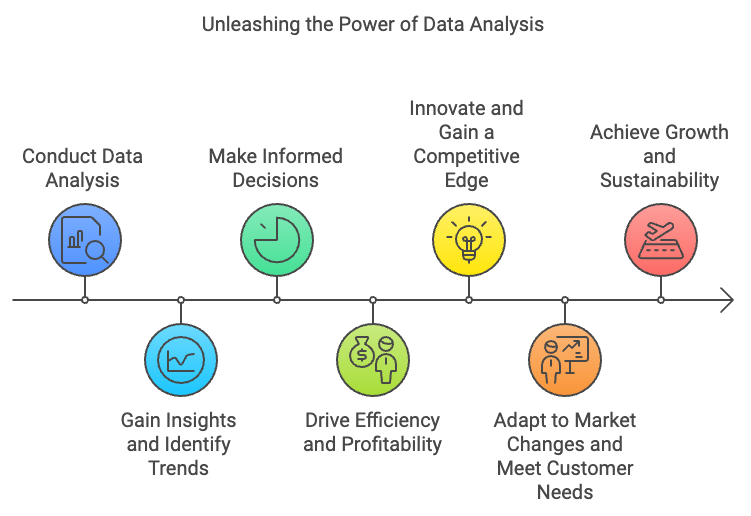
Napkin.AI का उपयोग करके निर्मित
डेटा विश्लेषण में सफल होने के लिए आपको ज्ञान की मजबूत नींव बनानी होगी, व्यावहारिक कौशलों को निखारना होगा, और मूल्यवान अनुभव जुटाना होगा। सांख्यिकी, गणित, और प्रोग्रामिंग से शुरुआत करें और वास्तविक-जीवन परियोजनाएँ करें। इसके बाद डोमेन विशेषज्ञता हासिल करें और क्षेत्र के पेशेवरों से जुड़ें। विशेषज्ञता, कौशल, और अनुभव का संयोजन एक सफल डेटा विश्लेषण करियर बनाता है।
Richie Cotton, Data Evangelist at DataCamp
शीर्ष डेटा विश्लेषण पाठ्यक्रम
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}