
कोर्स
Python परिचय
4 घंटा
7.1M
डेटा विश्लेषण में हिस्टोग्राम का उपयोग अक्सर किसी डेटा सेट के वितरण को ग्राफ़िक रूप से दर्शाने के लिए किया जाता है। यह हमें दिखाता है कि डेटा विभिन्न मानों में कैसे फैला है, जिससे पैटर्न, रुझान, और विसंगतियाँ पहचानने में मदद मिलती है।
यह लेख फ्रीक्वेंसी हिस्टोग्राम का परिचय देता है और आपको चरण-दर-चरण एक हिस्टोग्राम बनाना सिखाता है। हम हिस्टोग्राम के विभिन्न प्रकारों, उन्हें बनाने की लोकप्रिय तकनीकों, सामान्य गलतियों से बचने के तरीकों, और पालन करने योग्य सर्वोत्तम प्रथाओं के बारे में भी जानेंगे।
फ्रीक्वेंसी हिस्टोग्राम किसी डेटा सेट के वितरण का ग्राफ़िक प्रतिनिधित्व है। एक हिस्टोग्राम बिन्स की श्रृंखला से बनता है—यानी ऐसे अंतराल जो डेटा की रेंज को कवर करते हैं। हर बिन की एक फ्रीक्वेंसी होती है, अर्थात उस अंतराल में आने वाले डेटा बिंदुओं की संख्या। बिन्स क्षैतिज अक्ष पर और फ्रीक्वेंसी लंबवत अक्ष पर प्लॉट की जाती हैं, जिससे चार्ट बार जैसा प्रतिनिधित्व बनता है। प्रत्येक बार की ऊँचाई उस बिन में डेटा बिंदुओं की फ्रीक्वेंसी दर्शाती है।
हिस्टोग्राम लोकप्रिय हैं क्योंकि वे डेटा विश्लेषण में कई महत्वपूर्ण काम करते हैं:
अब जब हमने फ्रीक्वेंसी हिस्टोग्राम और डेटा एनालिटिक्स में उनके उद्देश्य को समझ लिया है, तो एक उदाहरण के जरिए इन्हें बनाना सीखते हैं।
मान लें कि आप एक डेटा विश्लेषक हैं और आपको पिछले महीने के दौरान एक रिटेल स्टोर की दैनिक बिक्री डेटा का विश्लेषण करने का कार्य सौंपा गया है।
आपका लक्ष्य दैनिक बिक्री के वितरण को समझना है ताकि पैटर्न पहचाने जा सकें, प्रदर्शन का आकलन हो, और इन्वेंट्री प्रबंधन व बिक्री रणनीतियों के लिए इनसाइट्स दिए जा सकें। विश्लेषण के हिस्से के रूप में, आपने तय किया कि एक हिस्टोग्राम से उपयोगी इनसाइट्स निकाली जा सकती हैं।
अपना फ्रीक्वेंसी हिस्टोग्राम बनाने के लिए आप ये कदम अपना सकते हैं:
मान लें आपने अपनी संस्था की डेटा टीम से जुड़कर बिक्री डेटाबेस से डेटा निकाला। आपने डेटा को नीचे दिखाए अनुसार सारणीबद्ध प्रारूप में व्यवस्थित किया है:
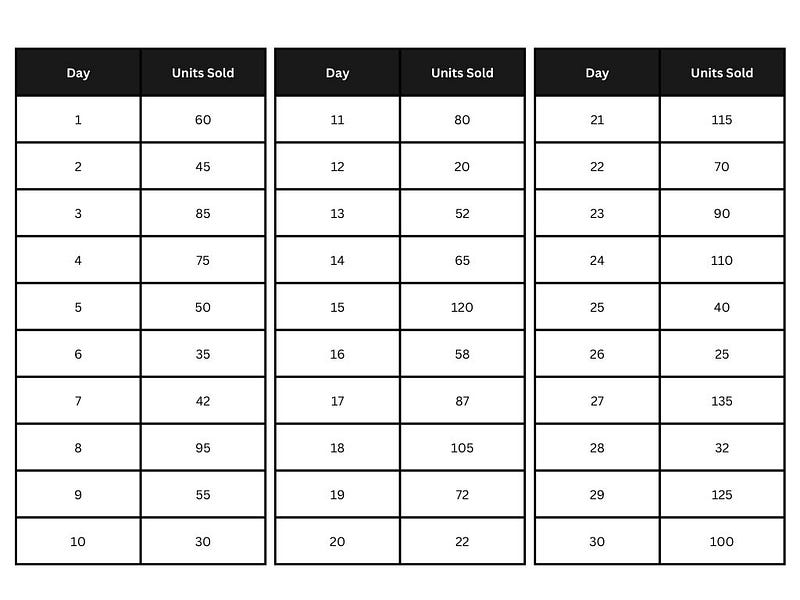 बिक्री डेटा सेट। चित्र: लेखक।
इसके बाद, डेटा की रेंज और वितरण के आधार पर उपयुक्त बिन्स चुनें।
डेटा का विश्लेषण करने पर आप देखते हैं कि सबसे छोटी मान 20 है, सबसे बड़ी 135, और कुल 30 ऑब्जर्वेशन हैं। स्क्वेयर रूट नियम (इसके बारे में आगे और जानेंगे) के अनुसार, √30 ≈ 5.5, यानी आप छह बिन्स ले सकते हैं। हमें 115 की रेंज को छह बिन्स में बाँटना होगा, जिससे लगभग 19 यूनिट का बिन-चौड़ाई आती है।
सरलता के लिए, 20 यूनिट चौड़ाई वाले बिन्स लें:
हर अंतराल में आने वाले ऑब्जर्वेशन्स की संख्या गिनें और उन्हें नीचे दिखाए अनुसार सारणीबद्ध करें:
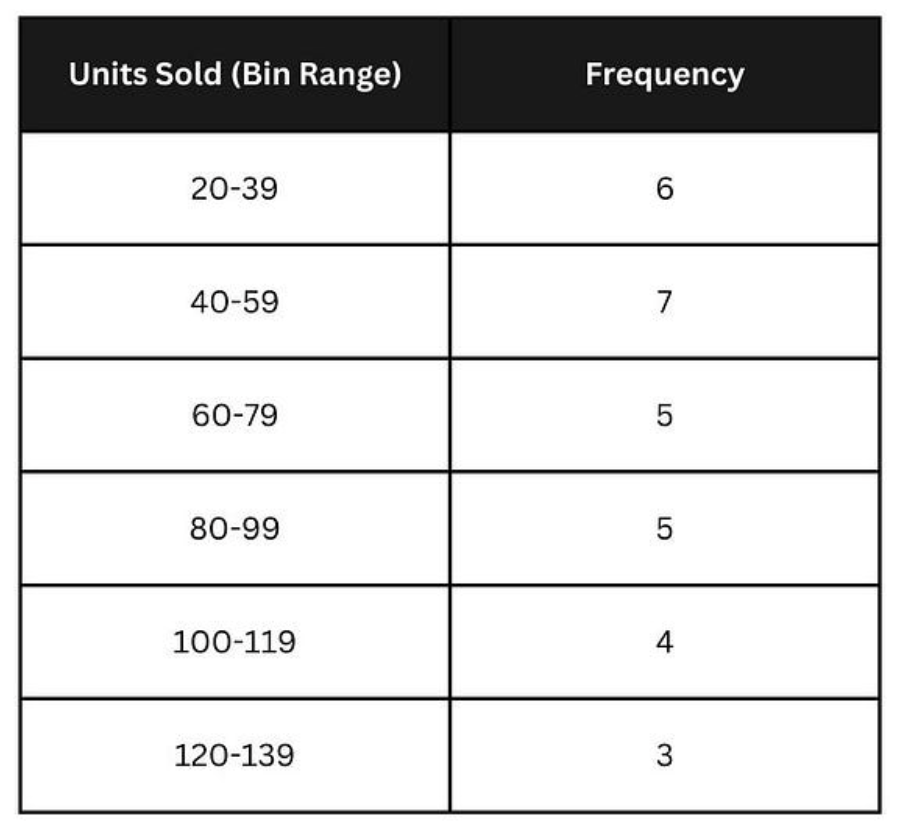
प्रत्येक बिन में फ्रीक्वेंसी की गणना। चित्र: लेखक।
बिन्स के लिए क्षैतिज रेखा (x-अक्ष) और फ्रीक्वेंसी के लिए लंबवत रेखा (y-अक्ष) खींचें। हर बिन के लिए उसकी फ्रीक्वेंसी के अनुरूप ऊँचाई वाला एक बार बनाएं।
आपका हिस्टोग्राम कुछ ऐसा दिखना चाहिए:
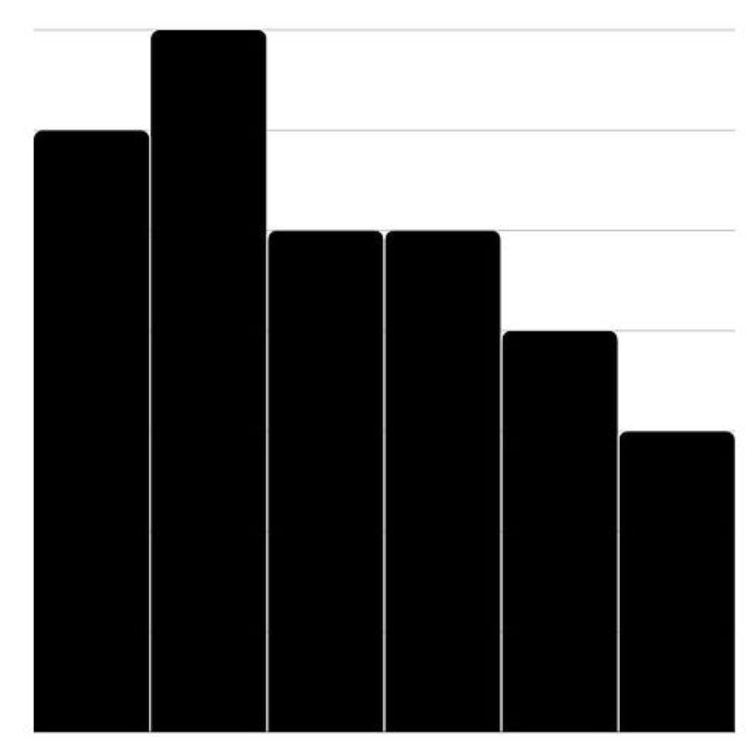 हिस्टोग्राम प्लॉट करना। चित्र: लेखक।
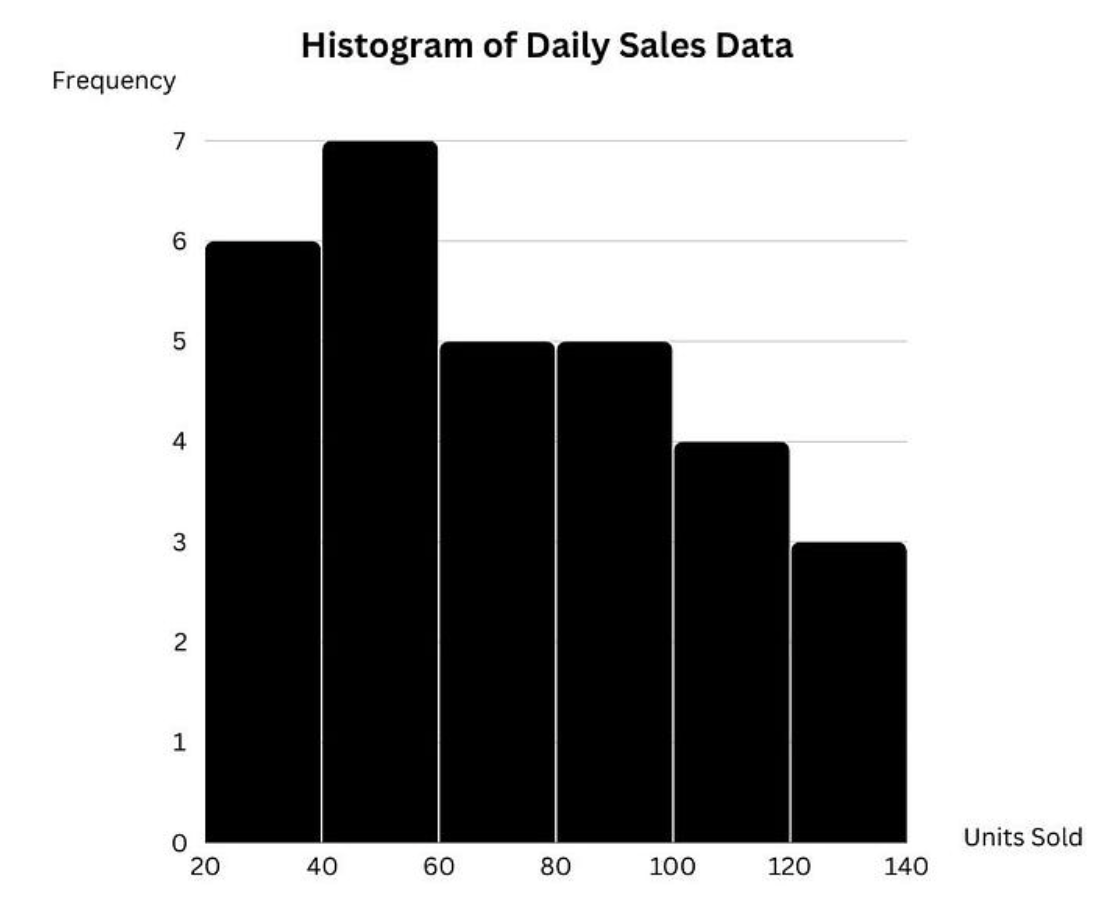
x-अक्ष को “Units Sold” और y-अक्ष को “Frequency” से लेबल करें। “Histogram of Daily Sales Data” जैसा शीर्षक दें। स्पष्ट विज़ुअलाइज़ेशन के लिए बार्स को समान दूरी पर और अलग-अलग रखें।
पूर्ण आरेख ऐसा दिखना चाहिए:
हिस्टोग्राम की लेबलिंग और फ़ॉर्मेटिंग। चित्र: लेखक।
बस इतना ही! आपने अपने विश्लेषण के लिए फ्रीक्वेंसी हिस्टोग्राम बना लिया है।
फ्रीक्वेंसी हिस्टोग्राम के अलग-अलग प्रकार होते हैं, जिनमें डेटा को दर्शाने के तरीके में हल्के भिन्नता होती है।
इन भिन्न रूपों से आप अपनी विश्लेषण परियोजनाओं में अलग-अलग परिस्थितियों के अनुसार नए इनसाइट्स निकाल सकते हैं; इसलिए इन प्रकारों का ज्ञान उपयोगी है।
हालाँकि हमने ऊपर हिस्टोग्राम मैन्युअल रूप से बनाना सीखा, आप विभिन्न टूल्स और तकनीकों से भी ऐसा कर सकते हैं, जिनकी विशेषताएँ और क्षमताएँ अलग-अलग होती हैं।
हिस्टोग्राम बनाने के लिए कुछ लोकप्रिय तकनीकें ये हैं:
बेशक, यह सूची संपूर्ण नहीं है; हिस्टोग्राम बनाने के लिए कई अन्य ऑनलाइन टूल्स भी उपलब्ध हैं। अपनी विश्लेषण परियोजना की जरूरतों के अनुसार उपयुक्त टूल अपनाने के लिए उन्हें बेझिझक आज़माएँ।
क्योंकि हिस्टोग्राम को अक्सर बुनियादी विश्लेषण आरेख माना जाता है, हम उन्हें औपचारिक रूप से नहीं सीखते—और यही उन्हें बनाते समय गलतियों का कारण बनता है। यहाँ कुछ सामान्य गलतियाँ और उनसे बचने की सर्वोत्तम प्रथाएँ दी गई हैं:
अनुचित बिन-चौड़ाई चुनना हिस्टोग्राम की रूप-रेखा और सटीकता पर बड़ा असर डाल सकता है।
बहुत चौड़े बिन्स बहुत सारे डेटा बिंदुओं को एक साथ समेट देते हैं, जिससे महत्वपूर्ण पैटर्न और विविधताएँ छिप सकती हैं। इस स्थिति में वितरण की बारीकियाँ और सूक्ष्म अंतर देखना कठिन हो जाता है।
दूसरी ओर, बहुत संकरे बिन्स का मतलब है कि हर बिन बहुत छोटी रेंज कवर करता है, जिससे कई बिन्स में बहुत कम डेटा बिंदु आ सकते हैं। यह स्तर का विवरण अनावश्यक हो सकता है और दर्शक को अत्यधिक जानकारी से अभिभूत कर सकता है, जिससे सार्थक पैटर्न या रुझान ढूँढना मुश्किल हो जाता है।
असंगत बिन आकार भ्रामक विज़ुअलाइज़ेशन देंगे और हिस्टोग्राम की व्याख्या कठिन बना देंगे।
सबसे पहले, सुनिश्चित करें कि आपके हिस्टोग्राम के सभी बिन्स की चौड़ाई समान हो। यह सुसंगति विभिन्न अंतरालों में फ्रीक्वेंसी की तुलना को सीधा बनाती है।
उपयुक्त बिन-चौड़ाई (और बिन्स की संख्या) निर्धारित करने के लिए कई दिशानिर्देश मददगार हो सकते हैं:
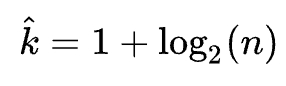 Sturges का नियम। स्रोत: Wikipedia
व्यवहार में, सर्वोत्तम बिन-चौड़ाई पुनरावृत्त समायोजन से मिलती है। किसी दिशानिर्देश-आधारित बिन-चौड़ाई से शुरू करें और फिर स्पष्टता और सूचनात्मकता के आधार पर ऊपर-नीचे समायोजित करें।
एक सामान्य गलती यह है कि ध्यान सिर्फ आरेख पर रहे और लेबल तथा स्केल पर नहीं।
यदि अक्षों को गलत या अपर्याप्त रूप से लेबल किया गया है, तो दर्शक नहीं समझ पाएँगे कि हिस्टोग्राम क्या दर्शाता है।
एकाधिक हिस्टोग्राम्स की तुलना करते समय y-अक्ष पर असंगत स्केल तुलना को विकृत कर सकता है। मान लें एक हिस्टोग्राम का y-अक्ष 0 से 100 तक है और दूसरे का 0 से 50 तक; तब बार की ऊँचाइयाँ सीधे तुलनीय नहीं होंगी। यह असंगति दर्शकों को ऐसी महत्वपूर्ण भिन्नता या समानता का आभास दे सकती है जो वास्तव में मौजूद नहीं है।
एक ही हिस्टोग्राम के भीतर असंगत स्केलिंग भी डेटा का गलत प्रतिनिधित्व कर सकती है। यदि y-अक्ष शून्य के अलावा किसी और संख्या से शुरू होता है या अनियमित अंतराल उपयोग करता है, तो यह बिन फ्रीक्वेंसी के बीच के अंतर को बढ़ा-चढ़ाकर या कम करके दिखा सकता है, जिससे गलत निष्कर्ष निकल सकते हैं।
हमेशा x-अक्ष और y-अक्ष को स्पष्ट और सटीक रूप से लेबल करें। हर अक्ष क्या दर्शाता है, यह बताएं और जहाँ लागू हो, माप की इकाइयाँ शामिल करें। हिस्टोग्राम के लिए संदर्भ देने वाला एक वर्णनात्मक शीर्षक जोड़ें।
खासकर कई हिस्टोग्राम्स की तुलना करते समय y-अक्ष के लिए एकसमान स्केल का उपयोग करें। इससे बार की ऊँचाई फ्रीक्वेंसी या रिलेटिव फ्रीक्वेंसी को सही ढंग से दर्शाती है और सार्थक तुलना संभव होती है। डेटा वितरण का सही प्रतिनिधित्व देने के लिए y-अक्ष शून्य से शुरू होना चाहिए। यदि व्यावहारिक रूप से शून्य से शुरू करना संभव न हो, तो प्रारंभिक बिंदु स्पष्ट रूप से बताएँ और समान अंतराल रखें।
आउटलायर वे डेटा बिंदु होते हैं जो मुख्य डेटा समूह से काफी बाहर होते हैं और वितरण के आकार को प्रभावित करते हैं। एक सामान्य गलती उन्हें बस निकाल देना और अनदेखा करना है।
उन्हें हटा देने से वितरण की वास्तविक प्रकृति छिप सकती है, जैसे लंबी टेल या असममिति (स्क्यूनेस) की मौजूदगी। उदाहरण के लिए, कुछ अत्यधिक उच्च मान वाला डेटा सेट आउटलायर सहित स्क्यूड दिख सकता है, लेकिन उन्हें हटाने पर अधिक सममित लगेगा।
कभी-कभी आउटलायर महत्वपूर्ण घटनाओं या इनसाइट्स का प्रतिनिधित्व करते हैं। जैसे, बिक्री डेटा में कोई आउटलायर असामान्य रूप से बड़ी खरीदारी हो सकती है, जो सफल मार्केटिंग अभियान या थोक ऑर्डर का संकेत हो सकता है। ऐसे बिंदुओं को नज़रअंदाज़ करना मूल्यवान जानकारी खो सकता है।
डेटा वितरण का समग्र दृश्य देने के लिए हिस्टोग्राम में आउटलायर शामिल करें। y-अक्ष का स्केल इस तरह रखें कि ये आउटलायर समा जाएँ और मुख्य डेटा अत्यधिक संकुचित न हो।
यदि विशिष्ट कारणों (जैसे त्रुटियाँ, अप्रासंगिक चरम मान) से आउटलायर हटाए गए हों, तो साथ के पाठ या लेजेंड में स्पष्ट रूप से समझाएँ। इससे पारदर्शिता बनी रहती है और दर्शक हटाने के तर्क को समझ पाते हैं।
इन सर्वोत्तम प्रथाओं का पालन करने से आपका हिस्टोग्राम इच्छित इनसाइट्स संप्रेषित करेगा और आगे की डेटा एनालिटिक्स में सहायक होगा।
इस लेख में आपने फ्रीक्वेंसी हिस्टोग्राम, उनके विभिन्न प्रकार, और डेटा एनालिटिक्स में उनकी अहमियत जानी। हिस्टोग्राम्स को मैन्युअल रूप से बनाने के बाद, हमने कुछ लोकप्रिय टूल्स और तकनीकों की सूची दी जिनसे आप हिस्टोग्राम बना सकते हैं। हमने बचने योग्य सामान्य गलतियाँ और अपनाने योग्य सर्वोत्तम प्रथाएँ भी सीखी।
हम आपको प्रोत्साहित करते हैं कि कई डेटा सेट्स पर हिस्टोग्राम बनाएँ और उनकी व्याख्या करें, ताकि दक्षता विकसित हो। अभ्यास और परिणामों का विश्लेषण आपको डेटा एनालिटिक्स में निपुण बनने में मदद करेगा।
सीखते रहिए!
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स