Last chance! 50% off DataCamp Premium
Sale ends in
Histogram umum digunakan dalam analisis data untuk merepresentasikan distribusi suatu himpunan data secara grafis. Ini memungkinkan kita memvisualisasikan bagaimana data tersebar di berbagai nilai, membantu mengungkap pola, tren, dan anomali.
Artikel ini memperkenalkan histogram frekuensi dan membantu Anda membuatnya selangkah demi selangkah. Kita juga akan mempelajari berbagai jenis histogram, beberapa teknologi populer untuk membuatnya, kesalahan umum yang perlu dihindari, dan praktik terbaik yang perlu diikuti.
Histogram frekuensi adalah representasi grafis dari distribusi suatu himpunan data. Histogram dibangun dari serangkaian bin, pada dasarnya interval yang mencakup rentang data. Setiap bin memiliki frekuensi, yaitu jumlah titik data dalam interval tersebut. Bin diplot pada sumbu horizontal, sedangkan frekuensi diplot pada sumbu vertikal, menghasilkan representasi mirip bagan batang. Tinggi setiap batang sesuai dengan frekuensi titik data dalam bin tersebut.
Histogram umum digunakan karena memiliki beberapa tujuan penting dalam analisis data:
Setelah memahami histogram frekuensi dan tujuannya dalam analitik data, mari kita pelajari cara membuatnya melalui sebuah contoh.
Pertimbangkan skenario di mana Anda, sebagai analis data, diminta menganalisis data penjualan harian sebuah toko ritel selama sebulan terakhir.
Tujuan Anda adalah memahami distribusi penjualan harian untuk mengidentifikasi pola, menilai kinerja, dan memberikan wawasan yang membantu pengelolaan inventaris serta strategi penjualan. Sebagai bagian dari analisis, Anda memutuskan histogram dapat membantu mendapatkan insight.
Berikut langkah-langkah yang dapat Anda ikuti untuk membuat histogram frekuensi:
Misalnya Anda terhubung dengan tim data di organisasi Anda dan mengambil data dari basis data penjualan organisasi. Anda telah menata data dalam format tabel seperti di bawah ini:
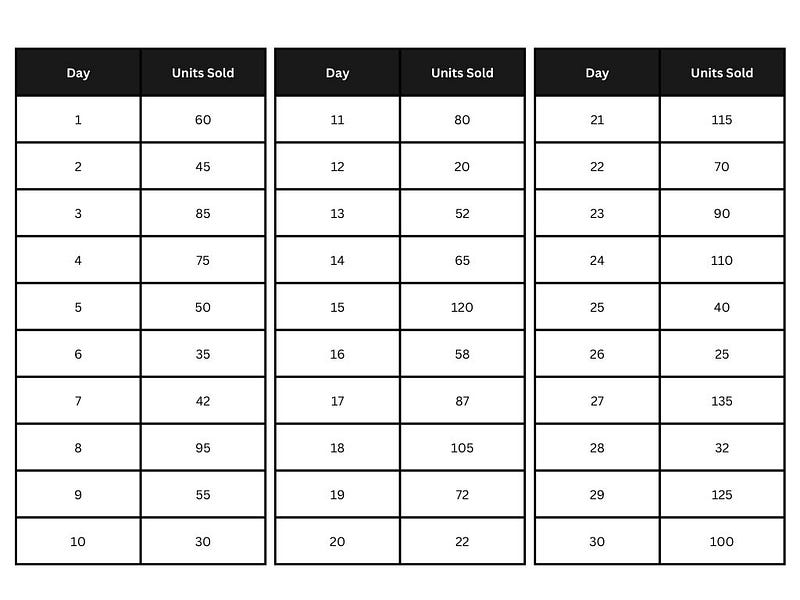 Dataset penjualan. Gambar oleh Penulis.
Selanjutnya, pilih bin yang sesuai berdasarkan rentang dan distribusi data.
Setelah menganalisis data, Anda menyadari nilai terkecil adalah 20, terbesar 135, dan Anda memiliki 30 observasi. Menggunakan aturan akar kuadrat (kita akan mempelajari topik ini nanti), √30 ≈ 5,5, Anda dapat menggunakan enam bin. Kita harus membagi rentang 115 menjadi enam bin, menghasilkan lebar bin sekitar 19 unit.
Untuk menyederhanakan, mari gunakan bin dengan lebar 20 unit:
Mari hitung jumlah observasi dalam setiap interval dan tabulasikan seperti di bawah ini:
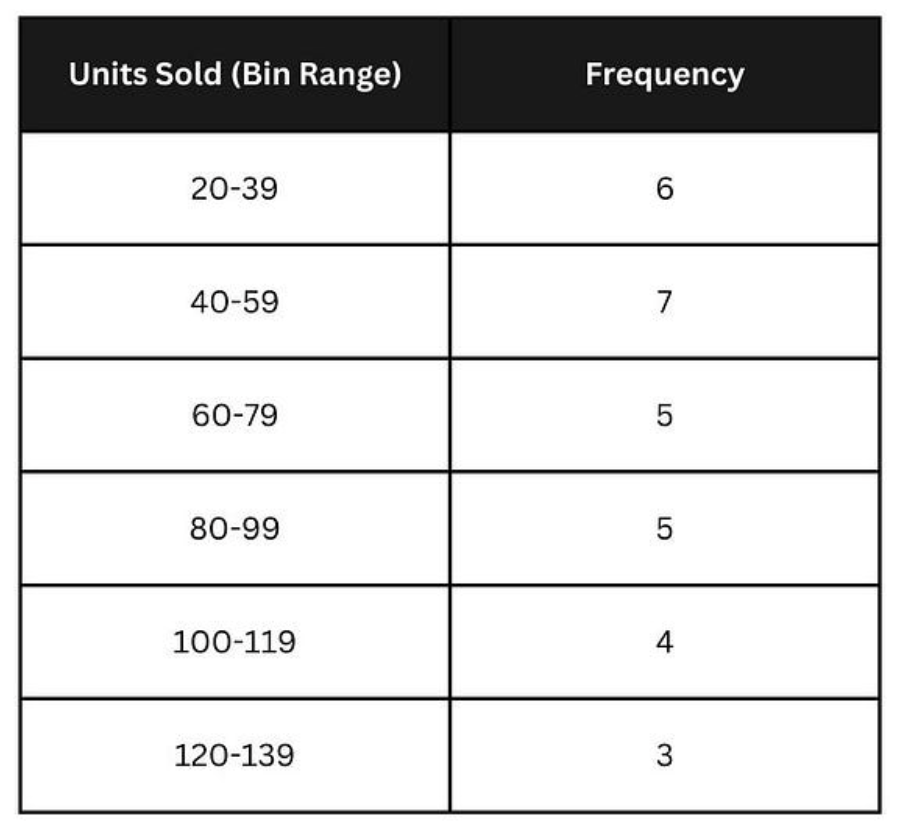
Menghitung frekuensi di setiap bin. Gambar oleh Penulis.
Gambarlah garis horizontal (sumbu-x) untuk bin dan garis vertikal (sumbu-y) untuk frekuensi. Untuk setiap bin, gambarlah batang dengan tinggi sesuai frekuensinya.
Histogram Anda akan terlihat seperti ini:
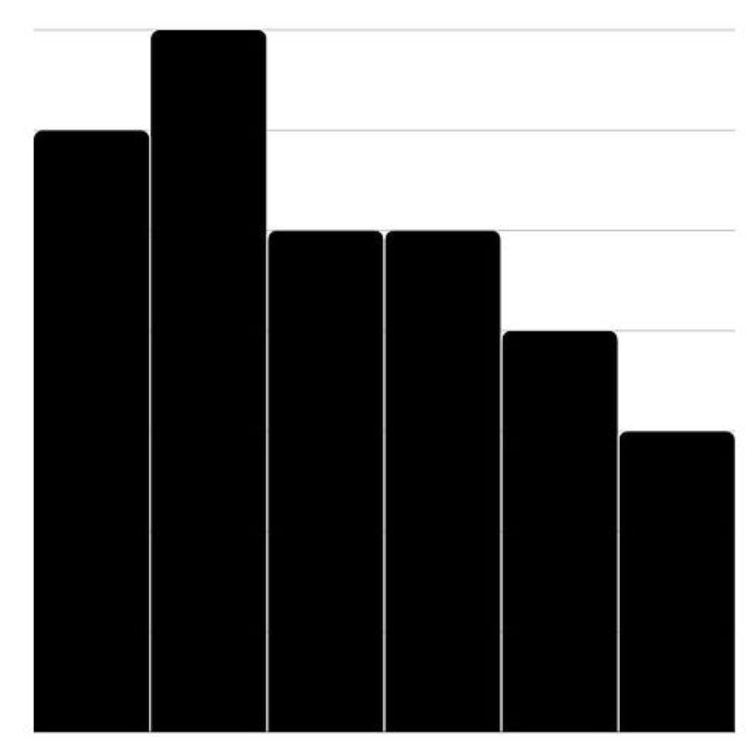 Memplot histogram. Gambar oleh Penulis.
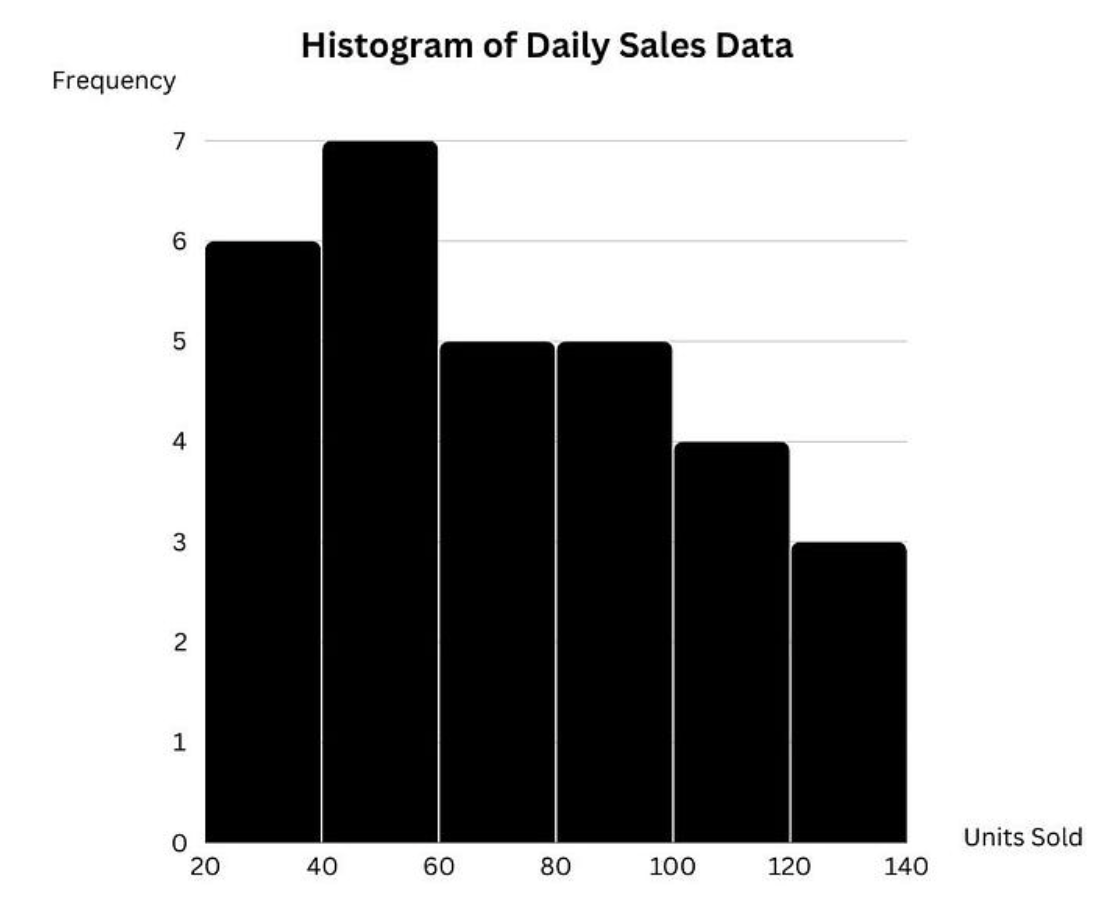
Beri label sumbu-x "Units Sold" dan sumbu-y "Frequency." Tambahkan judul seperti "Histogram of Daily Sales Data." Pastikan batang berjarak sama dan jelas terpisah untuk visualisasi yang jelas.
Diagram yang sudah selesai akan terlihat seperti ini:
Pemberian label dan pemformatan histogram. Gambar oleh Penulis.
Selesai! Anda telah membuat histogram frekuensi untuk analisis Anda.
Ada berbagai jenis histogram frekuensi, masing-masing menawarkan variasi kecil dalam cara data direpresentasikan.
Variasi histogram ini memungkinkan Anda menemukan wawasan yang berbeda tergantung pada skenario yang Anda temui dalam proyek analitik; oleh karena itu, mengetahui jenis-jenis ini ada dapat membantu.
Meskipun kita telah mempelajari cara membuat histogram secara manual di atas, Anda dapat melakukannya dengan berbagai alat dan teknologi, masing-masing dengan fitur dan kapabilitas berbeda.
Berikut beberapa teknologi populer untuk membuat histogram:
Tentu saja, daftar ini tidak lengkap, dan banyak alat online lain tersedia untuk membuat histogram. Silakan gunakan dan adopsi alat yang paling sesuai dengan kebutuhan proyek analitik Anda.
Karena histogram dianggap sebagai salah satu diagram analitik dasar, kita jarang mempelajarinya secara formal, yang sering kali menyebabkan kesalahan dalam pembuatannya. Berikut beberapa kesalahan umum dan praktik terbaik untuk menghindarinya:
Memilih lebar bin yang tidak tepat dapat berdampak signifikan pada tampilan dan ketepatan histogram.
Bin yang terlalu lebar dapat menyederhanakan data secara berlebihan dengan mengelompokkan terlalu banyak titik data, sehingga menutupi pola dan variasi penting dalam data. Ini menyulitkan untuk melihat detail dan nuansa yang lebih halus pada distribusi.
Di sisi lain, bin yang terlalu sempit berarti setiap bin mencakup rentang nilai data yang sangat kecil, yang dapat menghasilkan banyak bin dengan sangat sedikit titik data di masing-masing. Tingkat detail ini mungkin tidak diperlukan dan membebani pembaca dengan terlalu banyak informasi, sehingga sulit menemukan pola atau tren yang bermakna dalam data.
Ukuran bin yang tidak konsisten akan menghasilkan visualisasi yang menyesatkan dan membuat histogram lebih sulit diinterpretasikan.
Pertama, pastikan semua bin dalam histogram Anda memiliki lebar yang sama. Konsistensi ini memungkinkan perbandingan frekuensi yang lugas di berbagai interval.
Beberapa pedoman dapat membantu menentukan lebar bin (dan jumlah bin) yang sesuai:
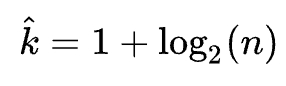 Aturan Sturges. Sumber: Wikipedia
Dalam praktiknya, lebar bin terbaik ditemukan melalui penyesuaian iteratif. Mulailah dengan lebar bin berbasis pedoman lalu sesuaikan naik atau turun sambil mengevaluasi histogram yang dihasilkan untuk kejelasan dan keberinformasiannya.
Kesalahan umum adalah hanya fokus pada diagram dan kurang memperhatikan label serta skala.
Pembaca mungkin tidak memahami apa yang diwakili histogram jika sumbu diberi label secara tidak benar atau tidak memadai.
Saat membandingkan beberapa histogram, skala sumbu-y yang tidak konsisten dapat mengacaukan perbandingan. Misalkan satu histogram menggunakan skala sumbu-y dari 0 hingga 100 dan yang lain menggunakan 0 hingga 50; tinggi batang tidak dapat dibandingkan secara langsung. Ketidakkonsistenan ini dapat menyesatkan pembaca sehingga mengira ada perbedaan atau kesamaan signifikan yang sebenarnya tidak ada.
Skala yang tidak konsisten dalam satu histogram juga dapat menyalahartikan data. Jika sumbu-y dimulai dari angka selain nol atau menggunakan interval tak beraturan, ini dapat melebih-lebihkan atau mengecilkan perbedaan yang tampak antar frekuensi bin, sehingga mengarah pada kesimpulan yang keliru tentang distribusi data.
Selalu beri label sumbu-x dan sumbu-y dengan jelas dan akurat. Jelaskan apa yang diwakili masing-masing sumbu dan sertakan satuan ukuran jika relevan. Sertakan judul deskriptif yang memberikan konteks untuk histogram.
Gunakan skala yang konsisten untuk sumbu-y, terutama saat membandingkan beberapa histogram. Ini memastikan tinggi batang secara akurat mencerminkan frekuensi atau frekuensi relatif dan memungkinkan perbandingan yang bermakna. Pastikan sumbu-y dimulai dari nol untuk memberikan representasi distribusi data yang sebenarnya. Jika memulai dari nol tidak praktis, jelaskan titik awalnya dengan jelas dan gunakan interval yang konsisten.
Outlier adalah titik data yang berada jauh di luar gugus utama data, memengaruhi bentuk distribusi data. Kesalahan umum adalah begitu saja mengecualikan dan mengabaikan outlier.
Mengecualikannya dapat menyembunyikan sifat sebenarnya dari distribusi, seperti keberadaan ekor panjang atau ketidaksimetrian (skewness). Satu dataset dengan beberapa nilai yang sangat tinggi mungkin menunjukkan distribusi yang miring jika outlier disertakan, tetapi akan tampak lebih simetris jika dihapus.
Terkadang outlier merepresentasikan fenomena signifikan atau wawasan penting. Misalnya, dalam data penjualan, sebuah outlier bisa berupa pembelian yang luar biasa besar yang mungkin menunjukkan keberhasilan kampanye pemasaran atau pesanan dalam jumlah banyak. Mengabaikan titik seperti ini dapat melewatkan informasi berharga.
Sertakan outlier dalam histogram untuk menyajikan gambaran lengkap distribusi data. Pastikan skala sumbu-y mengakomodasi outlier ini tanpa terlalu memampatkan data utama.
Jika outlier dikecualikan karena alasan tertentu (misalnya, kesalahan, nilai ekstrem yang tidak relevan), jelaskan dengan jelas dalam teks pendamping atau legenda. Ini memastikan transparansi dan membantu pembaca memahami alasan di balik pengecualian tersebut.
Mengikuti praktik terbaik ini memastikan histogram Anda menyampaikan insight yang dimaksud kepada pembaca dan membantu analitik lanjutan dalam proyek analitik.
Artikel ini memperkenalkan Anda pada histogram frekuensi, berbagai jenisnya, dan pentingnya dalam analitik data. Setelah membuat histogram secara manual, kami mencantumkan beberapa alat dan teknologi populer yang dapat Anda gunakan untuk membuat histogram. Kami juga mempelajari beberapa kesalahan umum yang perlu dihindari dan praktik terbaik yang perlu diikuti.
Kami mendorong Anda untuk menguji keterampilan Anda dengan membuat dan menafsirkan histogram dari berbagai dataset untuk meningkatkan kemahiran. Mempraktikkan tugas analitik dan menganalisis hasilnya dapat membantu Anda menjadi mahir dalam analitik data.
Selamat belajar!
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt