
Kurs
Einführung in Python
4 Std.
7M
Histogramme werden in der Datenanalyse häufig verwendet, um die Verteilung eines Datensatzes grafisch darzustellen. So lässt sich erkennen, wie sich Daten über verschiedene Werte verteilen – und Muster, Trends sowie Auffälligkeiten werden sichtbar.
Dieser Artikel führt dich in Häufigkeitshistogramme ein und zeigt dir Schritt für Schritt, wie du eines erstellst. Außerdem lernst du verschiedene Histogramm-Typen kennen, beliebte Technologien zu ihrer Erstellung, typische Fehler, die du vermeiden solltest, und Best Practices.
Ein Häufigkeitshistogramm ist eine grafische Darstellung der Verteilung eines Datensatzes. Ein Histogramm besteht aus sogenannten Klassen (Bins), also Intervallen, die den Wertebereich der Daten abdecken. Jede Klasse hat eine Häufigkeit: die Anzahl der Datenpunkte in diesem Intervall. Die Klassen werden auf der Horizontalen, die Häufigkeiten auf der Vertikalen aufgetragen – es entsteht eine Balkendarstellung. Die Höhe eines Balkens entspricht der Häufigkeit in der jeweiligen Klasse.
Histogramme sind verbreitet, weil sie in der Datenanalyse mehrere zentrale Aufgaben erfüllen:
Da wir nun wissen, was Häufigkeitshistogramme sind und wofür sie in der Datenanalyse genutzt werden, erstellen wir als Nächstes eines anhand eines Beispiels.
Stell dir vor, du sollst als Data Analyst die täglichen Verkaufszahlen eines Einzelhandelsgeschäfts für den vergangenen Monat analysieren.
Dein Ziel ist es, die Verteilung der Tagesumsätze zu verstehen, Muster zu erkennen, die Performance zu bewerten und Insights für Bestandsmanagement und Vertriebsstrategien zu liefern. Im Rahmen der Analyse entscheidest du, dass ein Histogramm hilfreiche Erkenntnisse liefern kann.
Folgende Schritte führen dich zu deinem Häufigkeitshistogramm:
Angenommen, du hast mit dem Datenteam gesprochen und die Daten aus den Vertriebsdatenbanken eurer Organisation abgerufen. Du hast sie wie unten in Tabellenform aufbereitet:
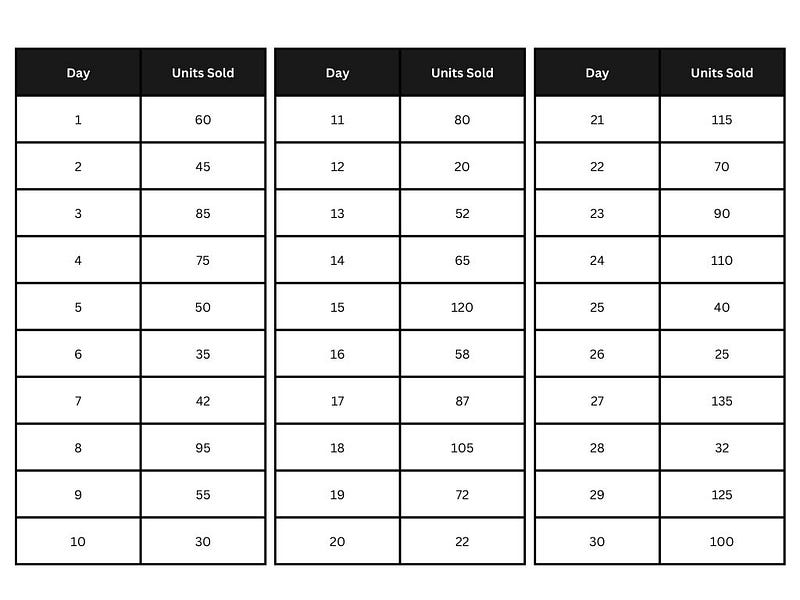 Sales-Datensatz. Bild: Autor.
Wähle als Nächstes geeignete Klassen basierend auf Wertebereich und Verteilung der Daten.
Nach der Analyse stellst du fest: Der kleinste Wert ist 20, der größte 135, und es gibt 30 Beobachtungen. Nach der Quadratwurzelregel (dazu später mehr) gilt: √30 ≈ 5,5 – sechs Klassen sind also sinnvoll. Die Spannweite 115 wird auf sechs Klassen verteilt, womit sich eine Klassenbreite von etwa 19 Einheiten ergibt.
Zur Einfachheit verwenden wir Klassenbreiten von 20 Einheiten:
Zähle, wie viele Beobachtungen in jedes Intervall fallen, und trage sie wie unten zusammen:
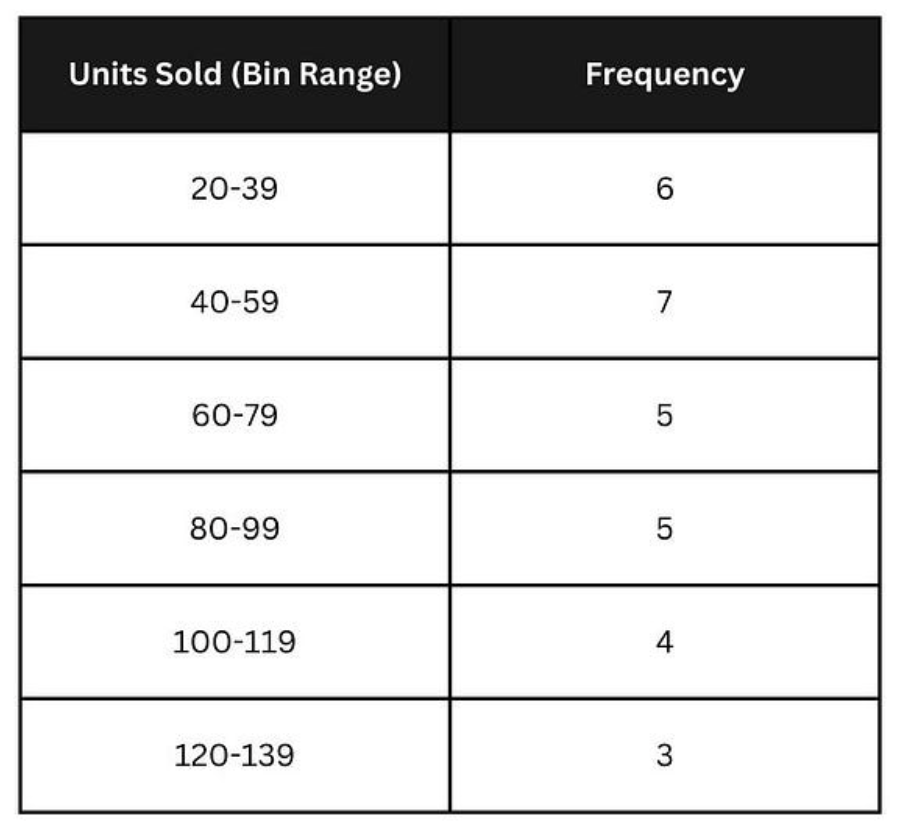
Häufigkeiten je Klasse berechnen. Bild: Autor.
Zeichne eine horizontale Achse (x-Achse) für die Klassen und eine vertikale Achse (y-Achse) für die Häufigkeiten. Zeichne für jede Klasse einen Balken, dessen Höhe der Häufigkeit entspricht.
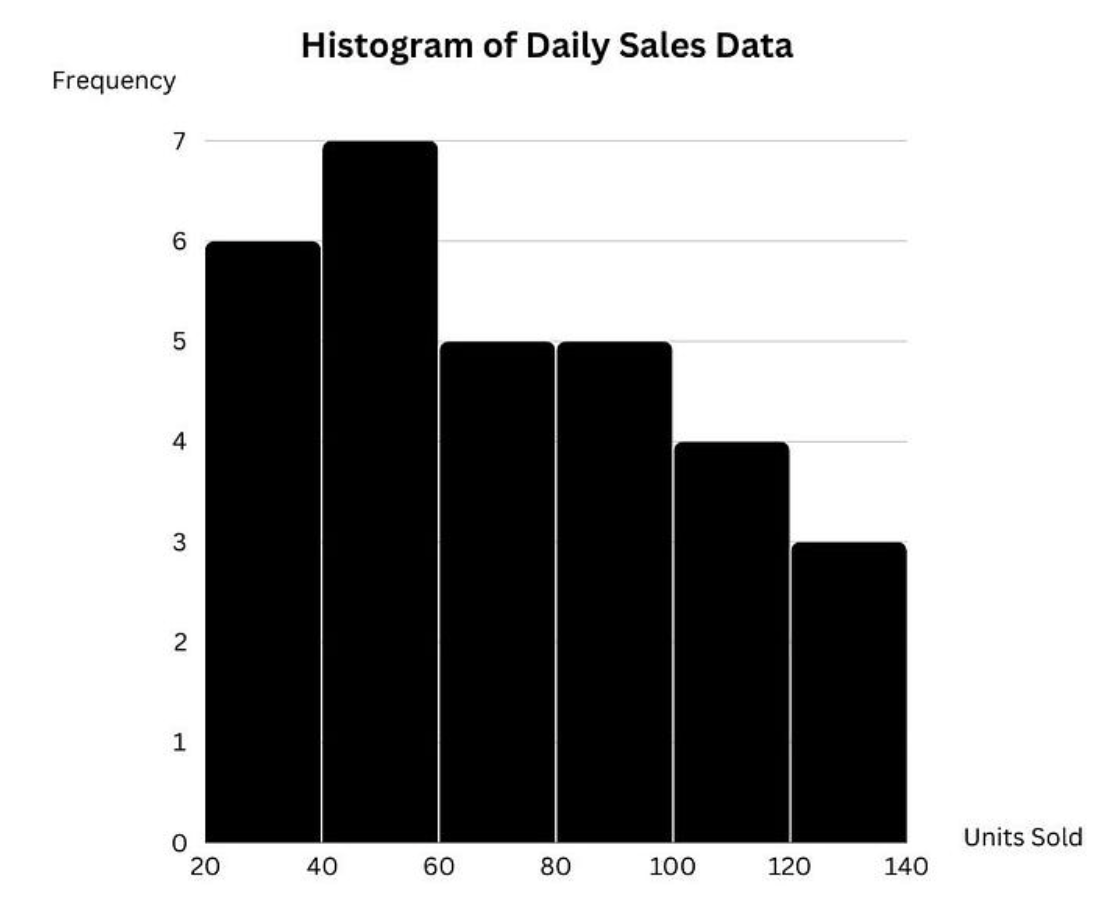
Dein Histogramm sollte in etwa so aussehen:
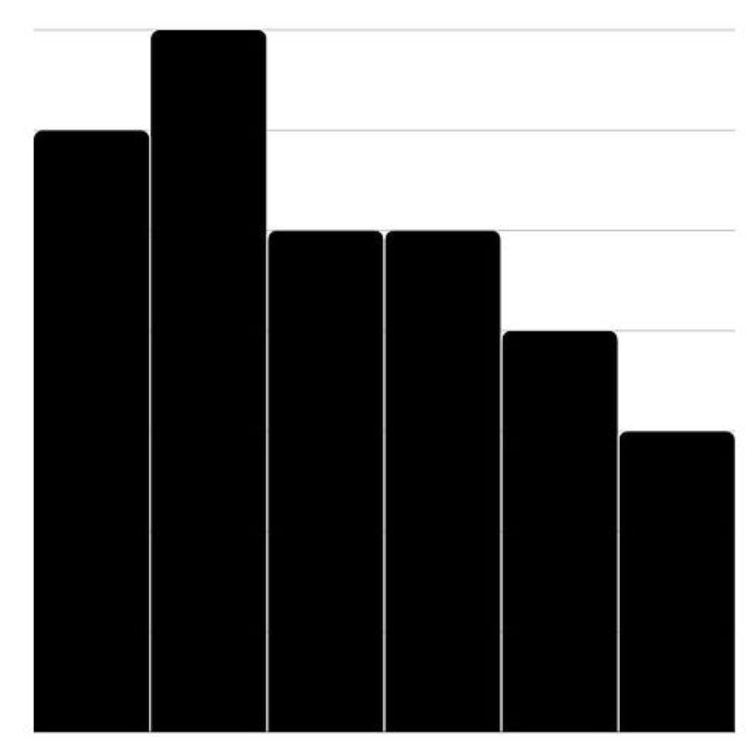 Histogramm plotten. Bild: Autor.
Beschrifte die x-Achse mit „Units Sold“ und die y-Achse mit „Frequency“. Füge einen Titel wie „Histogram of Daily Sales Data“ hinzu. Achte auf gleichmäßige Abstände und klar unterscheidbare Balken für eine gute Lesbarkeit.
So sollte das fertige Diagramm aussehen:
Beschriftung und Formatierung des Histogramms. Bild: Autor.
Fertig! Du hast das Häufigkeitshistogramm für deine Analyse erstellt.
Es gibt verschiedene Arten von Häufigkeitshistogrammen, die sich in der Darstellung leicht unterscheiden.
Diese Varianten ermöglichen je nach Anwendung unterschiedliche Einblicke – es lohnt sich also, sie zu kennen.
Auch wenn wir oben ein Histogramm manuell erstellt haben, kannst du es mit verschiedenen Tools und Technologien erzeugen – jeweils mit eigenen Stärken und Funktionen.
Beliebte Optionen sind:
Natürlich ist diese Liste nicht vollständig – es gibt viele weitere Online-Tools für Histogramme. Probiere aus, was für dein Analyseprojekt am besten passt.
Weil Histogramme als Grundlagenwerkzeug gelten, werden sie oft nie wirklich sauber gelernt – was schnell zu Fehlern führt. Hier sind typische Stolperfallen und wie du sie vermeidest:
Ungeeignete Klassenbreiten beeinflussen Darstellung und Aussagekraft eines Histogramms erheblich.
Zu breite Klassen fassen zu viele Datenpunkte zusammen und verschleiern wichtige Muster und Unterschiede. Feine Details gehen verloren.
Zu schmale Klassen decken sehr kleine Wertebereiche ab. Dadurch entstehen viele Klassen mit wenigen Beobachtungen – unnötige Detailfülle, die überfordert und Muster schwer erkennbar macht.
Uneinheitliche Klassenbreiten führen zu irreführenden Visualisierungen und erschweren die Interpretation.
Sorge zunächst für einheitliche Klassenbreiten im gesamten Histogramm. Diese Konsistenz erleichtert den Vergleich der Häufigkeiten.
Für die Wahl der Klassenbreite (und -anzahl) helfen Faustregeln:
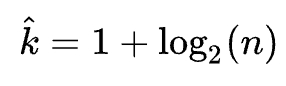 Sturges’ Regel. Quelle: Wikipedia
In der Praxis findest du die passende Klassenbreite oft iterativ. Starte mit einer Faustregel und justiere nach oben oder unten, bis das Histogramm klar und aussagekräftig ist.
Ein häufiger Fehler ist, sich nur auf das Diagramm zu konzentrieren – und Beschriftungen sowie Skalen zu vernachlässigen.
Sind Achsen falsch oder unzureichend beschriftet, bleibt unklar, was dargestellt wird.
Beim Vergleich mehrerer Histogramme kann eine uneinheitliche y-Achsen-Skalierung den Eindruck verfälschen. Nutzt ein Diagramm 0 bis 100 und ein anderes 0 bis 50, sind Balkenhöhen nicht direkt vergleichbar – das kann zu falschen Schlüssen führen.
Auch innerhalb eines einzelnen Histogramms kann eine ungeeignete Skalierung täuschen. Beginnt die y-Achse nicht bei null oder sind Intervalle unregelmäßig, werden Unterschiede über- oder untertrieben – mit falschen Interpretationen als Folge.
Beschrifte x- und y-Achse klar und korrekt. Benenne genau, was dargestellt wird, und gib Einheiten an, falls relevant. Verwende einen aussagekräftigen Titel mit Kontext.
Nutze eine konsistente y-Achsen-Skala, insbesondere beim Vergleich mehrerer Histogramme. So spiegeln Balkenhöhen Häufigkeiten korrekt wider und Vergleiche bleiben sinnvoll. Lasse die y-Achse nach Möglichkeit bei null starten. Wenn das nicht praktikabel ist, gib den Startpunkt klar an und verwende gleichmäßige Intervalle.
Ausreißer sind Datenpunkte, die deutlich außerhalb des Hauptclusters liegen und die Form der Verteilung beeinflussen. Ein häufiger Fehler ist, sie einfach auszublenden.
Das Entfernen kann das wahre Verteilungsbild verfälschen – etwa lange „Schwänze“ oder Schiefe verdecken. Ein Datensatz mit wenigen extrem hohen Werten wirkt mit Ausreißern schief, ohne sie hingegen scheinbar symmetrischer.
Zudem können Ausreißer wichtige Phänomene abbilden. In Verkaufsdaten könnte ein Ausreißer auf eine ungewöhnlich große Bestellung hinweisen – vielleicht durch eine erfolgreiche Kampagne oder einen Großeinkauf. Wer sie ignoriert, verpasst wertvolle Hinweise.
Beziehe Ausreißer in das Histogramm ein, um die Verteilung vollständig zu zeigen. Achte darauf, die y-Achse so zu skalieren, dass die Hauptdaten nicht „zusammengedrückt“ werden.
Wenn du Ausreißer aus triftigen Gründen ausschließt (z. B. Fehler, irrelevante Extremwerte), erkläre das transparent im Begleittext oder in der Legende. So bleibt deine Darstellung nachvollziehbar.
Wenn du diese Best Practices befolgst, vermittelt dein Histogramm die beabsichtigten Erkenntnisse und unterstützt die weiteren Analyseschritte in deinen Projekten.
In diesem Artikel hast du Häufigkeitshistogramme, ihre Varianten und ihre Bedeutung für die Datenanalyse kennengelernt. Nach der manuellen Erstellung haben wir beliebte Tools und Technologien vorgestellt und typische Fehler samt Best Practices beschrieben.
Setze dein Wissen in die Praxis um: Erstelle und interpretiere Histogramme für verschiedene Datensätze, um Routine zu gewinnen. Übung in Analyseaufgaben und die Auswertung der Ergebnisse machen dich in der Datenanalyse wirklich souverän.
Viel Erfolg beim Lernen!
Lerne mit DataCamp
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Javier Canales Luna
11 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
5 Min.








