

Cursus
Introductie tot Python
4 uur
7.1M
Oefen en volg je voortgang.
Ga Verder Met GoogleHistogrammen worden vaak gebruikt in data-analyse om de verdeling van een dataset grafisch weer te geven. Zo kun je zien hoe gegevens over verschillende waarden zijn verspreid en patronen, trends en anomalieën ontdekken.
Dit artikel introduceert frequentiehistogrammen en helpt je er stap voor stap een te maken. We bespreken ook verschillende soorten histogrammen, populaire tools om ze te maken, veelvoorkomende valkuilen en best practices.
Een frequentiehistogram is een grafische weergave van de verdeling van een dataset. Een histogram is opgebouwd uit een reeks bins: intervallen die samen het bereik van de data afdekken. Elke bin heeft een frequentie: het aantal datapunten binnen dat interval. De bins staan op de horizontale as en de frequenties op de verticale as, wat resulteert in een staafdiagram-achtige weergave. De hoogte van elke staaf komt overeen met de frequentie van datapunten in die bin.
Histogrammen zijn populair omdat ze meerdere cruciale doelen in data-analyse dienen:
Nu we weten wat frequentiehistogrammen zijn en waarvoor ze dienen in data-analyse, gaan we er met een voorbeeld zelf een maken.
Stel, je bent data-analist en je krijgt de opdracht om de dagelijkse verkoopcijfers van een winkel over de afgelopen maand te analyseren.
Je doel is om de verdeling van de dagelijkse verkoop te begrijpen om patronen te herkennen, prestaties te beoordelen en inzichten te leveren voor voorraadbeheer en verkoopstrategieën. Als onderdeel van de analyse besluit je dat een histogram kan helpen om inzichten te verkrijgen.
Volg deze stappen om je frequentiehistogram te maken:
Stel, je hebt contact opgenomen met het datateam van je organisatie en de gegevens uit de verkoopdatabases opgehaald. Je hebt de data in een tabelvorm georganiseerd zoals hieronder:
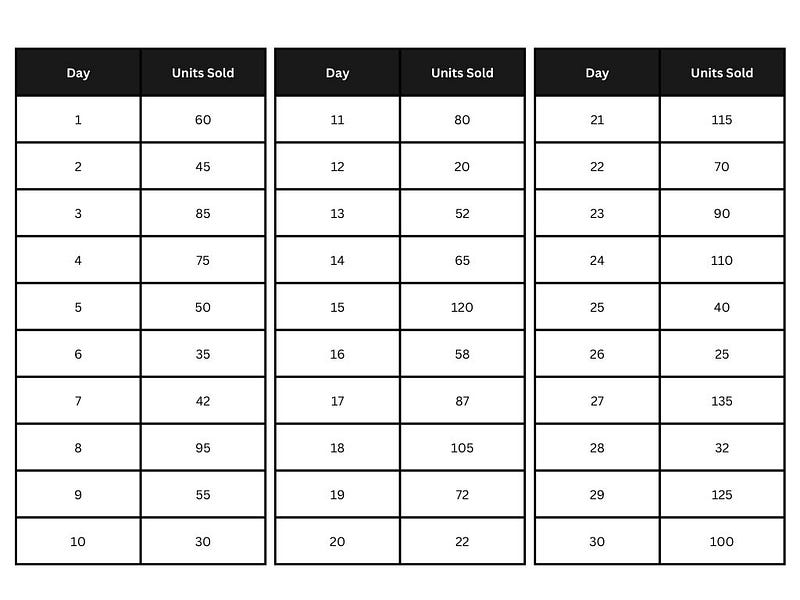 Sales-dataset. Afbeelding door de auteur.
Kies vervolgens geschikte bins op basis van het bereik en de verdeling van de data.
Na analyse van de data blijkt de kleinste waarde 20 te zijn, de grootste 135, en je hebt 30 observaties. Met de wortelregel (hier komen we later op terug), √30 ≈ 5,5, kun je zes bins gebruiken. We moeten het bereik van 115 in zes bins verdelen, wat leidt tot een binbreedte van ongeveer 19 eenheden.
Voor de eenvoud gebruiken we bins met een breedte van 20 eenheden:
Tel het aantal observaties binnen elk interval en zet ze in een tabel zoals hieronder:
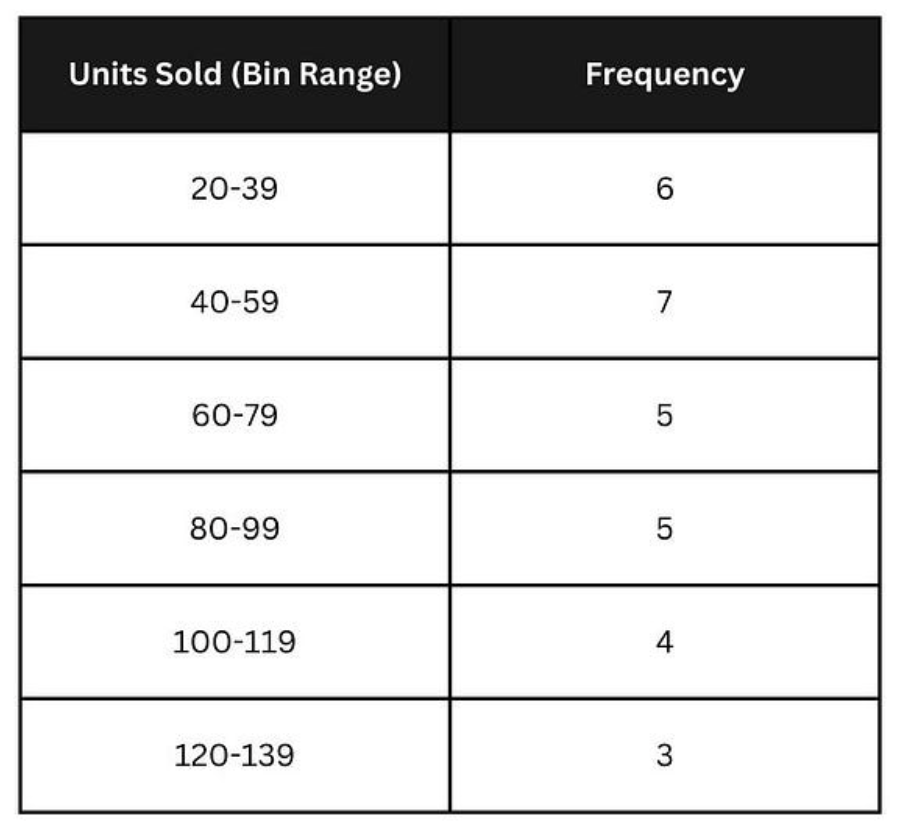
Frequenties per bin berekenen. Afbeelding door de auteur.
Teken een horizontale lijn (x-as) voor de bins en een verticale lijn (y-as) voor de frequenties. Teken voor elke bin een staaf waarvan de hoogte overeenkomt met de frequentie.
Je histogram zou er ongeveer zo uit moeten zien:
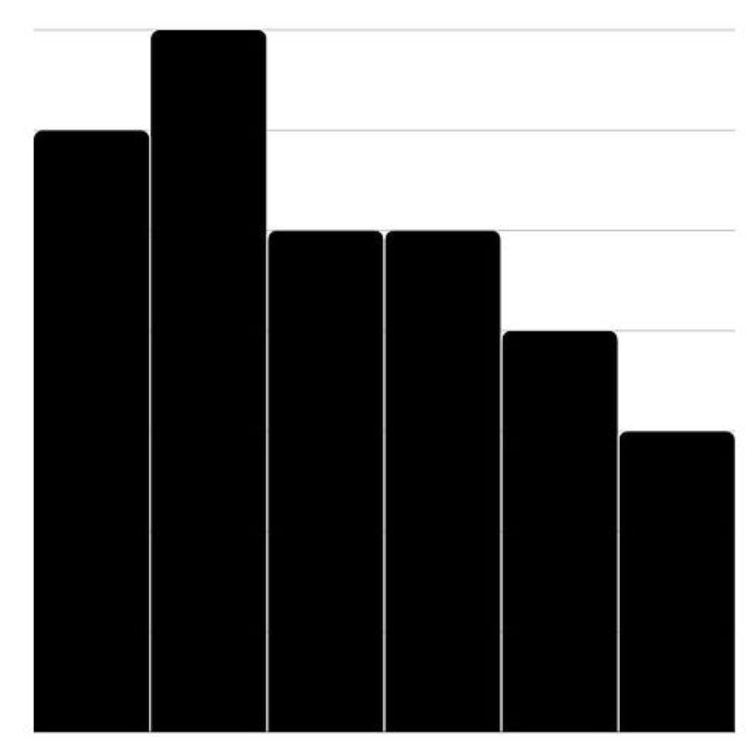 Het histogram plotten. Afbeelding door de auteur.
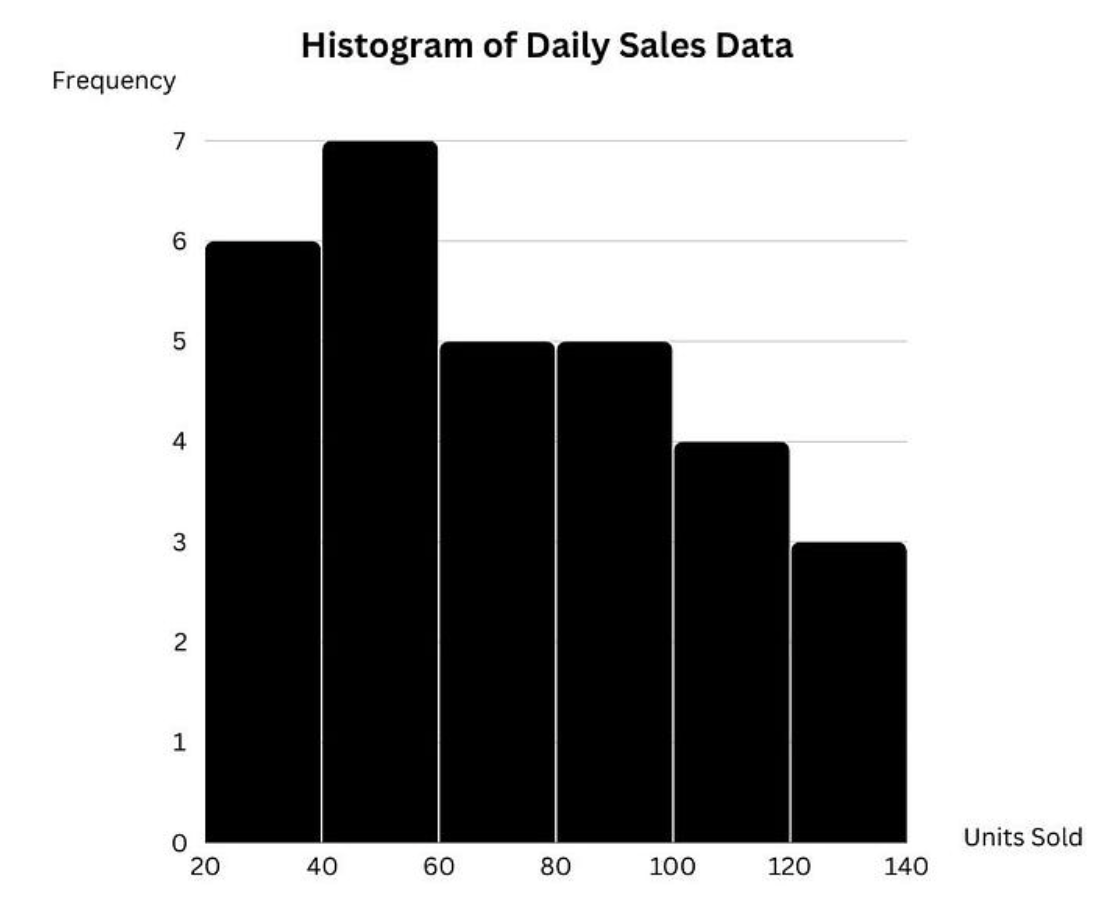
Label de x-as met “Units Sold” en de y-as met “Frequency”. Voeg een titel toe zoals “Histogram of Daily Sales Data”. Zorg dat de staven gelijkmatig verdeeld en duidelijk van elkaar te onderscheiden zijn voor een heldere visualisatie.
Het voltooide diagram zou er zo uit moeten zien:
Het histogram labelen en formatteren. Afbeelding door de auteur.
Dat is alles! Je hebt het frequentiehistogram voor je analyse gemaakt.
Er zijn verschillende soorten frequentiehistogrammen, die elk kleine variaties bieden in hoe de data wordt weergegeven.
Met deze varianten kun je, afhankelijk van de situatie in je analyseproject, verschillende inzichten blootleggen; het is daarom handig om te weten dat deze typen bestaan.
Hoewel we hierboven hebben geleerd hoe je handmatig histogrammen maakt, kan dat ook met diverse tools en technologieën, elk met eigen functies en mogelijkheden.
Hier zijn enkele populaire technologieën voor het maken van histogrammen:
Natuurlijk is deze lijst niet uitputtend en zijn er nog veel andere online tools beschikbaar om histogrammen te maken. Gebruik gerust wat het beste past bij de behoeften van jouw analyseproject.
Omdat histogrammen worden gezien als basisdiagrammen, leren we ze zelden formeel, wat vaak tot fouten leidt. Hier zijn enkele veelvoorkomende fouten en best practices om ze te vermijden:
Een ongeschikte binbreedte kan het uiterlijk en de nauwkeurigheid van het histogram sterk beïnvloeden.
Te brede bins kunnen de data overmatig versimpelen doordat te veel datapunten samen worden geclusterd, waardoor belangrijke patronen en variaties verdwijnen. Hierdoor zie je minder details en nuances in de verdeling.
Aan de andere kant betekent een smalle binbreedte dat elke bin een heel klein bereik aan waarden dekt, wat kan resulteren in veel bins met weinig datapunten. Dat detailniveau is vaak niet nodig en kan de lezer overladen, waardoor het lastiger wordt om betekenisvolle patronen of trends te ontdekken.
Inconsistente binformaten leiden tot misleidende visualisaties en maken interpretatie moeilijker.
Zorg er om te beginnen voor dat alle bins in je histogram dezelfde breedte hebben. Deze consistentie maakt een eenvoudige vergelijking van frequenties tussen intervallen mogelijk.
Er zijn verschillende richtlijnen om een geschikte binbreedte (en het aantal bins) te bepalen:
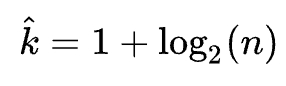 Sturges’ regel. Bron: Wikipedia
In de praktijk vind je de beste binbreedte door iteratief te verfijnen. Begin met een richtlijn en stel daarna naar boven of beneden bij, terwijl je beoordeelt of het resulterende histogram duidelijk en informatief is.
Een veelgemaakte fout is om je alleen op het diagram te richten en minder op de labels en de schalen.
Kijkers snappen mogelijk niet wat het histogram weergeeft als de assen onjuist of onvoldoende zijn gelabeld.
Bij het vergelijken van meerdere histogrammen kan inconsistente schaling op de y-as de vergelijking vertekenen. Stel dat het ene histogram een y-as van 0 tot 100 gebruikt en het andere 0 tot 50; dan zijn de staafhoogtes niet direct vergelijkbaar. Deze inconsistentie kan kijkers misleiden om verschillen of overeenkomsten te zien die er feitelijk niet zijn.
Inconsistente schaling binnen één histogram kan de data ook verkeerd voorstellen. Als de y-as niet bij nul begint of onregelmatige intervallen gebruikt, kunnen de verschillen tussen binfrequenties worden overdreven of juist afgezwakt, wat tot verkeerde conclusies over de verdeling leidt.
Label de x-as en y-as altijd duidelijk en nauwkeurig. Geef aan wat elke as vertegenwoordigt en vermeld indien van toepassing de eenheden. Voeg een beschrijvende titel toe die context biedt voor het histogram.
Gebruik een consistente schaal voor de y-as, zeker wanneer je meerdere histogrammen vergelijkt. Zo weerspiegelen de staafhoogtes de (relatieve) frequentie correct en kun je zinvolle vergelijkingen maken. Laat de y-as bij voorkeur bij nul beginnen voor een waarheidsgetrouwe weergave. Als dat niet praktisch is, geef dan het startpunt duidelijk aan en gebruik consistente intervallen.
Uitschieters zijn datapunten die ver buiten de hoofdmassa van de data vallen en de vorm van de verdeling beïnvloeden. Een veelgemaakte fout is om uitschieters simpelweg uit te sluiten en te negeren.
Door ze uit te sluiten kan de ware aard van de verdeling verborgen blijven, zoals een lange staart of scheefheid. Een dataset met enkele extreem hoge waarden kan een scheve verdeling tonen als uitschieters zijn inbegrepen, maar lijkt symmetrischer als ze zijn verwijderd.
Uitschieters kunnen soms belangrijke verschijnselen of inzichten vertegenwoordigen. In verkoopdata kan een uitschieter bijvoorbeeld een uitzonderlijk grote aankoop zijn, mogelijk door een succesvolle marketingcampagne of een bulkbestelling. Zulke punten negeren kan waardevolle informatie doen missen.
Neem uitschieters op in het histogram om een compleet beeld van de verdeling te geven. Zorg dat de schaal van de y-as ruimte biedt aan deze uitschieters zonder de hoofddata te veel samen te drukken.
Als je uitschieters om specifieke redenen uitsluit (bijv. fouten, irrelevante extreme waarden), leg dit dan duidelijk uit in de begeleidende tekst of legenda. Dit zorgt voor transparantie en helpt kijkers de reden van uitsluiting te begrijpen.
Door deze best practices te volgen, zorg je ervoor dat je histogram de beoogde inzichten overbrengt en je ondersteunt bij verdere analyses in je projecten.
Dit artikel heeft je geïntroduceerd in frequentiehistogrammen, hun verschillende typen en hun belang in data-analyse. Nadat we handmatig histogrammen hebben gemaakt, noemden we enkele populaire tools en technologieën om histogrammen te maken. We bespraken ook veelvoorkomende fouten en best practices.
We moedigen je aan om je vaardigheden te oefenen door histogrammen te maken en te interpreteren voor meerdere datasets. Het uitvoeren van analysetaken en het beoordelen van de resultaten helpt je om vaardig te worden in data-analyse.
Veel leerplezier!
Leer met DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

