

Airflow की प्रमुख विशेषताएँ
Airflow के फ़्रेमवर्क और इसकी आर्किटेक्चर—दोनों में—कई मुख्य विशेषताएँ हैं जो इसे विशिष्ट बनाती हैं। पहले, चलिए Airflow के फ़्रेमवर्क की सबसे महत्वपूर्ण विशेषताओं को थोड़ा गहराई से समझते हैं।
Airflow के फ़्रेमवर्क की विशेषताएँ
Airflow फ़्रेमवर्क की सबसे सरल इकाई टास्क्स हैं। टास्क्स को ऑपरेशंस के रूप में समझा जा सकता है, या अधिकांश डेटा टीमों के लिए, डेटा पाइपलाइन में किए जाने वाले कार्यों के रूप में।
परंपरागत ETL वर्कफ़्लो में तीन टास्क होते हैं; डेटा निकालना, उसे ट्रांसफ़ॉर्म करना, और लोड करना। डिपेंडेंसीज़ टास्क्स के बीच के संबंधों को परिभाषित करती हैं। हमारे ETL उदाहरण पर वापस आते हुए, “load” टास्क “transform” टास्क पर निर्भर है, जो बदले में “extract” टास्क पर निर्भर है। टास्क्स और डिपेंडेंसीज़ का संयोजन DAGs, या directed-acyclic graphs बनाता है। DAGs Airflow में डेटा पाइपलाइनों का प्रतिनिधित्व करते हैं और उन्हें परिभाषित करना थोड़ा जटिल हो सकता है। इसके बजाय, चलिए एक बुनियादी ETL पाइपलाइन के डायग्राम को देखते हैं:
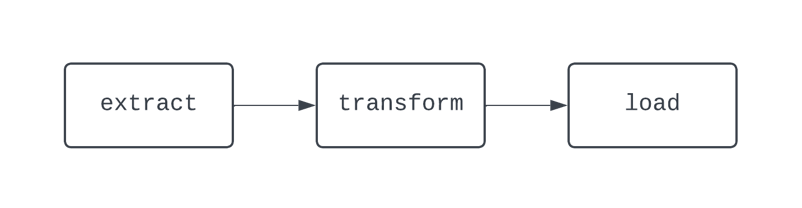
ऊपर दिए गए DAG में तीन टास्क हैं, जिनमें दो डिपेंडेंसीज़ हैं। इसे DAG इसलिए माना जाता है क्योंकि टास्क्स के बीच कोई लूप (या साइकिल) नहीं है। यहाँ, तीर इस प्रक्रिया की डायरेक्टेड प्रकृति दिखाते हैं; पहले extract टास्क चलता है, फिर transform और load टास्क्स। DAGs के साथ, प्रक्रिया का स्पष्ट आरंभ और अंत देखना आसान होता है, भले ही लॉजिक जटिल हो, जैसा कि नीचे दिखाए गए DAG में है:
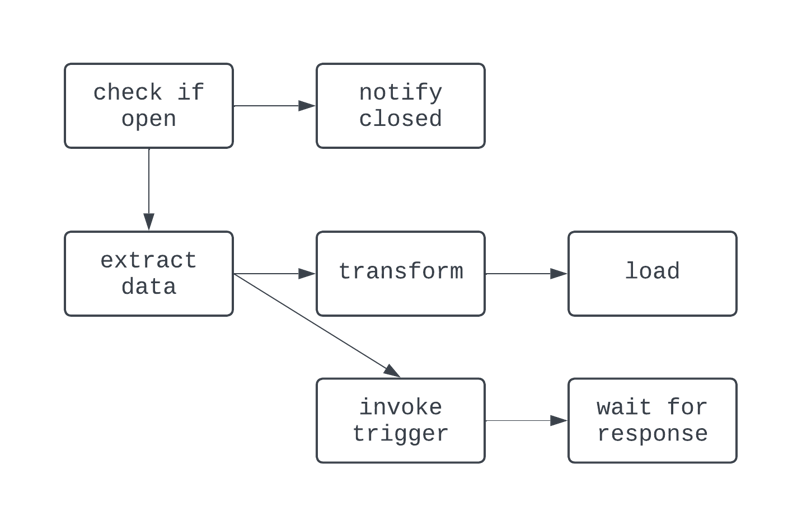
इस DAG में, लॉजिक कुछ ज़्यादा पेचीदा है। एक कंडीशन के आधार पर ब्रांचिंग है, और कुछ टास्क्स समानांतर में चलते हैं। फिर भी, ग्राफ डायरेक्टेड है और टास्क्स के बीच कोई साइक्लिक डिपेंडेंसी नहीं है। अब, आइए एक ऐसी प्रक्रिया देखें जो DAG नहीं है:
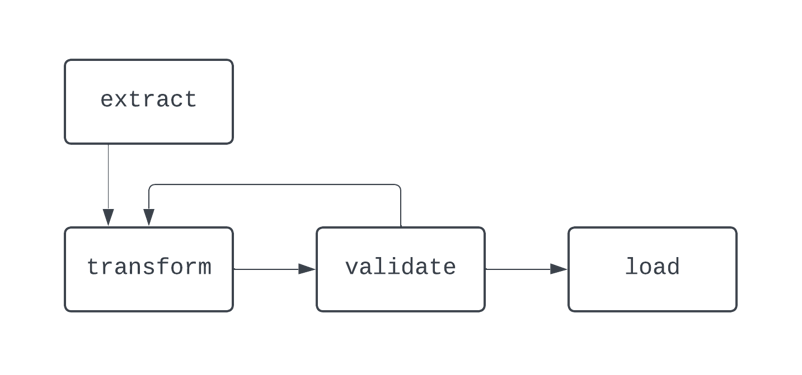
इस डायग्राम में, transform और validate टास्क्स के बीच एक स्पष्ट लूप है। कुछ मामलों में, यदि इस लूप से बाहर निकलने का कोई तरीका नहीं हुआ, तो यह DAG हमेशा चलता रह सकता है।
डेटा पाइपलाइनों का निर्माण करते समय, चाहे Airflow के बाहर भी, बेहतर यही है कि ऐसे वर्कफ़्लो बनाने से बचें जिन्हें DAGs के रूप में प्रदर्शित नहीं किया जा सकता, क्योंकि आप determinism या idempotency जैसी प्रमुख विशेषताएँ खो सकते हैं।
Airflow की आर्किटेक्चर की विशेषताएँ
DAGs को शेड्यूल करने, टास्क्स को निष्पादित करने और डेटा पाइपलाइन के निष्पादन विवरणों में दृश्यता देने के लिए, Airflow निम्नलिखित घटकों से बनी Python-आधारित आर्किटेक्चर का उपयोग करता है:
- Scheduler
- Executor
- Metadata database
- Webserver (UI)
चाहे आप Airflow को लोकली चला रहे हों या प्रोडक्शन वातावरण में, Airflow के सुचारु रूप से काम करने के लिए इन प्रत्येक घटकों का चालू और चल रहा होना आवश्यक है।
Scheduler का काम है (शायद आपने सही अनुमान लगाया) DAGs को शेड्यूल करना। किसी DAG को शेड्यूल करने के लिए, जब DAG को Python कोड के रूप में लिखा जाता है तब उसके लिए एक start date और schedule interval देना होता है।
एक बार DAG शेड्यूल हो जाने पर, उन DAGs के भीतर के टास्क्स को निष्पादित करना होता है, जहाँ executor काम आता है। Executor प्रत्येक टास्क के भीतर का लॉजिक नहीं चलाता; यह केवल टास्क को कॉन्फ़िगर किए गए संसाधनों द्वारा चलाने के लिए आवंटित करता है। मेटाडेटा डेटाबेस DAG रन के बारे में जानकारी स्टोर करता है, जैसे कि DAG और उससे जुड़े टास्क सफलतापूर्वक चले या नहीं।
मेटाडेटा डेटाबेस user-defined variables और connections जैसी जानकारी भी स्टोर करता है, जो प्रोडक्शन-ग्रेड डेटा पाइपलाइन बनाने में मदद करती हैं। अंत में, वेब सर्वर Airflow का यूज़र इंटरफ़ेस प्रदान करता है।
यह यूज़र इंटरफ़ेस, या UI, डेटा टीमों को उनके पाइपलाइन निष्पादन को मैनेज करने के लिए एक केंद्रीय टूल देता है। Airflow UI में, डेटा टीमें अपने DAGs की स्थिति देख सकती हैं, DAG को मैन्युअली फिर से चला सकती हैं, variables और connections स्टोर कर सकती हैं, और भी बहुत कुछ। Airflow UI डेटा ingestion और डिलीवरी प्रक्रियाओं में केंद्रीय दृश्यता देता है, जिससे डेटा टीमें अपनी डेटा पाइपलाइनों के प्रदर्शन से अवगत और सूचित रहती हैं।
Apache Airflow इंस्टॉल करना
Apache Airflow को इंस्टॉल करने के कई तरीके हैं। हम दो सबसे सामान्य तरीकों को कवर करेंगे।
pip के साथ Airflow इंस्टॉल करना
पूर्वापेक्षाएँ:
python3इंस्टॉल हो
pip, जो Python का पैकेज मैनेजर है, के साथ Airflow इंस्टॉल करने के लिए, आप निम्न कमांड चला सकते हैं:
pip install apache-airflowपैकेज इंस्टॉल होने के बाद, आपको Airflow प्रोजेक्ट के सभी घटक बनाने होंगे, जैसे Airflow होम डायरेक्टरी सेट करना, airflow.cfg फ़ाइल बनाना, मेटाडेटा डेटाबेस चलाना, और भी बहुत कुछ। यह काफी काम हो सकता है और Airflow का अच्छा-खासा पूर्व अनुभव माँग सकता है। सौभाग्य से, Astro CLI के साथ एक कहीं आसान तरीका उपलब्ध है।
Astro CLI के साथ Airflow इंस्टॉल करना
पूर्वापेक्षाएँ:
python3इंस्टॉल हो- Docker इंस्टॉल हो
Astronomer, जो एक मैनेज्ड Airflow प्रोवाइडर है, Airflow के साथ काम आसान बनाने के लिए कई मुफ़्त टूल देता है। इन्हीं में से एक टूल Astro CLI है।
Astro CLI Airflow चलाने के लिए आपको जिन सब चीज़ों की ज़रूरत होती है, उन्हें बनाना और मैनेज करना आसान बनाता है। शुरू करने के लिए, पहले आपको CLI इंस्टॉल करना होगा। अपनी मशीन पर ऐसा करने के लिए, Astronomer के दस्तावेज़ देखें और अपने ऑपरेटिंग सिस्टम के लिए दिए गए चरणों का पालन करें।
Astro CLI इंस्टॉल होने के बाद, पूरे Airflow प्रोजेक्ट को कॉन्फ़िगर करने में केवल एक कमांड लगती है:
astro dev initयह आपके वर्तमान वर्किंग डायरेक्टरी में Airflow प्रोजेक्ट के लिए आवश्यक सभी संसाधनों को कॉन्फ़िगर कर देगा। इसके बाद आपकी वर्तमान वर्किंग डायरेक्टरी कुछ इस तरह दिखेगी:
.
├── dags/
├── include/
├── plugins/
├── tests/
├── airflow_settings.yaml
├── Dockerfile
├── packages.txt
└── requirements.txt
प्रोजेक्ट बनने के बाद, प्रोजेक्ट शुरू करने के लिए astro dev start चलाएँ। लगभग एक मिनट बाद, आप अपने ब्राउज़र में https://localhost:8080/ पते पर Airflow UI खोल सकते हैं। अब, आप अपना पहला DAG लिखने के लिए तैयार हैं!
अपना पहला Airflow DAG लिखना
हमने Airflow के फ़्रेमवर्क और आर्किटेक्चर की बुनियादी और उन्नत विशेषताएँ कवर कर ली हैं। अब जबकि Airflow इंस्टॉल हो चुका है, आप अपना पहला DAG लिखने के लिए तैयार हैं। सबसे पहले, अभी-अभी बनाए गए Airflow प्रोजेक्ट की dags/ डायरेक्टरी में sample_dag.py नाम की फ़ाइल बनाएँ। अपने पसंदीदा टेक्स्ट एडिटर या IDE का उपयोग करके sample_dag.py फ़ाइल खोलें। पहले, DAG को इंस्टेंटिएट करते हैं।
from airflow import DAG
from datetime import datetime
with DAG(
dag_id="weather_etl",
start_date=datetime(year=2024, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1,
render_template_as_native_obj=True
) as dag:
...
ऊपर, हम with कॉन्टेक्स्ट-मैनेजर के साथ airflow मॉड्यूल के DAG फ़ंक्शन का उपयोग करके DAG परिभाषित करते हैं।
start_date, schedule interval, और catchup के लिए मान दिया गया है। यह DAG हर दिन 9:00 AM UTC पर चलेगा। चूँकि catchup True पर सेट है, यह DAG पहली बार ट्रिगर होने के दिन और 1 जनवरी, 2024 के बीच के प्रत्येक दिन के लिए चलेगा, और max_active_runs=1 यह सुनिश्चित करता है कि एक समय में केवल एक ही DAG रन सक्रिय हो।
अब कुछ टास्क्स जोड़ते हैं! पहले, हम एक टास्क बनाएँगे जो किसी API से डेटा एक्सट्रैक्ट करने को मॉक करेगा। नीचे दिया गया कोड देखें:
...
# Import the PythonOperator
from airflow.operators.python import PythonOperator
...
def extract_data_callable():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
extract_data = PythonOperator(
dag=dag,
task_id="extract_data",
python_callable=extract_data_callable
)
इसके बाद, हम एक टास्क बनाएँगे जो extract_data टास्क द्वारा लौटाए गए डेटा को ट्रांसफ़ॉर्म करेगा। यह निम्न कोड से किया जा सकता है। यहाँ, हम पिछले टास्क से डेटा प्राप्त करने के लिए XComs नामक Airflow फ़ीचर का उपयोग कर रहे हैं।
चूँकि render_templat_as_native_obj True पर सेट है, ये मान स्ट्रिंग्स के बजाय Python ऑब्जेक्ट्स के रूप में साझा किए जाते हैं। extract_data टास्क से कच्चा डेटा कीवर्ड आर्ग्युमेंट के रूप में transform_data_callable को पास किया जाता है। फिर इस डेटा को ट्रांसफ़ॉर्म करके रिटर्न किया जाता है, जिसे load_data टास्क समान तरीके से उपयोग करेगा।
...
# Import pandas
import pandas as pd
...
def transform_data_callable(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
transform_data = PythonOperator(
dag=dag,
task_id="transform_data",
python_callable=transform_data_callable,
op_kwargs={"raw_data": "{{ ti.xcom_pull(task_ids='extract_data') }}"}
)
def load_data_callable(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
load_data = PythonOperator(
dag=dag,
task_id="load_data",
python_callable=load_data_callable,
op_kwargs={"transformed_data": "{{ ti.xcom_pull(task_ids='transform_data') }}"}
)
...
अंत में, टास्क्स के बीच डिपेंडेंसीज़ सेट की जाती हैं। यहाँ दिया गया कोड extract_data, transform_data, और load_data टास्क्स के बीच डिपेंडेंसीज़ सेट करता है ताकि एक बुनियादी ETL DAG बन सके।
...
extract_data >> transform_data >> load_data
अंतिम परिणाम कुछ ऐसा दिखेगा!
from airflow import DAG
from datetime import datetime
from airflow.operators.python import PythonOperator
import pandas as pd
with DAG(
dag_id="weather_etl",
start_date=datetime(year=2024, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1,
render_template_as_native_obj=True
) as dag:
def extract_data_callable():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
extract_data = PythonOperator(
dag=dag,
task_id="extract_data",
python_callable=extract_data_callable
)
def transform_data_callable(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
transform_data = PythonOperator(
dag=dag,
task_id="transform_data",
python_callable=transform_data_callable,
op_kwargs={"raw_data": "{{ ti.xcom_pull(task_ids='extract_data') }}"}
)
def load_data_callable(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
load_data = PythonOperator(
dag=dag,
task_id="load_data",
python_callable=load_data_callable,
op_kwargs={"transformed_data": "{{ ti.xcom_pull(task_ids='transform_data') }}"}
)
# Set dependencies between tasks
extract_data >> transform_data >> load_data
एक बार जब आपने अपनी पाइपलाइन को Python कोड के रूप में परिभाषित कर लिया, तो आप Airflow UI का उपयोग करके अपने DAG को ऑन कर सकते हैं। weather_etl DAG पर क्लिक करें और ऊपर बाएँ स्विच को ऑन करें। देखें कि कैसे आपके टास्क्स और DAG रन सफलतापूर्वक पूर्ण होते हैं।
बधाई हो, आपने अपना पहला Airflow DAG लिखा और चलाया!
पारंपरिक ऑपरेटर्स के अलावा, Airflow ने TaskFlow API पेश किया है, जो डेकोरेटर्स और नैटिव Python कोड का उपयोग करके DAGs और टास्क्स को परिभाषित करना आसान बनाता है।
टास्क्स के बीच डेटा साझा करने के लिए XComs को स्पष्ट रूप से उपयोग करने के बजाय, TaskFlow API इस लॉजिक को पर्दे के पीछे XComs का उपयोग करके एब्स्ट्रैक्ट कर देता है। नीचे दिया गया कोड ऊपर जैसा ही लॉजिक और फ़ंक्शनलिटी दिखाता है, इस बार TaskFlow API के साथ इम्प्लीमेंट किया गया है, जो उन डेटा विश्लेषकों और वैज्ञानिकों के लिए अधिक सहज है जो स्क्रिप्ट-आधारित ETL लॉजिक बनाते रहे हैं।
from airflow.decorators import dag, task
from datetime import datetime
import pandas as pd
@dag(
start_date=datetime(year=2023, month=1, day=1, hour=9, minute=0),
schedule="@daily",
catchup=True,
max_active_runs=1
)
def weather_etl():
@task()
def extract_data():
# Print message, return a response
print("Extracting data from an weather API")
return {
"date": "2023-01-01",
"location": "NYC",
"weather": {
"temp": 33,
"conditions": "Light snow and wind"
}
}
@task()
def transform_data(raw_data):
# Transform response to a list
transformed_data = [
[
raw_data.get("date"),
raw_data.get("location"),
raw_data.get("weather").get("temp"),
raw_data.get("weather").get("conditions")
]
]
return transformed_data
@task()
def load_data(transformed_data):
# Load the data to a DataFrame, set the columns
loaded_data = pd.DataFrame(transformed_data)
loaded_data.columns = [
"date",
"location",
"weather_temp",
"weather_conditions"
]
print(loaded_data)
# Set dependencies using function calls
raw_dataset = extract_data()
transformed_dataset = transform_data(raw_dataset)
load_data(transformed_dataset)
# Allow the DAG to be run
weather_etl()
Airflow के सर्वोत्तम अभ्यास
Airflow DAGs बनाना पेचीदा हो सकता है। डेटा पाइपलाइनों और वर्कफ़्लोज़ का निर्माण करते समय—सिर्फ Airflow में ही नहीं, बल्कि अन्य टूलिंग के साथ भी—कुछ सर्वोत्तम अभ्यास ध्यान में रखना ज़रूरी है।
मॉड्युलैरिटी
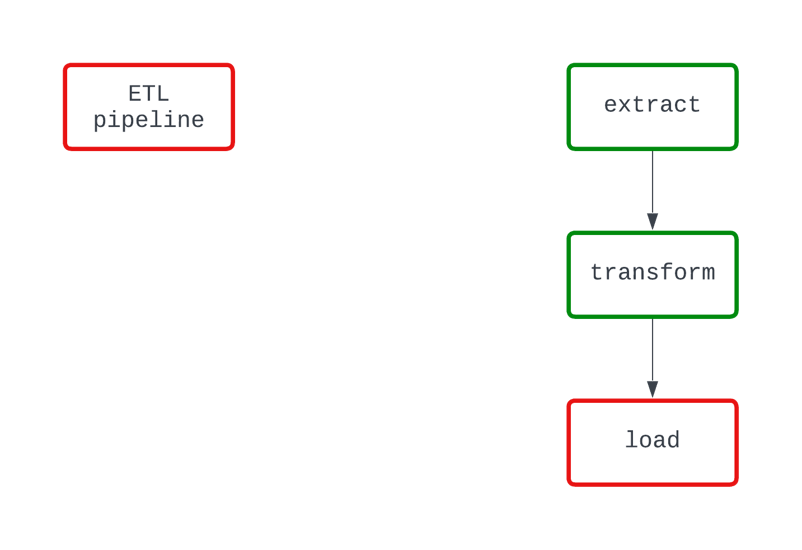
टास्क्स के साथ, Airflow मॉड्युलैरिटी को विज़ुअलाइज़ करना आसान बनाता है। एक ही टास्क में बहुत कुछ करने की कोशिश न करें। भले ही पूरा ETL पाइपलाइन एक टास्क में बनाया जा सकता है, इससे ट्रबलशूटिंग कठिन हो जाएगी। यह DAG के प्रदर्शन को विज़ुअलाइज़ करना भी मुश्किल बना देगा।
किसी टास्क को बनाते समय, यह सुनिश्चित करना महत्वपूर्ण है कि टास्क केवल एक ही काम करेगा, ठीक वैसे ही जैसे Python में फ़ंक्शंस करते हैं।
नीचे दिए गए उदाहरण पर नज़र डालें। दोनों DAGs एक ही काम करते हैं और कोड के एक ही बिंदु पर फ़ेल होते हैं। हालाँकि, बाएँ वाले DAG में यह स्पष्ट है कि load लॉजिक विफलता का कारण है, जबकि दाएँ वाले DAG से यह इतना स्पष्ट नहीं है।
डिटरमिनिज़्म
एक निर्धारक (deterministic) प्रक्रिया वह होती है जो समान इनपुट दिए जाने पर वही परिणाम देती है। जब कोई DAG किसी विशिष्ट इंटरवल के लिए चलता है, तो उसे हर बार वही परिणाम उत्पन्न करने चाहिए। यद्यपि यह डेटा पाइपलाइनों की एक अधिक जटिल विशेषता है, फिर भी सुसंगत परिणाम सुनिश्चित करने के लिए डिटरमिनिज़्म महत्वपूर्ण है।
Airflow के साथ, टेम्पोरल डेटा बनाने के लिए datetime.now() फ़ंक्शन का उपयोग करने के बजाय Jinja-टेम्प्लेटिंग का लाभ उठाकर टेम्प्लेटेड फ़ील्ड्स को Airflow ऑपरेटर्स में पास करें।
आइडेम्पोटेंसी
क्या होगा यदि आप किसी DAG को एक ही इंटरवल के लिए दो बार चलाएँ? 10 बार चलाएँ तो? क्या आपके लक्ष्य स्टोरेज माध्यम में डुप्लिकेट डेटा आ जाएगा? आइडेम्पोटेंसी सुनिश्चित करती है कि भले ही कोई डेटा पाइपलाइन कई बार निष्पादित की जाए, परिणाम ऐसा हो मानो पाइपलाइन केवल एक बार ही चली हो।
डेटा पाइपलाइनों को डिटरमिनिस्टिक बनाने के लिए, अपने DAGs में निम्न लॉजिक शामिल करने के बारे में सोचें:
- फ़ाइलों को ओवरराइट करें जब DAGs फिर से चलाए जाएँ, बजाय इसके कि उसी इंटरवल पर चलने पर अलग नाम की नई फ़ाइल बनाई जाए
- डिलीट-राइट पैटर्न का उपयोग करें ताकि डेटाबेस और डेटा वेयरहाउस में डेटा पुश किया जा सके,
INSERTकरने के बजाय, जो डुप्लिकेट्स का कारण बन सकता है।
Orchestration ट्रांसफ़ॉर्मेशन नहीं है
Airflow का उद्देश्य विशाल मात्रा में डेटा प्रोसेस करना नहीं है। यदि आप कुछ गीगाबाइट्स से अधिक डेटा पर ट्रांसफ़ॉर्मेशन चलाना चाहते हैं, तो काम के लिए Airflow अभी भी सही टूल है; हालाँकि, ट्रांसफ़ॉर्मेशन चलाने के लिए Airflow को किसी दूसरे टूल, जैसे dbt या Databricks, को इनवोक करना चाहिए।
आम तौर पर, टास्क्स या तो आपकी मशीन पर लोकली या प्रोडक्शन में वर्कर नोड्स के साथ निष्पादित होते हैं। किसी भी तरह, किसी भी कंप्यूटेशनल काम के लिए केवल कुछ गीगाबाइट्स मेमोरी ही उपलब्ध होगी।
बड़े डेटा को सँभालते समय, बहुत हल्के डेटा ट्रांसफ़ॉर्मेशन के लिए और ऑर्केस्ट्रेशन टूल के रूप में Airflow का उपयोग करने पर ध्यान दें।
उद्योग में Apache Airflow
डेटा पाइपलाइनों को कोड के रूप में परिभाषित करने की Airflow की क्षमता और इसके विस्तृत कनेक्टर्स व ऑपरेटर्स की विविधता के साथ, दुनिया भर की कंपनियाँ अपनी डेटा प्लेटफ़ॉर्म्स को शक्ति देने के लिए Airflow पर निर्भर करती हैं।
उद्योग में, कोई डेटा टीम SFTP साइट्स से लेकर क्लाउड फ़ाइल स्टोरेज सिस्टम और डेटा लेकहाउस तक, विभिन्न टूल्स के साथ काम कर सकती है। डेटा प्लेटफ़ॉर्म बनाने के लिए, इन अलग-अलग सिस्टम्स का इंटीग्रेशन अत्यावश्यक है।
एक सक्रिय ओपन-सोर्स कम्युनिटी के साथ, आपके डेटा टूलिंग को इंटीग्रेट करने में मदद करने के लिए हजारों प्री-बिल्ट कनेक्टर्स उपलब्ध हैं। S3 से Snowflake में कोई फ़ाइल डालना चाहते हैं? सौभाग्य से, S3ToSnowflakeOperator यह काम आसान बना देता है! Great Expectations के साथ डेटा क्वालिटी चेक्स कैसे? वह भी पहले से बना हुआ है।
यदि आपको काम के लिए सही प्री-बिल्ट टूल नहीं मिलता, तो भी कोई बात नहीं। Airflow एक्स्टेंसिबल है, जिससे आपकी ज़रूरतों को पूरा करने के लिए अपने कस्टम टूल्स बनाना आसान हो जाता है।
प्रोडक्शन में Airflow चलाते समय, आपको उस टूलिंग के बारे में भी सोचना होगा जिसका उपयोग आप इन्फ्रास्ट्रक्चर मैनेज करने के लिए कर रहे हैं। ऐसा करने के कई तरीके हैं—Astronomer जैसी प्रीमियम सेवाएँ, MWAA जैसे क्लाउड-नेटिव विकल्प, या फिर एक स्वनिर्मित समाधान।
आमतौर पर, इसमें लागत और इन्फ्रास्ट्रक्चर प्रबंधन के बीच समझौता शामिल होता है; अधिक महँगे समाधान का अर्थ हो सकता है कि मैनेज करने के लिए कम चीज़ें हों, जबकि सब कुछ एक ही EC2 इंस्टेंस पर चलाना सस्ता तो हो सकता है पर उसे बनाए रखना मुश्किल हो सकता है।
निष्कर्ष
Apache Airflow प्रोडक्शन में डेटा पाइपलाइनों को चलाने के लिए उद्योग-अग्रणी टूल है। शेड्यूलिंग, एक्स्टेंसिबिलिटी और ऑब्ज़र्वेबिलिटी जैसी क्षमताएँ प्रदान करते हुए और डेटा एनालिस्ट्स, साइंटिस्ट्स व इंजीनियरों को डेटा पाइपलाइनों को कोड के रूप में परिभाषित करने की अनुमति देकर, Airflow डेटा प्रोफ़ेशनल्स को व्यावसायिक प्रभाव बनाने पर ध्यान केंद्रित करने में मदद करता है।
Airflow के साथ शुरुआत करना आसान है, खासकर Astro CLI के साथ, और पारंपरिक ऑपरेटर्स व TaskFlow API आपके पहले DAGs लिखना सरल बनाते हैं। Airflow के साथ डेटा पाइपलाइनों का निर्माण करते समय, मॉड्युलैरिटी, डिटरमिनिज़्म और आइडेम्पोटेंसी को अपनी डिज़ाइन निर्णयों के केंद्र में रखें; ये सर्वोत्तम अभ्यास आगे चलकर सिरदर्द से बचाएँगे, विशेषकर जब आपके DAGs किसी त्रुटि से टकराएँ।
Airflow के साथ सीखने के लिए बहुत कुछ है। अपने अगले डेटा एनालिटिक्स या डेटा साइंस प्रोजेक्ट के लिए Airflow आज़माएँ। प्री-बिल्ट ऑपरेटर्स के साथ प्रयोग करें, या अपने खुद के बनाएँ। पारंपरिक ऑपरेटर्स और TaskFlow API के साथ टास्क्स के बीच डेटा साझा करना आज़माएँ। सीमाओं को आगे बढ़ाने से न डरें। यदि आप शुरू करने के लिए तैयार हैं, तो DataCamp का Introduction to Airflow in Python कोर्स देखें, जो Airflow की बुनियादों को कवर करता है और यह एक्सप्लोर करता है कि प्रोडक्शन में जटिल डेटा इंजीनियरिंग पाइपलाइनों को कैसे इम्प्लीमेंट किया जाए।
आप हमारा Introduction to Data Pipelines कोर्स भी शुरू कर सकते हैं, जो प्रभावी, उच्च-प्रदर्शन और विश्वसनीय डेटा पाइपलाइनों को बनाने के कौशल तराशने में मदद करेगा। अंत में, आप हमारे Airflow बनाम Prefect के तुलनात्मक लेख को भी देख सकते हैं, ताकि आपके लिए सर्वोत्तम टूल का चुनाव हो सके।
यदि आप और चाहते हैं, तो नीचे दिए गए कुछ संसाधन देखें। शुभकामनाएँ, और हैप्पी कोडिंग!
संसाधन
https://airflow.apache.org/docs/apache-airflow/stable/project.html
https://airflow.apache.org/blog/airflow-survey-2022/
https://airflow.apache.org/docs/apache-airflow/1.10.9/installation.html
https://docs.astronomer.io/astro/cli/get-started-cli
https://airflow.apache.org/docs/apache-airflow/stable/tutorial/taskflow.html
https://airflow.apache.org/docs/apache-airflow/stable/templates-ref.html
Apache Airflow क्या है?
Apache Airflow, या Airflow, प्रोडक्शन में आपकी डेटा पाइपलाइनों को चलाने के लिए एक ओपन-सोर्स टूल और फ़्रेमवर्क है। एक अग्रणी डेटा वर्कफ़्लो मैनेजमेंट टूल के रूप में, Apache Airflow डेटा प्रैक्टिशनर्स को अपनी डेटा पाइपलाइनों को कोड के रूप में परिभाषित करने के लिए Python का उपयोग करने देता है। Airflow पाइपलाइन निष्पादन को शेड्यूल करने और प्रदर्शन का अवलोकन करने की क्षमता जोड़ता है, जिससे यह आपके सभी डेटा वर्कफ़्लो के लिए एक केंद्रीकृत हब बन जाता है। चाहे आप किसी मॉडल के लिए प्रशिक्षण डेटा तैयार कर रहे हों या डेटा लेक में डेटा संरक्षित कर रहे हों, Airflow वह फ़ंक्शनलिटी जोड़ता है जो आपकी डेटा पाइपलाइनों को प्रोडक्शन-रेडी बनाती है।
Airflow को पहली बार 2014 में Airbnb में Maxime Beauchemin द्वारा बनाया गया था और बाद में मार्च 2016 में Apache Software Foundation के Incubator प्रोग्राम में शामिल किया गया, जिसके बाद 2019 में इसे टॉप-लेवल प्रोजेक्ट घोषित किया गया। Airflow के 2022 सर्वेक्षण के अनुसार, Airflow को हर महीने लाखों बार डाउनलोड किया जाता है, और हजारों बड़ी और छोटी कंपनियाँ इस टूल पर भरोसा करती हैं।