
Last chance! 50% off DataCamp Premium
Sale ends in
डेटा व्यवसायों और संगठनों के लिए आवश्यक है, और इतने सारे डेटा के प्रवाह को संगठित करने का काम डेटा पाइपलाइनों में चमकता है। तो, डेटा पाइपलाइनें क्या हैं, और अपनी खुद की पाइपलाइन बनाने के लिए आपको क्या जानना चाहिए?
डेटा आधुनिक व्यवसायों और संगठनों की जीवनरेखा है, जो निर्णय-निर्माण, इनसाइट्स, और नवाचार को आगे बढ़ाती है। हालांकि, डेटा का प्रबंधन और उसकी शक्ति का उपयोग करना जटिल और भयावह कार्य हो सकता है। यहीं पर डेटा पाइपलाइनें काम आती हैं। लेकिन डेटा पाइपलाइनें क्या हैं?
एक डेटा पाइपलाइन वह प्रणाली है जो विभिन्न स्रोतों से डेटा को प्राप्त करके उसे किसी नए स्थान, जैसे डेटाबेस, रिपॉजिटरी, या एप्लिकेशन, में पहुँचाती है और रास्ते में आवश्यक डेटा रूपांतरण (डेटा को एक फ़ॉर्मेट या संरचना से दूसरी में बदलना) करती है। इस पाइपलाइन के अंतिम उपयोगकर्ता विश्लेषकों से लेकर डेटा वैज्ञानिकों और व्यापार नेतृत्वकर्ताओं तक हो सकते हैं।
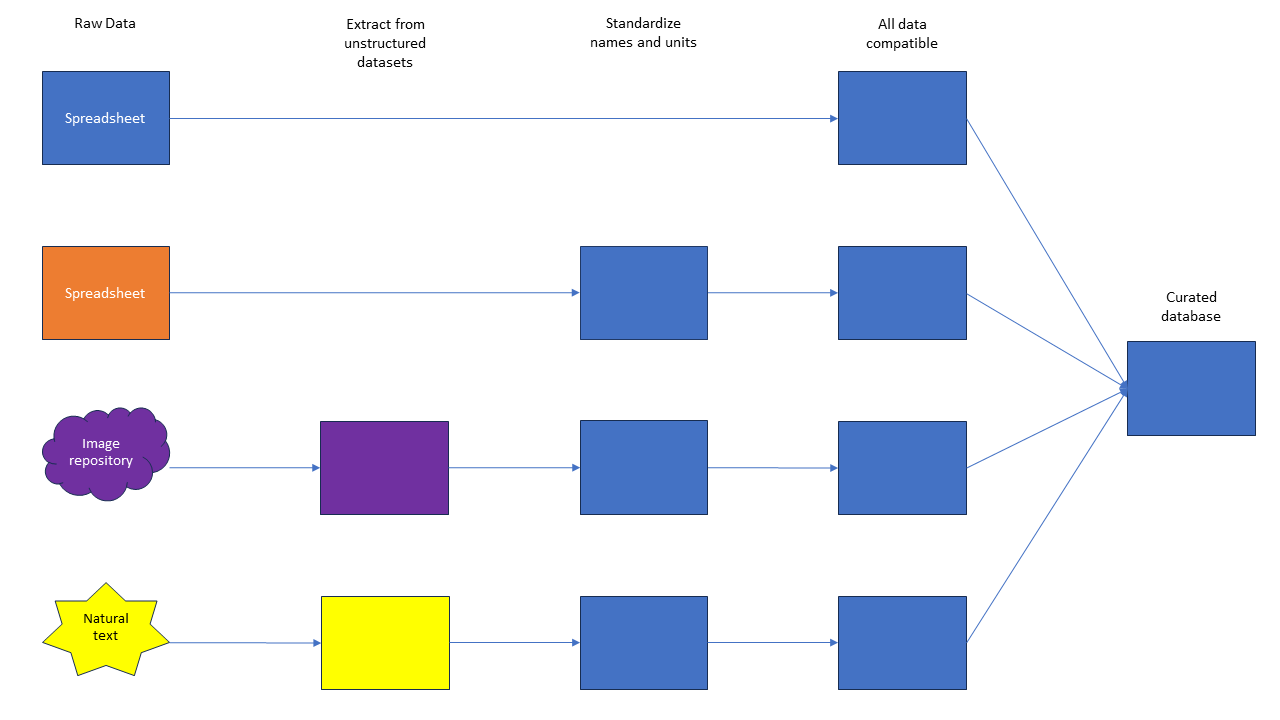
चित्र 1: एक सरल डेटा पाइपलाइन का उदाहरण। इस उदाहरण में, आपके पास चार डेटा स्रोत हैं: दो संरचित और दो असंरचित। चरणों की एक श्रृंखला के माध्यम से, आप असंरचित डेटा सेटों से संरचित डेटा निकालते हैं, सभी नामों और इकाइयों का मानकीकरण करते हैं, और जब सारा डेटा संगत हो जाता है, तो आप आवश्यक सभी जानकारी के साथ एक क्यूरेटेड डेटाबेस बना सकते हैं। इस डेटाबेस का उपयोग फिर विश्लेषकों, वैज्ञानिकों या व्यापार नेतृत्वकर्ताओं द्वारा किया जा सकता है।
हालाँकि यह एक सरल कार्य जैसा लगता है, इसमें कई सिरदर्द और निर्णय शामिल होते हैं। कई संगठनों में, पाइपलाइन बनाना और उनका रखरखाव करना डेटा इंजीनियरों द्वारा संभाला जाने वाला एक पूरा काम है। अन्य संगठनों में, यह डेटा वैज्ञानिक द्वारा किए जाने वाले अनेक कार्यों में से सिर्फ एक है। पाइपलाइन कौन रखता है, यह अक्सर संगठन के आकार, पाइपलाइनों की जटिलता, और उपलब्ध फंडिंग पर निर्भर करता है।
एक भरोसेमंद, सुरक्षित, और समय पर पाइपलाइन बनाना डेटा-आधारित निर्णय लेने का अहम हिस्सा है। चाहे आप डेटा इंजीनियरिंग करना चाहते हों या डेटा प्रक्रिया के किसी अन्य हिस्से में करियर बनाना चाहते हों, डेटा पाइपलाइनों को समझना आपके लिए लाभदायक रहेगा।
आप सोच रहे होंगे कि आपको पाइपलाइन बनाने की ज़रूरत ही क्यों है। यदि आप पहले से तैयार डेटा सेटों या केवल एक स्रोत से आने वाले डेटा के साथ काम कर रहे हैं, जैसा कि आपको Kaggle या DataCamp अभ्यासों में मिल सकता है, तो शायद आपको किसी पाइपलाइन की आवश्यकता नहीं पड़ी होगी। ये क्यूरेटेड डेटा सेट पहले से ही विश्लेषकों के लिए सीधे खींचने और काम करने हेतु सेटअप किए गए थे।
हालाँकि, यदि आप कई स्रोतों से जानकारी को संयोजित करना चाहते हैं, तो आपको यह सुनिश्चित करने के लिए एक पाइपलाइन सेटअप करनी पड़ सकती है कि आपका सारा डेटा आपके विश्लेषण के लिए सुलभ हो।
यहाँ कुछ प्रमुख कारण दिए गए हैं जिनकी वजह से आप डेटा पाइपलाइनें इस्तेमाल करने पर विचार कर सकते हैं:
उदाहरण के लिए, कल्पना करें कि आप जानना चाहते हैं कि किसी स्कूल जिले में छात्रों का औसत GPA किसी काउंटी की औसत आय या जनसंख्या आकार से सहसंबद्ध है या नहीं। इस विश्लेषण के लिए, आपको अपने अध्ययन में प्रत्येक स्कूल जिले से GPA डेटा, IRS से आय का डेटा, और Census Bureau से जनसंख्या आकार का डेटा खींचने की आवश्यकता हो सकती है।
आप यह जानकारी संभवतः एक बार मैन्युअल रूप से खींच सकते हैं। लेकिन कल्पना करें कि आपको यह विश्लेषण नियमित रूप से दोहराना है। एक विश्वसनीय पाइपलाइन बनाना इस जानकारी संग्रह को स्वचालित करने में मदद कर सकता है, जिससे आपका समय और सिरदर्द दोनों बचेंगे।
सिर्फ डेटा को एक जगह इकट्ठा करने के अतिरिक्त, पाइपलाइनें विभिन्न स्रोतों से आने वाले डेटा में असंगतताओं से निपटने में आपकी मदद कर सकती हैं। उदाहरण के लिए, Census Bureau काउंटी की पहचान पूर्ण नाम से कर सकता है, जबकि IRS संक्षिप्त नामों से काउंटी की पहचान कर सकता है।
पाइपलाइन के भीतर, आप अंतिम रिपॉजिटरी में काउंटी की पहचान के तरीके का मानकीकरण करने के लिए एक प्रणाली सेट कर सकते हैं। या, संभव है कि अलग-अलग प्रविष्टियों में जनसंख्या विभिन्न इकाइयों में अंकित हो, और आपको अपने अंतिम गंतव्य में प्रयुक्त इकाई प्रणाली का मानकीकरण करना पड़े। इस प्रकार के बदलावों को रूपांतरण कहा जाता है।
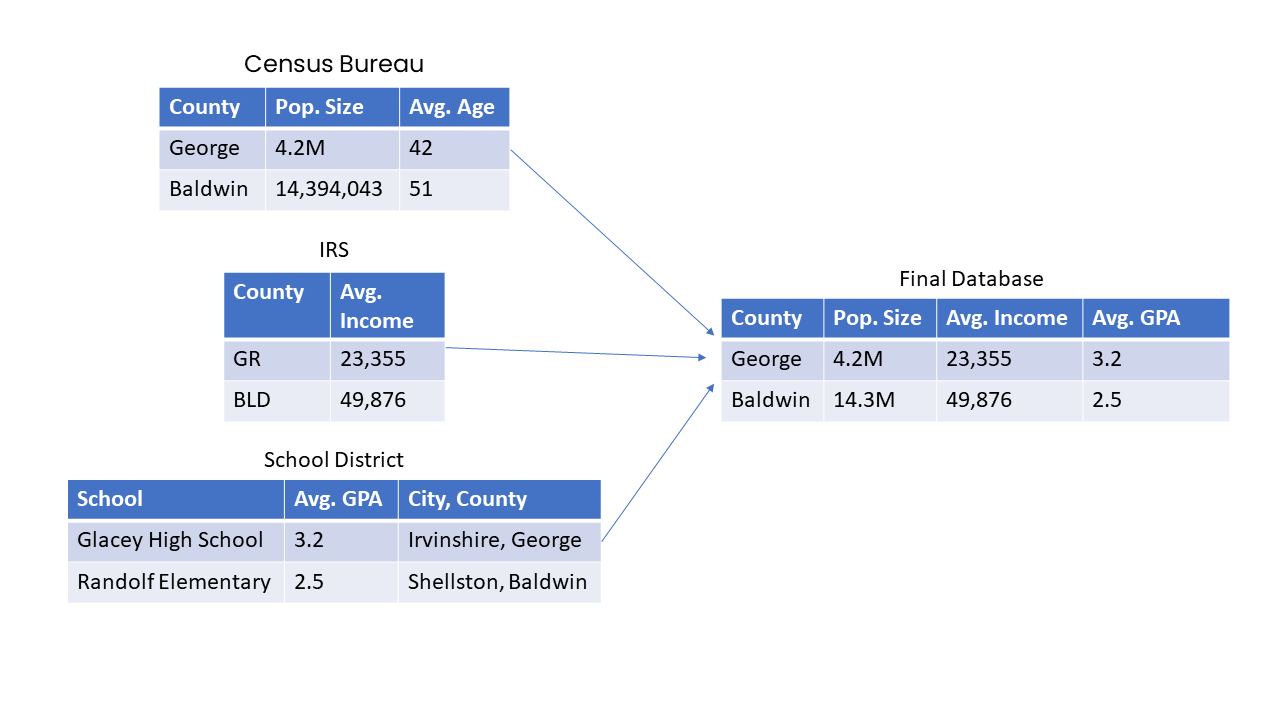
चित्र 2: विभिन्न स्रोतों से जानकारी मिलाते समय, इकाई परिवर्तन और मानकीकृत नाम जैसे रूपांतरण आवश्यक हो सकते हैं।
डेटा पाइपलाइनें आम तौर पर डेटा इंजीनियरों द्वारा विकसित और अनुरक्षित की जाती हैं।
एक बार जब पाइपलाइन के अंत में डेटा इकट्ठा, साफ, और व्यवस्थित हो जाता है, तो उसे विभिन्न हितधारकों द्वारा खींचा जा सकता है, जिनमें डेटा विश्लेषक, डेटा वैज्ञानिक, या बिज़नेस विश्लेषक शामिल हैं।
इसके बाद डेटा का उपयोग रीयल-टाइम एनालिटिक्स के लिए, एक अपडेटिंग डैशबोर्ड में डाला जाने के लिए, या किसी मशीन लर्निंग मॉडल में जोड़े जाने के लिए किया जा सकता है। कभी-कभी, पाइपलाइन का अंत किसी व्यवसायी नेता या व्यक्तिगत द्वारा उपयोग की जाने वाली एप्लिकेशन या डैशबोर्ड होता है।
पाइपलाइनें लगभग हर सेक्टर में प्रयोग होती हैं जो बड़े पैमाने पर डेटा का उपयोग करते हैं। कुछ बड़े संगठनों में, जैसे टेक सेक्टर में, उनकी पाइपलाइनें जटिल, कड़े नियमन के अधीन, और विशेष इंजीनियरों की टीम द्वारा प्रबंधित होती हैं।
छोटे संगठनों में, उदाहरण के लिए, दुनिया भर में कई सेंसरों से डेटा इकट्ठा करने की कोशिश कर रहा कोई एकल शोधकर्ता, पाइपलाइन बहुत सीधी और सरल हो सकती है, जिसमें कुछ ही चरण हों। अन्य उदाहरणों में जहाँ पाइपलाइनें इस्तेमाल हो सकती हैं, एक स्टॉक ब्रोकर जो यह तय करने के लिए वित्तीय जानकारी इकट्ठा कर रहा है कि कौन से स्टॉक खरीदे जाएँ, या कोई अस्पताल तंत्र जो अपने विभिन्न अस्पताल सहयोगियों से रोगी रिकॉर्ड इकट्ठा कर रहा है।
पाइपलाइनें मशीन लर्निंग मॉडलों के लिए भी महत्वपूर्ण हैं। ये मॉडल भारी मात्रा में डेटा का उपभोग करते हैं, और सुचारु रूप से चलने के लिए एक उचित पाइपलाइन अनिवार्य है। यह MLOps ट्यूटोरियल मशीन लर्निंग में पाइपलाइनों के उपयोग पर अधिक विवरण देता है।
डेटा को अलग-अलग तरीकों से संग्रहीत किया जा सकता है, जो डेटा के प्रकार और आपके इच्छित उपयोग पर निर्भर करता है। डेटा स्टोरेज के संदर्भ में आप जिन तीन शब्दों से शायद परिचित होंगे, वे हैं डेटा लेक, डेटाबेस, और डेटा वेयरहाउस। आइए संक्षेप में प्रत्येक पर नज़र डालें।
डेटा लेक एक बड़ा, लचीला स्टोरेज रिपॉजिटरी है जो बड़े पैमाने पर संरचित और असंरचित दोनों प्रकार का डेटा धारण कर सकता है। यह संगठनों को वेब लॉग, सेंसर, सोशल मीडिया, और अन्य स्रोतों से कच्चा, अप्रसंस्कृत डेटा उसके मूल रूप में स्टोर करने की अनुमति देता है।
डेटा लेक अपनी बहुमुखी प्रतिभा के लिए जाने जाते हैं, क्योंकि वे डेटा वैज्ञानिकों और विश्लेषकों को विभिन्न तरीकों से डेटा का अन्वेषण, रूपांतरण और विश्लेषण करने में सक्षम बनाते हैं। वे विशेष रूप से बिग डेटा और उन्नत विश्लेषिकी उपयोग मामलों के लिए मूल्यवान हैं जहाँ डेटा की स्कीमा और संरचना पूर्व-परिभाषित नहीं होती, जिससे संगठनों को विविध डेटा स्रोतों से इनसाइट्स निकालने की लचीलापन मिलता है।
डेटाबेस अधिक सामान्य-उद्देश्य वाले सिस्टम होते हैं जिनका उपयोग संरचित डेटा को कुशलतापूर्वक संग्रहीत, प्रबंधित और पुनः प्राप्त करने के लिए किया जाता है। यद्यपि वे डेटा वेयरहाउस से कुछ समानताएँ साझा करते हैं, डेटाबेस आम तौर पर लेनदेन संबंधी डेटा, दैनिक संचालन, और रीयल-टाइम एप्लिकेशन के लिए उपयोग किए जाते हैं। वे विभिन्न प्रकारों में आते हैं, जिनमें रेलेशनल डेटाबेस, NoSQL डेटाबेस, और इन-मेमोरी डेटाबेस शामिल हैं, जिनमें से प्रत्येक विशेष डेटा स्टोरेज और प्रोसेसिंग आवश्यकताओं के अनुरूप होता है। डेटाबेस डेटा अखंडता सुनिश्चित करते हैं, समवर्ती एक्सेस का समर्थन करते हैं, और डेटा क्वेरी करने और पुनः प्राप्त करने के लिए विभिन्न तंत्र प्रदान करते हैं।
दूसरी ओर, डेटा वेयरहाउस अत्यधिक संरचित और अनुकूलित रिपॉजिटरी होते हैं, जिन्हें मुख्य रूप से विश्लेषणात्मक उद्देश्यों के लिए संरचित डेटा को संग्रहीत, व्यवस्थित, और क्वेरी करने हेतु डिज़ाइन किया गया है। वे आम तौर पर पूर्व-परिभाषित स्कीमा का पालन करते हैं, डेटा गुणवत्ता और स्थिरता को लागू करते हैं, और जटिल क्वेरी और रिपोर्टिंग कार्यों के लिए अनुकूलित होते हैं।
डेटा वेयरहाउस उन व्यवसायों के लिए आदर्श हैं जो ऐतिहासिक डेटा के आधार पर सूचित निर्णय लेना चाहते हैं, क्योंकि वे मानकीकृत रिपोर्टिंग और विश्लेषिकी के लिए एकल स्रोत-ए-ट्रुथ प्रदान करते हैं। डेटा आमतौर पर विभिन्न स्रोतों से निकाला जाता है, एक सुसंगत फ़ॉर्मेट में रूपांतरित किया जाता है, और विश्लेषण के लिए डेटा वेयरहाउस में लोड किया जाता है।
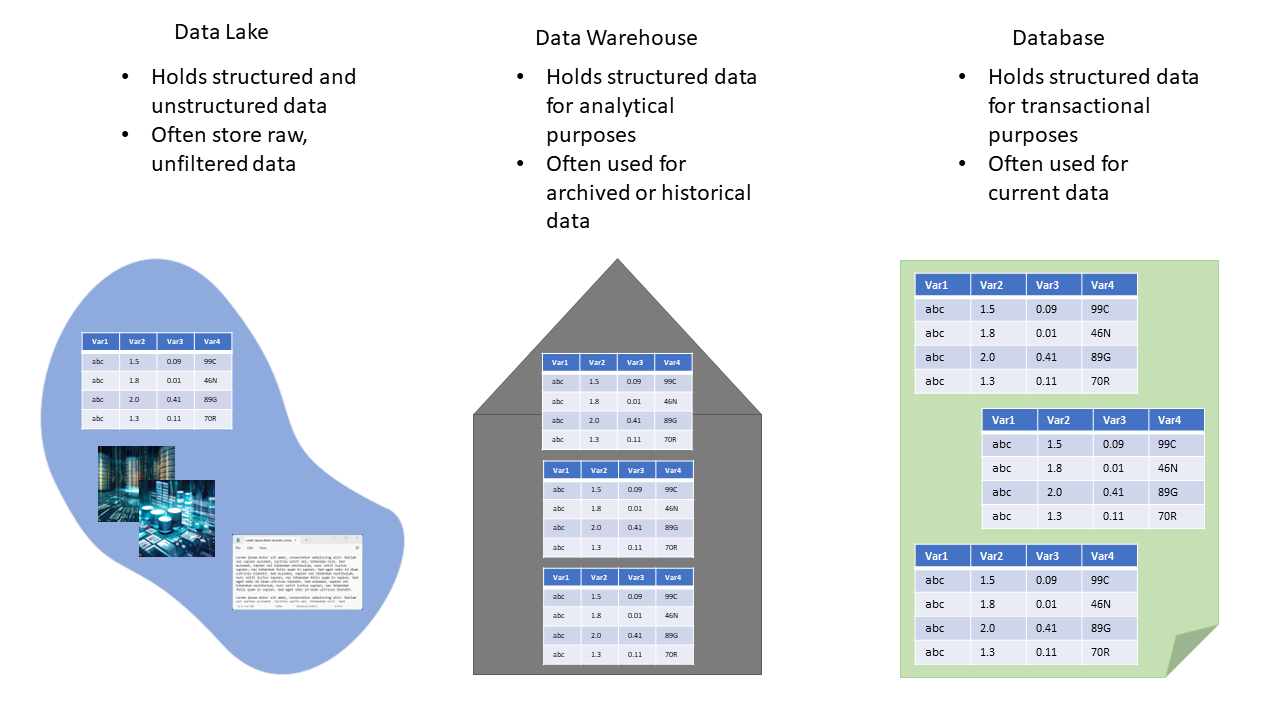
चित्र 3: डेटा लेक, डेटा वेयरहाउस, और डेटाबेस के बीच कुछ अंतर दर्शाते हुए। डेटा लेक का उपयोग पाइपलाइन में एक पूर्ववर्ती चरण के रूप में किया जा सकता है जो या तो वेयरहाउस या डेटाबेस में समाप्त हो सकती है।
पाइपलाइनें आमतौर पर दो मुख्य स्कीमा में से एक का पालन करती हैं: ETL (Extract, Transform, Load) या ELT (Extract, Load, Transform)।
ETL एक अनुक्रमिक दृष्टिकोण का पालन करता है। पहले, डेटा विभिन्न स्रोत प्रणालियों से निकाला जाता है, जिनमें डेटाबेस, फ़ाइलें, API, या अन्य डेटा रिपॉजिटरी शामिल हो सकते हैं।
निकाले जाने के बाद, डेटा को इच्छित स्कीमा, गुणवत्ता, और व्यावसायिक नियमों के अनुरूप रूपांतरित किया जाता है। इस रूपांतरण में डेटा की सफाई, एकत्रीकरण, और संरचना शामिल हो सकती है। अंततः, रूपांतरित डेटा को लक्ष्य डेटा वेयरहाउस या स्टोरेज सिस्टम में लोड किया जाता है, जो अक्सर रिपोर्टिंग और विश्लेषिकी के लिए अनुकूलित फ़ॉर्मेट में होता है।
जब डेटा को डेटा वेयरहाउस में संग्रहीत करने से पहले महत्वपूर्ण पुनर्संरचना या सफाई की आवश्यकता होती है, तो ETL लाभकारी होता है, क्योंकि यह सुनिश्चित करता है कि डेटा साफ़ है और विश्लेषण के लिए तैयार है। यह Python के साथ ETL पाठ्यक्रम Python और SQL का उपयोग करते हुए ETL का विस्तृत अवलोकन देता है।
ELT, दूसरी ओर, रूपांतरण चरण के क्रम को उलट देता है। ELT प्रक्रिया में, डेटा पहले स्रोत प्रणालियों से निकाला जाता है और बिना किसी महत्वपूर्ण रूपांतरण के यथावत डेटा वेयरहाउस, या कभी-कभी डेटा लेक, में लोड किया जाता है। डेटा का रूपांतरण और प्रोसेसिंग स्वयं डेटा वेयरहाउस के भीतर होती है।
यह दृष्टिकोण आधुनिक डेटा वेयरहाउस और बिग डेटा प्लेटफ़ॉर्म की प्रोसेसिंग शक्ति और लचीलेपन का लाभ उठाता है, जिससे वह ऐसे परिदृश्यों के लिए उपयुक्त बनता है जहाँ आप कच्चे डेटा की बड़ी मात्रा को संग्रहीत करना चाहते हैं और मांग पर रूपांतरण करना चाहते हैं।
ELT अक्सर तब पसंद किया जाता है जब आपके पास ऐसा डेटा वेयरहाउसिंग समाधान हो जो जटिल रूपांतरणों को कुशलतापूर्वक संभाल सके, जैसे क्लाउड-आधारित डेटा वेयरहाउस या Hadoop जैसे वितरित डेटा प्रोसेसिंग फ़्रेमवर्क।
पाइपलाइनें विकसित करने के लिए कई टूल उपलब्ध हैं। सही टूल चुनना आपकी पाइपलाइन के आकार, स्केलिंग की ज़रूरतों, उपलब्ध फंडिंग, और पाइपलाइन लक्ष्यों पर निर्भर करेगा। आप पूरी पाइपलाइन Python और SQL (या R और SQL) का उपयोग करके बना सकते हैं, या आप कई व्यावसायिक टूल में से कुछ का उपयोग कर सकते हैं।
यहाँ कुछ सामान्य व्यावसायिक प्रौद्योगिकियों और टूल का संक्षिप्त सूचीबद्ध विवरण है।
आप हमारे सर्वश्रेष्ठ ETL टूल की सूची और उन्हें क्यों चुनें, इस पर अलग लेख देख सकते हैं।
डेटा पाइपलाइन बनाने का पहला चरण वह डेटा एकत्र करना है जिसे पाइपलाइन में डाला जाना है। ऑनलाइन अद्यतन जानकारी प्राप्त करने के कई स्थान हैं, जिनमें सरकारी वेब पेज, सोशल मीडिया आउटलेट, और कुछ गैर-लाभकारी संगठन शामिल हैं। अक्सर, इनमें अपेक्षाकृत सरलता से उपयोग होने वाला API होता है।
API (एप्लिकेशन प्रोग्रामिंग इंटरफ़ेस) मूल रूप से वह सॉफ़्टवेयर है जो दो या अधिक एप्लिकेशनों के बीच संचार की अनुमति देता है। उदाहरण के लिए, आप अपने Python एप्लिकेशन में Twitter का API शामिल कर सकते हैं जो आपकी ओर से आपके एप्लिकेशन को ट्वीट पोस्ट करने या ट्वीट “पढ़ने” की अनुमति देगा। यह मूल रूप से एक मध्यस्थ है।
आप अपनी पाइपलाइन की शुरुआत में विभिन्न स्रोतों से डेटा एकत्र करने के लिए API का उपयोग कर सकते हैं। उदाहरण के लिए, आप किसी कंपनी के SEC से फाइलिंग डेटा इकट्ठा करने या NIH द्वारा रखी गई तालिकाओं से क्लिनिकल डेटा एकत्र करने के लिए API का उपयोग कर सकते हैं।
डेटा एकत्र करने की एक अन्य तकनीक वेब स्क्रैपिंग है। यह एक कस्टम-कोडेड स्क्रिप्ट का उपयोग करने की तकनीक है जिसे इंटरनेट पर किसी वेब पेज से जानकारी एकत्र करने के लिए डिज़ाइन किया जाता है। BeautifulSoup और Scrapy जैसी Python लाइब्रेरी इस प्रक्रिया को काफी आसान बनाती हैं, लेकिन फिर भी आपको आवश्यक जानकारी खोजने के लिए HTML या XML में नेविगेट करने में सक्षम होना चाहिए।
यदि आप वेब स्क्रैपिंग के बारे में अधिक जानना चाहते हैं, तो DataCamp के पास Python की Beautiful Soup, R का उपयोग करके वेब स्क्रैपिंग, और NLP के लिए वेब स्क्रैपिंग पर सामग्री उपलब्ध है।
वेब स्क्रैपिंग के लिए कोड-रहित सेवाएँ भी उपलब्ध हैं। यहाँ ऐसी ही एक सेवा है जो आपको किसी वेबपेज से जानकारी एकत्र करने और उस पेज में होने वाले परिवर्तनों की निगरानी करने देती है।
आपकी डेटा संग्रह प्रक्रिया में संरचित डेटा (जैसे स्प्रेडशीट या डेटाबेस) और असंरचित डेटा (जैसे पाठ या छवियाँ) का मिश्रण शामिल हो सकता है।
आपकी पाइपलाइन के अंतिम लक्ष्य पर निर्भर करते हुए, आप अपने असंरचित डेटा से जानकारी निकालकर एक समान रूप से संरचित डेटा सेट बना सकते हैं, या आप उसमें से कुछ को असंरचित ही छोड़ सकते हैं और केवल इतना सुनिश्चित कर सकते हैं कि अंतिम उपयोगकर्ता के लिए उचित क्रॉस-रेफ़रेंसिंग उपलब्ध हो।
संरचित डेटा को अक्सर SQL क्वेरी या ETL टूल का उपयोग करके निकाला जा सकता है, जबकि असंरचित डेटा के लिए प्राकृतिक भाषा संसाधन (NLP) तकनीकों या विशेष टूल की आवश्यकता हो सकती है।
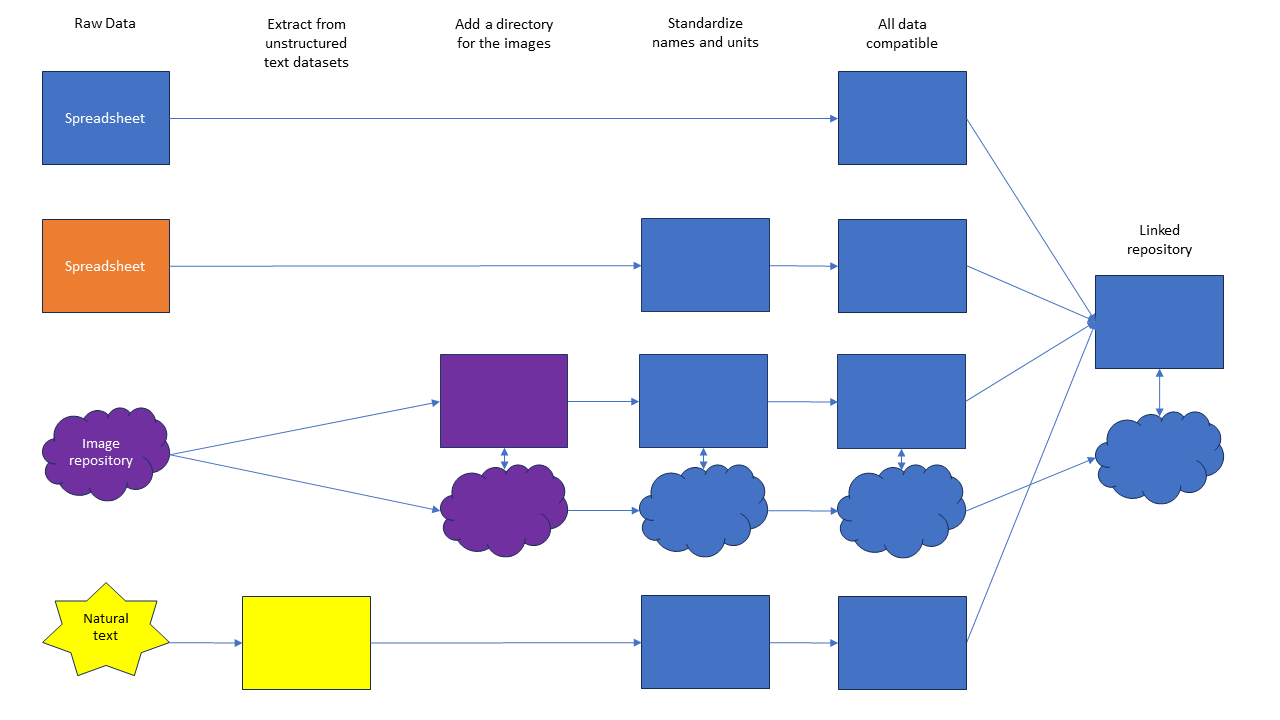
चित्र 4: अंत में असंरचित डेटा को यथावत छोड़ने वाली डेटा पाइपलाइन का उदाहरण। इस उदाहरण में, हम क्यूरेटेड संरचित डेटा और लिंक्ड छवियों का एक रिपॉजिटरी बनाना चाहते हैं। यह डेटा लेक भी हो सकता है। इसलिए, छवियों से संरचित डेटा निकालने के बजाय, हमने छवियों को डेटाबेस में प्रासंगिक डेटा से जोड़ने वाली एक निर्देशिका बनाई। अंतिम उपयोगकर्ता तब आवश्यकतानुसार स्प्रेडशीट की प्रत्येक पंक्ति के लिए कच्ची छवि खींच सकता है। वैकल्पिक रूप से, हम छवियों का विश्लेषण कर सकते थे और पृथक या हटाए गए भागों वाली छवि प्रदान कर सकते थे। यह कैसे करें, इस पर जानकारी के लिए यह इमेज विश्लेषण ट्यूटोरियल देखें।
एक बार जब आपके पास उपलब्ध डेटा स्रोत हों और मन में एक अंतिम लक्ष्य हो, तो आप अपनी पाइपलाइन सेट करना शुरू कर सकते हैं।
सबसे पहले आपको अपनी पाइपलाइन की योजना बनानी होगी। मैं सुझाव दूँगा कि पहले इसे कागज़ पर मैप करें। अपने कागज़ के सबसे बाएँ हिस्से में अपने डेटा स्रोत लिखें, और सबसे दाएँ हिस्से में अपना अंतिम लक्ष्य जोड़ें। बीच में, आप वे सारे चरण रख सकते हैं जिनकी आपको अपने स्रोतों से अपने अंतिम लक्ष्य तक पहुँचने के लिए आवश्यकता है।
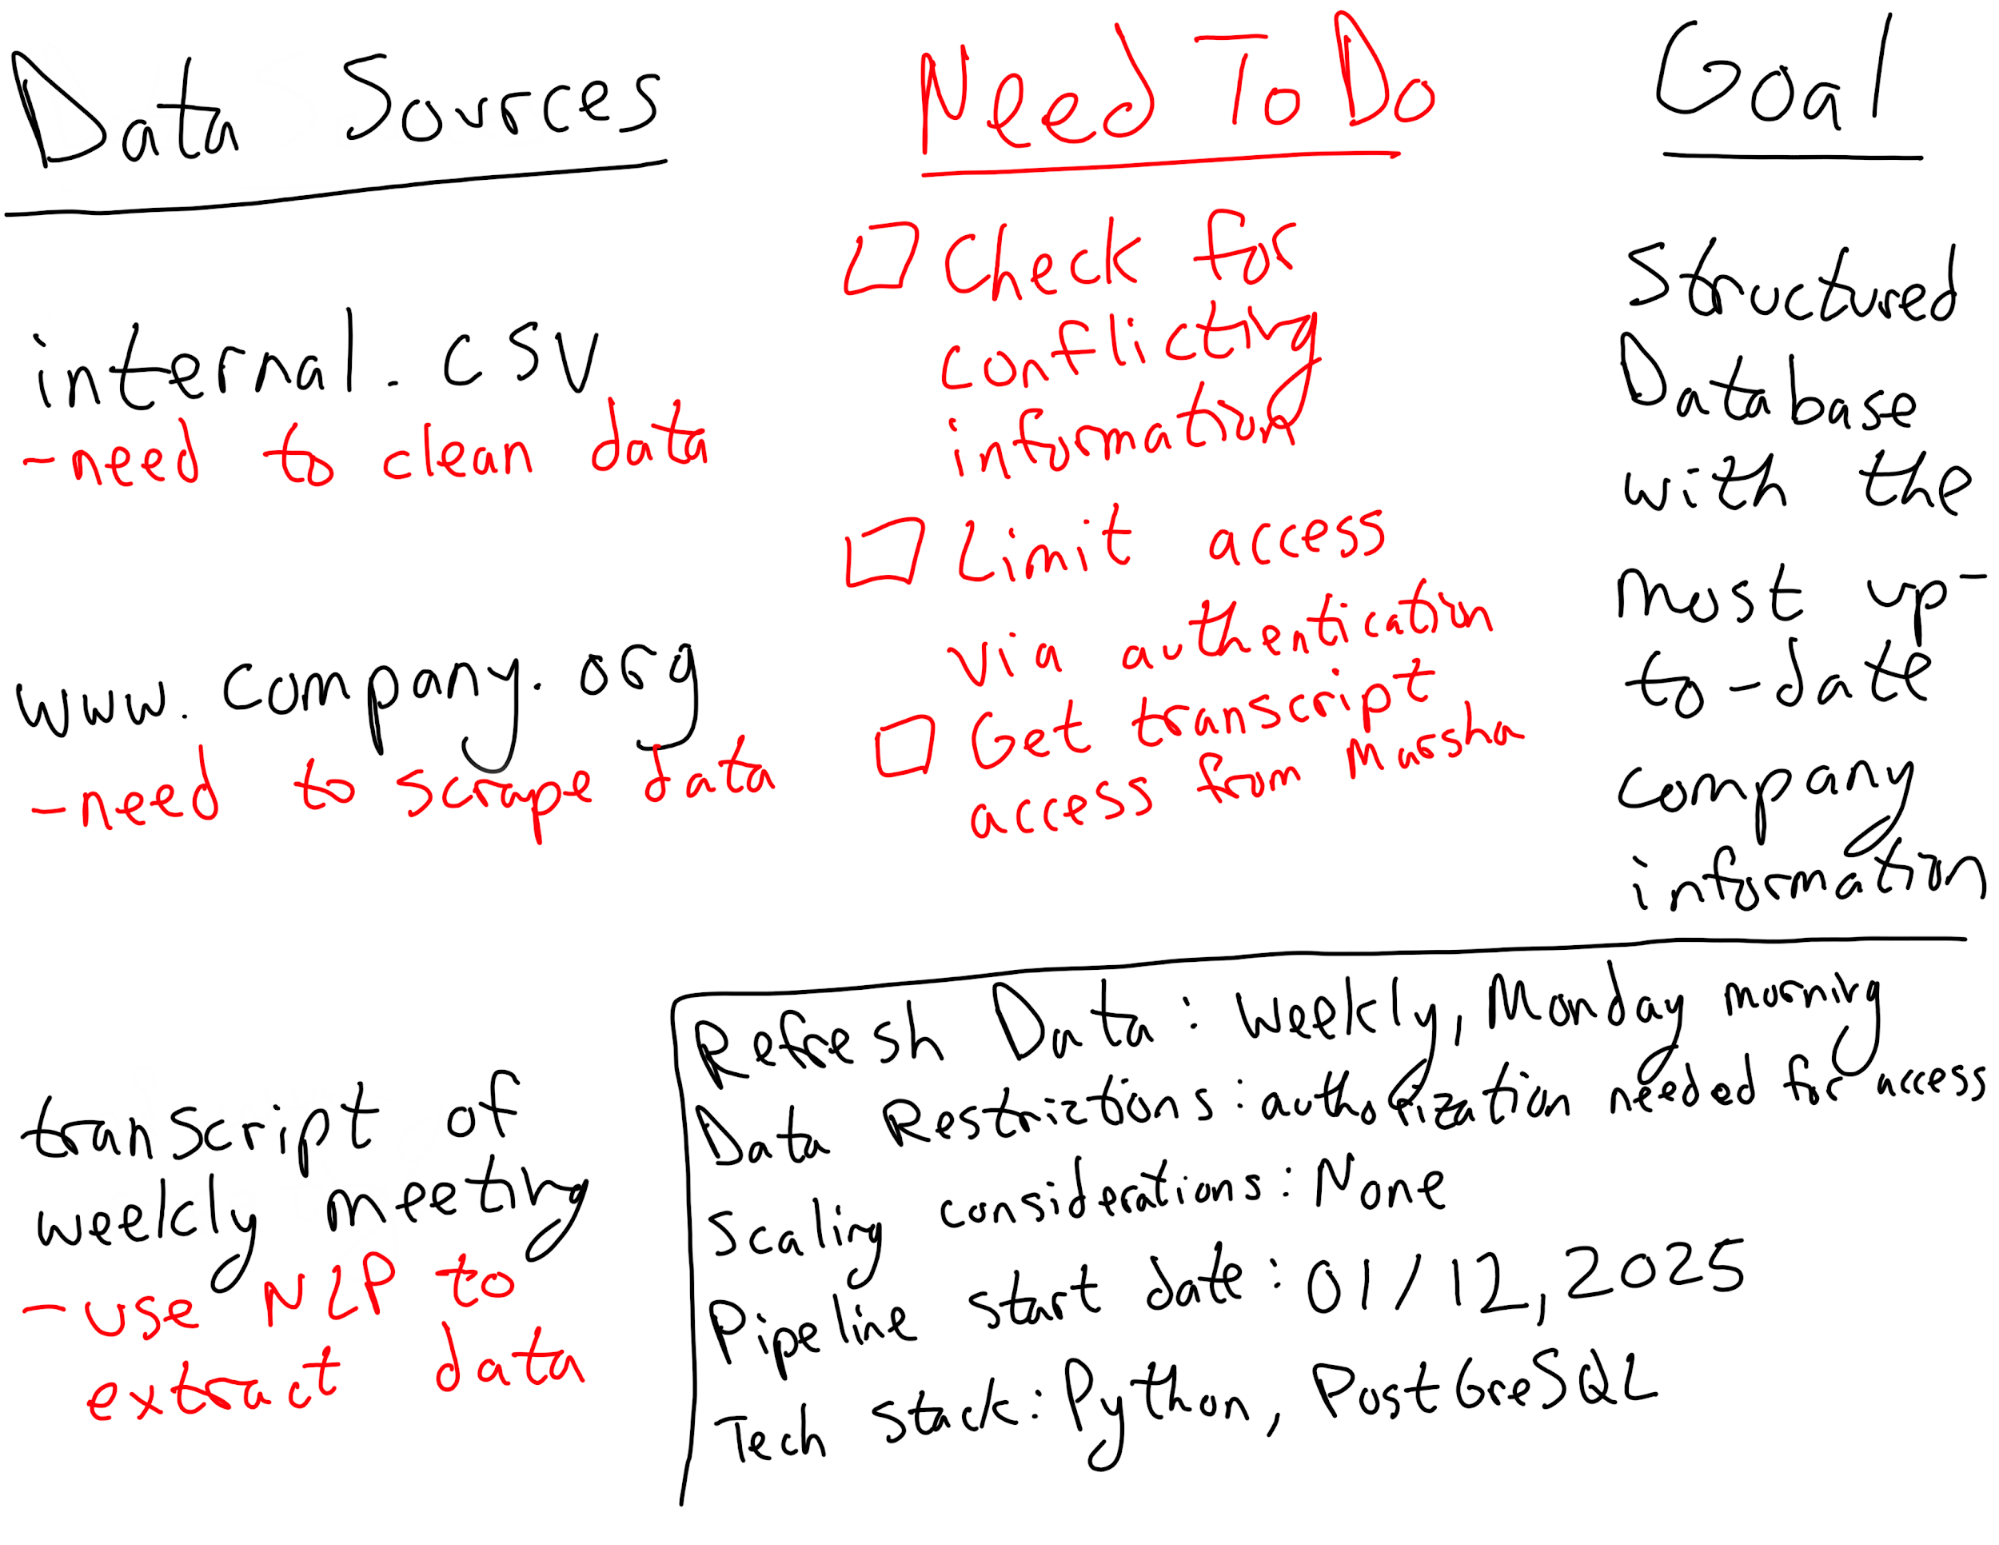
चित्र 5: पाइपलाइन के लिए उदाहरण योजना।
कुछ संभावित चरण जो आपको शामिल करने होंगे, वे हो सकते हैं:
एक बार जब आपने अपनी योजना मैप कर ली, तो आपको इसे बनाना शुरू करना होगा। यह पूरी तरह से आपकी पसंदीदा प्रोग्रामिंग भाषा में कोड किया जा सकता है, या इसमें एक या अधिक सेवाएँ शामिल हो सकती हैं जो पाइपलाइन का समर्थन करने के लिए डिज़ाइन की गई हैं। अपनी पाइपलाइन के निर्माण के दौरान हमेशा अपने अंतिम उपयोगकर्ता और उनकी आवश्यकताओं को ध्यान में रखना महत्वपूर्ण है।
एक अहम निर्णय जो आपको लेना होगा, वह है कि आप डेटा को कितनी बार अपडेट करना चाहते हैं। यदि सबसे अद्यतन जानकारी आवश्यक है, तो आपको रीयल-टाइम प्रोसेसिंग के लिए सुसज्जित पाइपलाइन सेट करनी होगी। हालाँकि, यदि इस स्तर की सटीकता आवश्यक नहीं है, तो आप संसाधन बचाने के लिए बैच प्रोसेसिंग पर विचार कर सकते हैं। इसका मतलब है कि डेटा निरंतर के बजाय बैचों में, जैसे साप्ताहिक या दैनिक, पाइपलाइन चरणों से गुज़रेगा।
अपनी पाइपलाइन बनाते समय ध्यान में रखने वाली एक और बात यह है कि आप आगे चलकर इसका रखरखाव कैसे करेंगे। आप पाइपलाइन के कार्यों की निगरानी करने, और किसी भी अप्रत्याशित समस्या का पता लगाने और उन्हें ठीक करने का तरीका बनाना चाहेंगे।
टाइपो, अधूरी या डुप्लिकेट प्रविष्टियाँ, और विभिन्न फ़ाइल प्रकार — ये कुछ ऐसी अनेक चुनौतियाँ हैं जिनका सामना आपकी पाइपलाइन को उसकी प्रारंभिक सेटअप के बहुत बाद भी करना पड़ सकता है। एक ठोस त्रुटि प्रबंधन और मॉनिटरिंग सिस्टम बनाना आपको बहुत सारे सिरदर्द से बचा सकता है।
डेटा पाइपलाइनें डिज़ाइन करने पर, विशेषकर मशीन लर्निंग संदर्भ में, अधिक विस्तृत नज़र के लिए, DataCamp का Designing Machine Learning Workflows in Python कोर्स देखें।
डेटा से जुड़ी हर चीज़ की तरह, अपनी पाइपलाइन को केवल उतना ही जटिल बनाना महत्वपूर्ण है जितनी आवश्यकता हो। सरल पाइपलाइनें बनाए रखना आसान और सस्ता होता है, अपडेट करना आसान होता है, और यदि आपको पाइपलाइन किसी अन्य इंजीनियर को सौंपनी पड़े तो उसे समझना भी सहज होता है।
पाइपलाइन के डिज़ाइन प्रक्रिया की शुरुआत में, प्रोजेक्ट की आवश्यकताओं का मूल्यांकन करना महत्वपूर्ण है, जिनमें भविष्य में संभावित स्केलिंग भी शामिल है। ऐसा करने से आपको आवश्यक जटिलता स्तर चुनने में मदद मिलेगी।
उदाहरण के लिए, यदि आपको कुछ महीनों के लिए तीन अलग-अलग सेंसरों से डेटा इकट्ठा करने हेतु एक अस्थायी पाइपलाइन चाहिए, तो आप Google Drive जैसे व्यापक रूप से उपलब्ध, निःशुल्क संसाधन का उपयोग करते हुए एक सरल एक-चरणीय पाइपलाइन पर विचार कर सकते हैं।
यदि, हालाँकि, आपके पास संवेदनशील डेटा है या आपको कई रूपांतरण करने की आवश्यकता है, तो आपको एन्क्रिप्शन के साथ Python या C# में कस्टम कोड बनाकर पाइपलाइन तैयार करनी पड़ सकती है।
अंततः, आप ऐसी पाइपलाइन सेट कर रहे हो सकते हैं जो अभी छोटी है, लेकिन आप अगले कुछ वर्षों में बड़े पैमाने पर विस्तार की उम्मीद करते हैं। इस स्थिति में, आप संभवतः ऐसी पाइपलाइन बनाना चाहेंगे जिसमें विस्तार को संभालने के लिए पर्याप्त अवसंरचना हो।
शुरुआत में एक छोटी पाइपलाइन डिज़ाइन करना आकर्षक लग सकता है, और बाद में आवश्यकता पड़ने पर बड़े पैमाने के लिए नई पाइपलाइन बनाने की योजना बनाना भी। यह काम कर सकता है, पर सावधान रहें!
कई डेटा इंजीनियरों को ऐसी पाइपलाइन की मरम्मत का काम सौंपा जाता है जो मौजूदा पैमाने के लिए डिज़ाइन नहीं की गई थी, क्योंकि नई पाइपलाइन बनाना बहुत महँगा या समय लेने वाला माना जाता है।
हालाँकि सादगी महत्वपूर्ण है, यदि आप दीर्घकालिक पाइपलाइन बना रहे हैं, तो अनुमानित विस्तार योजनाओं को ध्यान में रखकर उसे बनाना समझदारी होगी।
कुछ प्रश्न जो आप किसी प्रोजेक्ट की शुरुआत में पूछने पर विचार कर सकते हैं:
एक सामान्य जाल जिसमें जूनियर इंजीनियर फँस जाते हैं, वह है मौजूदा रुझानों के आगे झुक जाना, बजाय इसके कि काम के लिए सर्वोत्तम टूल का उपयोग करें।
ऐसा ही एक उदाहरण है कि कैसे कई कंपनियाँ बिना ठोस उपयोग मामले के अपनी टेक स्टैक में जनरेटिव AI को ठूँसने की कोशिश कर रही हैं।
एक डेटा प्रोफेशनल के रूप में, आपके लिए नई तकनीकों और रुझानों से अवगत रहना महत्वपूर्ण है। हालाँकि, यह सुनिश्चित करें कि आप अपने प्रोजेक्ट के लिए सर्वोत्तम टूल चुनें, न कि ऐसे रुझानों का अनुसरण करें जो एक कमजोर पाइपलाइन का कारण बन सकते हैं।
एक बार जब आपके पास अपनी पाइपलाइन की योजना हो, तो ऑप्टिमाइज़ेशन तरीकों पर विचार करना महत्वपूर्ण है। आप वह डेटा प्राप्त करना चाहते हैं जिसकी आपको आवश्यकता है, अपनी पसंद के रेज़ोल्यूशन और रिफ्रेश दरों के साथ, जबकि आपको जिन कंप्यूटिंग संसाधनों का उपभोग करना पड़े या पाइपलाइन के माध्यम से डेटा के चलने में जो समय देरी हो, उसे न्यूनतम रखना चाहते हैं।
पाइपलाइन ऑप्टिमाइज़ेशन का एक प्रमुख घटक पाइपलाइन के माध्यम से डेटा के प्रवाह की मॉनिटरिंग और लॉगिंग है। इससे आपको यह समझ मिलती है कि कहाँ बॉटलनेक डेटा प्रवाह को धीमा कर रहे हैं या अधिक कंप्यूटर संसाधनों का उपभोग कर रहे हैं।
सामान्य बॉटलनेक में धीमे डेटा स्रोत, संसाधन प्रतिबंध, या अक्षम डेटा रूपांतरण शामिल हो सकते हैं।
एक बार जब आपने बॉटलनेक की पहचान कर ली, तो आप प्रदर्शन को अनुकूलित करने के तरीकों पर विचार कर सकते हैं:
ऑप्टिमाइज़ेशन के लिए एक अन्य विचार डेटा की रिफ्रेश दर है। यदि डेटा आपकी पाइपलाइन के माध्यम से हर मिनट रिफ्रेश हो रहा है, पर आपको केवल हर पाँच मिनट में डेटा अपडेट चाहिए, तो अनावश्यक रिफ्रेश की संख्या घटाने से प्रोसेसर मुक्त हो सकते हैं और ऊर्जा खपत कम हो सकती है।
आपकी पाइपलाइनों से होकर बहने वाले कुछ प्रकार के डेटा में सुरक्षा या गोपनीयता संबंधी चिंताएँ हो सकती हैं। उदाहरण के लिए, चिकित्सीय डेटा पर अमेरिकी सरकार द्वारा कड़ा नियमन है और उसे मीडिया देखने की आदतों से संबंधित डेटा की तुलना में कहीं अधिक सुरक्षा उपायों की आवश्यकता होती है। अधिक सुरक्षा की आवश्यकता वाले डेटा के अन्य उदाहरण वित्तीय डेटा और पासवर्ड हैं।
आप जिन सुरक्षा उपायों का उपयोग करेंगे, वे उस प्रकार के डेटा के सुरक्षा संबंधी चिंताओं पर निर्भर करेंगे। कुछ मामलों में, अज्ञातकरण पर्याप्त हो सकता है, जिसमें व्यक्तिगत जानकारी को डेटा सेट से अलग कर दिया जाता है या हटा दिया जाता है। यह चिकित्सा अनुसंधान में उपयोग किया जा सकता है जहाँ व्यक्तिगत पहचान संबंधी जानकारी आवश्यक नहीं होती, लेकिन चिकित्सा रिकॉर्ड में अन्य जानकारी आवश्यक होती है।
अन्य सुरक्षा उपायों में एन्क्रिप्शन और लॉगिन प्राधिकरणों के माध्यम से डेटा तक पहुँच को नियंत्रित करना शामिल हो सकते हैं। इन तरीकों का उपयोग वित्तीय डेटा या कंपनी के गुप्त डेटा के लिए किया जा सकता है।
सभी संवेदनशील डेटा के साथ, सरकारी नियमों, जैसे GDPR (General Data Protection Regulation) या HIPAA (Health Insurance Portability and Accountability Act), से परिचित होना और उनका अनुपालन करना महत्वपूर्ण है।
आपके उद्योग और जिन प्रकार के डेटा आप संभालते हैं, उस पर निर्भर करते हुए, आपको CCPA (California Consumer Privacy Act) या FERPA (Family Educational Rights and Privacy Act) जैसे अतिरिक्त नियमों का भी अनुपालन करना पड़ सकता है।
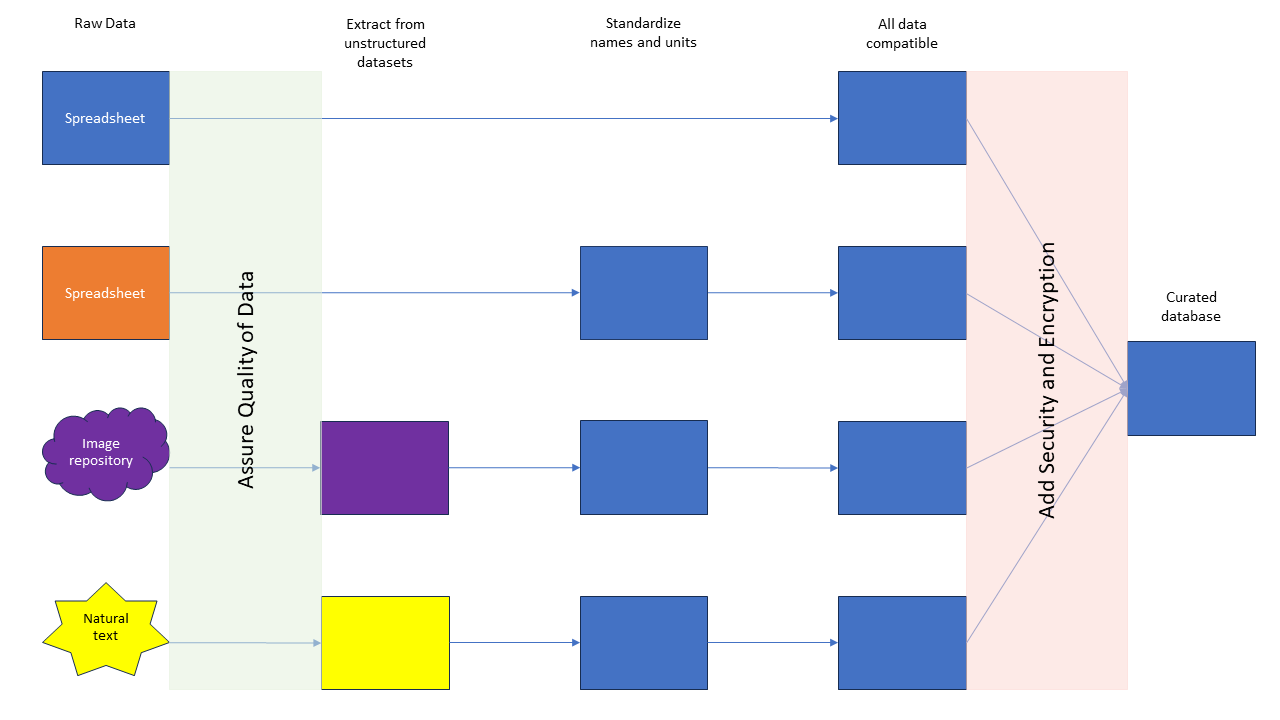
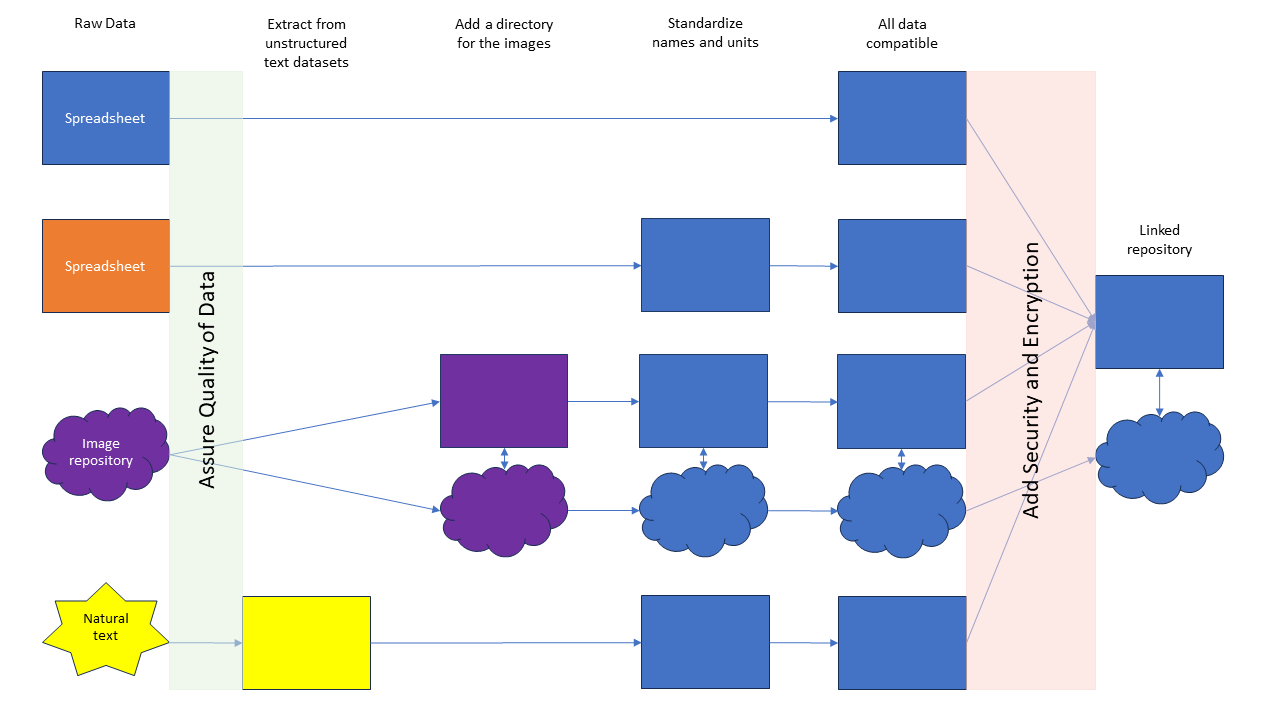
चित्र 6: पाइपलाइन में गुणवत्ता आश्वासन और सुरक्षा चरण जोड़ने का उदाहरण।
डेटा पाइपलाइनें और उन्हें बनाने वाले इंजीनियर डेटा जगत के अनसुने नायक हैं। वे डेटा को जगह-जगह बिना रुकावट के प्रवाहित होने देते हैं, उसे व्यवस्थित और छाँटते हैं। Statista के अनुसार, दुनिया ने सिर्फ 2020 में ही 64.2 ज़ेटाबाइट डेटा का सृजन, उपभोग और भंडारण किया, और यह आँकड़ा हर साल बढ़ता जा रहा है।
इस डेटा परिवेश में मज़बूत डेटा पाइपलाइनों का निर्माण और रखरखाव तेजी से महत्वपूर्ण हो रहा है। यदि इस ट्यूटोरियल ने डेटा पाइपलाइनों में आपकी रुचि जगाई है, तो अधिक गहन दृष्टि के लिए यह प्रारंभिक कोर्स देखें। यदि आप डेटा पाइपलाइन बनाना सीखने में रुचि रखते हैं, तो शुरुआत करने के लिए यह Python डेटा इंजीनियरिंग कोर्स देखें। और यदि आप अपना करियर शुरू करना चाहते हैं और नियोक्ताओं के समक्ष अपनी योग्यता सिद्ध करना चाहते हैं, तो हमारा डेटा इंजीनियर प्रमाणन देखें।
आज ही डेटा पाइपलाइन का उपयोग करना सीखना शुरू करें!
कोर्स
कोर्स
