Ada Perubahan Arsitektur yang Terjadi di Depan Mata
Selama beberapa tahun terakhir, sebagian besar orang memperlakukan AI seperti sebuah API.
Anda mengirim prompt, Anda mendapat respons, dan jika ingin terlihat canggih, Anda membungkusnya dengan retry dan sedikit logging lalu menyebutnya sistem. Itu bekerja untuk demo. Itulah yang membuat gelombang ini melaju begitu cepat. Namun pola itu berhenti berfungsi begitu Anda mencoba membangun sesuatu yang harus beroperasi dari waktu ke waktu.
Sistem AI produksi berperilaku lebih seperti proses daripada API.
Begitu Anda memperkenalkan kesinambungan, segalanya berubah. Anda tidak lagi menangani satu permintaan dan respons. Anda menangani rangkaian interaksi yang saling bergantung. Anda memerlukan memori dan status, dan Anda harus memutuskan apa yang penting sekarang, apa yang penting lima menit lalu, dan apa yang masih harus penting besok.
Dan begitu melewati batas itu, Anda menyadari ini bukan rekayasa prompt dalam skala besar.
Ini adalah desain sistem.
Yang sebenarnya Anda bangun bukanlah prompt yang lebih baik. Anda membangun sistem yang menentukan bagaimana konteks difilter dan berevolusi dari waktu ke waktu. Itulah disiplin yang muncul di sekitarnya. Itulah rekayasa konteks.
Konteks bukanlah prompt
Buka agen produksi apa pun di debugger Anda dan lihat apa yang sebenarnya dikirim ke model pada giliran tertentu. Hampir tidak pernah hanya pesan pengguna. Permintaan tipikal terlihat seperti ini:
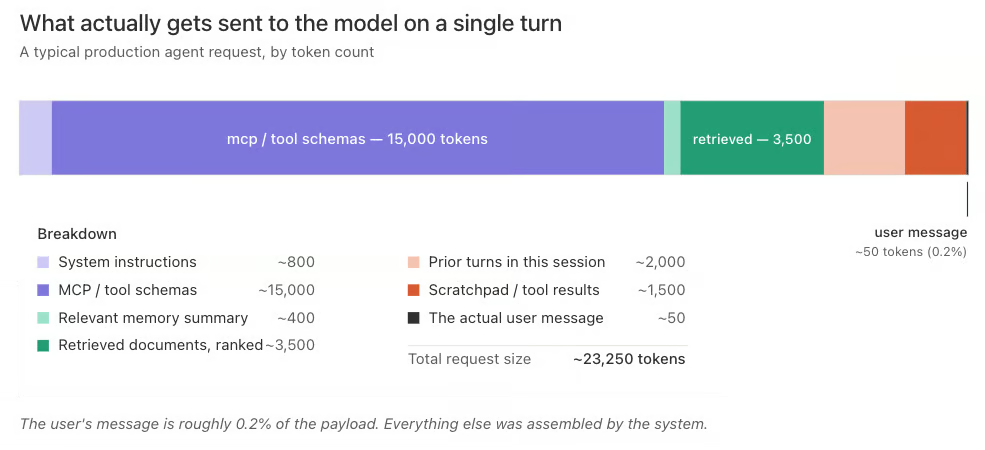
Pesan pengguna adalah bagian terkecil dari payload. Setiap blok lain difilter dan disuntikkan ke dalam prompt. Blok-blok itu adalah keluaran dari pipeline yang Anda rancang, bahkan jika Anda tidak menyadari bahwa Anda sedang merancangnya.
Pipeline itulah produk yang sebenarnya. Model adalah runtime. Rekayasa konteks adalah desain dari pipeline tersebut.
Setelah Anda menerima pembedaan itu, arsitekturnya tampak sangat berbeda.
Memori Bukan Satu Hal
"Tambah memori" adalah "tambah caching" yang baru. Kedengarannya seperti sebuah fitur, tetapi sebenarnya beberapa sistem berbeda yang kebetulan berbagi nama. Jika Anda tidak memisahkannya, Anda akan berakhir dengan satu blob store yang menjawab setiap pertanyaan dengan buruk. Pelupa di beberapa tempat, obsesif di tempat lain.
Irisan pertama adalah yang sudah diberikan ilmu kognitif, dan yang kebanyakan praktisi tuju: memori jangka pendek (STM) dan memori jangka panjang (LTM). Memori jangka pendek adalah apa pun yang saat ini berada di dalam jendela konteks, himpunan kerja yang dapat dilihat model pada giliran ini.
Memori jangka panjang adalah segala sesuatu yang bertahan lebih dari satu panggilan: fakta, artefak, rencana, keputusan sebelumnya, keluaran alat, dan aturan. Memori jangka pendek adalah masalah anggaran. Memori jangka panjang adalah masalah sistem.
Lima jenis di bawah ini semuanya memori jangka panjang, diorganisasi berdasarkan tujuannya dan bagaimana seharusnya disimpan. Mereka dipetakan ke taksonomi kanonik semantik, episodik, dan prosedural yang akan Anda lihat dalam kerangka yang terinspirasi ilmu kognitif seperti CoALA. Saya membagi dua dari kategori tersebut karena dalam produksi keduanya perlu diatur secara berbeda.
Memori kebijakan
Aturan dan batasan normatif. Biasanya bersifat global atau dibatasi per penyewa. Berversi dan dikendalikan ketat. Inilah yang diizinkan dilakukan sistem: aturan kepatuhan, pagar pengaman merek, batas keamanan. Jarang berubah dan dilakukan secara sengaja. Ini adalah memori prosedural dalam pengertian ilmu kognitif, aturan dan alur kerja yang membentuk perilaku lintas sesi. Kategori yang sama yang menampung berkas seperti CLAUDE.md atau AGENTS.md pada agen yang mengutamakan sistem berkas.
Memori preferensi
Parameter personalisasi yang stabil. Biasanya dibatasi per pengguna. Pengguna ini menginginkan respons JSON, pengguna itu lebih suka poin-poin, penyewa ini memformat tanggal DD/MM/YYYY. Memori preferensi membuat sistem terasa disesuaikan tanpa perlu diceritakan ulang di setiap sesi. Bersama dengan memori fakta di bawah, ini adalah lapisan semantik: pernyataan yang tahan lama dan dapat diquery tentang dunia dan isinya.
Memori fakta
Pernyataan tahan lama yang boleh digunakan ulang oleh agen. Harus mencakup asal-usul (provenance). “DB produksi pelanggan berada di us-east-1” adalah sebuah fakta. Begitu juga “tahun fiskal mereka dimulai pada April.” Fakta adalah tempat keunggulan yang bertumbuh-bertahap hidup, dan juga tempat persoalan desain paling sulit, karena setiap fakta yang Anda tulis adalah taruhan tentang masa depan. Saya memisahkan fakta dari preferensi karena jalur penulisan, profil pelapukan (decay), dan kebutuhan tata kelola yang berbeda, meski keduanya sama-sama memori semantik pada level kognitif.
Memori episodik
Ringkasan terstruktur dari pekerjaan yang telah selesai. Hal-hal seperti “kasus terselesaikan” atau “migrasi selesai.” Artefak yang dapat digunakan ulang yang didistilasi sistem dari jejak. Memori episodik memungkinkan sistem mengenali kita pernah melakukan ini sebelumnya dan mengambil kembali bentuk solusi terdahulu.
Memori jejak (trace)
Peristiwa eksekusi mentah yang hanya dapat ditambahkan. Ini adalah perekam penerbangan Anda. Volumenya tinggi, sebagian besar berguna untuk pengambilan dan pemutaran ulang, dan ini bukan tempat yang tepat untuk mencari tahu seperti apa seorang pengguna, hanya apa yang mereka lakukan. Pembedaan ini penting karena kebanyakan tim menyamakan keduanya dan akhirnya melakukan pencarian semantik di seluruh log eksekusi untuk menyimpulkan preferensi.
Dalam taksonomi yang lebih kasar, memori episodik dan jejak sama-sama berada di bawah payung episodik, termasuk transkrip percakapan, keluaran alat, dan riwayat run. Saya memisahkannya karena dalam produksi, aliran mentah dan ringkasan hasil distilasi memiliki pola akses, kebijakan retensi, dan profil biaya yang sangat berbeda. Memperlakukan keduanya sebagai satu hal adalah bagaimana tim akhirnya membayar harga basis data vektor untuk meng-grep log mereka.
Memori kerja tidak ada dalam daftar ini karena bukan memori jangka panjang. Itu adalah jendela konteks itu sendiri, himpunan kerja yang benar-benar dapat dilihat model pada giliran saat ini. Memori kerja nyata dan penting, dan banyak pekerjaan ML terapan yang paling sulit saat ini berada di sana: kompresi prompt, penggunaan ulang KV-cache, sliding-window attention, matematika anggaran untuk apa yang boleh menempati token-token tersebut.
Namun secara definisi ia bersifat sementara, dan menyamakannya dengan penyimpanan persisten di ataslah yang menghasilkan arsitektur di mana catatan coretan dan sistem pencatatan berbagi basis data. Tidak seharusnya. Memori kerja dirakit per giliran dari memori jangka panjang dan dibuang kecuali secara eksplisit dipromosikan. Langkah promosi adalah tempat kedua lapisan bertemu, dan di sanalah sebagian besar pekerjaan desain yang menarik terjadi.
Ketika seseorang berkata “agen kami punya memori,” tanyakan yang mana dari lima ini yang mereka maksud. Jika jawabannya “kami membuang semuanya ke vector store,” Anda baru saja menemukan alasan mengapa agen mereka terasa pelupa di beberapa tempat dan obsesif di tempat lain.
Loop, dan Apa yang Rusak di Dalamnya
Setiap sistem AI produksi pada akhirnya berkumpul pada bentuk yang sama: sebuah loop.
Bentuknya tidak kontroversial. Sebagian besar deskripsi loop agen mereduksi ke lima langkah yang sama: menyusun konteks, memanggil model, melakukan tindakan, mengamati hasil, dan memperbarui memori, lalu ulangi. Saya memberi label fase sedikit berbeda karena saya ingin memisahkan dua bagian dari “menyusun konteks” (apa yang Anda serap vs. apa yang Anda pilih) dan karena saya pikir promosi pantas mendapatkan namanya sendiri alih-alih dilipat ke dalam “memperbarui memori.”
Namun anatomi dasarnya sama, dan Anda akan melihat lima titik belok yang sama apakah Anda datang dari runtime agen, basis data, atau prompt.
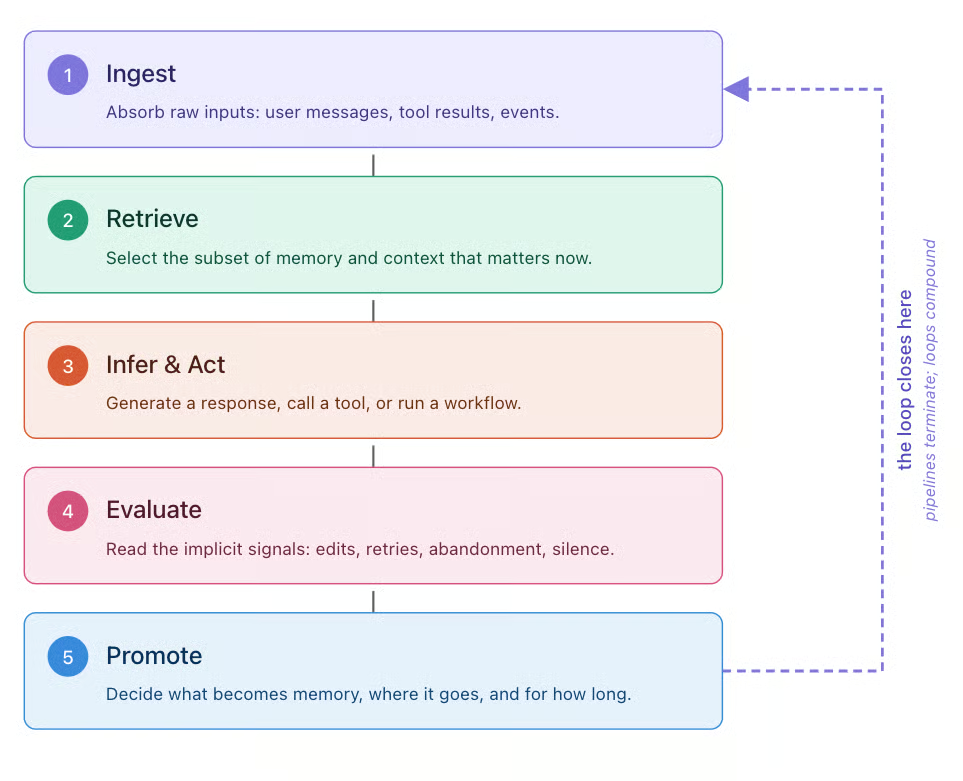
ReAct mempopulerkan penyelang-selingan penalaran dan tindakan pada 2022; sistem agen produksi sejak itu memperluas pola tersebut ke loop yang lebih luas di atas. Diagramnya membantu secara visual, tetapi mengetahui mode kegagalan dari setiap fase memberi tahu Anda di mana harus menghabiskan waktu rekayasa.
Injest
Ingest gagal saat Anda menerima terlalu banyak. Ingest adalah paruh pertama dari penyusunan konteks: menyerap masukan mentah dari lingkungan. Memperlakukan setiap peristiwa sebagai konteks potensial menciptakan kebisingan yang harus dibatalkan oleh retrieval nanti. Disiplin di sini ada pada batasnya. Apa yang Anda tolak untuk diserap?
Retrieve
Retrieve gagal secara senyap. Retrieve adalah paruh kedua dari perakitan konteks: memilih subset memori jangka panjang mana yang penting sekarang. Ia tidak melempar pengecualian saat mengembalikan potongan yang salah, ia hanya membuat model terdengar agak melenceng. Ini adalah fase yang paling kurang diinvestasikan dalam loop, dan yang paling berkorelasi erat dengan persepsi kualitas sistem.
Pencarian semantik murni adalah draf pertama. Untuk sebagian besar sistem produksi, baseline-nya adalah penyaringan metadata ditambah retrieval hibrida leksikal/semantik dengan reranking; setelah itu, dekomposisi kueri, penelusuran graf, dan retrieval multi-hop membantu ketika tugas bersifat komposisional, tetapi harus dibatasi oleh latensi dan anggaran evaluasi.
Infer & Act
Infer & Act gagal ketika konteks mendorong perilaku yang salah. Ini adalah memanggil model dan melakukan tindakan yang disatukan dalam satu fase, karena perencanaan dan pemanggilan alat keduanya merupakan konsekuensi dari apa yang membuat model memutuskan untuk dilakukan oleh konteks yang disusun. Di sinilah mode kegagalan konteks panjang menggigit: hilang di tengah, bias kebaruan (recency), pembusukan konteks.
Intuisinya adalah lebih banyak konteks seharusnya secara monoton meningkatkan respons. Anda memberi model lebih banyak informasi untuk dikerjakan, jadi Anda pikir hasilnya harus lebih baik. Dalam praktiknya, lebih banyak token sering kali membuat model lebih buruk. Penganggaran konteks kini menjadi disiplin nyata, dan naluri default “beri model semua yang kita punya” adalah jawaban salah yang default.
Evaluate
Evaluate adalah fase yang tidak dimiliki sebagian besar sistem sama sekali. Ini memperkenalkan umpan balik ke dalam sistem dengan mengamati hasil dari tindakannya. Anda ingin tahu apakah responsnya membantu, apakah alur kerja berhasil, dan apakah pengguna harus mengoreksinya.
Bahkan ketika umpan balik tidak ditangkap secara eksplisit, sinyal tetap ada. Beberapa yang bekerja baik di produksi: waktu ke pesan berikutnya (tindak lanjut yang cepat biasanya berarti jawabannya tidak tepat), jarak edit antara keluaran Anda dan versi yang sebenarnya dikirim atau disimpan pengguna (edit kecil adalah noise, edit besar adalah koreksi), dan pengabaian dalam N detik setelah hasil alat (pengguna melihat apa yang Anda hasilkan lalu pergi).
Tak satu pun dari ini mengharuskan pengguna menilai apa pun. Mereka hanya mengharuskan Anda menginstrumentasi apa yang sudah terjadi. Sinyal implisit ini ada di mana-mana, tetapi tidak ada apa pun di tumpukan yang mendengarkannya. Tanpa langkah ini, loop tidak tertutup: sistem berjalan tetapi tidak pernah belajar dari apa yang dihasilkannya.
Promote
Promote adalah fase yang paling mudah dibangun dengan salah. Promote adalah separuh dari memperbarui memori yang menangani penulisan kembali ke penyimpanan jangka panjang. Kebanyakan tim cenderung menulis berlebihan, membuang semuanya kembali dan meracuni penyimpanannya sendiri. Yang Anda butuhkan adalah kebijakan tertulis yang nyata yang menjawab enam pertanyaan:
- Apa yang ditulis?
- Pada granularitas apa?
- Ke jenis memori mana?
- Dengan asal-usul (provenance) apa?
- Dengan pelapukan (decay) seperti apa?
- Di bawah kewenangan siapa?
Ini adalah langkah tersulit untuk dilakukan dengan benar, dan juga yang paling krusial.
Pipeline berakhir. Loop bertumbuh-bertahap. Bedanya adalah Promote.
Anti-Pattern yang Mungkin Anda Kirimkan
Jika Anda telah membangun agen selama lebih dari beberapa bulan, hampir pasti Anda telah mengirimkan beberapa di antaranya. Eksperimen awal tim saya digigit oleh semuanya, itulah sebabnya saya tahu seperti apa bentuknya dari dalam.
- Membuang transkrip penuh pada setiap giliran: Ini adalah cara malas untuk mempertahankan status. Biayanya sangat mahal, cepat terkena pembusukan konteks, dan menurunkan kualitas respons dengan cara yang tidak terlihat hingga pengguna mengeluh. Peringkas pemadat yang berjalan di latar belakang bukanlah opsional pada skala besar, dan caching prompt harus disediakan untuk prefiks yang stabil (prompt sistem, definisi alat, blok kebijakan statis) dengan payload retrieval yang mudah berubah ditempatkan setelah bagian yang di-cache.
- Kelebihan konteks dalam strategi retrieval Anda: Padanannya di sisi retrieval adalah memperlakukan retrieval seperti wastafel dapur, menarik 20 potongan teratas dan berharap model menyortirnya. Nyatanya ia merata-ratakan, yang lebih buruk daripada memilih lima potongan yang bagus.
- Memperlakukan catatan coretan sebagai memori: Ini terjadi ketika hasil panggilan alat Anda, penalaran perantara, dan aset yang dihasilkan semuanya bocor ke penyimpanan jangka panjang karena tidak ada yang secara eksplisit membuangnya. “Memori” Anda sebagian besar adalah limbah.
- Satu penyimpanan memori untuk setiap jenis memori: Saat sistem menggunakan satu indeks vektor untuk semuanya: jejak, fakta, preferensi, kebijakan, dan ringkasan episodik semuanya dalam satu store, retrieval tidak dapat membedakan di antaranya dan model pun tidak.
- Memori yang tidak pernah lupa: Kebalikan dari kegagalan ini adalah memori yang tidak pernah lupa: tidak ada TTL, tidak ada pelapukan, tidak ada penggusuran. Hanya dalam beberapa bulan ini menjadi liabilitas alih-alih aset. Beberapa perilaku terbaik yang dapat Anda tambahkan ke sistem adalah kebijakan pelupaan yang agresif.
- Promosi berdasarkan jempol pengguna: Ini adalah jebakan karena sinyal umpan balik terkuat juga yang paling jarang dan paling bias. Sistem yang hanya mempromosikan pada sinyal positif eksplisit belajar mengoptimalkan untuk klik tombol alih-alih untuk kualitas sebenarnya.
- Tanpa pemutaran ulang (replay): Tanpa kemampuan replay, debugging menjadi tebak-tebakan. Anda tidak dapat mereproduksi sesi kemarin karena penyimpanan memori sudah bergerak. Ini adalah kelas bug yang merusak post-mortem.
Mengapa Ini Adalah Desain Sistem, Bukan Perasaan
Bagian yang pantas disebut “desain sistem” bukanlah model mentalnya. Ini soal pertukaran (trade-off), dan masing-masing memiliki jawaban yang salah yang lebih murah untuk dikirim tetapi lebih mahal untuk dijalani.
Ekonomi token kini menggerakkan arsitektur permintaan
Hit cache prompt biayanya sebagian kecil dari miss, sering kali hanya 10% dari harga input standar di API Anthropic dan model terbaru OpenAI, dan 25% di Gemini milik Google. Penetapan harga itu telah membentuk ulang apa yang rasional untuk ditempatkan di mana dalam sebuah permintaan, dan prefiks ramah-cache, skema alat yang stabil, serta instruksi sistem yang dipasak (pinned) bukan lagi pilihan kosmetik.
Itu menempatkan plafon penghematan di antara 4x dan 10x pada token input, bergantung pada penyedia, sebelum Anda menghitung penggandaan struktural dalam beban kerja agen, di mana prefiks yang sama dikirim ulang di setiap langkah. Dapatkan strategi cache dengan benar, dan agen yang terarsitektur baik berjalan beberapa kali lebih murah daripada yang terarsitektur buruk pada pekerjaan yang identik. Ini adalah hal terdekat yang dimiliki rekayasa AI dengan masalah cache-line, dan kebanyakan tim memperlakukannya seperti keputusan CSS.
Retrieval adalah masalah arsitektur
Lantai produksi bersifat hibrida (leksikal plus semantik), direranking, dengan penulisan ulang kueri. Plafonnya adalah retrieval agen, di mana model mengeluarkan dan menyempurnakan pencariannya sendiri di dalam loop. Jarak antara keduanya sangat besar, tak terlihat di tolok ukur, dan terlihat di setiap interaksi pengguna. Jika retrieval Anda hanya satu panggilan top-k, retrieval Andalah alasan agen Anda terasa bodoh.
Ruang lingkup konteks adalah batas keamanan
Isolasi multi-penyewa, sandboxing sub-agen, kebocoran lintas sesi. Ini bukan latihan pengerasan yang Anda lakukan nanti. Jika sub-agen dapat melihat himpunan kerja induknya secara default, Anda memiliki masalah yang menunggu terjadi, dan satu-satunya pertanyaan adalah apakah Anda yang menemukannya lebih dulu atau penyerang.
Evaluasi lebih sulit daripada kelas sistem mana pun sebelumnya
Sistem yang bertatus, stokastik, dan bergantung jalur tidak bisa diuji unit. Anda memerlukan evaluasi berbasis jejak, set retrieval emas, pemutaran ulang luring terhadap snapshot memori berversi, dan evaluator LLM-sebagai-juri yang juga berversi. Kebanyakan tim tidak memiliki semua ini dan terbang buta. Mereka mengetahui rilis terakhir menurunkan kualitas ketika ada pengguna yang memberi tahu.
Tata kelola tidak opsional, dan secara teknis lebih sulit dari yang Anda kira
Hak untuk dilupakan di bawah GDPR menjadi tidak sepele begitu “hal yang tahu tentang pengguna” adalah fakta yang diturunkan dari seratus interaksi. Apa artinya menghapus data pengguna dari sistem yang sudah menyerapnya ke dalam memori fakta? EU AI Act menambah lapisan lain di atasnya, dengan sebagian besar kewajibannya (termasuk tata kelola data, pengawasan manusia, dan persyaratan transparansi untuk sistem berisiko tinggi) mulai berlaku pada Agustus 2026.
Tim yang mengirimkan produk AI ke Eropa pada paruh kedua 2026 akan membutuhkan jawaban atas pertanyaan yang belum diselesaikan secara kolektif oleh bidang ini: bagaimana cara membuktikan penghapusan kontribusi pengguna terhadap fakta turunan, bagaimana mengaudit garis keturunan (lineage) promosi memori, bagaimana menunjukkan bahwa penyimpanan memori dilingkupkan seperti yang Anda klaim.
Jawaban siapa pun belum bagus. Tetap harus berfungsi, dan regulator tidak akan menunggu industri untuk mencari solusinya.
Inilah mengapa rekayasa konteks adalah tentang desain sistem dan bukan rekayasa prompt. Sebagian besar pekerjaan menarik terjadi di koneksi antar sistem, tempat konteks diteruskan dari satu tahap ke tahap lain. Hampir tidak ada yang ada di prompt itu sendiri. Dan hampir setiap trade-off di atas memiliki jalan pintas yang terlihat murah yang bertumbuh menjadi utang teknis yang akan Anda bayar kembali pada saat terburuk.
Ke Mana Lapisan Memori Sedang Berkumpul
Setelah Anda menerima bahwa memori adalah lima hal berbeda dengan beberapa pola akses berbeda, pertanyaan jelas berikutnya adalah: di mana semuanya berada?
Retrieval hibrida, artinya leksikal plus semantik dalam satu sistem, sebagian besar sudah menjadi masalah yang terselesaikan saat ini. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate, dan ekstensi vektor untuk Postgres semuanya mendukung beberapa versinya, dan celah kualitas produksi di antara mereka lebih sempit daripada yang disarankan pemasaran vendor. Jika seluruh lapisan memori hanyalah “embedding dan pencarian teks penuh,” pertanyaan arsitektur akan membosankan.
Bukan, karena memori bukan hanya retrieval. Lihat kembali lima jenis itu dan perhatikan apa yang sebenarnya dibutuhkan masing-masing dari penyimpanannya.
|
Jenis Memori |
Apa yang dibutuhkan dari sebuah penyimpanan |
|
Kebijakan |
Relasional. Aturan berversi, lingkup penyewa, foreign key ke pengguna dan peran, pembaruan transaksional. |
|
Preferensi |
Terstruktur dan dibatasi per pengguna. Baris atau JSON yang diindeks ke pengguna, skema yang dapat diprediksi. |
|
Fakta |
Retrieval hibrida berfaedah di sini. Pernyataan tahan lama dengan asal-usul, dapat diquery baik dengan kemiripan semantik maupun kecocokan persis pada entitas atau sumber. |
|
Episodik |
Ringkasan terstruktur dengan retrieval di atasnya. |
|
Jejak |
Penyimpanan peristiwa tambah-saja, volume tinggi, dengan indeks vektor dilapiskan untuk pemutaran ulang dan retrieval. |
Arsitektur tidak sengaja yang Anda dapatkan memisahkan ini di sepanjang sumbu yang paling menyakitkan. Data relasional hidup di Postgres atau padanannya yang terkelola. Retrieval hibrida hidup di Elasticsearch, OpenSearch, atau vector store khusus seperti Pinecone, Weaviate, atau LanceDB.
Jejak berakhir di S3 atau basis data deret waktu. Masing-masing merupakan pilihan kuat untuk pekerjaan yang dibangunnya, dan banyak tumpukan produksi menggunakannya dengan baik. Masalahnya bukan pada komponen individual. Masalahnya adalah setiap jalur retrieval yang bermakna menjadi join lintas sistem: “temukan fakta yang relevan dengan kueri ini, difilter oleh kebijakan yang berlaku untuk penyewa ini, dilingkupkan ke pengguna yang boleh dilihat agen ini.” Join itu melintasi tiga batas: kepercayaan, transaksi, dan latensi. Setiap kali konteks melintasi salah satu batas tersebut, Anda memperkenalkan kembali masalah konsistensi yang persis ingin Anda hindari.
Di sinilah gambar arsitektur berubah. Retrieval hibrida dalam penyimpanan yang sama dengan data relasional adalah kapabilitas pembedanya, dan itu adalah masalah yang berbeda dari retrieval hibrida saja. Retrieval hibrida sebagai fitur semakin tersedia di mana-mana.
Yang kurang umum adalah kolokasi data relasional, dokumen, dan vektor di bawah satu batas transaksional dan keamanan, sehingga memori kebijakan, preferensi, fakta, dan episodik dapat diquery bersama dengan jaminan ACID alih-alih direkonsiliasi lintas sistem.
Oracle AI Database adalah salah satu contoh pendekatan multi-model yang terkonsolidasi ini: tabel relasional, dokumen JSON, dan embedding vektor berada dalam satu mesin, dapat diquery bersama dalam satu pernyataan SQL, di dalam satu transaksi. Setelah Anda menganggap serius taksonomi lima jenis dan mulai menggambar join antara kebijakan, preferensi, dan fakta, pertanyaannya bergeser dari mesin retrieval mana yang terbaik menjadi di mana seharusnya data relasional yang mengatur retrieval itu tinggal.
Dalam praktiknya ini terlihat seperti satu pernyataan SQL yang melakukan join data kebijakan relasional, preferensi berformat JSON, dan kemiripan vektor atas memori fakta. Kueri yang sebaliknya akan melintasi tiga sistem ini runtuh menjadi satu:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Satu pernyataan itu melakukan empat hal sekaligus: menegakkan kebijakan penyewa, menghormati preferensi pengguna, menerapkan kontrol akses per fakta, dan memberi peringkat berdasarkan kemiripan semantik. Dalam arsitektur federasi, itu adalah empat perjalanan pulang-pergi melintasi tiga penyimpanan berbeda, dengan model konsistensi yang harus Anda pertahankan sendiri.
Di sini itu satu rencana kueri, satu batas transaksi, satu tempat untuk diaudit. Jaminan ACID yang sama yang menjadikan basis data sebagai sistem pencatatan untuk status bersama sejak 1970-an, kini diterapkan pada memori yang kebetulan mencakup vektor di samping baris.
Contoh kerja dari pola ini, termasuk RAG agen dengan pencarian hibrida dan buku catatan tentang arsitektur memori untuk rekayasa konteks, tersedia di AI Developer Hub Oracle di GitHub.
Anda tetap akan menginginkan penyimpanan khusus untuk beberapa hal. Memori jejak dengan volume tinggi memiliki karakteristik daya tahan dan biaya yang berbeda dari basis data operasional Anda. Penyimpanan blob untuk aset besar seperti dokumen, gambar, dan artefak model berada di tempat yang dibangun untuk itu. Basis data dokumen khusus mungkin masih masuk akal untuk alur kerja dokumen yang diperkeras di mana Anda memerlukan fitur spesifik dari kategori tersebut.
Intinya bukan bahwa platform terpadu menghilangkan setiap penyimpanan lain. Intinya adalah ia menghilangkan join yang paling mahal: antara data relasional yang mengatur apa yang boleh dilakukan agen dan data vektor yang membentuk apa yang sebenarnya dilakukan agen. Ketika keduanya ditempatkan bersama, masalah arsitektur bergeser dari “bagaimana saya menjaga penyimpanan ini tetap sinkron” menjadi “bagaimana saya merancang kebijakan memori yang baik,” yang merupakan masalah yang benar-benar penting.
Tujuh Prediksi untuk Tahap Berikutnya
Bagian di atas menggambarkan di mana kita berada. Ini adalah taruhan tentang ke mana kita akan pergi. Sengaja bersifat beropini. Tidak setuju saja dengan yang Anda tidak setujui.
1. Model tidak menjadi memori
Kisah yang menggoda adalah penyedia model menyerap memori ke dalam model itu sendiri. Jendela konteks memanjang, caching menjadi lebih pintar, dan lapisan memori eksternal menjadi tidak perlu. Itu tidak akan terjadi. Jendela konteks akan terus bertambah, tetapi tetap memerlukan priming pada setiap giliran. Model tetap tanpa status setiap sesi, dan lapisan memori eksternal tetap menjadi sistem pencatatan. Yang berubah adalah memori eksternal menjadi jauh lebih pintar (vector store dan platform hibrida hari ini, hal-hal yang belum kita bangun nanti), dan rekayasa konteks menjadi kerajinan untuk memutuskan apa yang dilihat model, kapan, dan mengapa. Jika penyedia terdepan mengirimkan primitif yang secara kredibel menggantikan sistem memori eksternal untuk penggunaan produksi, prediksi ini salah. Saya bertaruh sebaliknya.
2. Infrastruktur memori melampaui biaya inferensi untuk produk AI yang matang
Biaya inferensi turun kira-kira satu orde besaran setiap 18 bulan. Penyimpanan, retrieval, pembuatan embedding, reranking, dan perakitan konteks per permintaan tidak. Mereka berskala dengan jumlah pengguna, kedalaman sesi, dan riwayat interaksi, semuanya meningkat. Baris tagihan cloud dominan bergeser dari token GPU ke infrastruktur retrieval vektor dan hibrida. Ini membentuk ulang pertanyaan bangun vs beli. Infrastruktur memori tidak menjadi komoditas seperti lapisan model. Tim yang menang jangka panjang adalah yang memperlakukan infrastruktur memori sebagai investasi kelas satu sejak hari pertama.
3. RAG klasik menjadi arsitektur warisan
“Embed dokumen, top-k pada kueri pengguna, masukkan ke prompt” adalah COBOL-nya arsitektur AI. Ia bekerja, ada di mana-mana, dan akan memalukan jika dilihat ke belakang. Penggantinya sudah terlihat: retrieval agen, di mana model merencanakan pencariannya sendiri, mengeluarkan kueri bertahap, membaca hasil perantara, dan memutuskan apa yang akan diambil selanjutnya. Ini terlihat kurang seperti pencarian basis data dan lebih seperti proses penelitian. Tim yang masih membangun pipeline RAG statis hari ini sedang berada di jalur migrasi, entah mereka sadar atau tidak.
4. Memori menjadi permukaan adversarial
Serangan memori bertumbuh-bertahap dengan cara yang tidak dilakukan injeksi prompt. Lawan yang bisa menulis ke penyimpanan memori berumur panjang, entah secara langsung atau melalui saluran input yang tidak Anda anggap istimewa, dapat membentuk perilaku sistem itu untuk setiap pengguna di masa depan yang disentuhnya. Eksfiltrasi bekerja serupa sebaliknya: konteks dari satu sesi bocor ke sesi lain karena model pelingkupan ceroboh. Insiden peracunan memori serius di dunia nyata pertama akan datang. Kerja cepat industri pada asal-usul, atestasi, dan kontrol akses per fakta akan menyusulnya.
5. Batas privasi konteks menjadi persyaratan kepatuhan
Langkah logis berikutnya dari “ruang lingkup konteks adalah batas keamanan” adalah isolasi kriptografis segmen memori, sehingga agen hanya dapat mengungkap konteks berdasarkan kebutuhan untuk tahu. Ini penting saat Anda memiliki sub-agen dengan tingkat kepercayaan berbeda, atau rezim regulasi yang memerlukan pelingkupan yang terbukti atas fakta sensitif. Harapkan temuan audit industri teregulasi pertama yang mengutip “isolasi tidak memadai antara ruang lingkup memori agen” menjadi pemicunya, dengan kerangka kepatuhan menyusul segera setelahnya. Tim yang sudah memiliki pelingkupan kriptografis di peta jalan akan memenangkan RFP yang bergantung padanya. Tim yang tidak akan memasangnya di bawah tekanan tenggat waktu.
6. Konsistensi multi-agen menjadi kapabilitas yang dinamai dan diharapkan
Hari ini, agen penagihan dan agen dukungan yang menyentuh akun pelanggan yang sama bisa menghasilkan jawaban yang bertentangan karena mereka menarik irisan memori yang berbeda dan tidak ada yang merekonsiliasikannya. Itu masih bisa ditoleransi sekarang karena sebagian besar penerapan produksi adalah agen tunggal. Saat sistem multi-agen masuk produksi dalam skala, pengguna akan mulai menangkap kontradiksi tersebut, dan “konsistensi kontekstual” akan menjadi kapabilitas bernama yang diperebutkan platform. Ini akan muncul di matriks perbandingan vendor terlebih dahulu, lalu di daftar periksa pengadaan perusahaan. Menyelesaikannya lebih awal menjadi pembeda. Mengabaikannya berarti menghadapi tiket dukungan tentang mengapa dua agen Anda sendiri tidak setuju tentang pelanggan yang sama.
7. “Konteks berguna per kapita” menjadi metrik yang dibenchmark
Tolok ukur akan berpindah dari model ke seluruh sistem, dan metrik utama akan berupa sesuatu seperti konteks berguna yang dibawa per pengguna, per interaksi. Inilah angka yang benar-benar memprediksi retensi pengguna dan jarak antara produk yang terasa mengenal Anda dan yang terasa seperti di-reset setiap Selasa. Perhatikan ini di dek investor sebelum muncul di makalah akademik. Metrik berkorelasi, biaya per token konteks berguna, akan menjadi pertanyaan unit economics yang layak dijawab.
Apa yang Harus Dilakukan pada Hari Senin
Jika Anda baru dalam hal ini dan ingin tempat untuk mulai: berhenti memperlakukan memori sebagai satu hal. Pilih satu agen produksi yang Anda akses, beri label jenis memori apa yang sebenarnya ditampung oleh masing-masing penyimpanannya, dan perhatikan seberapa sering satu penyimpanan digunakan untuk tiga pekerjaan.
Jika Anda sudah membangun agen: instrumentasikan loop-nya. Secara khusus, instrumentasikan sinyal antara retrieval dan promosi. Saya telah melihat banyak tim yang dapat memberi tahu Anda apa yang di-retrieve sistem mereka pada giliran tertentu. Jauh lebih sedikit yang dapat memberi tahu Anda memori mana dari yang di-retrieve itu yang benar-benar digunakan model, dan hampir tidak ada yang dapat memberi tahu Anda mengapa memori tertentu dipromosikan sejak awal.
Mengetahui memori mana yang digunakan memungkinkan Anda memperkuatnya pada langkah promosi berikutnya, yang merupakan cara sistem memori berhenti menjadi log tulis-sekali dan mulai benar-benar belajar.
Loop umpan balik itulah tempat keunggulan yang bertumbuh-bertahap hidup, dan di sanalah pekerjaan menarik pada rentang disiplin ini berikutnya terjadi.
Setiap tim mendapatkan model terdepan yang sama dalam kurun waktu yang kurang lebih sama. Yang tidak bisa disalin orang lain adalah lapisan memori yang Anda bangun di sekelilingnya: yang dibentuk oleh pengguna Anda, keputusan Anda, dan penilaian Anda tentang apa yang layak diingat.
Model bersifat bersama. Sistem memori adalah milik Anda.