Es findet ein Architekturwechsel statt – direkt vor unseren Augen
In den letzten Jahren haben die meisten KI wie eine API behandelt.
Du schickst einen Prompt rein, bekommst eine Antwort raus, und wenn du es „professionell“ machst, packst du Retries und ein wenig Logging dazu – und nennst es ein System. Für Demos ging das durch. So konnte diese Welle so schnell shippen. Aber das Muster bricht zusammen, sobald du etwas bauen willst, das über längere Zeit stabil funktionieren muss.
Produktive KI-Systeme verhalten sich eher wie Prozesse als wie APIs.
In dem Moment, in dem du Kontinuität einführst, ändert sich alles. Es geht nicht mehr um eine einzelne Anfrage mit Antwort. Du hast eine Abfolge von Interaktionen, die voneinander abhängen. Du brauchst Gedächtnis und Zustand und musst entscheiden, was jetzt zählt, was vor fünf Minuten wichtig war und was morgen noch wichtig sein soll.
Und ab da merkst du: Das ist kein Prompt Engineering in groß.
Das ist Systems Design.
Du baust nicht einfach einen besseren Prompt. Du baust ein System, das bestimmt, wie Kontext gefiltert wird und sich über die Zeit weiterentwickelt. Das ist die neue Disziplin. Das ist Context Engineering.
Kontext ist nicht der Prompt
Öffne einen produktiven Agenten im Debugger und schau dir an, was in einem beliebigen Turn wirklich ans Modell gesendet wird. Es ist fast nie nur die Nachricht des Nutzers. Eine typische Anfrage sieht in etwa so aus:
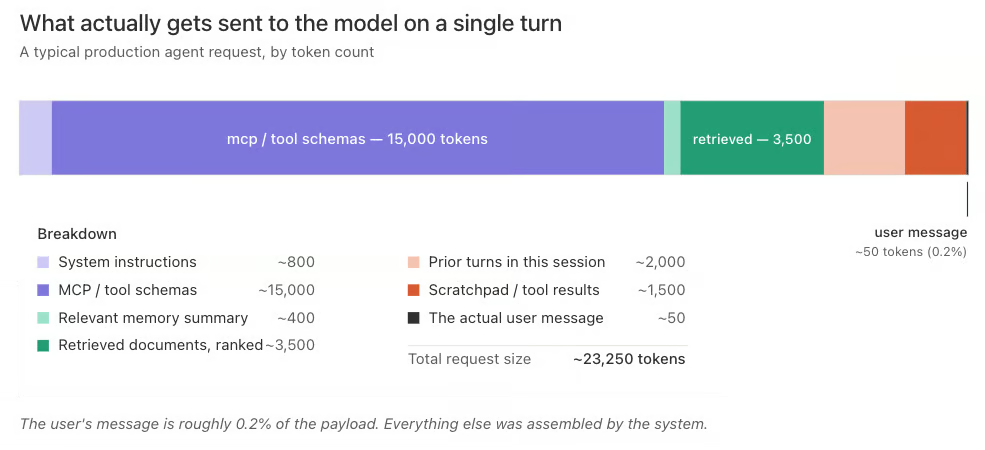
Die Nutzernachricht ist der kleinste Teil der Payload. Alle anderen Blöcke wurden gefiltert und in den Prompt injiziert. Diese Blöcke sind das Ergebnis einer Pipeline, die du entworfen hast – selbst wenn dir nicht klar war, dass du eine entwirfst.
Diese Pipeline ist das eigentliche Produkt. Das Modell ist die Laufzeitumgebung. Context Engineering ist das Design dieser Pipeline.
Wenn du diese Unterscheidung akzeptierst, sieht die Architektur plötzlich ganz anders aus.
Gedächtnis ist nicht nur eine Sache
„Mehr Gedächtnis hinzufügen“ ist das neue „Caching hinzufügen“. Es klingt wie ein Feature, ist aber in Wahrheit eine Handvoll unterschiedlicher Systeme mit demselben Namen. Wenn du sie nicht trennst, landest du bei einem einzigen Blob-Store, der jede Frage schlecht beantwortet – hier vergesslich, dort zwanghaft.
Der erste sinnvolle Schnitt kommt aus der Kognitionswissenschaft und darauf steuern die meisten Praktiker zu: Kurzzeitgedächtnis (STM) und Langzeitgedächtnis (LTM). Kurzzeitgedächtnis ist alles, was aktuell im Kontextfenster liegt – der Arbeitssatz, den das Modell in diesem Turn sieht.
Langzeitgedächtnis ist alles, was über einen einzelnen Aufruf hinauslebt: Fakten, Artefakte, Pläne, frühere Entscheidungen, Tool-Ausgaben und Regeln. Kurzzeitgedächtnis ist ein Budgetthema. Langzeitgedächtnis ist ein Systemproblem.
Die fünf Typen unten sind alle Langzeitgedächtnis – geordnet nach Zweck und Speicherform. Sie entsprechen der kanonischen semantischen, episodischen und prozeduralen Taxonomie aus kognitionswissenschaftlichen Frames wie CoALA. Zwei Kategorien teile ich weiter auf, weil sie in der Praxis unterschiedlich gesteuert werden müssen.
Policy Memory
Normative Regeln und Einschränkungen. Typisch global oder mandantenweit. Versioniert und streng kontrolliert. Das ist, was das System darf: Compliance-Regeln, Brand-Guardrails, Sicherheitsgrenzen. Ändert sich selten und bewusst. Das ist prozedurales Gedächtnis im kognitionswissenschaftlichen Sinn – Regeln und Workflows, die das Verhalten über Sessions hinweg prägen. Dieselbe Kategorie, die bei „Filesystem-first“-Agenten Dateien wie CLAUDE.md oder AGENTS.md enthält.
Preference Memory
Stabile Personalisierungsparameter. Meist nutzerbezogen. Dieser Nutzer möchte JSON-Antworten, jener bevorzugt Aufzählungspunkte, dieser Mandant formatiert Daten als DD/MM/YYYY. Preference Memory sorgt dafür, dass sich das System zugeschnitten anfühlt, ohne dass man es in jeder Session neu sagen muss. Zusammen mit Fact Memory unten bildet es die semantische Ebene: dauerhafte, abfragbare Aussagen über die Welt und ihre Dinge.
Fact Memory
Dauerhafte Aussagen, die der Agent wiederverwenden darf – mit Herkunftsnachweis. „Die Produktions-DB des Kunden liegt in us-east-1“ ist ein Fakt. Ebenso „ihr Geschäftsjahr beginnt im April.“ In Fakten steckt der Zinseszinseffekt – und die härtesten Designprobleme –, denn jeder geschriebene Fakt ist eine Wette auf die Zukunft. Ich trenne Fakten von Präferenzen, weil sie unterschiedliche Schreibpfade, Zerfallsprofile und Governance-Anforderungen haben – auch wenn beides auf kognitiver Ebene semantisches Gedächtnis ist.
Episodic Memory
Strukturierte Zusammenfassungen erledigter Arbeit. Dinge wie „Fall gelöst“ oder „Migration abgeschlossen.“ Wiederverwendbare Artefakte, die das System aus Traces destilliert hat. Episodic Memory lässt das System erkennen, dass wir das schon einmal gemacht haben, und ruft die Form der früheren Lösung ab.
Trace Memory
Rohdaten: anhängende Ausführungsereignisse. Dein Flugschreiber. Hohe Volumina, vor allem nützlich für Retrieval und Replay – aber nicht der richtige Ort, um etwas über den Nutzer zu erfahren, sondern nur darüber, was er getan hat. Die Unterscheidung ist wichtig, weil viele Teams beides vermischen und semantische Suche über Ausführungslogs machen, um Präferenzen zu erraten.
In einer gröberen Taxonomie liegen episodisches und Trace-Gedächtnis beide unter dem episodischen Schirm – inklusive Gesprächs-Transkripten, Tool-Ausgaben und Run-Historien. Ich trenne sie, weil Rohstrom und destillierte Zusammenfassung in der Praxis völlig unterschiedliche Zugriffsmuster, Aufbewahrungsrichtlinien und Kostenprofile haben. Beides als eine Sache zu behandeln, ist der Grund, warum Teams Vector-DB-Preise zahlen, um ihre Logs zu greppen.
Working Memory steht hier nicht, weil es kein Langzeitgedächtnis ist. Es ist das Kontextfenster selbst – der Arbeitssatz, den das Modell im aktuellen Turn tatsächlich sieht. Working Memory ist real und wichtig, und viel der härtesten angewandten ML-Arbeit spielt gerade dort: Prompt-Kompression, KV-Cache-Reuse, Sliding-Window-Attention, das Budgetrechnen dafür, was diese Tokens belegen darf.
Aber per Definition ist es flüchtig. Es mit den persistente(n) Stores oben zu verwechseln, führt zu Architekturen, in denen Notizblock und System of Record dieselbe Datenbank teilen. Das sollten sie nicht. Working Memory wird pro Turn aus Langzeitgedächtnis zusammengesetzt und verworfen – außer es wird explizit befördert. Dieser Promotion-Schritt ist die Schnittstelle beider Ebenen – und dort passiert der spannendste Teil des Designs.
Wenn jemand sagt „Unser Agent hat Gedächtnis“, frag nach, welchen der fünf Typen er meint. Wenn die Antwort ist „Wir kippen alles in einen Vector Store“, hast du gerade den Grund gefunden, warum sich der Agent teils vergesslich und teils obsessiv anfühlt.
Der Loop – und wo er bricht
Jedes produktive KI-System konvergiert irgendwann auf dieselbe Form: ein Loop.
Die Form ist unstrittig. Die meisten Beschreibungen des Agenten-Loops lassen sich auf fünf Schritte reduzieren: Kontext zusammenstellen, Modell aufrufen, handeln, Ergebnisse beobachten, Gedächtnis aktualisieren – dann wiederholen. Ich benenne die Phasen etwas anders, weil ich die zwei Hälften von „Kontext zusammenstellen“ trennen will (was du aufnimmst vs. was du auswählst) – und weil Promotion einen eigenen Namen verdient, statt in „Gedächtnis aktualisieren“ unterzugehen.
Die Anatomie bleibt gleich – und du siehst dieselben fünf Kipppunkte, egal ob du vom Agenten-Runtime, von der Datenbank oder vom Prompt herdenkst.
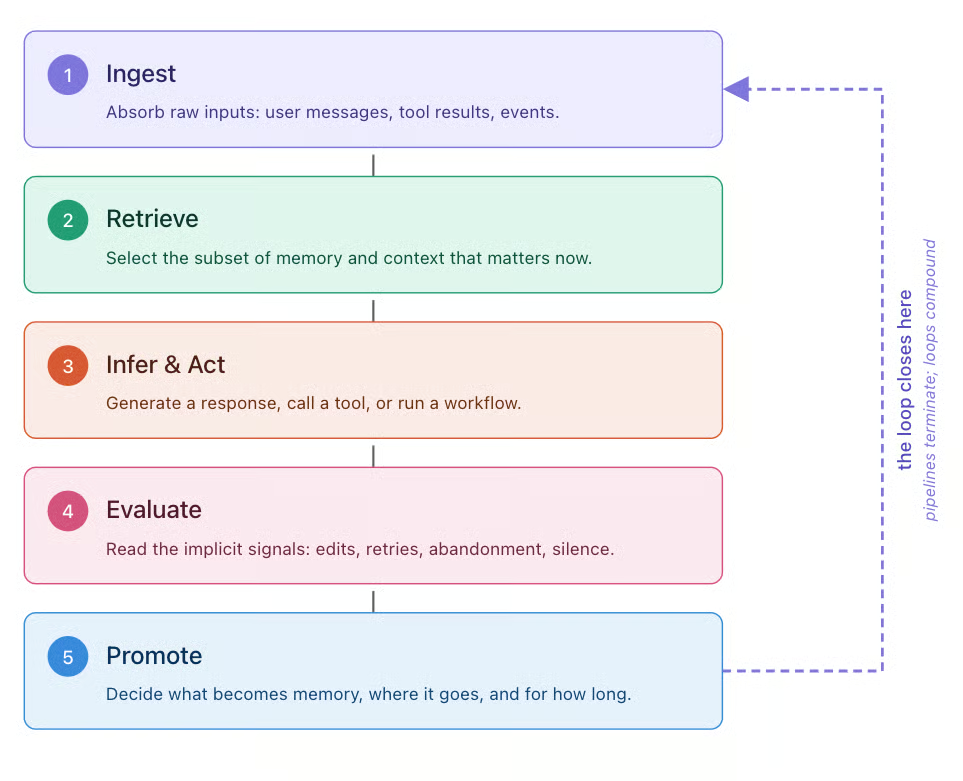
ReAct hat 2022 das Ineinandergreifen von Reasoning und Action populär gemacht; produktive Agentensysteme haben dieses Muster seitdem zum umfassenden Loop oben ausgebaut. Das Diagramm hilft visuell, aber zu wissen, wie jede Phase scheitert, zeigt dir, wo du Engineering-Zeit investieren solltest.
Injest
Ingest scheitert, wenn du zu viel akzeptierst. Ingest ist die erste Hälfte des Kontextaufbaus: Rohinputs aus der Umgebung aufnehmen. Wenn jedes Ereignis als potenzieller Kontext gilt, entsteht Rauschen, das Retrieval später wieder ausbügeln muss. Die Disziplin liegt an der Grenze: Was verweigert ihr zu absorbieren?
Retrieve
Retrieve scheitert leise. Retrieve ist die zweite Hälfte des Kontextaufbaus: auswählen, welcher Teil des Langzeitgedächtnisses jetzt zählt. Es wirft keine Exception, wenn es den falschen Chunk zurückgibt – das Modell klingt nur leicht daneben. Es ist die am wenigsten investierte Phase im Loop – und die, die am stärksten mit der wahrgenommenen Systemqualität korreliert.
Reine semantische Suche ist der erste Entwurf. Für die meisten produktiven Systeme ist die Basis Metadaten-Filterung plus hybrides lexikalisch/semantisches Retrieval mit Reranking; darüber hinaus helfen Query-Dekomposition, Graph-Traversal und Multi-Hop-Retrieval bei zusammengesetzten Aufgaben – begrenzt durch Latenz- und Evaluationsbudgets.
Infer & Act
Infer & Act scheitert, wenn der Kontext falsches Verhalten auslöst. Das ist Modell aufrufen und handeln in einer Phase, weil Planung und Tool-Aufruf Folgen dessen sind, wozu der zusammengebaute Kontext das Modell veranlasst hat. Hier beißen die Long-Context-Fehler: Lost-in-the-middle, Recency Bias, Context Rot.
Intuitiv sollte mehr Kontext die Antworten immer verbessern. In der Praxis macht mehr Text das Modell oft schlechter. Kontext zu budgetieren ist inzwischen eine echte Disziplin – und der Reflex „Gib dem Modell alles, was wir haben“ ist die Standard-Fehlannahme.
Evaluate
Evaluate fehlt in den meisten Systemen komplett. Diese Phase bringt Feedback ins System, indem sie die Ergebnisse der eigenen Aktionen beobachtet. Du willst wissen, ob die Antwort geholfen hat, ob der Workflow erfolgreich war und ob der Nutzer korrigieren musste.
Auch ohne explizites Feedback gibt es Signale. In der Praxis bewährt: Zeit bis zur nächsten Nachricht (eine schnelle Rückfrage heißt meist, die Antwort saß nicht), Edit-Distanz zwischen deinem Output und der Version, die der Nutzer wirklich gesendet oder gespeichert hat (kleine Edits sind Rauschen, große Edits sind Korrektur), sowie Abbruch innerhalb von N Sekunden nach einem Tool-Ergebnis (der Nutzer hat es gesehen und ist abgesprungen).
Keines davon verlangt, dass der Nutzer irgendetwas bewertet. Du musst nur instrumentieren, was ohnehin passiert. Diese impliziten Signale sind überall – aber in keinem Stack hört jemand hin. Ohne diesen Schritt schließt sich der Loop nicht: Das System läuft, lernt aber nie aus seinen Ergebnissen.
Promote
Promote ist die Phase, die am leichtesten falsch gebaut wird. Promote ist die Hälfte von Memory aktualisieren, die das Zurückschreiben ins Langzeitgedächtnis übernimmt. Die meisten Teams überschreiben – sie kippen alles zurück und vergiften dadurch den Store. Du brauchst eine echte, schriftliche Policy, die sechs Fragen beantwortet:
- Was wird geschrieben?
- In welcher Granularität?
- In welchen Gedächtnistyp?
- Mit welcher Herkunftsangabe?
- Mit welchem Verfall?
- Unter wessen Autorität?
Das ist der schwerste und zugleich wichtigste Schritt.
Pipelines enden. Loops verstärken. Der Unterschied ist Promote.
Antipatterns, die du wahrscheinlich schon ausgeliefert hast
Wenn du seit ein paar Monaten Agenten baust, hast du sehr wahrscheinlich mehrere davon verschifft. Mein Team ist in der frühen Phase an jedem einzelnen davon angeeckt – deshalb kenne ich sie von innen.
- Das vollständige Transkript in jedem Turn mitschicken: Der faule Weg, Zustand zu bewahren. Unerträglich teuer, führt schnell zu Context Rot und verschlechtert Antworten – oft unbemerkt, bis Nutzer sich beschweren. Ein kompaktierender Summarizer im Hintergrund ist im Scale nicht optional. Prompt-Caching gehört auf stabile Präfixe (System-Prompts, Tool-Definitionen, statische Policy-Blöcke), während volatile Retrieval-Payloads nach den gecachten Abschnitten stehen.
- Kontext-Overload in der Retrieval-Strategie: Das Pendant auf Retrieval-Seite: den „Küchenspüle“-Ansatz fahren, Top-20-Chunks ziehen und hoffen, das Modell sortiert es schon. Es mittelt sie – was schlechter ist, als fünf gute Chunks zu wählen.
- Den Notizblock als Gedächtnis behandeln: Tool-Resultate, Zwischendenken und generierte Assets landen dauerhaft im Speicher, weil nie etwas explizit verworfen wird. Dein „Gedächtnis“ besteht überwiegend aus Abgasen.
- Ein Store für jede Art Gedächtnis: Wenn Systeme einen einzigen Vektorindex für alles nutzen – Traces, Fakten, Präferenzen, Policies und episodische Summaries in einem Store –, kann Retrieval nicht unterscheiden – und das Modell auch nicht.
- Ein Gedächtnis, das nie vergisst: Das Gegenstück: kein TTL, kein Verfall, keine Eviction. Nach wenigen Monaten wird das zur Last. Einige der besten Verhaltensweisen, die du hinzufügen kannst, sind aggressive Vergessens-Policies.
- Promotion bei Daumen-hoch: Falle, weil das stärkste Feedbacksignal zugleich das seltenste und am stärksten verzerrte ist. Systeme, die nur bei explizit positivem Signal promoten, optimieren fürs Button-Klicken – nicht für Qualität.
- Kein Replay: Ohne Replay wird Debugging zum Rätselraten. Du kannst die Session von gestern nicht reproduzieren, weil sich der Memory-Store weiterbewegt hat. Diese Bugklasse ruiniert Post-Mortems.
Warum das Systems Design ist – nicht „Vibes“
Der Teil, der den Namen „Systems Design“ verdient, ist nicht das mentale Modell. Es sind die Trade-offs – und jeder davon hat eine falsche Antwort, die billiger zu shippen und teurer zu betreiben ist.
Token-Ökonomie bestimmt jetzt die Request-Architektur
Prompt-Cache-Hits kosten nur einen Bruchteil von Misses – oft nur 10% des Standard-Input-Preises bei der API von Anthropic und neueren Modellen von OpenAI sowie 25% bei Googles Gemini. Diese Preise verändern rational, was wo in eine Anfrage gehört. Cache-freundliche Präfixe, stabile Tool-Schemata und fixierte Systeminstruktionen sind keine Kosmetik mehr.
Damit liegt das Einsparpotenzial je nach Anbieter irgendwo zwischen 4x und 10x bei Input-Tokens – bevor du die strukturellen Effekte in agentischen Workloads einrechnest, wo dasselbe Präfix in jedem Schritt erneut gesendet wird. Mit der richtigen Cache-Strategie läuft ein gut architektierter Agent bei identischer Arbeit um ein Mehrfaches günstiger als ein schlecht architektierter. Das ist das Nächste, was KI-Engineering an ein Cache-Line-Problem hat – und viele Teams behandeln es wie eine CSS-Entscheidung.
Retrieval ist ein Architekturproblem
In der Produktion ist es hybrid (lexikalisch plus semantisch), mit Reranking und Query-Rewriting. Die Obergrenze ist agentisches Retrieval, bei dem das Modell seine eigenen Suchen im Loop ausführt und verfeinert. Der Abstand dazwischen ist enorm, in Benchmarks unsichtbar – und in jeder Nutzerinteraktion sichtbar. Wenn dein Retrieval ein einzelner Top-k-Call ist, ist dein Retrieval der Grund, warum sich dein Agent dumm anfühlt.
Kontext-Scope ist eine Sicherheitsgrenze
Mandantenisolation, Sandboxen für Sub-Agenten, Leaks zwischen Sessions. Das sind keine Härtungsübungen „für später“. Wenn ein Sub-Agent per Default den Working Set des Parents sehen kann, wartet ein Problem – die einzige Frage ist, ob du es zuerst findest oder ein Angreifer.
Evaluation ist schwieriger als bei jeder früheren Systemklasse
Zustandsbehaftete, stochastische, pfadabhängige Systeme lassen sich nicht unit-testen. Du brauchst Trace-basierte Evaluation, goldene Retrieval-Sets, Offline-Replay gegen versionierte Memory-Snapshots und LLM-as-Judge-Evaluatoren, die selbst versioniert sind. Die meisten Teams haben all das nicht und fliegen blind. Sie merken Qualitätsrückgänge erst, wenn ein Nutzer sie meldet.
Governance ist nicht optional – und technisch härter als gedacht
Das Recht auf Vergessenwerden nach DSGVO wird knifflig, sobald „das, was über den Nutzer Bescheid weiß“ ein Fakt ist, der aus hundert Interaktionen abgeleitet wurde. Was heißt es, Nutzerdaten zu löschen, wenn das System sie schon ins Fact Memory aufgenommen hat? Der EU AI Act legt noch eine Schicht drauf: Ein Großteil der Pflichten (inkl. Data Governance, menschlicher Aufsicht, Transparenzanforderungen für Hochrisikosysteme) gilt ab August 2026.
Teams, die in der zweiten Jahreshälfte 2026 KI-Produkte nach Europa liefern, brauchen Antworten auf Fragen, die das Feld noch nicht gelöst hat: Wie entfernst du nachweisbar den Beitrag eines Nutzers zu einem abgeleiteten Fakt? Wie auditierst du die Herkunft einer Memory-Promotion? Wie zeigst du, dass ein Memory-Store so gescoped ist, wie du behauptest?
Niemand hat hier schon gute Antworten. Es muss trotzdem funktionieren – und die Aufsicht wartet nicht, bis die Branche nachzieht.
Darum geht es beim Context Engineering um Systems Design, nicht um Prompt Engineering. Das Interessante passiert in den Verbindungen zwischen Systemen – dort, wo Kontext von einer Stufe zur nächsten wandert. Fast nichts davon steckt im Prompt selbst. Und fast jeder Trade-off hat eine Abkürzung, die billig aussieht und sich später als technische Schuld rächt – ausgerechnet dann, wenn es am meisten wehtut.
Wohin sich die Memory-Schicht entwickelt
Wenn du akzeptierst, dass Gedächtnis fünf verschiedene Dinge mit unterschiedlichen Zugriffsmustern ist, stellt sich die naheliegende Frage: Wo lebt das alles?
Hybrides Retrieval – also lexikalisch plus semantisch in einem System – ist weitgehend gelöst. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate und die Vektor-Erweiterungen für Postgres unterstützen Varianten davon, und die Lücke in Produktionsreife ist kleiner, als Marketing vermuten lässt. Wäre die gesamte Memory-Schicht nur „Embeddings und Volltextsuche“, wäre die Architekturfrage langweilig.
Ist sie aber nicht – weil Gedächtnis mehr als Retrieval ist. Schau dir die fünf Typen noch einmal an und beachte, was jeder vom Store wirklich braucht.
|
Memory-Typ |
Was der Store können muss |
|
Policy |
Relational. Versionierte Regeln, Mandanten-Scopes, Foreign Keys zu Nutzern und Rollen, transaktionale Updates. |
|
Preference |
Strukturiert und nutzerbezogen. Zeilen oder JSON, auf einen Nutzer geschlüsselt, vorhersehbares Schema. |
|
Fact |
Hier zahlt sich hybrides Retrieval aus. Dauerhafte Aussagen mit Provenienz, abfragbar sowohl über semantische Ähnlichkeit als auch exakte Übereinstimmung bei Entität oder Quelle. |
|
Episodic |
Strukturierte Zusammenfassungen mit Retrieval darüber. |
|
Trace |
Append-only Event-Storage, hohes Volumen, mit Vektorindizes obendrauf für Replay und Retrieval. |
Die unbeabsichtigte Architektur, bei der du landest, trennt entlang der Achse, die am meisten schmerzt. Relationale Daten leben in Postgres oder einem Managed-Pendant. Hybrides Retrieval lebt in Elasticsearch, OpenSearch oder einem dedizierten Vector Store wie Pinecone, Weaviate oder LanceDB.
Traces landen in S3 oder einer Time-Series-Datenbank. Jedes davon ist für seinen Job stark – und viele Produktionsstacks nutzen sie gut. Das Problem ist nicht die einzelne Komponente. Es ist, dass jeder sinnvolle Retrieval-Pfad zu einem Join über Systeme wird: „Finde faktenrelevante Treffer zur Query, gefiltert nach den für diesen Mandanten geltenden Policies, gescoped auf Nutzer, die dieser Agent sehen darf.“ Dieser Join überquert drei Grenzen: Vertrauen, Transaktion und Latenz. Jedes Mal, wenn Kontext eine davon überquert, führst du genau das Konsistenzproblem wieder ein, das du vermeiden wolltest.
Hier ändert sich das Architektur-Bild. Hybrides Retrieval im selben Store wie die relationalen Daten ist die entscheidende Fähigkeit – und ein anderes Problem als hybrides Retrieval allein. Hybrides Retrieval als Feature gibt es zunehmend überall.
Seltener ist, relationale, Dokument- und Vektordaten unter einer einzigen transaktionalen und Sicherheitsgrenze zu konzentrieren, sodass Policy-, Preference-, Fact- und Episodic Memory gemeinsam mit ACID-Garantien abgefragt werden können – statt über Systeme hinweg abgeglichen zu werden.
Oracle AI Database ist ein Beispiel für diesen konvergierten Multi-Model-Ansatz: Relationale Tabellen, JSON-Dokumente und Vektor-Embeddings leben in einer Engine, gemeinsam in einem SQL-Statement abfragbar, innerhalb einer Transaktion. Nimmst du die Fünf-Typen-Taxonomie ernst und zeichnest die Joins zwischen Policy, Preference und Fact, verschiebt sich die Frage von „Welcher Retrieval-Engine ist die beste?“ zu „Wo sollen die relationalen Daten leben, die dieses Retrieval steuern?“
In der Praxis heißt das: ein einziges SQL-Statement, das relationale Policy-Daten, JSON-codierte Präferenzen und Vektorähnlichkeit über Fact Memory joint. Die Query, die sonst drei Systeme spannt, schrumpft auf eins:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Dieses eine Statement tut vier Dinge gleichzeitig: Mandanten-Policy erzwingen, Nutzerpräferenz respektieren, Zugriffsrechte pro Fakt anwenden und nach semantischer Ähnlichkeit ranken. In einer föderierten Architektur wären das vier Round-Trips über drei Stores – mit einem Konsistenzmodell, das du selbst verteidigen musst.
Hier ist es ein Query-Plan, eine Transaktionsgrenze, ein Ort zum Auditen. Dieselben ACID-Garantien, die Datenbanken seit den 1970ern zum System of Record für geteilten Zustand machen – jetzt angewendet auf Gedächtnis, das neben Zeilen auch Vektoren enthält.
Laufende Beispiele dieses Musters – inklusive agentischem RAG mit Hybrid Search und einem Notebook zur Memory-Architektur fürs Context Engineering – findest du im AI Developer Hub von Oracle auf GitHub.
Für manches willst du weiterhin spezialisierte Stores. Trace Memory in hohem Volumen hat andere Haltbarkeits- und Kostencharakteristika als deine operative Datenbank. Blob Storage für große Assets wie Dokumente, Bilder und Modellartefakte gehört in eine dafür gebaute Plattform. Eine dedizierte Dokumentdatenbank kann für gehärtete Dokument-Workflows weiterhin Sinn ergeben, wenn du deren spezifische Features brauchst.
Der Punkt ist nicht, dass eine einheitliche Plattform jeden anderen Store überflüssig macht. Der Punkt ist, dass sie den teuersten Join eliminiert: den zwischen den relationalen Daten, die steuern, was der Agent darf, und den Vektordaten, die prägen, was der Agent tatsächlich tut. Wenn beides co-located ist, verschiebt sich das Architekturproblem von „Wie halte ich diese Stores konsistent?“ zu „Wie designe ich gute Memory-Policies?“ – und das ist die Frage, die wirklich zählt.
Sieben Vorhersagen für das, was als Nächstes kommt
Oben steht, wo wir sind. Das hier sind Wetten darauf, wohin wir gehen. Absichtlich pointiert. Widersprich ruhig denen, denen du widersprichst.
1. Das Modell wird nicht zum Gedächtnis
Die verlockende Story: Anbieter integrieren Gedächtnis ins Modell. Längere Kontextfenster, schlaueres Caching, die externe Memory-Schicht wird überflüssig. Das wird nicht passieren. Kontextfenster wachsen weiter, müssen aber in jedem Turn neu befüllt werden. Das Modell bleibt pro Session zustandslos – und die externe Memory-Schicht bleibt System of Record. Sie wird nur viel smarter (heute Vector Stores und hybride Plattformen, morgen Neues). Context Engineering wird zur Kunst, zu entscheiden, was das Modell wann und warum sieht. Sollte ein Frontier-Anbieter ein Primitive liefern, das externe Memory-Systeme in der Praxis glaubwürdig ersetzt, ist diese Prognose falsch. Ich würde dagegen wetten.
2. Memory-Infrastruktur überholt Inferenzkosten bei reifen KI-Produkten
Inferenzkosten fallen grob um eine Größenordnung alle 18 Monate. Storage, Retrieval, Embedding-Erzeugung, Reranking und die per-Request-Kontextmontage nicht. Sie skalieren mit Nutzerzahl, Session-Tiefe und Interaktionshistorie – alles wachsend. Die dominierende Cloud-Rechnung verschiebt sich von GPU-Tokens zu Vektor- und Hybrid-Retrieval-Infrastruktur. Das verändert Build-vs-Buy. Memory-Infrastruktur commoditisiert nicht so wie die Modellschicht. Gewinnen werden die Teams, die sie von Tag eins als Erstklass-Thema behandeln.
3. Klassisches RAG wird zur Legacy-Architektur
„Dokumente embedden, Top-k auf die Nutzerfrage, in den Prompt stopfen“ ist das COBOL der KI-Architektur. Es funktioniert, ist überall – und wird rückblickend peinlich. Der Ersatz ist schon sichtbar: agentisches Retrieval, bei dem das Modell seine Suchen plant, mehrstufige Queries ausführt, Zwischenergebnisse liest und entscheidet, was als Nächstes zu holen ist. Es ähnelt weniger einer DB-Abfrage und mehr einem Research-Prozess. Teams, die heute noch statische RAG-Pipelines bauen, sind bereits auf Migrationskurs – ob sie es wissen oder nicht.
4. Memory wird zur Angriffsfläche
Memory-Angriffe verstärken sich auf eine Weise, die Prompt-Injection nicht kann. Wer in einen langlebigen Memory-Store schreiben kann – direkt oder über einen Input-Kanal, den du nicht als privilegiert angesehen hast –, kann das Verhalten für alle künftigen Nutzer prägen. Exfiltration funktioniert umgekehrt genauso: Kontext aus einer Session leakt in eine andere, weil das Scoping schlampig war. Der erste ernsthafte Memory-Poisoning-Vorfall kommt. Danach folgt der Branchen-Run auf Provenienz, Attestation und Zugriffskontrolle pro Fakt.
5. Kontext-Privacy-Grenzen werden zur Compliance-Pflicht
Der nächste logische Schritt von „Kontext-Scope ist eine Sicherheitsgrenze“ ist kryptografische Isolation von Memory-Segmenten, sodass Agenten nur bei Bedarf Kontext preisgeben. Relevant, sobald Sub-Agenten unterschiedliche Vertrauensstufen haben oder Regulierung nachweisbares Scoping sensibler Fakten verlangt. Erwarte den ersten Audit-Fund in einer regulierten Branche mit „unzureichender Isolation zwischen Agenten-Memory-Scopes“ als Auslöser – gefolgt von entsprechenden Compliance-Frameworks. Teams mit Kryptoskoping auf der Roadmap gewinnen die RFPs, die es verlangen. Andere rüsten es unter Zeitdruck nach.
6. Multi-Agent-Konsistenz wird benannt und erwartet
Heute können ein Billing-Agent und ein Support-Agent zum selben Kunden widersprüchliche Antworten geben, weil sie unterschiedliche Memory-Slices gezogen haben und nichts sie abgleicht. Momentan tolerierbar, weil die meisten Deployments Single-Agent sind. Mit Multi-Agent-Systemen in der Breite bemerken Nutzer die Widersprüche – und „kontextuelle Konsistenz“ wird zur benannten Fähigkeit, um die Plattformen konkurrieren. Erst in Vergleichsmatrizen, dann in Enterprise-Checklisten. Wer es früh löst, differenziert sich. Wer es ignoriert, beantwortet Supporttickets, warum zwei eigene Agenten sich beim selben Kunden widersprechen.
7. „Nützlicher Kontext pro Kopf“ wird zur Benchmark-Metrik
Benchmarks wandern von Modellen zu ganzen Systemen. Die Leitmetrik wird etwas wie nützlicher Kontext pro Nutzer, pro Interaktion. Diese Zahl sagt Bindung voraus – und den Unterschied zwischen einem Produkt, das dich kennt, und einem, das sich jeden Dienstag zurücksetzt. Achte auf Investorenpräsentationen – dort taucht sie auf, bevor sie in Papers landet. Korrelierend wird „Kosten pro nützlichem Kontext-Token“ eine Frage der Unit Economics.
Was du am Montag tust
Wenn du neu einsteigst und starten willst: Hör auf, Memory als eine Sache zu sehen. Nimm einen produktiven Agenten, zu dem du Zugang hast, beschrifte, welche Art Gedächtnis jeder seiner Stores wirklich hält – und stell fest, wie oft ein Store drei Jobs macht.
Wenn du schon Agenten baust: instrumentiere den Loop. Speziell das Signal zwischen Retrieval und Promotion. Viele Teams können sagen, was ihr System in einem Turn retrieved hat. Viel weniger können sagen, welche dieser Memories das Modell tatsächlich genutzt hat – und fast keines kann sagen, warum eine bestimmte Memory überhaupt promotet wurde.
Zu wissen, welche Memories genutzt wurden, erlaubt dir, sie im nächsten Promotion-Schritt zu verstärken – so hört ein Memory-System auf, ein Write-Once-Log zu sein, und beginnt wirklich zu lernen.
In diesem Feedback-Loop liegt der Zinseszinseffekt – und dort passiert die spannende Arbeit im nächsten Abschnitt dieser Disziplin.
Alle bekommen die gleichen Frontier-Modelle zur ungefähr gleichen Zeit. Was niemand kopieren kann, ist die Memory-Schicht, die du darum baust: geformt von deinen Nutzern, deinen Entscheidungen und deinem Urteil darüber, was es wert ist, erinnert zu werden.
Modelle sind geteilt. Das Memory-System gehört dir.