Er vindt een architecturale verschuiving plaats, recht voor je neus
De afgelopen jaren hebben de meeste mensen AI behandeld als een API.
Je stuurt een prompt in, je krijgt een antwoord terug, en als je je geavanceerd voelt, voorzie je het van retries en wat logging en noem je het een systeem. Dat werkte voor demo’s. Het is wat deze hele golf zo snel heeft laten verschepen. Maar het patroon houdt op te werken zodra je iets wilt bouwen dat over tijd moet blijven functioneren.
Productie-AI-systemen gedragen zich meer als processen dan als API’s.
Op het moment dat je continuïteit introduceert, verandert alles. Je hebt niet langer te maken met één request en response. Je hebt te maken met een reeks interacties die van elkaar afhangen. Je hebt geheugen en state nodig, en je moet beslissen wat nu belangrijk is, wat vijf minuten geleden belangrijk was, en wat morgen nog steeds belangrijk moet zijn.
En zodra je die grens overgaat, realiseer je je: dit is geen prompt engineering op schaal.
Dit is systeemontwerp.
Wat je echt bouwt is niet een betere prompt. Je bouwt een systeem dat bepaalt hoe context in de tijd wordt gefilterd en ontwikkeld. Dat is de discipline die hieromheen ontstaat. Dat is context engineering.
Context is niet de prompt
Open een willekeurige productie-agent in je debugger en kijk wat er daadwerkelijk naar het model wordt gestuurd in een bepaalde beurt. Het is bijna nooit alleen het bericht van de gebruiker. Een typische request ziet er ongeveer zo uit:
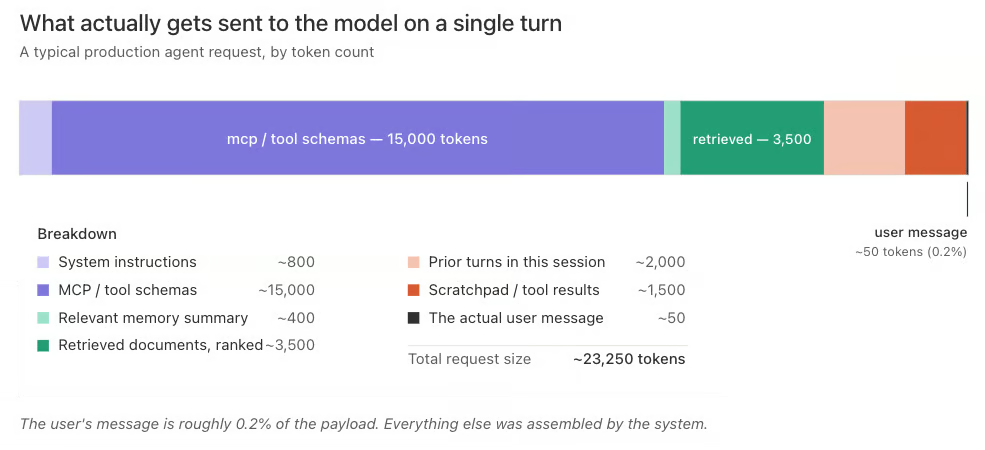
Het gebruikersbericht is het kleinste deel van de payload. Elk ander blok is gefilterd en in de prompt geïnjecteerd. Die blokken zijn de output van een pipeline die jij hebt ontworpen, ook al had je niet door dat je er een ontwierp.
Die pipeline is het echte product. Het model is de runtime. Context engineering is het ontwerp van de pipeline.
Zodra je dat onderscheid accepteert, ziet de architectuur er heel anders uit.
Geheugen is niet één ding
"Geheugen toevoegen" is het nieuwe "caching toevoegen." Het klinkt als een feature, maar het zijn eigenlijk meerdere verschillende systemen die toevallig dezelfde naam delen. Als je ze niet scheidt, eindig je met één blobstore die elke vraag slecht beantwoordt. Vergeetachtig op sommige plekken, dwangmatig op andere.
De eerste opdeling is die welke de cognitieve wetenschap ons al heeft gegeven, en waar de meeste praktijkmensen op uitkomen: kortetermijngeheugen (STM) en langetermijngeheugen (LTM). Kortetermijngeheugen is wat er op dit moment in het contextvenster staat, de working set die het model in deze beurt kan zien.
Langetermijngeheugen is alles wat een enkele call overleeft: feiten, artefacten, plannen, eerdere beslissingen, tooloutputs en regels. Kortetermijngeheugen is een budgetprobleem. Langetermijngeheugen is een systeemprobleem.
De vijf types hieronder zijn allemaal langetermijngeheugen, geordend naar waarvoor ze dienen en hoe ze opgeslagen zouden moeten worden. Ze mappen op de canonieke semantische, episodische en procedurele taxonomie die je ziet in door cognitieve wetenschap geïnspireerde kaders zoals CoALA. Ik splits twee van die categorieën op omdat ze in productie anders bestuurd moeten worden.
Beleidsgeheugen
Normatieve regels en beperkingen. Meestal globaal of tenant-geschaald. Geversioneerd en strikt gecontroleerd. Dit is wat het systeem mag doen: complianceregels, merkrandvoorwaarden, beveiligingsgrenzen. Het verandert zelden en doelbewust. Dit is procedureel geheugen in de cognitieve zin: de regels en workflows die gedrag vormgeven over sessies heen. Dezelfde categorie die in filesystem-first agents bestanden zoals CLAUDE.md of AGENTS.md bevat.
Voorkeursgeheugen
Stabiele personalisatieparameters. Meestal per gebruiker geschaald. Deze gebruiker wil JSON-antwoorden, die gebruiker geeft de voorkeur aan opsommingstekens, deze tenant formatteert data als DD/MM/JJJJ. Voorkeursgeheugen zorgt ervoor dat het systeem afgestemd aanvoelt zonder dat het elke sessie opnieuw verteld hoeft te worden. Samen met feitengeheugen hieronder vormt dit de semantische laag: duurzame, doorzoekbare beweringen over de wereld en de dingen daarin.
Feitengeheugen
Duurzame beweringen die de agent kan hergebruiken. Moeten herkomst bevatten. “De productie-DB van de klant staat in us-east-1” is een feit. Dat geldt ook voor “hun fiscale jaar begint in april.” Feiten zijn waar samengestelde voordelen ontstaan, en waar de lastigste ontwerpproblemen zitten, omdat elk feit dat je wegschrijft een gok is op de toekomst. Ik splits feiten af van voorkeuren omdat ze verschillende write-paden, verschillende vervalprofielen en verschillende governance-eisen hebben, hoewel beide op cognitief niveau semantisch geheugen zijn.
Episodisch geheugen
Gestructureerde samenvattingen van afgerond werk. Dingen als “case opgelost” of “migratie voltooid.” Herbruikbare artefacten die het systeem uit traces heeft gedestilleerd. Episodisch geheugen laat het systeem herkennen dit hebben we eerder gedaan en de vorm van de eerdere oplossing terughalen.
Trace-geheugen
Ruwe, alleen-toevoegbare uitvoeringsevents. Dit is je vluchtrecorder. Het is hoog-volume, vooral nuttig voor retrieval en replay, en het is niet de juiste plek om te kijken als je wilt weten hoe een gebruiker is, alleen wat die heeft gedaan. Het onderscheid is belangrijk omdat de meeste teams die twee verwarren en semantische search uitvoeren over uitvoeringslogs om voorkeuren af te leiden.
In een grovere taxonomie vallen zowel episodisch als trace-geheugen onder de episodische paraplu, inclusief gespreks-transcripten, tooloutputs en run-histories. Ik scheid ze omdat in productie de ruwe stroom en de gedestilleerde samenvatting totaal verschillende toegangspatronen, retentiebeleid en kostenprofielen hebben. Ze als één ding behandelen is hoe teams vector-databaseprijzen betalen om hun logs te greppen.
Werkgeheugen staat niet op deze lijst omdat het geen langetermijngeheugen is. Het is het contextvenster zelf, de working set die het model in de huidige beurt daadwerkelijk kan zien. Werkgeheugen is echt en belangrijk, en veel van het lastigste toegepaste ML-werk zit er nu: promptcompressie, hergebruik van KV-cache, sliding-window attention, het budgetteren van wat die tokens mag innemen.
Maar het is per definitie vluchtig, en het verwarren met de persistente stores hierboven levert architecturen op waarbij het kladblok en het system of record dezelfde database delen. Dat zouden ze niet moeten. Werkgeheugen wordt per beurt samengesteld uit langetermijngeheugen en weggegooid, tenzij expliciet gepromoveerd. De promotie-stap is waar de twee lagen elkaar ontmoeten, en daar gebeurt het meeste interessante ontwerpkwerk.
Als iemand zegt “onze agent heeft geheugen,” vraag dan welke van deze vijf ze bedoelen. Als het antwoord is “we gooien alles in een vector store,” heb je zojuist de reden gevonden waarom hun agent op sommige plekken vergeetachtig voelt en op andere obsessief.
De loop, en wat erin stukgaat
Elk productie-AI-systeem convergeert uiteindelijk naar dezelfde vorm: een loop.
De vorm is niet controversieel. De meeste beschrijvingen van de agentloop komen neer op dezelfde vijf stappen: context samenstellen, het model aanroepen, acties uitvoeren, resultaten observeren, en geheugen bijwerken, dan herhalen. Ik label de fasen net iets anders omdat ik de twee helften van “context samenstellen” wil scheiden (wat je absorbeert vs. wat je selecteert) en omdat ik vind dat promotie een eigen naam verdient in plaats van op te gaan in “geheugen bijwerken.”
Maar de onderliggende anatomie is hetzelfde, en je ziet dezelfde vijf knooppunten of je hier nu vanuit de agent-runtime, de database of de prompt naar keek.
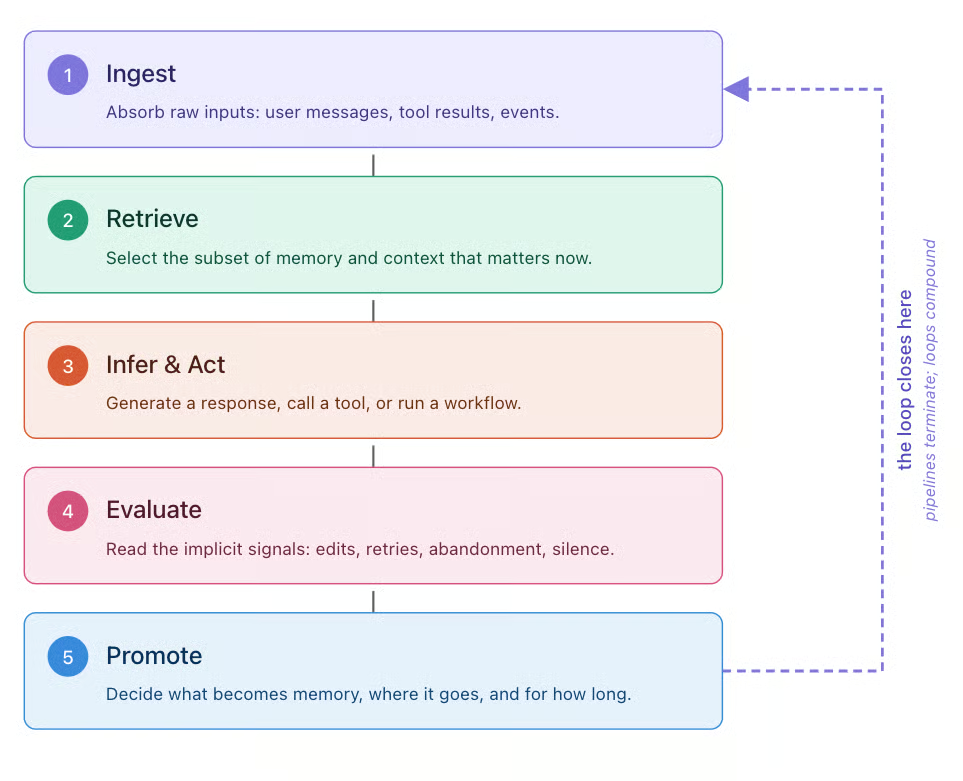
ReAct populariseerde het afwisselen van redeneren en handelen in 2022; productie-agentsystemen hebben dat patroon sindsdien uitgebreid tot de bredere loop hierboven. Het diagram biedt een handig visueel beeld, maar het kennen van de faalmodus van elke fase vertelt je waar je je engineeringtijd aan moet besteden.
Injest
Ingest faalt wanneer je te veel accepteert. Ingest is de eerste helft van het samenstellen van context: ruwe input uit de omgeving absorberen. Elk event als potentiële context behandelen creëert ruis die retrieval later ongedaan moet maken. De discipline zit hier aan de grens. Wat weiger je te absorberen?
Retrieve
Retrieve faalt stilletjes. Retrieve is de tweede helft van contextassemblage: selecteren welke subset van langetermijngeheugen nu relevant is. Het gooit geen exception wanneer het het verkeerde fragment terugstuurt, het laat het model gewoon net iets off klinken. Het is de meest ondergeïnvesteerde fase in de loop, en degene die het sterkst correleert met de ervaren systeemkwaliteit.
Pure semantische zoekopdrachten zijn een eerste versie. Voor de meeste productiesystemen is de baseline metadatafiltering plus hybride lexicale/semantische retrieval met reranking; daarbovenop helpen querydecompositie, graftraversal en multi-hop retrieval wanneer taken compositioneel zijn, maar ze moeten begrensd worden door latency- en evaluatiebudgetten.
Infer & Act
Infer & Act faalt wanneer context tot verkeerd gedrag leidt. Dit is het model aanroepen en acties ondernemen samengevouwen tot één fase, omdat zowel de planning als het aanroepen van tools consequenties zijn van wat de samengestelde context het model heeft doen besluiten. Hier bijten de long-context faalmodi: lost-in-the-middle, recency bias, contextrot.
De intuïtie is dat meer context reacties monotonisch zou moeten verbeteren. Je geeft het model meer informatie om mee te werken, dus je zou denken dat het beter presteert. In de praktijk maken meer tokens het model vaak slechter. Context budgetteren is nu een echte discipline, en de standaardreflex om “het model alles te geven wat we hebben” is het standaard foute antwoord.
Evaluate
Evaluate is de fase die de meeste systemen helemaal niet hebben. Het introduceert feedback in het systeem door de uitkomst van zijn acties te observeren. Je wilt weten of het antwoord hielp, of de workflow slaagde, en of de gebruiker het moest corrigeren.
Zelfs wanneer feedback niet expliciet wordt vastgelegd, bestaan er nog steeds signalen. Enkele die in productie goed werken: time-to-next-message (een snelle follow-up betekent meestal dat het antwoord niet landde), edit-distance tussen jouw output en de versie die de gebruiker daadwerkelijk heeft verzonden of opgeslagen (kleine edits zijn ruis, grote edits zijn correctie), en afhaken binnen N seconden na een toolresultaat (de gebruiker keek naar wat je produceerde en liep weg).
Geen van deze vereist dat de gebruiker iets beoordeelt. Je hoeft alleen te instrumenteren wat al gebeurt. Deze impliciete signalen zijn overal, maar niets in de stack luistert ernaar. Zonder deze stap sluit de loop niet: het systeem draait maar leert nooit van wat het produceert.
Promote
Promote is de fase die het gemakkelijkst is om verkeerd te bouwen. Promote is de helft van geheugen bijwerken die het terugschrijven naar langetermijnopslag afhandelt. De meeste teams schrijven te veel weg, gooien alles terug en vergiftigen de store zelf. Wat je nodig hebt is een echt, uitgeschreven beleid dat zes vragen beantwoordt:
- Wat wordt weggeschreven?
- Op welke granulariteit?
- In welk geheugentype?
- Met welke herkomst?
- Met welk verval?
- Onder wiens bevoegdheid?
Dit is de lastigste stap om goed te krijgen, en ook de belangrijkste.
Pipelines eindigen. Loops stapelen op. Het verschil is Promote.
De antipatronen die je waarschijnlijk verscheept
Als je al langer dan een paar maanden agents bouwt, heb je er vrijwel zeker meerdere van deze verscheept. De vroege experimenten van mijn team zijn door elk van hen gebeten, daarom herken ik ze van binnenuit.
- De volledige transcriptie elke beurt meesturen: Dit is de luie manier om state te behouden. Het is peperduur, raakt snel aan contextrot en verslechtert de antwoordkwaliteit op manieren die pas opvallen als gebruikers klagen. Een compacterende samenvatter die op de achtergrond draait is op schaal niet optioneel, en promptcaching moet worden gereserveerd voor stabiele prefixen (systeemprompts, tooldefinities, statische beleidsblokken) met vluchtige retrieval-payloads die ná de gecachte secties staan.
- Contextoverload in je retrievalstrategie: Het retrieval-equivalent is retrieval behandelen als een alles-in-de-wasbak, de top-20 fragments ophalen en hopen dat het model het uitzoekt. Het middelt ze juist, wat slechter is dan vijf goede fragments kiezen.
- Het kladblok als geheugen behandelen: Dit is wanneer je toolresultaten, tussentijdse redeneringen en gegenereerde assets allemaal weglekken naar langetermijnopslag omdat er nooit iets expliciet wordt weggegooid. Je “geheugen” is vooral uitlaatgas.
- Eén memorystore voor elk soort geheugen: Wanneer systemen één enkele vectorindex voor alles gebruiken: traces, feiten, voorkeuren, beleid en episodische samenvattingen in één store, dan kan retrieval er niet tussen onderscheiden en het model evenmin.
- Geheugen dat nooit vergeet: De tegenovergestelde fout is een geheugen dat nooit vergeet: geen TTL, geen verval, geen eviction. Na slechts een paar maanden wordt dit een aansprakelijkheid in plaats van een asset. Enkele van de beste gedragingen die je aan een systeem kunt toevoegen zijn agressieve vergeetbeleid.
- Promoveren op duimpje-omhoog van de gebruiker: Dit is een val omdat het sterkste feedbacksignaal ook het zeldzaamste en meest bevooroordeelde is. Systemen die alleen op expliciet positieve signalen promoveren, leren optimaliseren voor de knopklik in plaats van voor echte kwaliteit.
- Geen replay: Zonder replay-capaciteit wordt debuggen giswerk. Je kunt de sessie van gisteren niet reproduceren omdat de memorystore is veranderd. Dit is de bugklasse die post-mortems verpest.
Waarom dit systeemontwerp is, niet vibes
Het deel hiervan dat de naam “systeemontwerp” verdient, is niet het mentale model. Het zijn de trade-offs, en elk ervan heeft een fout antwoord dat goedkoper is om te verschepen en duurder om mee te leven.
Tokeneconomie bepaalt nu requestarchitectuur
Promptcache-hits kosten een fractie van cachemisses, vaak slechts 10% van de standaard inputprijs op de API van Anthropic en de nieuwere modellen van OpenAI, en 25% op Google’s Gemini. Die prijsstelling heeft veranderd wat het rationeel is om waar in een request te plaatsen, en cachevriendelijke prefixen, stabiele toolschema’s en vastgepinde systeeminstructies zijn niet langer cosmetische keuzes.
Dat zet het besparingsplafond ergens tussen 4x en 10x op inputtokens, afhankelijk van de provider, nog voordat je de structurele stapeling in agentische workloads meetelt, waar dezelfde prefix elke stap opnieuw wordt verzonden. Krijg je cachestrategie goed, dan draait een goed geanimeerde agent meerdere keren goedkoper dan een slecht geanimeerde op identiek werk. Dit is het dichtst dat AI-engineering bij een cacheline-probleem komt, en de meeste teams behandelen het als een CSS-beslissing.
Retrieval is een architectuurprobleem
De productievloer is hybride (lexicaal plus semantisch), gererankt, met query rewriting. Het plafond is agentische retrieval, waar het model zijn eigen zoekopdrachten uitgeeft en verfijnt binnen de loop. De afstand tussen die twee is enorm, onzichtbaar in benchmarks, en zichtbaar in elke gebruikersinteractie. Als je retrieval één enkele top-k-aanroep is, is jouw retrieval de reden dat je agent dom aanvoelt.
Contextafbakening is een beveiligingsgrens
Multi-tenant isolatie, sandboxing van sub-agents, lekken tussen sessies. Dit zijn geen hardening-oefeningen die je later doet. Als een sub-agent standaard de working set van de parent kan zien, heb je een probleem dat staat te gebeuren, en de enige vraag is of jij het eerst vindt of een tegenstander.
Evaluatie is lastiger dan voor elke eerdere klasse systeem
Stateful, stochastische, pad-afhankelijke systemen laat je niet unit-testen. Je hebt trace-based evaluatie nodig, golden retrieval sets, offline replay tegen geversioneerde geheugen-snapshots, en LLM-as-judge evaluatoren die zelf geversioneerd zijn. De meeste teams hebben niets hiervan en vliegen blind. Ze ontdekken dat hun laatste deploy de kwaliteit heeft teruggezet wanneer een gebruiker het vertelt.
Governance is niet optioneel, en technisch lastiger dan je denkt
Recht om vergeten te worden onder de AVG wordt niet-triviaal zodra “het ding dat over de gebruiker weet” een feit is afgeleid uit honderd interacties. Wat betekent het om de gegevens van een gebruiker te verwijderen uit een systeem dat ze al in feitengeheugen heeft opgenomen? De EU AI Act voegt daar nog een laag bovenop, waarbij het grootste deel van de verplichtingen (inclusief datagovernance, menselijk toezicht en transparantie-eisen voor hoogrisicosystemen) ingaat in augustus 2026.
Teams die in de tweede helft van 2026 AI-producten in Europa verschepen, zullen antwoorden nodig hebben op vragen die het veld nog niet collectief heeft opgelost: hoe je aantoonbaar de bijdrage van een gebruiker aan een afgeleid feit verwijdert, hoe je de herkomst van een geheugenpromotie auditeert, hoe je aantoont dat een memorystore zo is afgebakend als jij zegt.
Niemand heeft hier al een goed antwoord op. Het moet toch werken, en toezichthouders wachten niet tot de industrie het uitzoekt.
Dit is waarom context engineering over systeemontwerp gaat en niet over prompt engineering. Het meeste interessante werk gebeurt in de verbindingen tussen systemen, waar context van de ene fase naar de andere wordt doorgegeven. Bijna niets zit in de prompt zelf. En bijna elke trade-off hierboven heeft een goedkoop ogende shortcut die zich opstapelt tot technische schuld die je op het slechtst mogelijke moment terugbetaalt.
Waar de geheugenlaag naartoe convergeert
Zodra je accepteert dat geheugen vijf verschillende dingen is met meerdere verschillende toegangspatronen, is de voor de hand liggende volgende vraag: waar leeft het allemaal?
Hybride retrieval, oftewel lexicaal plus semantisch in één systeem, is grotendeels een opgelost probleem op dit punt. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate en de vector-extensies voor Postgres ondersteunen allemaal een variant hiervan, en het gat in productiekwaliteit ertussen is kleiner dan vendor marketing suggereert. Als de hele geheugenlaag slechts “embeddings en full-text search” was, zou de architectuurvraag saai zijn.
Dat is het niet, omdat geheugen niet alleen retrieval is. Kijk nog eens naar de vijf types en let op wat elk daadwerkelijk van zijn store nodig heeft.
|
Geheugentype |
Wat het nodig heeft van een store |
|
Beleid |
Relationeel. Geversioneerde regels, tenant-scopes, foreign keys naar gebruikers en rollen, transactionele updates. |
|
Voorkeur |
Gestructureerd en per gebruiker geschaald. Rijen of JSON gekoppeld aan een gebruiker, voorspelbaar schema. |
|
Feit |
Hybride retrieval bewijst hier zijn waarde. Duurzame beweringen met herkomst, doorzoekbaar op zowel semantische gelijkenis als exacte match op entiteit of bron. |
|
Episodisch |
Gestructureerde samenvattingen met retrieval eroverheen. |
|
Trace |
Alleen-toevoegbare eventopslag, hoog-volume, met vectorindexen erbovenop voor replay en retrieval. |
De toevallige architectuur waarmee je eindigt, scheidt deze langs de as die het meest pijn doet. De relationele data leeft in Postgres of een beheerde variant. De hybride retrieval leeft in Elasticsearch, OpenSearch of een dedicated vectorstore zoals Pinecone, Weaviate of LanceDB.
Traces belanden in S3 of een time-series database. Elk hiervan is een sterke keuze voor de taak waarvoor het is gebouwd, en veel productiestacks gebruiken ze goed. Het probleem is niet een individueel component. Het is dat elk betekenisvol retrievalpad een join over systemen wordt: “vind feiten die relevant zijn voor deze query, gefilterd op het beleid dat geldt voor deze tenant, afgebakend naar gebruikers die deze agent mag zien.” Die join kruist drie grenzen: trust, transactie en latency. Elke keer dat context één van die grenzen oversteekt, herintroduceer je precies het consistentieprobleem dat je wilde vermijden.
Hier verandert het architectuurplaatje. Hybride retrieval in dezelfde store als de relationele data is de onderscheidende capaciteit, en dat is een ander probleem dan hybride retrieval alleen. Hybride retrieval als feature is steeds vaker overal beschikbaar.
Minder gebruikelijk is het co-loceren van relationele, document- en vectordata onder één transactionele en beveiligingsgrens, zodat beleids-, voorkeurs-, feiten- en episodisch geheugen samen bevraagd kunnen worden met ACID-garanties in plaats van verzoend te moeten worden over systemen heen.
Oracle AI Database is één voorbeeld van deze geconvergeerde, multimodel benadering: relationele tabellen, JSON-documenten en vectorembeddings leven in één engine, samen te bevragen in één SQL-statement, binnen één transactie. Zodra je de vijf-typen-taxonomie serieus neemt en de joins tussen beleid, voorkeur en feit gaat tekenen, verschuift de vraag van welke retrieval-engine het beste is naar waar de relationele data die die retrieval bestuurt eigenlijk zou moeten leven.
In de praktijk ziet dit eruit als één enkel SQL-statement dat relationele beleidsdata, JSON-gecodeerde voorkeuren en vectorsimilariteit over feitengeheugen joint. De query die anders drie systemen zou overspannen, klapt in tot één:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Dat ene statement doet vier dingen tegelijk: tenantbeleid afdwingen, gebruikersvoorkeur respecteren, toegangsniveaus per feit toepassen en rangschikken op semantische gelijkenis. In een gefedereerde architectuur zijn dat vier rondes over drie verschillende stores, met een consistentiemodel dat je zelf moet verdedigen.
Hier is het één queryplan, één transactiegens, één plek om te auditen. Dezelfde ACID-garanties die databases sinds de jaren 70 tot system of record voor gedeelde state hebben gemaakt, nu toegepast op geheugen dat toevallig vectors naast rijen omvat.
Werkende voorbeelden van dit patroon, waaronder agentische RAG met hybride search en een notebook over geheugenarchitectuur voor context engineering, vind je in Oracle’s AI Developer Hub op GitHub.
Je wilt nog steeds gespecialiseerde stores voor een paar dingen. Trace-geheugen op hoog volume heeft andere duurzaamheid- en kostenkenmerken dan je operationele database. Blobopslag voor grote assets zoals documenten, afbeeldingen en modelartefacten hoort ergens thuis dat daarvoor is gebouwd. Een dedicated documentendatabase kan nog steeds logisch zijn voor geharde documentworkflows waar je de specifieke features van die categorie nodig hebt.
Het punt is niet dat een verenigd platform elke andere store elimineert. Het punt is dat het de duurste join elimineert: die tussen de relationele data die bepaalt wat de agent mag doen en de vectordata die vormt wat de agent daadwerkelijk doet. Wanneer die twee co-gelokaliseerd zijn, verschuift het architectuurprobleem van “hoe houd ik deze stores in sync” naar “hoe ontwerp ik goede geheugenbeleiden,” en dat is het probleem dat er echt toe doet.
Zeven voorspellingen voor wat hierna komt
De secties hierboven beschrijven waar we nu zijn. Dit zijn weddenschappen over waar we heen gaan. Ze zijn bewust uitgesproken. Wees het oneens met de punten waar je het niet mee eens bent.
1. Het model wordt niet het geheugen
Het verleidelijke verhaal is dat modelproviders geheugen opnemen in het model zelf. Lange contextvensters rekken op, caching wordt slimmer, en de externe geheugenlaag wordt onnodig. Dat gaat niet gebeuren. Contextvensters blijven groeien, maar ze zullen nog steeds elke beurt priming vereisen. Het model blijft stateless per sessie, en de externe geheugenlaag blijft het system of record. Wat verandert is dat extern geheugen veel slimmer wordt (vectorstores en hybride platforms vandaag, dingen die we nog niet hebben gebouwd later), en context engineering het ambacht wordt van beslissen wat het model wanneer en waarom ziet. Als een frontierprovider een primitive levert die geloofwaardig een extern geheugensysteem voor productiegebruik vervangt, is deze voorspelling fout. Ik zou ertegen wedden.
2. Geheugeninfrastructuur overtreft inferentiekosten voor volwassen AI-producten
Inferentiekosten dalen grofweg met een orde van grootte elke 18 maanden. Opslag, retrieval, embeddinggeneratie, reranking en het samenstellen van context per request niet. Die schalen met gebruikersaantal, sessiediepte en interactiegeschiedenis, die allemaal groeien. De dominante post op de cloudrekening verschuift van GPU-tokens naar vector- en hybride retrievalinfrastructuur. Dit verandert de build-versus-buy-vraag. Geheugeninfrastructuur commoditiseert niet zoals de modellag. De teams die op lange termijn winnen, zijn degenen die vanaf dag één geheugeninfrastructuur als first-class investering behandelen.
3. Klassieke RAG wordt de legacy-architectuur
“Documenten embedden, top-k op de gebruikersquery, in de prompt proppen” is de COBOL van AI-architectuur. Het werkt, het is overal, en het wordt achteraf genânt. De vervanger is al zichtbaar: agentische retrieval, waarbij het model zijn eigen zoekopdrachten plant, meerstapsqueries uitstuurt, tussentijdse resultaten leest en beslist wat het daarna moet ophalen. Het lijkt minder op een databaselookup en meer op een onderzoeksproces. Teams die vandaag nog statische RAG-pipelines bouwen, zitten op een migratiepad, of ze het nu weten of niet.
4. Geheugen wordt het aanvallingsoppervlak
Geheugenaanvallen stapelen zich op op een manier die prompt injection niet doet. Een tegenstander die kan schrijven naar een langlevende memorystore, direct of via een inputkanaal waarvan jij niet dacht dat het geprivilegieerd was, kan het gedrag van dat systeem vormgeven voor elke toekomstige gebruiker die het raakt. Exfiltratie werkt omgekeerd hetzelfde: context uit de ene sessie die lekt naar een andere omdat het afbakeningsmodel slordig was. Het eerste serieuze real-world incident van geheugengifiging komt eraan. De industriële haast op herkomst, attestation en per-feit toegangscontrole zal erop volgen.
5. Privacygrenzen van context worden een compliance-eis
De volgende logische stap van “contextafbakening is een beveiligingsgrens” is cryptografische isolatie van geheugensegmenten, zodat agents alleen context kunnen onthullen op need-to-know-basis. Dit is belangrijk zodra je sub-agents met verschillende vertrouwensniveaus hebt, of regelgevingen die aantoonbare afbakening van gevoelige feiten vereisen. Verwacht dat de eerste auditbevinding in een gereguleerde sector die “onvoldoende isolatie tussen agentgeheugenscopes” citeert, de katalysator wordt, met compliancekaders die kort daarop volgen. Teams die cryptografische afbakening al op hun roadmap hebben, winnen de RFP’s die ervan afhangen. Teams die dat niet hebben, bouwen het achteraf onder deadline-druk.
6. Consistentie tussen meerdere agents wordt een benoemde, verwachte capability
Vandaag kunnen een billing-agent en een supportagent die dezelfde klantaccount aanraken, tegenstrijdige antwoorden produceren omdat ze verschillende stukken geheugen hebben opgehaald en niets ze verzoent. Dat is nu nog te tolereren omdat de meeste productiedeploys single-agent zijn. Naarmate multi-agent systemen op schaal in productie gaan, zullen gebruikers de tegenstrijdigheden opmerken, en “contextuele consistentie” wordt een benoemde capability waarop platforms concurreren. Het duikt eerst op in vendorvergelijkingsmatrices, daarna in inkoopchecklists van enterprises. Het vroeg oplossen wordt een onderscheidend vermogen. Het negeren betekent supporttickets afhandelen over waarom twee van je eigen agents het oneens zijn over dezelfde klant.
7. “Nuttige context per capita” wordt een gebenchmarktte metriek
Benchmarks verschuiven van modellen naar hele systemen, en de headline-metriek wordt iets als nuttige context per gebruiker, per interactie. Het is het getal dat daadwerkelijk gebruikersretentie voorspelt en het verschil tussen een product dat aanvoelt alsof het je kent en een dat voelt alsof het elke dinsdag reset. Let erop in investeerdersdecks voordat het in academische papers verschijnt. Een gecorreleerde metriek, kosten per nuttige contexttoken, wordt een unit-economics-vraag die het waard is om te beantwoorden.
Wat je maandag doet
Als je hier nieuw in bent en een startpunt zoekt: stop met geheugen als één ding te behandelen. Kies een productie-agent waar je toegang toe hebt, label welk type geheugen elke store daadwerkelijk bevat, en merk op hoe vaak één store voor drie taken wordt gebruikt.
Als je al agents bouwt: instrumenteer de loop. Instrumenteer specifiek het signaal tussen retrieval en promotie. Ik heb veel teams gezien die je kunnen vertellen wat hun systeem in een bepaalde beurt heeft opgehaald. Veel minder kunnen je vertellen welke van die opgehaalde herinneringen het model daadwerkelijk gebruikte, en bijna niemand kan je vertellen waarom een bepaalde herinnering überhaupt gepromoveerd werd.
Weten welke herinneringen zijn gebruikt, is wat je in staat stelt ze bij de volgende promotie stap te versterken, en zo stopt een geheugensysteem met een write-once log te zijn en begint het daadwerkelijk te leren.
Die feedbackloop is waar het samengestelde voordeel zit, en daar gebeurt het interessante werk in het komende stuk van deze discipline.
Elk team krijgt ongeveer dezelfde frontiermodellen op ongeveer dezelfde tijdlijn. Wat niemand anders kan kopiëren is de geheugenlaag die jij eromheen bouwt: die wordt gevormd door jouw gebruikers, jouw beslissingen en jouw oordeel over wat het waard is om te onthouden.
Modellen zijn gedeeld. Het geheugensysteem is van jou.