एक स्थापत्य बदलाव आंखों के सामने हो रहा है
पिछले कुछ वर्षों से, ज़्यादातर लोग एआई को एक API की तरह मान रहे हैं।
आप एक प्रॉम्प्ट भेजते हैं, एक प्रतिक्रिया मिलती है, और अगर आप थोड़े परिष्कृत हैं, तो आप उसे रिट्राइज़ और थोड़ी लॉगिंग से लपेटकर एक सिस्टम कह देते हैं। यह डेमो के लिए काम आया। इसी ने इस पूरी लहर को इतनी जल्दी शिप होने दिया। लेकिन जैसे ही आप ऐसा कुछ बनाने की कोशिश करते हैं जिसे समय के साथ चलना हो, यह पैटर्न काम करना बंद कर देता है।
प्रोडक्शन एआई सिस्टम API की तुलना में प्रक्रियाओं की तरह ज़्यादा बर्ताव करते हैं।
जैसे ही आप निरंतरता लाते हैं, सब कुछ बदल जाता है। आप अब एकल रिक्वेस्ट और रिस्पॉन्स से नहीं जूझ रहे होते। आप ऐसे अंतःक्रियाओं के क्रम से जूझ रहे होते हैं जो एक-दूसरे पर निर्भर होते हैं। आपको मेमोरी और स्टेट चाहिए, और आपको तय करना पड़ता है कि अभी क्या मायने रखता है, पांच मिनट पहले क्या रखता था, और कल भी क्या रखना चाहिए।
और जैसे ही आप वह सीमा पार करते हैं, आपको अहसास होता है कि यह बड़े पैमाने पर प्रॉम्प्ट इंजीनियरिंग नहीं है।
यह सिस्टम डिज़ाइन है।
आप वास्तव में एक बेहतर प्रॉम्प्ट नहीं बना रहे हैं। आप एक ऐसा सिस्टम बना रहे हैं जो तय करता है कि समय के साथ संदर्भ कैसे फिल्टर और विकसित होगा। इसी के इर्द-गिर्द जो अनुशासन उभर रहा है, वही है कॉन्टेक्स्ट इंजीनियरिंग।
कॉन्टेक्स्ट प्रॉम्प्ट नहीं है
किसी भी प्रोडक्शन एजेंट को अपने डिबगर में खोलें और देखें कि किसी दिए गए टर्न पर मॉडल को वास्तव में क्या भेजा जाता है। यह लगभग कभी केवल उपयोगकर्ता का संदेश नहीं होता। एक सामान्य रिक्वेस्ट कुछ इस तरह दिखता है:
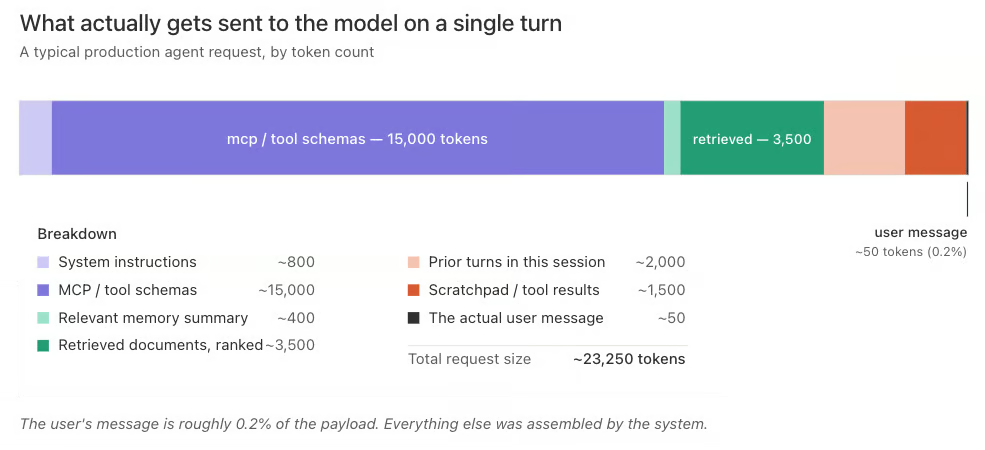
उपयोगकर्ता संदेश पेलोड का सबसे छोटा हिस्सा है। बाकी हर ब्लॉक को फिल्टर करके प्रॉम्प्ट में इंजेक्ट किया गया। ये ब्लॉक उस पाइपलाइन का आउटपुट हैं जिसे आपने डिज़ाइन किया, भले ही आपको एहसास न हुआ हो कि आप एक पाइपलाइन डिज़ाइन कर रहे थे।
वही पाइपलाइन असली प्रोडक्ट है। मॉडल रनटाइम है। कॉन्टेक्स्ट इंजीनियरिंग उस पाइपलाइन का डिज़ाइन है।
एक बार यह अंतर मान लें, आर्किटेक्चर बिल्कुल अलग दिखता है।
मेमोरी एक चीज़ नहीं है
"मेमोरी जोड़ें" नया "कैशिंग जोड़ें" है। यह फीचर जैसा लगता है, पर असल में यह कई अलग-अलग सिस्टम हैं जो संयोग से एक ही नाम साझा करते हैं। अगर आप इन्हें अलग नहीं करते, तो आप एक सिंगल ब्लॉब स्टोर के साथ खत्म करेंगे जो हर सवाल का खराब जवाब देता है—कुछ जगह भूलक्कड़, कुछ जगह जुनूनी।
पहली कटौती वही है जो कॉग्निटिव साइंस हमें पहले ही दे चुकी है, और जिस पर ज़्यादातर प्रैक्टिशनर एकमत हो रहे हैं: शॉर्ट-टर्म मेमोरी (STM) और लॉन्ग-टर्म मेमोरी (LTM)। शॉर्ट-टर्म मेमोरी वह सब है जो फिलहाल कॉन्टेक्स्ट विंडो के अंदर है—वह वर्किंग सेट जिसे मॉडल इस टर्न पर देख सकता है।
लॉन्ग-टर्म मेमोरी वह सब है जो एक कॉल से आगे कायम रहती है: तथ्य, आर्टिफैक्ट्स, योजनाएं, पूर्व निर्णय, टूल आउटपुट्स, और नियम। शॉर्ट-टर्म मेमोरी एक बजट समस्या है। लॉन्ग-टर्म मेमोरी एक सिस्टम्स समस्या है।
नीचे दिए गए पांच प्रकार सभी लॉन्ग-टर्म मेमोरी हैं, जिन्हें उनके प्रयोजन और भंडारण के आधार पर संगठित किया गया है। ये कॉग्निटिव साइंस-प्रेरित फ्रेम्स जैसे CoALA में दिखने वाली मानक सेमांटिक, एपिसोडिक, और प्रोसीजरल वर्गीकरण पर मैप होते हैं। मैं उनमें से दो श्रेणियों को इसलिए उपविभाजित कर रहा हूं क्योंकि प्रोडक्शन में उन्हें अलग तरह से गवर्न करना पड़ता है।
पॉलिसी मेमोरी
नॉर्मेटिव नियम और प्रतिबंध। आमतौर पर ग्लोबल या टेनेंट-स्कोप्ड। वर्ज़निंग के साथ और सख्ती से नियंत्रित। यह वह है जो सिस्टम करने के लिए अनुमत है: कंप्लायंस नियम, ब्रांड गार्डरेल्स, सिक्योरिटी सीमाएं। यह कम और जानबूझकर बदलता है। यह कॉग्निटिव साइंस अर्थ में प्रोसीजरल मेमोरी है—वह नियम और वर्कफ्लो जो सत्रों में व्यवहार को आकार देते हैं। वही श्रेणी जो फाइलसिस्टम-फर्स्ट एजेंट्स में CLAUDE.md या AGENTS.md जैसी फाइलों को रखती है।
पसंद मेमोरी
स्थिर पर्सनलाइज़ेशन पैरामीटर्स। आमतौर पर यूज़र-स्कोप्ड। यह उपयोगकर्ता JSON प्रतिक्रियाएं चाहता है, वह उपयोगकर्ता बुलेट पॉइंट्स पसंद करता है, वह टेनेंट तारीखें DD/MM/YYYY फॉर्मेट करता है। पसंद मेमोरी सिस्टम को हर सत्र में फिर से बताए बिना ही अनुकूलित महसूस कराती है। नीचे दी गई फैक्ट मेमोरी के साथ मिलकर, यही सेमांटिक लेयर है: दुनिया और उसमें मौजूद चीज़ों के बारे में टिकाऊ, क्वेरी योग्य अभिकथन।
फैक्ट मेमोरी
टिकाऊ अभिकथन जिनका एजेंट पुन: उपयोग कर सकता है। इनमें उद्गम-स्रोत (provenance) शामिल होना चाहिए। “कस्टमर का प्रोडक्शन DB us-east-1 में है” एक तथ्य है। वैसे ही “उनका वित्तीय वर्ष अप्रैल में शुरू होता है।” भी। तथ्यों में ही चक्रवृद्धि बढ़त बसती है, और वहीं सबसे कठिन डिज़ाइन समस्याएं भी हैं, क्योंकि हर लिखा गया तथ्य भविष्य पर एक दांव है। मैं तथ्यों को पसंदों से अलग करता हूं क्योंकि इनके लिखने के रास्ते, क्षय प्रोफाइल, और गवर्नेंस आवश्यकताएं अलग हैं—भले ही दोनों कॉग्निटिव स्तर पर सेमांटिक मेमोरी हैं।
एपिसोडिक मेमोरी
पूर्ण कार्य के संरचित सारांश। जैसे “केस सुलझा” या “माइग्रेशन पूरा।” रन ट्रेसेज़ से सिस्टम द्वारा निकाले गए पुन: प्रयोज्य आर्टिफैक्ट्स। एपिसोडिक मेमोरी सिस्टम को यह पहचानने देती है कि हम यह पहले कर चुके हैं और पिछले समाधान का खाका वापस लाती है।
ट्रेस मेमोरी
कच्चे, केवल-एपेंड एक्ज़ीक्यूशन इवेंट्स। यह आपका फ्लाइट रिकॉर्डर है। हाई-वॉल्यूम, मुख्यतः रिट्रीवल और रिप्ले के लिए उपयोगी, और यह वह जगह नहीं है जहां आप यह जानने जाते हैं कि उपयोगकर्ता कैसा है—सिर्फ यह कि उसने क्या किया। यह अंतर इसलिए मायने रखता है क्योंकि ज़्यादातर टीमें दोनों को मिला देती हैं और फिर पसंदों का अनुमान लगाने के लिए एक्ज़ीक्यूशन लॉग्स पर सेमांटिक सर्च चलाती हैं।
एक मोटे वर्गीकरण में, एपिसोडिक और ट्रेस मेमोरी दोनों एपिसोडिक छाते के नीचे आती हैं, जिसमें बातचीत के प्रतिलेख, टूल आउटपुट्स, और रन हिस्ट्री शामिल हैं। मैं इन्हें अलग करता हूं क्योंकि प्रोडक्शन में कच्ची स्ट्रीम और निचोड़ा गया सारांश एक्सेस पैटर्न, रिटेंशन पॉलिसी, और लागत प्रोफाइल में बेहद अलग होते हैं। इन्हें एक ही चीज़ मानना ही वह तरीका है जिससे टीमें अपने लॉग्स को grep करने के लिए वेक्टर-डेटाबेस की कीमतें चुकाती हैं।
वर्किंग मेमोरी इस सूची में इसलिए नहीं है क्योंकि वह लॉन्ग-टर्म मेमोरी नहीं है। वही कॉन्टेक्स्ट विंडो—वह वर्किंग सेट—जिसे मॉडल मौजूदा टर्न पर वास्तव में देख सकता है। वर्किंग मेमोरी वास्तविक और महत्वपूर्ण है, और अभी का बहुत सा मुश्किल एप्लाइड-एमएल काम वहीं है: प्रॉम्प्ट कंप्रेशन, KV-कैश रीयूज़, स्लाइडिंग-विंडो अटेंशन, और उन टोकन्स पर बजट गणित जिन्हें यह जगह मिले।
परिभाषा से यह क्षणभंगुर है, और इसे ऊपर दी गई पर्सिस्टेंट स्टोर्स के साथ मिलाना वही आर्किटेक्चर पैदा करता है जहां स्क्रैचपैड और सिस्टम ऑफ रिकॉर्ड एक ही डेटाबेस साझा करते हैं। उन्हें नहीं करना चाहिए। वर्किंग मेमोरी हर टर्न पर लॉन्ग-टर्म मेमोरी से असेंबल होती है और तब तक त्याग दी जाती है जब तक कि उसे स्पष्ट रूप से प्रोमोट न किया जाए। प्रोमोशन स्टेप वहीं है जहां ये दो परतें मिलती हैं—और वहीं अधिकांश रोचक डिज़ाइन काम होता है।
जब कोई कहता है “हमारे एजेंट के पास मेमोरी है,” तो पूछें इन पांच में से कौन-सी। अगर जवाब है “हम सब कुछ एक वेक्टर स्टोर में डाल देते हैं,” तो आपने वही वजह ढूंढ ली कि उनका एजेंट कुछ जगह भूलक्कड़ लगता है और कुछ जगह जुनूनी।
लूप, और उसमें क्या टूटता है
हर प्रोडक्शन एआई सिस्टम आखिरकार एक ही आकार पर आकर ठहरता है: एक लूप।
यह आकार विवादास्पद नहीं है। एजेंट लूप के अधिकांश वर्णन वही पांच चरणों में सिमटते हैं: संदर्भ को जुटाना, मॉडल को कॉल करना, क्रियाएं लेना, परिणामों को देखना, और मेमोरी अपडेट करना—फिर दोहराना। मैं चरणों के लेबल थोड़ा अलग करता हूं क्योंकि मैं “assemble context” के दो हिस्सों (क्या आप अवशोषित करते हैं बनाम क्या चुनते हैं) को अलग करना चाहता हूं और क्योंकि मुझे लगता है कि प्रोमोशन अपना नाम डिज़र्व करता है, न कि “update memory” में समा जाना चाहिए।
लेकिन अंतर्निहित शारीरिक रचना वही है, और आप वही पांच मोड़ देखेंगे, चाहे आप एजेंट रनटाइम, डेटाबेस, या प्रॉम्प्ट से क्यों न आए हों।
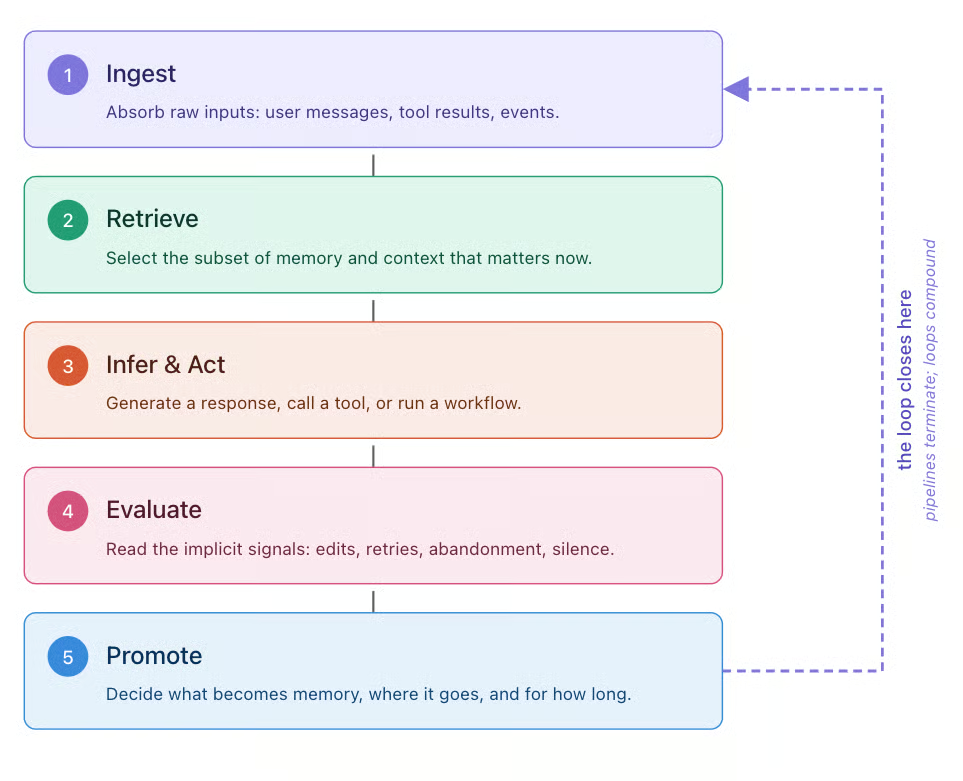
ReAct ने 2022 में तर्क और क्रिया को इंटरलीव करने को लोकप्रिय बनाया; प्रोडक्शन एजेंट सिस्टम्स ने तब से उस पैटर्न को ऊपर दिए व्यापक लूप में विस्तारित कर दिया है। आरेख सहायक विज़ुअल देता है, लेकिन प्रत्येक चरण के फेल्योर मोड को जानना बताता है कि इंजीनियरिंग समय कहां लगाना है।
Injest
Ingest तब विफल होता है जब आप बहुत कुछ स्वीकार लेते हैं। Ingest, संदर्भ जुटाने का पहला आधा है: परिवेश से कच्चे इनपुट्स को अवशोषित करना। हर इवेंट को संभावित संदर्भ मानना वह शोर पैदा करता है जिसे बाद में रिट्रीवल को पूर्ववत करना पड़ता है। अनुशासन यहां सीमा पर है। आप क्या अवशोषित करने से इनकार कर रहे हैं?
Retrieve
Retrieve चुपचाप विफल होता है। Retrieve संदर्भ असेंबली का दूसरा आधा है: लॉन्ग-टर्म मेमोरी के किस सबसेट की अभी ज़रूरत है यह चुनना। जब यह गलत चंक लौटाता है तो कोई एक्सेप्शन नहीं फेंकता, बस मॉडल को थोड़ा-सा गलत-गलत सुनाता है। यह लूप का सबसे कम निवेशित चरण है, और जो धारित सिस्टम क्वालिटी से सबसे कसकर सहसंबद्ध है।
शुद्ध सेमांटिक सर्च एक फर्स्ट ड्राफ्ट है। ज़्यादातर प्रोडक्शन सिस्टम्स के लिए बेसलाइन है मेटाडेटा फ़िल्टरिंग प्लस हाइब्रिड लेक्सिकल/सेमांटिक रिट्रीवल विद रीरैंकिंग; उससे आगे, क्वेरी डीकंपोजिशन, ग्राफ ट्रैवर्सल, और मल्टी-हॉप रिट्रीवल कम्पोज़िशनल टास्क्स में मदद करते हैं, पर उन्हें लेटेंसी और इवैल्यूएशन बजट्स से बांधना जरूरी है।
Infer & Act
Infer & Act तब विफल होता है जब संदर्भ गलत व्यवहार को जन्म देता है। यह मॉडल को कॉल करना और क्रियाएं लेना एक ही चरण में समाए हुए हैं, क्योंकि योजना और टूल इनवोकेशन दोनों उसी के परिणाम हैं जो जुटाए गए संदर्भ ने मॉडल को करने का निर्णय करवाया। यही वह जगह है जहां लॉन्ग-कॉन्टेक्स्ट फेल्योर मोड्स काटते हैं: ‘लॉस्ट-इन-द-मिडल’, ‘रीसेंसी बायस’, ‘कॉन्टेक्स्ट रॉट’।
सहज धारणा यह है कि अधिक संदर्भ से प्रतिक्रियाएं एकरेखीय रूप से बेहतर होनी चाहिए। आप मॉडल को काम करने के लिए अधिक जानकारी दे रहे हैं, तो लगेगा कि वह बेहतर करेगा। व्यवहार में, अधिक टोकन्स अक्सर मॉडल को बदतर बनाते हैं। अब संदर्भ का बजटिंग एक वास्तविक अनुशासन है, और “मॉडल को हमारे पास जो भी है सब दे दो” डिफ़ॉल्ट प्रवृत्ति ही डिफ़ॉल्ट गलत उत्तर है।
Evaluate
Evaluate वह चरण है जो अधिकांश सिस्टम्स में होता ही नहीं। यह अपनी क्रियाओं के परिणाम का अवलोकन करके सिस्टम में फीडबैक लाता है। आप जानना चाहते हैं कि प्रतिक्रिया ने मदद की या नहीं, वर्कफ़्लो सफल हुआ या नहीं, और क्या उपयोगकर्ता को उसे सुधारना पड़ा।
भले ही फीडबैक को स्पष्ट रूप से कैप्चर न किया जाए, सिग्नल्स फिर भी मौजूद होते हैं। प्रोडक्शन में जो कुछ अच्छे से काम करते हैं: टाइम-टू-नेक्स्ट-मेसेज (तेज़ फॉलो-अप आमतौर पर दर्शाता है कि जवाब असरदार नहीं रहा), आपके आउटपुट और वह वर्शन जिसे उपयोगकर्ता ने वास्तव में भेजा या सेव किया उसके बीच की एडिट-डिस्टेंस (छोटे एडिट्स शोर हैं, बड़े एडिट्स सुधार), और किसी टूल रिज़ल्ट के N सेकंड्स के भीतर परित्याग (यूज़र ने देखा जो आपने बनाया और चला गया)।
इनमें से किसी के लिए भी उपयोगकर्ता से रेटिंग मांगने की ज़रूरत नहीं। बस आपको वही इंस्ट्रूमेंट करना है जो पहले से हो रहा है। ये अप्रत्यक्ष सिग्नल हर जगह हैं, पर स्टैक में कुछ भी इन्हें सुन नहीं रहा। इस चरण के बिना लूप बंद नहीं होता: सिस्टम चलता है पर अपनी ही उपज से कभी सीखता नहीं।
Promote
Promote वह चरण है जिसे गलत बनाना सबसे आसान है। Promote, update memory का वह आधा है जो लॉन्ग-टर्म स्टोरेज में लिखना संभालता है। अधिकांश टीमें ज़रूरत से ज़्यादा लिखने की गलती करती हैं—सब कुछ वापस डंप कर देती हैं और खुद स्टोर को ज़हरीला बना देती हैं। आपको एक वास्तविक, लिखित नीति चाहिए जो छह सवालों के जवाब दे:
- क्या लिखा जाएगा?
- किस ग्रैन्युलैरिटी पर?
- किस मेमोरी प्रकार में?
- किस उद्गम-स्रोत के साथ?
- किस क्षय (decay) के साथ?
- किस अधिकार के तहत?
यह सबसे मुश्किल कदम है, और सबसे अहम भी।
पाइपलाइन्स समाप्त होती हैं। लूप्स चक्रवृद्धि करते हैं। फर्क है Promote।
एंटी-पैटर्न्स जो आप शायद शिप कर रहे हैं
अगर आप कुछ महीनों से एजेंट बना रहे हैं, तो आपने लगभग निश्चित रूप से इनमें से कई शिप किए हैं। मेरी टीम के शुरुआती प्रयोग हर एक से कटी—इसीलिए मुझे पता है वे अंदर से कैसे दिखते हैं।
- हर टर्न पर पूरा ट्रांस्क्रिप्ट डंप करना: स्टेट बनाए रखने का यह आलसी तरीका है। यह बेतहाशा महंगा है, तेजी से कॉन्टेक्स्ट रॉट हिट करता है, और प्रतिक्रियाओं की गुणवत्ता को उस तरह बिगाड़ता है जो तब तक दिखती नहीं जब तक उपयोगकर्ता शिकायत न करें। बैकग्राउंड में चलने वाला एक कॉम्पैक्टिंग समराइज़र स्केल पर वैकल्पिक नहीं है, और प्रॉम्प्ट कैशिंग को स्थिर प्रीफ़िक्स (सिस्टम प्रॉम्प्ट्स, टूल डेफिनिशन, स्थिर पॉलिसी ब्लॉक्स) तक सीमित रखना चाहिए, जबकि अस्थिर रिट्रीवल पेलोड्स कैश्ड सेक्शंस के बाद रखें।
- आपकी रिट्रीवल स्ट्रैटेजी में कॉन्टेक्स्ट ओवरलोड: रिट्रीवल-साइड का समकक्ष है किचन-सिंक जैसा व्यवहार—टॉप-20 चंक्स खींच लेना और उम्मीद करना कि मॉडल छांट देगा। वह औसत निकाल देता है, जो पांच अच्छे चंक्स चुनने से भी बदतर है।
- स्क्रैचपैड को मेमोरी मान लेना: यह तब होता है जब आपके टूल कॉल परिणाम, मध्यवर्ती तर्क, और जेनरेटेड एसेट्स सब लॉन्ग-टर्म स्टोरेज में लीक हो जाते हैं क्योंकि कभी कुछ स्पष्ट रूप से त्यागा ही नहीं जाता। आपकी “मेमोरी” ज्यादातर एग्ज़ॉस्ट होती है।
- हर तरह की मेमोरी के लिए एक ही मेमोरी स्टोर: जब सिस्टम्स हर चीज़ के लिए एक ही वेक्टर इंडेक्स का उपयोग करते हैं—ट्रेसेज़, तथ्य, पसंद, नीतियां, और एपिसोडिक सारांश सब एक ही स्टोर में—तो रिट्रीवल इन्हें अलग नहीं कर पाती और न ही मॉडल।
- ऐसी मेमोरी जो कभी भूलती नहीं: विपरीत विफलता है ऐसी मेमोरी जो कभी भूलती ही नहीं: न TTL, न क्षय, न एविक्शन। केवल कुछ महीनों में ही यह संपत्ति के बजाय देनदारी बन जाती है। कुछ बेहतरीन व्यवहार जो आप सिस्टम में जोड़ सकते हैं, वे आक्रामक भूलने की नीतियां हैं।
- यूज़र थंब्स-अप पर प्रोमोट करना: यह जाल है क्योंकि सबसे मज़बूत फीडबैक सिग्नल सबसे दुर्लभ और सबसे पक्षपाती भी है। जो सिस्टम केवल स्पष्ट पॉज़िटिव सिग्नल्स पर प्रोमोट करते हैं, वे बटन-क्लिक के लिए ऑप्टिमाइज़ करना सीखते हैं, न कि वास्तविक गुणवत्ता के लिए।
- कोई रिप्ले नहीं: रिप्ले क्षमता के बिना, डिबगिंग अटकल बन जाती है। आप कल का सत्र पुन: उत्पन्न नहीं कर सकते क्योंकि मेमोरी स्टोर आगे बढ़ चुका है। यह वही बग क्लास है जो पोस्ट-मॉर्टम्स को बर्बाद कर देती है।
क्यों यह सिस्टम डिज़ाइन है, वाइब्स नहीं
वह हिस्सा जो “सिस्टम्स डिज़ाइन” नाम का हकदार है, वह मानसिक मॉडल नहीं। वे ट्रेड-ऑफ्स हैं—और हर एक का गलत जवाब होता है जिसे शिप करना सस्ता और उसके साथ जीना महंगा पड़ता है।
अब टोकन इकोनॉमिक्स रिक्वेस्ट आर्किटेक्चर को चलाते हैं
प्रॉम्प्ट कैश हिट्स की लागत कैश मिसेज़ की तुलना में एक अंश होती है—अक्सर Anthropic के API और OpenAI के नए मॉडलों पर मानक इनपुट कीमत का केवल 10%, और Google के Gemini पर 25%। इस प्राइसिंग ने यह बदल दिया है कि किसी रिक्वेस्ट में क्या कहां रखना तर्कसंगत है, और कैश-फ्रेंडली प्रीफ़िक्स, स्थिर टूल स्कीमाज़, और पिन्ड सिस्टम इंस्ट्रक्शंस अब कॉस्मेटिक विकल्प नहीं रहे।
इससे बचत की छत प्रदाता के अनुसार इनपुट टोकन्स पर 4x से 10x के बीच कहीं आती है—उससे पहले कि आप एजेंटिक वर्कलोड्स में संरचनात्मक चक्रवृद्धि को गिनें, जहां वही प्रीफ़िक्स हर स्टेप पर फिर भेजा जाता है। कैश रणनीति सही करें, और एक अच्छे-से आर्किटेक्टेड एजेंट समान काम पर बुरी तरह आर्किटेक्टेड एजेंट से कई गुना सस्ता चलता है। यह एआई इंजीनियरिंग में कैश-लाइन समस्या के सबसे करीब है, और ज़्यादातर टीमें इसे CSS फैसले की तरह ले रही हैं।
रिट्रीवल एक आर्किटेक्चर समस्या है
प्रोडक्शन फ़्लोर हाइब्रिड (लेक्सिकल प्लस सेमांटिक), रीरैंक्ड, और क्वेरी रीराइटिंग के साथ है। छत है एजेंटिक रिट्रीवल, जहां मॉडल लूप के अंदर अपनी ही खोजें जारी और परिष्कृत करता है। इन दोनों के बीच की दूरी विशाल है—बेंचमार्क्स में अदृश्य, और हर यूज़र इंटरैक्शन में स्पष्ट। अगर आपकी रिट्रीवल एकल top-k कॉल है, तो वही वजह है कि आपका एजेंट मंदबुद्धि लगता है।
कॉन्टेक्स्ट स्कोपिंग एक सुरक्षा सीमा है
मल्टी-टेनेंट आइसोलेशन, सब-एजेंट सैंडबॉक्सिंग, क्रॉस-सेशन लीकैज। ये वे हार्डनिंग एक्सरसाइज़ नहीं हैं जो आप बाद में करते हैं। अगर कोई सब-एजेंट डिफ़ॉल्ट रूप से पैरेंट का वर्किंग सेट देख सकता है, तो आपके पास एक संभावित समस्या है—सवाल केवल यह है कि पहले आप उसे ढूंढते हैं या कोई प्रतिद्वंद्वी।
मूल्यांकन किसी भी पूर्ववर्ती सिस्टम वर्ग से कठिन है
स्टेटफुल, स्टोकेस्टिक, पाथ-डिपेंडेंट सिस्टम यूनिट-टेस्ट नहीं होते। आपको ट्रेस-आधारित मूल्यांकन, गोल्डन रिट्रीवल सेट्स, वर्ज़न्ड मेमोरी स्नैपशॉट्स के खिलाफ ऑफ़लाइन रिप्ले, और LLM-as-judge इवैल्यूएटर्स चाहिए जो खुद भी वर्ज़न्ड हों। ज़्यादातर टीमों के पास इनमें से कुछ भी नहीं—वे बिना आंकड़ों के उड़ रही हैं। उन्हें पता तब चलता है कि उनकी आखिरी डिप्लॉयमेंट ने गुणवत्ता घटा दी, जब कोई यूज़र बताता है।
गवर्नेंस वैकल्पिक नहीं है, और तकनीकी रूप से जितना आप सोचते हैं उससे कठिन है
GDPR के तहत ‘भूल जाने के अधिकार’ का विषय गैर-तुच्छ हो जाता है जैसे ही “वह चीज़ जो उपयोगकर्ता के बारे में जानती है” सौ अंतःक्रियाओं से निकला एक तथ्य हो। ऐसे सिस्टम से किसी उपयोगकर्ता का डेटा हटाने का क्या मतलब है जिसने उसे फैक्ट मेमोरी में पहले ही समाहित कर लिया है? EU AI Act इसके ऊपर एक और परत जोड़ता है, जिसकी अधिकांश बाध्यताएं (जिनमें डेटा गवर्नेंस, मानव पर्यवेक्षण, और उच्च-जोखिम सिस्टम्स के लिए पारदर्शिता आवश्यकताएं शामिल हैं) अगस्त 2026 में लागू होती हैं।
जो टीमें 2026 की दूसरी छमाही में यूरोप में एआई प्रोडक्ट्स शिप कर रही होंगी, उन्हें ऐसे सवालों के जवाब चाहिए होंगे जिनका समाधान क्षेत्र ने सामूहिक रूप से अभी तक नहीं निकाला: किसी व्युत्पन्न तथ्य से उपयोगकर्ता के योगदान को प्रमाणिक रूप से कैसे हटाएं, किसी मेमोरी प्रोमोशन की वंशावली (lineage) का ऑडिट कैसे करें, यह कैसे दिखाएं कि मेमोरी स्टोर वही स्कोप रखता है जैसा आप कहते हैं।
किसी का जवाब अभी अच्छा नहीं है। फिर भी काम करना होगा, और रेगुलेटर्स उद्योग के इंतजार में नहीं बैठेंगे।
इसीलिए कॉन्टेक्स्ट इंजीनियरिंग प्रॉम्प्ट इंजीनियरिंग नहीं, सिस्टम्स डिज़ाइन है। ज़्यादातर दिलचस्प काम सिस्टम्स के बीच के कनेक्शंस में होता है, जहां संदर्भ एक चरण से दूसरे में जाता है। लगभग कुछ भी प्रॉम्प्ट में खुद नहीं होता। और ऊपर के लगभग हर ट्रेड-ऑफ का एक सस्ता-सा लगने वाला शॉर्टकट है जो तकनीकी कर्ज़ में बदलकर सबसे गलत वक्त पर वसूला जाता है।
मेमोरी लेयर कहां कंवर्ज हो रही है
एक बार मान लें कि मेमोरी पांच अलग-अलग चीज़ें हैं, जिनके कई अलग एक्सेस पैटर्न हैं, तो अगला स्वाभाविक सवाल है: यह सब रहता कहां है?
हाइब्रिड रिट्रीवल—मतलब एक ही सिस्टम में लेक्सिकल प्लस सेमांटिक—इस बिंदु पर काफी हद तक हल समस्या है। Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate, और Postgres के वेक्टर एक्सटेंशंस सभी इसका कोई-न-कोई संस्करण सपोर्ट करते हैं, और प्रोडक्शन-क्वालिटी गैप वेंडर मार्केटिंग जितना चौड़ा नहीं है। अगर पूरी मेमोरी लेयर बस “एंबेडिंग्स और फुल-टेक्स्ट सर्च” होती, तो आर्किटेक्चर का सवाल उबाऊ हो जाता।
वह इसलिए नहीं है क्योंकि मेमोरी केवल रिट्रीवल नहीं है। पांच प्रकारों को फिर देखें और नोटिस करें कि हर एक को अपने स्टोर से वास्तव में क्या चाहिए।
|
मेमोरी प्रकार |
स्टोर से क्या चाहिए |
|
पॉलिसी |
रिलेशनल। वर्ज़न्ड नियम, टेनेंट स्कोप्स, यूज़र्स और रोल्स के लिए फ़ॉरेन कीज़, ट्रांज़ैक्शनल अपडेट्स। |
|
पसंद |
संरचित और यूज़र-स्कोप्ड। यूज़र-किएड रो या JSON, पूर्वानुमेय स्कीमा। |
|
फैक्ट |
यहीं हाइब्रिड रिट्रीवल अपनी कीमत वसूलता है। उद्गम-स्रोत के साथ टिकाऊ अभिकथन, जिन्हें सेमांटिक समानता और एंटिटी या सोर्स पर एक्ज़ैक्ट मैच—दोनों से क्वेरी किया जा सके। |
|
एपिसोडिक |
संरचित सारांश, जिन पर रिट्रीवल हो सके। |
|
ट्रेस |
केवल-एपेंड इवेंट स्टोरेज, उच्च-वॉल्यूम, रिप्ले और रिट्रीवल के लिए उस पर वेक्टर इंडेक्सेज़ लेयर्ड। |
जो आकस्मिक आर्किटेक्चर आपके पास होगा, वह इन्हें उसी धुरी पर अलग करता है जहां सबसे ज़्यादा चोट लगती है। रिलेशनल डेटा Postgres या उसके मैनेज्ड समकक्ष में रहता है। हाइब्रिड रिट्रीवल Elasticsearch, OpenSearch, या Pinecone, Weaviate, LanceDB जैसे समर्पित वेक्टर स्टोर्स में।
ट्रेसेज़ S3 या किसी टाइम-सीरीज़ डेटाबेस में पहुंचते हैं। इनमें से हर एक अपने काम के लिए सशक्त विकल्प है, और कई प्रोडक्शन स्टैक्स इन्हें अच्छी तरह उपयोग करते हैं। समस्या किसी एक कंपोनेंट में नहीं। समस्या यह है कि हर सार्थक रिट्रीवल पाथ सिस्टम्स के पार एक जॉइन बन जाता है: “इस क्वेरी से संबंधित तथ्य ढूंढो, उन नीतियों से फ़िल्टर करके जो इस टेनेंट पर लागू होती हैं, उन यूज़र्स तक स्कोप्ड करके जिन्हें यह एजेंट देख सकता है।” वह जॉइन तीन सीमाओं को लांघता है: ट्रस्ट, ट्रांज़ैक्शन, और लेटेंसी। हर बार जब संदर्भ इनमें से किसी सीमा को पार करता है, आप ठीक वही कंसिस्टेंसी समस्या फिर से आमंत्रित करते हैं जिसे आप टालना चाहते थे।
यहीं आर्किटेक्चर की तस्वीर बदलती है। हाइब्रिड रिट्रीवल को उसी स्टोर में रखना जहां रिलेशनल डेटा है—यही भेदकारी क्षमता है, और यह केवल हाइब्रिड रिट्रीवल की समस्या से अलग है। हाइब्रिड रिट्रीवल फीचर के रूप में अब लगभग हर जगह उपलब्ध हो रहा है।
कम आम है रिलेशनल, डॉक्यूमेंट, और वेक्टर डेटा को एक ही ट्रांज़ैक्शनल और सिक्योरिटी बाउंड्री के तहत सह-स्थित करना, ताकि पॉलिसी, पसंद, तथ्य, और एपिसोडिक मेमोरी को ACID गारंटी के साथ एक साथ क्वेरी किया जा सके—बजाय इसके कि उन्हें सिस्टम्स के पार रीकॉन्साइल किया जाए।
Oracle AI Database इस कंवर्ज्ड, मल्टी-मॉडल अप्रोच का एक उदाहरण है: रिलेशनल टेबल्स, JSON दस्तावेज़, और वेक्टर एंबेडिंग्स एक ही इंजन में रहते हैं, एक ही SQL स्टेटमेंट में, एक ही ट्रांज़ैक्शन के अंदर एक साथ क्वेरी किए जा सकते हैं। एक बार आप पांच-प्रकार वर्गीकरण को गंभीरता से लें और पॉलिसी, पसंद, और तथ्य के बीच के जॉइन्स बनाना शुरू करें, तो सवाल “कौन-सा रिट्रीवल इंजन सबसे अच्छा है” से शिफ्ट होकर यह बन जाता है कि “वह रिलेशनल डेटा, जो उस रिट्रीवल को गवर्न करता है, वास्तव में कहां रहना चाहिए।”
व्यवहार में यह एक सिंगल SQL स्टेटमेंट जैसा दिखता है जो रिलेशनल पॉलिसी डेटा, JSON-एन्कोडेड पसंद, और फैक्ट मेमोरी पर वेक्टर समानता को जॉइन करता है। जो क्वेरी अन्यथा तीन सिस्टम्स में फैली होती, वह एक में सिमट जाती है:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
वह एक स्टेटमेंट एक साथ चार काम कर रहा है: टेनेंट पॉलिसी लागू करना, यूज़र पसंद का सम्मान करना, प्रति-तथ्य एक्सेस कंट्रोल लागू करना, और सेमांटिक समानता से रैंक करना। फेडरेटेड आर्किटेक्चर में, ये तीन अलग स्टोर्स के पार चार राउंड ट्रिप्स होते हैं—एक ऐसे कंसिस्टेंसी मॉडल के साथ जिसकी जिम्मेदारी आपकी है।
यहां यह एक क्वेरी प्लान, एक ट्रांज़ैक्शन बाउंड्री, एक जगह ऑडिट करने की है। वही ACID गारंटी जो 1970 के दशक से साझा स्टेट के सिस्टम ऑफ रिकॉर्ड के रूप में डेटाबेस को विश्वसनीय बनाती आई हैं—अब ऐसी मेमोरी पर लागू जो रो के साथ वेक्टर्स भी शामिल करती है।
इस पैटर्न के कामकाजी उदाहरण—हाइब्रिड सर्च के साथ एजेंटिक RAG और कॉन्टेक्स्ट इंजीनियरिंग के लिए मेमोरी आर्किटेक्चर पर एक नोटबुक सहित—Oracle के AI Developer Hub on GitHub पर उपलब्ध हैं।
फिर भी कुछ चीज़ों के लिए आपको विशिष्ट स्टोर्स चाहिए होंगे। उच्च-वॉल्यूम ट्रेस मेमोरी की स्थायित्व और लागत विशेषताएं आपके ऑपरेशनल डेटाबेस से अलग हैं। बड़े आर्टिफैक्ट्स जैसे दस्तावेज़, छवियां, और मॉडल आर्टिफैक्ट्स के लिए ब्लॉब स्टोरेज उसी जगह का हकदार है जो इसके लिए बना हो। कठोर डॉक्यूमेंट वर्कफ़्लोज़ के लिए एक समर्पित डॉक्यूमेंट डेटाबेस अब भी मायने रख सकता है, जहां आपको उस श्रेणी की विशिष्ट विशेषताएं चाहिए।
मुद्दा यह नहीं कि एकीकृत प्लेटफ़ॉर्म हर दूसरे स्टोर को खत्म कर देता है। मुद्दा यह है कि यह सबसे महंगे जॉइन को खत्म करता है: उस जॉइन को जो उस रिलेशनल डेटा के बीच है जो एजेंट को करने की अनुमति को गवर्न करता है और उस वेक्टर डेटा के बीच है जो एजेंट वास्तव में क्या करता है उसे आकार देता है। जब ये दोनों सह-स्थित होते हैं, तो स्थापत्य समस्या “इन स्टोर्स को सिंक में कैसे रखें” से शिफ्ट होकर “अच्छी मेमोरी नीतियां कैसे डिज़ाइन करें” बन जाती है—जो वास्तव में मायने रखती है।
आगे क्या आने वाला है: सात भविष्यवाणियां
ऊपर के सेक्शंस बताते हैं कि हम कहां हैं। ये इस बारे में दांव हैं कि हम कहां जा रहे हैं। जानबूझकर रायपूर्ण हैं। जिनसे असहमत हों—निःसंकोच रहें।
1. मॉडल मेमोरी नहीं बनता
लुभावनी कहानी यह है कि मॉडल प्रदाता मेमोरी को मॉडल में ही समाहित कर देंगे। लंबी कॉन्टेक्स्ट विंडोज़ खिंचेंगी, कैशिंग और स्मार्ट हो जाएगी, और बाहरी मेमोरी लेयर अनावश्यक हो जाएगी। ऐसा नहीं होगा। कॉन्टेक्स्ट विंडोज़ बढ़ती रहेंगी, पर हर टर्न पर प्राइमिंग फिर भी चाहिए होगी। मॉडल हर सत्र में स्टेटलेस रहता है, और बाहरी मेमोरी लेयर सिस्टम ऑफ रिकॉर्ड रहती है। जो बदलता है वह है बाहरी मेमोरी का बहुत स्मार्ट होना (आज वेक्टर स्टोर्स और हाइब्रिड प्लेटफ़ॉर्म्स, आगे जो अभी बने नहीं), और कॉन्टेक्स्ट इंजीनियरिंग वह कला बनती है कि मॉडल क्या, कब, और क्यों देखे। अगर कोई फ्रंटियर प्रदाता ऐसा प्रिमिटिव शिप करता है जो प्रोडक्शन उपयोग के लिए किसी बाहरी मेमोरी सिस्टम को विश्वसनीय रूप से बदल देता है, तो यह भविष्यवाणी गलत होगी। मैं इसके खिलाफ दांव लगाऊंगा।
2. परिपक्व एआई प्रोडक्ट्स के लिए मेमोरी इंफ्रास्ट्रक्चर पर खर्च इन्फेरेंस से आगे निकलता है
इन्फेरेंस लागत लगभग हर 18 महीने में एक ऑर्डर ऑफ मैग्निट्यूड से गिर रही है। स्टोरेज, रिट्रीवल, एंबेडिंग जनरेशन, रीरैंकिंग, और प्रति-रिक्वेस्ट संदर्भ का असेंबली ऐसा नहीं कर रहे। ये उपयोगकर्ता संख्या, सत्र गहराई, और इंटरैक्शन इतिहास के साथ स्केल करते हैं—जो सब बढ़ रहे हैं। प्रमुख क्लाउड बिल लाइन GPU टोकन्स से वेक्टर और हाइब्रिड रिट्रीवल इंफ्रास्ट्रक्चर की ओर शिफ्ट होती है। इससे बिल्ड-वर्सस-बाय सवाल नया आकार लेता है। मेमोरी इंफ्रास्ट्रक्चर मॉडल लेयर की तरह कमोडिटाइज़ नहीं होता। जो टीमें लंबी दौड़ में जीतती हैं वे वही हैं जो दिन एक से मेमोरी इंफ्रास्ट्रक्चर को फर्स्ट-क्लास निवेश मानती हैं।
3. क्लासिकल RAG लेगेसी आर्किटेक्चर बन जाता है
“डॉक्यूमेंट्स एंबेड करो, यूज़र क्वेरी पर top-k, प्रॉम्प्ट में भर दो”—यह एआई आर्किटेक्चर का COBOL है। यह काम करता है, हर जगह है, और बाद में शर्मनाक लगेगा। इसका विकल्प पहले से दिख रहा है: एजेंटिक रिट्रीवल, जहां मॉडल अपनी खोजों की योजना बनाता है, मल्टी-स्टेप क्वेरियां जारी करता है, मध्यवर्ती परिणाम पढ़ता है, और आगे क्या लाना है यह तय करता है। यह एक डेटाबेस लुकअप जैसा कम और एक रिसर्च प्रक्रिया जैसा ज़्यादा दिखता है। जो टीमें आज भी स्टैटिक RAG पाइपलाइन्स बना रही हैं, वे माइग्रेशन पथ पर हैं—चाहे जानती हों या नहीं।
4. मेमोरी विरोधी सतह (adversarial surface) बन जाती है
मेमोरी हमले उस तरह चक्रवृद्धि होते हैं जिस तरह प्रॉम्प्ट इंजेक्शन नहीं। कोई प्रतिद्वंद्वी जो किसी दीर्घ-जीवी मेमोरी स्टोर में लिख सकता है—सीधे या किसी ऐसे इनपुट चैनल से जिसे आपने विशेषाधिकार प्राप्त नहीं माना—वह उस सिस्टम के व्यवहार को हर भविष्य के उपयोगकर्ता के लिए आकार दे सकता है। एक्सफ़िल्ट्रेशन उलटी दिशा में भी वैसे ही काम करता है: एक सत्र का संदर्भ दूसरे में लीक हो जाना क्योंकि स्कोपिंग मॉडल ढीला था। पहला गंभीर वास्तविक-दुनिया मेमोरी पॉइज़निंग घटनाक्रम आने वाला है। इसके बाद प्रति-तथ्य उद्गम-स्रोत, अटेस्टेशन, और एक्सेस कंट्रोल पर उद्योग-स्तरीय हड़बड़ी होगी।
5. कॉन्टेक्स्ट प्राइवेसी सीमाएं अनुपालन आवश्यकताएं बन जाती हैं
“कॉन्टेक्स्ट स्कोपिंग एक सुरक्षा सीमा है” से अगला तार्किक कदम है मेमोरी खंडों का क्रिप्टोग्राफ़िक आइसोलेशन, ताकि एजेंट्स केवल आवश्यकता-आधार पर संदर्भ उजागर कर सकें। यह तब मायने रखता है जब आपके पास अलग भरोसा-स्तरों वाले सब-एजेंट्स हों, या रेग्युलेटरी रेजीम्स हों जो संवेदनशील तथ्यों के प्रूवेबल स्कोपिंग की मांग करते हैं। “एजेंट मेमोरी स्कोप्स के बीच अपर्याप्त आइसोलेशन” को उद्धृत करने वाली पहली रेग्युलेटेड-इंडस्ट्री ऑडिट फाइंडिंग इस बदलाव का उत्प्रेरक होगी—उसके बाद अनुपालन फ़्रेमवर्क्स आएंगे। जिन टीमों के रोडमैप पर पहले से क्रिप्टोग्राफ़िक स्कोपिंग है वे उन RFPs को जीतेंगी जो उस पर निर्भर हैं। जिनके पास नहीं, वे डेडलाइन के दबाव में इसे रेट्रोफ़िट करेंगी।
6. मल्टी-एजेंट कंसिस्टेंसी एक नामित, अपेक्षित क्षमता बनती है
आज, एक बिलिंग एजेंट और एक सपोर्ट एजेंट जो एक ही कस्टमर अकाउंट को छूते हैं, विरोधाभासी उत्तर दे सकते हैं क्योंकि उन्होंने मेमोरी के अलग स्लाइस खींचे और कुछ भी उन्हें समेटता नहीं। यह अभी इसलिए सहने योग्य है क्योंकि अधिकांश प्रोडक्शन डिप्लॉयमेंट्स सिंगल-एजेंट हैं। जैसे ही मल्टी-एजेंट सिस्टम्स बड़े पैमाने पर प्रोडक्शन में आते हैं, उपयोगकर्ता विरोधाभास पकड़ना शुरू कर देंगे, और “प्रासंगिक कंसिस्टेंसी” एक नामित क्षमता बन जाएगी जिस पर प्लेटफ़ॉर्म्स प्रतिस्पर्धा करेंगे। यह पहले वेंडर तुलना मैट्रिक्स में दिखेगा, फिर एंटरप्राइज प्रोक्योरमेंट चेकलिस्ट्स में। इसे जल्दी हल करना एक विभेदक बनता है। इसे अनदेखा करना आपके अपने दो एजेंट्स के एक ही कस्टमर पर असहमति वाले सपोर्ट टिकट्स को जन्म देता है।
7. “प्रति व्यक्ति उपयोगी संदर्भ” एक बेंचमार्क्ड मीट्रिक बनता है
बेंचमार्क्स मॉडल्स से पूरे सिस्टम्स की ओर शिफ्ट होंगे, और हेडलाइन मीट्रिक कुछ ऐसा होगा: प्रति उपयोगकर्ता, प्रति इंटरैक्शन वह उपयोगी संदर्भ जो साथ ले जाया गया। यही संख्या वास्तव में उपयोगकर्ता प्रतिधारण और उस उत्पाद के बीच के अंतर की भविष्यवाणी करती है जो आपको जानता हुआ लगता है बनाम वह जो हर मंगलवार रीसेट हो जाता है। इसे अकादमिक पेपर्स से पहले निवेशकों के डेक्स में देखें। एक सहसंबद्ध मीट्रिक, ‘प्रति उपयोगी संदर्भ टोकन लागत’, यूनिट इकोनॉमिक्स का सवाल बन जाएगा जिसका जवाब देना उचित होगा।
सोमवार को क्या करें
अगर आप इसमें नए हैं और शुरू करने की जगह चाहते हैं: मेमोरी को एक चीज़ मानना बंद करें। कोई ऐसा प्रोडक्शन एजेंट चुनें जिसकी आपको पहुंच हो, लेबल करें कि उसके प्रत्येक स्टोर में वास्तव में किस तरह की मेमोरी है, और नोटिस करें कि कितनी बार एक स्टोर तीन कामों के लिए उपयोग हो रहा है।
अगर आप पहले से एजेंट बना रहे हैं: लूप को इंस्ट्रूमेंट करें। विशेष रूप से, रिट्रीवल और प्रोमोशन के बीच के सिग्नल को इंस्ट्रूमेंट करें। मैंने बहुत-सी टीमें देखी हैं जो आपको बता सकती हैं कि किसी दिए गए टर्न पर उनके सिस्टम ने क्या रिट्रीव किया। बहुत कम बता पाती हैं कि उन रिट्रीव्ड मेमोरीज़ में से मॉडल ने वास्तव में किन्हें उपयोग किया, और लगभग कोई नहीं बता पाता कि किसी दी गई मेमोरी को पहली जगह प्रोमोट क्यों किया गया।
कौन-सी मेमोरीज़ उपयोग हुईं—यह जानना ही आपको अगले प्रोमोशन स्टेप पर उन्हें सुदृढ़ करने देता है, और यहीं से मेमोरी सिस्टम ‘राइट-वंस लॉग’ होना छोड़कर वास्तव में सीखना शुरू करता है।
वही फीडबैक लूप वह जगह है जहां चक्रवृद्धि बढ़त बसती है—और इसी अनुशासन के अगले दौर का रोचक काम यहीं हो रहा है।
हर टीम को लगभग एक ही टाइमलाइन पर वही फ्रंटियर मॉडल्स मिलते हैं। जो कोई कॉपी नहीं कर सकता, वह है वह मेमोरी लेयर जो आप उनके चारों ओर बनाते हैं—जो आपके उपयोगकर्ताओं, आपके फैसलों, और इस पर आपके निर्णय से आकार लेती है कि क्या याद रखने लायक है।
मॉडल साझा हैं। मेमोरी सिस्टम आपका अपना है।