Hay un cambio arquitectónico a la vista
Durante los últimos años, mucha gente ha tratado la IA como si fuera una API.
Envías un prompt, recibes una respuesta y, si te pones fino, lo envuelves con reintentos y algo de logging y lo llamas sistema. Para demos funcionó. Es lo que permitió que esta ola se desplegara tan rápido. Pero el patrón se rompe en cuanto intentas construir algo que deba operar en el tiempo.
Los sistemas de IA en producción se comportan más como procesos que como APIs.
En cuanto introduces continuidad, todo cambia. Ya no es una única petición y respuesta. Es una secuencia de interacciones que dependen entre sí. Necesitas memoria y estado, y debes decidir qué importa ahora, qué importó hace cinco minutos y qué debería seguir importando mañana.
Y cuando cruzas esa línea, te das cuenta de que esto no va de escalar el prompt engineering.
Esto va de diseño de sistemas.
Lo que realmente construyes no es un mejor prompt. Construyes un sistema que decide cómo se filtra y evoluciona el contexto con el tiempo. De ahí nace una disciplina. Eso es la ingeniería de contexto.
El contexto no es el prompt
Abre cualquier agente en producción en tu depurador y mira lo que realmente se envía al modelo en un turno. Casi nunca es solo el mensaje del usuario. Una petición típica se parece a esto:
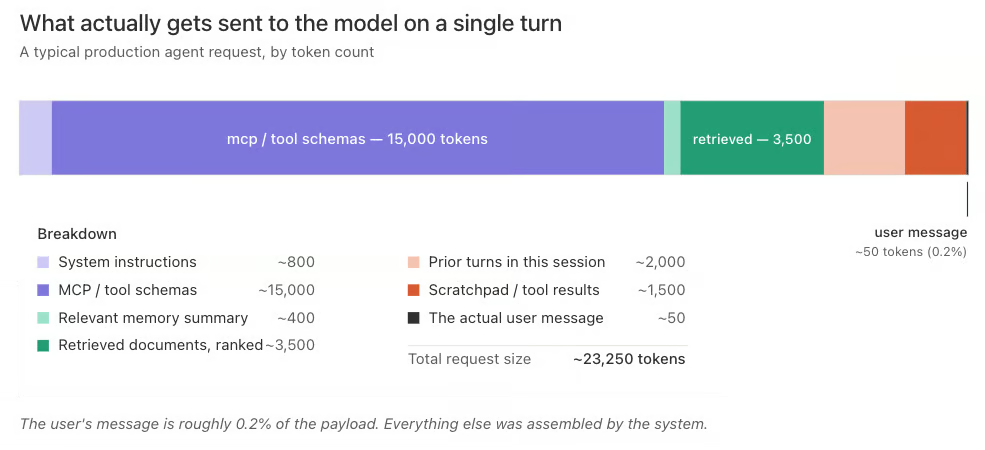
El mensaje del usuario es la parte más pequeña del payload. Todo lo demás se filtró y se inyectó en el prompt. Esos bloques son la salida de una canalización que diseñaste, aunque no fueras del todo consciente de ello.
Esa canalización es el verdadero producto. El modelo es el runtime. La ingeniería de contexto es el diseño de esa canalización.
Una vez aceptas esta distinción, la arquitectura se ve muy diferente.
La memoria no es una sola cosa
"Añadir memoria" es el nuevo "añadir caché". Suena a una única funcionalidad, pero en realidad son varios sistemas distintos que comparten nombre. Si no los separas, acabarás con un único blob store que responde mal a todo: olvidadizo en unas cosas y obsesivo en otras.
La primera división nos la dio la ciencia cognitiva y a ella convergen la mayoría de profesionales: memoria a corto plazo (STM) y memoria a largo plazo (LTM). La memoria a corto es lo que entra en la ventana de contexto: el conjunto de trabajo que el modelo puede ver en este turno.
La memoria a largo es todo lo que sobrevive más allá de una llamada: hechos, artefactos, planes, decisiones previas, salidas de herramientas y reglas. La memoria a corto es un problema de presupuesto. La memoria a largo es un problema de sistemas.
Los cinco tipos siguientes son todos de largo plazo, organizados por su fin y cómo deben almacenarse. Encajan con la taxonomía canónica semántica, episódica y procedimental que verás en marcos inspirados en ciencia cognitiva como CoALA. Subdivido dos categorías porque en producción necesitan gobernanzas distintas.
Memoria de políticas
Reglas y restricciones normativas. Normalmente globales o por inquilino. Versionadas y estrictamente controladas. Define lo que el sistema tiene permitido hacer: cumplimiento, límites de marca, fronteras de seguridad. Cambia rara vez y de forma deliberada. Es memoria procedimental en el sentido cognitivo: reglas y flujos que moldean el comportamiento entre sesiones. La misma categoría que guarda archivos como CLAUDE.md o AGENTS.md en agentes "filesystem-first".
Memoria de preferencias
Parámetros de personalización estables. Normalmente a nivel de usuario. Esta persona quiere respuestas en JSON, aquella prefiere viñetas, este cliente usa fechas en formato DD/MM/AAAA. La memoria de preferencias hace que el sistema se sienta adaptado sin tener que repetirlo en cada sesión. Junto con la memoria de hechos, forma la capa semántica: afirmaciones duraderas y consultables sobre el mundo y sus elementos.
Memoria de hechos
Afirmaciones duraderas que el agente puede reutilizar. Deben incluir procedencia. «La base de datos de producción del cliente está en us-east-1» es un hecho. También lo es «su año fiscal empieza en abril». Los hechos son donde vive la ventaja compuesta y donde están los problemas de diseño más duros, porque cada hecho que escribes es una apuesta sobre el futuro. Separo los hechos de las preferencias porque tienen flujos de escritura, perfiles de caducidad y requisitos de gobernanza distintos, aunque ambas sean memoria semántica a nivel cognitivo.
Memoria episódica
Resúmenes estructurados de trabajo completado. Cosas como «caso resuelto» o «migración completada». Artefactos reutilizables que el sistema destila a partir de trazas. La memoria episódica permite que el sistema reconozca ya hemos hecho esto antes y recupere la forma de la solución previa.
Memoria de trazas
Eventos de ejecución en bruto, de solo anexado. Es tu registrador de vuelo. De alto volumen, útil sobre todo para recuperación y reproducción, y no es el lugar adecuado para saber cómo es un usuario, solo lo que hizo. La distinción importa porque muchos equipos confunden ambas cosas y acaban haciendo búsquedas semánticas sobre logs de ejecución para inferir preferencias.
En una taxonomía más gruesa, tanto la memoria episódica como la de trazas caen bajo el paraguas episódico, incluyendo transcripciones, salidas de herramientas e historiales de ejecución. Yo las separo porque en producción el flujo bruto y el resumen destilado tienen patrones de acceso, retención y costes muy distintos. Tratarlo como una sola cosa es cómo se termina pagando precio de base de datos vectorial para hacer grep a tus logs.
La memoria de trabajo no aparece aquí porque no es de largo plazo. Es la ventana de contexto en sí, el conjunto que el modelo puede ver en el turno actual. La memoria de trabajo es real e importante, y gran parte del trabajo de ML aplicado hoy vive ahí: compresión de prompts, reutilización de la caché KV, atención de ventana deslizante, las matemáticas de presupuesto sobre qué ocupa esos tokens.
Pero, por definición, es transitoria, y confundirla con los almacenes persistentes anteriores produce arquitecturas donde el bloc de notas y el sistema de registro comparten base de datos. No deberían. La memoria de trabajo se monta en cada turno a partir de la memoria a largo plazo y se descarta salvo que se promocione explícitamente. El paso de promoción es donde se juntan ambas capas y donde ocurre gran parte del diseño interesante.
Cuando alguien dice «nuestro agente tiene memoria», pregunta a cuál de estas cinco se refiere. Si la respuesta es «lo volcamos todo en un vector store», acabas de encontrar la razón por la que su agente es olvidadizo en unas cosas y obsesivo en otras.
El bucle y dónde se rompe
Todo sistema de IA en producción acaba convergiendo al mismo patrón: un bucle.
La forma no es polémica. La mayoría de descripciones del bucle de un agente se reducen a cinco pasos: armar el contexto, llamar al modelo, ejecutar acciones, observar resultados y actualizar la memoria, y vuelta a empezar. Yo etiqueto las fases de forma ligeramente distinta porque separo las dos mitades de «armar contexto» (lo que absorbes vs. lo que seleccionas) y porque creo que la promoción merece nombre propio en lugar de diluirse en «actualizar memoria».
Pero la anatomía subyacente es la misma, y verás los mismos cinco puntos de inflexión vengas del runtime del agente, de la base de datos o del prompt.
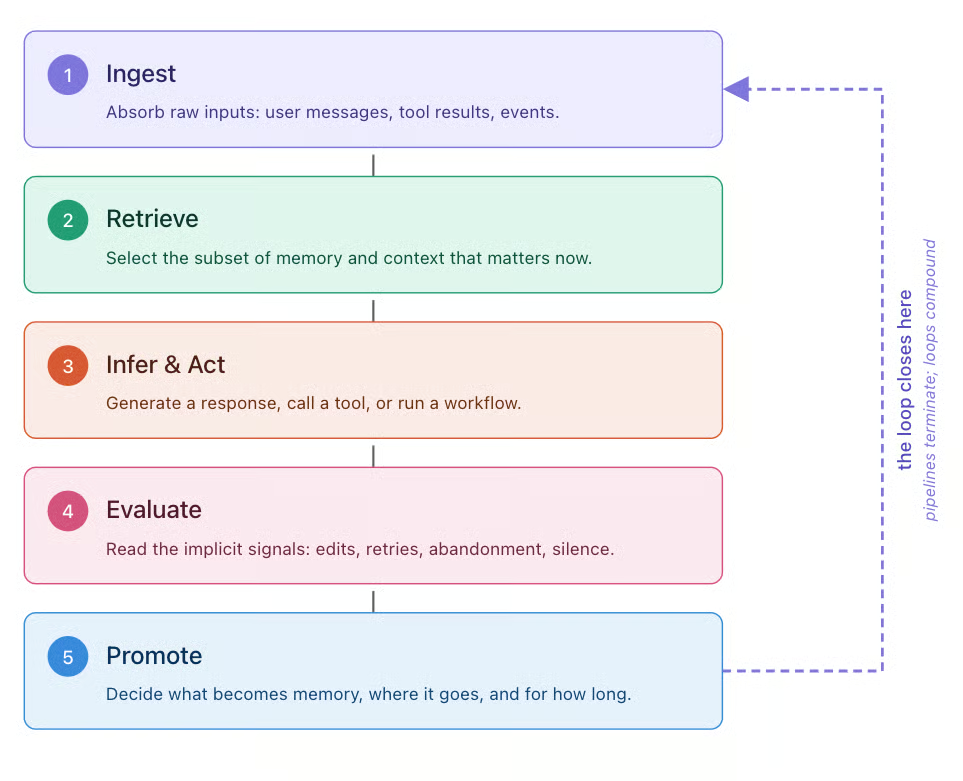
ReAct popularizó en 2022 la intercalación de razonamiento y acción; los sistemas de agentes en producción han ampliado ese patrón al bucle más amplio de arriba. El diagrama ayuda, pero conocer el modo de fallo de cada fase te dice dónde invertir tiempo de ingeniería.
Injest
Ingest falla cuando aceptas demasiado. Ingest es la primera mitad de armar el contexto: absorber entradas en bruto del entorno. Tratar cada evento como contexto potencial crea ruido que la recuperación deberá deshacer después. La disciplina aquí está en el borde. ¿Qué estás rechazando absorber?
Retrieve
Retrieve falla en silencio. Retrieve es la segunda mitad del armado de contexto: seleccionar qué subconjunto de memoria a largo plazo importa ahora. No lanza una excepción si devuelve el bloque equivocado; solo hace que el modelo suene ligeramente fuera de tono. Es la fase menos atendida del bucle y la que más correlaciona con la calidad percibida del sistema.
La búsqueda puramente semántica es un primer borrador. En la mayoría de sistemas en producción, la base es filtrado por metadatos más recuperación híbrida léxica/semántica con reranking; a partir de ahí, la descomposición de consultas, el recorrido de grafos y la recuperación multi-hop ayudan cuando las tareas son composicionales, pero deben acotarse por latencia y presupuesto de evaluación.
Infer & Act
Infer & Act falla cuando el contexto impulsa el comportamiento equivocado. Aquí junto llamar al modelo y ejecutar acciones porque la planificación y la invocación de herramientas son consecuencia de lo que el contexto montado hace que el modelo decida. Aquí muerden los fallos de contexto largo: pérdida en medio, sesgo de recencia, pudrición del contexto.
La intuición dice que más contexto debería mejorar la respuesta de forma monótona. Le das más información al modelo y, en teoría, debería rendir mejor. En la práctica, más tokens a menudo lo empeoran. Presupuestar el contexto ya es una disciplina real, y el instinto por defecto de «darle al modelo todo lo que tenemos» es el error por defecto.
Evaluate
Evaluate es la fase que la mayoría de sistemas ni siquiera tienen. Introduce feedback observando el resultado de las acciones. Quieres saber si la respuesta ayudó, si el flujo tuvo éxito y si el usuario tuvo que corregirla.
Aunque no captures feedback explícito, hay señales. Algunas que funcionan bien en producción: tiempo hasta el siguiente mensaje (una réplica rápida suele indicar que la respuesta no convenció), distancia de edición entre tu salida y la versión que el usuario envió o guardó (ediciones pequeñas son ruido, grandes son corrección) y abandono dentro de N segundos tras el resultado de una herramienta (el usuario vio lo que generaste y se fue).
Ninguna de estas requiere que el usuario puntúe nada. Solo necesitas instrumentar lo que ya ocurre. Estas señales implícitas están por todas partes, pero nada en el stack las escucha. Sin este paso, el bucle no se cierra: el sistema corre pero no aprende de lo que produce.
Promote
Promote es la fase más fácil de implementar mal. Promote es la mitad de actualizar memoria que escribe en el almacenamiento a largo plazo. La mayoría de equipos peca por exceso: lo vuelcan todo y envenenan el propio almacén. Lo que necesitas es una política real, por escrito, que responda seis preguntas:
- ¿Qué se escribe?
- ¿Con qué granularidad?
- ¿En qué tipo de memoria?
- ¿Con qué procedencia?
- ¿Con qué caducidad?
- ¿Bajo qué autoridad?
Este es el paso más difícil de acertar, y también el más crucial.
Las canalizaciones terminan. Los bucles se componen. La diferencia está en Promote.
Antipatrones que probablemente estás enviando
Si llevas unos meses construyendo agentes, casi seguro que has enviado varios de estos. Los primeros experimentos de mi equipo tropezaron con todos, por eso sé cómo se ven desde dentro.
- Volcar la transcripción completa en cada turno: Es la forma perezosa de preservar estado. Es carísimo, sufre pudrición de contexto rápido y degrada la calidad de respuestas de formas que no verás hasta que los usuarios se quejen. Un resumidor compacto en segundo plano no es opcional a escala, y el caché de prompts debería reservarse para prefijos estables (prompts de sistema, definiciones de herramientas, bloques de política estáticos) con payloads volátiles de recuperación después de las secciones en caché.
- Sobrecarga de contexto en tu estrategia de recuperación: El equivalente del lado de retrieval es tratarlo como un cajón desastre, trayendo los top-20 y esperando que el modelo los ordene. En realidad los promedia, que es peor que elegir cinco buenos.
- Tratar el bloc de notas como memoria: Cuando los resultados de llamadas a herramientas, el razonamiento intermedio y los artefactos generados se cuelan en el almacenamiento a largo plazo porque nada los descarta explícitamente. Tu «memoria» es, en su mayoría, residuos.
- Un solo almacén para cada tipo de memoria: Cuando todo va a un único índice vectorial —trazas, hechos, preferencias, políticas y resúmenes—, retrieval no puede desambiguar entre ellos y el modelo tampoco.
- Memoria que nunca olvida: El fallo opuesto: sin TTL, sin caducidad, sin expulsión. En pocos meses se convierte en una carga. Algunas de las mejores conductas que puedes añadir son políticas de olvido agresivas.
- Promocionar con el pulgar arriba del usuario: Trampa: la señal más fuerte es la más rara y sesgada. Si solo promocionas con señales positivas explícitas, optimizas para el clic, no para la calidad real.
- Sin reproducción: Sin capacidad de replay, depurar es conjetura. No puedes reproducir la sesión de ayer porque la memoria ya cambió. Esta es la clase de bugs que arruina los post-mortem.
Por qué esto es diseño de sistemas, no "sensaciones"
Lo que merece llamarse «diseño de sistemas» no es el modelo mental. Son los trade-offs, y cada uno tiene una respuesta incorrecta más barata de enviar y más cara de mantener.
La economía de tokens ahora marca la arquitectura de las peticiones
Los aciertos de caché de prompt cuestan una fracción de un fallo: a menudo solo el 10% del precio estándar de entrada en la API de Anthropic y en los modelos más nuevos de OpenAI, y un 25% en Gemini de Google. Esa tarificación ha reconfigurado qué conviene poner y dónde en una petición, y los prefijos amigables con la caché, esquemas estables de herramientas e instrucciones de sistema fijas ya no son detalles cosméticos.
Eso pone el techo de ahorro entre 4x y 10x en tokens de entrada, según el proveedor, antes de contar el efecto compuesto en cargas agenticas, donde el mismo prefijo se reenvía en cada paso. Con una buena estrategia de caché, un agente bien diseñado cuesta varias veces menos que uno mal diseñado haciendo el mismo trabajo. Es lo más parecido a un problema de líneas de caché en ingeniería de IA, y muchos equipos lo tratan como si fuera CSS.
Retrieval es un problema de arquitectura
En producción es híbrido (léxico + semántico), con reranking y reescritura de consultas. El techo es la recuperación agentica, donde el modelo emite y refina sus propias búsquedas dentro del bucle. La distancia entre ambos es enorme, invisible en benchmarks y evidente en cada interacción de usuario. Si tu retrieval es una sola llamada top-k, es la razón de que tu agente parezca "torpe".
Acotar el contexto es un perímetro de seguridad
Aislamiento multi-tenant, sandboxing de subagentes, fugas entre sesiones. No son endurecimientos que haces después. Si un subagente puede ver el conjunto de trabajo del padre por defecto, tienes un problema esperando a suceder, y la única duda es si lo encuentras tú o un adversario.
Evaluar es más difícil que en cualquier clase de sistema anterior
Sistemas con estado, estocásticos y dependientes de la trayectoria no se testean con unit tests. Necesitas evaluación basada en trazas, conjuntos dorados de retrieval, reproducción offline contra instantáneas versionadas de memoria y evaluadores LLM-as-judge también versionados. La mayoría de equipos no tiene nada de esto y vuela a ciegas. Se enteran de la regresión por un usuario.
La gobernanza no es opcional y es técnicamente más dura de lo que crees
El derecho al olvido del RGPD deja de ser trivial en cuanto «lo que sabe del usuario» es un hecho derivado de cien interacciones. ¿Qué significa borrar los datos de un usuario de un sistema que ya los absorbió en la memoria de hechos? La AI Act de la UE añade otra capa, con la mayoría de obligaciones (gobernanza de datos, supervisión humana y transparencia para sistemas de alto riesgo) entrando en vigor en agosto de 2026.
Los equipos que envíen productos de IA a Europa en la segunda mitad de 2026 necesitarán respuestas a preguntas que el sector aún no ha resuelto: cómo eliminar de forma verificable la contribución de un usuario a un hecho derivado, cómo auditar el linaje de una promoción de memoria, cómo demostrar que un almacén de memoria está acotado como dices.
Nadie tiene una respuesta buena aún. Aun así debe funcionar, y los reguladores no van a esperar a que el sector lo averigüe.
Por eso la ingeniería de contexto va de diseño de sistemas y no de prompt engineering. La mayor parte del trabajo interesante ocurre en las conexiones entre sistemas, cuando el contexto pasa de una etapa a otra. Casi nada está en el prompt en sí. Y casi cada trade-off tiene un atajo barato que se convierte en deuda técnica que pagarás en el peor momento.
Hacia dónde converge la capa de memoria
Una vez aceptas que la memoria son cinco cosas con patrones de acceso distintos, la siguiente pregunta es: ¿dónde vive todo eso?
La recuperación híbrida —léxica más semántica en un mismo sistema— está en gran medida resuelta. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate y las extensiones vectoriales de Postgres lo soportan, y la brecha de calidad en producción es menor de lo que sugiere el marketing. Si toda la capa de memoria fuera solo «embeddings y búsqueda full-text», la arquitectura sería aburrida.
No lo es, porque la memoria no es solo retrieval. Mira otra vez los cinco tipos y fíjate en lo que cada uno necesita de su almacén.
|
Tipo de memoria |
Qué necesita del almacén |
|
Políticas |
Relacional. Reglas versionadas, ámbitos por inquilino, claves foráneas a usuarios y roles, actualizaciones transaccionales. |
|
Preferencias |
Estructuradas y por usuario. Filas o JSON indexado por usuario, esquema predecible. |
|
Hechos |
Aquí la recuperación híbrida demuestra su valor. Afirmaciones duraderas con procedencia, consultables por similitud semántica y coincidencia exacta por entidad o fuente. |
|
Episódica |
Resúmenes estructurados con recuperación sobre ellos. |
|
Trazas |
Almacenamiento de eventos de solo anexado, alto volumen, con índices vectoriales para reproducción y recuperación. |
La arquitectura accidental que acabas teniendo separa esto por el eje que más duele. Los datos relacionales viven en Postgres o equivalente gestionado. La recuperación híbrida vive en Elasticsearch, OpenSearch o un vector store dedicado como Pinecone, Weaviate o LanceDB.
Las trazas acaban en S3 o en una base de datos de series temporales. Cada pieza es fuerte para lo que fue diseñada y muchas pilas de producción las usan bien. El problema no es cada componente por separado. Es que cada ruta de recuperación significativa se convierte en un join entre sistemas: «encuentra hechos relevantes para esta consulta, filtrados por las políticas de este inquilino y acotados a los usuarios que este agente puede ver». Ese join cruza tres fronteras: confianza, transacción y latencia. Cada vez que el contexto cruza una de esas fronteras, reintroduces el problema de consistencia que intentabas evitar.
Aquí es donde cambia el dibujo de arquitectura. La recuperación híbrida en el mismo almacén que los datos relacionales es la capacidad diferencial, y eso es distinto de la recuperación híbrida a secas. La recuperación híbrida como feature está apareciendo en todas partes.
Lo menos común es co-ubicar datos relacionales, documentos y vectores bajo un único perímetro transaccional y de seguridad, de forma que las memorias de política, preferencias, hechos y episodios se consulten juntas con garantías ACID en lugar de reconciliarse entre sistemas.
Oracle AI Database es un ejemplo de este enfoque convergente y multimodelo: tablas relacionales, documentos JSON y embeddings vectoriales viven en un único motor, consultables juntos en una sola sentencia SQL, dentro de una única transacción. Cuando tomas en serio la taxonomía de cinco tipos y dibujas los joins entre política, preferencia y hecho, la pregunta pasa de cuál motor de retrieval es mejor a dónde debe vivir realmente el dato relacional que gobierna ese retrieval.
En la práctica, esto se ve como una única sentencia SQL que une datos relacionales de política, preferencias en JSON y similitud vectorial sobre memoria de hechos. La consulta que, de otro modo, abarcaría tres sistemas, se reduce a uno:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Esa única sentencia hace cuatro cosas a la vez: aplica la política del inquilino, respeta la preferencia del usuario, aplica controles de acceso por hecho y ordena por similitud semántica. En una arquitectura federada, eso son cuatro idas y vueltas entre tres almacenes, con un modelo de consistencia que debes defender tú.
Aquí es un único plan de consulta, un perímetro transaccional, un lugar donde auditar. Las mismas garantías ACID que han hecho de las bases de datos el sistema de registro del estado compartido desde los 70, ahora aplicadas a una memoria que incluye vectores junto a filas.
Ejemplos funcionales de este patrón, incluyendo RAG agentico con búsqueda híbrida y un notebook sobre arquitectura de memoria para ingeniería de contexto, están en el AI Developer Hub de Oracle en GitHub.
Seguirás queriendo almacenes especializados para algunas cosas. La memoria de trazas a gran volumen tiene otras necesidades de durabilidad y coste que tu base operativa. El almacenamiento de blobs para documentos, imágenes y artefactos de modelos debe ir a un servicio hecho para ello. Una base de datos de documentos dedicada puede seguir teniendo sentido para flujos de documentos exigentes donde necesites sus features específicas.
La idea no es que una plataforma unificada elimine todos los demás almacenes. La idea es que elimina el join más caro: el que une los datos relacionales que gobiernan lo que el agente puede hacer con los datos vectoriales que moldean lo que el agente hace de verdad. Cuando ambos cohabitan, el problema arquitectónico pasa de «cómo mantengo estos stores sincronizados» a «cómo diseño buenas políticas de memoria», que es el problema que realmente importa.
Siete predicciones de lo que viene
Lo anterior describe dónde estamos. Esto es una apuesta sobre hacia dónde vamos. Son posturas deliberadas. Discrepa de lo que no compartas.
1. El modelo no se convierte en la memoria
La tentación es que los proveedores metan la memoria en el propio modelo. Las ventanas de contexto crecen, la caché se vuelve más lista y la memoria externa deja de hacer falta. No va a pasar. Las ventanas crecerán, pero seguirán necesitando cebado en cada turno. El modelo sigue sin estado en cada sesión y la memoria externa sigue siendo el sistema de registro. Lo que cambia es que la memoria externa se vuelve mucho más inteligente (hoy, stores vectoriales y plataformas híbridas; mañana, cosas aún por construir), y la ingeniería de contexto se convierte en el arte de decidir qué ve el modelo, cuándo y por qué. Si un proveedor de frontera lanza un primitivo que sustituye de verdad a un sistema de memoria externo para producción, esta predicción es falsa. Yo apostaría en contra.
2. La infraestructura de memoria superará al gasto en inferencia en productos maduros de IA
Los costes de inferencia caen aproximadamente un orden de magnitud cada 18 meses. El almacenamiento, la recuperación, la generación de embeddings, el reranking y el montaje de contexto por petición no. Escalan con usuarios, profundidad de sesión e historial de interacción, todo al alza. La partida dominante de la factura cloud pasa de tokens de GPU a infraestructura vectorial e híbrida. Esto reconfigura el build-vs-buy. La infraestructura de memoria no se comoditiza como la capa de modelos. Ganarán a largo plazo quienes la traten como inversión de primera desde el día uno.
3. El RAG clásico se convertirá en arquitectura heredada
«Embeddear documentos, top-k sobre la consulta del usuario, meterlo en el prompt» será el COBOL de la arquitectura de IA. Funciona, está en todas partes y en retrospectiva dará vergüenza. El reemplazo ya se ve: recuperación agentica, donde el modelo planifica sus búsquedas, emite consultas multi-paso, lee resultados intermedios y decide qué traer después. Se parece menos a mirar una base de datos y más a investigar. Quienes sigan construyendo RAG estático hoy están en ruta de migración, lo sepan o no.
4. La memoria será la nueva superficie de ataque
Los ataques a memoria se componen de un modo que el prompt injection no. Un adversario que pueda escribir en un almacén de memoria duradero, ya sea directo o a través de un canal de entrada que no consideraste privilegiado, puede moldear el comportamiento del sistema para todo usuario futuro. La exfiltración funciona igual al revés: contexto de una sesión filtrándose en otra por un modelo de alcance descuidado. El primer incidente serio de envenenamiento de memoria llegará. Después vendrá la carrera por procedencia, certificación y control de acceso por hecho.
5. Los perímetros de privacidad del contexto serán requisito de cumplimiento
El siguiente paso lógico desde «acotar contexto es un perímetro de seguridad» es el aislamiento criptográfico de segmentos de memoria, para que los agentes solo revelen contexto bajo necesidad. Importa en cuanto tengas subagentes con distintos niveles de confianza o normativas que exijan acotación demostrable de hechos sensibles. Espera la primera auditoría en sector regulado que cite «aislamiento insuficiente entre memorias de agentes» como detonante, con marcos de cumplimiento siguiéndole. Los equipos que ya tengan aislamiento criptográfico en su hoja de ruta ganarán los RFP que dependan de ello; los demás lo adaptarán a contrarreloj.
6. La consistencia multiagente será una capacidad esperada y con nombre
Hoy, un agente de facturación y otro de soporte sobre la misma cuenta pueden dar respuestas contradictorias porque tiran de memorias distintas y nada las reconcilia. Es tolerable porque la mayoría de despliegues son de agente único. A medida que los sistemas multiagente salten a producción a escala, los usuarios detectarán las contradicciones y la «consistencia contextual» será una capacidad con nombre por la que los proveedores compitan. Saldrá primero en comparativas de vendedores y luego en checklists de compras. Resolverlo pronto diferenciará. Ignorarlo es abrir tickets sobre por qué dos agentes tuyos discrepan del mismo cliente.
7. «Contexto útil per cápita» será una métrica con benchmark
Los benchmarks se moverán de modelos a sistemas completos, y la métrica titular será algo como contexto útil por usuario y por interacción. Es el número que predice la retención y la diferencia entre un producto que parece conocerte y uno que se resetea cada martes. Lo verás en decks de inversores antes que en papers. Una métrica correlacionada, coste por token de contexto útil, será clave en la economía unitaria.
Qué hacer el lunes
Si empiezas y quieres un punto de partida: deja de tratar la memoria como una sola cosa. Elige un agente en producción al que tengas acceso, etiqueta qué tipo de memoria guarda cada almacén y fíjate cuántas veces un mismo almacén hace tres trabajos.
Si ya estás construyendo agentes: instrumenta el bucle. En concreto, instrumenta la señal entre retrieval y promoción. He visto muchos equipos capaces de decirte qué recuperó su sistema en un turno. Muy pocos pueden decirte qué memorias recuperadas usó realmente el modelo, y casi ninguno puede explicar por qué se promocionó una memoria concreta.
Saber qué memorias se usaron te permite reforzarlas en el siguiente paso de promoción, que es cómo una memoria deja de ser un log de escritura única y empieza a aprender de verdad.
Ahí, en ese bucle de feedback, vive la ventaja compuesta, y es donde se está haciendo el trabajo interesante en esta disciplina en los próximos tiempos.
Todos los equipos reciben los mismos modelos de frontera en plazos similares. Lo que nadie puede copiar es la capa de memoria que construyes alrededor: la que moldean tus usuarios, tus decisiones y tu criterio sobre qué merece la pena recordar.
Los modelos se comparten. El sistema de memoria es tuyo.