Một bước chuyển kiến trúc đang diễn ra ngay trước mắt
Trong vài năm qua, đa số mọi người đối xử với AI như một API.
Bạn gửi một lời nhắc vào, nhận một phản hồi ra, và nếu thấy “cao tay” hơn, bạn bọc thêm cơ chế thử lại và chút ghi nhật ký rồi gọi đó là một hệ thống. Cách đó ổn cho demo. Nó giúp cả làn sóng này ra mắt rất nhanh. Nhưng mô hình đó ngừng hiệu quả ngay khi bạn cố xây thứ phải vận hành theo thời gian.
Hệ thống AI chạy sản xuất giống một quy trình hơn là một API.
Ngay khi bạn đưa tính liên tục vào, mọi thứ thay đổi. Bạn không còn xử lý một yêu cầu - một phản hồi nữa. Bạn xử lý một chuỗi tương tác phụ thuộc lẫn nhau. Bạn cần bộ nhớ và trạng thái, và phải quyết định điều gì quan trọng lúc này, điều gì quan trọng 5 phút trước, và điều gì vẫn cần quan trọng vào ngày mai.
Và khi vượt qua lằn ranh đó, bạn nhận ra đây không phải là “kỹ thuật lời nhắc” ở quy mô.
Đây là thiết kế hệ thống.
Thứ bạn thực sự xây không phải là một lời nhắc tốt hơn. Bạn đang xây một hệ thống quyết định cách ngữ cảnh được lọc và tiến hóa theo thời gian. Đó là phương pháp luận đang hình thành. Đó là kỹ thuật ngữ cảnh.
Ngữ cảnh không phải là lời nhắc
Mở bất kỳ tác tử chạy sản xuất nào trong trình gỡ lỗi và xem thực sự gửi gì tới mô hình ở một lượt nhất định. Hầu như không bao giờ chỉ là tin nhắn của người dùng. Một yêu cầu điển hình trông như sau:
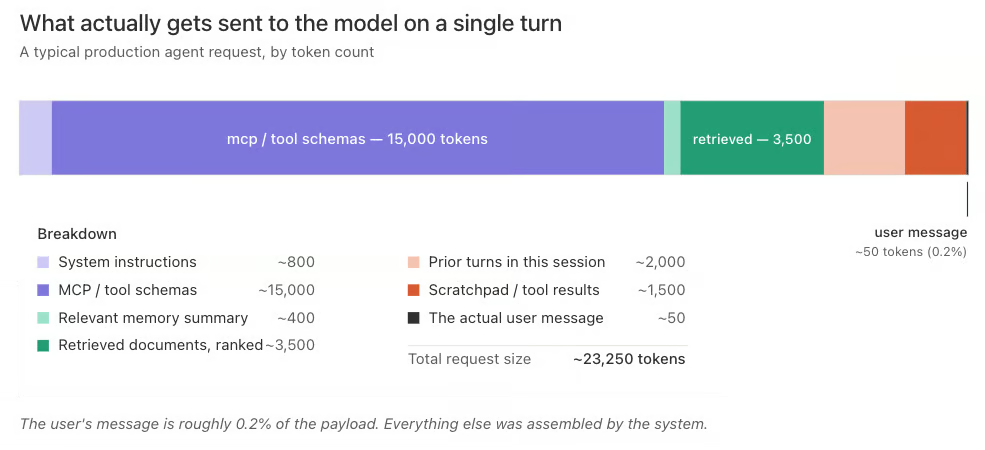
Tin nhắn người dùng là phần nhỏ nhất của tải trọng. Mọi khối còn lại đều được lọc và đưa vào lời nhắc. Những khối đó là đầu ra của một đường ống do bạn thiết kế, ngay cả khi bạn không nhận ra mình đang thiết kế một cái.
Chính đường ống đó mới là sản phẩm thật. Mô hình là môi trường chạy. Kỹ thuật ngữ cảnh là thiết kế của đường ống.
Khi chấp nhận sự khác biệt này, kiến trúc sẽ trông rất khác.
Bộ nhớ không chỉ là một thứ
"Thêm bộ nhớ" là “thêm bộ nhớ đệm” kiểu mới. Nghe như một tính năng, nhưng thực ra là vài hệ thống khác nhau tình cờ cùng tên. Nếu không tách bạch, bạn sẽ có một kho blob duy nhất trả lời mọi câu hỏi một cách tệ hại: đãng trí ở chỗ này, ám ảnh ở chỗ khác.
Cắt lớp đầu tiên là điều khoa học nhận thức đã cho chúng ta và đa số người thực hành đang hội tụ: bộ nhớ ngắn hạn (STM) và bộ nhớ dài hạn (LTM). Bộ nhớ ngắn hạn là mọi thứ hiện có trong cửa sổ ngữ cảnh, tập làm việc mà mô hình có thể nhìn thấy ở lượt này.
Bộ nhớ dài hạn là mọi thứ sống sót qua một lần gọi: sự kiện, hiện vật, kế hoạch, quyết định trước đó, đầu ra công cụ, và quy tắc. Bộ nhớ ngắn hạn là bài toán ngân sách. Bộ nhớ dài hạn là một vấn đề về hệ thống.
Năm loại dưới đây đều là bộ nhớ dài hạn, được tổ chức theo mục đích và cách lưu trữ. Chúng ánh xạ tới phân loại kinh điển: ngữ nghĩa, hồi ức, và thủ tục mà bạn sẽ thấy trong các khung lấy cảm hứng từ khoa học nhận thức như CoALA. Tôi chia nhỏ hai hạng mục vì khi đưa vào sản xuất, chúng cần được quản trị khác nhau.
Bộ nhớ chính sách
Các quy tắc và ràng buộc mang tính chuẩn tắc. Thường là phạm vi toàn cục hoặc theo tenant. Được phiên bản hóa và kiểm soát chặt. Đây là những gì hệ thống được cho phép làm: quy tắc tuân thủ, giới hạn thương hiệu, ranh giới bảo mật. Nó hiếm khi thay đổi và luôn có chủ đích. Đây là bộ nhớ thủ tục theo nghĩa khoa học nhận thức, các quy tắc và quy trình định hình hành vi xuyên suốt các phiên. Cùng hạng mục chứa các tệp như CLAUDE.md hoặc AGENTS.md trong các tác tử ưu tiên hệ thống tệp.
Bộ nhớ sở thích
Các tham số cá nhân hóa ổn định. Thường theo phạm vi người dùng. Người dùng này muốn phản hồi dạng JSON, người kia thích gạch đầu dòng, tenant này định dạng ngày DD/MM/YYYY. Bộ nhớ sở thích giúp hệ thống trở nên phù hợp mà không cần được dạy lại mỗi phiên. Cùng với bộ nhớ sự kiện dưới đây, đây là lớp ngữ nghĩa: các mệnh đề bền vững, có thể truy vấn về thế giới và những gì trong đó.
Bộ nhớ sự kiện
Các mệnh đề bền vững mà tác tử có thể tái sử dụng. Phải bao gồm nguồn gốc. “CSDL production của khách hàng ở us-east-1” là một sự kiện. “Năm tài chính của họ bắt đầu vào tháng Tư” cũng vậy. Sự kiện là nơi lợi thế cộng dồn tồn tại, và là chỗ khó nhất trong thiết kế, vì mỗi sự kiện bạn ghi là một canh bạc về tương lai. Tôi tách sự kiện khỏi sở thích vì chúng có đường ghi khác nhau, hồ sơ suy giảm khác nhau, và yêu cầu quản trị khác nhau, dù cả hai đều là bộ nhớ ngữ nghĩa ở cấp độ nhận thức.
Bộ nhớ hồi ức
Tóm tắt có cấu trúc của công việc đã hoàn thành. Những thứ như “đã xử lý xong tình huống” hoặc “đã hoàn tất di trú.” Hiện vật có thể tái sử dụng được hệ thống chưng cất từ vết chạy. Bộ nhớ hồi ức giúp hệ thống nhận ra chúng ta đã làm việc này trước đây và truy hồi hình hài lời giải trước đó.
Bộ nhớ vết chạy
Các sự kiện thực thi thô, chỉ ghi thêm. Đây là “hộp đen” của bạn. Khối lượng lớn, chủ yếu hữu ích cho truy hồi và phát lại, và không phải nơi phù hợp để tìm hiểu người dùng là người thế nào, chỉ là họ đã làm gì. Sự phân biệt này quan trọng vì đa số đội ngũ trộn lẫn cả hai và kết thúc bằng việc làm tìm kiếm ngữ nghĩa trên log thực thi để suy ra sở thích.
Trong một phân loại thô hơn, cả bộ nhớ hồi ức và vết chạy cùng nằm dưới ô hồi ức, bao gồm bản ghi hội thoại, đầu ra công cụ, và lịch sử chạy. Tôi tách chúng vì trong sản xuất, luồng thô và bản tóm đã chưng cất có mẫu truy cập, chính sách lưu giữ, và hồ sơ chi phí rất khác nhau. Xem chúng là một thứ là cách các đội ngũ phải trả giá vector-database để grep log.
Bộ nhớ làm việc không có trong danh sách này vì nó không phải dài hạn. Nó chính là cửa sổ ngữ cảnh, tập làm việc mà mô hình thực sự có thể thấy ở lượt hiện tại. Bộ nhớ làm việc là có thật và quan trọng, và nhiều công việc ML ứng dụng khó nhất hiện nay nằm ở đây: nén lời nhắc, tái sử dụng KV-cache, attention cửa sổ trượt, toán ngân sách cho những token nào được chiếm chỗ.
Nhưng theo định nghĩa nó là thoáng qua, và nhầm lẫn nó với các kho bền vững ở trên tạo ra kiến trúc trong đó sổ tay nháp và hệ thống ghi nhận chia sẻ cùng một cơ sở dữ liệu. Không nên như vậy. Bộ nhớ làm việc được lắp ráp theo từng lượt từ bộ nhớ dài hạn và bị loại bỏ trừ khi được thăng cấp rõ ràng. Bước thăng cấp là nơi hai lớp gặp nhau, và là nơi phần lớn công việc thiết kế thú vị xảy ra.
Khi ai đó nói “tác tử của chúng tôi có bộ nhớ”, hãy hỏi họ đang nói tới loại nào trong năm loại này. Nếu câu trả lời là “chúng tôi đổ mọi thứ vào vector store”, bạn vừa tìm ra lý do vì sao tác tử của họ đôi lúc đãng trí, đôi lúc ám ảnh.
Vòng lặp, và những gì đứt gãy trong đó
Mọi hệ thống AI chạy sản xuất cuối cùng đều hội tụ về cùng một hình hài: một vòng lặp.
Hình hài đó không gây tranh cãi. Hầu hết mô tả về vòng lặp của tác tử quy về cùng năm bước: lắp ghép ngữ cảnh, gọi mô hình, thực hiện hành động, quan sát kết quả, và cập nhật bộ nhớ, rồi lặp lại. Tôi đặt tên các pha hơi khác vì muốn tách hai nửa của “lắp ghép ngữ cảnh” (những gì bạn hấp thụ so với những gì bạn chọn) và vì tôi nghĩ “thăng cấp” xứng đáng có tên riêng thay vì gộp vào “cập nhật bộ nhớ.”
Nhưng giải phẫu nền tảng là như nhau, và bạn sẽ thấy cùng năm điểm bẻ cong dù bạn đi từ runtime tác tử, cơ sở dữ liệu, hay lời nhắc.
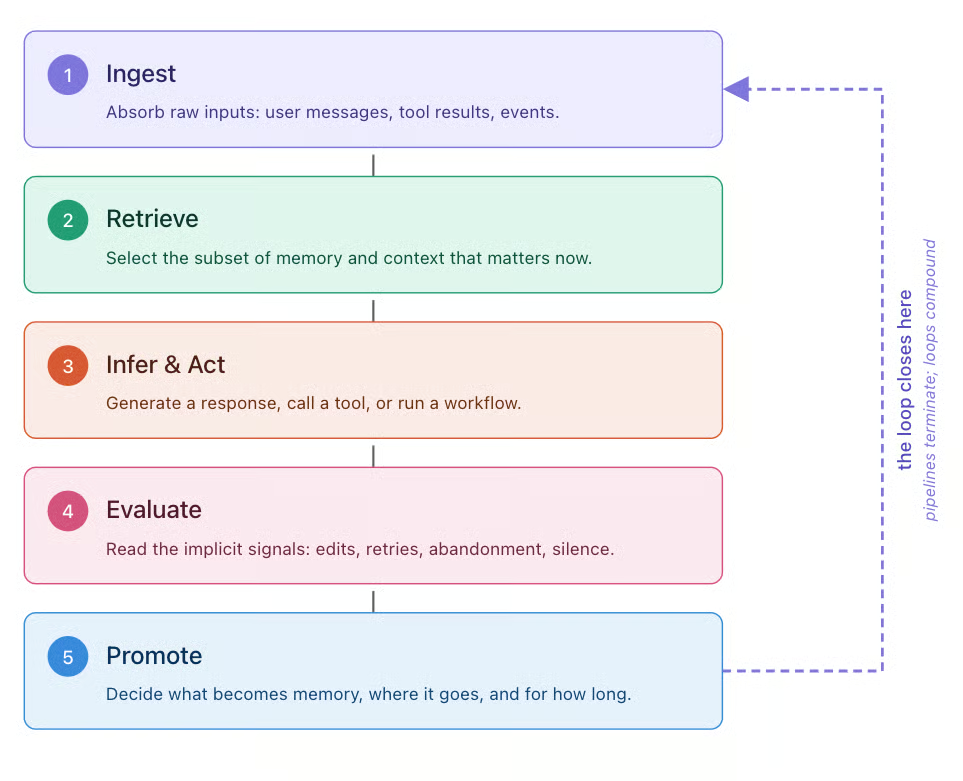
ReAct đã phổ biến việc đan xen suy luận và hành động vào năm 2022; các hệ thống tác tử sản xuất từ đó mở rộng mẫu hình này thành vòng lặp rộng hơn ở trên. Sơ đồ giúp hình dung, nhưng hiểu chế độ lỗi của từng pha mới cho bạn biết nên đầu tư kỹ thuật vào đâu.
Injest
Ingest thất bại khi bạn chấp nhận quá nhiều. Ingest là nửa đầu của lắp ghép ngữ cảnh: hấp thụ dữ liệu thô từ môi trường. Xem mọi sự kiện như ngữ cảnh tiềm năng tạo nhiễu mà bước truy hồi phải gỡ sau đó. Kỷ luật ở đây là ở biên. Bạn đang từ chối hấp thụ điều gì?
Retrieve
Retrieve thất bại một cách lặng lẽ. Retrieve là nửa sau của lắp ghép ngữ cảnh: chọn tập con bộ nhớ dài hạn nào quan trọng lúc này. Nó không ném ngoại lệ khi trả về nhầm mảnh, nó chỉ làm mô hình nghe hơi “lệch pha”. Đây là pha bị đầu tư thiếu nhất trong vòng lặp, và là pha tương quan chặt nhất với chất lượng hệ thống cảm nhận được.
Tìm kiếm thuần ngữ nghĩa chỉ là bản nháp đầu. Với đa số hệ thống sản xuất, đường cơ sở là lọc theo siêu dữ liệu cộng truy hồi lai từ vựng/ngữ nghĩa với xếp hạng lại; vượt lên nữa, phân rã truy vấn, duyệt đồ thị, và truy hồi multi-hop hữu ích khi nhiệm vụ có tính kết hợp, nhưng phải bị ràng bởi độ trễ và ngân sách đánh giá.
Suy luận & Hành động
Infer & Act thất bại khi ngữ cảnh dẫn đến hành vi sai. Đây là gộp gọi mô hình và thực hiện hành động vào một pha, vì cả lập kế hoạch lẫn gọi công cụ đều là hệ quả của việc ngữ cảnh lắp ghép khiến mô hình quyết định làm gì. Đây là nơi các chế độ lỗi ngữ cảnh dài cắn bạn: “lạc ở giữa”, thiên lệch gần đây, mục ruỗng ngữ cảnh.
Trực giác cho rằng nhiều ngữ cảnh hơn sẽ cải thiện phản hồi theo đơn điệu. Bạn đưa cho mô hình nhiều thông tin hơn để làm việc, nên tưởng rằng nó phải làm tốt hơn. Thực tế, nhiều token thường khiến mô hình tệ đi. Lập ngân sách ngữ cảnh giờ là một kỷ luật thực thụ, và bản năng mặc định “đưa cho mô hình mọi thứ ta có” là câu trả lời sai mặc định.
Đánh giá
Evaluate là pha hầu hết hệ thống không hề có. Nó đưa phản hồi vào hệ thống bằng cách quan sát kết quả của hành động. Bạn muốn biết phản hồi có hữu ích không, quy trình có thành công không, và người dùng có phải chỉnh lại không.
Ngay cả khi không ghi nhận phản hồi tường minh, tín hiệu vẫn tồn tại. Một vài tín hiệu hiệu quả trong sản xuất: thời gian tới tin nhắn tiếp theo (một phản hồi nhanh thường nghĩa là câu trả lời không ổn), khoảng cách chỉnh sửa giữa đầu ra của bạn và phiên bản người dùng thực sự gửi hoặc lưu (chỉnh nhỏ là nhiễu, chỉnh lớn là sửa lỗi), và rời bỏ trong vòng N giây sau một kết quả công cụ (người dùng xem những gì bạn tạo ra rồi bỏ đi).
Không tín hiệu nào trong số này đòi người dùng phải chấm điểm. Bạn chỉ cần đo đạc những gì vốn dĩ diễn ra. Những tín hiệu ngầm này ở khắp nơi, nhưng chẳng thành phần nào trong stack lắng nghe chúng. Không có bước này, vòng lặp không khép kín: hệ thống chạy nhưng không bao giờ học từ những gì nó tạo ra.
Thăng cấp
Promote là pha dễ xây sai nhất. Promote là nửa của cập nhật bộ nhớ xử lý việc ghi ngược vào lưu trữ dài hạn. Hầu hết đội ngũ mắc sai lầm thiên về ghi quá nhiều, đổ lại mọi thứ và làm nhiễm độc chính kho lưu trữ. Bạn cần một chính sách được viết hẳn hoi trả lời sáu câu hỏi:
- Viết những gì?
- Ở mức hạt nào?
- Vào loại bộ nhớ nào?
- Nguồn gốc ra sao?
- Suy giảm thế nào?
- Dưới thẩm quyền của ai?
Đây là bước khó nhất để làm đúng, và cũng là bước then chốt nhất.
Đường ống thì kết thúc. Vòng lặp thì cộng dồn. Sự khác biệt nằm ở Thăng cấp.
Những phản mẫu bạn có lẽ đang triển khai
Nếu bạn xây tác tử hơn vài tháng, gần như chắc chắn bạn đã triển khai vài điều dưới đây. Thử nghiệm ban đầu của đội tôi dính đòn từ tất cả, nên tôi biết chúng trông thế nào từ bên trong.
- Đổ toàn bộ bản ghi hội thoại vào mỗi lượt: Đây là cách lười để bảo toàn trạng thái. Cực kỳ tốn kém, dính mục ruỗng ngữ cảnh rất nhanh, và làm giảm chất lượng phản hồi theo những cách chỉ lộ ra khi người dùng phàn nàn. Một bộ tóm tắt nén chạy nền là không thể thiếu ở quy mô, và bộ nhớ đệm lời nhắc nên dành cho các tiền tố ổn định (lời nhắc hệ thống, định nghĩa công cụ, khối chính sách tĩnh) với tải truy hồi biến động đặt sau các phần đã được cache.
- Quá tải ngữ cảnh trong chiến lược truy hồi: Tương đương phía truy hồi là coi truy hồi như chậu rửa bát, kéo top-20 mảnh và hy vọng mô hình tự sắp xếp. Thực tế nó “lấy trung bình”, còn tệ hơn chọn 5 mảnh tốt.
- Xem sổ tay nháp là bộ nhớ: Khi kết quả gọi công cụ, suy luận trung gian, và hiện vật sinh ra đều rò rỉ vào lưu trữ dài hạn vì không gì bị loại bỏ rõ ràng. “Bộ nhớ” của bạn chủ yếu là khí thải.
- Một kho bộ nhớ cho mọi loại bộ nhớ: Khi hệ thống dùng một chỉ mục vector cho mọi thứ: vết chạy, sự kiện, sở thích, chính sách, và tóm tắt hồi ức chung một kho, truy hồi không thể phân biệt và mô hình cũng vậy.
- Bộ nhớ không bao giờ quên: Thất bại đối nghịch là bộ nhớ không bao giờ quên: không TTL, không suy giảm, không loại bỏ. Chỉ sau vài tháng, nó trở thành gánh nặng hơn là tài sản. Một vài hành vi tốt nhất bạn có thể thêm vào hệ thống là chính sách quên mạnh tay.
- Thăng cấp dựa vào “ngón tay cái” người dùng: Cái bẫy vì tín hiệu phản hồi mạnh nhất lại hiếm và thiên lệch nhất. Hệ thống chỉ thăng cấp khi có tín hiệu dương tường minh sẽ học cách tối ưu cho cú nhấp nút thay vì chất lượng thực.
- Không có phát lại: Không có khả năng phát lại, gỡ lỗi trở thành đoán mò. Bạn không thể tái hiện phiên hôm qua vì kho bộ nhớ đã thay đổi. Đây là lớp lỗi phá hỏng các buổi hậu kiểm.
Vì sao đây là thiết kế hệ thống, không phải cảm tính
Phần xứng đáng tên “thiết kế hệ thống” không phải là mô hình tư duy. Đó là các đánh đổi, và mỗi đánh đổi đều có một câu trả lời sai trông rẻ để triển khai nhưng đắt để duy trì.
Kinh tế token giờ chi phối kiến trúc yêu cầu
Lượt trúng bộ nhớ đệm lời nhắc có chi phí bằng một phần nhỏ lượt trượt, thường chỉ 10% giá input tiêu chuẩn trên API của Anthropic và các mô hình mới của OpenAI, và 25% trên Gemini của Google. Mức giá đó đã định hình lại điều hợp lý nên đặt ở đâu trong một yêu cầu, và các tiền tố thân thiện với cache, schema công cụ ổn định, và chỉ dẫn hệ thống cố định không còn là lựa chọn “mỹ phẩm” nữa.
Điều đó đặt trần tiết kiệm đâu đó giữa 4x và 10x trên token đầu vào, tùy nhà cung cấp, trước khi tính đến cộng dồn mang tính cấu trúc trong tác vụ agentic, nơi cùng tiền tố được gửi lại mỗi bước. Chọn đúng chiến lược cache, một tác tử kiến trúc tốt chạy rẻ hơn nhiều lần so với kiến trúc kém trên cùng khối lượng công việc. Đây là thứ gần nhất trong kỹ thuật AI với “bài toán dòng cache”, nhưng đa số đội ngũ đang xem nó như quyết định CSS.
Truy hồi là vấn đề kiến trúc
Sàn sản xuất là lai (từ vựng cộng ngữ nghĩa), xếp hạng lại, với viết lại truy vấn. Trần là truy hồi “agentic”, nơi mô hình tự phát hành và tinh chỉnh truy vấn trong vòng lặp. Khoảng cách giữa hai thứ là khổng lồ, vô hình trong benchmark, và hiện rõ trong mọi tương tác người dùng. Nếu truy hồi của bạn chỉ là một cuộc gọi top-k đơn lẻ, chính truy hồi là lý do tác tử của bạn “kém thông minh”.
Phạm vi ngữ cảnh là ranh giới bảo mật
Cách ly đa tenant, sandbox cho tác tử phụ, rò rỉ xuyên phiên. Đây không phải bài tập gia cố để làm sau. Nếu tác tử phụ có thể mặc định nhìn thấy tập làm việc của tác tử cha, bạn có một vấn đề đang chờ xảy ra, và câu hỏi chỉ là bạn hay kẻ tấn công phát hiện trước.
Đánh giá khó hơn bất kỳ lớp hệ thống nào trước đây
Hệ thống có trạng thái, ngẫu nhiên, phụ thuộc đường đi không thể unit-test. Bạn cần đánh giá dựa trên vết chạy, bộ truy hồi vàng, phát lại ngoại tuyến trên snapshot bộ nhớ được phiên bản hóa, và bộ đánh giá “LLM làm giám khảo” cũng được phiên bản hóa. Đa số đội ngũ không có gì trong số này và đang bay trong mù mờ. Họ biết bản triển khai gần nhất làm giảm chất lượng khi người dùng báo.
Quản trị không phải tùy chọn, và khó hơn bạn nghĩ
Quyền được quên theo GDPR trở nên không tầm thường ngay khi “thứ biết về người dùng” là một sự kiện được suy ra từ hàng trăm tương tác. Xóa dữ liệu người dùng nghĩa là gì trong một hệ thống đã hấp thụ nó vào bộ nhớ sự kiện? Đạo luật AI của EU thêm một lớp nữa, với phần lớn nghĩa vụ (gồm quản trị dữ liệu, giám sát con người, và yêu cầu minh bạch cho hệ thống rủi ro cao) có hiệu lực tháng 8 năm 2026.
Các đội ngũ đưa sản phẩm AI vào châu Âu nửa cuối 2026 sẽ cần câu trả lời cho những câu hỏi mà lĩnh vực này chưa giải được: cách loại bỏ có chứng cứ đóng góp của một người dùng vào một sự kiện suy ra, cách kiểm toán nguồn gốc của một lần thăng cấp bộ nhớ, cách chứng minh một kho bộ nhớ được phân phạm vi như bạn tuyên bố.
Chưa có câu trả lời nào tốt. Nó vẫn phải hoạt động, và cơ quan quản lý sẽ không đợi ngành tự lần mò.
Đây là lý do kỹ thuật ngữ cảnh nói về thiết kế hệ thống chứ không phải kỹ thuật lời nhắc. Hầu hết công việc thú vị xảy ra ở các mối nối giữa hệ thống, nơi ngữ cảnh được truyền từ giai đoạn này sang giai đoạn khác. Gần như chẳng có gì trong chính lời nhắc. Và gần như mọi đánh đổi ở trên đều có một lối tắt trông rẻ nhưng cộng dồn thành nợ kỹ thuật bạn sẽ trả vào thời điểm xấu nhất.
Lớp bộ nhớ đang hội tụ về đâu
Khi chấp nhận rằng bộ nhớ là năm thứ khác nhau với nhiều mẫu truy cập khác nhau, câu hỏi hiển nhiên tiếp theo là: tất cả sống ở đâu?
Truy hồi lai, nghĩa là từ vựng cộng ngữ nghĩa trong cùng một hệ, về cơ bản đã là vấn đề được giải quyết ở thời điểm này. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate, và các phần mở rộng vector cho Postgres đều hỗ trợ phiên bản nào đó, và khoảng cách chất lượng sản xuất giữa chúng hẹp hơn lời tiếp thị của nhà cung cấp. Nếu cả lớp bộ nhớ chỉ là “embedding và tìm kiếm toàn văn”, câu hỏi kiến trúc đã nhàm chán.
Không phải vậy, vì bộ nhớ không chỉ là truy hồi. Nhìn lại năm loại và để ý từng loại thực sự cần gì từ kho của nó.
|
Loại bộ nhớ |
Nhu cầu từ kho lưu trữ |
|
Chính sách |
Quan hệ. Quy tắc có phiên bản, phạm vi tenant, khóa ngoại tới người dùng và vai trò, cập nhật giao dịch. |
|
Sở thích |
Có cấu trúc và theo phạm vi người dùng. Dòng hoặc JSON khóa theo người dùng, schema dự đoán được. |
|
Sự kiện |
Truy hồi lai phát huy tác dụng ở đây. Mệnh đề bền vững có nguồn gốc, có thể truy vấn cả theo tương đồng ngữ nghĩa lẫn khớp chính xác theo thực thể hoặc nguồn. |
|
Hồi ức |
Tóm tắt có cấu trúc với truy hồi trên chúng. |
|
Vết chạy |
Lưu trữ sự kiện chỉ ghi thêm, khối lượng lớn, với chỉ mục vector xếp chồng cho phát lại và truy hồi. |
Kiến trúc “vô tình” bạn kết thúc sẽ tách chúng theo trục gây đau nhất. Dữ liệu quan hệ sống trong Postgres hoặc dịch vụ quản lý tương đương. Truy hồi lai sống trong Elasticsearch, OpenSearch, hoặc một kho vector chuyên dụng như Pinecone, Weaviate, hoặc LanceDB.
Vết chạy kết thúc ở S3 hoặc cơ sở dữ liệu chuỗi thời gian. Mỗi thành phần đều mạnh cho công việc nó được xây cho, và nhiều stack sản xuất dùng tốt. Vấn đề không nằm ở từng thành phần riêng lẻ. Vấn đề là mọi đường truy hồi có ý nghĩa trở thành một phép nối xuyên hệ: “tìm các sự kiện liên quan tới truy vấn này, lọc theo các chính sách áp dụng cho tenant này, trong phạm vi người dùng mà tác tử này được phép thấy.” Phép nối đó băng qua ba ranh giới: tin cậy, giao dịch, và độ trễ. Mỗi lần ngữ cảnh vượt một ranh giới như vậy, bạn tái giới thiệu chính vấn đề nhất quán mà bạn muốn tránh.
Đây là nơi bức tranh kiến trúc thay đổi. Truy hồi lai trong cùng kho với dữ liệu quan hệ là năng lực khác biệt, và đó là vấn đề khác so với truy hồi lai đơn thuần. Truy hồi lai như một tính năng ngày càng có ở khắp nơi.
Điều ít phổ biến hơn là đồng vị trí dữ liệu quan hệ, tài liệu, và vector dưới cùng một ranh giới giao dịch và bảo mật, để bộ nhớ chính sách, sở thích, sự kiện, và hồi ức có thể được truy vấn cùng nhau với bảo đảm ACID thay vì hòa giải xuyên hệ.
Oracle AI Database là một ví dụ về cách tiếp cận hợp nhất, đa mô hình: bảng quan hệ, tài liệu JSON, và embedding vector sống trong một engine duy nhất, có thể truy vấn cùng nhau trong một câu lệnh SQL, trong một giao dịch. Khi bạn coi nghiêm túc phân loại năm loại và bắt đầu vẽ phép nối giữa chính sách, sở thích, và sự kiện, câu hỏi chuyển từ “engine truy hồi nào tốt nhất” sang “dữ liệu quan hệ điều hành việc truy hồi nên sống ở đâu”.
Trong thực tế, điều này trông như một câu lệnh SQL duy nhất nối dữ liệu chính sách quan hệ, sở thích mã hóa JSON, và tương đồng vector trên bộ nhớ sự kiện. Truy vấn vốn sẽ băng qua ba hệ giờ thu gọn thành một:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Câu lệnh đơn này làm bốn việc cùng lúc: áp chính sách tenant, tôn trọng sở thích người dùng, áp kiểm soát truy cập theo từng sự kiện, và xếp hạng theo tương đồng ngữ nghĩa. Trong kiến trúc liên kết, đó là bốn lần khứ hồi qua ba kho khác nhau, với mô hình nhất quán bạn phải tự bảo vệ.
Ở đây, đó là một kế hoạch truy vấn, một ranh giới giao dịch, một nơi để kiểm toán. Cùng các bảo đảm ACID vốn khiến cơ sở dữ liệu trở thành hệ thống ghi nhận trạng thái chia sẻ từ thập niên 1970, nay áp dụng cho bộ nhớ bao gồm cả vector bên cạnh hàng dữ liệu.
Ví dụ hoạt động của mẫu hình này, gồm RAG agentic với tìm kiếm lai và một notebook về kiến trúc bộ nhớ cho kỹ thuật ngữ cảnh, có trong AI Developer Hub của Oracle trên GitHub.
Bạn vẫn sẽ muốn các kho chuyên biệt cho vài thứ. Bộ nhớ vết chạy khối lượng lớn có đặc tính bền vững và chi phí khác cơ sở dữ liệu vận hành. Lưu trữ blob cho hiện vật lớn như tài liệu, ảnh, và hiện vật mô hình nên ở nơi được xây cho việc đó. Một cơ sở dữ liệu tài liệu chuyên dụng vẫn có thể hợp lý cho quy trình tài liệu cần các tính năng đặc thù của hạng mục này.
Điểm mấu chốt không phải một nền tảng hợp nhất loại bỏ mọi kho khác. Điểm mấu chốt là nó loại bỏ phép nối đắt nhất: phép nối giữa dữ liệu quan hệ điều hành tác tử được phép làm gì và dữ liệu vector định hình tác tử thực sự làm gì. Khi hai thứ này đồng vị trí, bài toán kiến trúc chuyển từ “làm sao giữ các kho đồng bộ” sang “làm sao thiết kế chính sách bộ nhớ tốt”, vốn là bài toán thực sự quan trọng.
Bảy dự đoán cho chặng tiếp theo
Những phần trên mô tả nơi chúng ta đang đứng. Đây là những cược về nơi chúng ta sẽ tới. Chúng có chủ kiến. Hãy bất đồng với điều bạn bất đồng.
1. Mô hình sẽ không trở thành bộ nhớ
Câu chuyện cám dỗ là nhà cung cấp mô hình hấp thụ bộ nhớ vào chính mô hình. Cửa sổ ngữ cảnh kéo dài, bộ nhớ đệm thông minh hơn, và lớp bộ nhớ bên ngoài trở nên không cần thiết. Điều đó sẽ không xảy ra. Cửa sổ ngữ cảnh sẽ tiếp tục lớn hơn, nhưng vẫn cần mồi ở mỗi lượt. Mô hình vẫn vô trạng thái theo từng phiên, và lớp bộ nhớ bên ngoài vẫn là hệ thống ghi nhận. Điều thay đổi là bộ nhớ bên ngoài thông minh hơn nhiều (kho vector và nền tảng lai ngày nay, và những thứ ta chưa xây sau này), và kỹ thuật ngữ cảnh trở thành nghệ thuật quyết định mô hình sẽ thấy gì, khi nào, và vì sao. Nếu một nhà cung cấp tuyến đầu tung ra một primitive có thể thay thế đáng tin một hệ thống bộ nhớ bên ngoài cho sản xuất, dự đoán này sai. Tôi đặt cược ngược lại.
2. Hạ tầng bộ nhớ chi tiêu vượt suy luận cho sản phẩm AI trưởng thành
Chi phí suy luận đang giảm cỡ một bậc độ lớn mỗi 18 tháng. Lưu trữ, truy hồi, sinh embedding, xếp hạng lại, và lắp ghép ngữ cảnh theo yêu cầu thì không. Chúng tỉ lệ theo số người dùng, độ sâu phiên, và lịch sử tương tác, tất cả đều đang tăng. Mục lớn nhất trên hóa đơn đám mây chuyển từ token GPU sang hạ tầng vector và truy hồi lai. Điều này định hình lại câu hỏi tự xây hay mua. Hạ tầng bộ nhớ không bị “hàng hóa hóa” như lớp mô hình. Đội nào thắng dài hạn là đội coi hạ tầng bộ nhớ là hạng mục đầu tư hạng nhất ngay từ ngày đầu.
3. RAG cổ điển trở thành kiến trúc di sản
“Embedding tài liệu, top-k theo truy vấn người dùng, nhét vào lời nhắc” là COBOL của kiến trúc AI. Nó hoạt động, ở khắp nơi, và sẽ đáng xấu hổ khi nhìn lại. Thứ thay thế đã lộ diện: truy hồi agentic, nơi mô hình tự lập kế hoạch tìm kiếm, phát hành truy vấn nhiều bước, đọc kết quả trung gian, và quyết định sẽ lấy gì tiếp theo. Nó giống quy trình nghiên cứu hơn là truy vấn cơ sở dữ liệu. Các đội vẫn xây pipeline RAG tĩnh hôm nay đang trên lộ trình di trú, dù họ có biết hay không.
4. Bộ nhớ trở thành bề mặt đối kháng
Tấn công vào bộ nhớ cộng dồn theo cách prompt injection không làm được. Một kẻ địch có thể ghi vào kho bộ nhớ sống lâu, trực tiếp hay qua kênh đầu vào bạn không nghĩ là đặc quyền, có thể định hình hành vi hệ thống đó với mọi người dùng tương lai nó chạm tới. Exfiltration hoạt động ngược lại: ngữ cảnh từ phiên này rò sang phiên khác vì mô hình phân phạm vi cẩu thả. Sự cố “đầu độc bộ nhớ” nghiêm trọng đầu tiên sắp tới. Cuộc chạy đua trong ngành về nguồn gốc, chứng thực, và kiểm soát truy cập theo từng sự kiện sẽ theo sau.
5. Ranh giới quyền riêng tư ngữ cảnh trở thành yêu cầu tuân thủ
Bước tiếp theo hợp lý từ “phạm vi ngữ cảnh là ranh giới bảo mật” là cô lập mật mã các phân đoạn bộ nhớ, để tác tử chỉ có thể tiết lộ ngữ cảnh theo nguyên tắc cần-biết. Điều này quan trọng ngay khi bạn có tác tử phụ với mức tin cậy khác nhau, hoặc chế độ quản lý đòi hỏi phạm vi hóa có thể chứng minh được cho sự kiện nhạy cảm. Hãy kỳ vọng phát hiện kiểm toán ngành được quản lý đầu tiên trích dẫn “tách biệt không đủ giữa phạm vi bộ nhớ tác tử” làm chất xúc tác, với khung tuân thủ theo sau. Đội đã có cô lập mật mã trên lộ trình sẽ thắng các RFP phụ thuộc vào nó. Đội không có sẽ phải gắn thêm dưới áp lực thời hạn.
6. Nhất quán đa tác tử trở thành năng lực được đặt tên và kỳ vọng
Hôm nay, một tác tử thanh toán và một tác tử hỗ trợ chạm vào cùng tài khoản khách hàng có thể đưa câu trả lời mâu thuẫn vì chúng kéo các lát bộ nhớ khác nhau và không gì hòa giải chúng. Điều đó hiện còn chấp nhận được vì đa số triển khai sản xuất là đơn tác tử. Khi hệ thống đa tác tử đi vào sản xuất ở quy mô, người dùng sẽ bắt lỗi mâu thuẫn, và “nhất quán theo ngữ cảnh” sẽ trở thành năng lực có tên mà nền tảng cạnh tranh. Nó sẽ xuất hiện trước trong ma trận so sánh nhà cung cấp, rồi trong danh sách kiểm mua sắm doanh nghiệp. Giải quyết sớm trở thành khác biệt hóa. Bỏ qua nghĩa là nhận ticket hỗ trợ hỏi vì sao hai tác tử của chính bạn bất đồng về cùng khách hàng.
7. “Ngữ cảnh hữu ích bình quân đầu người” trở thành chỉ số có benchmark
Benchmark sẽ dịch chuyển từ mô hình sang toàn hệ thống, và chỉ số tiêu đề sẽ là thứ gì đó như lượng ngữ cảnh hữu ích mang theo mỗi người dùng, mỗi tương tác. Đó là con số thực sự dự báo giữ chân người dùng và khoảng cách giữa một sản phẩm có cảm giác “hiểu bạn” và một sản phẩm như “đặt lại mỗi thứ Ba”. Hãy để ý nó trong deck cho nhà đầu tư trước khi xuất hiện trong bài báo học thuật. Chỉ số tương quan, chi phí trên mỗi token ngữ cảnh hữu ích, sẽ trở thành câu hỏi về đơn kinh tế đáng để trả lời.
Làm gì vào thứ Hai
Nếu bạn mới và muốn một điểm khởi đầu: đừng coi bộ nhớ là một thứ. Chọn một tác tử sản xuất bạn có quyền truy cập, gắn nhãn mỗi kho của nó thực sự giữ loại bộ nhớ nào, và để ý tần suất một kho đang làm ba việc.
Nếu bạn đã xây tác tử: hãy đo đạc vòng lặp. Cụ thể, đo tín hiệu giữa truy hồi và thăng cấp. Tôi đã thấy nhiều đội có thể nói họ đã truy hồi gì ở một lượt. Ít hơn nhiều đội có thể nói mảnh bộ nhớ nào trong số đó mô hình thực sự dùng, và gần như không đội nào có thể nói vì sao một bộ nhớ nhất định được thăng cấp ngay từ đầu.
Biết mảnh bộ nhớ nào được dùng cho phép bạn củng cố chúng ở bước thăng cấp tiếp theo, đó là cách hệ thống bộ nhớ ngừng là log ghi-một-lần và bắt đầu thực sự học.
Vòng phản hồi đó là nơi lợi thế cộng dồn tồn tại, và là nơi công việc thú vị trong chặng tiếp theo của kỷ luật này đang diễn ra.
Mọi đội đều có cùng các mô hình tuyến đầu trong khung thời gian xấp xỉ nhau. Thứ không ai khác sao chép được là lớp bộ nhớ bạn xây quanh chúng: thứ được định hình bởi người dùng của bạn, quyết định của bạn, và phán đoán của bạn về điều đáng để ghi nhớ.
Mô hình thì dùng chung. Hệ thống bộ nhớ là của bạn.