Un virage architectural se joue sous vos yeux
Depuis deux ou trois ans, beaucoup traitent l’IA comme une simple API.
On envoie un prompt, on récupère une réponse et, si l’on veut faire « propre », on ajoute quelques relances et un peu de logs et on appelle ça un système. Parfait pour une démo. C’est ce qui a permis à cette vague d’arriver si vite. Mais ce schéma s’effondre dès que vous devez construire quelque chose qui vit dans la durée.
En production, les systèmes d’IA se comportent davantage comme des processus que comme des APIs.
Dès que vous introduisez de la continuité, tout change. Il ne s’agit plus d’une requête / réponse unique, mais d’une séquence d’interactions dépendantes les unes des autres. Il faut de la mémoire et de l’état, puis décider ce qui compte maintenant, ce qui comptait il y a cinq minutes et ce qui doit encore compter demain.
Et une fois cette ligne franchie, vous réalisez qu’il ne s’agit pas de « prompt engineering » à l’échelle.
C’est du design système.
Vous ne construisez pas un meilleur prompt, mais un système qui décide comment le contexte est filtré et évolue dans le temps. C’est la discipline qui émerge : le context engineering.
Le contexte n’est pas le prompt
Ouvrez n’importe quel agent en production dans votre débogueur et regardez ce qui part vraiment vers le modèle à un tour donné. Ce n’est presque jamais seulement le message de l’utilisateur. Une requête typique ressemble à ceci :
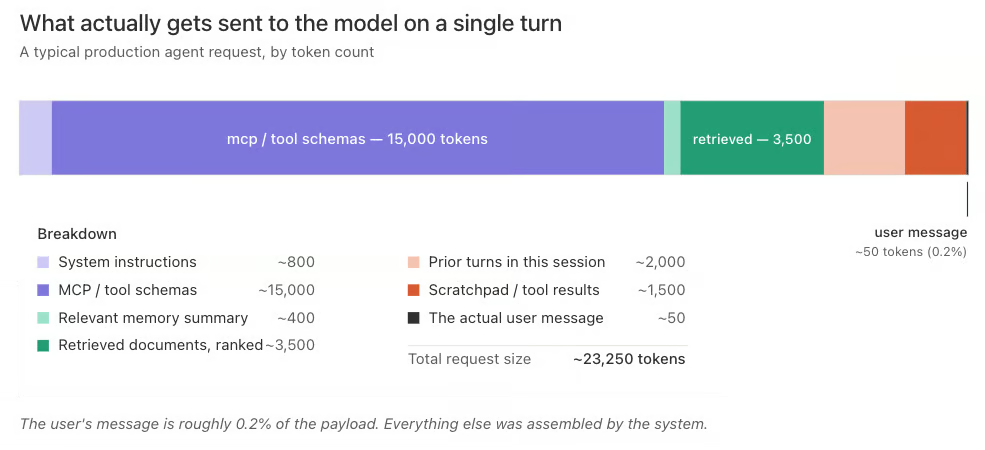
Le message utilisateur est la plus petite partie du payload. Tous les autres blocs sont filtrés puis injectés dans le prompt. Ces blocs sont le résultat d’un pipeline que vous avez conçu, parfois sans en avoir conscience.
Ce pipeline est le vrai produit. Le modèle est le runtime. Le context engineering, c’est le design de ce pipeline.
Une fois cette distinction acceptée, l’architecture n’a plus la même tête.
La mémoire n’est pas monolithique
« Ajouter de la mémoire » est le nouveau « ajouter du cache ». Cela semble une fonctionnalité, mais recouvre en réalité plusieurs systèmes distincts qui partagent un nom. Si vous ne les séparez pas, vous finirez avec un blob store unique qui répond mal à toutes les questions : amnésique par endroits, obsessionnel par d’autres.
La première coupe vient des sciences cognitives et fait consensus chez les praticiens : mémoire à court terme (MCT) et mémoire à long terme (MLT). La mémoire à court terme est ce qui tient dans la fenêtre de contexte, l’ensemble de travail visible par le modèle à ce tour-ci.
La mémoire à long terme, c’est tout ce qui survit au-delà d’un appel : faits, artefacts, plans, décisions passées, sorties d’outils, règles. La MCT est une affaire de budget. La MLT est un problème système.
Les cinq types ci-dessous relèvent tous de la MLT, organisés par finalité et mode de stockage. Ils correspondent à la taxonomie canonique sémantique, épisodique et procédurale que l’on retrouve dans des cadres inspirés des sciences cognitives comme CoALA. Je subdivise deux de ces catégories car, en production, elles doivent être gouvernées différemment.
Mémoire de politique
Règles et contraintes normatives. En général globales ou au niveau locataire. Versionnées et strictement contrôlées. C’est ce que le système est autorisé à faire : conformité, garde-fous de marque, périmètres de sécurité. Ça change rarement, et délibérément. C’est la mémoire procédurale au sens des sciences cognitives, les règles et workflows qui cadrent le comportement entre sessions. La même catégorie qui contient des fichiers comme CLAUDE.md ou AGENTS.md chez les agents « filesystem-first ».
Mémoire de préférence
Paramètres de personnalisation stables. Généralement au niveau utilisateur. Tel utilisateur veut des réponses en JSON, tel autre préfère des puces, tel locataire formate les dates en JJ/MM/AAAA. La mémoire de préférence rend le système personnalisé sans tout répéter à chaque session. Avec la mémoire de faits ci-dessous, c’est la couche sémantique : des assertions durables et interrogeables sur le monde et ses objets.
Mémoire de faits
Assertions durables que l’agent peut réutiliser. Avec provenance obligatoire. « La base de production du client est en us-east-1 » est un fait. Tout comme « son exercice fiscal commence en avril. » Les faits sont là où se niche l’avantage cumulatif — et les plus gros défis de design — car chaque fait écrit est un pari sur l’avenir. Je sépare les faits des préférences car ils ont des parcours d’écriture, des profils d’oubli et des exigences de gouvernance différents, bien que tous deux soient de la mémoire sémantique au niveau cognitif.
Mémoire épisodique
Résumés structurés de travaux terminés. Par exemple « dossier résolu » ou « migration effectuée ». Des artefacts réutilisables que le système distille à partir des traces. La mémoire épisodique permet au système de reconnaître qu’on l’a déjà fait et de retrouver la forme de la solution précédente.
Mémoire de traces
Événements d’exécution bruts, append-only. C’est votre enregistreur de vol. Gros volume, surtout utile pour la recherche et la relecture, et ce n’est pas le bon endroit pour comprendre qui est un utilisateur, seulement ce qu’il a fait. La distinction est cruciale : beaucoup confondent les deux et finissent par faire de la recherche sémantique dans les logs pour déduire des préférences.
Dans une taxonomie plus grossière, la mémoire épisodique et la mémoire de traces se rangent sous le même parapluie, englobant transcriptions, sorties d’outils et historiques d’exécution. Je les sépare car, en production, le flux brut et le résumé distillé ont des patrons d’accès, politiques de rétention et profils de coût radicalement différents. Les traiter comme une seule et même chose, c’est payer un index vectoriel pour faire un grep sur vos logs.
La mémoire de travail n’apparaît pas ici car elle n’est pas de long terme. C’est la fenêtre de contexte elle-même, l’ensemble de travail visible par le modèle au tour courant. Elle est bien réelle et cruciale, et nombre des défis d’IA appliquée s’y jouent aujourd’hui : compression de prompt, réutilisation de KV-cache, attention fenêtrée, et l’arbitrage budgétaire des tokens qui la composent.
Mais elle est par définition transitoire, et la confondre avec les stockages persistants ci-dessus produit des architectures où brouillon et système d’enregistrement partagent la même base. À proscrire. La mémoire de travail est assemblée à chaque tour à partir de la MLT, puis jetée, sauf promotion explicite. La promotion est le point de jonction entre les deux couches, là où se joue l’essentiel du design.
Quand quelqu’un dit « notre agent a de la mémoire », demandez de laquelle de ces cinq il parle. Si la réponse est « on met tout dans un vector store », vous avez trouvé pourquoi leur agent est amnésique par endroits et obsessionnel par d’autres.
La boucle, et ses points de rupture
Tout système d’IA en production converge vers la même forme : une boucle.
La forme ne fait pas débat. La plupart des descriptions d’une agent loop se réduisent à cinq étapes : assembler le contexte, appeler le modèle, agir, observer, mettre à jour la mémoire, puis recommencer. J’étiquette les phases un peu différemment pour séparer les deux moitiés d’« assembler le contexte » (ce que vous absorbez vs. ce que vous sélectionnez) et parce que la promotion mérite son propre nom plutôt que d’être noyée dans « mettre à jour la mémoire ».
Mais l’anatomie sous-jacente est la même, et vous verrez les mêmes cinq points d’inflexion que vous veniez du runtime d’agent, de la base ou du prompt.
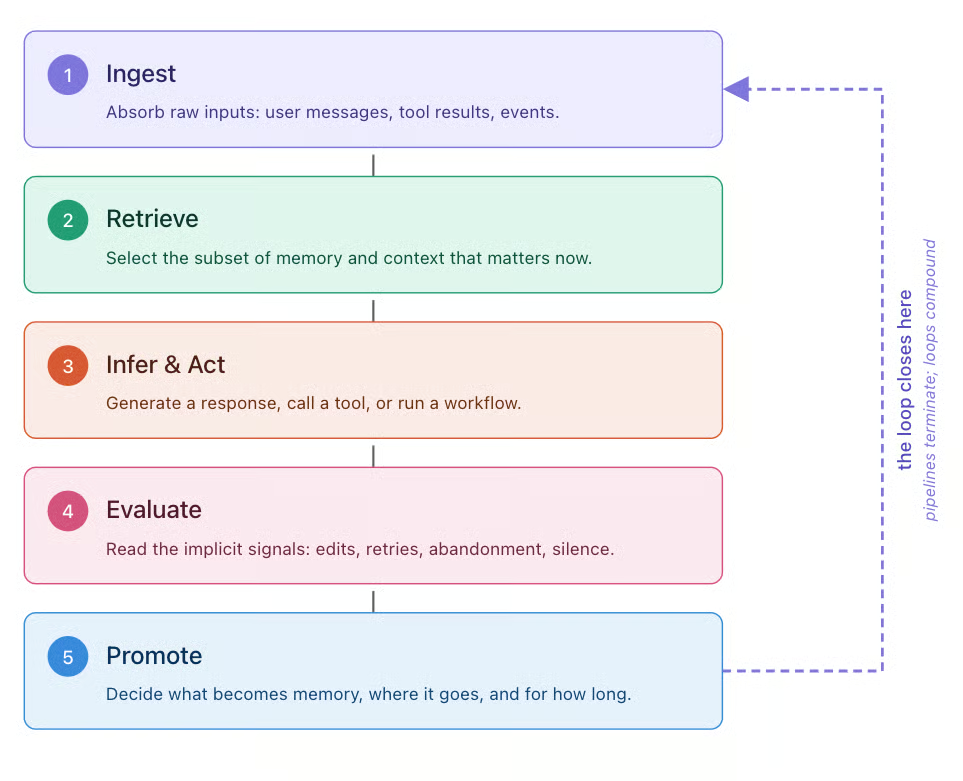
ReAct a popularisé l’entrelacement du raisonnement et de l’action en 2022 ; les systèmes d’agents en production ont depuis étendu ce schéma en la boucle ci-dessus. Le schéma visuel aide, mais connaître le mode de défaillance de chaque phase vous dit où investir votre temps d’ingénierie.
Injest
Ingest échoue quand vous acceptez trop. Ingest est la première moitié de l’assemblage du contexte : absorber les entrées brutes de l’environnement. Considérer chaque événement comme contexte potentiel crée un bruit que la recherche doit ensuite réparer. La discipline se joue à la frontière : qu’allez-vous refuser d’absorber ?
Retrieve
Retrieve échoue en silence. Retrieve est la seconde moitié de l’assemblage du contexte : sélectionner le sous-ensemble de mémoire à long terme qui compte maintenant. Quand il renvoie le mauvais segment, il ne jette pas d’exception : il fait juste sonner le modèle « un peu à côté ». C’est la phase la plus sous-investie de la boucle, et celle qui corrèle le plus avec la qualité perçue du système.
La recherche sémantique pure n’est qu’un premier jet. En production, le socle est un filtrage par métadonnées plus un retrieval hybride lexical/sémantique avec reranking ; au-delà, la décomposition de requête, la traversée de graphe et le multi-hop aident pour les tâches compositionnelles, à borner par la latence et le budget d’évaluation.
Inférer & agir
Inférer & agir échoue quand le contexte induit le mauvais comportement. Cette phase regroupe appeler le modèle et déclencher des actions, car la planification et l’usage d’outils découlent de ce que le contexte assemblé pousse le modèle à faire. C’est là que mordent les échecs liés aux longs contextes : « lost-in-the-middle », biais de récit, pourrissement du contexte.
L’intuition veut que plus de contexte améliore monotoniquement les réponses. En pratique, davantage de tokens dégrade souvent le modèle. Budgéter le contexte est désormais une vraie discipline, et l’instinct de « tout donner au modèle » est la mauvaise réponse par défaut.
Évaluer
Évaluer est la phase que la plupart des systèmes n’ont pas. Elle introduit du feedback en observant l’issue des actions. Vous voulez savoir si la réponse a aidé, si le workflow a réussi, et si l’utilisateur a dû corriger.
Même sans feedback explicite, des signaux existent : temps jusqu’au prochain message (un enchaînement rapide suggère une réponse ratée), distance d’édition entre votre sortie et la version finalement envoyée ou enregistrée (petites modifs = bruit, grosses modifs = correction), et abandon dans les N secondes suivant un résultat d’outil (l’utilisateur a regardé puis est parti).
Aucun de ces signaux n’exige que l’utilisateur note quoi que ce soit. Il suffit d’instrumenter ce qui se passe déjà. Ils sont partout, mais la pile ne les écoute pas. Sans cette étape, la boucle ne se ferme pas : le système tourne mais n’apprend jamais de ce qu’il produit.
Promouvoir
Promouvoir est la phase la plus facile à mal implémenter. C’est la moitié de mise à jour de la mémoire qui écrit en MLT. La plupart des équipes en écrivent trop, déversant tout et empoisonnant le store. Il vous faut une politique écrite qui réponde à six questions :
- Qu’est-ce qui est écrit ?
- À quelle granularité ?
- Dans quel type de mémoire ?
- Avec quelle provenance ?
- Avec quel profil d’oubli ?
- Sous quelle autorité ?
C’est l’étape la plus dure à réussir, et aussi la plus cruciale.
Les pipelines s’arrêtent. Les boucles composent. La différence, c’est Promote.
Les anti-patterns que vous shippez probablement
Si vous construisez des agents depuis quelques mois, vous avez presque certainement livré plusieurs de ceux-ci. Nos premiers essais y ont tous mordu, d’où ce retour d’expérience.
- Tout déverser à chaque tour : la solution de facilité pour garder l’état. Ruineusement coûteuse, elle amène vite le pourrissement du contexte et dégrade la qualité de façon sournoise. Un résumeur compactant en arrière-plan est incontournable à l’échelle, et le cache de prompt doit être réservé aux préfixes stables (prompts système, définitions d’outils, blocs de politique statiques), avec les payloads de retrieval volatils après les sections mises en cache.
- Surcharge de contexte dans la stratégie de retrieval : l’équivalent côté retrieval consiste à tout rapatrier (top-20) en espérant que le modèle triera. Il moyenne, ce qui est pire que de choisir cinq bons segments.
- Prendre le brouillon pour de la mémoire : quand résultats d’appels d’outils, raisonnements intermédiaires et assets générés fuient en MLT faute d’éviction explicite. Votre « mémoire » n’est alors que de l’échappement.
- Un seul store pour tous les types de mémoire : quand un unique index vectoriel contient traces, faits, préférences, politiques et résumés épisodiques, le retrieval ne peut pas désambiguïser, et le modèle non plus.
- Une mémoire qui n’oublie jamais : l’inverse : pas de TTL, pas d’oubli, pas d’éviction. En quelques mois, c’est un passif. Certaines des meilleures améliorations passent par des politiques d’oubli agressives.
- Promouvoir sur pouces levés : piège classique : le signal le plus fort est le plus rare et le plus biaisé. Les systèmes qui ne promeuvent que sur signal positif explicite optimisent le clic, pas la qualité réelle.
- Pas de replay : sans capacité de relecture, le débogage devient de la divination. Vous ne pouvez pas rejouer la session d’hier car la mémoire a changé. C’est la classe de bugs qui ruine les post-mortems.
Pourquoi c’est du design système, pas du « ressenti »
Ce qui mérite l’appellation « design système », ce ne sont pas les schémas mentaux, mais les arbitrages — chacun ayant une mauvaise réponse, moins chère à shipper et plus coûteuse à opérer.
L’économie des tokens dicte l’architecture des requêtes
Un hit de cache de prompt coûte une fraction d’un miss, souvent 10 % du prix d’entrée standard sur l’API d’Anthropic et les modèles récents d’OpenAI, et 25 % sur Gemini de Google. Cette tarification rebat les cartes de ce qu’il est rationnel de placer où dans une requête : préfixes à l’aise avec le cache, schémas d’outils stables et instructions système épinglées ne sont plus cosmiques.
Le plafond d’économie se situe entre x4 et x10 sur les tokens d’entrée selon le fournisseur, avant même d’additionner l’effet cumulatif sur des charges agentiques, où le même préfixe est renvoyé à chaque étape. Avec une stratégie de cache juste, un agent bien architecturé coûte plusieurs fois moins cher qu’un mauvais, pour un travail identique. C’est l’analogue du « cache line » en ingénierie IA, et beaucoup le traitent comme une décision CSS.
Le retrieval est un sujet d’architecture
En production, c’est hybride (lexical + sémantique), reranké, avec réécriture de requête. Le plafond, c’est le retrieval agentique, où le modèle émet et affine ses recherches au sein de la boucle. L’écart entre les deux est immense, invisible dans les benchmarks, flagrant pour les utilisateurs. Si votre retrieval se résume à un top-k, c’est lui qui donne l’impression que votre agent est « bête ».
Le périmètre du contexte est une frontière de sécurité
Isolation multi-locataires, sandboxing de sous-agents, fuites inter-sessions. Ce ne sont pas des durcissements à faire à la fin. Si un sous-agent peut voir par défaut l’ensemble de travail du parent, vous avez un problème en attente — à vous ou à un adversaire de le trouver d’abord.
L’évaluation est plus dure que pour toute autre classe de systèmes
Des systèmes étatiques, stochastiques, dépendants du chemin ne se « unit-testent » pas. Il faut une évaluation basée sur les traces, des jeux dorés pour le retrieval, de la relecture offline contre des snapshots versionnés de mémoire, et des évaluateurs « LLM-as-judge » eux-mêmes versionnés. La plupart des équipes n’ont rien de tout ça et volent à vue.
La gouvernance est incontournable, et plus technique que prévu
Le droit à l’oubli (RGPD) devient non trivial dès que « ce qui sait sur l’utilisateur » est un fait déduit d’une centaine d’interactions. Que veut dire supprimer les données d’un utilisateur d’un système qui les a déjà absorbées en mémoire de faits ? L’AI Act européen ajoute une couche, avec la plupart de ses obligations (gouvernance des données, supervision humaine, transparence pour les systèmes à haut risque) applicables en août 2026.
Les équipes qui livreront en Europe au S2 2026 devront répondre à des questions encore sans solution partagée : suppression prouvable de la contribution d’un utilisateur à un fait dérivé, audit de la lignée d’une promotion de mémoire, preuve que le store est réellement scoping comme annoncé.
Personne n’a encore une bonne réponse. Il faudra pourtant que ça marche, et les régulateurs n’attendront pas.
Voilà pourquoi le context engineering relève du design système, pas du prompt engineering. L’essentiel du travail se situe dans les connexions entre systèmes, là où le contexte passe d’une étape à l’autre. Presque rien ne se joue dans le prompt lui-même. Et presque chaque arbitrage ci-dessus a un raccourci « pas cher » qui s’accumule en dette technique à rembourser au pire moment.
Vers quoi converge la couche mémoire
Une fois admis que la mémoire comporte cinq natures, avec des patrons d’accès différents, la question évidente devient : où tout cela vit-il ?
Le retrieval hybride (lexical + sémantique dans un même système) est largement résolu aujourd’hui. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate et les extensions vectorielles de Postgres le proposent, et l’écart de qualité production entre eux est plus étroit que ne le laisse entendre le marketing. Si la couche mémoire se résumait à « embeddings + plein texte », l’architecture serait ennuyeuse.
Ce n’est pas le cas, car la mémoire ne se résume pas au retrieval. Revenez aux cinq types et regardez ce que chacun exige de son store.
|
Type de mémoire |
Exigences vis-à-vis du store |
|
Politique |
Relationnel. Règles versionnées, portées locataires, clés étrangères vers utilisateurs et rôles, mises à jour transactionnelles. |
|
Préférence |
Structuré et au niveau utilisateur. Lignes ou JSON indexé par utilisateur, schéma prévisible. |
|
Fait |
Le retrieval hybride prend tout son sens ici. Assertions durables avec provenance, interrogeables à la fois par similarité sémantique et correspondance exacte sur entité ou source. |
|
Épisodique |
Résumés structurés avec retrieval par-dessus. |
|
Trace |
Stockage d’événements append-only, gros volume, avec index vectoriels superposés pour relecture et retrieval. |
L’architecture « accidentelle » sépare souvent ces besoins selon l’axe le plus douloureux. Les données relationnelles vivent dans Postgres (ou un équivalent managé). Le retrieval hybride vit dans Elasticsearch, OpenSearch, ou un store vectoriel dédié comme Pinecone, Weaviate ou LanceDB.
Les traces finissent dans S3 ou une base série temporelle. Chacun excelle dans son rôle et beaucoup de stacks s’en sortent très bien ainsi. Le problème n’est pas un composant isolé, mais que chaque trajet de retrieval significatif devient une jointure inter-systèmes : « trouver les faits liés à cette requête, filtrés par les politiques du locataire, dans le périmètre des utilisateurs que l’agent peut voir ». Cette jointure franchit trois frontières : confiance, transaction et latence. À chaque passage, vous réintroduisez l’incohérence que vous cherchiez à éviter.
C’est là que l’architecture bascule. Le retrieval hybride dans le même store que les données relationnelles est la capacité différenciante — autre chose qu’un simple retrieval hybride. En tant que fonctionnalité, il est de plus en plus disponible partout.
Plus rare est la co-localisation des données relationnelles, documentaires et vectorielles sous une même frontière transactionnelle et de sécurité, afin que politiques, préférences, faits et épisodique puissent être interrogés ensemble avec des garanties ACID, plutôt que réconciliés entre systèmes.
Oracle AI Database illustre cet approvisionnement multi-modèles convergent : tables relationnelles, documents JSON et embeddings vectoriels cohabitent dans un seul moteur, interrogeables ensemble en une requête SQL, dans une transaction unique. En prenant au sérieux la taxonomie en cinq types et en traçant les jointures entre politiques, préférences et faits, la question devient : où doivent vivre les données relationnelles qui gouvernent ce retrieval ?
Concrètement, ça ressemble à une requête SQL qui joint données de politique relationnelles, préférences encodées en JSON et similarité vectorielle sur la mémoire de faits. La requête qui traverserait trois systèmes se réduit à une seule :
-- Trouver en une requête les faits pertinents pour cette question,
-- restreints par les politiques et préférences applicables à cet utilisateur.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Cette seule instruction fait quatre choses à la fois : appliquer la politique locataire, respecter la préférence utilisateur, contrôler l’accès par fait et classer par similarité sémantique. En fédéré, cela ferait quatre allers-retours sur trois stores différents, avec un modèle de cohérence à votre charge.
Ici, c’est un plan de requête, une frontière transactionnelle, un lieu d’audit. Les mêmes garanties ACID qui font des bases de données le système d’enregistrement du partage d’état depuis les années 1970, appliquées à une mémoire qui inclut désormais des vecteurs en plus des lignes.
Des exemples opérationnels de ce motif — RAG agentique en recherche hybride et un notebook sur l’architecture mémoire pour le context engineering — sont disponibles sur le AI Developer Hub d’Oracle sur GitHub.
Vous voudrez encore des stores spécialisés pour certaines choses. La mémoire de traces à gros volume n’a pas les mêmes besoins de durabilité et de coût que votre base opérationnelle. Le stockage d’objets pour de gros assets (documents, images, artefacts de modèle) a sa place dédiée. Une base documentaire spécialisée reste pertinente pour des workflows documentaires éprouvés nécessitant des fonctions propres à cette catégorie.
L’idée n’est pas qu’une plateforme unifiée élimine tous les autres stores, mais qu’elle supprime la jointure la plus coûteuse : celle entre les données relationnelles qui définissent ce que l’agent peut faire et les données vectorielles qui influencent ce qu’il fait vraiment. Une fois co-localisées, la question n’est plus « comment les garder synchrones » mais « comment concevoir de bonnes politiques de mémoire », ce qui est le vrai sujet.
Sept prédictions pour la suite
Ce qui précède décrit l’état des lieux. Voici des paris sur la trajectoire. Ils sont volontairement tranchés. Désapprouvez ceux avec lesquels vous êtes en désaccord.
1. Le modèle ne devient pas la mémoire
La tentation est d’imaginer les fournisseurs intégrant la mémoire au modèle lui-même. Les fenêtres s’allongent, le caching s’affûte, la mémoire externe deviendrait inutile. Cela n’arrivera pas. Les fenêtres de contexte grandiront, mais il faudra toujours les amorcer à chaque tour. Le modèle reste sans état à chaque session, et la mémoire externe demeure le système d’enregistrement. En revanche, cette mémoire externe devient beaucoup plus intelligente (stores vectoriels et plateformes hybrides aujourd’hui, autre chose demain), et le context engineering devient l’art de décider ce que le modèle voit, quand et pourquoi. Si un acteur de pointe livre un primitive qui remplace crédiblement la mémoire externe en production, cette prédiction est fausse. J’en doute.
2. L’infrastructure mémoire dépasse l’inférence dans les produits IA mûrs
Les coûts d’inférence chutent d’un ordre de grandeur tous les ~18 mois. Le stockage, le retrieval, la génération d’embeddings, le reranking et l’assemblage du contexte par requête non. Ils évoluent avec le nombre d’utilisateurs, la profondeur des sessions, l’historique d’interaction — tout ce qui grimpe. La ligne dominante de la facture cloud bascule des GPU tokens vers l’infrastructure vectorielle/hybride. Cela rebat la question build vs buy. L’infrastructure mémoire ne se commoditise pas comme la couche modèle. Les gagnants traiteront la mémoire comme un investissement de premier ordre dès le départ.
3. Le RAG classique devient une architecture légacy
« Embeddings de documents, top-k sur la requête, stuffing dans le prompt » sera le COBOL de l’architecture IA. Ça marche, c’est partout, et on en rougira. Le remplacement est déjà visible : le retrieval agentique, où le modèle planifie ses recherches, exécute des requêtes multi-étapes, lit les résultats intermédiaires et décide quoi chercher ensuite. On est plus proche d’un processus de recherche que d’une simple consultation de base. Ceux qui persistent dans des pipelines RAG statiques sont déjà sur une trajectoire de migration.
4. La mémoire devient la surface d’attaque
Les attaques sur la mémoire composent, là où l’injection de prompt ne fait que heurter. Un adversaire qui écrit dans une mémoire durable, directement ou via un canal d’entrée mal protégé, peut façonner le comportement du système pour tous les utilisateurs futurs. L’exfiltration opère en sens inverse : du contexte fuyant d’une session vers une autre faute de scoping rigoureux. Le premier incident sérieux de « memory poisoning » arrive. L’industrie s’activera ensuite sur la provenance, l’attestation et le contrôle d’accès par fait.
5. Les frontières de confidentialité du contexte deviennent une exigence de conformité
La suite logique du « scoping du contexte = frontière de sécurité », c’est l’isolation cryptographique de segments de mémoire, afin que les agents ne révèlent que sur le strict besoin d’en connaître. Cela devient crucial dès que vous avez des sous-agents à niveaux de confiance différents, ou des régimes réglementaires imposant un scoping prouvable de faits sensibles. Attendez-vous à ce que le premier audit d’un secteur réglementé pointant une « isolation insuffisante entre mémoires d’agents » fasse déclic, les cadres de conformité suivront. Les équipes qui ont déjà ce scoping cryptographique sur leur feuille de route gagneront les AO dépendants de cette exigence.
6. La cohérence multi-agents devient une capacité attendue et nommée
Aujourd’hui, un agent facturation et un agent support sur un même compte client peuvent répondre des choses contradictoires car ils ont tiré des tranches de mémoire différentes sans réconciliation. Tolérable tant que la production reste mono-agent. Quand les systèmes multi-agents passeront à l’échelle, les utilisateurs détecteront ces contradictions, et la « cohérence contextuelle » deviendra une capacité étiquetée et concurrentielle. Elle apparaîtra d’abord dans les matrices comparatives, puis dans les checklists d’achats. La résoudre tôt différencie. L’ignorer, c’est prendre des tickets support sur des désaccords entre vos propres agents.
7. Le « contexte utile par personne » devient un indicateur benchmarké
Les benchmarks déplaceront le focus du modèle vers le système complet, et l’indicateur phare ressemblera à « contexte utile porté par utilisateur, par interaction ». C’est le chiffre qui prédit la rétention et la différence entre un produit qui « vous connaît » et un autre qui réinitialise chaque mardi. Guettez-le dans les decks investisseurs avant les papiers académiques. Un corrélat, le coût par token de contexte utile, deviendra une unité d’économie à optimiser.
Que faire lundi
Si vous commencez : cessez de traiter la mémoire comme un bloc uniforme. Choisissez un agent de production, étiquetez le type de mémoire que contient chaque store et observez à quelle fréquence un même store sert à trois usages.
Si vous construisez déjà : instrumentez la boucle. En particulier, le signal entre retrieval et promotion. Beaucoup peuvent dire ce que leur système a retrouvé à un tour donné. Rares sont ceux qui savent quelles mémoires le modèle a effectivement utilisées, et presque aucun ne sait pourquoi une mémoire a été promue.
Savoir quelles mémoires ont été utilisées permet de les renforcer à la prochaine promotion, et de transformer un système de mémoire d’un journal à écriture seule en un système qui apprend vraiment.
C’est dans cette boucle de feedback que vit l’avantage cumulatif, et c’est là que se joue l’essentiel du métier dans les prochains temps.
Tout le monde accède aux mêmes modèles à peu près au même rythme. Ce que personne ne peut copier, c’est la couche mémoire que vous bâtissez autour : modelée par vos utilisateurs, vos choix et votre jugement de ce qui mérite d’être retenu.
Les modèles sont partagés. Le système de mémoire est le vôtre.