Há uma mudança arquitetural acontecendo bem diante dos nossos olhos
Nos últimos anos, a maioria das pessoas vem tratando a IA como se fosse uma API.
Você envia um prompt, recebe uma resposta e, se quiser ser mais "sofisticado", coloca retries e um pouco de logging e chama isso de sistema. Funcionou para demos. Foi isso que permitiu que essa onda chegasse tão rápido. Mas esse padrão deixa de funcionar no momento em que você tenta construir algo que precisa operar ao longo do tempo.
Sistemas de IA em produção se comportam mais como processos do que como APIs.
No momento em que você introduz continuidade, tudo muda. Você deixa de lidar com uma única requisição e resposta. Passa a lidar com uma sequência de interações que dependem umas das outras. Você precisa de memória e estado, e tem que decidir o que importa agora, o que importou há cinco minutos e o que ainda deve importar amanhã.
E quando você cruza essa linha, percebe que isso não é prompt engineering em escala.
Isso é design de sistemas.
O que você está realmente construindo não é um prompt melhor. Você está construindo um sistema que determina como o contexto é filtrado e evolui ao longo do tempo. Essa é a disciplina que está surgindo. Isso é context engineering.
Contexto não é o prompt
Abra qualquer agente em produção no seu debugger e veja o que realmente é enviado ao modelo em um determinado turno. Quase nunca é só a mensagem do usuário. Uma requisição típica se parece com isto:
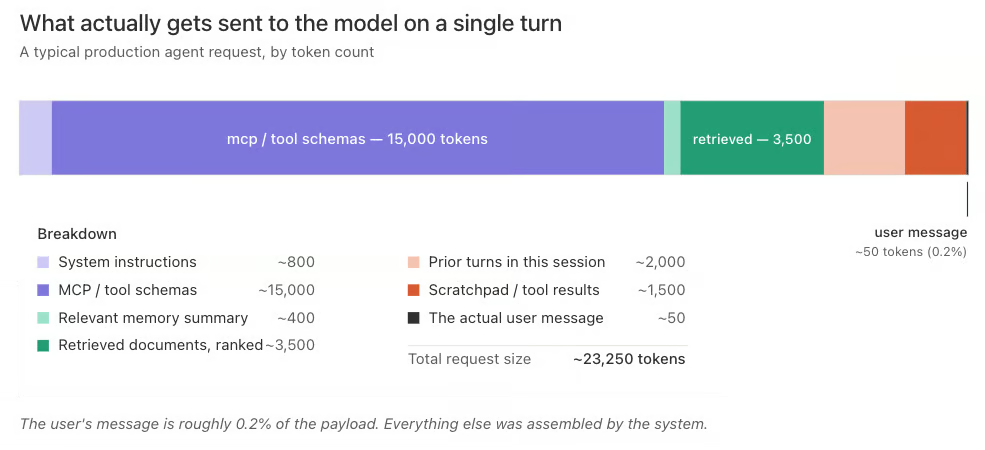
A mensagem do usuário é a menor parte do payload. Todo o restante foi filtrado e injetado no prompt. Esses blocos são a saída de um pipeline que você desenhou — mesmo que não tenha percebido que estava desenhando um.
Esse pipeline é o produto de verdade. O modelo é o runtime. Context engineering é o design desse pipeline.
Quando você aceita essa distinção, a arquitetura muda completamente.
Memória não é uma coisa só
"Adicionar memória" é o novo "adicionar cache". Parece um recurso, mas na prática são vários sistemas diferentes que compartilham o mesmo nome. Se você não separar, vai acabar com um único blob store que responde mal a todas as perguntas — esquecido em alguns lugares, obsessivo em outros.
O primeiro corte é o que a ciência cognitiva já nos deu, e para o qual a maioria dos praticantes está convergindo: memória de curto prazo (STM) e memória de longo prazo (LTM). Memória de curto prazo é o que está dentro da janela de contexto agora — o working set que o modelo consegue ver neste turno.
Memória de longo prazo é tudo o que sobrevive a uma única chamada: fatos, artefatos, planos, decisões anteriores, saídas de ferramentas e regras. Curto prazo é um problema de orçamento. Longo prazo é um problema de sistemas.
Os cinco tipos abaixo são todos memória de longo prazo, organizados pelo objetivo e por como devem ser armazenados. Eles se mapeiam para a taxonomia canônica semântica, episódica e procedimental que você verá em frameworks inspirados na ciência cognitiva, como o CoALA. Estou subdividindo duas dessas categorias porque, em produção, precisam de governança diferente.
Memória de políticas
Regras e restrições normativas. Tipicamente globais ou por cliente (tenant). Versionadas e rigidamente controladas. É o que o sistema está autorizado a fazer: regras de compliance, limites de marca, fronteiras de segurança. Muda raramente e de forma deliberada. É a memória procedimental no sentido da ciência cognitiva — as regras e os fluxos que moldam o comportamento entre sessões. É a mesma categoria que guarda arquivos como CLAUDE.md ou AGENTS.md em agentes que partem do filesystem.
Memória de preferências
Parâmetros estáveis de personalização. Geralmente no escopo do usuário. Este usuário quer respostas em JSON, aquele prefere bullet points, este cliente formata datas como DD/MM/AAAA. Memória de preferências faz o sistema parecer sob medida sem precisar repetir tudo a cada sessão. Junto com a memória de fatos abaixo, forma a camada semântica: assertivas duráveis e consultáveis sobre o mundo e suas entidades.
Memória de fatos
Assertivas duráveis que o agente pode reutilizar. Precisam incluir proveniência. “O banco de produção do cliente está em us-east-1” é um fato. Assim como “o ano fiscal deles começa em abril”. Fatos são onde a vantagem composta vive — e onde estão os problemas de design mais difíceis — porque cada fato escrito é uma aposta sobre o futuro. Eu separo fatos de preferências porque têm caminhos de escrita, perfis de decadência e requisitos de governança diferentes, embora ambas sejam memória semântica no nível cognitivo.
Memória episódica
Sumários estruturados de trabalhos concluídos. Coisas como “caso resolvido” ou “migração concluída”. Artefatos reutilizáveis que o sistema destilou de traces. Memória episódica é o que permite ao sistema reconhecer que já fizemos isso antes e recuperar o contorno da solução anterior.
Memória de traces
Eventos brutos de execução, somente anexo (append-only). É a sua caixa-preta. Volume alto, útil principalmente para recuperação e replay, e não é o lugar certo para entender como é um usuário — apenas o que ele fez. A distinção importa porque muitos times confundem as duas coisas e acabam fazendo busca semântica em logs de execução para inferir preferências.
Numa taxonomia mais ampla, memória episódica e de traces ficam sob o guarda-chuva episódico, incluindo transcrições de conversas, saídas de ferramentas e históricos de execuções. Eu as separo porque, em produção, o fluxo bruto e o resumo destilado têm padrões de acesso, políticas de retenção e perfis de custo muito diferentes. Tratar tudo como uma coisa só é como times acabam pagando preço de banco vetorial para dar grep em logs.
A memória de trabalho não está nesta lista porque não é de longo prazo. É a própria janela de contexto, o working set que o modelo realmente enxerga no turno atual. Memória de trabalho é real e importante, e boa parte do trabalho mais difícil em ML aplicado hoje está aí: compressão de prompt, reutilização de KV-cache, atenção com janela deslizante e a matemática do orçamento sobre o que ocupa aqueles tokens.
Mas é transitória por definição, e confundi-la com os stores persistentes acima produz arquiteturas em que o rascunho (scratchpad) e o system of record compartilham o mesmo banco. Não deveriam. A memória de trabalho é montada a cada turno a partir da memória de longo prazo e descartada, a menos que seja explicitamente promovida. A etapa de promoção é onde as duas camadas se encontram — e onde acontece a maior parte do trabalho de design interessante.
Quando alguém disser “nosso agente tem memória”, pergunte qual desses cinco tipos. Se a resposta for “jogamos tudo em um vector store”, você acabou de encontrar o motivo de o agente parecer esquecido em alguns lugares e obsessivo em outros.
O loop — e onde ele quebra
Todo sistema de IA em produção acaba convergindo para o mesmo formato: um loop.
O formato não é controverso. A maioria das descrições do loop do agente se resume aos mesmos cinco passos: montar o contexto, chamar o modelo, executar ações, observar resultados e atualizar a memória — e repetir. Eu rotulo as fases de forma um pouco diferente porque quero separar as duas metades de “montar o contexto” (o que você absorve vs. o que seleciona) e porque acho que promoção merece um nome próprio em vez de ser diluída em “atualizar a memória”.
Mas a anatomia é a mesma, e você verá os mesmos cinco pontos de inflexão tenha vindo do runtime do agente, do banco de dados ou do prompt.
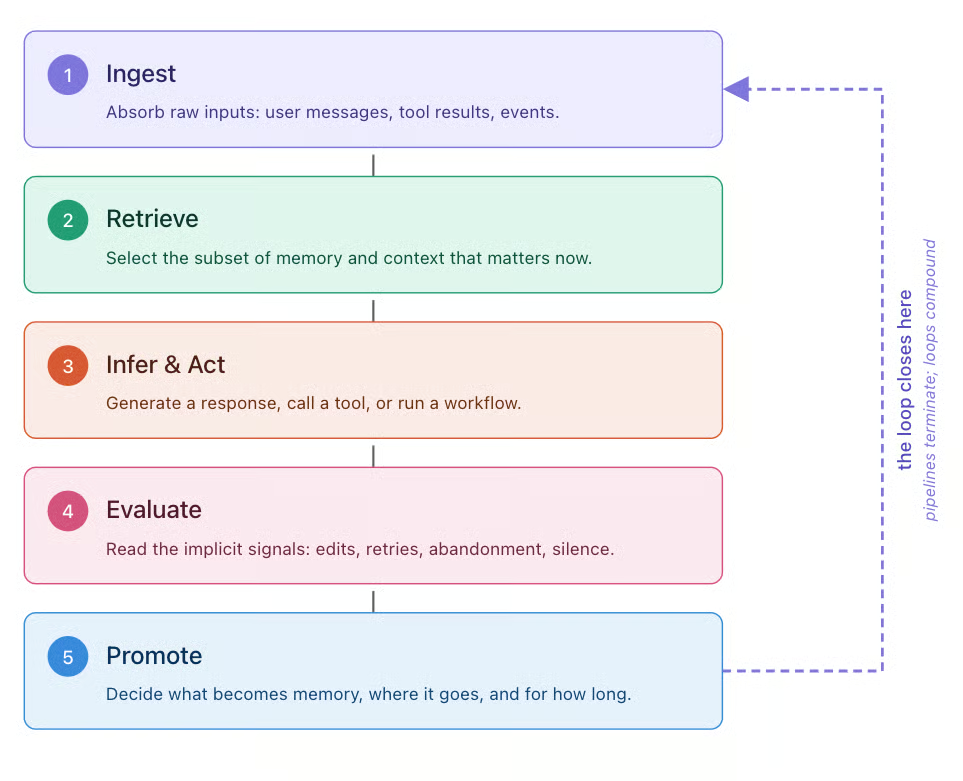
ReAct popularizou a intercalação de raciocínio e ação em 2022; sistemas de agentes em produção desde então expandiram esse padrão para o loop mais amplo acima. O diagrama ajuda a visualizar, mas conhecer o modo de falha de cada fase é o que mostra onde investir engenharia.
Injest
Ingest falha quando você aceita demais. Ingest é a primeira metade de montar o contexto: absorver entradas brutas do ambiente. Tratar todo evento como potencial contexto cria ruído que a recuperação terá que desfazer depois. A disciplina está na fronteira. O que você está se recusando a absorver?
Retrieve
Retrieve falha silenciosamente. Retrieve é a segunda metade da montagem de contexto: selecionar qual subconjunto da memória de longo prazo importa agora. Não lança exceção quando retorna o bloco errado — só deixa o modelo soar um pouco fora do tom. É a fase mais subinvestida do loop e a que mais se correlaciona com a percepção de qualidade do sistema.
Busca puramente semântica é rascunho. Para a maioria dos sistemas em produção, o básico é filtragem por metadados + recuperação híbrida lexical/semântica com reranking; além disso, decomposição de consultas, travessia de grafos e recuperação multi-hop ajudam quando as tarefas são composicionais, mas precisam ser limitadas por latência e orçamento de avaliação.
Infer & Act
Infer & Act falha quando o contexto direciona o comportamento errado. Aqui estão colapsadas as etapas de chamar o modelo e executar ações, porque o planejamento e a invocação de ferramentas são consequências do que o contexto montado levou o modelo a decidir. É aqui que mordem os modos de falha de long context: perdido no meio (lost-in-the-middle), viés de recência, apodrecimento de contexto.
A intuição diz que mais contexto deveria melhorar a resposta de forma monotônica. Você dá mais informação ao modelo e imagina que ele irá melhor. Na prática, mais tokens muitas vezes pioram o resultado. Orçar contexto virou uma disciplina real — e o instinto padrão de “dar ao modelo tudo o que temos” é a resposta padrão errada.
Evaluate
Evaluate é a fase que a maioria dos sistemas nem tem. Ela introduz feedback ao observar o resultado das ações. Você quer saber se a resposta ajudou, se o fluxo teve sucesso e se o usuário precisou corrigir.
Mesmo quando o feedback não é capturado explicitamente, sinais existem. Alguns que funcionam bem em produção: tempo até a próxima mensagem (um retorno rápido geralmente significa que a resposta não atendeu), distância de edição entre sua saída e a versão que o usuário de fato enviou ou salvou (pequenas edições são ruído; grandes, correção) e abandono dentro de N segundos após o resultado de uma ferramenta (o usuário viu o que você produziu e foi embora).
Nenhum desses sinais exige que o usuário avalie algo. Só exigem instrumentar o que já acontece. Esses sinais implícitos estão por toda parte, mas nada na stack está ouvindo. Sem essa etapa, o loop não fecha: o sistema roda, mas não aprende com o que produz.
Promote
Promote é a fase mais fácil de implementar errado. Promote é a metade de atualizar a memória que escreve de volta para o armazenamento de longo prazo. A maioria dos times peca por excesso de escrita, despejando tudo de volta e contaminando o próprio store. O que você precisa é de uma política real e escrita que responda a seis perguntas:
- O que é escrito?
- Em que granularidade?
- Em qual tipo de memória?
- Com qual proveniência?
- Com qual decadência?
- Sob a autoridade de quem?
Esta é a etapa mais difícil de acertar — e também a mais crucial.
Pipelines terminam. Loops se compõem. A diferença é Promote.
Os anti-padrões que você provavelmente está entregando
Se você vem construindo agentes há alguns meses, quase certamente já entregou vários destes. As primeiras experiências do meu time sofreram com todos eles — por isso sei como parecem por dentro.
- Despejar a transcrição completa a cada turno: É o jeito preguiçoso de preservar estado. Fica caríssimo, atinge o apodrecimento de contexto rapidamente e degrada a qualidade das respostas de formas que só aparecem quando os usuários reclamam. Um sumarizador compactador rodando em background não é opcional em escala, e cache de prompt deve ser reservado para prefixos estáveis (prompts de sistema, definições de ferramentas, blocos de política estáticos), com payloads voláteis de retrieval ficando depois das seções em cache.
- Sobrecarga de contexto na sua estratégia de retrieval: O equivalente do outro lado é tratar retrieval como pia de cozinha, puxando os top-20 chunks e esperando que o modelo os organize. Ele faz média deles, o que é pior do que escolher cinco bons chunks.
- Tratar o scratchpad como memória: É quando resultados de chamadas de ferramentas, raciocínio intermediário e ativos gerados vazam para o armazenamento de longo prazo porque nada jamais os descarta explicitamente. Sua “memória” é, em grande parte, resíduo.
- Um único store para todo tipo de memória: Quando sistemas usam um único índice vetorial para tudo — traces, fatos, preferências, políticas e sumários episódicos juntos —, o retrieval não consegue desambiguar entre eles, e o modelo também não.
- Memória que nunca esquece: O fracasso oposto é a memória que nunca esquece: sem TTL, sem decadência, sem expulsão. Em poucos meses isso vira passivo, não ativo. Algumas das melhores melhorias que você pode adicionar a um sistema são políticas agressivas de esquecimento.
- Promover com base no "joinha" do usuário: É uma armadilha porque o sinal de feedback mais forte também é o mais raro e enviesado. Sistemas que promovem apenas com sinais positivos explícitos aprendem a otimizar para o clique no botão, não para a qualidade real.
- Sem replay: Sem capacidade de replay, depurar vira adivinhação. Você não reproduz a sessão de ontem porque o store de memória já mudou. Essa é a classe de bugs que arruína post-mortems.
Por que isso é design de sistemas, não "vibes"
A parte que merece o nome “design de sistemas” não é o modelo mental. São os trade-offs — e cada um deles tem uma resposta errada que é mais barata de lançar e mais cara de sustentar.
A economia de tokens agora determina a arquitetura da requisição
Acertos de cache de prompt custam uma fração dos misses — muitas vezes só 10% do preço padrão de input na API da Anthropic e nos modelos mais novos da OpenAI, e 25% no Gemini do Google. Essa precificação remodelou o que faz sentido colocar onde em uma requisição; prefixes amigáveis a cache, schemas estáveis de ferramentas e instruções fixas de sistema deixaram de ser escolhas cosméticas.
Isso coloca o teto de economia entre 4x e 10x em tokens de entrada, dependendo do provedor — antes de contar o efeito composto em workloads agentic, em que o mesmo prefixo é reenviado a cada passo. Acerte a estratégia de cache e um agente bem arquitetado roda várias vezes mais barato que um mal arquitetado fazendo o mesmo trabalho. É o mais perto que a engenharia de IA tem de um problema de cache line — e muitos times tratam como decisão de CSS.
Retrieval é um problema de arquitetura
Na prática, produção é híbrida (lexical + semântica), com reranking e reescrita de consultas. O teto é retrieval agentic, em que o modelo emite e refina suas próprias buscas dentro do loop. A distância entre os dois é enorme — invisível em benchmarks e visível em toda interação do usuário. Se o seu retrieval é uma única chamada top-k, o retrieval é o motivo de seu agente parecer "burro".
Escopo de contexto é uma fronteira de segurança
Isolamento multi-tenant, sandboxing de subagentes, vazamento entre sessões. Isso não é algo para “endurecer” depois. Se um subagente enxerga por padrão o working set do pai, você tem um problema esperando acontecer — e a única dúvida é se você encontra antes ou um adversário encontra.
Avaliar é mais difícil do que em qualquer classe anterior de sistema
Sistemas com estado, estocásticos e dependentes de trajetória não "unit-testam". Você precisa de avaliação baseada em traces, conjuntos dourados de retrieval, replay offline contra snapshots versionados de memória e avaliadores LLM-as-judge que também sejam versionados. A maioria dos times não tem nada disso e voa às cegas. Descobrem que o último deploy regrediu qualidade quando um usuário avisa.
Governança não é opcional — e é tecnicamente mais difícil do que parece
Direito ao esquecimento no GDPR fica nada trivial no momento em que “a coisa que sabe sobre o usuário” é um fato derivado de cem interações. O que significa deletar dados de um usuário de um sistema que já os absorveu na memória de fatos? O EU AI Act adiciona outra camada, com a maior parte de suas obrigações (incluindo governança de dados, supervisão humana e requisitos de transparência para sistemas de alto risco) entrando em vigor em agosto de 2026.
Times que lançarem produtos de IA na Europa no segundo semestre de 2026 vão precisar responder perguntas que o setor ainda não resolveu coletivamente: como remover de forma comprovável a contribuição de um usuário a um fato derivado; como auditar a linhagem de uma promoção de memória; como demonstrar que um store de memória está escopado como você afirma.
Ninguém tem uma boa resposta ainda. Ainda assim, tem que funcionar — e os reguladores não vão esperar a indústria descobrir como.
É por isso que context engineering é sobre design de sistemas e não sobre prompt engineering. Quase todo o trabalho interessante está nas conexões entre sistemas — onde o contexto é passado de uma etapa para outra. Quase nada está no prompt em si. E quase todo trade-off acima tem um atalho que parece barato e se compõe em dívida técnica que você vai pagar no pior momento possível.
Para onde a camada de memória está convergindo
Depois que você aceita que memória são cinco coisas diferentes com vários padrões de acesso, a próxima pergunta óbvia é: onde tudo isso vive?
Recuperação híbrida — lexical mais semântica em um único sistema — hoje é, em grande parte, um problema resolvido. Elasticsearch, OpenSearch, LanceDB, Pinecone, Weaviate e as extensões vetoriais do Postgres suportam alguma versão disso, e o gap de qualidade de produção entre eles é menor do que o marketing sugere. Se a camada de memória fosse só “embeddings e busca full-text”, a arquitetura seria entediante.
Não é — porque memória não é só retrieval. Olhe novamente os cinco tipos e repare no que cada um realmente precisa do seu store.
|
Tipo de memória |
O que precisa do store |
|
Política |
Relacional. Regras versionadas, escopos por tenant, chaves estrangeiras para usuários e papéis, updates transacionais. |
|
Preferência |
Estruturada e no escopo do usuário. Linhas ou JSON indexados pelo usuário, schema previsível. |
|
Fato |
Retrieval híbrido mostra seu valor aqui. Assertivas duráveis com proveniência, consultáveis por similaridade semântica e por correspondência exata em entidade ou fonte. |
|
Episódica |
Sumários estruturados com retrieval sobre eles. |
|
Trace |
Armazenamento de eventos append-only, alto volume, com índices vetoriais sobrepostos para replay e recuperação. |
A arquitetura acidental que você acaba tendo separa isso pelo eixo que mais dói. Os dados relacionais vivem em Postgres ou equivalente gerenciado. O retrieval híbrido vive em Elasticsearch, OpenSearch ou em um vector store dedicado como Pinecone, Weaviate ou LanceDB.
Traces vão para S3 ou um banco de séries temporais. Cada um é uma ótima escolha para o trabalho a que foi feito — e muita stack de produção usa bem. O problema não é um componente isolado. É que todo caminho de retrieval significativo vira um join entre sistemas: “encontre fatos relevantes para esta consulta, filtrados pelas políticas que se aplicam a este tenant, e no escopo dos usuários que este agente pode ver.” Esse join cruza três fronteiras: confiança, transação e latência. Toda vez que o contexto cruza uma dessas fronteiras, você reintroduz exatamente o problema de consistência que estava tentando evitar.
É aqui que a arquitetura muda. Retrieval híbrido no mesmo store que os dados relacionais é o diferencial — e esse é um problema diferente de apenas fazer retrieval híbrido. Como recurso, retrieval híbrido está cada vez mais disponível em todo lugar.
O que é menos comum é co-locar dados relacionais, documentos e vetores sob um único limite transacional e de segurança, para que políticas, preferências, fatos e memória episódica possam ser consultados juntos com garantias ACID — em vez de reconciliados entre sistemas.
Oracle AI Database é um exemplo dessa abordagem convergente e multimodelo: tabelas relacionais, documentos JSON e embeddings vetoriais vivem em um único engine, consultáveis juntos em uma única instrução SQL, dentro de uma única transação. Quando você leva a sério a taxonomia de cinco tipos e começa a desenhar os joins entre política, preferência e fato, a pergunta muda de qual engine de retrieval é melhor para onde devem viver os dados relacionais que governam esse retrieval.
Na prática, isso se parece com uma única instrução SQL que faz join de dados relacionais de política, preferências em JSON e similaridade vetorial sobre a memória de fatos. A consulta que, de outra forma, atravessaria três sistemas, se colapsa em um:
-- Find facts relevant to this question, scoped to the policies
-- and preferences that apply to this user, in a single query.
SELECT f.fact_text, f.provenance, f.created_at
FROM   fact_memory f
JOIN   user_preferences p
       ON p.user_id = :current_user
JOIN   tenant_policies t
       ON t.tenant_id = p.tenant_id
      AND t.is_active = 'Y'
WHERE  f.tenant_id = p.tenant_id
  AND  JSON_VALUE(p.prefs, '$.allow_personalization') = 'true'
  AND  f.access_level <= t.max_access_level
ORDER BY VECTOR_DISTANCE(
           f.embedding,
           VECTOR_EMBEDDING(MINILM USING :query AS DATA),
           COSINE
         )
FETCH FIRST 5 ROWS ONLY;
Essa única instrução faz quatro coisas ao mesmo tempo: aplica política por tenant, respeita preferências do usuário, aplica controles de acesso por fato e ranqueia por similaridade semântica. Em uma arquitetura federada, isso seriam quatro idas e vindas entre três stores diferentes, com um modelo de consistência que você mesmo teria que defender.
Aqui, é um plano de consulta, um limite transacional, um lugar para auditar. As mesmas garantias ACID que fazem bancos de dados serem o system of record para estado compartilhado desde os anos 1970 — agora aplicadas a memória que inclui vetores ao lado de linhas.
Exemplos funcionais desse padrão — incluindo RAG agentic com busca híbrida e um notebook sobre arquitetura de memória para context engineering — estão no AI Developer Hub da Oracle no GitHub.
Você ainda vai querer stores especializados para algumas coisas. Memória de traces em alto volume tem características de durabilidade e custo diferentes do seu banco operacional. Blob storage para ativos grandes — documentos, imagens, artefatos de modelos — deve ficar onde isso é nativo. Um banco de documentos dedicado pode continuar fazendo sentido para fluxos de documentos críticos, quando você precisa de features específicas dessa categoria.
O ponto não é que uma plataforma unificada elimina todo o resto. O ponto é que elimina o join mais caro: entre os dados relacionais que governam o que o agente pode fazer e os dados vetoriais que moldam o que o agente efetivamente faz. Quando esses dois estão co-localizados, o problema arquitetural muda de “como mantenho esses stores em sincronia” para “como desenho boas políticas de memória” — que é o problema que realmente importa.
Sete previsões para o que vem a seguir
As seções acima descrevem onde estamos. Estas são apostas sobre para onde vamos. São propositalmente opinativas. Discorde do que você discordar.
1. O modelo não vira a memória
A história tentadora é que os provedores incorporam a memória no próprio modelo. Janelas de contexto se estendem, o cache fica mais inteligente e a camada externa de memória se torna desnecessária. Isso não vai acontecer. As janelas de contexto continuarão crescendo, mas ainda vão exigir "isca" (priming) a cada turno. O modelo permanece sem estado a cada sessão, e a memória externa continua sendo o system of record. O que muda é que a memória externa fica muito mais inteligente (vector stores e plataformas híbridas hoje, coisas que ainda não construímos depois), e context engineering vira a arte de decidir o que o modelo vê, quando e por quê. Se algum provedor de fronteira lançar um primitivo que substitua, de forma crível, um sistema externo de memória para uso em produção, esta previsão estará errada. Eu aposto contra.
2. Infra de memória vai gastar mais do que inferência em produtos de IA maduros
Os custos de inferência vêm caindo algo como uma ordem de grandeza a cada 18 meses. Já armazenamento, retrieval, geração de embeddings, reranking e a montagem do contexto por requisição não. Eles escalam com número de usuários, profundidade de sessão e histórico de interação — todos crescendo. A linha dominante da conta na nuvem muda de tokens de GPU para infraestrutura de retrieval vetorial e híbrido. Isso remodela a decisão build vs. buy. Infra de memória não se comoditiza como a camada de modelos. Vencem a longo prazo os times que tratam memória como investimento de primeira classe desde o dia um.
3. RAG clássico vira arquitetura legada
“Fazer embedding de documentos, top-k na consulta do usuário, enfiar no prompt” é o COBOL da arquitetura de IA. Funciona, está em todo lugar — e vai ser constrangedor em retrospecto. O substituto já está visível: retrieval agentic, no qual o modelo planeja suas próprias buscas, emite consultas em múltiplos passos, lê resultados intermediários e decide o que buscar em seguida. Parece menos uma consulta de banco e mais um processo de pesquisa. Times que ainda estão construindo pipelines de RAG estáticos hoje já estão em rota de migração, queiram ou não.
4. Memória vira a superfície de ataque
Ataques à memória se compõem de um jeito que prompt injection não faz. Um adversário que consegue escrever em um store de memória de longa duração — diretamente ou por um canal de entrada que você não considerava privilegiado — pode moldar o comportamento do sistema para todos os usuários futuros que ele tocar. Exfiltração funciona igual ao contrário: contexto de uma sessão vazando para outra porque o modelo de escopo era relaxado. O primeiro incidente sério de envenenamento de memória no mundo real está chegando. A correria da indústria por proveniência, atestação e controle de acesso por fato virá na sequência.
5. Fronteiras de privacidade de contexto viram exigência de compliance
O próximo passo lógico de “escopo de contexto é fronteira de segurança” é o isolamento criptográfico de segmentos de memória — para que agentes só revelem contexto em base de necessidade de conhecimento. Isso importa no momento em que você tem subagentes com níveis de confiança diferentes ou regulações que exigem escopo comprovável de fatos sensíveis. Espere a primeira auditoria em setor regulado citando “isolamento insuficiente entre escopos de memória de agentes” como gatilho — e frameworks de compliance na sequência. Times que já têm escopo criptográfico no roadmap vão ganhar RFPs que dependem disso. Quem não tem vai adaptar às pressas sob pressão de prazo.
6. Consistência entre múltiplos agentes vira capacidade nomeada e esperada
Hoje, um agente de billing e um de suporte, tocando a mesma conta de cliente, podem dar respostas contraditórias porque puxaram fatias diferentes de memória e nada as reconciliou. É tolerável agora porque a maioria dos deployments é de agente único. À medida que sistemas multiagente forem para produção em escala, os usuários vão começar a notar as contradições — e “consistência contextual” vira capacidade nomeada na qual plataformas competem. Vai aparecer primeiro em matrizes de comparação de vendors e depois em checklists de compras corporativas. Resolver cedo vira diferencial. Ignorar significa receber chamados perguntando por que dois agentes seus discordam sobre o mesmo cliente.
7. “Contexto útil per capita” vira métrica de benchmark
Benchmarks vão sair do nível de modelo para o nível de sistema — e a métrica principal será algo como contexto útil carregado por usuário, por interação. É o número que realmente prevê retenção e a diferença entre um produto que parece conhecer você e outro que parece resetar toda terça-feira. Vai aparecer em decks para investidores antes de surgir em papers acadêmicos. Uma métrica correlata — custo por token de contexto útil — vira questão de unit economics que vale responder.
O que fazer na segunda-feira
Se você é novo nisso e quer um ponto de partida: pare de tratar memória como uma coisa só. Pegue um agente de produção ao qual você tenha acesso, rotule que tipo de memória cada um dos stores realmente contém — e repare quantas vezes um store está fazendo três trabalhos.
Se você já está construindo agentes: instrumente o loop. Especificamente, instrumente o sinal entre retrieval e promoção. Vi muitos times que conseguem dizer o que o sistema recuperou em um dado turno. Bem menos conseguem dizer quais dessas memórias recuperadas o modelo realmente usou — e quase nenhum consegue dizer por que uma memória foi promovida em primeiro lugar.
Saber quais memórias foram usadas permite reforçá-las na próxima etapa de promoção — é assim que um sistema de memória deixa de ser um log write-once e passa a realmente aprender.
Esse loop de feedback é onde vive a vantagem composta — e é onde está acontecendo o trabalho interessante no próximo capítulo desta disciplina.
Todo mundo acessa os mesmos modelos de fronteira em prazos parecidos. O que ninguém mais copia é a camada de memória que você constrói em volta deles: moldada pelos seus usuários, suas decisões e seu julgamento sobre o que vale a pena lembrar.
Modelos são compartilhados. O sistema de memória é seu.