Hanya dua hari setelah rilis GPT-5.5 Instant, OpenAI kembali membawa kabar besar dengan rilis baru yang berfokus pada tiga hal sekaligus:
- model suara yang bisa bernalar sambil berbicara: yaitu GPT‑Realtime‑2
- terjemahan langsung untuk 70+ bahasa: GPT‑Realtime‑Translate
- dan terakhir, transkripsi streaming yang mampu mengikuti percakapan nyata: GPT‑Realtime‑Whisper
Dalam artikel ini, kami akan merangkum kabar terbaru tentang ketiga model tersebut.
Jika Anda tertarik pada model pesaing yang berfokus pada interaksi langsung, kami sarankan membaca panduan kami tentang TML-Interaction-Small dari Thinking Machines Lab.
Apa itu GPT-Realtime-2?
GPT-Realtime-2 adalah model suara waktu nyata baru di API OpenAI, dan model suara pertama yang oleh OpenAI digambarkan memiliki "penalaran kelas GPT-5."
Model ini dibuat untuk interaksi suara langsung; yakni seseorang berbicara kepadanya, bukan mengetik.
Model ini dirancang untuk menjaga percakapan tetap berjalan sambil menalar permintaan, memanggil alat, dan menangani koreksi. Dengan kata lain, ia merespons dengan cara yang sesuai dengan momen.
Berikut beberapa karakteristik penting dibandingkan model sebelumnya, GPT-Realtime-1.5:
- jendela konteks melonjak dari 32K ke 128K
- pengembang kini dapat mengatur tingkat upaya penalaran
- sentuhan kecil seperti frasa pembuka membuat agen suara terasa kurang kaku
Apa itu GPT-Realtime-Translate?
GPT-Realtime-Translate adalah model terjemahan ucapan langsung baru dari OpenAI, mendukung 70+ bahasa input dan 13 bahasa output.
Model ini dibuat untuk kasus suara-ke-suara: setiap orang berbicara dalam bahasa pilihannya, dan model menerjemahkan secara waktu nyata. Model ini dirancang untuk menjaga makna tetap utuh ketika pembicara berganti konteks, menggunakan pelafalan regional, atau menyelipkan istilah khusus domain.
Apa itu GPT-Realtime-Whisper?
GPT-Realtime-Whisper adalah model pengenalan ucapan-ke-teks streaming baru dari OpenAI, dibuat untuk transkripsi berlatensi rendah saat pembicara berbicara.
Whisper asli dirancang untuk potongan audio yang sudah selesai. Dengan versi streaming yang lebih baru, kita memiliki model yang lebih berguna untuk takarir siaran langsung dan agen suara yang perlu memahami pengguna secara berkelanjutan, bukan giliran demi giliran.
Jadi, jika Anda bingung, berikut strukturnya:
- GPT-Realtime-2 = agen percakapan suara lengkap. Mendengarkan, bernalar, memanggil alat, merespons dengan suara. Gunakan ini saat Anda menginginkan suara masuk dan suara keluar.
- GPT-Realtime-Translate = pipa terjemahan. Ucapan dalam bahasa A → ucapan dalam bahasa B. Ia tidak bercakap-cakap dengan siapa pun; ia mengonversi satu aliran menjadi aliran lain.
- GPT-Realtime-Whisper = pipa transkripsi. Ucapan masuk → teks keluar. Tanpa penalaran, tanpa respons suara. Anda akan menggunakannya untuk takarir langsung, dan sebagainya.
Fitur Utama GPT-Realtime-2
Fitur berikut berlaku khusus untuk GPT-Realtime-2.
Preambles
Pengembang dapat membuat model mengucapkan frasa pengisi singkat seperti "izinkan saya memeriksanya" atau "sebentar, saya cek dulu" sebelum respons utamanya.
Ini adalah fitur besar karena orang cenderung tidak sabar atau tidak toleran terhadap keheningan yang canggung. Pengisi ala manusia adalah salah satu hal yang membuat agen terasa kompeten.
Panggilan alat paralel dengan narasi audio
GPT-Realtime-2 dapat memanggil beberapa alat sekaligus dan menarasikan apa yang sedang dilakukan. Jadi alih-alih hening saat tugas multi-langkah, pengguna mendapatkan komentar berkelanjutan. Ini terutama kemenangan dari sisi UX.
Perilaku pemulihan yang lebih kuat
Saat terjadi masalah—misalnya alat gagal atau permintaan ambigu—model dapat mengatakan sesuatu seperti "Saya sedang mengalami kendala dengan itu sekarang" alih-alih diam atau mengarang.
Jendela konteks: 32K → 128K
Peningkatan ini melipatgandakan empat kali lipat riwayat percakapan dan konteks yang dapat diproses model dalam satu sesi, dari 32.000 token menjadi 128.000 token. Ini membuat model cocok untuk percakapan yang lebih panjang tanpa drift.
Upaya penalaran yang dapat disesuaikan
Pengembang kini dapat memilih tingkat penalaran: minimal, rendah, sedang, tinggi, dan sangat tinggi.
Rendah adalah default, yang menjaga latensi tetap rendah untuk percakapan sederhana bolak-balik, dengan opsi yang lebih saksama saat permintaan lebih sulit.
Pemahaman domain dan kontrol nada yang lebih baik
Model kini lebih baik dalam mempertahankan terminologi khusus, seperti istilah kesehatan atau jargon finansial. Model ini juga dapat menyesuaikan penyampaiannya: lebih tenang saat menyelesaikan masalah, empatik saat pengguna frustrasi, bersemangat saat mengonfirmasi tindakan yang berhasil.
Hasil Tolok Ukur GPT-Realtime-2
Mari kita lihat tolok ukurnya. OpenAI membandingkannya dengan GPT-Realtime-1.5, sehingga memberikan gambaran year-over-year yang jelas:
- Big Bench Audio (kecerdasan audio): 81,4% → 96,6% — kenaikan 15,2 poin.
- Audio MultiChallenge (mengikuti instruksi dalam dialog lisan): 34,7% → 48,5% — kenaikan 13,8 poin.
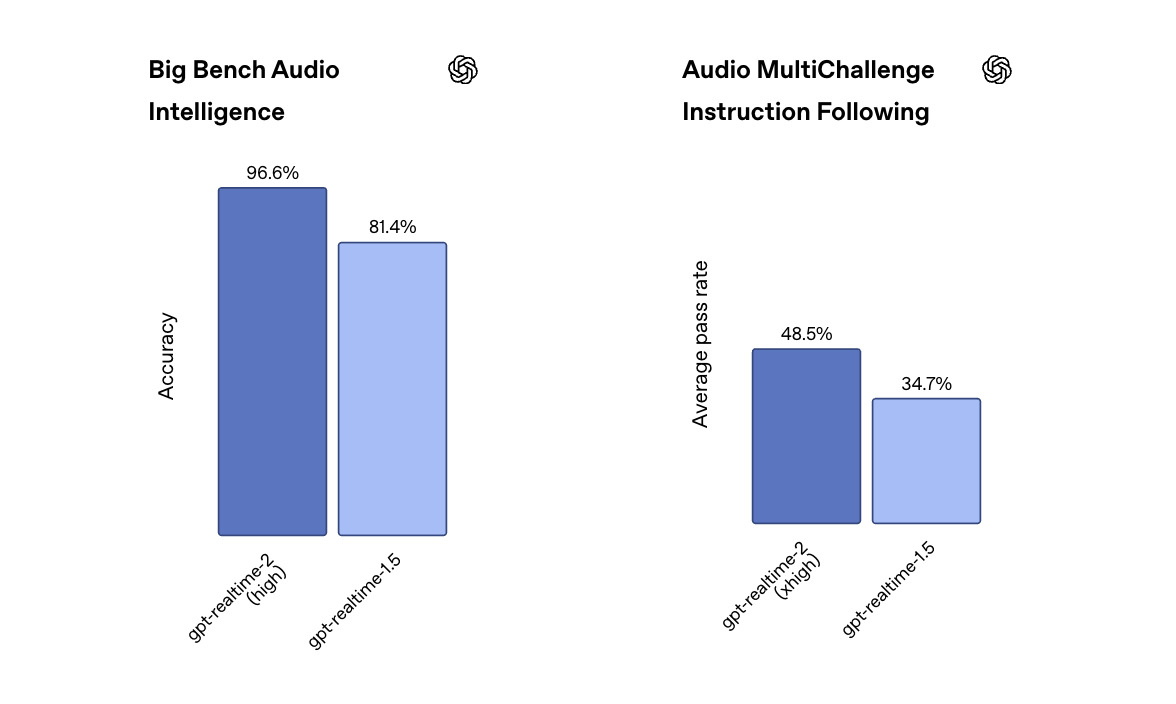
Angka Big Bench Audio menarik. 96,6% menunjukkan tolok ukur mendekati saturasi. Sementara itu, Audio MultiChallenge masih di bawah 50%, jadi hasil tolok ukur kedua ini menjadi pengingat realitas yang berguna. "Lebih baik daripada model suara tahun lalu" dan "siap untuk produksi tanpa pengawasan" adalah tolok ukur yang berbeda.
Perlu dicatat: angka-angka ini dijalankan pada pengaturan penalaran "tinggi" dan "sangat tinggi". Default di produksi adalah "rendah" demi alasan latensi, sehingga pengguna mungkin mengalami hasil yang berbeda dari ekspektasi berdasarkan angka utama tolok ukur.
Bagaimana Cara Mengakses GPT-Realtime-2?
Ketiga model audio sudah tersedia di Realtime API:
- GPT-Realtime-2: $32 per 1M token input audio ($0,40 untuk input cache), $64 per 1M token output audio.
- GPT-Realtime-Translate: $0,034 per menit.
- GPT-Realtime-Whisper: $0,017 per menit.
Dua model dengan harga per menit jauh lebih mudah dipertimbangkan untuk penganggaran. Harga audio per token sulit dikonversi menjadi "berapa biaya per panggilan?" tanpa melakukan instrumentasi. Jadi pengembang sebaiknya meluangkan waktu untuk memodelkan biaya yang diharapkan sebelum merilis atau membuat janji.
Untungnya, Anda dapat menguji GPT-Realtime-2 di Playground, dan OpenAI mengarahkan pengembang ke Codex (kami telah banyak menulis tentang Codex) dengan prompt awal untuk menambahkannya ke aplikasi yang sudah ada.
GPT-Realtime-2 dan Keamanan
Di sisi keamanan, OpenAI menyatakan bahwa pengklasifikasi aktif dapat menghentikan sesi yang melanggar pedoman konten berbahaya, dan pengembang dapat menambahkan pagar pembatas mereka sendiri melalui Agents SDK, yang juga telah kami ulas.
Perlu diingat: Suara menghadirkan cara-cara sangat spesifik di mana sesuatu bisa salah. Hal-hal ini patut dibahas:
- Aktivasi tidak sengaja: Sistem mulai mendengarkan atau merespons saat tidak ada yang bermaksud berbicara dengannya.
- Perekaman audio ambient: Setelah mikrofon menyala, ia menangkap semua suara di ruangan, bukan hanya pengguna. Percakapan latar, anak-anak, rekan kerja, TV, rapat rahasia di sebelah, dan lain-lain.
- Kekhawatiran kloning suara: Suara bersifat biometrik. Ucapan sintetis yang terdengar seperti orang nyata dapat digunakan untuk peniruan, penipuan, atau melewati sistem autentikasi suara. Ini menjadi perhatian baik pada output maupun input.
Penutup
OpenAI menggabungkan hal-hal yang membuat agen suara terasa kompeten — frasa pengisi, panggilan alat bernarasi, pemulihan yang mulus, jendela konteks besar, kenop penalaran yang nyata — ke dalam model yang juga benar-benar bisa bernalar. Dampaknya bagi pengguna: lebih sedikit keheningan canggung dan percakapan yang lebih kecil kemungkinannya berantakan. Ini langkah maju yang besar.





Hanya dua hari setelah rilis GPT-5.5 Instant, OpenAI kembali membawa kabar besar dengan rilis baru yang berfokus pada tiga hal sekaligus:
Dalam artikel ini, kami akan merangkum kabar terbaru tentang ketiga model tersebut.
Jika Anda tertarik pada model pesaing yang berfokus pada interaksi langsung, kami sarankan membaca panduan kami tentang TML-Interaction-Small dari Thinking Machines Lab.
Apa itu GPT-Realtime-2?
GPT-Realtime-2 adalah model suara waktu nyata baru di API OpenAI, dan model suara pertama yang oleh OpenAI digambarkan memiliki "penalaran kelas GPT-5."
Model ini dibuat untuk interaksi suara langsung; yakni seseorang berbicara kepadanya, bukan mengetik.
Model ini dirancang untuk menjaga percakapan tetap berjalan sambil menalar permintaan, memanggil alat, dan menangani koreksi. Dengan kata lain, ia merespons dengan cara yang sesuai dengan momen.
Berikut beberapa karakteristik penting dibandingkan model sebelumnya, GPT-Realtime-1.5:
Apa itu GPT-Realtime-Translate?
GPT-Realtime-Translate adalah model terjemahan ucapan langsung baru dari OpenAI, mendukung 70+ bahasa input dan 13 bahasa output.
Model ini dibuat untuk kasus suara-ke-suara: setiap orang berbicara dalam bahasa pilihannya, dan model menerjemahkan secara waktu nyata. Model ini dirancang untuk menjaga makna tetap utuh ketika pembicara berganti konteks, menggunakan pelafalan regional, atau menyelipkan istilah khusus domain.
Apa itu GPT-Realtime-Whisper?
GPT-Realtime-Whisper adalah model pengenalan ucapan-ke-teks streaming baru dari OpenAI, dibuat untuk transkripsi berlatensi rendah saat pembicara berbicara.
Whisper asli dirancang untuk potongan audio yang sudah selesai. Dengan versi streaming yang lebih baru, kita memiliki model yang lebih berguna untuk takarir siaran langsung dan agen suara yang perlu memahami pengguna secara berkelanjutan, bukan giliran demi giliran.
Jadi, jika Anda bingung, berikut strukturnya:
Fitur Utama GPT-Realtime-2
Fitur berikut berlaku khusus untuk GPT-Realtime-2.
Preambles
Pengembang dapat membuat model mengucapkan frasa pengisi singkat seperti "izinkan saya memeriksanya" atau "sebentar, saya cek dulu" sebelum respons utamanya.
Ini adalah fitur besar karena orang cenderung tidak sabar atau tidak toleran terhadap keheningan yang canggung. Pengisi ala manusia adalah salah satu hal yang membuat agen terasa kompeten.
Panggilan alat paralel dengan narasi audio
GPT-Realtime-2 dapat memanggil beberapa alat sekaligus dan menarasikan apa yang sedang dilakukan. Jadi alih-alih hening saat tugas multi-langkah, pengguna mendapatkan komentar berkelanjutan. Ini terutama kemenangan dari sisi UX.
Perilaku pemulihan yang lebih kuat
Saat terjadi masalah—misalnya alat gagal atau permintaan ambigu—model dapat mengatakan sesuatu seperti "Saya sedang mengalami kendala dengan itu sekarang" alih-alih diam atau mengarang.
Jendela konteks: 32K → 128K
Peningkatan ini melipatgandakan empat kali lipat riwayat percakapan dan konteks yang dapat diproses model dalam satu sesi, dari 32.000 token menjadi 128.000 token. Ini membuat model cocok untuk percakapan yang lebih panjang tanpa drift.
Upaya penalaran yang dapat disesuaikan
Pengembang kini dapat memilih tingkat penalaran: minimal, rendah, sedang, tinggi, dan sangat tinggi.
Rendah adalah default, yang menjaga latensi tetap rendah untuk percakapan sederhana bolak-balik, dengan opsi yang lebih saksama saat permintaan lebih sulit.
Pemahaman domain dan kontrol nada yang lebih baik
Model kini lebih baik dalam mempertahankan terminologi khusus, seperti istilah kesehatan atau jargon finansial. Model ini juga dapat menyesuaikan penyampaiannya: lebih tenang saat menyelesaikan masalah, empatik saat pengguna frustrasi, bersemangat saat mengonfirmasi tindakan yang berhasil.
Hasil Tolok Ukur GPT-Realtime-2
Mari kita lihat tolok ukurnya. OpenAI membandingkannya dengan GPT-Realtime-1.5, sehingga memberikan gambaran year-over-year yang jelas:
Angka Big Bench Audio menarik. 96,6% menunjukkan tolok ukur mendekati saturasi. Sementara itu, Audio MultiChallenge masih di bawah 50%, jadi hasil tolok ukur kedua ini menjadi pengingat realitas yang berguna. "Lebih baik daripada model suara tahun lalu" dan "siap untuk produksi tanpa pengawasan" adalah tolok ukur yang berbeda.
Perlu dicatat: angka-angka ini dijalankan pada pengaturan penalaran "tinggi" dan "sangat tinggi". Default di produksi adalah "rendah" demi alasan latensi, sehingga pengguna mungkin mengalami hasil yang berbeda dari ekspektasi berdasarkan angka utama tolok ukur.
Bagaimana Cara Mengakses GPT-Realtime-2?
Ketiga model audio sudah tersedia di Realtime API:
Dua model dengan harga per menit jauh lebih mudah dipertimbangkan untuk penganggaran. Harga audio per token sulit dikonversi menjadi "berapa biaya per panggilan?" tanpa melakukan instrumentasi. Jadi pengembang sebaiknya meluangkan waktu untuk memodelkan biaya yang diharapkan sebelum merilis atau membuat janji.
Untungnya, Anda dapat menguji GPT-Realtime-2 di Playground, dan OpenAI mengarahkan pengembang ke Codex (kami telah banyak menulis tentang Codex) dengan prompt awal untuk menambahkannya ke aplikasi yang sudah ada.
GPT-Realtime-2 dan Keamanan
Di sisi keamanan, OpenAI menyatakan bahwa pengklasifikasi aktif dapat menghentikan sesi yang melanggar pedoman konten berbahaya, dan pengembang dapat menambahkan pagar pembatas mereka sendiri melalui Agents SDK, yang juga telah kami ulas.
Perlu diingat: Suara menghadirkan cara-cara sangat spesifik di mana sesuatu bisa salah. Hal-hal ini patut dibahas:
Penutup
OpenAI menggabungkan hal-hal yang membuat agen suara terasa kompeten — frasa pengisi, panggilan alat bernarasi, pemulihan yang mulus, jendela konteks besar, kenop penalaran yang nyata — ke dalam model yang juga benar-benar bisa bernalar. Dampaknya bagi pengguna: lebih sedikit keheningan canggung dan percakapan yang lebih kecil kemungkinannya berantakan. Ini langkah maju yang besar.