Nur zwei Tage nach der Veröffentlichung von GPT-5.5 Instant hat OpenAI erneut große Neuigkeiten: ein Release mit gleich drei Schwerpunkten:
- Ein Sprachmodell, das beim Sprechen schlussfolgern kann: das ist GPT‑Realtime‑2
- Live-Übersetzung in über 70 Sprachen: GPT‑Realtime‑Translate
- Und schließlich Streaming-Transkription, die mit echten Gesprächen Schritt hält: GPT‑Realtime‑Whisper
In diesem Artikel fassen wir die wichtigsten Neuigkeiten zu diesen drei Modellen zusammen.
Wenn du an einem Konkurrenzmodell mit Fokus auf Live-Interaktion interessiert bist, lies unseren Guide zu Thinking Machines Labs TML-Interaction-Small.
Was ist GPT-Realtime-2?
GPT-Realtime-2 ist das neue Realtime-Sprachmodell in OpenAIs API und das erste, das OpenAI mit „GPT-5-Klasse beim Schlussfolgern“ beschreibt.
Es ist für Live-Sprachinteraktionen gebaut, also dafür, dass jemand hinein spricht statt tippt.
Das Modell hält das Gespräch am Laufen, während es Anfragen durchdenkt, Tools aufruft und Korrekturen verarbeitet. Es reagiert also so, wie es in dem Moment passt.
Wichtige Unterschiede zum Vorgänger GPT-Realtime-1.5:
- Das Kontextfenster springt von 32K auf 128K.
- Entwickelnde können den Aufwand fürs Schlussfolgern feinjustieren.
- Kleine Details wie Vorab-Phrasen lassen Sprachagenten weniger robotisch wirken.
Was ist GPT-Realtime-Translate?
GPT-Realtime-Translate ist OpenAIs neues Modell für Live-Sprachübersetzung mit Unterstützung für über 70 Eingabesprachen und 13 Ausgabesprachen.
Es ist für Voice-to-Voice gedacht: Jede Person spricht in ihrer bevorzugten Sprache, und das Modell übersetzt in Echtzeit. Es soll die Bedeutung zusammenhalten, auch wenn Sprecher den Kontext wechseln, regionale Aussprachen nutzen oder fachspezifische Begriffe einstreuen.
Was ist GPT-Realtime-Whisper?
GPT-Realtime-Whisper ist OpenAIs neues Streaming-Spracherkennungsmodell, ausgelegt auf Transkription mit niedriger Latenz, während die Person spricht.
Das ursprüngliche Whisper war für abgeschlossene Audiosegmente konzipiert. Die neue Streaming-Variante ist nützlicher für Live-Untertitel und Sprachagenten, die Nutzer kontinuierlich statt im Wechsel verstehen müssen.
Falls du den Überblick verloren hast, hier die Struktur:
- GPT-Realtime-2 = ein vollwertiger, konversationaler Sprachagent. Hört zu, schlussfolgert, ruft Tools auf, spricht zurück. Du nutzt es, wenn du Sprache rein und Sprache raus willst.
- GPT-Realtime-Translate = eine Übersetzungs-Pipeline. Sprache in Sprache A → Sprache in Sprache B. Es führt kein Gespräch, sondern wandelt einen Stream in einen anderen um.
- GPT-Realtime-Whisper = eine Transkriptions-Pipeline. Sprache rein → Text raus. Kein Schlussfolgern, keine Sprachantwort. Ideal für Live-Untertitel usw.
Wichtige Features von GPT-Realtime-2
Die folgenden Features gelten speziell für GPT-Realtime-2.
Preambles
Entwickelnde können das Modell kurze Füllsätze sagen lassen wie „Ich prüfe das kurz“ oder „Einen Moment, ich schaue nach“, bevor die eigentliche Antwort kommt.
Das ist wichtig, weil Menschen auf peinliche Pausen meist ungeduldig reagieren. Menschliche Füller tragen viel dazu bei, dass ein Agent kompetent wirkt.
Parallele Tool-Aufrufe mit Audiokommentar
GPT-Realtime-2 kann mehrere Tools gleichzeitig aufrufen und parallel dazu erzählen, was es tut. Statt Funkstille bei mehrstufigen Aufgaben bekommt der Nutzer laufenden Kommentar. Das ist vor allem ein UX-Gewinn.
Robusteres Fehlermanagement
Wenn etwas schiefgeht, etwa wenn ein Tool fehlschlägt oder eine Anfrage unklar ist, kann das Modell so etwas sagen wie „Damit habe ich gerade Schwierigkeiten“ statt zu schweigen oder etwas zu erfinden.
Kontextfenster: 32K → 128K
Das Upgrade vervierfacht die Gesprächshistorie und den Kontext, den das Modell in einer Sitzung verarbeiten kann: von 32.000 auf 128.000 Token. Damit eignet es sich für längere Gespräche ohne Drift.
Anpassbarer Schlussfolgeraufwand
Entwickelnde können nun zwischen minimal, low, medium, high und xhigh beim Schlussfolgern wählen.
Low ist der Standard, hält die Latenz für einfache Dialoge niedrig und bietet bewusstere Optionen, wenn die Anfrage komplexer ist.
Besseres Domänenverständnis und Tonalitätssteuerung
Das Modell behält fachliche Terminologie besser bei, etwa in Gesundheitsthemen oder im Finanzjargon. Außerdem kann es seine Ansprache anpassen: ruhiger beim Lösen eines Problems, empathisch bei Frust, positiv beim Bestätigen eines Erfolgs.
Benchmarks zu GPT-Realtime-2
Werfen wir einen Blick auf die Benchmarks. OpenAI vergleicht mit GPT-Realtime-1.5, was ein klares Jahr-zu-Jahr-Bild ergibt:
- Big Bench Audio (Audio-Intelligenz): 81,4% → 96,6% — plus 15,2 Punkte.
- Audio MultiChallenge (Anweisungen in gesprochener Dialogführung befolgen): 34,7% → 48,5% — plus 13,8 Punkte.
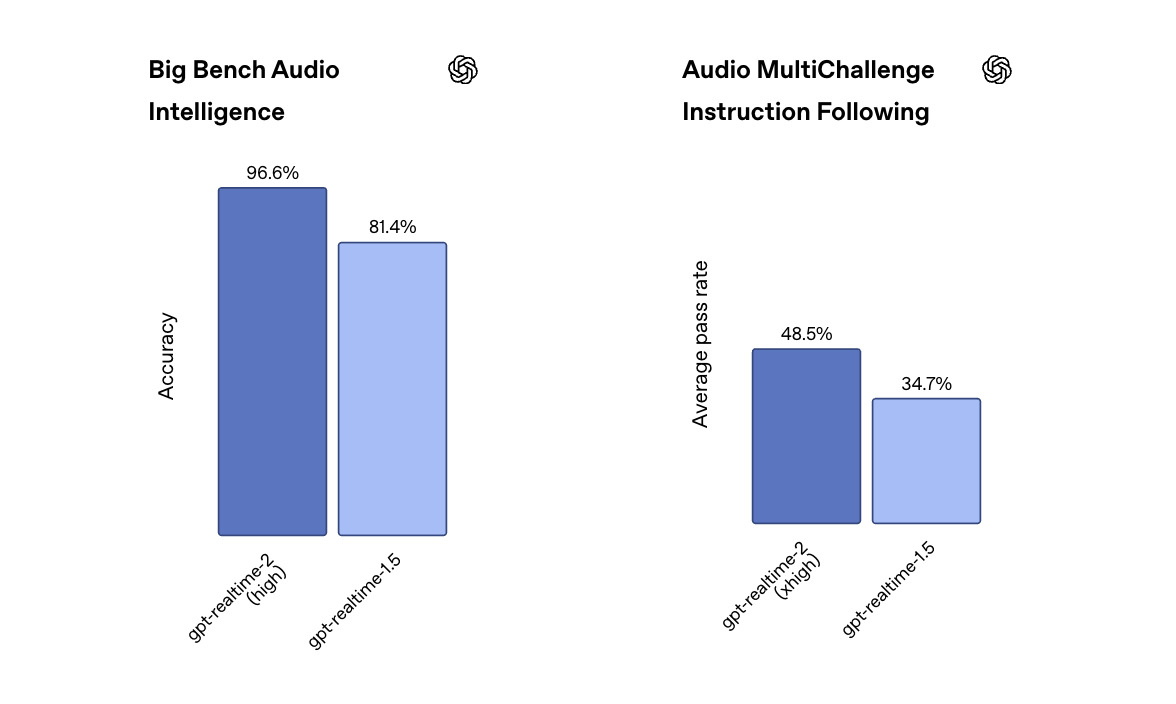
Die Big-Bench-Audio-Zahl ist spannend: 96,6% deutet darauf hin, dass die Benchmark sich der Sättigung nähert. Audio MultiChallenge liegt dagegen noch unter 50% und liefert damit einen nützlichen Realitätscheck. „Besser als das Vorjahres-Sprachmodell“ und „bereit für unbeaufsichtigten Produktionseinsatz“ sind unterschiedliche Hürden.
Wichtig: Diese Werte wurden mit den Schlussfolger-Einstellungen „high“ und „xhigh“ erzielt. In der Produktion ist aus Latenzgründen „low“ Standard, daher können Nutzer andere Erfahrungen machen, als es die Schlagzeilen-Benchmarks erwarten lassen.
Wie erhalte ich Zugang zu GPT-Realtime-2?
Alle drei Audiomodelle sind ab sofort in der Realtime API verfügbar:
- GPT-Realtime-2: 32 $ pro 1 Mio. Audio-Eingabetoken (0,40 $ bei gecachtem Input), 64 $ pro 1 Mio. Audio-Ausgabetoken.
- GPT-Realtime-Translate: 0,034 $ pro Minute.
- GPT-Realtime-Whisper: 0,017 $ pro Minute.
Die minutenbasierten Modelle sind für die Budgetplanung deutlich greifbarer. Audio-Tokenpreise lassen sich nur schwer in „Was kostet mich ein Anruf?“ umrechnen, ohne es zu messen. Entwickelnde sollten also etwas Zeit einplanen, die erwarteten Kosten zu modellieren, bevor sie ausliefern oder Zusagen machen.
Zum Glück kannst du GPT-Realtime-2 im Playground testen. Außerdem verweist OpenAI auf Codex (wir haben viel über Codex geschrieben) mit einem Starter-Prompt, um es in bestehende Apps einzubinden.
GPT-Realtime-2 und Sicherheit
Auf der Sicherheitsseite sagt OpenAI, dass aktive Klassifikatoren Sitzungen stoppen können, die gegen Richtlinien zu schädlichen Inhalten verstoßen. Entwickelnde können über das Agents SDK, über das wir ebenfalls geschrieben haben, eigene Leitplanken ergänzen.
Behalte im Hinterkopf: Stimme bringt sehr spezifische Risiken mit sich. Diese Punkte sind wichtig:
- Unbeabsichtigte Aktivierungen: Das System beginnt zuzuhören oder zu antworten, obwohl niemand mit ihm sprechen wollte.
- Umgebungsaufnahmen: Ist ein Mikrofon an, nimmt es alles im Raum auf, nicht nur den Nutzer. Hintergrundgespräche, Kinder, Kollegen, ein Fernseher, ein vertrauliches Meeting nebenan usw.
- Sorgen um Stimm-Kloning: Stimme ist biometrisch. Synthetische Sprache, die wie eine reale Person klingt, kann für Imitation, Betrug oder zum Umgehen von Sprach-Authentifizierung genutzt werden. Das betrifft sowohl Output als auch Input.
Fazit
OpenAI bündelt die Dinge, die Sprachagenten kompetent wirken lassen — Füllphrasen, kommentierte Tool-Aufrufe, elegantes Recovery, ein großes Kontextfenster, ein echter Schlussfolger-Regler — in ein Modell, das auch tatsächlich schlussfolgern kann. Für Nutzer heißt das: weniger peinliche Pausen und Gespräche, die seltener entgleisen. Das ist ein großer Schritt nach vorn.





Nur zwei Tage nach der Veröffentlichung von GPT-5.5 Instant hat OpenAI erneut große Neuigkeiten: ein Release mit gleich drei Schwerpunkten:
In diesem Artikel fassen wir die wichtigsten Neuigkeiten zu diesen drei Modellen zusammen.
Wenn du an einem Konkurrenzmodell mit Fokus auf Live-Interaktion interessiert bist, lies unseren Guide zu Thinking Machines Labs TML-Interaction-Small.
Was ist GPT-Realtime-2?
GPT-Realtime-2 ist das neue Realtime-Sprachmodell in OpenAIs API und das erste, das OpenAI mit „GPT-5-Klasse beim Schlussfolgern“ beschreibt.
Es ist für Live-Sprachinteraktionen gebaut, also dafür, dass jemand hinein spricht statt tippt.
Das Modell hält das Gespräch am Laufen, während es Anfragen durchdenkt, Tools aufruft und Korrekturen verarbeitet. Es reagiert also so, wie es in dem Moment passt.
Wichtige Unterschiede zum Vorgänger GPT-Realtime-1.5:
Was ist GPT-Realtime-Translate?
GPT-Realtime-Translate ist OpenAIs neues Modell für Live-Sprachübersetzung mit Unterstützung für über 70 Eingabesprachen und 13 Ausgabesprachen.
Es ist für Voice-to-Voice gedacht: Jede Person spricht in ihrer bevorzugten Sprache, und das Modell übersetzt in Echtzeit. Es soll die Bedeutung zusammenhalten, auch wenn Sprecher den Kontext wechseln, regionale Aussprachen nutzen oder fachspezifische Begriffe einstreuen.
Was ist GPT-Realtime-Whisper?
GPT-Realtime-Whisper ist OpenAIs neues Streaming-Spracherkennungsmodell, ausgelegt auf Transkription mit niedriger Latenz, während die Person spricht.
Das ursprüngliche Whisper war für abgeschlossene Audiosegmente konzipiert. Die neue Streaming-Variante ist nützlicher für Live-Untertitel und Sprachagenten, die Nutzer kontinuierlich statt im Wechsel verstehen müssen.
Falls du den Überblick verloren hast, hier die Struktur:
Wichtige Features von GPT-Realtime-2
Die folgenden Features gelten speziell für GPT-Realtime-2.
Preambles
Entwickelnde können das Modell kurze Füllsätze sagen lassen wie „Ich prüfe das kurz“ oder „Einen Moment, ich schaue nach“, bevor die eigentliche Antwort kommt.
Das ist wichtig, weil Menschen auf peinliche Pausen meist ungeduldig reagieren. Menschliche Füller tragen viel dazu bei, dass ein Agent kompetent wirkt.
Parallele Tool-Aufrufe mit Audiokommentar
GPT-Realtime-2 kann mehrere Tools gleichzeitig aufrufen und parallel dazu erzählen, was es tut. Statt Funkstille bei mehrstufigen Aufgaben bekommt der Nutzer laufenden Kommentar. Das ist vor allem ein UX-Gewinn.
Robusteres Fehlermanagement
Wenn etwas schiefgeht, etwa wenn ein Tool fehlschlägt oder eine Anfrage unklar ist, kann das Modell so etwas sagen wie „Damit habe ich gerade Schwierigkeiten“ statt zu schweigen oder etwas zu erfinden.
Kontextfenster: 32K → 128K
Das Upgrade vervierfacht die Gesprächshistorie und den Kontext, den das Modell in einer Sitzung verarbeiten kann: von 32.000 auf 128.000 Token. Damit eignet es sich für längere Gespräche ohne Drift.
Anpassbarer Schlussfolgeraufwand
Entwickelnde können nun zwischen minimal, low, medium, high und xhigh beim Schlussfolgern wählen.
Low ist der Standard, hält die Latenz für einfache Dialoge niedrig und bietet bewusstere Optionen, wenn die Anfrage komplexer ist.
Besseres Domänenverständnis und Tonalitätssteuerung
Das Modell behält fachliche Terminologie besser bei, etwa in Gesundheitsthemen oder im Finanzjargon. Außerdem kann es seine Ansprache anpassen: ruhiger beim Lösen eines Problems, empathisch bei Frust, positiv beim Bestätigen eines Erfolgs.
Benchmarks zu GPT-Realtime-2
Werfen wir einen Blick auf die Benchmarks. OpenAI vergleicht mit GPT-Realtime-1.5, was ein klares Jahr-zu-Jahr-Bild ergibt:
Die Big-Bench-Audio-Zahl ist spannend: 96,6% deutet darauf hin, dass die Benchmark sich der Sättigung nähert. Audio MultiChallenge liegt dagegen noch unter 50% und liefert damit einen nützlichen Realitätscheck. „Besser als das Vorjahres-Sprachmodell“ und „bereit für unbeaufsichtigten Produktionseinsatz“ sind unterschiedliche Hürden.
Wichtig: Diese Werte wurden mit den Schlussfolger-Einstellungen „high“ und „xhigh“ erzielt. In der Produktion ist aus Latenzgründen „low“ Standard, daher können Nutzer andere Erfahrungen machen, als es die Schlagzeilen-Benchmarks erwarten lassen.
Wie erhalte ich Zugang zu GPT-Realtime-2?
Alle drei Audiomodelle sind ab sofort in der Realtime API verfügbar:
Die minutenbasierten Modelle sind für die Budgetplanung deutlich greifbarer. Audio-Tokenpreise lassen sich nur schwer in „Was kostet mich ein Anruf?“ umrechnen, ohne es zu messen. Entwickelnde sollten also etwas Zeit einplanen, die erwarteten Kosten zu modellieren, bevor sie ausliefern oder Zusagen machen.
Zum Glück kannst du GPT-Realtime-2 im Playground testen. Außerdem verweist OpenAI auf Codex (wir haben viel über Codex geschrieben) mit einem Starter-Prompt, um es in bestehende Apps einzubinden.
GPT-Realtime-2 und Sicherheit
Auf der Sicherheitsseite sagt OpenAI, dass aktive Klassifikatoren Sitzungen stoppen können, die gegen Richtlinien zu schädlichen Inhalten verstoßen. Entwickelnde können über das Agents SDK, über das wir ebenfalls geschrieben haben, eigene Leitplanken ergänzen.
Behalte im Hinterkopf: Stimme bringt sehr spezifische Risiken mit sich. Diese Punkte sind wichtig:
Fazit
OpenAI bündelt die Dinge, die Sprachagenten kompetent wirken lassen — Füllphrasen, kommentierte Tool-Aufrufe, elegantes Recovery, ein großes Kontextfenster, ein echter Schlussfolger-Regler — in ein Modell, das auch tatsächlich schlussfolgern kann. Für Nutzer heißt das: weniger peinliche Pausen und Gespräche, die seltener entgleisen. Das ist ein großer Schritt nach vorn.