सिर्फ दो दिन पहले GPT-5.5 Instant के रिलीज़ के बाद, OpenAI ने एक और बड़ा अपडेट दिया है, जो एक साथ तीन बातों पर केंद्रित है:
- एक वॉइस मॉडल जो बोलते हुए तर्क कर सकता है: यही है GPT‑Realtime‑2
- 70+ भाषाओं में लाइव अनुवाद: GPT‑Realtime‑Translate
- और अंत में, वास्तविक बातचीत के साथ तालमेल रखने वाला स्ट्रीमिंग ट्रांसक्रिप्शन: GPT‑Realtime‑Whisper
इस लेख में, हम इन तीनों मॉडलों की ताज़ा खबरों से आपको जल्दी अवगत कराएंगे।
यदि आप लाइव इंटरैक्शन पर केंद्रित किसी प्रतिद्वंद्वी मॉडल में रुचि रखते हैं, तो हमारा गाइड देखें: Thinking Machines Lab का TML-Interaction-Small।
GPT-Realtime-2 क्या है?
GPT-Realtime-2 OpenAI के API में नया रीयलटाइम वॉइस मॉडल है, और पहला वॉइस मॉडल है जिसे OpenAI ने "GPT-5-स्तरीय तर्क क्षमता" वाला बताया है।
यह लाइव वॉइस इंटरैक्शन के लिए बनाया गया है; यानी, कोई इसमें बोल रहा है, टाइप नहीं कर रहा।
मॉडल को इस तरह डिजाइन किया गया है कि वह अनुरोध पर विचार करते हुए, टूल कॉल करते हुए, और सुधारों को संभालते हुए भी बातचीत को जारी रखे। यानी, यह पल के अनुरूप प्रतिक्रिया देता है।
पिछले मॉडल GPT-Realtime-1.5 की तुलना में कुछ महत्वपूर्ण विशेषताएँ:
- कॉन्टेक्स्ट विंडो 32K से बढ़कर 128K हो गई है
- डेवलपर्स अब तर्क-प्रयास के स्तर को नियंत्रित कर सकते हैं
- प्रीऐम्बल जैसी छोटी चीज़ें वॉइस एजेंट्स को कम रोबोटिक महसूस कराती हैं
GPT-Realtime-Translate क्या है?
GPT-Realtime-Translate OpenAI का नया लाइव स्पीच ट्रांसलेशन मॉडल है, जो 70+ इनपुट भाषाओं और 13 आउटपुट भाषाओं का समर्थन करता है।
यह वॉइस-टू-वॉइस स्थिति के लिए बना है: हर व्यक्ति अपनी पसंदीदा भाषा में बोलता है, और मॉडल रीयलटाइम में अनुवाद करता है। वक्ता संदर्भ बदलें, क्षेत्रीय उच्चारण इस्तेमाल करें, या डोमेन-विशेष शब्द जोड़ें—यह अर्थ को जोड़े रखता है।
GPT-Realtime-Whisper क्या है?
GPT-Realtime-Whisper OpenAI का नया स्ट्रीमिंग स्पीच-टू-टेक्स्ट मॉडल है, जो वक्ता के बोलते समय ही कम विलंबता वाला ट्रांसक्रिप्शन देता है।
मूल Whisper को पूर्ण ऑडियो खंडों के लिए डिज़ाइन किया गया था। नए स्ट्रीमिंग संस्करण के साथ, हमारे पास ऐसा मॉडल है जो लाइव प्रसारण कैप्शन और ऐसे वॉइस एजेंट्स के लिए अधिक उपयोगी है जिन्हें उपयोगकर्ता को टर्न-बाय-टर्न के बजाय निरंतर समझना पड़ता है।
तो, यदि आप उलझ गए हों, तो संरचना इस प्रकार है:
- GPT-Realtime-2 = एक संपूर्ण संवादात्मक वॉइस एजेंट। सुनता है, तर्क करता है, टूल्स कॉल करता है, जवाब में बोलता है। इसे तब उपयोग करें जब आपको वॉइस इन और वॉइस आउट दोनों चाहिए।
- GPT-Realtime-Translate = एक अनुवाद पाइप। भाषा A में भाषण → भाषा B में भाषण। यह किसी से बातचीत नहीं कर रहा; यह एक स्ट्रीम को दूसरी में बदल रहा है।
- GPT-Realtime-Whisper = एक ट्रांसक्रिप्शन पाइप। स्पीच इन → टेक्स्ट आउट। न तर्क, न वॉइस प्रतिक्रिया। आप इसे लाइव कैप्शन आदि के लिए उपयोग करेंगे।
GPT-Realtime-2 की मुख्य विशेषताएँ
निम्नलिखित विशेषताएँ विशेष रूप से GPT-Realtime-2 पर लागू होती हैं।
प्रीऐम्बल्स
डेवलपर्स मॉडल से उसके मुख्य उत्तर से पहले "मैं यह जाँचकर बताता हूँ" या "कृपया एक क्षण, मैं देखता हूँ" जैसे छोटे भराव वाक्य कहलवा सकते हैं।
यह बड़ी सुविधा है क्योंकि लोग असहज खामोशी के प्रति अधीर या असहिष्णु होते हैं। मानवीय शैली के भराव वाक्य एजेंट को सक्षम महसूस कराने वाली चीज़ों में से एक हैं।
ऑडियो नैरेशन के साथ समानांतर टूल कॉल्स
GPT-Realtime-2 एक साथ कई टूल्स कॉल कर सकता है और ऐसा करते समय वह क्या कर रहा है, इसकी नैरेशन भी दे सकता है। तो बहु-चरणीय कार्य के दौरान सन्नाटे के बजाय उपयोगकर्ता को लगातार कमेंट्री मिलती रहती है। यह अधिकतर UX के लिए फायदेमंद है।
बेहतर रिकवरी व्यवहार
जब कुछ गलत हो जाए—जैसे कोई टूल फेल हो जाए या अनुरोध अस्पष्ट हो—तो मॉडल "मुझे अभी इसमें दिक्कत आ रही है" जैसा कुछ कह सकता है, खामोश होने या मनगढ़ंत उत्तर देने के बजाय।
कॉन्टेक्स्ट विंडो: 32K → 128K
यह अपग्रेड एक सत्र में मॉडल द्वारा संसाधित की जा सकने वाली बातचीत के इतिहास और संदर्भ की मात्रा को चार गुना कर देता है—32,000 टोकन से 128,000 टोकन तक। इससे मॉडल लंबी बातचीत के लिए उपयुक्त हो जाता है, बिना ड्रिफ्ट के।
समायोज्य तर्क-प्रयास
डेवलपर्स अब न्यूनतम, लो, मीडियम, हाई और xhigh तर्क स्तरों में से चुन सकते हैं।
डिफ़ॉल्ट "लो" है, जो साधारण आगे-पीछे की बातचीत में विलंबता कम रखता है; जबकि कठिन अनुरोधों के लिए अधिक विचारशील विकल्प उपलब्ध हैं।
बेहतर डोमेन समझ और टोन नियंत्रण
अब मॉडल स्वास्थ्य सेवा शब्दावली या वित्तीय जार्गन जैसे विशिष्ट शब्दों को बेहतर तरीके से बनाए रखता है। यह अपनी डिलीवरी भी समायोजित कर सकता है: समस्या सुलझाते समय शांत, उपयोगकर्ता की झुंझलाहट पर सहानुभूतिपूर्ण, सफल क्रिया की पुष्टि करते समय उत्साहपूर्ण।
GPT-Realtime-2 बेंचमार्क परिणाम
आइए बेंचमार्क्स पर नज़र डालें। OpenAI की तुलना GPT-Realtime-1.5 से है, जो साल-दर-साल की स्पष्ट तस्वीर देती है:
- Big Bench Audio (ऑडियो इंटेलिजेंस): 81.4% → 96.6% — 15.2 अंकों की बढ़त।
- Audio MultiChallenge (बोली गई बातचीत में निर्देशों का पालन): 34.7% → 48.5% — 13.8 अंकों की बढ़त।
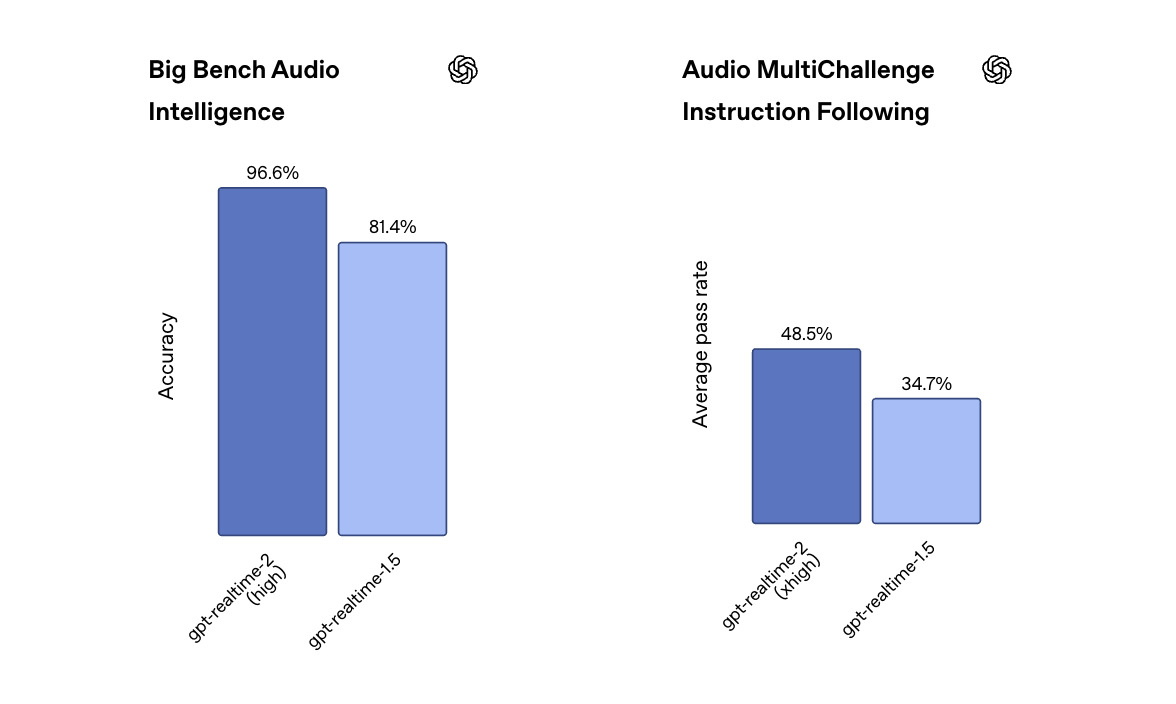
Big Bench Audio का आँकड़ा दिलचस्प है। 96.6% बताता है कि बेंचमार्क संतृप्ति के करीब है। दूसरी ओर, Audio MultiChallenge अभी भी 50% से नीचे है, इसलिए दूसरा बेंचमार्क परिणाम वास्तविकता की उपयोगी जाँच है। "पिछले साल के वॉइस मॉडल से बेहतर" और "बिना निगरानी के प्रोडक्शन के लिए तैयार" अलग-अलग मानदंड हैं।
ध्यान देने योग्य बात: ये आँकड़े "हाई" और "xhigh" तर्क सेटिंग्स पर चलाए गए थे। प्रोडक्शन में डिफ़ॉल्ट "लो" होगा ताकि विलंबता कम रहे, इसलिए उपयोगकर्ताओं का अनुभव सुर्खियों वाले बेंचमार्क परिणाम से अलग हो सकता है।
मैं GPT-Realtime-2 तक कैसे पहुँच सकता/सकती हूँ?
तीनों ऑडियो मॉडल अब Realtime API में उपलब्ध हैं:
- GPT-Realtime-2: प्रति 1M ऑडियो इनपुट टोकन $32 (कैश्ड इनपुट के लिए $0.40), प्रति 1M ऑडियो आउटपुट टोकन $64।
- GPT-Realtime-Translate: प्रति मिनट $0.034।
- GPT-Realtime-Whisper: प्रति मिनट $0.017।
मिनट के हिसाब से कीमत वाले दोनों मॉडल बजटिंग के लिहाज़ से समझना कहीं आसान हैं। प्रति-टोकन ऑडियो प्राइसिंग को "प्रति कॉल इसकी लागत क्या होगी?" में बदले बिना इन्स्ट्रूमेंटिंग के कठिन है। इसलिए डेवलपर को शिपिंग या कोई वादा करने से पहले अपेक्षित लागत का कुछ मॉडलिंग करने की उम्मीद रखनी चाहिए।
अच्छी बात यह है कि आप Playground में GPT-Realtime-2 को टेस्ट कर सकते हैं, और OpenAI डेवलपर्स को Codex की ओर इंगित कर रहा है (हमने Codex पर काफी लिखा है) ताकि मौजूदा ऐप्स में इसे जोड़ने के लिए एक स्टार्टर प्रॉम्प्ट मिल सके।
GPT-Realtime-2 और सुरक्षा
सुरक्षा पक्ष पर, OpenAI कहता है कि सक्रिय क्लासिफायर उन सत्रों को रोक सकते हैं जो हानिकारक सामग्री दिशानिर्देशों का उल्लंघन करते हैं, और डेवलपर्स Agents SDK के माध्यम से अपने स्वयं के गार्डरेल जोड़ सकते हैं, जिस पर हमने भी लिखा है।
ध्यान रखें: वॉइस कुछ बहुत विशिष्ट तरीकों से गलत जा सकता है। इन पर बात करना ज़रूरी है:
- अनजाने सक्रियण: सिस्टम तब सुनना या जवाब देना शुरू कर दे जब किसी ने उससे बात करने का इरादा ही नहीं किया था।
- परिवेशी ऑडियो कैप्चर: एक बार माइक्रोफ़ोन ऑन हो गया तो वह कमरे की हर चीज़ उठाता है, सिर्फ़ उपयोगकर्ता नहीं। बैकग्राउंड बातचीत, बच्चे, सहकर्मी, टीवी, पास के कक्ष में गोपनीय मीटिंग, वगैरह।
- वॉइस-क्लोनिंग चिंताएँ: आवाज़ बायोमेट्रिक है। किसी वास्तविक व्यक्ति जैसी सुनाई देने वाली सिंथेटिक स्पीच का इस्तेमाल प्रतिरूपण, धोखाधड़ी, या वॉइस-ऑथेंटिकेशन सिस्टम को बायपास करने में हो सकता है। यह आउटपुट और इनपुट—दोनों तरह की चिंता है।
अंतिम विचार
OpenAI वे सब चीज़ें एक साथ ला रहा है जो वॉइस एजेंट्स को कुशल महसूस कराती हैं—भराव वाक्य, नैरेटेड टूल कॉल, सहज रिकवरी, बड़ा कॉन्टेक्स्ट विंडो, वास्तविक तर्क-डायल—एक ऐसे मॉडल में जो सच में तर्क भी कर सकता है। उपयोगकर्ता के लिए इसका नतीजा: कम असहज खामोशियाँ और ऐसी बातचीत जो टूटने की संभावना कम रखती हैं। यह बड़ा कदम है।


सिर्फ दो दिन पहले GPT-5.5 Instant के रिलीज़ के बाद, OpenAI ने एक और बड़ा अपडेट दिया है, जो एक साथ तीन बातों पर केंद्रित है:
इस लेख में, हम इन तीनों मॉडलों की ताज़ा खबरों से आपको जल्दी अवगत कराएंगे।
यदि आप लाइव इंटरैक्शन पर केंद्रित किसी प्रतिद्वंद्वी मॉडल में रुचि रखते हैं, तो हमारा गाइड देखें: Thinking Machines Lab का TML-Interaction-Small।
GPT-Realtime-2 क्या है?
GPT-Realtime-2 OpenAI के API में नया रीयलटाइम वॉइस मॉडल है, और पहला वॉइस मॉडल है जिसे OpenAI ने "GPT-5-स्तरीय तर्क क्षमता" वाला बताया है।
यह लाइव वॉइस इंटरैक्शन के लिए बनाया गया है; यानी, कोई इसमें बोल रहा है, टाइप नहीं कर रहा।
मॉडल को इस तरह डिजाइन किया गया है कि वह अनुरोध पर विचार करते हुए, टूल कॉल करते हुए, और सुधारों को संभालते हुए भी बातचीत को जारी रखे। यानी, यह पल के अनुरूप प्रतिक्रिया देता है।
पिछले मॉडल GPT-Realtime-1.5 की तुलना में कुछ महत्वपूर्ण विशेषताएँ:
GPT-Realtime-Translate क्या है?
GPT-Realtime-Translate OpenAI का नया लाइव स्पीच ट्रांसलेशन मॉडल है, जो 70+ इनपुट भाषाओं और 13 आउटपुट भाषाओं का समर्थन करता है।
यह वॉइस-टू-वॉइस स्थिति के लिए बना है: हर व्यक्ति अपनी पसंदीदा भाषा में बोलता है, और मॉडल रीयलटाइम में अनुवाद करता है। वक्ता संदर्भ बदलें, क्षेत्रीय उच्चारण इस्तेमाल करें, या डोमेन-विशेष शब्द जोड़ें—यह अर्थ को जोड़े रखता है।
GPT-Realtime-Whisper क्या है?
GPT-Realtime-Whisper OpenAI का नया स्ट्रीमिंग स्पीच-टू-टेक्स्ट मॉडल है, जो वक्ता के बोलते समय ही कम विलंबता वाला ट्रांसक्रिप्शन देता है।
मूल Whisper को पूर्ण ऑडियो खंडों के लिए डिज़ाइन किया गया था। नए स्ट्रीमिंग संस्करण के साथ, हमारे पास ऐसा मॉडल है जो लाइव प्रसारण कैप्शन और ऐसे वॉइस एजेंट्स के लिए अधिक उपयोगी है जिन्हें उपयोगकर्ता को टर्न-बाय-टर्न के बजाय निरंतर समझना पड़ता है।
तो, यदि आप उलझ गए हों, तो संरचना इस प्रकार है:
GPT-Realtime-2 की मुख्य विशेषताएँ
निम्नलिखित विशेषताएँ विशेष रूप से GPT-Realtime-2 पर लागू होती हैं।
प्रीऐम्बल्स
डेवलपर्स मॉडल से उसके मुख्य उत्तर से पहले "मैं यह जाँचकर बताता हूँ" या "कृपया एक क्षण, मैं देखता हूँ" जैसे छोटे भराव वाक्य कहलवा सकते हैं।
यह बड़ी सुविधा है क्योंकि लोग असहज खामोशी के प्रति अधीर या असहिष्णु होते हैं। मानवीय शैली के भराव वाक्य एजेंट को सक्षम महसूस कराने वाली चीज़ों में से एक हैं।
ऑडियो नैरेशन के साथ समानांतर टूल कॉल्स
GPT-Realtime-2 एक साथ कई टूल्स कॉल कर सकता है और ऐसा करते समय वह क्या कर रहा है, इसकी नैरेशन भी दे सकता है। तो बहु-चरणीय कार्य के दौरान सन्नाटे के बजाय उपयोगकर्ता को लगातार कमेंट्री मिलती रहती है। यह अधिकतर UX के लिए फायदेमंद है।
बेहतर रिकवरी व्यवहार
जब कुछ गलत हो जाए—जैसे कोई टूल फेल हो जाए या अनुरोध अस्पष्ट हो—तो मॉडल "मुझे अभी इसमें दिक्कत आ रही है" जैसा कुछ कह सकता है, खामोश होने या मनगढ़ंत उत्तर देने के बजाय।
कॉन्टेक्स्ट विंडो: 32K → 128K
यह अपग्रेड एक सत्र में मॉडल द्वारा संसाधित की जा सकने वाली बातचीत के इतिहास और संदर्भ की मात्रा को चार गुना कर देता है—32,000 टोकन से 128,000 टोकन तक। इससे मॉडल लंबी बातचीत के लिए उपयुक्त हो जाता है, बिना ड्रिफ्ट के।
समायोज्य तर्क-प्रयास
डेवलपर्स अब न्यूनतम, लो, मीडियम, हाई और xhigh तर्क स्तरों में से चुन सकते हैं।
डिफ़ॉल्ट "लो" है, जो साधारण आगे-पीछे की बातचीत में विलंबता कम रखता है; जबकि कठिन अनुरोधों के लिए अधिक विचारशील विकल्प उपलब्ध हैं।
बेहतर डोमेन समझ और टोन नियंत्रण
अब मॉडल स्वास्थ्य सेवा शब्दावली या वित्तीय जार्गन जैसे विशिष्ट शब्दों को बेहतर तरीके से बनाए रखता है। यह अपनी डिलीवरी भी समायोजित कर सकता है: समस्या सुलझाते समय शांत, उपयोगकर्ता की झुंझलाहट पर सहानुभूतिपूर्ण, सफल क्रिया की पुष्टि करते समय उत्साहपूर्ण।
GPT-Realtime-2 बेंचमार्क परिणाम
आइए बेंचमार्क्स पर नज़र डालें। OpenAI की तुलना GPT-Realtime-1.5 से है, जो साल-दर-साल की स्पष्ट तस्वीर देती है:
Big Bench Audio का आँकड़ा दिलचस्प है। 96.6% बताता है कि बेंचमार्क संतृप्ति के करीब है। दूसरी ओर, Audio MultiChallenge अभी भी 50% से नीचे है, इसलिए दूसरा बेंचमार्क परिणाम वास्तविकता की उपयोगी जाँच है। "पिछले साल के वॉइस मॉडल से बेहतर" और "बिना निगरानी के प्रोडक्शन के लिए तैयार" अलग-अलग मानदंड हैं।
ध्यान देने योग्य बात: ये आँकड़े "हाई" और "xhigh" तर्क सेटिंग्स पर चलाए गए थे। प्रोडक्शन में डिफ़ॉल्ट "लो" होगा ताकि विलंबता कम रहे, इसलिए उपयोगकर्ताओं का अनुभव सुर्खियों वाले बेंचमार्क परिणाम से अलग हो सकता है।
मैं GPT-Realtime-2 तक कैसे पहुँच सकता/सकती हूँ?
तीनों ऑडियो मॉडल अब Realtime API में उपलब्ध हैं:
मिनट के हिसाब से कीमत वाले दोनों मॉडल बजटिंग के लिहाज़ से समझना कहीं आसान हैं। प्रति-टोकन ऑडियो प्राइसिंग को "प्रति कॉल इसकी लागत क्या होगी?" में बदले बिना इन्स्ट्रूमेंटिंग के कठिन है। इसलिए डेवलपर को शिपिंग या कोई वादा करने से पहले अपेक्षित लागत का कुछ मॉडलिंग करने की उम्मीद रखनी चाहिए।
अच्छी बात यह है कि आप Playground में GPT-Realtime-2 को टेस्ट कर सकते हैं, और OpenAI डेवलपर्स को Codex की ओर इंगित कर रहा है (हमने Codex पर काफी लिखा है) ताकि मौजूदा ऐप्स में इसे जोड़ने के लिए एक स्टार्टर प्रॉम्प्ट मिल सके।
GPT-Realtime-2 और सुरक्षा
सुरक्षा पक्ष पर, OpenAI कहता है कि सक्रिय क्लासिफायर उन सत्रों को रोक सकते हैं जो हानिकारक सामग्री दिशानिर्देशों का उल्लंघन करते हैं, और डेवलपर्स Agents SDK के माध्यम से अपने स्वयं के गार्डरेल जोड़ सकते हैं, जिस पर हमने भी लिखा है।
ध्यान रखें: वॉइस कुछ बहुत विशिष्ट तरीकों से गलत जा सकता है। इन पर बात करना ज़रूरी है:
अंतिम विचार
OpenAI वे सब चीज़ें एक साथ ला रहा है जो वॉइस एजेंट्स को कुशल महसूस कराती हैं—भराव वाक्य, नैरेटेड टूल कॉल, सहज रिकवरी, बड़ा कॉन्टेक्स्ट विंडो, वास्तविक तर्क-डायल—एक ऐसे मॉडल में जो सच में तर्क भी कर सकता है। उपयोगकर्ता के लिए इसका नतीजा: कम असहज खामोशियाँ और ऐसी बातचीत जो टूटने की संभावना कम रखती हैं। यह बड़ा कदम है।