在发布 GPT-5.5 Instant 的两天后,OpenAI 又带来了重磅更新,此次聚焦于三件事:
- 一款能边说边推理的语音模型:也就是 GPT‑Realtime‑2
- 覆盖 70+ 种语言的实时翻译:GPT‑Realtime‑Translate
- 以及可跟上真实对话节奏的流式转写:GPT‑Realtime‑Whisper
本文将为您快速梳理这三款模型的最新动态。
如果您对以实时交互为重点的竞品模型感兴趣,建议阅读我们的指南:Thinking Machines Lab 的 TML-Interaction-Small。
什么是 GPT-Realtime-2?
GPT-Realtime-2 是 OpenAI API 中新的实时语音模型,也是 OpenAI 首次将语音模型描述为具备“GPT-5 级推理能力”。
它专为实时语音交互而构建,也就是说,用户是对它说话,而不是打字。
该模型旨在一边推理请求、一边调用工具、处理纠正,同时让对话持续推进。换言之,它会以符合当下场景的方式作答。
与前代模型 GPT-Realtime-1.5 相比,以下特性尤为重要:
- 上下文窗口从 32K 跃升至 128K
- 开发者现在可以调节推理力度
- 通过开场短语等小改进,让语音代理更少“机器人感”
什么是 GPT-Realtime-Translate?
GPT-Realtime-Translate 是 OpenAI 新的实时语音翻译模型,支持 70+ 种输入语言和 13 种输出语言。
它面向“语音到语音”的使用场景:每个人都用自己偏好的语言说话,模型实时完成翻译。即便说话者切换语境、使用地区口音或穿插专业术语,它也应能保持语义一致。
什么是 GPT-Realtime-Whisper?
GPT-Realtime-Whisper 是 OpenAI 新的流式语音转文本模型,面向低延迟转写,可随说随转。
最初的 Whisper 面向已完成的音频片段。新版流式版本则更适合直播字幕,以及需要持续理解用户而非“轮到你-轮到我”的语音代理。
如果您还不太清晰,可以这样理解:
- GPT-Realtime-2 = 完整的对话式语音代理。能听、能推理、能调用工具、能回应。需要“语音输入和语音输出”时用它。
- GPT-Realtime-Translate = 翻译管道。A 语言的语音 → B 语言的语音。它不与任何人“对话”,只是把一条音频流转成另一条。
- GPT-Realtime-Whisper = 转写管道。语音输入 → 文本输出。不做推理,不做语音回应。适用于直播字幕等场景。
GPT-Realtime-2 的关键特性
以下特性特指 GPT-Realtime-2。
开场短语(Preambles)
开发者可以让模型在主要回答前,说一些简短的填充语,如“让我查一下”或“请稍等,我看一下”。
这是一个重要特性,因为人们往往对尴尬的沉默不耐烦或难以容忍。类人的填充语会让代理显得更能干。
并行工具调用与语音讲解
GPT-Realtime-2 能同时调用多个工具,并在执行过程中口头讲解正在做什么。因此,在多步骤任务期间不再是一片沉寂,用户会听到连续的解说。这主要是用户体验上的提升。
更强的恢复能力
当出现问题时,比如工具失败或请求不明确,模型可以说“我现在处理这个有些困难”,而不是沉默或胡编乱造。
上下文窗口:32K → 128K
此次升级将单次会话中可处理的对话历史与上下文容量扩大四倍,从 32,000 个 token 提升至 128,000 个 token,更适合长对话且不易跑偏。
可调节的推理力度
开发者现在可以在 minimal、low、medium、high 和 xhigh 等级之间选择推理力度。
默认是 low,可在简单来回对话中尽量降低延迟;当请求更复杂时可选择更审慎的选项。
更好的领域理解与语气控制
模型现在能更好地保留专业术语,例如医疗或金融行话。它还可以调整表达方式:解决问题时更冷静,用户受挫时更具同理心,确认成功操作时更积极。
GPT-Realtime-2 基准测试结果
来看一下基准测试。OpenAI 与 GPT-Realtime-1.5 对比,便于形成清晰的年度横向视角:
- Big Bench Audio(音频智能):81.4% → 96.6% —— 提升 15.2 个百分点。
- Audio MultiChallenge(口语对话中的指令跟随):34.7% → 48.5% —— 提升 13.8 个百分点。
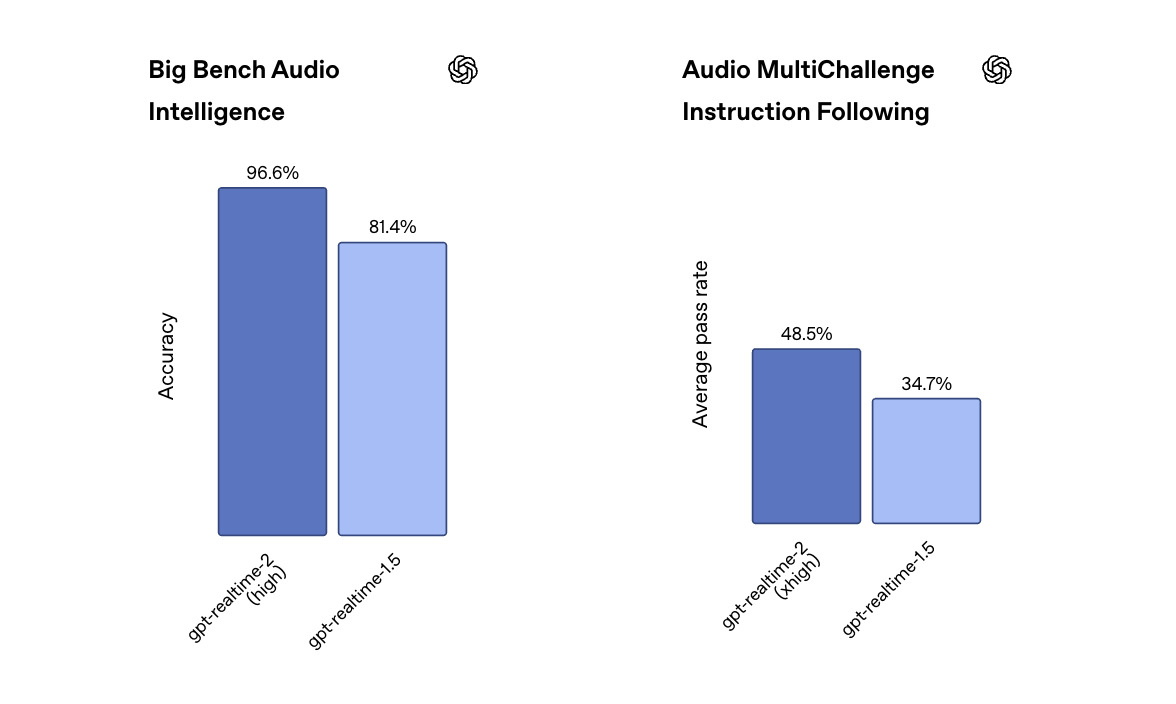
Big Bench Audio 的数值很有意思。96.6% 表明该基准正接近“饱和”。而 Audio MultiChallenge 仍低于 50%,这个结果则提供了一个有益的现实参照。“比去年的语音模型更好”与“已准备好无监督投产”之间仍有差距。
需要提醒的是:这些分数是在“high”和“xhigh”的推理设置下跑出的。生产中的默认设置为“low”,以降低延迟,因此用户的实际体验可能与基准标题给人的预期不同。
如何获取 GPT-Realtime-2?
这三款音频模型现已在 Realtime API 中提供:
- GPT-Realtime-2:每 100 万音频输入 token 收费 $32(缓存输入 $0.40),每 100 万音频输出 token 收费 $64。
- GPT-Realtime-Translate:每分钟 $0.034。
- GPT-Realtime-Whisper:每分钟 $0.017。
按分钟计费的两款模型更便于做预算评估。按音频 token 计费在没有实际埋点的情况下,很难换算成“每次调用要花多少钱?”。开发者在上线或对外承诺之前,应该预留一些时间来建模预期成本。
好在,您可以在 Playground 中测试 GPT-Realtime-2,OpenAI 也引导开发者使用 Codex(我们已撰写大量关于 Codex 的内容),并提供了将其集成到现有应用的入门提示。
GPT-Realtime-2 与安全性
在安全方面,OpenAI 表示,活动分类器可终止违反其有害内容指南的会话,开发者也可以通过我们介绍过的 Agents SDK 叠加自有防护措施。
请注意:语音引入了一些非常具体的风险,值得讨论:
- 意外唤醒:系统在无人刻意与之交谈时开始监听或回应。
- 环境音频采集:一旦麦克风开启,它会拾取房间里的一切,而不仅仅是用户。背景对话、孩子、同事、电视、隔壁的保密会议等。
- 声音克隆顾虑:声音是生物特征。听起来像真人的合成语音可能被用于冒充、欺诈,或绕过语音认证系统。这既涉及输出,也涉及输入。
结语
OpenAI 将让语音代理“显得能干”的要素——填充短语、带解说的工具调用、优雅的恢复机制、大上下文窗口、可调推理刻度——打包进了一个确实具备推理能力的模型里。对用户而言,这意味着更少的尴尬沉默,以及更不易崩盘的对话。这是重要的一步进展。


在发布 GPT-5.5 Instant 的两天后,OpenAI 又带来了重磅更新,此次聚焦于三件事:
本文将为您快速梳理这三款模型的最新动态。
如果您对以实时交互为重点的竞品模型感兴趣,建议阅读我们的指南:Thinking Machines Lab 的 TML-Interaction-Small。
什么是 GPT-Realtime-2?
GPT-Realtime-2 是 OpenAI API 中新的实时语音模型,也是 OpenAI 首次将语音模型描述为具备“GPT-5 级推理能力”。
它专为实时语音交互而构建,也就是说,用户是对它说话,而不是打字。
该模型旨在一边推理请求、一边调用工具、处理纠正,同时让对话持续推进。换言之,它会以符合当下场景的方式作答。
与前代模型 GPT-Realtime-1.5 相比,以下特性尤为重要:
什么是 GPT-Realtime-Translate?
GPT-Realtime-Translate 是 OpenAI 新的实时语音翻译模型,支持 70+ 种输入语言和 13 种输出语言。
它面向“语音到语音”的使用场景:每个人都用自己偏好的语言说话,模型实时完成翻译。即便说话者切换语境、使用地区口音或穿插专业术语,它也应能保持语义一致。
什么是 GPT-Realtime-Whisper?
GPT-Realtime-Whisper 是 OpenAI 新的流式语音转文本模型,面向低延迟转写,可随说随转。
最初的 Whisper 面向已完成的音频片段。新版流式版本则更适合直播字幕,以及需要持续理解用户而非“轮到你-轮到我”的语音代理。
如果您还不太清晰,可以这样理解:
GPT-Realtime-2 的关键特性
以下特性特指 GPT-Realtime-2。
开场短语(Preambles)
开发者可以让模型在主要回答前,说一些简短的填充语,如“让我查一下”或“请稍等,我看一下”。
这是一个重要特性,因为人们往往对尴尬的沉默不耐烦或难以容忍。类人的填充语会让代理显得更能干。
并行工具调用与语音讲解
GPT-Realtime-2 能同时调用多个工具,并在执行过程中口头讲解正在做什么。因此,在多步骤任务期间不再是一片沉寂,用户会听到连续的解说。这主要是用户体验上的提升。
更强的恢复能力
当出现问题时,比如工具失败或请求不明确,模型可以说“我现在处理这个有些困难”,而不是沉默或胡编乱造。
上下文窗口:32K → 128K
此次升级将单次会话中可处理的对话历史与上下文容量扩大四倍,从 32,000 个 token 提升至 128,000 个 token,更适合长对话且不易跑偏。
可调节的推理力度
开发者现在可以在 minimal、low、medium、high 和 xhigh 等级之间选择推理力度。
默认是 low,可在简单来回对话中尽量降低延迟;当请求更复杂时可选择更审慎的选项。
更好的领域理解与语气控制
模型现在能更好地保留专业术语,例如医疗或金融行话。它还可以调整表达方式:解决问题时更冷静,用户受挫时更具同理心,确认成功操作时更积极。
GPT-Realtime-2 基准测试结果
来看一下基准测试。OpenAI 与 GPT-Realtime-1.5 对比,便于形成清晰的年度横向视角:
Big Bench Audio 的数值很有意思。96.6% 表明该基准正接近“饱和”。而 Audio MultiChallenge 仍低于 50%,这个结果则提供了一个有益的现实参照。“比去年的语音模型更好”与“已准备好无监督投产”之间仍有差距。
需要提醒的是:这些分数是在“high”和“xhigh”的推理设置下跑出的。生产中的默认设置为“low”,以降低延迟,因此用户的实际体验可能与基准标题给人的预期不同。
如何获取 GPT-Realtime-2?
这三款音频模型现已在 Realtime API 中提供:
按分钟计费的两款模型更便于做预算评估。按音频 token 计费在没有实际埋点的情况下,很难换算成“每次调用要花多少钱?”。开发者在上线或对外承诺之前,应该预留一些时间来建模预期成本。
好在,您可以在 Playground 中测试 GPT-Realtime-2,OpenAI 也引导开发者使用 Codex(我们已撰写大量关于 Codex 的内容),并提供了将其集成到现有应用的入门提示。
GPT-Realtime-2 与安全性
在安全方面,OpenAI 表示,活动分类器可终止违反其有害内容指南的会话,开发者也可以通过我们介绍过的 Agents SDK 叠加自有防护措施。
请注意:语音引入了一些非常具体的风险,值得讨论:
结语
OpenAI 将让语音代理“显得能干”的要素——填充短语、带解说的工具调用、优雅的恢复机制、大上下文窗口、可调推理刻度——打包进了一个确实具备推理能力的模型里。对用户而言,这意味着更少的尴尬沉默,以及更不易崩盘的对话。这是重要的一步进展。