A soli due giorni dal rilascio di GPT-5.5 Instant, OpenAI annuncia altre grandi novità, con una nuova release che punta su tre aspetti insieme:
- un modello vocale che sa ragionare mentre parla: è GPT‑Realtime‑2
- traduzione in tempo reale in oltre 70 lingue: GPT‑Realtime‑Translate
- e infine, trascrizione in streaming che tiene il passo con conversazioni reali: GPT‑Realtime‑Whisper
In questo articolo, facciamo il punto su queste tre novità.
Se ti interessa un modello concorrente incentrato sull'interazione live, ti consiglio di leggere la nostra guida su TML-Interaction-Small del Thinking Machines Lab.
Che cos'è GPT-Realtime-2?
GPT-Realtime-2 è il nuovo modello vocale realtime nell'API di OpenAI, e il primo modello vocale che OpenAI descrive come dotato di "ragionamento di classe GPT-5".
È pensato per interazioni vocali live; cioè, qualcuno ci parla, non digita.
Il modello è progettato per far scorrere la conversazione mentre elabora la richiesta, chiama strumenti e gestisce correzioni. In altre parole, risponde in modo adeguato al momento.
Ecco alcune caratteristiche importanti rispetto al modello precedente, GPT-Realtime-1.5:
- la finestra di contesto passa da 32K a 128K
- gli sviluppatori possono ora modulare lo sforzo di ragionamento
- accorgimenti come le frasi di preambolo rendono le voice agent meno robotiche
Che cos'è GPT-Realtime-Translate?
GPT-Realtime-Translate è il nuovo modello di traduzione vocale live di OpenAI, che supporta oltre 70 lingue in input e 13 lingue in output.
È pensato per il caso voce-a-voce: ognuno parla nella propria lingua preferita e il modello traduce in tempo reale. Dovrebbe mantenere il significato anche quando gli interlocutori cambiano contesto, usano pronunce regionali o inseriscono termini specifici di dominio.
Che cos'è GPT-Realtime-Whisper?
GPT-Realtime-Whisper è il nuovo modello di speech-to-text in streaming di OpenAI, creato per trascrizioni a bassa latenza mentre l'oratore parla.
L'originale Whisper era progettato per blocchi di audio completati. Con la nuova versione in streaming, abbiamo un modello più utile per sottotitoli live e agenti vocali che devono comprendere l'utente in modo continuo e non a turni.
Quindi, se ti sei perso, ecco lo schema:
- GPT-Realtime-2 = un agente vocale conversazionale completo. Ascolta, ragiona, chiama strumenti, risponde a voce. Lo usi quando vuoi voce in e voce out.
- GPT-Realtime-Translate = un canale di traduzione. Voce in lingua A → voce in lingua B. Non sta conversando con nessuno; converte uno stream in un altro.
- GPT-Realtime-Whisper = un canale di trascrizione. Voce in → testo out. Niente ragionamento, nessuna risposta vocale. Lo useresti per sottotitoli live, ecc.
Funzionalità chiave di GPT-Realtime-2
Le seguenti funzionalità si applicano in particolare a GPT-Realtime-2.
Preamboli
Gli sviluppatori possono far pronunciare al modello brevi frasi di riempimento come "fammi controllare" o "un momento mentre verifico" prima della risposta principale.
È una grande novità perché le persone tendono a essere impazienti o intolleranti al silenzio imbarazzante. Il riempitivo in stile umano è una di quelle cose che fanno sembrare un agente competente.
Chiamate agli strumenti in parallelo con narrazione audio
GPT-Realtime-2 può chiamare più strumenti contemporaneamente e raccontare cosa sta facendo mentre lo fa. Così, invece di silenzi durante un'attività multi-step, l'utente riceve un commento continuo. È soprattutto un vantaggio di UX.
Comportamento di recupero più solido
Quando qualcosa va storto, ad esempio se uno strumento fallisce o se una richiesta è ambigua, il modello può dire qualcosa come "al momento ho difficoltà con questo" invece di tacere o inventare.
Finestra di contesto: 32K → 128K
L'upgrade quadruplica la quantità di cronologia della conversazione e di contesto che il modello può elaborare in una singola sessione, passando da 32.000 token a 128.000 token. Questo rende il modello adatto a conversazioni più lunghe senza derive.
Sforzo di ragionamento regolabile
Gli sviluppatori possono ora scegliere tra livelli di ragionamento minimale, basso, medio, alto e xhigh.
Basso è il default, che mantiene bassa la latenza per scambi semplici, con opzioni più ponderate quando la richiesta è più complessa.
Migliore comprensione dei domini e controllo del tono
Il modello ora conserva meglio la terminologia specializzata, come termini sanitari o gergo finanziario. Può anche adeguare il registro: più calmo quando risolve un problema, empatico quando l'utente è frustrato, energico quando conferma un'azione riuscita.
Risultati dei benchmark di GPT-Realtime-2
Diamo un'occhiata ai benchmark. OpenAI confronta con GPT-Realtime-1.5, offrendo un quadro chiaro anno su anno:
- Big Bench Audio (intelligenza audio): 81,4% → 96,6% — +15,2 punti.
- Audio MultiChallenge (rispetto delle istruzioni nel dialogo parlato): 34,7% → 48,5% — +13,8 punti.
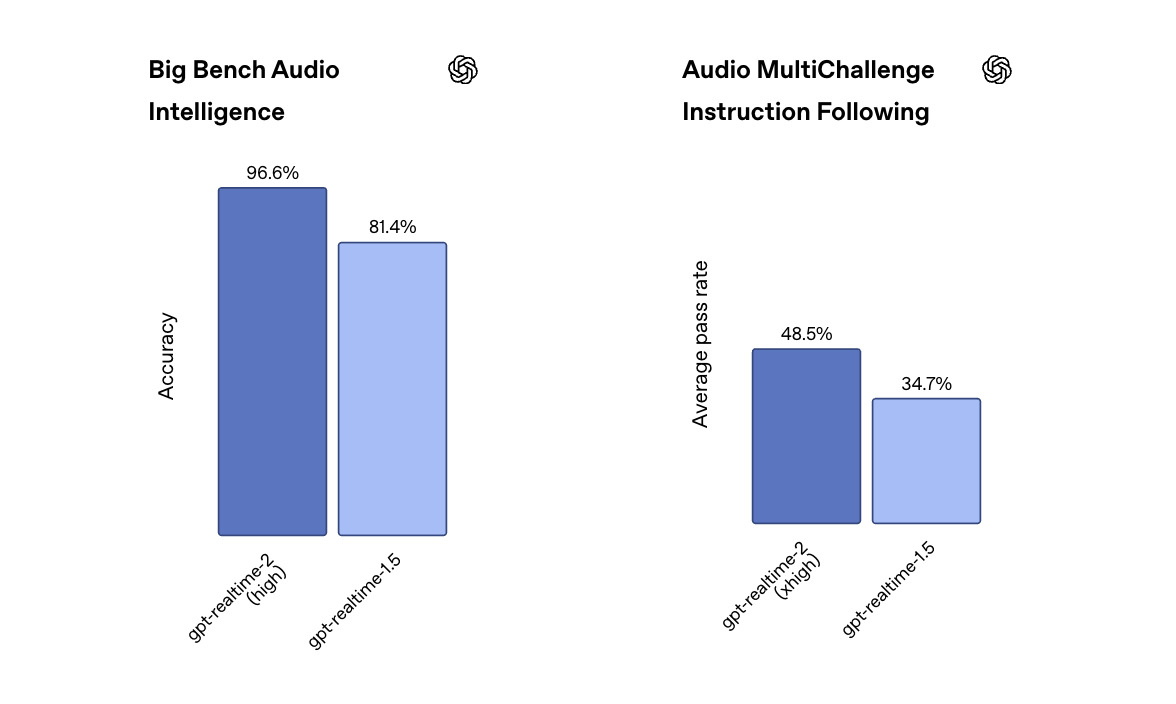
Il valore di Big Bench Audio è interessante. 96,6% ci dice che il benchmark si sta avvicinando alla saturazione. Audio MultiChallenge, invece, è ancora sotto il 50%, quindi questo secondo risultato è un utile bagno di realtà. "Meglio del modello vocale dell'anno scorso" e "pronto per la produzione non supervisionata" sono obiettivi diversi.
Vale la pena segnalarlo: questi numeri sono stati ottenuti con impostazioni di ragionamento "high" e "xhigh". In produzione il default sarà "low" per motivi di latenza, quindi l'esperienza degli utenti potrebbe differire dalle aspettative basate sul risultato di benchmark principale.
Come posso accedere a GPT-Realtime-2?
Tutti e tre i modelli audio sono già disponibili nella Realtime API:
- GPT-Realtime-2: 32 $ per 1M token audio in input (0,40 $ per input in cache), 64 $ per 1M token audio in output.
- GPT-Realtime-Translate: 0,034 $ al minuto.
- GPT-Realtime-Whisper: 0,017 $ al minuto.
I due modelli con prezzo al minuto sono molto più semplici da stimare a livello di budget. La tariffazione per token audio è difficile da convertire in "quanto costerà per chiamata?" senza strumenti di misurazione concreti. Quindi uno sviluppatore dovrebbe prevedere un po' di tempo per modellare i costi attesi prima di rilasciare o fare promesse.
Per fortuna, puoi testare GPT-Realtime-2 nel Playground, e OpenAI indica agli sviluppatori Codex (abbiamo scritto molto su Codex) con un prompt iniziale per integrarlo in app esistenti.
GPT-Realtime-2 e sicurezza
Sul fronte della sicurezza, OpenAI afferma che classificatori attivi possono interrompere le sessioni che violano le linee guida sui contenuti dannosi, e gli sviluppatori possono aggiungere ulteriori paletti tramite l'Agents SDK, di cui abbiamo scritto.
Tieni a mente: la voce introduce modi molto specifici in cui le cose possono andare storte. Vale la pena parlarne:
- Attivazioni accidentali: il sistema inizia ad ascoltare o a rispondere quando nessuno intendeva interagirci.
- Acquisizione di audio ambientale: una volta che un microfono è acceso, capta tutto ciò che c'è nella stanza, non solo l'utente. Conversazioni di sottofondo, bambini, colleghi, una TV, una riunione riservata nella stanza accanto, ecc.
- Preoccupazioni per il voice cloning: la voce è biometrica. Parlato sintetico che suona come una persona reale può essere usato per impersonificazione, frode o per aggirare sistemi di autenticazione vocale. È un rischio sia in output che in input.
Considerazioni finali
OpenAI sta unendo gli elementi che fanno sembrare competenti le voice agent — frasi di riempimento, chiamate agli strumenti narrate, recupero elegante, una grande finestra di contesto, un vero selettore di ragionamento — in un modello che sa anche davvero ragionare. Cosa significa per l'utente: meno silenzi imbarazzanti e conversazioni meno soggette a sfaldarsi. È un grande passo avanti.







A soli due giorni dal rilascio di GPT-5.5 Instant, OpenAI annuncia altre grandi novità, con una nuova release che punta su tre aspetti insieme:
In questo articolo, facciamo il punto su queste tre novità.
Se ti interessa un modello concorrente incentrato sull'interazione live, ti consiglio di leggere la nostra guida su TML-Interaction-Small del Thinking Machines Lab.
Che cos'è GPT-Realtime-2?
GPT-Realtime-2 è il nuovo modello vocale realtime nell'API di OpenAI, e il primo modello vocale che OpenAI descrive come dotato di "ragionamento di classe GPT-5".
È pensato per interazioni vocali live; cioè, qualcuno ci parla, non digita.
Il modello è progettato per far scorrere la conversazione mentre elabora la richiesta, chiama strumenti e gestisce correzioni. In altre parole, risponde in modo adeguato al momento.
Ecco alcune caratteristiche importanti rispetto al modello precedente, GPT-Realtime-1.5:
Che cos'è GPT-Realtime-Translate?
GPT-Realtime-Translate è il nuovo modello di traduzione vocale live di OpenAI, che supporta oltre 70 lingue in input e 13 lingue in output.
È pensato per il caso voce-a-voce: ognuno parla nella propria lingua preferita e il modello traduce in tempo reale. Dovrebbe mantenere il significato anche quando gli interlocutori cambiano contesto, usano pronunce regionali o inseriscono termini specifici di dominio.
Che cos'è GPT-Realtime-Whisper?
GPT-Realtime-Whisper è il nuovo modello di speech-to-text in streaming di OpenAI, creato per trascrizioni a bassa latenza mentre l'oratore parla.
L'originale Whisper era progettato per blocchi di audio completati. Con la nuova versione in streaming, abbiamo un modello più utile per sottotitoli live e agenti vocali che devono comprendere l'utente in modo continuo e non a turni.
Quindi, se ti sei perso, ecco lo schema:
Funzionalità chiave di GPT-Realtime-2
Le seguenti funzionalità si applicano in particolare a GPT-Realtime-2.
Preamboli
Gli sviluppatori possono far pronunciare al modello brevi frasi di riempimento come "fammi controllare" o "un momento mentre verifico" prima della risposta principale.
È una grande novità perché le persone tendono a essere impazienti o intolleranti al silenzio imbarazzante. Il riempitivo in stile umano è una di quelle cose che fanno sembrare un agente competente.
Chiamate agli strumenti in parallelo con narrazione audio
GPT-Realtime-2 può chiamare più strumenti contemporaneamente e raccontare cosa sta facendo mentre lo fa. Così, invece di silenzi durante un'attività multi-step, l'utente riceve un commento continuo. È soprattutto un vantaggio di UX.
Comportamento di recupero più solido
Quando qualcosa va storto, ad esempio se uno strumento fallisce o se una richiesta è ambigua, il modello può dire qualcosa come "al momento ho difficoltà con questo" invece di tacere o inventare.
Finestra di contesto: 32K → 128K
L'upgrade quadruplica la quantità di cronologia della conversazione e di contesto che il modello può elaborare in una singola sessione, passando da 32.000 token a 128.000 token. Questo rende il modello adatto a conversazioni più lunghe senza derive.
Sforzo di ragionamento regolabile
Gli sviluppatori possono ora scegliere tra livelli di ragionamento minimale, basso, medio, alto e xhigh.
Basso è il default, che mantiene bassa la latenza per scambi semplici, con opzioni più ponderate quando la richiesta è più complessa.
Migliore comprensione dei domini e controllo del tono
Il modello ora conserva meglio la terminologia specializzata, come termini sanitari o gergo finanziario. Può anche adeguare il registro: più calmo quando risolve un problema, empatico quando l'utente è frustrato, energico quando conferma un'azione riuscita.
Risultati dei benchmark di GPT-Realtime-2
Diamo un'occhiata ai benchmark. OpenAI confronta con GPT-Realtime-1.5, offrendo un quadro chiaro anno su anno:
Il valore di Big Bench Audio è interessante. 96,6% ci dice che il benchmark si sta avvicinando alla saturazione. Audio MultiChallenge, invece, è ancora sotto il 50%, quindi questo secondo risultato è un utile bagno di realtà. "Meglio del modello vocale dell'anno scorso" e "pronto per la produzione non supervisionata" sono obiettivi diversi.
Vale la pena segnalarlo: questi numeri sono stati ottenuti con impostazioni di ragionamento "high" e "xhigh". In produzione il default sarà "low" per motivi di latenza, quindi l'esperienza degli utenti potrebbe differire dalle aspettative basate sul risultato di benchmark principale.
Come posso accedere a GPT-Realtime-2?
Tutti e tre i modelli audio sono già disponibili nella Realtime API:
I due modelli con prezzo al minuto sono molto più semplici da stimare a livello di budget. La tariffazione per token audio è difficile da convertire in "quanto costerà per chiamata?" senza strumenti di misurazione concreti. Quindi uno sviluppatore dovrebbe prevedere un po' di tempo per modellare i costi attesi prima di rilasciare o fare promesse.
Per fortuna, puoi testare GPT-Realtime-2 nel Playground, e OpenAI indica agli sviluppatori Codex (abbiamo scritto molto su Codex) con un prompt iniziale per integrarlo in app esistenti.
GPT-Realtime-2 e sicurezza
Sul fronte della sicurezza, OpenAI afferma che classificatori attivi possono interrompere le sessioni che violano le linee guida sui contenuti dannosi, e gli sviluppatori possono aggiungere ulteriori paletti tramite l'Agents SDK, di cui abbiamo scritto.
Tieni a mente: la voce introduce modi molto specifici in cui le cose possono andare storte. Vale la pena parlarne:
Considerazioni finali
OpenAI sta unendo gli elementi che fanno sembrare competenti le voice agent — frasi di riempimento, chiamate agli strumenti narrate, recupero elegante, una grande finestra di contesto, un vero selettore di ragionamento — in un modello che sa anche davvero ragionare. Cosa significa per l'utente: meno silenzi imbarazzanti e conversazioni meno soggette a sfaldarsi. È un grande passo avanti.