À peine deux jours après la sortie de GPT-5.5 Instant, OpenAI revient avec d'autres annonces majeures, réunies dans une nouvelle version axée sur trois volets :
- un modèle vocal capable de raisonner en parlant : c'est GPT‑Realtime‑2
- la traduction en direct dans plus de 70 langues : GPT‑Realtime‑Translate
- et enfin, la transcription en streaming qui suit le rythme d'une vraie conversation : GPT‑Realtime‑Whisper
Dans cet article, nous faisons le point sur ces trois modèles.
Si vous cherchez un modèle concurrent dédié à l'interaction en direct, nous vous recommandons notre guide sur le TML-Interaction-Small de Thinking Machines Lab.
Qu'est-ce que GPT-Realtime-2 ?
GPT-Realtime-2 est le nouveau modèle vocal temps réel de l'API d'OpenAI, et le premier modèle vocal qu'OpenAI décrit comme doté d'un « raisonnement de classe GPT-5 ».
Il est conçu pour les interactions vocales en direct ; autrement dit, on lui parle, on ne tape pas.
Le modèle est pensé pour faire avancer la conversation tout en raisonnant sur une demande, en appelant des outils et en gérant les corrections. En un mot, il répond de manière adaptée au moment.
Voici quelques points clés par rapport au modèle précédent, GPT-Realtime-1.5 :
- la fenêtre de contexte passe de 32K à 128K
- les développeurs peuvent désormais ajuster l'effort de raisonnement
- des détails comme des préambules rendent les agents vocaux moins robotiques
Qu'est-ce que GPT-Realtime-Translate ?
GPT-Realtime-Translate est le nouveau modèle de traduction vocale en direct d'OpenAI, compatible avec plus de 70 langues en entrée et 13 langues en sortie.
Il est conçu pour le cas voix-à-voix : chaque personne parle dans sa langue, et le modèle traduit en temps réel. Il est censé préserver le sens lorsque les interlocuteurs changent de sujet, utilisent des accents régionaux ou emploient des termes spécialisés.
Qu'est-ce que GPT-Realtime-Whisper ?
GPT-Realtime-Whisper est le nouveau modèle de reconnaissance vocale en streaming d'OpenAI, optimisé pour une transcription à faible latence pendant que l'orateur parle.
Le Whisper d'origine était conçu pour des segments audio finalisés. Avec cette version en streaming, on dispose d'un modèle plus utile pour les sous-titres de diffusion en direct et pour les agents vocaux qui doivent comprendre l'utilisateur en continu plutôt que tour à tour.
Pour récapituler, voici la structure :
- GPT-Realtime-2 = un agent vocal conversationnel complet. Il écoute, raisonne, appelle des outils et répond à l'oral. À utiliser quand vous voulez de la voix en entrée et en sortie.
- GPT-Realtime-Translate = un canal de traduction. Parole en langue A → parole en langue B. Il ne tient pas une conversation ; il convertit un flux en un autre.
- GPT-Realtime-Whisper = un canal de transcription. Parole en → texte en sortie. Pas de raisonnement, pas de réponse vocale. À utiliser pour des sous-titres en direct, etc.
Fonctionnalités clés de GPT-Realtime-2
Les fonctionnalités suivantes concernent spécifiquement GPT-Realtime-2.
Préambules
Les développeurs peuvent faire prononcer au modèle de courtes phrases de transition comme « laissez-moi vérifier » ou « un instant, je regarde » avant la réponse principale.
C'est important, car nous tolérons mal les silences gênants. Ces « remplissages » à la manière humaine contribuent à donner une impression de maîtrise.
Appels d'outils en parallèle avec narration audio
GPT-Realtime-2 peut appeler plusieurs outils en même temps et décrire à voix haute ce qu'il fait. Plutôt que des blancs pendant une tâche en plusieurs étapes, l'utilisateur profite d'un commentaire continu. Un vrai plus pour l'expérience utilisateur.
Meilleure reprise en cas de problème
Si quelque chose se passe mal, par exemple un outil qui échoue ou une demande ambiguë, le modèle peut dire « j'ai un souci avec ça pour le moment » au lieu de se taire ou d'inventer une réponse.
Fenêtre de contexte : 32K → 128K
La mise à niveau quadruple la quantité d'historique et de contexte que le modèle peut traiter en une seule session, passant de 32 000 à 128 000 tokens. Idéal pour des conversations plus longues, sans dérive.
Effort de raisonnement ajustable
Les développeurs peuvent désormais choisir entre des niveaux de raisonnement minimal, faible, moyen, élevé et très élevé.
Le niveau par défaut est « faible », afin de limiter la latence pour les échanges simples, avec des options plus réfléchies lorsque la demande est plus complexe.
Meilleure compréhension des domaines et contrôle du ton
Le modèle retient mieux la terminologie spécialisée, par exemple en santé ou en finance. Il peut aussi adapter sa manière de s'exprimer : plus posé pour résoudre un problème, empathique face à la frustration, enjoué pour confirmer une action réussie.
Résultats de benchmark de GPT-Realtime-2
Jetons un œil aux benchmarks. OpenAI compare à GPT-Realtime-1.5, ce qui donne une lecture claire d'une année sur l'autre :
- Big Bench Audio (intelligence audio) : 81,4 % → 96,6 % — soit +15,2 points.
- Audio MultiChallenge (suivi d'instructions en dialogue parlé) : 34,7 % → 48,5 % — soit +13,8 points.
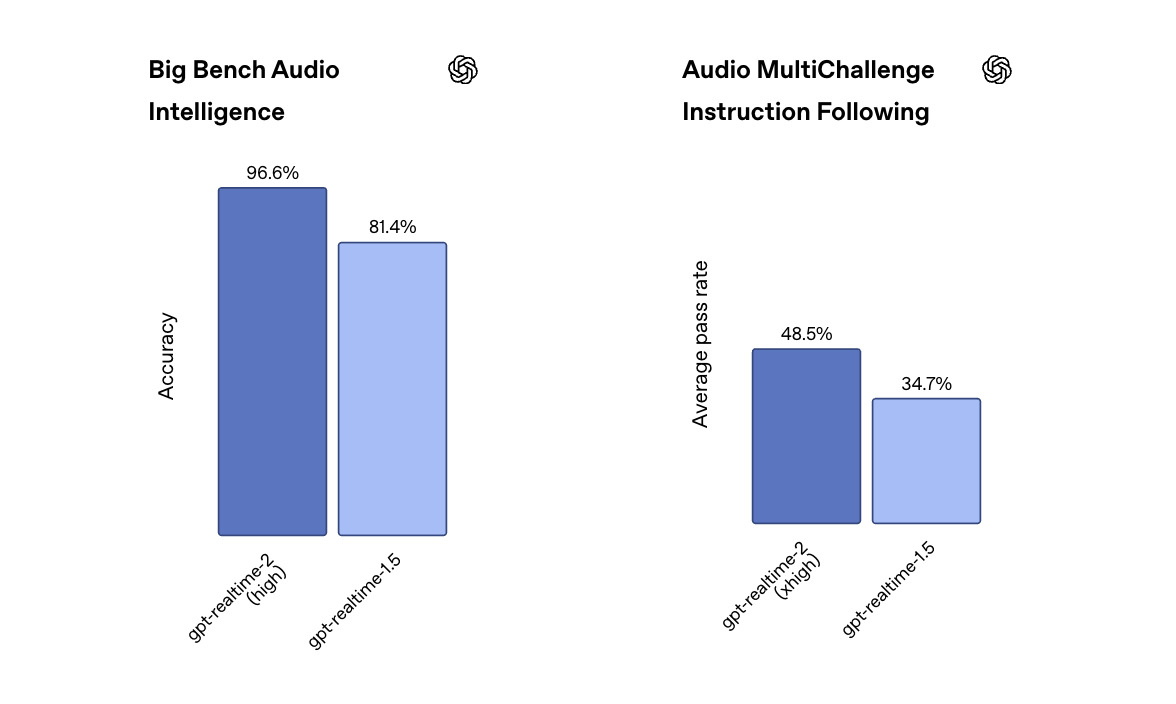
Le score Big Bench Audio est révélateur : 96,6 % laisse penser que le benchmark arrive à saturation. Audio MultiChallenge, en revanche, reste sous les 50 %, ce qui en fait un bon garde-fou. « Mieux que le modèle vocal de l'an dernier » et « prêt pour une mise en production sans supervision » ne sont pas le même niveau d'exigence.
À noter : ces scores ont été obtenus avec des réglages de raisonnement « élevé » et « très élevé ». En production, le défaut est « faible » pour des raisons de latence, et l'expérience réelle pourrait donc différer des performances mises en avant.
Les trois modèles audio sont dès maintenant disponibles via l'API Realtime :
- GPT-Realtime-2 : 32 $ par 1 M de tokens audio en entrée (0,40 $ en entrée mise en cache), 64 $ par 1 M de tokens audio en sortie.
- GPT-Realtime-Translate : 0,034 $ par minute.
- GPT-Realtime-Whisper : 0,017 $ par minute.
Les deux modèles facturés à la minute sont bien plus simples à appréhender pour la budgétisation. La tarification audio au token est difficile à convertir en « coût par appel » sans instrumenter. Il faudra donc prévoir un peu de modélisation des coûts attendus avant de livrer ou d'annoncer quoi que ce soit.
Bonne nouvelle, vous pouvez tester GPT-Realtime-2 dans le Playground, et OpenAI oriente les développeurs vers Codex (nous avons beaucoup écrit sur Codex) avec un prompt de départ pour l'intégrer à des applications existantes.
GPT-Realtime-2 et la sécurité
Côté sécurité, OpenAI indique que des classificateurs actifs peuvent interrompre les sessions qui enfreignent ses règles sur les contenus nuisibles, et que les développeurs peuvent ajouter leurs propres garde-fous via le Agents SDK, que nous avons également couvert.
Gardez à l'esprit que la voix introduit des risques très spécifiques. Parmi eux :
- Activations involontaires : le système se met à écouter ou à répondre alors que personne ne s'adressait à lui.
- Capture de l'audio ambiant : une fois le micro ouvert, tout ce qui se passe dans la pièce est enregistré, pas seulement l'utilisateur. Conversations de fond, enfants, collègues, télévision, réunion confidentielle à côté, etc.
- Usurpation vocale : la voix est biométrique. Une synthèse vocale ressemblant à une vraie personne peut servir à l'usurpation d'identité, à la fraude ou au contournement de systèmes d'authentification vocale. C'est un risque autant en sortie qu'en entrée.
Dernières réflexions
OpenAI réunit tout ce qui fait paraître un agent vocal compétent — phrases de transition, appels d'outils commentés, reprise élégante, grande fenêtre de contexte, véritable réglage du raisonnement — au sein d'un modèle qui sait réellement raisonner. Résultat pour l'utilisateur : moins de silences gênants et des conversations qui se désagrègent moins facilement. C'est une vraie avancée.






À peine deux jours après la sortie de GPT-5.5 Instant, OpenAI revient avec d'autres annonces majeures, réunies dans une nouvelle version axée sur trois volets :
Dans cet article, nous faisons le point sur ces trois modèles.
Si vous cherchez un modèle concurrent dédié à l'interaction en direct, nous vous recommandons notre guide sur le TML-Interaction-Small de Thinking Machines Lab.
Qu'est-ce que GPT-Realtime-2 ?
GPT-Realtime-2 est le nouveau modèle vocal temps réel de l'API d'OpenAI, et le premier modèle vocal qu'OpenAI décrit comme doté d'un « raisonnement de classe GPT-5 ».
Il est conçu pour les interactions vocales en direct ; autrement dit, on lui parle, on ne tape pas.
Le modèle est pensé pour faire avancer la conversation tout en raisonnant sur une demande, en appelant des outils et en gérant les corrections. En un mot, il répond de manière adaptée au moment.
Voici quelques points clés par rapport au modèle précédent, GPT-Realtime-1.5 :
Qu'est-ce que GPT-Realtime-Translate ?
GPT-Realtime-Translate est le nouveau modèle de traduction vocale en direct d'OpenAI, compatible avec plus de 70 langues en entrée et 13 langues en sortie.
Il est conçu pour le cas voix-à-voix : chaque personne parle dans sa langue, et le modèle traduit en temps réel. Il est censé préserver le sens lorsque les interlocuteurs changent de sujet, utilisent des accents régionaux ou emploient des termes spécialisés.
Qu'est-ce que GPT-Realtime-Whisper ?
GPT-Realtime-Whisper est le nouveau modèle de reconnaissance vocale en streaming d'OpenAI, optimisé pour une transcription à faible latence pendant que l'orateur parle.
Le Whisper d'origine était conçu pour des segments audio finalisés. Avec cette version en streaming, on dispose d'un modèle plus utile pour les sous-titres de diffusion en direct et pour les agents vocaux qui doivent comprendre l'utilisateur en continu plutôt que tour à tour.
Pour récapituler, voici la structure :
Fonctionnalités clés de GPT-Realtime-2
Les fonctionnalités suivantes concernent spécifiquement GPT-Realtime-2.
Préambules
Les développeurs peuvent faire prononcer au modèle de courtes phrases de transition comme « laissez-moi vérifier » ou « un instant, je regarde » avant la réponse principale.
C'est important, car nous tolérons mal les silences gênants. Ces « remplissages » à la manière humaine contribuent à donner une impression de maîtrise.
Appels d'outils en parallèle avec narration audio
GPT-Realtime-2 peut appeler plusieurs outils en même temps et décrire à voix haute ce qu'il fait. Plutôt que des blancs pendant une tâche en plusieurs étapes, l'utilisateur profite d'un commentaire continu. Un vrai plus pour l'expérience utilisateur.
Meilleure reprise en cas de problème
Si quelque chose se passe mal, par exemple un outil qui échoue ou une demande ambiguë, le modèle peut dire « j'ai un souci avec ça pour le moment » au lieu de se taire ou d'inventer une réponse.
Fenêtre de contexte : 32K → 128K
La mise à niveau quadruple la quantité d'historique et de contexte que le modèle peut traiter en une seule session, passant de 32 000 à 128 000 tokens. Idéal pour des conversations plus longues, sans dérive.
Effort de raisonnement ajustable
Les développeurs peuvent désormais choisir entre des niveaux de raisonnement minimal, faible, moyen, élevé et très élevé.
Le niveau par défaut est « faible », afin de limiter la latence pour les échanges simples, avec des options plus réfléchies lorsque la demande est plus complexe.
Meilleure compréhension des domaines et contrôle du ton
Le modèle retient mieux la terminologie spécialisée, par exemple en santé ou en finance. Il peut aussi adapter sa manière de s'exprimer : plus posé pour résoudre un problème, empathique face à la frustration, enjoué pour confirmer une action réussie.
Résultats de benchmark de GPT-Realtime-2
Jetons un œil aux benchmarks. OpenAI compare à GPT-Realtime-1.5, ce qui donne une lecture claire d'une année sur l'autre :
Le score Big Bench Audio est révélateur : 96,6 % laisse penser que le benchmark arrive à saturation. Audio MultiChallenge, en revanche, reste sous les 50 %, ce qui en fait un bon garde-fou. « Mieux que le modèle vocal de l'an dernier » et « prêt pour une mise en production sans supervision » ne sont pas le même niveau d'exigence.
À noter : ces scores ont été obtenus avec des réglages de raisonnement « élevé » et « très élevé ». En production, le défaut est « faible » pour des raisons de latence, et l'expérience réelle pourrait donc différer des performances mises en avant.
Comment accéder à GPT-Realtime-2 ?
Les trois modèles audio sont dès maintenant disponibles via l'API Realtime :
Les deux modèles facturés à la minute sont bien plus simples à appréhender pour la budgétisation. La tarification audio au token est difficile à convertir en « coût par appel » sans instrumenter. Il faudra donc prévoir un peu de modélisation des coûts attendus avant de livrer ou d'annoncer quoi que ce soit.
Bonne nouvelle, vous pouvez tester GPT-Realtime-2 dans le Playground, et OpenAI oriente les développeurs vers Codex (nous avons beaucoup écrit sur Codex) avec un prompt de départ pour l'intégrer à des applications existantes.
GPT-Realtime-2 et la sécurité
Côté sécurité, OpenAI indique que des classificateurs actifs peuvent interrompre les sessions qui enfreignent ses règles sur les contenus nuisibles, et que les développeurs peuvent ajouter leurs propres garde-fous via le Agents SDK, que nous avons également couvert.
Gardez à l'esprit que la voix introduit des risques très spécifiques. Parmi eux :
Dernières réflexions
OpenAI réunit tout ce qui fait paraître un agent vocal compétent — phrases de transition, appels d'outils commentés, reprise élégante, grande fenêtre de contexte, véritable réglage du raisonnement — au sein d'un modèle qui sait réellement raisonner. Résultat pour l'utilisateur : moins de silences gênants et des conversations qui se désagrègent moins facilement. C'est une vraie avancée.