Apenas dos días después del lanzamiento de GPT-5.5 Instant, OpenAI trae más novedades con una versión que se centra en tres frentes a la vez:
- un modelo de voz que puede razonar mientras habla: es GPT‑Realtime‑2
- traducción en vivo en más de 70 idiomas: GPT‑Realtime‑Translate
- y, por último, transcripción en streaming que sigue el ritmo de una conversación real: GPT‑Realtime‑Whisper
En este artículo, te ponemos al día sobre estas tres novedades.
Si te interesa un modelo competidor centrado en la interacción en vivo, te recomendamos nuestra guía sobre TML-Interaction-Small de Thinking Machines Lab.
¿Qué es GPT-Realtime-2?
GPT-Realtime-2 es el nuevo modelo de voz en tiempo real de la API de OpenAI, y el primero que OpenAI describe con "razonamiento de clase GPT-5".
Está diseñado para interacciones de voz en vivo; es decir, para que alguien le hable, no para escribirle.
El modelo mantiene la conversación fluyendo mientras razona sobre una petición, llama a herramientas y maneja correcciones. Dicho de otro modo, responde de forma acorde al momento.
Algunas características clave frente al modelo anterior, GPT-Realtime-1.5:
- la ventana de contexto salta de 32K a 128K
- los desarrolladores ahora pueden ajustar el esfuerzo de razonamiento
- detalles como frases de preámbulo hacen que los agentes de voz suenen menos robóticos
¿Qué es GPT-Realtime-Translate?
GPT-Realtime-Translate es el nuevo modelo de traducción de voz en vivo de OpenAI, compatible con más de 70 idiomas de entrada y 13 idiomas de salida.
Está pensado para el caso voz a voz: cada persona habla en su idioma preferido y el modelo traduce en tiempo real. Debería mantener el sentido cuando los hablantes cambian de contexto, usan acentos regionales o introducen términos específicos de un dominio.
¿Qué es GPT-Realtime-Whisper?
GPT-Realtime-Whisper es el nuevo modelo de voz a texto en streaming de OpenAI, pensado para transcripción con baja latencia mientras la persona habla.
El Whisper original estaba diseñado para fragmentos de audio completos. Con la nueva versión en streaming, tenemos un modelo más útil para subtítulos en directo y agentes de voz que necesitan entender al usuario de forma continua, no por turnos.
Si te has perdido, aquí va el resumen:
- GPT-Realtime-2 = un agente conversacional de voz completo. Escucha, razona, llama a herramientas y responde hablando. Úsalo cuando quieras voz de entrada y voz de salida.
- GPT-Realtime-Translate = un conducto de traducción. Voz en idioma A → voz en idioma B. No conversa con nadie; convierte un flujo en otro.
- GPT-Realtime-Whisper = un conducto de transcripción. Voz de entrada → texto de salida. Sin razonamiento, sin respuesta por voz. Lo usarías para subtítulos en directo, etc.
Funciones clave de GPT-Realtime-2
Las siguientes funciones se aplican específicamente a GPT-Realtime-2.
Preámbulos
Los desarrolladores pueden hacer que el modelo diga frases cortas de relleno como "déjame comprobarlo" o "un momento, que lo miro" antes de su respuesta principal.
Es una gran mejora porque solemos ser impacientes o intolerantes con los silencios incómodos. Ese relleno más humano es de esas cosas que hacen que un agente parezca competente.
Llamadas a herramientas en paralelo con narración de audio
GPT-Realtime-2 puede llamar a varias herramientas a la vez y narrar lo que está haciendo mientras lo hace. En lugar de silencio durante una tarea de varios pasos, el usuario recibe un comentario continuo. Es sobre todo una mejora de UX.
Mejor comportamiento de recuperación
Cuando algo falla, ya sea porque una herramienta se cae o porque la petición es ambigua, el modelo puede decir algo como "estoy teniendo problemas con eso ahora mismo" en lugar de quedarse callado o inventarse algo.
Ventana de contexto: 32K → 128K
La mejora cuadruplica el historial de conversación y el contexto que el modelo puede procesar en una sesión, pasando de 32.000 a 128.000 tokens. Esto lo hace apto para conversaciones más largas sin deriva.
Esfuerzo de razonamiento ajustable
Los desarrolladores ahora pueden elegir entre niveles de razonamiento mínimo, bajo, medio, alto y muy alto.
Bajo es el valor por defecto, lo que mantiene la latencia baja en intercambios simples, con opciones más deliberadas cuando la petición es más compleja.
Mejor comprensión de dominios y control del tono
El modelo retiene mejor la terminología especializada, como términos sanitarios o jerga financiera. También puede modular su entrega: más calmado al resolver un problema, empático cuando el usuario está frustrado y enérgico al confirmar una acción correcta.
Resultados de los benchmarks de GPT-Realtime-2
Veamos los benchmarks. OpenAI compara con GPT-Realtime-1.5, lo que permite una foto clara de un año a otro:
- Big Bench Audio (inteligencia de audio): 81,4% → 96,6% — una subida de 15,2 puntos.
- Audio MultiChallenge (seguimiento de instrucciones en diálogo hablado): 34,7% → 48,5% — una subida de 13,8 puntos.
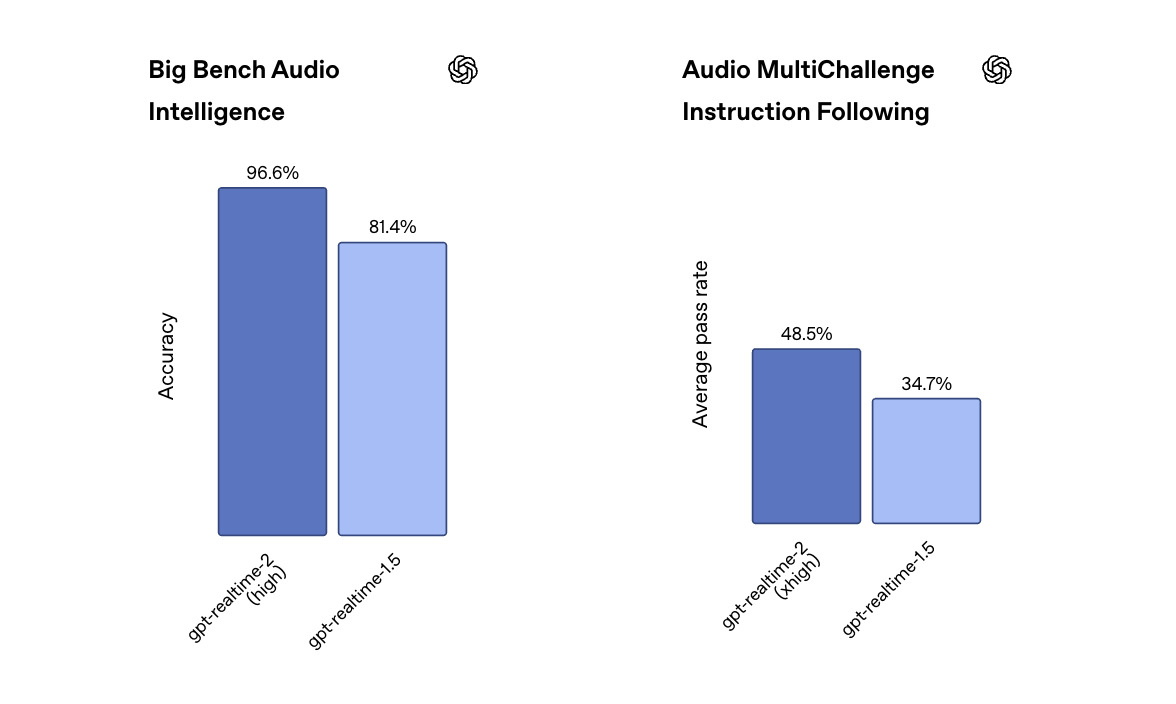
El dato de Big Bench Audio es interesante. Un 96,6% sugiere que el benchmark se acerca a la saturación. Audio MultiChallenge, en cambio, sigue por debajo del 50%, así que este segundo resultado sirve de contrapeso: "mejor que el modelo de voz del año pasado" y "listo para producción sin supervisión" no son el mismo listón.
Importante: estas cifras se obtuvieron con los ajustes de razonamiento "alto" y "muy alto". En producción, el valor por defecto será "bajo" por motivos de latencia, así que la experiencia real puede diferir de lo que sugieren los titulares.
¿Cómo puedo acceder a GPT-Realtime-2?
Los tres modelos de audio ya están disponibles en la Realtime API:
- GPT-Realtime-2: 32 $ por 1M de tokens de audio de entrada (0,40 $ con entrada en caché), 64 $ por 1M de tokens de audio de salida.
- GPT-Realtime-Translate: 0,034 $ por minuto.
- GPT-Realtime-Whisper: 0,017 $ por minuto.
Los dos modelos con precio por minuto son mucho más sencillos para presupuestar. El precio por token de audio es difícil de convertir en "¿cuánto costará por llamada?" sin instrumentarlo. Así que conviene dedicar tiempo a modelar costes esperados antes de lanzar o comprometerse.
Por suerte, puedes probar GPT-Realtime-2 en el Playground, y OpenAI orienta a los desarrolladores hacia Codex (hemos escrito mucho sobre Codex) con un prompt inicial para integrarlo en apps existentes.
GPT-Realtime-2 y seguridad
En materia de seguridad, OpenAI afirma que clasificadores activos pueden detener sesiones que violen sus directrices de contenido dañino, y que los desarrolladores pueden añadir sus propios controles con el Agents SDK, del que también hemos hablado.
Ten en cuenta: la voz introduce riesgos muy específicos. Merece la pena destacarlos:
- Activaciones accidentales: el sistema empieza a escuchar o responder cuando nadie pretendía hablarle.
- Captura de audio ambiente: cuando se enciende un micrófono, recoge todo lo que hay en la sala, no solo al usuario. Conversaciones de fondo, niños, compañeros, una tele, una reunión confidencial al lado, etc.
- Riesgos de clonación de voz: la voz es biométrica. El habla sintética que suena como una persona real puede usarse para suplantación, fraude o para saltarse sistemas de autenticación por voz. Es un riesgo tanto en salida como en entrada.
Reflexiones finales
OpenAI está agrupando lo que hace que los agentes de voz parezcan competentes —frases de relleno, llamadas a herramientas narradas, recuperación elegante, una gran ventana de contexto, un control real del razonamiento— en un modelo que además sabe razonar. ¿Qué gana el usuario? Menos silencios incómodos y conversaciones menos propensas a romperse. Es un gran paso adelante.






Apenas dos días después del lanzamiento de GPT-5.5 Instant, OpenAI trae más novedades con una versión que se centra en tres frentes a la vez:
En este artículo, te ponemos al día sobre estas tres novedades.
Si te interesa un modelo competidor centrado en la interacción en vivo, te recomendamos nuestra guía sobre TML-Interaction-Small de Thinking Machines Lab.
¿Qué es GPT-Realtime-2?
GPT-Realtime-2 es el nuevo modelo de voz en tiempo real de la API de OpenAI, y el primero que OpenAI describe con "razonamiento de clase GPT-5".
Está diseñado para interacciones de voz en vivo; es decir, para que alguien le hable, no para escribirle.
El modelo mantiene la conversación fluyendo mientras razona sobre una petición, llama a herramientas y maneja correcciones. Dicho de otro modo, responde de forma acorde al momento.
Algunas características clave frente al modelo anterior, GPT-Realtime-1.5:
¿Qué es GPT-Realtime-Translate?
GPT-Realtime-Translate es el nuevo modelo de traducción de voz en vivo de OpenAI, compatible con más de 70 idiomas de entrada y 13 idiomas de salida.
Está pensado para el caso voz a voz: cada persona habla en su idioma preferido y el modelo traduce en tiempo real. Debería mantener el sentido cuando los hablantes cambian de contexto, usan acentos regionales o introducen términos específicos de un dominio.
¿Qué es GPT-Realtime-Whisper?
GPT-Realtime-Whisper es el nuevo modelo de voz a texto en streaming de OpenAI, pensado para transcripción con baja latencia mientras la persona habla.
El Whisper original estaba diseñado para fragmentos de audio completos. Con la nueva versión en streaming, tenemos un modelo más útil para subtítulos en directo y agentes de voz que necesitan entender al usuario de forma continua, no por turnos.
Si te has perdido, aquí va el resumen:
Funciones clave de GPT-Realtime-2
Las siguientes funciones se aplican específicamente a GPT-Realtime-2.
Preámbulos
Los desarrolladores pueden hacer que el modelo diga frases cortas de relleno como "déjame comprobarlo" o "un momento, que lo miro" antes de su respuesta principal.
Es una gran mejora porque solemos ser impacientes o intolerantes con los silencios incómodos. Ese relleno más humano es de esas cosas que hacen que un agente parezca competente.
Llamadas a herramientas en paralelo con narración de audio
GPT-Realtime-2 puede llamar a varias herramientas a la vez y narrar lo que está haciendo mientras lo hace. En lugar de silencio durante una tarea de varios pasos, el usuario recibe un comentario continuo. Es sobre todo una mejora de UX.
Mejor comportamiento de recuperación
Cuando algo falla, ya sea porque una herramienta se cae o porque la petición es ambigua, el modelo puede decir algo como "estoy teniendo problemas con eso ahora mismo" en lugar de quedarse callado o inventarse algo.
Ventana de contexto: 32K → 128K
La mejora cuadruplica el historial de conversación y el contexto que el modelo puede procesar en una sesión, pasando de 32.000 a 128.000 tokens. Esto lo hace apto para conversaciones más largas sin deriva.
Esfuerzo de razonamiento ajustable
Los desarrolladores ahora pueden elegir entre niveles de razonamiento mínimo, bajo, medio, alto y muy alto.
Bajo es el valor por defecto, lo que mantiene la latencia baja en intercambios simples, con opciones más deliberadas cuando la petición es más compleja.
Mejor comprensión de dominios y control del tono
El modelo retiene mejor la terminología especializada, como términos sanitarios o jerga financiera. También puede modular su entrega: más calmado al resolver un problema, empático cuando el usuario está frustrado y enérgico al confirmar una acción correcta.
Resultados de los benchmarks de GPT-Realtime-2
Veamos los benchmarks. OpenAI compara con GPT-Realtime-1.5, lo que permite una foto clara de un año a otro:
El dato de Big Bench Audio es interesante. Un 96,6% sugiere que el benchmark se acerca a la saturación. Audio MultiChallenge, en cambio, sigue por debajo del 50%, así que este segundo resultado sirve de contrapeso: "mejor que el modelo de voz del año pasado" y "listo para producción sin supervisión" no son el mismo listón.
Importante: estas cifras se obtuvieron con los ajustes de razonamiento "alto" y "muy alto". En producción, el valor por defecto será "bajo" por motivos de latencia, así que la experiencia real puede diferir de lo que sugieren los titulares.
¿Cómo puedo acceder a GPT-Realtime-2?
Los tres modelos de audio ya están disponibles en la Realtime API:
Los dos modelos con precio por minuto son mucho más sencillos para presupuestar. El precio por token de audio es difícil de convertir en "¿cuánto costará por llamada?" sin instrumentarlo. Así que conviene dedicar tiempo a modelar costes esperados antes de lanzar o comprometerse.
Por suerte, puedes probar GPT-Realtime-2 en el Playground, y OpenAI orienta a los desarrolladores hacia Codex (hemos escrito mucho sobre Codex) con un prompt inicial para integrarlo en apps existentes.
GPT-Realtime-2 y seguridad
En materia de seguridad, OpenAI afirma que clasificadores activos pueden detener sesiones que violen sus directrices de contenido dañino, y que los desarrolladores pueden añadir sus propios controles con el Agents SDK, del que también hemos hablado.
Ten en cuenta: la voz introduce riesgos muy específicos. Merece la pena destacarlos:
Reflexiones finales
OpenAI está agrupando lo que hace que los agentes de voz parezcan competentes —frases de relleno, llamadas a herramientas narradas, recuperación elegante, una gran ventana de contexto, un control real del razonamiento— en un modelo que además sabe razonar. ¿Qué gana el usuario? Menos silencios incómodos y conversaciones menos propensas a romperse. Es un gran paso adelante.