Apenas dois dias após o lançamento do GPT-5.5 Instant, a OpenAI trouxe mais novidades, com um lançamento que foca em três frentes ao mesmo tempo:
- um modelo de voz que consegue raciocinar enquanto fala: é o GPT‑Realtime‑2
- tradução ao vivo em mais de 70 idiomas: GPT‑Realtime‑Translate
- e, por fim, transcrição em streaming que acompanha conversas reais: GPT‑Realtime‑Whisper
Neste artigo, vamos te colocar a par das novidades desses três modelos.
Se você procura um modelo concorrente focado em interação ao vivo, vale conferir nosso guia sobre o TML-Interaction-Small, do Thinking Machines Lab.
O que é o GPT-Realtime-2?
GPT-Realtime-2 é o novo modelo de voz em tempo real da API da OpenAI, e o primeiro que a empresa descreve como tendo "raciocínio no nível do GPT-5".
Ele foi criado para interações de voz ao vivo; ou seja, alguém fala com o modelo, não digita.
O modelo foi projetado para manter a conversa fluindo enquanto raciocina sobre um pedido, chama ferramentas e lida com correções. Em outras palavras, ele responde de um jeito que encaixa no momento.
Aqui vão algumas características importantes em relação ao modelo anterior, o GPT-Realtime-1.5:
- a janela de contexto salta de 32K para 128K
- desenvolvedores agora podem ajustar o esforço de raciocínio
- detalhes como frases de preâmbulo deixam agentes de voz menos robóticos
O que é o GPT-Realtime-Translate?
GPT-Realtime-Translate é o novo modelo de tradução de fala ao vivo da OpenAI, com suporte a mais de 70 idiomas de entrada e 13 idiomas de saída.
Ele foi feito para o caso voz‑para‑voz: cada pessoa fala no idioma de preferência, e o modelo traduz em tempo real. A ideia é preservar o sentido quando os falantes mudam de contexto, usam sotaques regionais ou mencionam termos específicos de domínio.
O que é o GPT-Realtime-Whisper?
GPT-Realtime-Whisper é o novo modelo de fala‑para‑texto em streaming da OpenAI, feito para transcrição de baixa latência enquanto a pessoa fala.
O Whisper original foi projetado para trechos de áudio concluídos. Com a versão mais recente em streaming, temos um modelo mais útil para legendas de transmissões ao vivo e para agentes de voz que precisam entender o usuário continuamente, e não turno a turno.
Se ficou confuso, aqui vai o resumo:
- GPT-Realtime-2 = um agente de conversação por voz completo. Ouve, raciocina, chama ferramentas, responde falando. Você usa quando quer voz de entrada e voz de saída.
- GPT-Realtime-Translate = um canal de tradução. Fala no idioma A → fala no idioma B. Ele não está conversando com ninguém; está convertendo um fluxo em outro.
- GPT-Realtime-Whisper = um canal de transcrição. Fala entra → texto sai. Sem raciocínio, sem resposta por voz. Ideal para legendas ao vivo, etc.
Principais recursos do GPT-Realtime-2
Os recursos a seguir se aplicam especificamente ao GPT-Realtime-2.
Preâmbulos
Desenvolvedores podem configurar o modelo para dizer frases curtas de preenchimento como "deixa eu verificar isso" ou "um momento enquanto eu consulto" antes da resposta principal.
Isso é grande coisa porque as pessoas tendem a ser impacientes ou pouco tolerantes com silêncio constrangedor. Preenchimento no estilo humano é um daqueles detalhes que fazem o agente soar competente.
Chamadas de ferramentas em paralelo com narração em áudio
O GPT-Realtime-2 pode chamar várias ferramentas de uma vez e narrar o que está fazendo ao mesmo tempo. Em vez de ficar no vácuo durante uma tarefa em múltiplas etapas, o usuário recebe comentários contínuos. É, sobretudo, uma vitória de UX.
Comportamento de recuperação mais robusto
Quando algo dá errado, como uma falha de ferramenta ou um pedido ambíguo, por exemplo, o modelo pode dizer algo como "estou com dificuldade nisso agora" em vez de ficar em silêncio ou inventar algo.
Janela de contexto: 32K → 128K
O upgrade quadruplica a quantidade de histórico de conversa e contexto que o modelo consegue processar em uma única sessão, passando de 32.000 para 128.000 tokens. Isso deixa o modelo mais adequado para conversas longas, sem perder o fio.
Esforço de raciocínio ajustável
Desenvolvedores agora podem selecionar níveis de raciocínio entre mínimo, baixo, médio, alto e muito alto.
Baixo é o padrão, o que reduz a latência em trocas simples, com opções mais deliberadas quando o pedido é mais complexo.
Melhor entendimento de domínio e controle de tom
O modelo agora retém melhor a terminologia especializada, como termos de saúde ou jargão financeiro. Ele também ajusta a entrega: mais calmo ao resolver um problema, empático quando o usuário está frustrado, animado ao confirmar uma ação bem-sucedida.
Resultados de benchmark do GPT-Realtime-2
Vamos dar uma olhada nos benchmarks. A OpenAI está comparando com o GPT-Realtime-1.5, o que dá uma visão clara de evolução ano a ano:
- Big Bench Audio (inteligência em áudio): 81,4% → 96,6% — alta de 15,2 pontos.
- Audio MultiChallenge (seguir instruções em diálogos falados): 34,7% → 48,5% — alta de 13,8 pontos.
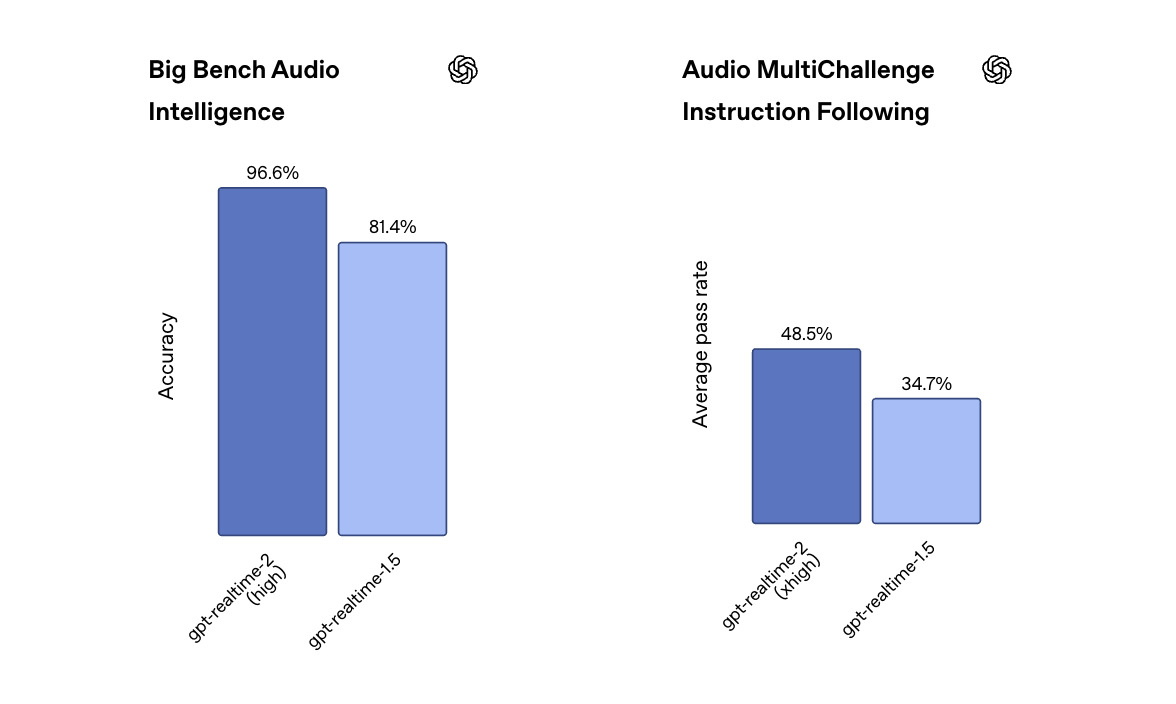
O número do Big Bench Audio chama atenção. Um 96,6% indica que o benchmark está perto de saturar. Já o Audio MultiChallenge ainda está abaixo de 50%, então esse segundo resultado serve como um bom choque de realidade. "Melhor que o modelo de voz do ano passado" e "pronto para produção sem supervisão" são coisas diferentes.
Vale destacar: esses números foram obtidos com as configurações de raciocínio "alto" e "muito alto". Em produção, o padrão será "baixo" por questões de latência, então a experiência real pode diferir da expectativa criada pelo número de destaque no benchmark.
Como acessar o GPT-Realtime-2?
Os três modelos de áudio já estão disponíveis na Realtime API:
- GPT-Realtime-2: US$ 32 por 1M de tokens de entrada em áudio (US$ 0,40 para entrada em cache), US$ 64 por 1M de tokens de saída em áudio.
- GPT-Realtime-Translate: US$ 0,034 por minuto.
- GPT-Realtime-Whisper: US$ 0,017 por minuto.
Os modelos cobrados por minuto são bem mais fáceis de estimar no orçamento. Precificar áudio por token é difícil de converter em "quanto custa por chamada?" sem instrumentar de fato. Então o desenvolvedor deve reservar um tempo para modelar custos esperados antes de lançar ou assumir compromissos.
Felizmente, dá para testar o GPT-Realtime-2 no Playground, e a OpenAI indica que desenvolvedores usem o Codex (já escrevemos bastante sobre o Codex) com um prompt inicial para integrá-lo a apps existentes.
GPT-Realtime-2 e segurança
Do lado da segurança, a OpenAI afirma que classificadores ativos podem encerrar sessões que violem as diretrizes de conteúdo nocivo, e que os desenvolvedores podem adicionar suas próprias proteções via Agents SDK, sobre o qual também já escrevemos.
Lembre-se: voz traz formas bem específicas de algo dar errado. Vale discutir:
- Ativações acidentais: o sistema começa a ouvir ou responder quando ninguém quis falar com ele.
- Captação de áudio ambiente: quando o microfone está ligado, ele pega tudo no ambiente, não só o usuário. Conversas ao fundo, crianças, colegas, TV, uma reunião confidencial na sala ao lado etc.
- Preocupações com clonagem de voz: voz é biometria. Fala sintética que soa como uma pessoa real pode ser usada para personificação, fraude ou para burlar sistemas de autenticação por voz. É uma preocupação tanto de saída quanto de entrada.
Considerações finais
A OpenAI está reunindo os elementos que fazem agentes de voz parecerem competentes — frases de preenchimento, chamadas de ferramentas narradas, recuperação elegante, janela de contexto ampla, um controle real de raciocínio — em um modelo que também consegue, de fato, raciocinar. Para o usuário, isso significa menos silêncios constrangedores e conversas menos propensas a desandar. É um grande avanço.











Apenas dois dias após o lançamento do GPT-5.5 Instant, a OpenAI trouxe mais novidades, com um lançamento que foca em três frentes ao mesmo tempo:
Neste artigo, vamos te colocar a par das novidades desses três modelos.
Se você procura um modelo concorrente focado em interação ao vivo, vale conferir nosso guia sobre o TML-Interaction-Small, do Thinking Machines Lab.
O que é o GPT-Realtime-2?
GPT-Realtime-2 é o novo modelo de voz em tempo real da API da OpenAI, e o primeiro que a empresa descreve como tendo "raciocínio no nível do GPT-5".
Ele foi criado para interações de voz ao vivo; ou seja, alguém fala com o modelo, não digita.
O modelo foi projetado para manter a conversa fluindo enquanto raciocina sobre um pedido, chama ferramentas e lida com correções. Em outras palavras, ele responde de um jeito que encaixa no momento.
Aqui vão algumas características importantes em relação ao modelo anterior, o GPT-Realtime-1.5:
O que é o GPT-Realtime-Translate?
GPT-Realtime-Translate é o novo modelo de tradução de fala ao vivo da OpenAI, com suporte a mais de 70 idiomas de entrada e 13 idiomas de saída.
Ele foi feito para o caso voz‑para‑voz: cada pessoa fala no idioma de preferência, e o modelo traduz em tempo real. A ideia é preservar o sentido quando os falantes mudam de contexto, usam sotaques regionais ou mencionam termos específicos de domínio.
O que é o GPT-Realtime-Whisper?
GPT-Realtime-Whisper é o novo modelo de fala‑para‑texto em streaming da OpenAI, feito para transcrição de baixa latência enquanto a pessoa fala.
O Whisper original foi projetado para trechos de áudio concluídos. Com a versão mais recente em streaming, temos um modelo mais útil para legendas de transmissões ao vivo e para agentes de voz que precisam entender o usuário continuamente, e não turno a turno.
Se ficou confuso, aqui vai o resumo:
Principais recursos do GPT-Realtime-2
Os recursos a seguir se aplicam especificamente ao GPT-Realtime-2.
Preâmbulos
Desenvolvedores podem configurar o modelo para dizer frases curtas de preenchimento como "deixa eu verificar isso" ou "um momento enquanto eu consulto" antes da resposta principal.
Isso é grande coisa porque as pessoas tendem a ser impacientes ou pouco tolerantes com silêncio constrangedor. Preenchimento no estilo humano é um daqueles detalhes que fazem o agente soar competente.
Chamadas de ferramentas em paralelo com narração em áudio
O GPT-Realtime-2 pode chamar várias ferramentas de uma vez e narrar o que está fazendo ao mesmo tempo. Em vez de ficar no vácuo durante uma tarefa em múltiplas etapas, o usuário recebe comentários contínuos. É, sobretudo, uma vitória de UX.
Comportamento de recuperação mais robusto
Quando algo dá errado, como uma falha de ferramenta ou um pedido ambíguo, por exemplo, o modelo pode dizer algo como "estou com dificuldade nisso agora" em vez de ficar em silêncio ou inventar algo.
Janela de contexto: 32K → 128K
O upgrade quadruplica a quantidade de histórico de conversa e contexto que o modelo consegue processar em uma única sessão, passando de 32.000 para 128.000 tokens. Isso deixa o modelo mais adequado para conversas longas, sem perder o fio.
Esforço de raciocínio ajustável
Desenvolvedores agora podem selecionar níveis de raciocínio entre mínimo, baixo, médio, alto e muito alto.
Baixo é o padrão, o que reduz a latência em trocas simples, com opções mais deliberadas quando o pedido é mais complexo.
Melhor entendimento de domínio e controle de tom
O modelo agora retém melhor a terminologia especializada, como termos de saúde ou jargão financeiro. Ele também ajusta a entrega: mais calmo ao resolver um problema, empático quando o usuário está frustrado, animado ao confirmar uma ação bem-sucedida.
Resultados de benchmark do GPT-Realtime-2
Vamos dar uma olhada nos benchmarks. A OpenAI está comparando com o GPT-Realtime-1.5, o que dá uma visão clara de evolução ano a ano:
O número do Big Bench Audio chama atenção. Um 96,6% indica que o benchmark está perto de saturar. Já o Audio MultiChallenge ainda está abaixo de 50%, então esse segundo resultado serve como um bom choque de realidade. "Melhor que o modelo de voz do ano passado" e "pronto para produção sem supervisão" são coisas diferentes.
Vale destacar: esses números foram obtidos com as configurações de raciocínio "alto" e "muito alto". Em produção, o padrão será "baixo" por questões de latência, então a experiência real pode diferir da expectativa criada pelo número de destaque no benchmark.
Como acessar o GPT-Realtime-2?
Os três modelos de áudio já estão disponíveis na Realtime API:
Os modelos cobrados por minuto são bem mais fáceis de estimar no orçamento. Precificar áudio por token é difícil de converter em "quanto custa por chamada?" sem instrumentar de fato. Então o desenvolvedor deve reservar um tempo para modelar custos esperados antes de lançar ou assumir compromissos.
Felizmente, dá para testar o GPT-Realtime-2 no Playground, e a OpenAI indica que desenvolvedores usem o Codex (já escrevemos bastante sobre o Codex) com um prompt inicial para integrá-lo a apps existentes.
GPT-Realtime-2 e segurança
Do lado da segurança, a OpenAI afirma que classificadores ativos podem encerrar sessões que violem as diretrizes de conteúdo nocivo, e que os desenvolvedores podem adicionar suas próprias proteções via Agents SDK, sobre o qual também já escrevemos.
Lembre-se: voz traz formas bem específicas de algo dar errado. Vale discutir:
Considerações finais
A OpenAI está reunindo os elementos que fazem agentes de voz parecerem competentes — frases de preenchimento, chamadas de ferramentas narradas, recuperação elegante, janela de contexto ampla, um controle real de raciocínio — em um modelo que também consegue, de fato, raciocinar. Para o usuário, isso significa menos silêncios constrangedores e conversas menos propensas a desandar. É um grande avanço.