Slechts twee dagen na de release van GPT-5.5 Instant komt OpenAI met meer groot nieuws, met een release die zich tegelijk op drie dingen richt:
- een stemmodel dat kan redeneren terwijl het praat: dat is GPT‑Realtime‑2
- livevertaling in 70+ talen: GPT‑Realtime‑Translate
- en tot slot streamingtranscriptie die echte gesprekken kan bijhouden: GPT‑Realtime‑Whisper
In dit artikel praten we je bij over het nieuws rond deze drie modellen.
Ben je geïnteresseerd in een concurrerend model dat focust op live interactie, lees dan onze gids over Thinking Machines Labs TML-Interaction-Small.
Wat is GPT-Realtime-2?
GPT-Realtime-2 is het nieuwe realtime stemmodel in OpenAI's API, en het eerste stemmodel dat OpenAI omschrijft als met "redeneren op GPT-5-niveau".
Het is gebouwd voor live steminteracties; m.a.w. iemand praat erin, niet typt.
Het model is ontworpen om het gesprek gaande te houden terwijl het een verzoek doorredeneert, tools aanroept en correcties verwerkt. Met andere woorden: het reageert op een manier die past bij het moment.
Hier zijn enkele belangrijke kenmerken vergeleken met het vorige model, GPT-Realtime-1.5:
- het contextvenster springt van 32K naar 128K
- ontwikkelaars kunnen nu de hoeveelheid redeneerinspanning instellen
- kleine accenten zoals inleidende zinnetjes laten stemagents minder robotachtig aanvoelen
Wat is GPT-Realtime-Translate?
GPT-Realtime-Translate is OpenAI's nieuwe model voor live spraakvertaling, met ondersteuning voor 70+ invoertalen en 13 uitvoertalen.
Het is gemaakt voor voice-to-voice: iedereen spreekt in z'n voorkeurstaal, en het model vertaalt in realtime. Het zou de betekenis moeten vasthouden wanneer sprekers van context wisselen, regionale uitspraak gebruiken of vaktermen laten vallen.
Wat is GPT-Realtime-Whisper?
GPT-Realtime-Whisper is OpenAI's nieuwe streaming spraak-naar-tekstmodel, gebouwd voor transcriptie met lage latentie terwijl de spreker praat.
De oorspronkelijke Whisper was ontworpen voor afgeronde audiobrokken. Met de nieuwere streamingversie hebben we een model dat nuttiger is voor live ondertiteling en stemagents die de gebruiker continu moeten begrijpen in plaats van beurtelings.
Dus, als je de draad kwijt bent, zo zit het:
- GPT-Realtime-2 = een volwaardig converserend stemagent. Luistert, redeneert, roept tools aan, praat terug. Dit gebruik je wanneer je stem-in én stem-uit wilt.
- GPT-Realtime-Translate = een vertaalpijp. Spraak in taal A → spraak in taal B. Het voert geen gesprek met iemand; het zet één stroom om in een andere.
- GPT-Realtime-Whisper = een transcriptiepijp. Spraak in → tekst uit. Geen redeneren, geen stemantwoord. Je zou het gebruiken voor live ondertiteling, enz.
Belangrijkste features van GPT-Realtime-2
De volgende features gelden specifiek voor GPT-Realtime-2.
Preambles
Ontwikkelaars kunnen het model korte vulzinnen laten zeggen zoals "laat me dat even checken" of "een momentje terwijl ik het opzoek" vóór de hoofdreactie.
Dit is een grote feature omdat mensen vaak ongeduldig of intolerant zijn bij ongemakkelijke stiltes. Menselijke stijlvulling is zo'n ding dat een agent bekwaam laat aanvoelen.
Parallelle toolcalls met audio-narratie
GPT-Realtime-2 kan meerdere tools tegelijk aanroepen en ondertussen vertellen wat het doet. In plaats van stilte tijdens een taak met meerdere stappen, krijgt de gebruiker doorlopend commentaar. Dit is vooral een UX-winst.
Sterker herstelgedrag
Als er iets misgaat, bijvoorbeeld wanneer een tool faalt of een verzoek dubbelzinnig is, kan het model iets zeggen als "dit lukt me nu even niet" in plaats van stil te vallen of iets te verzinnen.
Contextvenster: 32K → 128K
De upgrade verviervoudigt de hoeveelheid gespreksgeschiedenis en context die het model in één sessie kan verwerken, van 32.000 tokens naar 128.000 tokens. Dit maakt het model geschikt voor langere gesprekken zonder drift.
Aanpasbare redeneerinspanning
Ontwikkelaars kunnen nu kiezen uit minimale, lage, middelhoge, hoge en extra hoge redeneringsniveaus.
Laag is de standaard, wat de latentie beperkt voor simpel heen-en-weer, met meer doordachte opties wanneer het verzoek moeilijker is.
Betere domeinbegrip en tooncontrole
Het model onthoudt nu beter gespecialiseerde terminologie, zoals zorgtermen of financieel jargon. Het kan ook de toon van de levering aanpassen: rustiger bij het oplossen van een probleem, empathisch wanneer een gebruiker gefrustreerd is, vrolijk bij het bevestigen van een geslaagde actie.
Benchmarkresultaten van GPT-Realtime-2
Laten we naar de benchmarks kijken. OpenAI vergelijkt met GPT-Realtime-1.5, wat een helder jaar-op-jaarbeeld geeft:
- Big Bench Audio (audio-intelligentie): 81,4% → 96,6% — een stijging van 15,2 punten.
- Audio MultiChallenge (instructies volgen in gesproken dialoog): 34,7% → 48,5% — een stijging van 13,8 punten.
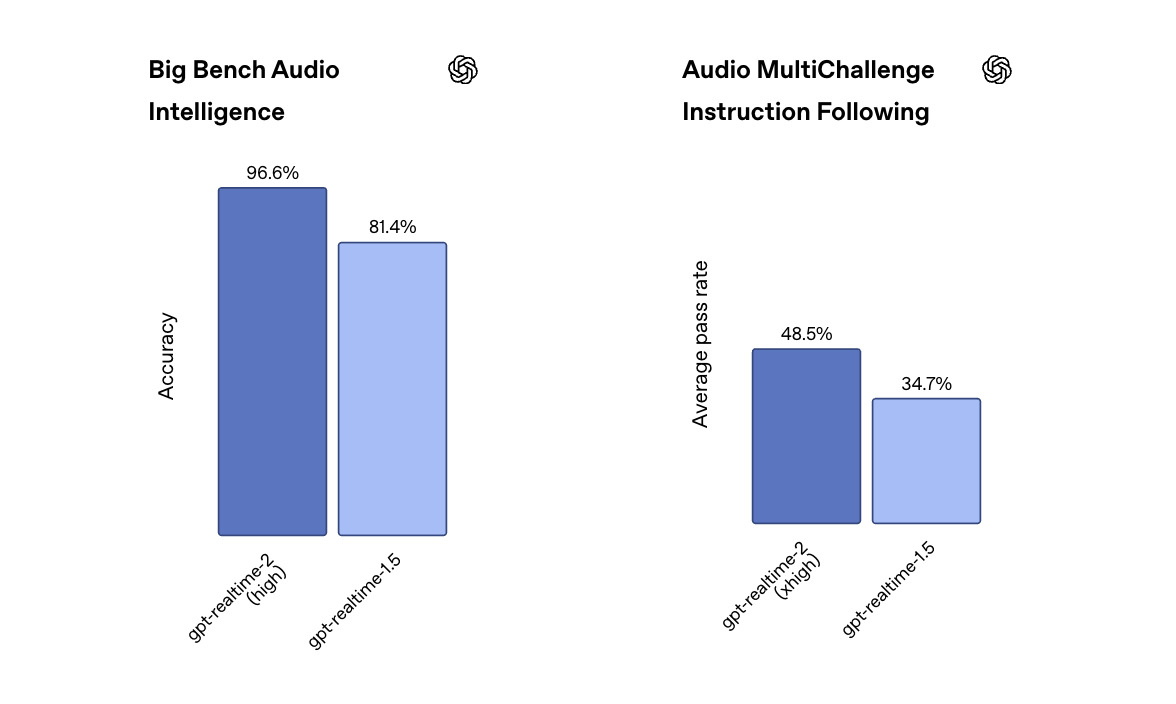
Het Big Bench Audio-cijfer is interessant. 96,6% laat zien dat de benchmark verzadiging nadert. Audio MultiChallenge zit daarentegen nog onder de 50%, dus dit tweede benchmarkresultaat is een nuttige realiteitscheck. "Beter dan het stemmodel van vorig jaar" en "klaar voor onbewaakte productie" zijn verschillende latten.
Het is de moeite waard te noemen: deze cijfers zijn gedraaid op de instellingen "hoog" en "extra hoog" voor redeneren. De standaard in productie zal "laag" zijn omwille van latentie, dus gebruikers kunnen een andere ervaring hebben dan verwacht op basis van het headline-benchmarkresultaat.
Hoe krijg ik toegang tot GPT-Realtime-2?
Alle drie audiomodellen zijn nu beschikbaar in de Realtime API:
- GPT-Realtime-2: $32 per 1M audiotokens voor input ($0,40 voor gecachte input), $64 per 1M audiotokens voor output.
- GPT-Realtime-Translate: $0,034 per minuut.
- GPT-Realtime-Whisper: $0,017 per minuut.
De twee modellen met minutentarief zijn veel makkelijker te doorgronden voor budgettering. Audioprijzen per token zijn lastig om te zetten in "wat kost dit per call?" zonder het daadwerkelijk te meten. Een ontwikkelaar moet dus rekenen op wat tijd om verwachte kosten te modelleren vóór je iets lanceert of belooft.
Gelukkig kun je GPT-Realtime-2 testen in de Playground, en OpenAI verwijst ontwikkelaars naar Codex (we hebben veel geschreven over Codex) met een startprompt om het aan bestaande apps toe te voegen.
GPT-Realtime-2 en veiligheid
Aan de veiligheidskant zegt OpenAI dat actieve classifiers sessies kunnen stoppen die in strijd zijn met de richtlijnen voor schadelijke inhoud, en ontwikkelaars kunnen eigen waarborgen toevoegen via de Agents SDK, waar we ook over hebben geschreven.
Houd in gedachten: stem introduceert zeer specifieke manieren waarop het mis kan gaan. Deze zijn het bespreken waard:
- Per ongeluk activeren: het systeem begint te luisteren of reageren terwijl niemand ertegen wilde praten.
- Opname van omgevingsgeluid: zodra een microfoon aan staat, pikt hij alles in de ruimte op, niet alleen de gebruiker. Achtergrondgesprekken, kinderen, collega’s, een tv, een vertrouwelijke meeting naast de deur, enzovoort.
- Zorgen rond stemklonen: stem is biometrisch. Synthetische spraak die klinkt als een echte persoon kan worden gebruikt voor imitatie, fraude of het omzeilen van stemauthenticatie. Dit is zowel een output- als inputzorg.
Tot slot
OpenAI bundelt de dingen die stemagents bekwaam laten aanvoelen — vulzinnen, becommentarieerde toolcalls, gracieus herstel, een groot contextvenster, een echte redeneerknop — in een model dat ook echt kan redeneren. Wat dit voor de gebruiker betekent: minder ongemakkelijke stiltes en gesprekken die minder snel uit elkaar vallen. Dat is een grote stap vooruit.




Slechts twee dagen na de release van GPT-5.5 Instant komt OpenAI met meer groot nieuws, met een release die zich tegelijk op drie dingen richt:
In dit artikel praten we je bij over het nieuws rond deze drie modellen.
Ben je geïnteresseerd in een concurrerend model dat focust op live interactie, lees dan onze gids over Thinking Machines Labs TML-Interaction-Small.
Wat is GPT-Realtime-2?
GPT-Realtime-2 is het nieuwe realtime stemmodel in OpenAI's API, en het eerste stemmodel dat OpenAI omschrijft als met "redeneren op GPT-5-niveau".
Het is gebouwd voor live steminteracties; m.a.w. iemand praat erin, niet typt.
Het model is ontworpen om het gesprek gaande te houden terwijl het een verzoek doorredeneert, tools aanroept en correcties verwerkt. Met andere woorden: het reageert op een manier die past bij het moment.
Hier zijn enkele belangrijke kenmerken vergeleken met het vorige model, GPT-Realtime-1.5:
Wat is GPT-Realtime-Translate?
GPT-Realtime-Translate is OpenAI's nieuwe model voor live spraakvertaling, met ondersteuning voor 70+ invoertalen en 13 uitvoertalen.
Het is gemaakt voor voice-to-voice: iedereen spreekt in z'n voorkeurstaal, en het model vertaalt in realtime. Het zou de betekenis moeten vasthouden wanneer sprekers van context wisselen, regionale uitspraak gebruiken of vaktermen laten vallen.
Wat is GPT-Realtime-Whisper?
GPT-Realtime-Whisper is OpenAI's nieuwe streaming spraak-naar-tekstmodel, gebouwd voor transcriptie met lage latentie terwijl de spreker praat.
De oorspronkelijke Whisper was ontworpen voor afgeronde audiobrokken. Met de nieuwere streamingversie hebben we een model dat nuttiger is voor live ondertiteling en stemagents die de gebruiker continu moeten begrijpen in plaats van beurtelings.
Dus, als je de draad kwijt bent, zo zit het:
Belangrijkste features van GPT-Realtime-2
De volgende features gelden specifiek voor GPT-Realtime-2.
Preambles
Ontwikkelaars kunnen het model korte vulzinnen laten zeggen zoals "laat me dat even checken" of "een momentje terwijl ik het opzoek" vóór de hoofdreactie.
Dit is een grote feature omdat mensen vaak ongeduldig of intolerant zijn bij ongemakkelijke stiltes. Menselijke stijlvulling is zo'n ding dat een agent bekwaam laat aanvoelen.
Parallelle toolcalls met audio-narratie
GPT-Realtime-2 kan meerdere tools tegelijk aanroepen en ondertussen vertellen wat het doet. In plaats van stilte tijdens een taak met meerdere stappen, krijgt de gebruiker doorlopend commentaar. Dit is vooral een UX-winst.
Sterker herstelgedrag
Als er iets misgaat, bijvoorbeeld wanneer een tool faalt of een verzoek dubbelzinnig is, kan het model iets zeggen als "dit lukt me nu even niet" in plaats van stil te vallen of iets te verzinnen.
Contextvenster: 32K → 128K
De upgrade verviervoudigt de hoeveelheid gespreksgeschiedenis en context die het model in één sessie kan verwerken, van 32.000 tokens naar 128.000 tokens. Dit maakt het model geschikt voor langere gesprekken zonder drift.
Aanpasbare redeneerinspanning
Ontwikkelaars kunnen nu kiezen uit minimale, lage, middelhoge, hoge en extra hoge redeneringsniveaus.
Laag is de standaard, wat de latentie beperkt voor simpel heen-en-weer, met meer doordachte opties wanneer het verzoek moeilijker is.
Betere domeinbegrip en tooncontrole
Het model onthoudt nu beter gespecialiseerde terminologie, zoals zorgtermen of financieel jargon. Het kan ook de toon van de levering aanpassen: rustiger bij het oplossen van een probleem, empathisch wanneer een gebruiker gefrustreerd is, vrolijk bij het bevestigen van een geslaagde actie.
Benchmarkresultaten van GPT-Realtime-2
Laten we naar de benchmarks kijken. OpenAI vergelijkt met GPT-Realtime-1.5, wat een helder jaar-op-jaarbeeld geeft:
Het Big Bench Audio-cijfer is interessant. 96,6% laat zien dat de benchmark verzadiging nadert. Audio MultiChallenge zit daarentegen nog onder de 50%, dus dit tweede benchmarkresultaat is een nuttige realiteitscheck. "Beter dan het stemmodel van vorig jaar" en "klaar voor onbewaakte productie" zijn verschillende latten.
Het is de moeite waard te noemen: deze cijfers zijn gedraaid op de instellingen "hoog" en "extra hoog" voor redeneren. De standaard in productie zal "laag" zijn omwille van latentie, dus gebruikers kunnen een andere ervaring hebben dan verwacht op basis van het headline-benchmarkresultaat.
Hoe krijg ik toegang tot GPT-Realtime-2?
Alle drie audiomodellen zijn nu beschikbaar in de Realtime API:
De twee modellen met minutentarief zijn veel makkelijker te doorgronden voor budgettering. Audioprijzen per token zijn lastig om te zetten in "wat kost dit per call?" zonder het daadwerkelijk te meten. Een ontwikkelaar moet dus rekenen op wat tijd om verwachte kosten te modelleren vóór je iets lanceert of belooft.
Gelukkig kun je GPT-Realtime-2 testen in de Playground, en OpenAI verwijst ontwikkelaars naar Codex (we hebben veel geschreven over Codex) met een startprompt om het aan bestaande apps toe te voegen.
GPT-Realtime-2 en veiligheid
Aan de veiligheidskant zegt OpenAI dat actieve classifiers sessies kunnen stoppen die in strijd zijn met de richtlijnen voor schadelijke inhoud, en ontwikkelaars kunnen eigen waarborgen toevoegen via de Agents SDK, waar we ook over hebben geschreven.
Houd in gedachten: stem introduceert zeer specifieke manieren waarop het mis kan gaan. Deze zijn het bespreken waard:
Tot slot
OpenAI bundelt de dingen die stemagents bekwaam laten aanvoelen — vulzinnen, becommentarieerde toolcalls, gracieus herstel, een groot contextvenster, een echte redeneerknop — in een model dat ook echt kan redeneren. Wat dit voor de gebruiker betekent: minder ongemakkelijke stiltes en gesprekken die minder snel uit elkaar vallen. Dat is een grote stap vooruit.